Il formato di tabella aperto Iceberg spiegato in modo semplice
|
8
min di lettura

La vostra dashboard dice che i ricavi di ieri sono calati, ma il problema è meno evidente. Un motore ha letto una directory prima che un nuovo batch fosse completamente confermato, un altro ha interpretato una partizione in modo diverso e un terzo vede ancora uno schema precedente. I file esistono, eppure la tabella non riesce a fornire un'unica risposta affidabile.
È il problema che affronta il formato di tabella aperto Iceberg. Aggiunge uno strato strutturato di metadati e transazioni ai dati archiviati in file aperti, lasciando i team liberi di usare motori come Spark, Flink, Trino o Hive. La decisione importante nel 2026, però, non è solo se Iceberg sia un buon formato di tabella. È quale catalogo controlla metadati, policy e percorso di accesso tra quei motori.
Indice
Introduzione ai formati di tabella moderni e perché sono importanti
Garanzie transazionali, evoluzione dello schema e strategie di partizionamento
Iceberg, Delta Lake e Hudi a confronto per il vostro lakehouse
Integrazioni con l'ecosistema, modelli di migrazione e flussi di lavoro di esempio
Best practice, ottimizzazione delle prestazioni e troubleshooting in produzione
Introduzione ai formati di tabella moderni e perché sono importanti
Un data lake tradizionale nasce spesso con un job di ingestione che scrive file Parquet su un object storage, un metastore che registra la posizione di una tabella e un motore di query che individua i file scansionando le cartelle. Questo approccio può funzionare per dati in sola aggiunta, ma la pressione operativa arriva presto.
Un producer può scrivere nella directory di data sbagliata. Un job di riparazione può modificare i file mentre è in corso una query di una dashboard. Un analista può leggere un misto di file vecchi e nuovi. Se il layout delle partizioni della tabella cambia, ogni producer e consumer potrebbe dover comprendere la modifica manualmente. Il data lake si comporta allora meno come un database e più come una cartella condivisa con regole non documentate.
I formati di tabella aperti migliorano questa situazione collocando un'astrazione di tabella sopra i file. Tengono traccia di schemi, snapshot, metadati a livello di file e commit, così che i motori di query possano capire quali file appartengono a una versione coerente della tabella. I dati restano in formati di storage aperti, ma gli utenti ottengono un comportamento simile a quello di un database.
Per i clienti di digna e per team enterprise analoghi, l'affidabilità significa più di query andate a buon fine. Una tabella di reporting deve arrivare in tempo, mantenere la struttura attesa, superare le validazioni di business ed esporre abbastanza storico da permettere di indagare su un incidente. Iceberg aiuta a stabilire le fondamenta transazionali e strutturali della tabella. L'observability deve comunque operare attorno a queste fondamenta, verificando se i dati sono arrivati, se i valori sono cambiati in modo inatteso e se i consumer a valle restano compatibili. I team che vogliono approfondire il concetto più ampio possono usare questa panoramica sui formati di tabella aperti come contesto aggiuntivo.
Regola pratica: considerate un formato di tabella aperto come uno strato di affidabilità per i file, non come una piattaforma di governance completa.
Apache Iceberg è stato creato in Netflix nel 2017 per risolvere problemi di scalabilità e coerenza delle tabelle in stile Hive. Netflix lo ha donato all'Apache Software Foundation a novembre 2018 e il progetto è diventato un progetto Apache di primo livello a maggio 2020. La sua specifica è proseguita con la release stabile 1.0.0 di ottobre 2022 e la release 1.6.1 di agosto 2024, secondo la storia del progetto Apache Iceberg.
Questa guida parte dal modello di tabella di base e passa poi all'architettura dei metadati di Iceberg, al comportamento transazionale, al confronto tra formati, ai modelli di migrazione e all'operatività in produzione. L'attenzione finale è sulla governance, perché la specifica dei file è solo una parte di una piattaforma dati enterprise.
Che cos'è un formato di tabella aperto e come funziona
Immaginate un data lake grezzo come un magazzino pieno di scatole etichettate. I file Parquet sono le scatole, le cartelle sono aree di stoccaggio approssimative e un motore di query è un addetto che cerca le scatole che potrebbero contenere una risposta. Senza un inventario affidabile, l'addetto può cercare troppo, perdere file rilevanti o combinare scatole provenienti da consegne incompatibili.
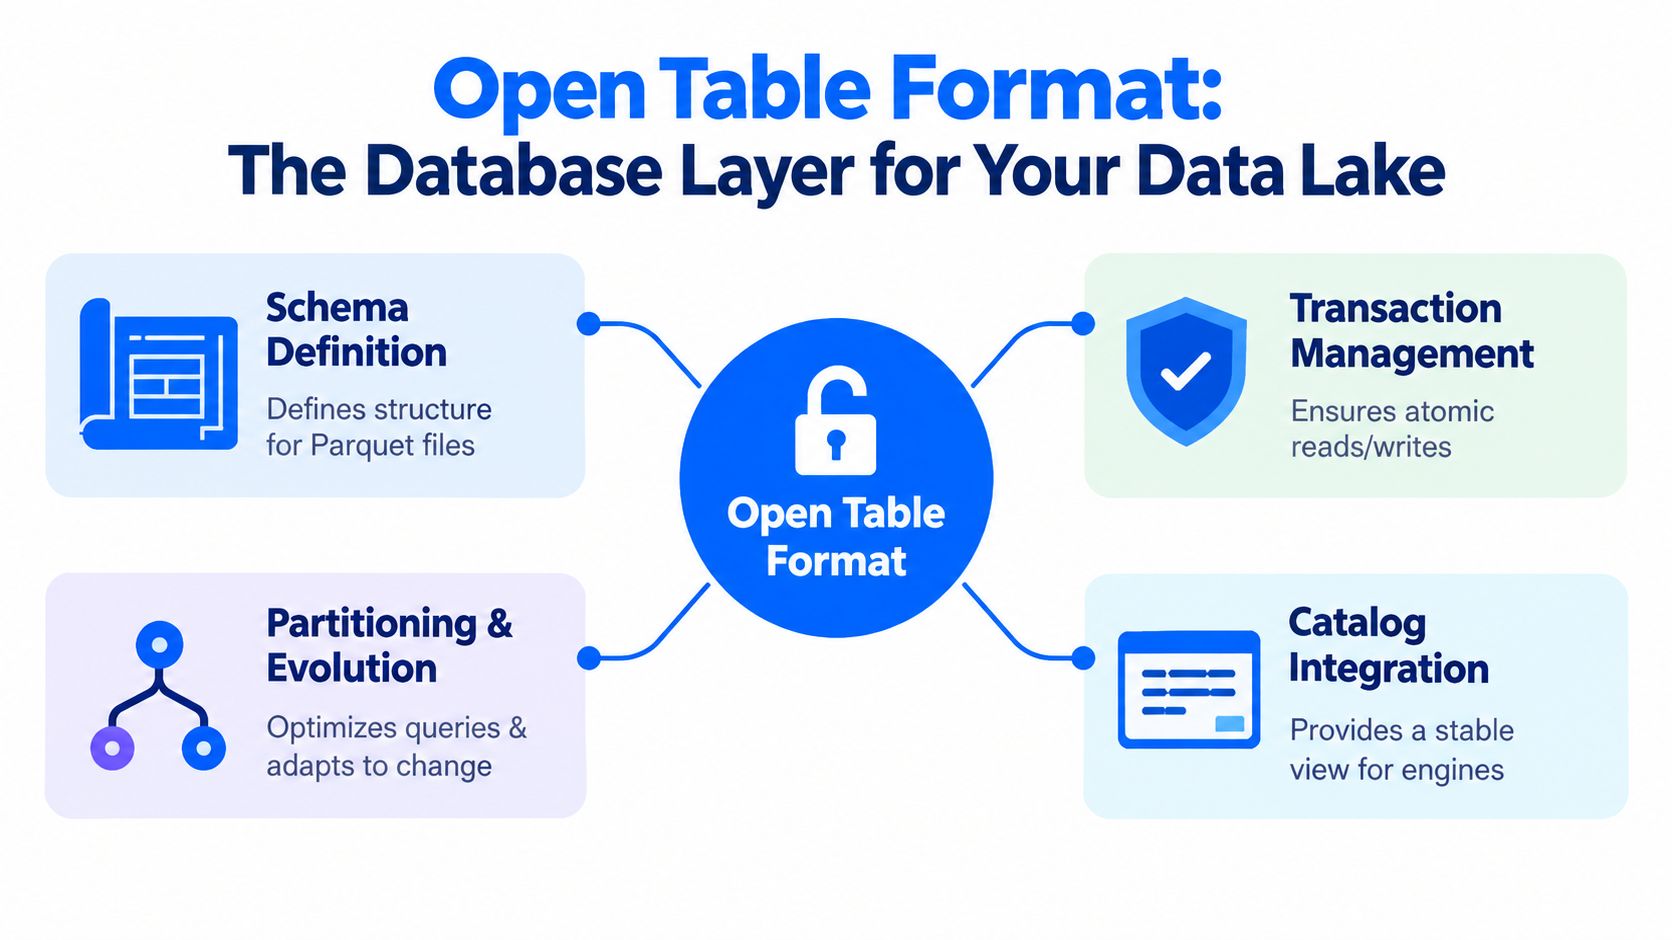
Un formato di tabella aperto aggiunge quell'inventario e un insieme di regole. Di solito prevede tre livelli collegati:
I file di dati contengono i record veri e propri, di solito in formati colonnari come Parquet.
I metadati della tabella descrivono schemi, snapshot, file, statistiche e informazioni sulle partizioni.
Un catalogo offre ai motori un modo stabile per trovare i metadati correnti della tabella e applicare le policy di accesso.
Questo terzo livello è facile da sottovalutare. Il formato definisce come viene rappresentato lo stato della tabella, mentre il catalogo definisce come i motori individuano quello stato. Un job Spark, una pipeline Flink e una query Trino possono lavorare sulla stessa tabella solo se riescono a risolverla attraverso un catalogo compatibile e a interpretare la versione del formato pertinente.
Dai file a una tabella gestita
Supponiamo che una pipeline riceva record di vendita. Scrive file di dati Parquet su un object storage, ma non li colloca in una cartella per data sperando che ogni lettore ne comprenda il layout. Iceberg registra i file nei manifest, li associa a uno snapshot della tabella e pubblica un nuovo stato dei metadati attraverso il catalogo.
Un lettore individua prima lo stato corrente della tabella. Usa poi i metadati per pianificare la scansione, selezionando solo i file che potrebbero contenere record corrispondenti. È diverso dal chiedere al motore di elencare ogni oggetto e ispezionare ogni file.
La parola aperto non si riferisce solo al codice open source. Un formato di tabella aperto punta a fornire una specifica documentata che più motori possono implementare. La specifica di Iceberg è passata attraverso versioni formali. La documentazione Apache afferma che le versioni 1, 2 e 3 sono complete e adottate dalla community, mentre la versione 4 è ancora in fase di sviluppo attivo. La documentazione indica inoltre la 1.11.0 come versione più recente della documentazione nel 2026, a conferma del continuo investimento nel progetto, come si vede nella specifica e documentazione di Iceberg.
L'apertura riduce la dipendenza da un unico motore di query, ma non elimina automaticamente i comportamenti specifici dei fornitori. Lettori e scrittori devono comunque supportare funzionalità compatibili, e il catalogo può applicare policy, credenziali o regole di governance proprie. Questa distinzione diventa centrale quando più motori condividono tabelle di produzione.
Dentro l'architettura del formato di tabella aperto Iceberg
L'architettura di Iceberg si capisce più facilmente partendo dal catalogo e scendendo. Il catalogo punta al file di metadati corrente. Quei metadati identificano lo snapshot attivo e collegano la tabella a una o più manifest list. Le manifest list puntano ai file manifest, e i manifest descrivono i file di dati disponibili per lo snapshot.

Seguire la lettura di una tabella
Una lettura semplificata si presenta così:
Il motore chiede al catalogo la posizione dei metadati correnti della tabella.
Il file di metadati identifica lo snapshot corrente.
Lo snapshot fa riferimento a una manifest list.
La manifest list identifica i file manifest.
Il motore valuta le voci dei manifest e legge i file di dati idonei.
I dati veri e propri restano in file come Parquet. Per chi desidera una spiegazione separata del formato di storage sottostante, questa guida a Parquet offre un utile contesto. Il contributo di Iceberg è l'organizzazione a livello di tabella attorno a quei file.
I manifest memorizzano i valori di partizione dei file di dati. Quando una query include un predicato, il motore può confrontarlo con le tuple di partizione e scartare i file che non possono corrispondere. Questo è il pruning guidato dai metadati. Il motore spende meno risorse ad aprire file irrilevanti e il processo di pianificazione non dipende dall'interpretazione manuale dei nomi delle directory.
Iceberg supporta anche il partizionamento nascosto. Un producer può scrivere un timestamp mentre la tabella applica internamente una trasformazione di partizione, ad esempio estraendo una data o troncando un valore. Producer e consumer non devono gestire direttamente una colonna di partizione separata, il che riduce gli errori causati da espressioni di partizione incoerenti.
Perché gli snapshot sono importanti
Ogni scrittura crea un nuovo snapshot. Un lettore risolve un singolo snapshot e pianifica su quello stato coerente, invece di osservare una tabella mentre vengono aggiunti o rimossi file. Questo design supporta l'isolamento degli snapshot e modifiche della tabella serializzabili e atomiche, così che i lettori non vedano scritture parziali o non confermate.
Il modello a snapshot consente anche il time travel. Un analista che indaga su una discrepanza in una dashboard può interrogare uno stato precedente della tabella, purché gli snapshot e i file pertinenti siano ancora disponibili. Questo rende l'indagine storica più precisa rispetto all'uso di estrazioni copiate o di cartelle conservate manualmente.
La documentazione sulle prestazioni di Apache Iceberg osserva che l'architettura dei metadati può consentire di leggere anche tabelle da più petabyte da un singolo nodo, senza richiedere un motore SQL distribuito solo per scorrere i metadati della tabella. La stessa documentazione cita casi con un miglioramento delle prestazioni di 10 volte, come descritto nella documentazione sulle prestazioni di Iceberg. La lezione pratica è che il design dei metadati può influire sul costo di pianificazione tanto quanto il layout dei file influisce sul costo di scansione.
Garanzie transazionali, evoluzione dello schema e strategie di partizionamento
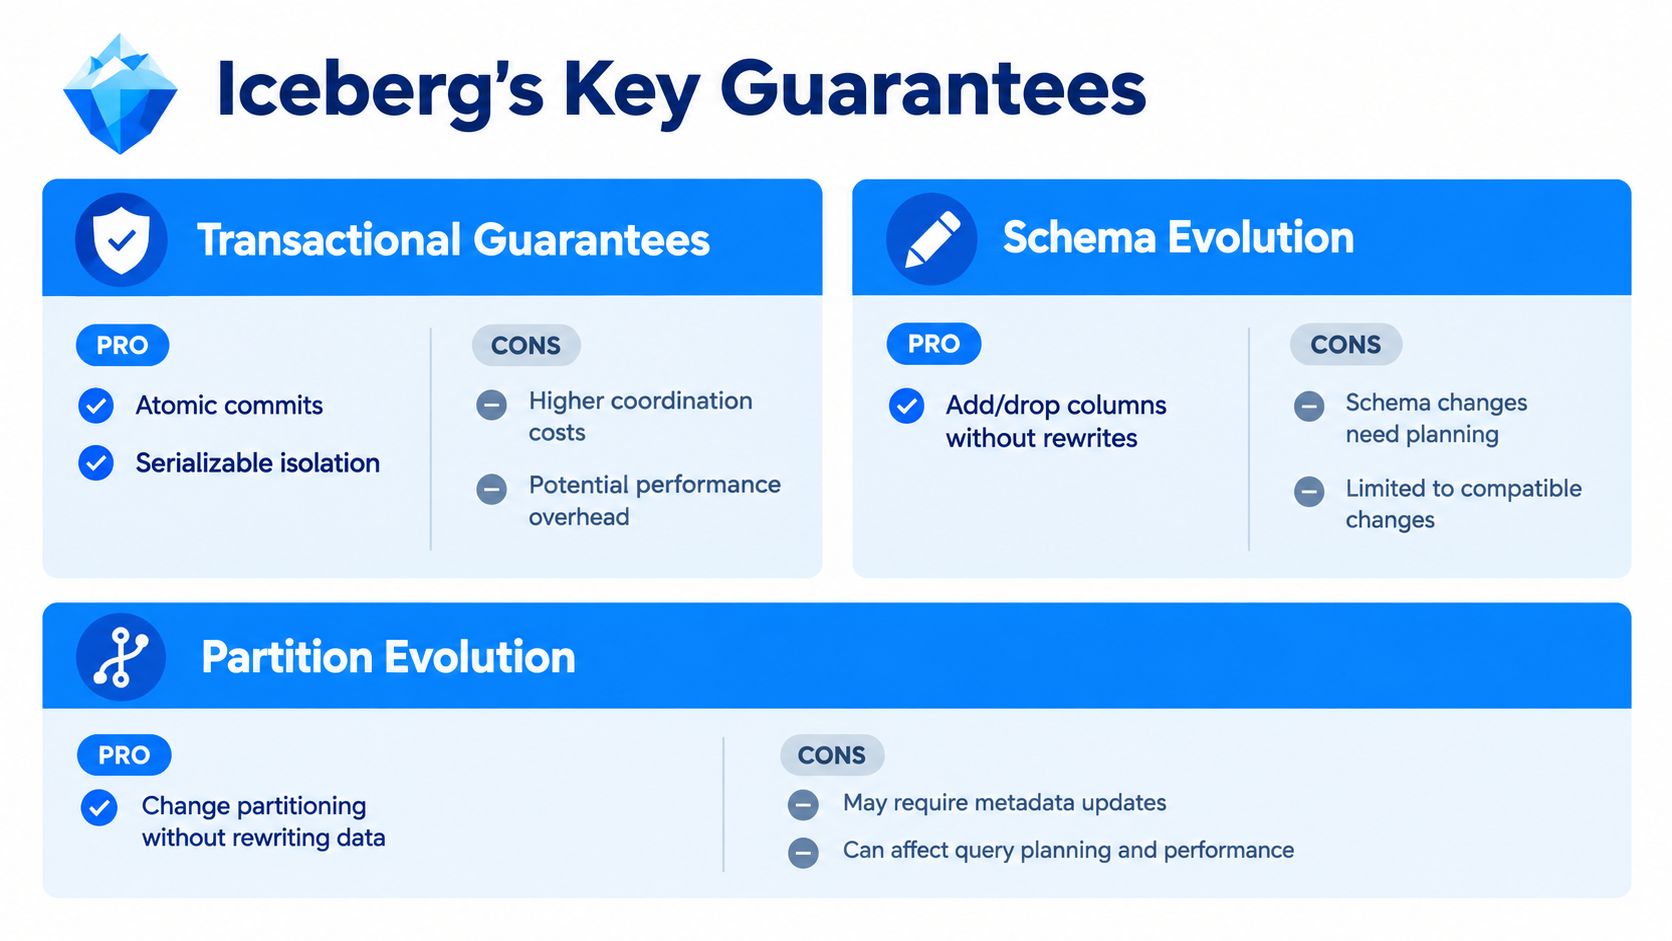
Il valore di Iceberg diventa più chiaro quando una tabella cambia mentre persone e pipeline continuano a usarla. Uno scrittore non pubblica uno stato della tabella a metà. Prepara un nuovo snapshot e lo conferma in modo atomico. I lettori continuano a vedere lo snapshot confermato precedente finché quello nuovo non diventa visibile.
Questo offre ai team l'isolamento degli snapshot e modifiche della tabella serializzabili. Gli scrittori concorrenti hanno comunque bisogno di una strategia per i conflitti, e un commit fallito può richiedere una logica di retry, ma i lettori non combineranno per errore una scrittura incompleta con uno stato precedente della tabella.
Modifiche che evitano di riscrivere i dati
Iceberg supporta operazioni di evoluzione dello schema come aggiungere, eliminare, rinominare e riordinare colonne senza riscrivere i file di dati esistenti. I metadati tengono traccia dello schema logico, quindi rinominare una colonna non significa necessariamente riscrivere fisicamente ogni file storico.
Questa capacità non elimina la necessità di disciplina. Un campo rinominato può comunque confondere gli strumenti a valle che identificano le colonne per nome, e un campo eliminato può influire su report o modelli. I controlli di compatibilità dello schema e le notifiche ai consumer restano importanti, soprattutto quando motori diversi supportano le funzionalità del formato a livelli diversi. Un sistema di tracciamento degli schemi come digna Schema Tracker può affiancare la tabella e individuare le modifiche strutturali prima che diventino incidenti a valle.
L'evoluzione delle partizioni segue un principio simile. Iceberg tratta la modifica di una specifica di partizione come un'operazione sui metadati. I vecchi file restano nel loro layout esistente, mentre i nuovi file usano la specifica aggiornata. I team possono adattare il partizionamento a nuovi modelli di accesso senza riscrivere l'intera tabella storica né metterla offline.
Scegliere con attenzione il partizionamento nascosto
Il partizionamento nascosto è utile quando i team vogliono un'organizzazione fisica senza esporre i meccanismi di partizione a ogni producer. Un campo timestamp può supportare il pruning per data senza richiedere che ogni job di ingestione popoli correttamente una colonna di partizione corrispondente.
C'è un compromesso. Dopo un'evoluzione delle partizioni, una tabella può contenere file scritti con specifiche diverse. Iceberg è in grado di pianificare su tutto questo storico, ma gli operatori devono comunque monitorare se layout vecchi e nuovi producano un comportamento di scansione disomogeneo. Le modifiche alle partizioni dovrebbero seguire i modelli di query osservati, non sostituire la comprensione di come il carico di lavoro accede ai dati.
Eliminazioni a livello di riga
Il formato Iceberg v2 supporta le eliminazioni a livello di riga tramite file di eliminazione separati, anziché riscrivere interi file di dati. Le eliminazioni posizionali identificano una riga tramite il percorso del file e la posizione della riga. Le eliminazioni per uguaglianza identificano le righe in base a valori di colonna corrispondenti, il che può supportare flussi di aggiornamento ed eliminazione con una minore amplificazione delle scritture, come descritto in questa spiegazione delle eliminazioni a livello di riga in Iceberg.
I file di eliminazione introducono considerazioni di manutenzione. Le query possono dover unire i dati di base con le informazioni di eliminazione, e le operazioni di compattazione o riscrittura possono successivamente consolidare il layout. Il formato riduce l'onere immediato di riscrittura, ma non elimina la gestione del ciclo di vita.
Iceberg, Delta Lake e Hudi a confronto per il vostro lakehouse
Iceberg, Delta Lake e Hudi affrontano tutti il divario tra file di dati non gestiti e un comportamento delle tabelle simile a quello di un database. La scelta giusta dipende dal carico di lavoro, dai motori, dalla strategia di catalogo e dai servizi operativi che il vostro team è pronto a gestire.
Criterio | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Ambito principale | Tabelle analitiche multi-motore e interoperabilità aperta | Forte allineamento con l'ecosistema Databricks | Carichi lakehouse con molti aggiornamenti e orientati allo streaming |
Modello dei metadati | Architettura con snapshot, manifest list e manifest | Design incentrato sul transaction log | Design orientato alla timeline e ai table service |
Evoluzione dello schema | Supporta modifiche come aggiunta, eliminazione, ridenominazione e riordinamento | Supporta l'evoluzione dello schema, con un comportamento che dipende dal runtime e dal supporto delle funzionalità | Supporta ampie capacità di evoluzione dello schema |
Strategia di partizionamento | Partizionamento nascosto ed evoluzione delle partizioni solo a livello di metadati | La gestione delle partizioni dipende dalla configurazione della tabella e della piattaforma | Usa partizionamento più clustering e table service |
Modifiche alle righe | File di eliminazione v2, con eliminazioni posizionali e per uguaglianza | Aggiornamenti ed eliminazioni tramite operazioni Delta | Forte supporto per upsert, eliminazioni e flussi incrementali |
Scelta del motore | Progettato per un'ampia interoperabilità tra motori | Particolarmente naturale nei deployment Databricks | Forte integrazione con Spark e lo streaming, con un supporto più ampio dell'ecosistema |
Ruolo del catalogo | Il catalogo è centrale per discovery e governance | Catalogo e servizi di piattaforma influiscono molto sull'apertura | Il catalogo può essere meno centrale per il funzionamento di base della tabella, ma la governance richiede comunque servizi di contorno |
Queste descrizioni sono indicazioni architetturali, non un benchmark universale. La velocità delle query dipende da dimensione dei file, distribuzione dei dati, ordinamento, compattazione, versioni dei motori, forma del carico di lavoro e implementazione del catalogo. Un team di piattaforma dovrebbe testare letture e scritture rappresentative invece di scegliere solo in base a una lista di funzionalità.
Adattate il formato al modello operativo
Scegliete Iceberg quando più motori devono condividere le tabelle e il team apprezza uno strato di tabella ampiamente specificato, con partizionamento nascosto ed evoluzione indipendente. Scegliete Delta Lake quando l'integrazione profonda con Databricks, i servizi nativi della piattaforma e un modello operativo unificato con un solo fornitore contano più di una maggiore neutralità del catalogo.
Hudi merita considerazione quando il design è guidato da aggiornamenti frequenti, change capture, elaborazione incrementale o ingestione in streaming. Il suo approccio include capacità di storage engine e di gestione delle tabelle che possono influenzare il modo in cui la piattaforma gestisce indicizzazione, compattazione e ingestione.
La domanda più importante spesso si trova al di fuori della specifica dei file. Un team di governance ha bisogno di un unico luogo in cui gestire namespace, responsabilità, classificazione, permessi e storico di audit. Iceberg fornisce transazioni e metadati delle tabelle, ma da solo non offre un sistema completo di policy tra motori diversi. I team che valutano Iceberg insieme a carichi di lavoro Databricks possono consultare anche le considerazioni sulla qualità dei dati in Databricks, in particolare dove i controlli della piattaforma incontrano i processi di affidabilità dei dati.
Integrazioni con l'ecosistema, modelli di migrazione e flussi di lavoro di esempio
Iceberg si inserisce in un lakehouse attraverso due interfacce: storage e catalogo. Spark o Flink possono produrre i dati, Trino o Hive possono interrogarli e un object storage può contenere i file. Il catalogo collega queste attività a un'unica identità della tabella ed espone i metadati necessari a ciascun motore compatibile.
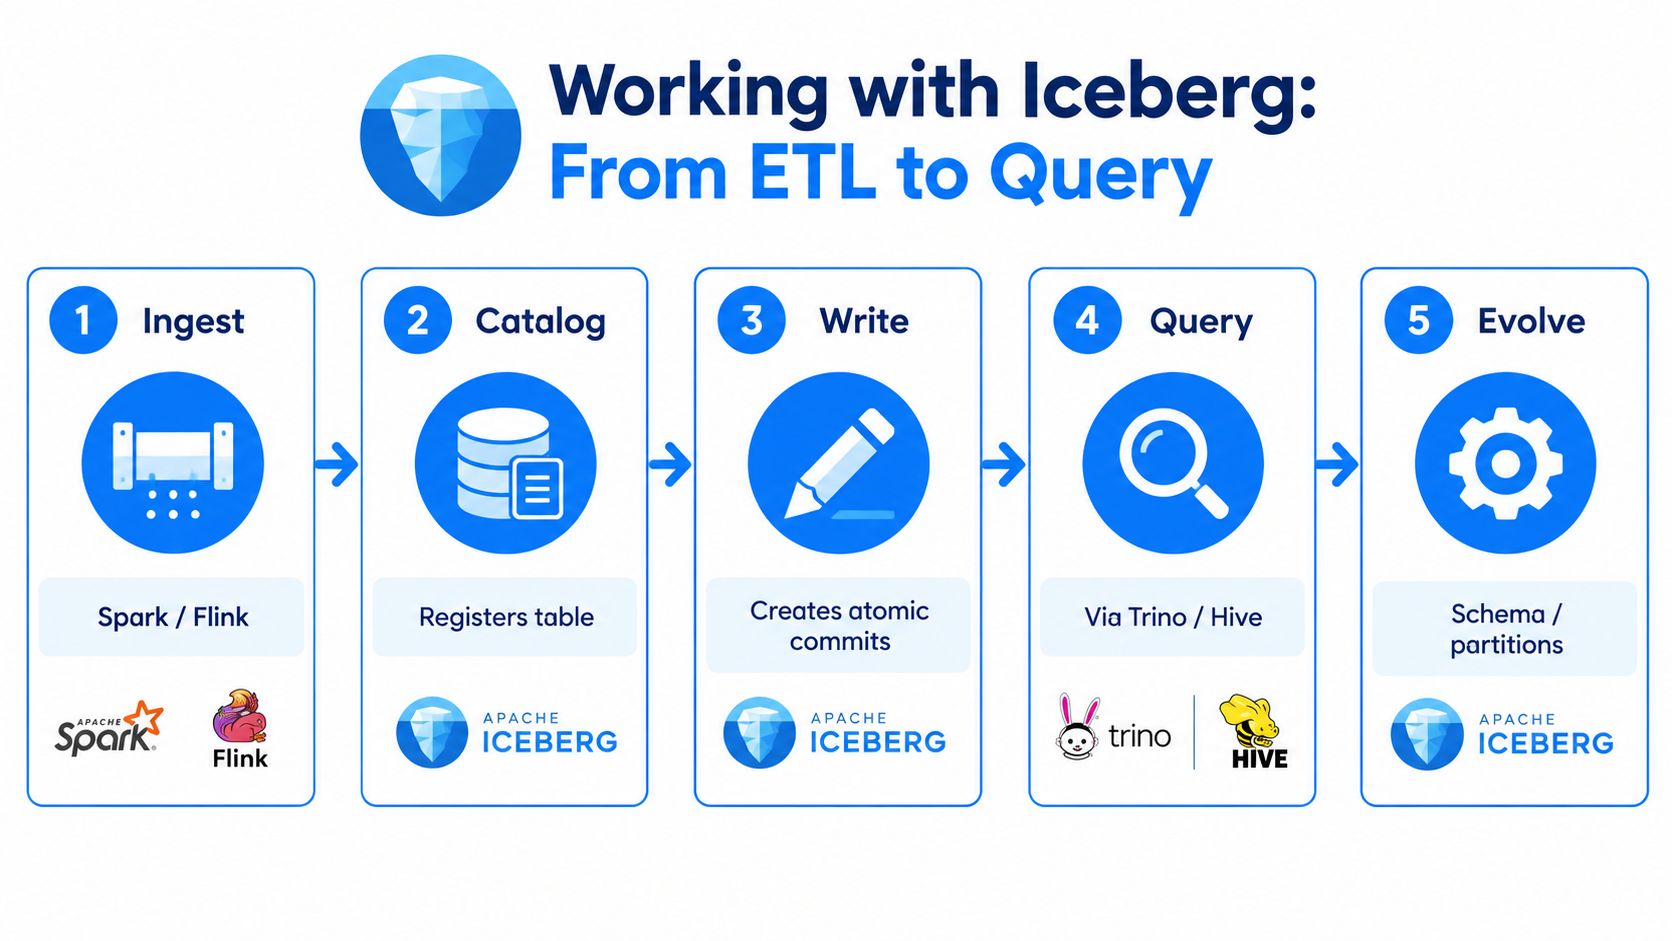
Un flusso di lavoro tipico si presenta così:
Ingestione: Spark o Flink ricevono record in batch o in streaming.
Catalogo: la tabella viene registrata tramite un catalogo come Hive Metastore, AWS Glue Catalog o un catalogo REST di Iceberg.
Scrittura: il motore crea i file di dati e pubblica uno snapshot atomico.
Query: Trino, Hive, Spark o un altro motore compatibile risolve la tabella tramite il catalogo.
Evoluzione: il responsabile modifica lo schema o la specifica di partizione man mano che il carico di lavoro si sviluppa.
La sintassi esatta varia da motore a motore, ma i concetti restano stabili. Un flusso SQL potrebbe creare una tabella con uno schema esplicito, inserire record, modificare una colonna e interrogare uno snapshot precedente. Un job Spark potrebbe usare l'interfaccia DataFrameWriterV2 di Iceberg, mentre Flink usa il proprio sink Iceberg e la configurazione del catalogo.
Migrare senza perdere il controllo
Una migrazione da Hive a Iceberg può seguire percorsi diversi. I team possono convertire i dati esistenti e registrarli tramite i metadati di Iceberg, oppure riscrivere i file per migliorare il layout, normalizzare gli schemi ed eliminare vecchie ipotesi sulle partizioni. La conversione dei metadati può ridurre l'interruzione, mentre una riscrittura offre l'occasione di ottimizzare i file di dati. La scelta dipende dalle condizioni della tabella esistente e dalla tolleranza verso il lavoro di migrazione.
Una migrazione da Delta a Iceberg richiede la stessa cura, con un'attenzione aggiuntiva a storico delle transazioni, funzionalità non supportate, eliminazioni, colonne generate e dipendenze a valle. Un piano di migrazione dovrebbe censire lettori e scrittori prima di cambiare la titolarità della tabella. La guida alla pianificazione della migrazione dei dati può aiutare a organizzare dipendenze, validazione e decisioni di rollout.
Observability attorno alla tabella
Gli snapshot di Iceberg vi dicono quale stato della tabella è stato confermato. Non vi dicono se una sorgente ha consegnato i record attesi, se i valori di business sono plausibili o se la metrica chiave di una dashboard è uscita dal suo comportamento normale. Questi controlli appartengono al sistema di affidabilità dei dati che circonda la tabella.
Ad esempio, un team può validare le regole sui record dopo il commit di uno snapshot, monitorare l'orario di arrivo di ogni caricamento atteso, confrontare le metriche attuali con il comportamento storico e segnalare le modifiche di schema prima che i modelli di BI smettano di funzionare. I controlli possono essere eseguiti direttamente sulla tabella, senza copiare i dati sottostanti in un archivio di monitoraggio separato.
Best practice, ottimizzazione delle prestazioni e troubleshooting in produzione
L'operatività di Iceberg in produzione ruota attorno al mantenere in salute, insieme, metadati, file, snapshot e policy. Una tabella può restare corretta dal punto di vista transazionale e diventare al tempo stesso costosa da interrogare, perché contiene troppi file piccoli, snapshot obsoleti o layout sovrapposti derivanti da diverse specifiche di partizione.
Iniziate dalla gestione dei file. Monitorate la creazione di file piccoli, compattate i file compatibili e scegliete impostazioni di scrittura che producano dimensioni di file adatte ai motori che servono la tabella. La compattazione dovrebbe basarsi sulle evidenze del carico di lavoro. Una tabella usata per frequenti letture incrementali può richiedere un ritmo di manutenzione diverso da una tabella che serve scansioni analitiche occasionali.
I metadati meritano un monitoraggio dedicato. Tenete traccia della crescita dei manifest, della latenza di pianificazione, dell'accumulo di snapshot e degli schemi ricorrenti di commit falliti. Fate scadere gli snapshot in base ai requisiti di ripristino e di audit, poi eliminate i file orfani solo dopo aver verificato che nessuno snapshot attivo o processo esterno dipenda ancora da essi.
Regola operativa: la manutenzione non è semplice pulizia. Fa parte del design della tabella per le query e per il ripristino.
Il troubleshooting diventa più sistematico quando i sintomi vengono associati ai livelli:
Pianificazione lenta: esaminate il numero di manifest, la crescita dei metadati e il tempo di risposta del catalogo prima di dare la colpa al motore di query.
Scansioni lente: verificate l'efficacia del pruning, la dimensione dei file, la distribuzione dei dati e se le specifiche di partizione evolute creino layout disomogenei.
Record mancanti: confrontate la finestra di ingestione attesa con lo snapshot confermato e validate separatamente la consegna della sorgente.
Errori di schema: individuate lo scrittore che ha modificato lo schema, poi verificate la compatibilità dei lettori e le ipotesi a valle.
Conflitti di commit: esaminate gli scrittori concorrenti, il comportamento dei retry e i job di manutenzione che potrebbero contendersi la stessa tabella.
Crescita inattesa dello storage: esaminate snapshot conservati, file di eliminazione, scritture fallite e file di dati orfani.
Gli aggiornamenti del formato richiedono un piano di rollout. I cambi di versione di Iceberg sono opzionali tabella per tabella, quindi le tabelle più vecchie possono coesistere con quelle più recenti. Il sondaggio 2025 sull'ecosistema Apache Iceberg ha riportato che il 78,6% degli intervistati usa esclusivamente Iceberg tra i formati di tabella aperti, mentre uno studio indipendente sulle aziende ha riportato che il 58% usa Iceberg per analytics critiche per il business, il 95% lo usa o prevede di usarlo per AI/ML e il 79% sta spostando o prevede di spostare i dati rimanenti su Iceberg entro 12 mesi. Questi dati provengono dalla sintesi del sondaggio 2025 State of the Apache Iceberg Ecosystem e indicano uno slancio, non la prova che ogni organizzazione abbia risolto l'operatività con versioni miste.
Il prossimo tema di pianificazione è Iceberg v3, con funzionalità come row lineage, deletion vector e nuovi tipi logici. Testate insieme lettori e scrittori, definite criteri di compatibilità e aggiornate tabelle rappresentative prima di un rollout esteso. Il formato può essere aperto, ma un'infrastruttura può comunque accumulare un debito di affidabilità nascosto se cataloghi, motori e policy di governance evolvono a velocità diverse.
Il catalogo va scelto con la stessa cura. Iceberg fornisce comportamento ACID, evoluzione dello schema e time travel, mentre lineage, classificazione, controllo degli accessi e audit trail unificati dipendono dal catalogo e dallo stack di governance. Databricks ha annunciato la disponibilità generale di Managed Iceberg, Iceberg v3 e Foreign Iceberg in Unity Catalog il 28 maggio 2026, mentre Snowflake ha integrato Polaris in Horizon Catalog per l'interoperabilità REST con Iceberg, come descritto nei materiali della specifica di Apache Iceberg. Queste mosse dell'ecosistema rafforzano la decisione centrale: l'apertura tra motori diversi dipende non solo dai file della tabella, ma anche da chi controlla l'accesso ai metadati e l'applicazione delle policy.
digna gira all'interno del vostro ambiente e combina tracciamento degli schemi, monitoraggio della tempestività, validazione in-database, rilevamento delle anomalie e osservabilità della piattaforma dati attorno a tabelle e pipeline critiche. Visitate digna per scoprire come il vostro team può monitorare le analytics basate su Iceberg senza spostare i dati di produzione.
La maggior parte degli incidenti di Iceberg in produzione si rivela un problema di valori travestito da problema di metadati, quindi pianificate la gestione della qualità dei dati insieme alla migrazione.
Domande frequenti
Quale problema risolve Iceberg?
Impedisce che motori diversi siano in disaccordo su che cosa contenga una tabella. Senza un formato di tabella, un motore può leggere una directory prima che un batch sia completamente confermato, un altro può interpretare una partizione in modo diverso e un terzo può vedere ancora uno schema precedente, anche se ogni file coinvolto è perfettamente valido.
Come è strutturata una tabella Iceberg?
Iceberg mantiene una catena di metadati: una voce del catalogo punta a un file di metadati che descrive lo snapshot corrente, quello snapshot punta a una manifest list e i manifest elencano i file di dati con le relative statistiche. Ogni commit scrive nuovi metadati invece di modificare quelli vecchi, ed è questo che rende il rollback economico.
Iceberg supporta scrittori concorrenti?
Sì, tramite la concorrenza ottimistica. Ogni scrittore prepara le proprie modifiche e poi tenta di sostituire il puntatore ai metadati della tabella; se un altro commit è arrivato prima, lo scrittore riprova sul nuovo stato. Le scritture in conflitto sugli stessi file falliscono in modo esplicito invece di sovrascriversi a vicenda in silenzio.
Quali motori funzionano con Iceberg?
Spark, Trino, Flink, Dremio, Snowflake e BigQuery, tra gli altri, leggono Iceberg, anche se la copertura delle funzionalità varia: alcuni motori leggono ma non scrivono, e le funzionalità più recenti arrivano in modo disomogeneo. Verificate che le operazioni specifiche di cui avete bisogno siano supportate da ogni motore del vostro stack, non solo da quello con cui fate i test.
Che cosa va storto di solito con Iceberg in produzione?
File piccoli e snapshot non scaduti, in quest'ordine. Le scritture in streaming o in batch frequenti producono molti file di dati piccoli e una lunga catena di metadati, che rallenta la pianificazione finché compattazione e scadenza degli snapshot non vengono eseguite secondo una pianificazione. Nessuno dei due problemi compromette la correttezza, quindi il sintomo si manifesta come una latenza delle query in progressivo aumento.


