In-database processing: l'elaborazione dei dati nel database
|
7
min di lettura

L'in-database processing esegue analisi e monitoraggio direttamente all'interno del motore di database del cliente, così i dati restano dove sono e l'overhead di trasferimento scompare. Questo conta soprattutto quando il vostro data warehouse è grande, sensibile o entrambe le cose, perché la scelta non riguarda solo la velocità, ma il fatto che il controllo avvenga là dove i dati già risiedono.
Di solito è il lunedì mattina a rivelare per primo il punto debole. Una dashboard non si aggiorna, un report finanziario perde righe o un alert di freschezza scatta quando gli utenti di business si sono già accorti del problema, e la causa profonda è spesso la stessa: i dati hanno dovuto lasciare un sistema prima di poter essere analizzati in un altro.
Indice
Quando lo spostamento dei dati manda in crisi le vostre dashboard
Esecuzione in-database e workflow di estrazione e analisi a confronto
Come digna esegue l'osservabilità all'interno del vostro data warehouse
Casi d'uso di settore che richiedono l'affidabilità dell'in-database
Prendere la decisione: l'in-database è adatto al vostro stack?
Quando lo spostamento dei dati manda in crisi le vostre dashboard
Il problema di solito inizia senza preavviso. Un feed del data warehouse arriva in orario, il job di estrazione viene eseguito e il motore esterno riceve quella che sembra una copia pulita. Poi un ritardo a monte, una colonna malformata o un batch troppo grande fanno slittare i numeri quel tanto che basta perché la dashboard non corrisponda più a ciò che il business si aspetta.
È questo il fascino principale dell'in-database processing. Il motore di database svolge il lavoro dove i dati già si trovano, così i team evitano il passaggio di estrazione che aggiunge latenza, crea copie aggiuntive e amplia la superficie di sicurezza. Le ragioni storiche a favore di questo modello sono rimaste coerenti dalla metà degli anni '90, ma un'adozione più ampia è arrivata solo a metà degli anni 2000, quando l'analisi è passata dalle workstation esterne agli enterprise data warehouse e i database orientati alle colonne hanno reso praticabili la scansione e l'aggregazione direttamente nel data warehouse. La panoramica storica sull'in-database processing mostra chiaramente questo percorso.

Un buon esempio di dashboard aiuta a inquadrare il problema. Se la metrica che state osservando deriva già da tabelle del data warehouse, estrarre quelle tabelle verso un altro motore solo per controllare la freschezza o lo schema drift crea un secondo punto di errore. Per una rapida panoramica su come sono strutturate di solito le superfici di reporting, sfogliate gli esempi di dashboard GTM di Yalc e osservate come le metriche operative dipendano da dati sorgente puliti e aggiornati.
Regola pratica: se un controllo può fallire perché i dati hanno dovuto spostarsi, l'architettura sta già facendo più lavoro di quanto l'utente abbia chiesto.
Ecco perché le moderne piattaforme di osservabilità trattano sempre più il data warehouse stesso come luogo di esecuzione. Un motore separato può comunque essere utile, ma il costo di spostare dati regolamentati e ad alto volume spesso supera la comodità di un workflow esterno. I team che mantengono il calcolo vicino ai dati di solito ottengono un controllo migliore sulla governance ed evitano lo scomodo divario tra “la sorgente è a posto” e “la copia per il reporting è sbagliata”.
Se vedete già tabelle duplicate, dashboard in ritardo o un lavoro di riconciliazione che si ripete ogni mattina, il problema probabilmente non è la definizione delle vostre metriche. È il passaggio in più.
Per una modalità di errore correlata, leggete come la ridondanza dei dati crea anomalie nei sistemi di analisi e reporting, perché le copie duplicate spesso spiegano come mai un team si fida dei numeri e un altro no.
Come si è evoluto e come funziona l'in-database processing
L'architettura non è nata tutta in una volta. I sistemi di analisi in-database sono diventati rilevanti dal punto di vista commerciale a metà degli anni '90, poi si sono diffusi più ampiamente a metà degli anni 2000, quando i team di data warehouse hanno smesso di considerare l'analisi come qualcosa da fare su una workstation separata. L'idea chiave era semplice: mantenere i dati dove sono, ridurre gli spostamenti ed eseguire il lavoro statistico dove i dati già risiedevano.
Una tappa spesso citata in questa evoluzione è la conferenza Teradata Partners di Orlando, dal 18 al 22 settembre 2005, quando Thomas Tileston presentò l'idea di accelerare il data mining combinando SAS e Teradata all'interno del data warehouse. Quel momento fu importante perché trasformò un'ottimizzazione di nicchia in un modello enterprise. I database orientati alle colonne, progettati per analisi, data warehousing e reporting, resero l'approccio praticabile migliorando il modo in cui i sistemi scansionano e aggregano grandi dataset.

Dall'accelerazione del data warehouse all'analisi nativa nel database
I sistemi moderni oggi eseguono le elaborazioni direttamente all'interno del motore di database invece di estrarre i dati in memoria di lavoro. La documentazione di IBM afferma che operare sui dati nel database evita i problemi di sicurezza associati alla loro estrazione, e il progetto MADlib si descrive come una libreria basata su SQL di machine learning, data mining e statistica che gira su larga scala all'interno del motore di database, senza importazioni o esportazioni verso altri strumenti. Il punto architetturale è che l'analisi diventa una responsabilità del database, non di un componente accessorio.
Le funzioni analitiche in-database di Teradata hanno spinto ulteriormente questo modello verso un'ampia libreria, e una fonte citata riporta oltre 200 funzioni analitiche in un'architettura shared-nothing, tra cui profilazione, statistiche descrittive e campionamento. È questa ampiezza ad aver permesso al modello di sopravvivere oltre il primo tuning dei data warehouse e di diventare utile per operazioni fortemente orientate alla governance.
Il compromesso pratico rimane. Man mano che il database si fa carico di più logica, le prestazioni dipendono da pianificazione delle query, indicizzazione, località della memoria ed esecuzione vettorizzata. Un motore ben ottimizzato può trasformare tutto questo in un punto di forza, mentre uno mal configurato trasforma il lavoro in-database in un collo di bottiglia.
La storia è importante perché spiega perché non si tratta più di un esperimento. I team non stanno adottando un trucco ingegnoso, ma un modello di esecuzione maturo, già plasmato dai vincoli dei data warehouse su larga scala.
Se state confrontando i moderni modelli di storage ed esecuzione, che cos'è un open table format è una lettura complementare utile, perché il dibattito sullo storage aperto si sovrappone spesso alla questione di dove debba girare l'analisi.
Esecuzione in-database e workflow di estrazione e analisi a confronto
La domanda essenziale è dove debba avvenire il lavoro e quali effetti abbia questa scelta su sicurezza, latenza e complessità operativa.
Dimensione | In-database processing | Workflow di estrazione e analisi |
|---|---|---|
Spostamento dei dati | Il calcolo resta dove risiedono i dati, quindi gli spostamenti sono ridotti al minimo | I dati vengono copiati o esportati prima dell'analisi, il che aggiunge overhead di trasferimento |
Livello di sicurezza | I dati possono restare nell'ambiente del cliente, il che aiuta con i dataset regolamentati | Più copie e trasferimenti esterni creano una superficie di esposizione più ampia |
Profilo delle prestazioni | Dipende da pianificazione delle query, indicizzazione, località della memoria e comportamento del pushdown | Dipende dalla velocità di trasferimento, dallo staging e dal profilo di calcolo del motore esterno |
Uso ideale | Carichi di lavoro del data warehouse grandi, sensibili o sensibili alla latenza | Analisi leggere, esplorazioni ad hoc o sistemi che prevedono già esportazioni |
Rischio operativo | Può sovraccaricare la produzione se il motore viene spinto troppo | Può divergere dalla sorgente e creare verità obsolete o duplicate |
L'esecuzione in-database mantiene i dataset grandi o sensibili all'interno del system of record, così un altro motore non ha bisogno di leggerli attraverso la rete. Questo è importante negli ambienti enterprise in cui il data warehouse sorgente è già soggetto ad aspettative di governance, controllo degli accessi e audit. Il compromesso non è teorico. Il motore di database ha ora più lavoro da svolgere, quindi piani di esecuzione inefficienti, un'indicizzazione debole o un forte carico concorrente possono rallentare contemporaneamente i job di produzione e i controlli di osservabilità.
Le indicazioni di IBM sull'analisi in-database sono chiare: mantenere i dati nel database evita i problemi di sicurezza associati alla loro estrazione, ed è per questo che questo modello compare spesso negli ambienti regolamentati. Per un confronto pratico tra un'esecuzione in-database più sicura e le pipeline esterne, consultate il confronto tra esecuzione in-database e pipeline esterne.
Lo schema drift rende la differenza ancora più netta. Come la ridondanza crea anomalie nei sistemi di analisi e reporting spiega perché le copie aggiuntive creano spesso versioni contrastanti dello stesso fatto. Quando osservabilità, controlli di qualità o rilevamento delle anomalie girano al di fuori del data warehouse, i team spesso passano più tempo a riconciliare le copie che a risolvere il problema di fondo.
Dove vince di solito ciascun approccio
L'in-database vince quando i dati sono troppo sensibili per essere spostati, troppo grandi per essere copiati spesso o troppo importanti per non essere ispezionati subito dopo l'arrivo.
L'estrazione e analisi vince quando il dataset è piccolo, la logica è sperimentale o il data warehouse non dovrebbe sostenere un carico analitico aggiuntivo.
I modelli ibridi vincono quando la governance deve restare vicina al data warehouse, ma il lavoro esplorativo ha bisogno di un ambiente separato.
La ricerca basata su benchmark dei carichi di lavoro dei data warehouse misura tempi di risposta, throughput e costo totale. I benchmark in tempo reale verificano se un sistema è in grado di assorbire i flussi in ingresso senza ritardi. Questo è importante perché i controlli di osservabilità si comportano come carichi di lavoro del data warehouse sensibili alla latenza, non come job di reporting offline.
Come digna esegue l'osservabilità all'interno del vostro data warehouse
digna mantiene il calcolo delle metriche all'interno dei database del cliente, così i dati restano dove sono mentre la piattaforma li valuta. È l'impostazione giusta per i team che mettono la governance al primo posto, perché il livello di osservabilità non ha bisogno di copiare altrove i dati di produzione prima di poterne ispezionare freschezza, schema o comportamento.
Il modello operativo si concentra su cinque dimensioni: freschezza, volume, schema, distribuzione e lineage. Sono i meccanismi pratici alla base del monitoraggio del comportamento dei dati, non un semplice controllo sul superamento di una singola regola in un dato momento. Un data warehouse può sembrare sano in un batch e intanto presentare una deriva in un altro, quindi i controlli devono seguire i dati nel tempo.
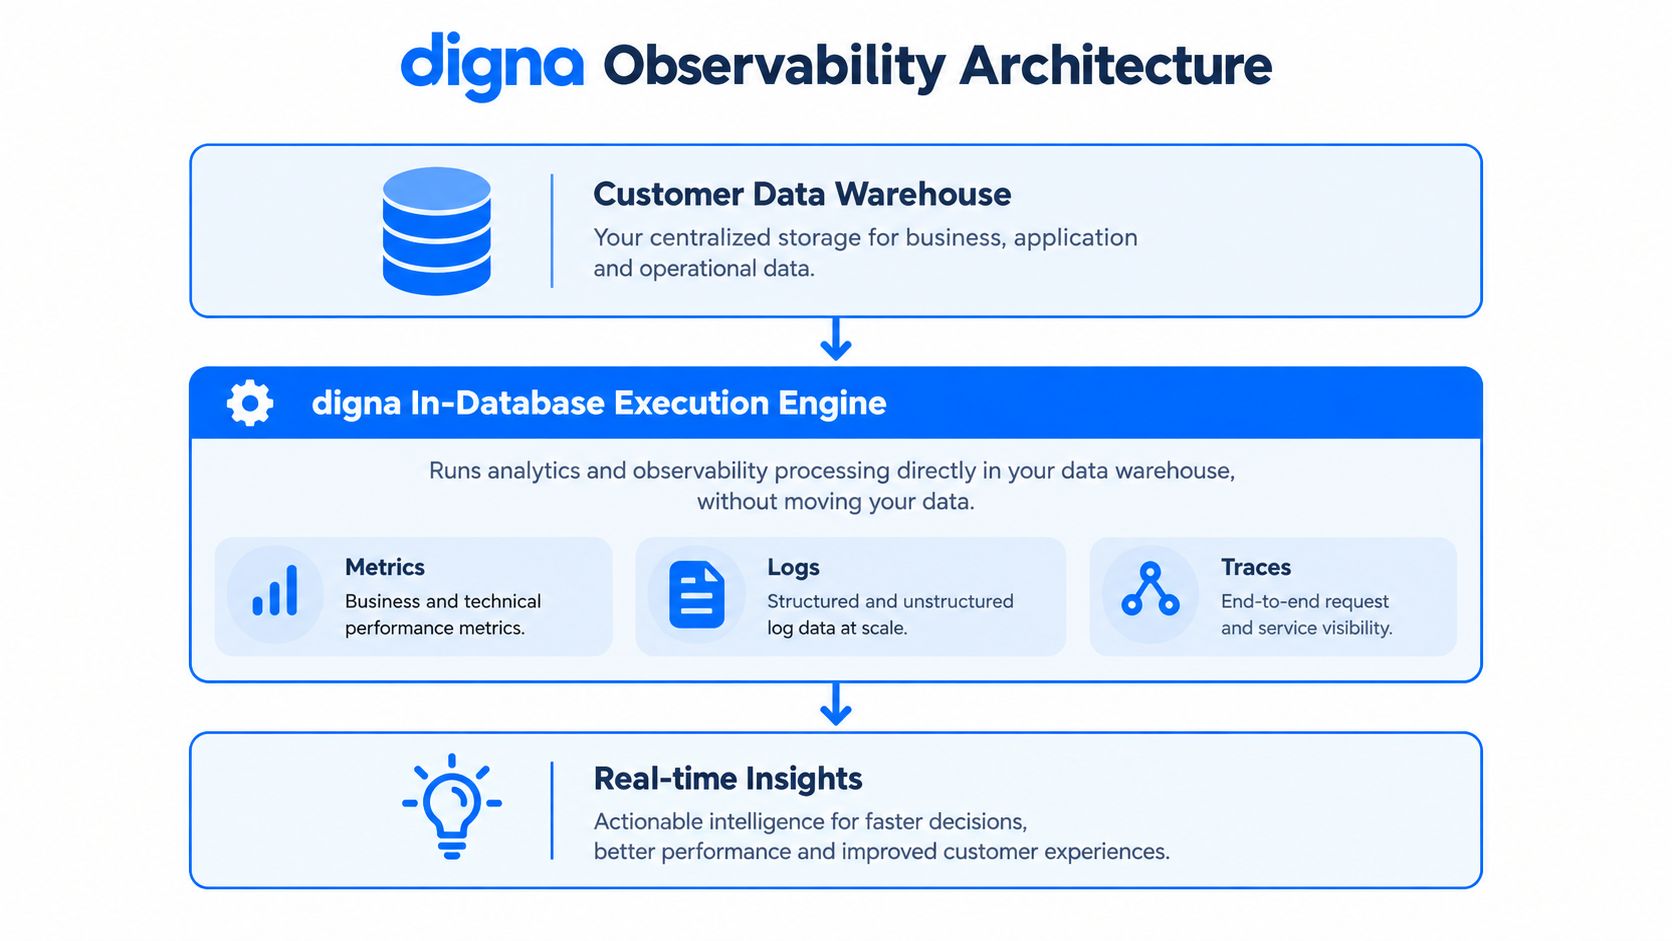
Che cosa succede all'interno del data warehouse
Il monitoraggio dello schema drift confronta lo schema in arrivo o dedotto con una baseline attesa o con uno schema contrattuale, quindi classifica aggiunte, rimozioni, ridenominazioni e modifiche dei tipi di dati per una gestione basata sulla gravità. Questo dettaglio è importante perché una colonna mancante e una colonna rinominata di solito non meritano la stessa risposta. Un alert rigido su ogni modifica crea rumore, mentre l'assenza totale di alert lascia esposti i sistemi a valle.
Il monitoraggio della tempestività verifica se i dati sono arrivati in orario, in anticipo o in ritardo, e il rilevamento delle anomalie apprende il comportamento dei dataset senza richiedere la configurazione manuale di regole per ogni caso. È questo passaggio da regole rigide all'apprendimento delle baseline a rendere il sistema praticabile su scala enterprise, soprattutto quando i feed variano in base al giorno, alla sorgente o al ciclo di business.
L'esecuzione in-database della piattaforma risponde bene anche a una domanda comune nelle aziende: come si monitorano freschezza e violazioni delle regole di business senza trasformare ogni incidente in un progetto di manutenzione costruito a mano? La risposta di solito è lasciare che il calcolo lo faccia il data warehouse e che il livello di osservabilità interpreti il pattern.
Regola operativa: se un monitor ha bisogno di continui aggiustamenti manuali solo per restare silenzioso, non è osservabilità, è alert fatigue con qualche passaggio in più.
La documentazione di digna descrive anche un modello di licenza modulare, con una tariffa base più un costo per tabella attiva per modulo. Questo tipo di struttura è importante dal punto di vista operativo, perché i team raramente hanno bisogno di tutte le funzionalità fin dal primo giorno: di solito partono da un problema e poi si estendono una volta che il modello ha dimostrato il suo valore.
Per i team che confrontano diversi stili di implementazione, i controlli sulla rimozione di OpenDatabase sono un utile esempio complementare di come l'ispezione lato data warehouse possa essere impostata come un'attività di audit controllata anziché come un'esportazione di dati verso l'esterno.
Il vantaggio pratico è semplice. Mantenete i dati nell'ambiente del cliente, calcolate le metriche dove i dati già risiedono e riducete il numero di punti in cui una copia obsoleta può diventare “la verità”.
Quando l'in-database processing non è la scelta giusta
Anche la configurazione in-database più solida ha dei limiti. Se il motore non riesce a pianificare bene la query, non può sfruttare la località della memoria o non può trarre vantaggio dall'esecuzione vettorizzata, il lavoro di osservabilità diventa un overhead sulla produzione invece che una protezione.
Le modalità di errore sono pratiche, non teoriche
La prima è la compatibilità. Non tutti i database espongono le stesse funzioni analitiche e non tutti gli ambienti consentono lo stesso livello di pushdown. Se la piattaforma non può eseguire i controlli necessari all'interno del motore, i team finiscono di solito per reintrodurre le esportazioni dalla porta di servizio.
La seconda è la contesa delle risorse. Un data warehouse che serve già BI e analisi ad hoc può essere rallentato se i job di osservabilità sono pianificati male o troppo costosi da eseguire in linea. Pianificazione delle query e indicizzazione sono decisive, e “tenerlo nel database” non significa mai “eseguire tutto immediatamente”.
La terza è l'eccesso di ambizione. Analisi leggere, indagini di breve durata o dataset a basso rischio spesso non giustificano il costo di configurazione. In questi casi, un workflow esterno più semplice può essere più facile da supportare e da dismettere in seguito, soprattutto quando i team hanno già una pipeline di dati ETL che sostiene il carico operativo.
Mantenete i controlli dove risiedono i dati solo quando il motore può assorbire il lavoro senza diventare esso stesso il problema.
Il compromesso per le aziende è chiaro. L'esecuzione in-database può ridurre gli spostamenti e aiutare i dati regolamentati a restare nell'ambiente del cliente, ma chiede anche di più allo stack di database. Se il team non riesce a controllare la forma delle query, la progettazione degli indici o l'isolamento dei carichi di lavoro, il modello può comunque fallire su larga scala.
La scelta non è ideologica. Si riduce alla capacità del data warehouse di assorbire il carico di monitoraggio senza creare nuovi colli di bottiglia, nuovo lavoro di tuning o nuove pressioni sui costi. Come già osservato, alcuni carichi di lavoro si gestiscono meglio all'interno del data warehouse, mentre altri risultano più puliti al di fuori.
Casi d'uso di settore che richiedono l'affidabilità dell'in-database
I settori regolamentati tengono a questo modello per lo stesso motivo: non possono permettersi una seconda copia della verità che diverge. I team di servizi finanziari, sanità, telecomunicazioni e settore pubblico gestiscono tutti dati sensibili, tracciabili o critici dal punto di vista dei tempi operativi, quindi il controllo deve avvenire senza spostamenti non necessari.
I team finanziari di solito devono ispezionare sul posto dati transazionali, di rischio e regolamentari. Se il processo di monitoraggio esporta i dati verso un altro ambiente, può entrare in conflitto con i requisiti di residenza dei dati, le aspettative di audit o i controlli interni. I team della sanità affrontano una pressione diversa: caricamenti in ritardo o modifiche dello schema possono distorcere il reporting clinico e operativo, e non è un problema che vorreste scoprire a posteriori.
I team delle telecomunicazioni gestiscono flussi costanti ad alto volume, quindi il rilevamento continuo delle anomalie deve funzionare senza il pesante collo di bottiglia delle esportazioni. I team del settore pubblico hanno bisogno di prove che i controlli stessi siano verificabili, il che rende interessante l'esecuzione in-database, perché la traccia del monitoraggio resta vicina all'ambiente governato.
Il vincolo comune a questi settori
Il filo conduttore non è il settore, ma la forma operativa dei dati. Ciascuno di questi ambienti ha bisogno di un monitoraggio abbastanza rapido da essere utile, abbastanza rigoroso da soddisfare la governance e abbastanza circoscritto da non creare nuove copie che si allontanano dalla sorgente.
Ecco perché la questione sicurezza contro complessità conta più della definizione. Se il carico di lavoro è sensibile, ad alto volume e strettamente legato alla compliance, l'esecuzione in-database diventa spesso la scelta pratica più che una preferenza architetturale. Se il carico di lavoro è occasionale o esplorativo, lo stesso approccio può creare più problemi di quanti ne risolva.
La tendenza recente nell'osservabilità va nella stessa direzione: trattare qualità dei dati e osservabilità come un unico problema di analisi centrato sul database, invece che come due attività separate. È utile perché la domanda centrale nelle aziende raramente è “Riusciamo a rilevare un problema?”, ma “Riusciamo a rilevarlo senza danneggiare il sistema che stiamo cercando di proteggere?”
Prendere la decisione: l'in-database è adatto al vostro stack?
Partite dai dati, non dallo strumento. Se il dataset è troppo sensibile per lasciare l'ambiente, troppo grande per essere spostato in modo efficiente o troppo vicino alla fonte di verità per tollerare ritardi, l'in-database processing merita una valutazione seria.
Poi verificate il carico di lavoro. Rilevamento delle anomalie in tempo reale, controlli di freschezza, monitoraggio dello schema drift e validazione delle regole di business traggono tutti vantaggio dall'esecuzione vicino alla sorgente dei dati. Se gli stessi controlli vengono eseguiti solo di tanto in tanto, o se sono esplorativi anziché operativi, la semplicità di un motore esterno può essere sufficiente.
Quindi mettete alla prova il motore stesso. Supporta le funzioni analitiche di cui avete bisogno? Può eseguire il pushdown in modo pulito? Può gestire l'osservabilità senza sottrarre risorse alle query di produzione? Queste domande contano più dell'etichetta di marketing, perché un database che non sa pianificare bene vi penalizzerà più rapidamente di un job esterno lento.
Una breve checklist decisionale
Scegliete l'in-database processing quando i dati sono regolamentati, il volume è elevato o la latenza è importante.
Preferite l'analisi esterna quando il carico di lavoro è leggero, temporaneo o ancora in evoluzione.
Validate il comportamento del motore prima del rilascio, in particolare piani di esecuzione, indicizzazione e isolamento dei carichi di lavoro.
Mantenete gli strumenti di BI esistenti dove già funzionano, perché l'esecuzione in-database non richiede di buttare via il resto dello stack.
L'equivoco più grande è pensare che l'esecuzione in-database sostituisca tutto il resto. Non è così. Cambia il luogo in cui avvengono i controlli, non l'esistenza di analisti, dashboard o applicazioni a valle. In pratica, le implementazioni migliori mantengono il data warehouse come fonte di verità, usano il motore di database per le ispezioni ad alta intensità di governance ed evitano di ricostruire un intero stack analitico solo per risolvere un problema di freschezza.
Se la vostra configurazione attuale passa più tempo a copiare i dati che a controllarli, probabilmente l'architettura vi sta remando contro. Se cercate una piattaforma che calcoli qualità e osservabilità all'interno dell'ambiente del cliente, mantenga i dati dove sono e supporti un monitoraggio modulare di anomalie, tempestività, validazione, modifiche dello schema e metriche di business, visitate digna e scoprite come il modello in-database si adatta al vostro data warehouse e ai vostri requisiti di governance.
Poiché è la compatibilità del motore a decidere se i controlli possono restare all'interno del database, l'elenco dei database e data warehouse con cui digna si integra è la prima cosa da verificare per il vostro stack.
Domande frequenti
Che cos'è l'in-database processing?
L'in-database processing esegue analisi e monitoraggio direttamente all'interno del motore di database, così i dati restano dove sono invece di essere estratti verso uno strumento esterno. Questo elimina l'overhead di trasferimento, evita copie aggiuntive e mantiene ridotta la superficie di sicurezza, il che conta soprattutto quando un data warehouse è grande, sensibile o entrambe le cose.
Quando l'in-database processing si è affermato?
L'analisi in-database è diventata rilevante dal punto di vista commerciale a metà degli anni '90 e si è diffusa ampiamente a metà degli anni 2000. Una tappa citata spesso è la conferenza Teradata Partners del settembre 2005, in cui fu presentata la combinazione di SAS e Teradata all'interno del data warehouse, mentre i database orientati alle colonne resero praticabili la scansione e l'aggregazione direttamente nel data warehouse.
Qual è la differenza tra in-database processing e workflow di estrazione e analisi?
L'in-database processing calcola dove risiedono i dati, mentre i workflow di estrazione e analisi copiano o esportano prima i dati verso un altro motore. Il primo è adatto a carichi di lavoro grandi, sensibili o sensibili alla latenza, ma può sovraccaricare la produzione; il secondo è adatto ad analisi leggere o ad hoc, ma può divergere dalla sorgente e creare verità duplicate.
Quando l'in-database processing non è la scelta giusta?
Fatica in tre situazioni indicate nell'articolo: lacune di compatibilità, quando il database non dispone delle funzioni analitiche o del pushdown necessari; contesa delle risorse, quando i job di osservabilità rallentano le query di BI; ed eccesso di ambizione, quando analisi leggere, di breve durata o a basso rischio non giustificano il costo di configurazione dell'esecuzione all'interno del motore.
Come usa digna l'in-database processing per la Data Observability?
digna mantiene il calcolo delle metriche all'interno dei database del cliente e monitora lì freschezza, volume, schema, distribuzione e lineage. I suoi controlli sullo schema drift confrontano la struttura in arrivo con una baseline attesa e classificano per gravità aggiunte, rimozioni, ridenominazioni e modifiche dei tipi, mentre il rilevamento delle anomalie apprende il comportamento dei dataset senza regole manuali.


