Diagramma dell'architettura dei dati: guida ai blueprint moderni
|
7
min di lettura

Una dashboard smette di funzionare cinque minuti prima della riunione del management. La finanza vede i ricavi di ieri. Le operations vedono valori null in una tabella di KPI giornaliera. Lo sviluppatore BI controlla Looker o Power BI, trova il sintomo, e a quel punto inizia il vero lavoro. Quale job di ingestion non è andato a buon fine? È cambiato un modello dbt? Qualcuno ha aggiunto una colonna a monte rompendo una trasformazione a valle? Il caricamento nel warehouse è stato completato ma è finito nello schema sbagliato?
Questa corsa contro il tempo è un'esperienza comune. La parte dolorosa non è solo il disservizio. È la mancanza di una mappa condivisa. Le persone conoscono pezzi del sistema, ma nessuno riesce a ricostruire l'intero percorso dalla sorgente alla dashboard senza aprire cinque strumenti e scrivere a tre team.
È qui che un diagramma dell'architettura dei dati smette di essere documentazione di facciata e diventa infrastruttura operativa. Un buon diagramma è il blueprint del vostro patrimonio di dati. Mostra come i dati entrano, dove arrivano, come cambiano, chi li consuma e dove un guasto rischia di danneggiare di più il business. Questo conta perché i motivi per cui i team costruiscono questi diagrammi sono per lo più legati al business, non decorativi. Nel report 2026 Trends in Data Architecture di Dataversity, Reporting & Business Intelligence è in testa con il 68,0%, seguito da Regulatory Compliance & Data Governance con il 59,2% e da Data Science & Discovery con il 52,7%.
Il compito del diagramma non è impressionare gli architetti. È prevenire dashboard rotte, accorciare la risposta agli incidenti, supportare la governance e mantenere affidabili i sistemi di analytics e di AI quando la piattaforma cambia sotto di loro.
Indice
Introduzione: molto più di linee e riquadri
Un diagramma dell'architettura dei dati debole di solito sembra affollato e non dice nulla. Ha riquadri per Snowflake, S3, Kafka, dbt e Tableau, tutti collegati da frecce che significano “qui succede qualcosa”. A colpo d'occhio può essere accurato, ma non vi aiuterà quando un report non si aggiorna o quando il team di compliance chiede dove si spostano i record sensibili.
Un diagramma solido si comporta piuttosto come la planimetria di una casa. Una planimetria non mostra solo che una casa ha delle stanze. Mostra la struttura, i flussi, i punti di accesso, gli impianti e i vincoli. Nel lavoro sui dati, questo significa sistemi sorgente, percorsi di ingestion, zone di storage, logica di trasformazione, layer di accesso e confini di ownership.
Regola pratica: se il vostro diagramma non aiuta un ingegnere reperibile a spiegare perché una dashboard si è rotta, non è finito.
L'altro errore è trattare il diagramma come un artefatto una tantum per una revisione dell'architettura. Le piattaforme reali non stanno ferme. Compaiono nuovi connettori SaaS. I data contract derivano. Una tabella di feature per il machine learning viene aggiunta in fretta per rispettare una scadenza e poi, alla fine, diventa critica per il business. Se il diagramma non evolve con questi cambiamenti, il team smette di fidarsene.
Questa perdita di fiducia causa danni concreti al business. I report rotti rallentano le decisioni. Una scarsa visibilità sulla lineage rende più lenta l'analisi delle cause. Le revisioni di governance diventano ricerche manuali tra i sistemi. Le iniziative di AI ereditano input instabili e falliscono in modi meno visibili rispetto alla BI. L'arte di disegnare diagrammi sta proprio al centro di questi risultati. Se fatta bene, offre agli ingegneri una mappa operativa condivisa e dà agli stakeholder di business la certezza che la piattaforma non si regga sulla conoscenza tacita di pochi.
Che cos'è un diagramma dell'architettura dei dati
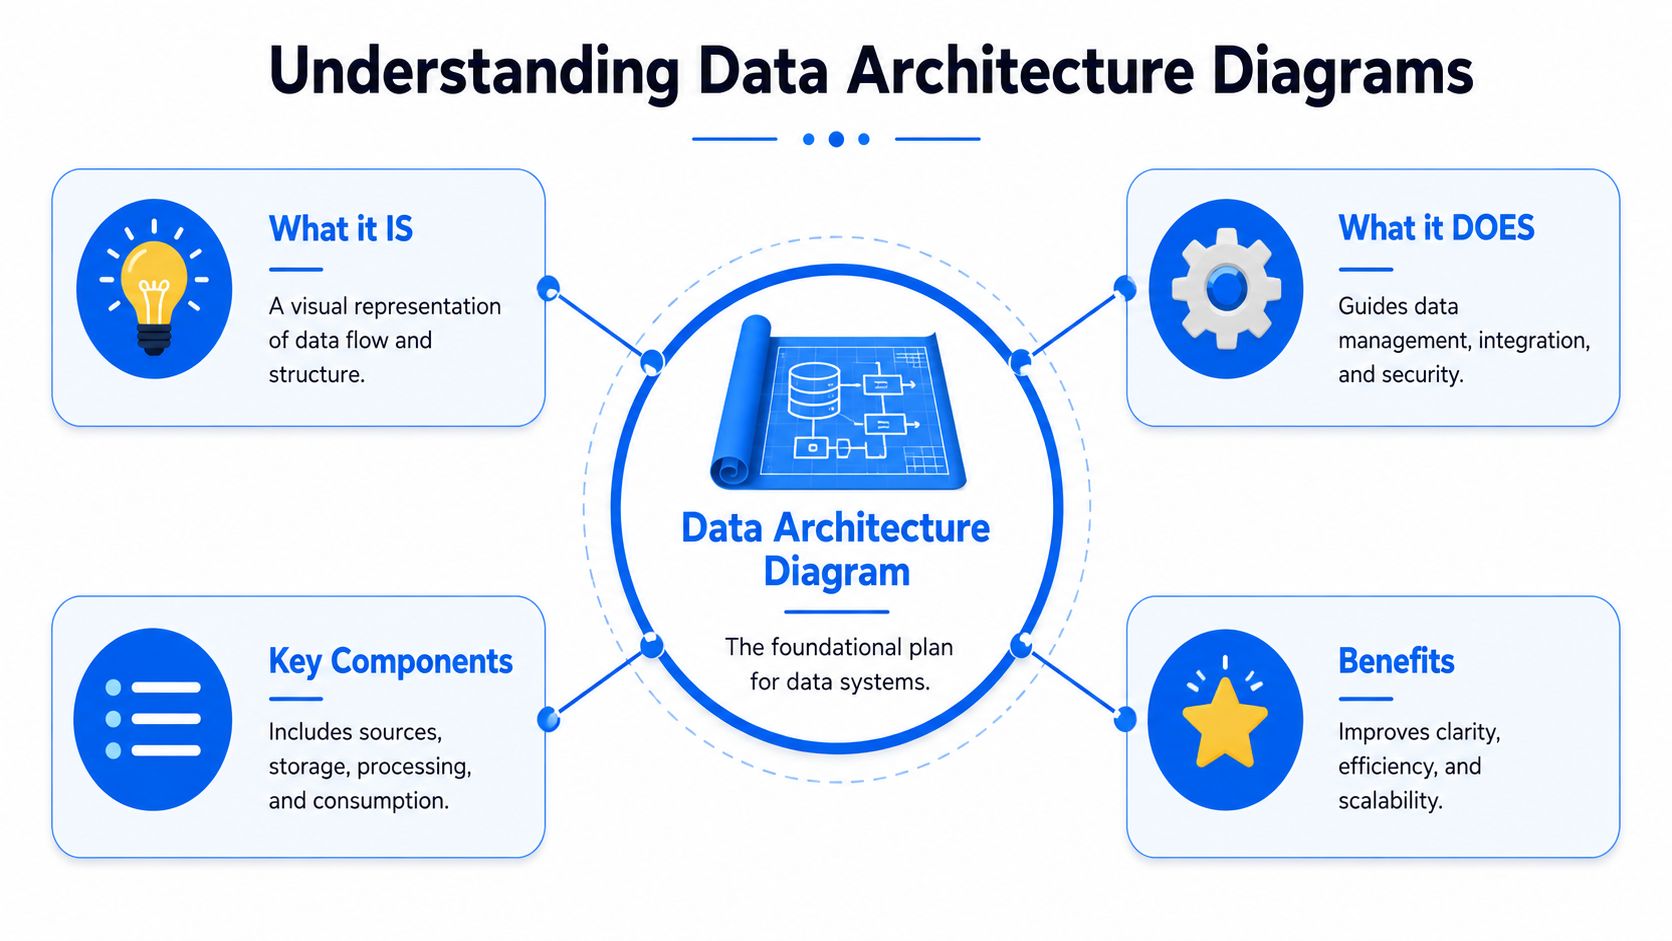
Un diagramma dell'architettura dei dati è una mappa visiva di come i dati si muovono all'interno di un'organizzazione. Il modello mentale più utile non è lo schema di un rack di server. È una pianta urbanistica. Una pianta urbanistica mostra strade, servizi, zone e il modo in cui le persone si spostano tra di esse. Il vostro diagramma dei dati dovrebbe mostrare dove nascono i dati, i percorsi che seguono, i luoghi in cui vengono archiviati, le regole che li modellano e le destinazioni in cui persone e applicazioni li utilizzano.
Una guida pratica di Instaclustr lo descrive come uno strumento di mappatura visiva che definisce il flusso end-to-end dalle sorgenti di ingestion agli endpoint di consumo, includendo sorgenti dati, layer di storage, processi di trasformazione e meccanismi di distribuzione. È la base giusta. Il valore nasce dal rendere queste relazioni abbastanza visibili da individuare colli di bottiglia, dipendenze nascoste e passaggi di consegne deboli.
Che cosa va inserito nel diagramma
Un diagramma utile di solito include questi elementi:
Sorgenti dati come applicazioni SaaS, database transazionali, stream di eventi, file flat, API e feed dei partner.
Layer di storage come una landing zone su object storage, un raw lake, un warehouse, data mart curati o un lakehouse.
Componenti di trasformazione come job ETL, pipeline ELT, modelli dbt, job Spark, layer di orchestrazione e fasi di validazione.
Endpoint di consumo come dashboard, notebook, destinazioni di reverse ETL, API interne e consumatori di feature ML.
Punti di controllo come confini di accesso, zone con dati sensibili, etichette di ownership e dipendenze operative.
Non vi serve ogni dettaglio implementativo in ogni diagramma. Vi serve la giusta quantità di verità per il pubblico a cui è destinato.
Perché i team ne hanno davvero bisogno
Il vantaggio più grande è la comprensione condivisa. Gli ingegneri usano il diagramma per ragionare sulle dipendenze. I team di analytics lo usano per capire perché una metrica affidabile si trova in una tabella e non in un'altra. I team di governance lo usano per tracciare dove si spostano i dati soggetti a controllo. I leader lo usano per verificare se la piattaforma supporta il reporting, i requisiti normativi e le ambizioni di AI senza dover chiedere a sei persone sei spiegazioni diverse.
Un diagramma si guadagna il suo posto quando riduce le discussioni durante gli incidenti e l'ambiguità durante la pianificazione.
Ecco perché “riquadri e frecce” non è un insulto, quando sono fatti bene. Un buon diagramma dell'architettura dei dati condensa la complessità in una forma che l'intera organizzazione può usare.
I layer comuni dell'architettura dei dati moderna
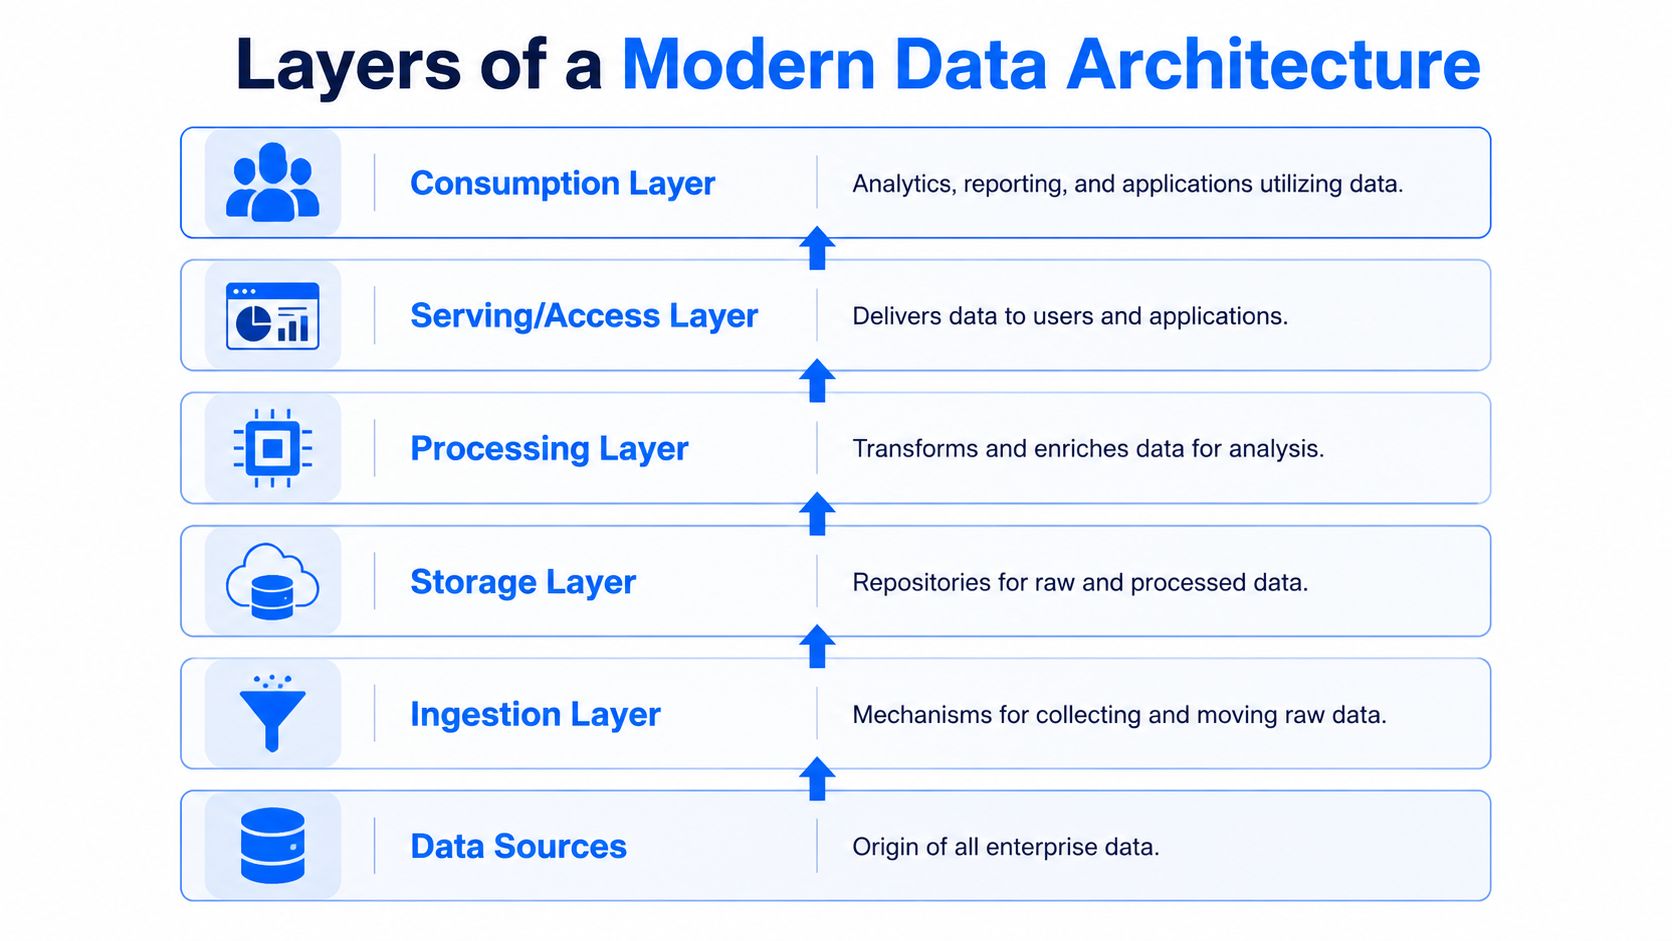
Le piattaforme moderne sono più facili da comprendere quando si smette di pensare in termini di strumenti e si inizia a pensare in termini di layer. Gli strumenti cambiano. I layer, di solito, no. Quando un team dice che il suo diagramma sembra caotico, il problema di fondo è spesso che sistemi sorgente, job di elaborazione, endpoint di serving e controlli di governance sono tutti disegnati sullo stesso piano visivo.
Sorgenti dati e ingestion
Alla base si trovano i sistemi che producono i dati. Tra questi ci sono database di prodotto, piattaforme CRM, sistemi ERP, processori di pagamento, file CSV inviati dai fornitori, stream di eventi dalle app e API esterne. Il diagramma dovrebbe distinguere tra sorgenti batch e streaming, perché generano aspettative operative molto diverse.
Il layer di ingestion si trova direttamente sopra di esse. Connettori, job personalizzati e stream processor prelevano o ricevono i dati all'interno di questo layer. Se una dashboard dipende dall'ingestion giornaliera da Salesforce, il diagramma dovrebbe mostrare chiaramente quella cadenza e quel passaggio di consegne. Se un caso d'uso antifrode consuma eventi tramite Kafka o un altro stream, non nascondetelo dietro la stessa freccia generica usata per un caricamento notturno di file.
Una regola pratica è etichettare il percorso di ingestion in base al metodo, non solo allo strumento. “Pull via API ogni ora”, “CDC da OLTP” e “file SFTP notturno” dicono al lettore molto più di un semplice logo del vendor.
Storage ed elaborazione
Lo storage è il punto in cui molti diagrammi diventano vaghi. I team disegnano un unico grande riquadro “piattaforma dati” e perdono le scelte architetturali che contano. Separate lo storage raw da quello raffinato. Separate l'object storage dai layer di serving analitico. Se usate sia un data lake sia data mart curati, mostrateli entrambi.
Se state decidendo come rappresentare queste zone, questo confronto tra data lake e data mart è utile perché rispecchia la distinzione pratica che gli architetti devono mostrare visivamente. I lake tendono a contenere dati più ampi e meno curati. I mart esistono per servire specifici domini analitici o gruppi di stakeholder. Quando un team li riduce a un unico riquadro di storage, i lettori non capiscono dove avviene la standardizzazione né dove iniziano i dati pronti per il business.
L'elaborazione si colloca tra storage e serving, anche se in alcune architetture avviene all'interno del warehouse o del lakehouse anziché in un ambiente di calcolo separato. Questo layer include trasformazioni SQL, workload Spark, job Python, orchestrazione e controlli basati su regole. La chiave è mostrare dove i dati raw diventano dati affidabili. Se non segnalate questa transizione, gli utenti di business daranno per scontato che ogni tabella della piattaforma sia ugualmente sicura da usare.
Serving e controlli trasversali
Il layer di serving espone i dati a strumenti di BI, API, applicazioni a valle, notebook e sistemi di ML. È il layer che gli utenti di business percepiscono. Se una dashboard del consiglio di amministrazione si rompe, il sintomo emerge in questo layer, anche se la causa si trova molto più in basso.
Trasversalmente a tutti questi layer, governance e osservabilità dovrebbero essere disegnate come capacità trasversali, non come una nota a piè di pagina. Controlli di accesso, ownership, zone di policy, lineage, controlli di freschezza e quality gate influenzano ogni fase. Se compaiono solo in una legenda in un angolo, i lettori li considerano facoltativi. Non lo sono.
Un diagramma a layer ben fatto include spesso queste convenzioni visive:
Layer orizzontali per separare sorgente, ingestion, storage, elaborazione, serving e consumo.
Frecce direzionali per mostrare il flusso dei dati e, dove utile, la tempistica o la modalità.
Marcatori di confine per domini, ambienti o zone di fiducia.
Etichette di ownership così che chiunque possa rispondere a “chi lo sistema?” senza lasciare la pagina.
Il risultato è un diagramma che funziona come una mappa del sistema anziché come un collage di vendor.
Tipi di diagramma e pattern architetturali più comuni
Un singolo diagramma dell'architettura dei dati raramente sopravvive al contatto con il lavoro reale. La versione usata in un comitato direttivo può sembrare perfettamente chiara ed essere comunque inutile alle 2 di notte, quando un job di ingestion si blocca e la dashboard delle vendite smette di aggiornarsi. I team migliori risolvono il problema disegnando per la decisione da prendere, e mostrando poi dove il sistema cambia nel tempo, non solo dove si trovano i dati.
Scegliete il tipo di diagramma prima dello strumento
La suddivisione pratica è tra concettuale, logico e fisico. Le indicazioni del Cloud Adoption Framework di Microsoft sui pattern di architettura dei dati si adattano bene a questa distinzione, perché collegano le viste architetturali alle scelte implementative e ai vincoli operativi, non solo allo stile di presentazione.
Tipo di diagramma | Pubblico | Livello di dettaglio | Scopo |
|---|---|---|---|
Concettuale | Dirigenti, responsabili di dominio, stakeholder della governance | Alto livello | Mostrare domini di business, flussi principali, ownership e forma strategica |
Logico | Architetti, responsabili analytics, ingegneri senior | Medio | Mostrare entità dati, movimenti, fasi di elaborazione e confini di dominio |
Fisico | Platform engineer, team di implementazione, operations | Dettagliato | Mostrare sistemi reali, schemi, job, interfacce e dipendenze rilevanti per il deployment |
Un diagramma concettuale racconta la storia di business. I dati dei clienti entrano dai sistemi di prodotto e operativi, passano attraverso piattaforme governate e poi raggiungono i casi d'uso di reporting, reverse ETL e ML.
Un diagramma logico mostra come funziona quella storia. Aggiunge modalità di ingestion, zone di storage, fasi di trasformazione, modelli semantici e confini di fiducia.
Un diagramma fisico mostra cosa può rompersi. Nomina il warehouse, l'object storage, lo strumento di orchestrazione, la piattaforma di streaming, gli schemi, le tabelle critiche e i controlli che fermano i dati errati prima che raggiungano la finanza o il feature store di un modello.
Se gli stakeholder continuano a chiedere più dettagli, spesso hanno bisogno di un diagramma diverso, non di uno più denso.
Come i pattern moderni cambiano il quadro
I pattern architetturali cambiano sia la forma del sistema sia le modalità di guasto che dovete mettere in evidenza. Un pattern con warehouse centralizzato ruota di solito attorno a modelli curati, controllo rigoroso e definizioni condivise. Un pattern lake mostra un'ingestion più ampia e molteplici percorsi di elaborazione. Un pattern orientato al mesh sposta l'attenzione sui confini di dominio, sui contratti e sui passaggi di ownership.
Se state modellando una ownership decentralizzata, questa introduzione a che cosa significa il data mesh nelle architetture moderne è utile, perché il diagramma smette di essere un unico riquadro di piattaforma centrale e diventa una mappa di data product di dominio con policy condivise e regole di interoperabilità.
I diagrammi lakehouse richiedono un'attenzione particolare. Nella pratica, i team spesso li disegnano in modo eccessivamente semplificato, come se un unico riquadro con l'etichetta "lakehouse" spiegasse il modello operativo. Non è così. Un diagramma lakehouse utile mostra dove lo storage aperto incontra le prestazioni in stile warehouse, dove vengono gestiti i metadati, come convergono i percorsi batch e streaming e dove i controlli di qualità bloccano i dati non affidabili. Senza questo dettaglio, il diagramma nasconde proprio i punti in cui di solito nascono dashboard rotte e feature di AI inaffidabili.
La scelta del pattern dovrebbe riflettere la realtà operativa:
Warehouse-first è adatto al reporting regolamentato, a metriche stabili e alla gestione centralizzata delle definizioni.
Lake-first è adatto a dati sorgente eterogenei, all'esplorazione di data science e alla conservazione dei dati raw a costi inferiori.
Lakehouse è adatto ai team che vogliono uno storage condiviso con più pattern di calcolo e self-service governato.
Orientato al mesh è adatto alle organizzazioni in cui i domini possiedono i data product e un team centrale non riesce a stare dietro a ogni richiesta.
Il compromesso non è mai astratto. La centralizzazione migliora la coerenza ma può rallentare la delivery. La decentralizzazione accelera le decisioni locali ma aumenta il costo di governance, interoperabilità e supporto.
I diagrammi statici falliscono in fretta nei sistemi dinamici
È questa la lacuna che molti diagrammi di architettura non colgono. Mostrano riquadri e frecce come se le pipeline girassero in uno stato stazionario, ma i sistemi di dati in produzione si comportano più come strade che come planimetrie. I volumi hanno picchi. Gli schemi derivano. Le API a monte rallentano. Gli obiettivi di freschezza vengono mancati. Un diagramma che ignora queste dinamiche diventa decorativo.
Un diagramma dei pattern migliore segnala il comportamento dinamico direttamente sulla pagina. Mostrate quali flussi sono batch e quali streaming. Segnate i quality gate prima delle zone affidabili. Etichettate i passaggi ad alto rischio, come la replica CDC, le API di terze parti e le pipeline di feature ML. Aggiungete semplici segnali di osservabilità come copertura della lineage, controlli di freschezza, confini degli SLA o ownership per la risposta agli incidenti.
Questo livello aggiuntivo mantiene il diagramma utile anche dopo la revisione dell'architettura. Aiuta un ingegnere a capire perché un KPI si è rotto, aiuta un analista a valutare se una tabella è sicura da usare e aiuta un team di ML a evitare di addestrare modelli su dati obsoleti o incompleti.
Il pattern giusto è quello che il vostro team è in grado di gestire in modo affidabile, spiegare con chiarezza e governare senza andare per tentativi.
Come creare il vostro diagramma dell'architettura dei dati passo dopo passo
La maggior parte dei diagrammi scadenti fallisce prima ancora che qualcuno disegni il primo riquadro. Si parte da uno strumento anziché da una domanda. Se non decidete per chi è il diagramma e quale decisione deve supportare, produrrete qualcosa che sembra completo e non aiuta nessuno.
Partite dal perimetro, non dal software
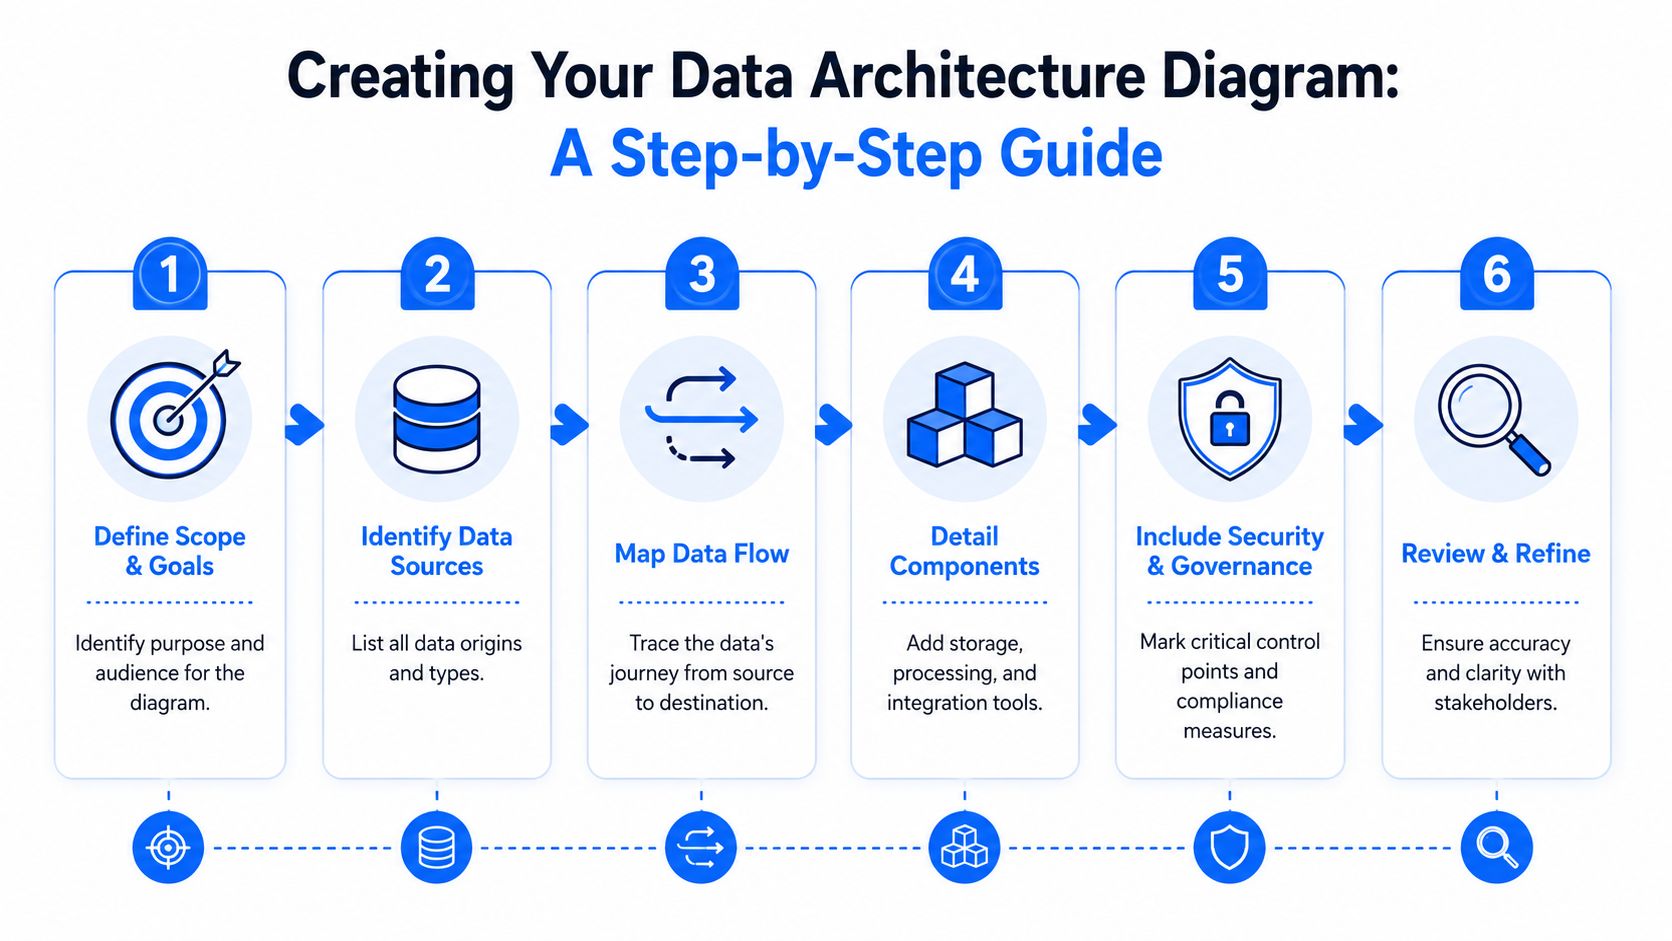
Iniziate dal perimetro. State mappando l'intera piattaforma aziendale, un dominio, una pipeline critica o una migrazione verso uno stato target? “Tutto” è quasi sempre troppo ampio per una prima versione utile.
Poi definite il pubblico. Un Head of Data vuole vedere ownership, capacità di business e rischi principali. Un platform engineer ha bisogno di pipeline, confini di storage e punti di guasto. Se mescolate entrambi i livelli in una prima bozza, finirete con il classico “diagramma onnicomprensivo” illeggibile.
Seguite questa sequenza:
Formulate la domanda a cui il diagramma deve rispondere. Ad esempio: “Perché questo KPI si rompe?”, “Come si muovono i dati regolamentati?” oppure “Cosa cambia nell'architettura target?”
Fissate il perimetro attorno a una piattaforma, un dominio o un flusso di lavoro.
Indicate il pubblico ed eliminate i dettagli che non userà.
Scegliete uno stile di notazione e rispettatelo. La coerenza batte sempre l'originalità.
Mappate il percorso che i dati seguono davvero
Una volta fissato il perimetro, fate l'inventario del percorso reale dei dati. Non affidatevi alla memoria. Attingete a orchestratori, schemi del warehouse, data catalog, viste di lineage di dbt, configurazioni dei connettori e ticket degli incidenti. L'architettura che le persone pensano di avere e quella che effettivamente gestiscono sono spesso diverse.
Mappate da sinistra a destra o dal basso verso l'alto, ma restate coerenti. Includete:
Sistemi sorgente con un contesto sufficiente a capirne il ruolo.
Meccanismi di ingestion e se sono batch, CDC, basati su eventi o su file.
Zone di landing e storage come raw, staged, curated e serving.
Fasi di trasformazione incluse orchestrazione e dipendenze chiave.
Endpoint di consumo inclusi dashboard, applicazioni a valle, flussi di lavoro di data science e API.
Etichettate i passaggi che generano rischio. Ad esempio, un file depositato da un fornitore esterno ha un profilo di affidabilità molto diverso da una replica CDC interna. Un feed Excel mantenuto manualmente merita un simbolo di avvertimento almeno nella vostra mente, anche se non fisicamente sulla pagina.
È anche il momento in cui una notazione standard aiuta. Le frecce dovrebbero indicare un flusso. I cilindri dovrebbero indicare lo storage. Le linee tratteggiate possono indicare metadati, controllo o dipendenze indirette. Se ogni stile di connettore significa ogni volta qualcosa di diverso, il lettore deve imparare il vostro linguaggio visivo personale prima di poter capire il sistema.
Una rapida panoramica può aiutare i team ad allinearsi su cosa significhi “abbastanza buono”:
Aggiungete i punti di controllo e rivedetelo con chi gestisce il sistema
Dopo aver mappato il flusso, aggiungete i controlli che di solito vengono omessi. Indicate la ownership per dominio o per team. Mostrate dove entrano i dati sensibili. Segnalate i confini di fiducia, i quality gate e le dipendenze critiche per il reporting o il ML. A questo punto il diagramma smette di essere descrittivo e diventa operativo.
Rivedete la bozza con le persone più vicine alla realtà:
I platform engineer individuano i dettagli mancanti su infrastruttura e orchestrazione.
Gli analytics engineer individuano problemi nella logica di trasformazione e nel semantic layer.
Gli sviluppatori BI individuano le ipotesi a valle sui dati curati.
I responsabili di governance o sicurezza individuano i punti ciechi su policy e accessi.
Un diagramma rivisto solo dagli architetti di solito riflette il design previsto. Un diagramma rivisto da chi gestisce il sistema riflette il sistema che avete davvero.
Infine, versionatelo. Mantenete la sorgente modificabile. Registrate le modifiche insieme ai cambiamenti della piattaforma. Se uno schema, una pipeline o un modello di ownership cambia e il diagramma no, inizia subito a deteriorarsi.
Integrare qualità dei dati e osservabilità nel diagramma
I diagrammi statici si rompono prima nei punti in cui la vostra piattaforma cambia più velocemente. Di solito non si tratta dello storage. Sono i bordi vivi del sistema. Compaiono nuovi campi nella sorgente. Un connettore consegna in ritardo. Un modello dbt continua a girare ma produce un significato alterato perché un tipo a monte è cambiato. Il diagramma sembra ancora corretto, eppure la pipeline si sta già allontanando dall'immagine.
Perché i diagrammi statici falliscono nelle pipeline moderne
Il problema è particolarmente acuto nei flussi di lavoro di analytics e ML, dove l'evoluzione degli schemi avviene spesso e in modo sottile. Una sorgente aggiunge un campo nullable. Un'altra rinomina una colonna. Una tabella del warehouse subisce un cambio di tipo che non fa fallire l'ingestion ma rompe il calcolo di una feature a valle o il filtro di una dashboard. Un diagramma di architettura statico non mostrerà nulla di tutto questo a meno che qualcuno non lo aggiorni manualmente, e a quel punto l'incidente si è già verificato.
Una sintesi di settore tratta dalla discussione di FanRuan sui diagrammi dell'architettura dei dati evidenzia direttamente questa lacuna, osservando che il 68% dei fallimenti del ML deriva da modifiche silenziose agli schemi e che i diagrammi integrano raramente il tracciamento automatico degli schemi. Che gestiate reporting finanziario, pipeline di interoperabilità sanitaria o analytics di prodotto, la lezione è la stessa. Una mappa che ignora la deriva diventa un'opera d'arte storica.
Per i team che vogliono chiarire il rapporto tra il monitoraggio dello stato di salute delle pipeline e la garanzia di correttezza, questa analisi di data observability e data quality a confronto è utile, perché i diagrammi di architettura devono fare spazio a entrambe. Una vi dice che qualcosa è cambiato o è arrivato in ritardo. L'altra vi dice se i dati sono validi per l'uso.
Cosa aggiungere per rendere il diagramma operativo
Un diagramma dell'architettura dei dati vivo include il modello di salute del sistema, non solo la sua struttura. Questo non significa disegnare ogni alert. Significa segnalare dove l'affidabilità viene stabilita o persa.
Ecco cosa funziona bene nella pratica:
Indicatori di freschezza sui percorsi di ingestion, così i lettori sanno quali pipeline sono attese ogni ora, ogni giorno o in base agli eventi.
Quality gate prima delle zone affidabili, per mostrare dove i record vengono validati prima di entrare nei layer curati.
Punti di osservazione degli schemi sulle interfacce volatili, come API esterne, tabelle raw allineate alla sorgente e tabelle di feature.
Etichette di monitoraggio delle tabelle critiche sulle tabelle curate che alimentano le dashboard del management o i modelli in produzione.
Tag di ownership sui confini degli alert, così il team giusto risponde quando scatta un segnale.
Questo cambia lo scopo del diagramma. Non dice più soltanto “i dati fluiscono da A a B”. Dice “questo percorso deve arrivare entro questa aspettativa, questa tabella è critica per il business, questa transizione include una validazione e questa sorgente è soggetta a schema drift”.
Un insieme pratico di notazioni potrebbe essere questo:
Indicatore | Significato | Risultato di business |
|---|---|---|
Icona dell'orologio | Aspettativa di freschezza o puntualità | Prevenire report obsoleti e SLA mancati |
Icona dello scudo | Gate di validazione o di policy | Intercettare i record non validi prima che si propaghino |
Icona dell'occhio | Checkpoint di osservabilità | Far emergere prima i guasti nascosti |
Badge dello schema | Punto di osservazione delle modifiche strutturali | Proteggere le trasformazioni a valle e gli input del ML |
Etichetta del responsabile | Team responsabile della risposta | Accorciare l'instradamento degli incidenti |
Non trattate l'osservabilità come uno strumento accessorio al di fuori dell'architettura. Appartiene al diagramma, perché definisce se l'architettura è sicura da gestire.
Quando i team aggiungono questi segnali, cambia anche la qualità delle revisioni. Una sorgente può essere “attiva” ed essere comunque inutilizzabile. Una dashboard può aggiornarsi puntualmente ed essere comunque sbagliata. Il diagramma operativo dovrebbe rendere visibili entrambi i rischi.
Best practice ed errori comuni da evitare
Un diagramma dell'architettura dei dati viene messo alla prova la prima volta che una dashboard si rompe alle 8 del mattino o che un modello inizia a calcolare punteggi su feature obsolete. In quel momento, a nessuno importa se il diagramma è curato graficamente. Bisogna vedere cosa è cambiato, chi è responsabile del percorso che sta fallendo e dove i controlli di qualità avrebbero dovuto intercettare il problema.
Questo standard cambia il modo in cui il diagramma va disegnato e mantenuto. Trattatelo come la planimetria di una casa usata da costruttori e ispettori, non come un poster preparato per una revisione trimestrale. I buoni diagrammi aiutano i team a rilasciare modifiche in sicurezza, a tracciarne rapidamente l'impatto e a decidere dove aggiungere controlli prima che un record errato raggiunga la finanza, le operations o un sistema di ML.
Una checklist pratica:
Rendete esplicita la ownership. Assegnate un team o un ruolo con un nome a ogni flusso critico per il business, dataset condiviso e confine degli alert.
Adattate la vista al pubblico. I platform engineer hanno bisogno di confini di sistema, passaggi di consegne e punti di guasto. Gli stakeholder di business hanno bisogno dei percorsi che influenzano report, prodotti rivolti ai clienti e livelli di servizio.
Mostrate le transizioni, non solo i riquadri. I problemi di solito nascono nei punti di ingestion, nelle join, nelle modifiche agli schemi e nei passaggi tra team.
Versionate il diagramma insieme alla piattaforma. Se il warehouse, il percorso di orchestrazione o il layer di serving cambiano, cambia anche il diagramma.
Segnate i segnali operativi sul diagramma. Obiettivi di freschezza, gate di validazione, punti di osservazione degli schemi e checkpoint di osservabilità dovrebbero stare sul flusso che proteggono.
Collegate l'architettura al consumo. Etichettate quali percorsi alimentano dashboard, API, job di reverse ETL o feature store, così l'impatto di un incidente è evidente.
Gli errori comuni sono altrettanto prevedibili, e di solito nascono dal trattare il diagramma come documentazione statica anziché come artefatto operativo.
Il diagramma onnicomprensivo. Un'unica tela cerca di mostrare ogni sorgente, tabella, team, strumento e dipendenza. Il risultato è illeggibile durante le revisioni di design e inutile durante gli incidenti.
Notazione incoerente. Un'icona di storage significa una cosa in un dominio e qualcos'altro in un altro. I lettori smettono di fidarsi della mappa.
Modellazione basata sugli strumenti. I loghi dei vendor sostituiscono le decisioni architetturali. Il lettore vede i prodotti, ma non i confini di fiducia, i quality gate o il rischio di business.
Pensiero da istantanea. Il diagramma riflette la pipeline del trimestre scorso, mentre il sistema attuale è già cambiato.
Contesto di runtime mancante. I dati si muovono nell'immagine, ma non c'è traccia di cosa debba essere aggiornato, di cosa possa fallire o di cosa alimenti un report critico per il management o un modello in produzione.
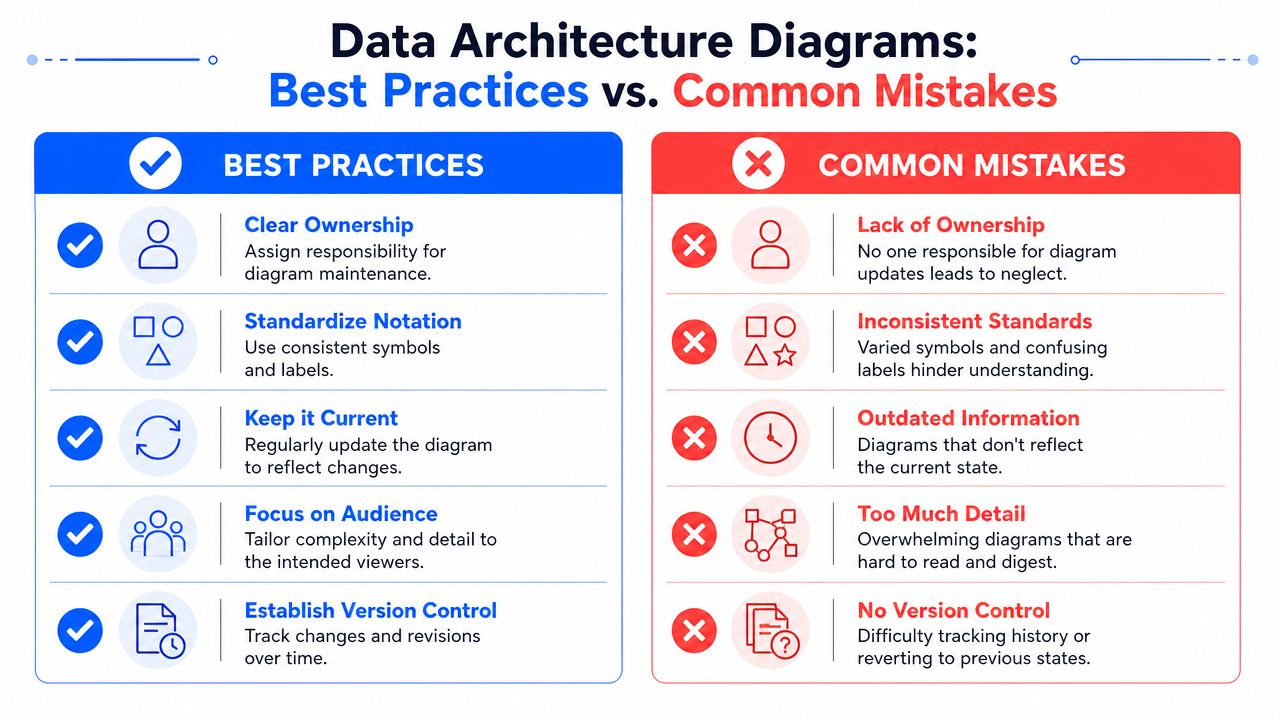
Il compromesso è semplice. Un diagramma più pulito e circoscritto lascia fuori alcuni dettagli. Va bene così. Cercare di includere ogni dettaglio di solito nasconde quei pochi dettagli che contano quando la qualità dei dati peggiora o una pipeline si blocca. Preferisco un piccolo insieme di diagrammi a layer sempre aggiornati a un unico diagramma master che nessuno aggiorna.
Un buon diagramma dell'architettura dei dati si guadagna la fiducia perché resta vicino alla realtà. Mostra come i dati dovrebbero fluire, dove è probabile che falliscano e quale processo di business si rompe se succede.
Se il vostro team vuole passare dalla documentazione statica a una visione operativa dell'affidabilità dei dati, vale la pena dare un'occhiata a digna. Si concentra sulla data quality e sulla data observability moderne, inclusi rilevamento delle anomalie, monitoraggio della puntualità, validazione a livello di record e tracciamento degli schemi, ed è eseguito all'interno di ambienti controllati dal cliente. Questo lo rende particolarmente adatto ai team che hanno bisogno di maggiore visibilità sullo stato di salute delle pipeline senza rinunciare al controllo dei dati di produzione.
Domande frequenti
Che cos'è un diagramma dell'architettura dei dati?
È un blueprint che mostra come i dati si muovono all'interno di un'organizzazione: le sorgenti, i percorsi di ingestion, dove i dati vengono archiviati ed elaborati, come vengono resi disponibili ai consumatori e i controlli trasversali di sicurezza, governance e qualità che si applicano lungo il percorso.
Che cosa dovrebbe includere un diagramma dell'architettura dei dati?
Sorgenti e meccanismi di ingestion, layer di storage e di elaborazione, endpoint di serving e di consumo e gli aspetti trasversali. Dovrebbe mostrare anche la ownership e la direzione delle dipendenze, perché è ciò che serve quando una dashboard si rompe e bisogna trovare il job a monte responsabile.
Quali sono i tipi più comuni di diagrammi di architettura?
I diagrammi concettuali mostrano domini e relazioni per gli stakeholder non tecnici. I diagrammi logici mostrano dataset, flussi e layer senza dettagli sui vendor. I diagrammi fisici mostrano i sistemi e i servizi reali. Scegliere il tipo prima dello strumento evita un diagramma che non serve a nessuno.
Perché i diagrammi di architettura statici diventano obsoleti così in fretta?
Perché i sistemi continuano a cambiare e il diagramma no. Nel giro di pochi sprint un disegno fatto a mano non riflette più la realtà, e le persone smettono di fidarsene. I diagrammi derivati da metadati e lineage in tempo reale sopravvivono; quelli mantenuti a mano degenerano in semplice decorazione.
In che modo un diagramma di architettura aiuta la qualità dei dati?
Trasforma un incidente in un percorso tracciabile. Quando una tabella di KPI mostra valori null, il diagramma indica quale job di ingestion la alimenta, quali trasformazioni stanno nel mezzo e chi è responsabile di ogni passaggio: è la differenza tra una diagnosi di dieci minuti e un pomeriggio passato a tirare a indovinare.


