Descrizione dello schema del database: guida completa per i data team
|
6
min di lettura

State fissando una dashboard che ieri sembrava a posto, poi una sola colonna rinominata trasforma un caricamento di routine in un caos di null, cast falliti e imbarazzanti messaggi su Slack prima dello standup del mattino. Di solito è il momento in cui ci si rende conto che lo schema del database non è un dettaglio di sfondo, ma ciò che tiene insieme l'intera catena di reporting. Una descrizione dello schema del database offre a ogni team lo stesso contratto da leggere e, quando viene trattata come un artefatto vivo anziché come un diagramma statico, fa la differenza tra un rilascio controllato e un silenzioso incidente in produzione.
Indice
Perché una descrizione dello schema conta prima della prima query
Formati comuni per rappresentare una descrizione dello schema
Un esempio concreto di descrizione dello schema del database
Best practice per scrivere e mantenere le descrizioni dello schema
Perché una descrizione dello schema conta prima della prima query
Una modifica di schema sbagliata raramente appare drammatica all'inizio. Qualcuno rinomina una colonna in una tabella sorgente, il job ETL continua a girare e una dashboard per il management si apre con spazi vuoti dove ieri c'erano i numeri. Non è un problema di reporting isolato, è un contratto rotto tra il database e le persone che lo leggono.
Una descrizione dello schema del database utile è il riferimento condiviso che mantiene visibile quel contratto. I data engineer ne hanno bisogno per sapere cosa si può modificare in sicurezza. Gli analytics engineer ne hanno bisogno affinché le trasformazioni non presuppongano che una colonna significhi qualcosa che non significa più. Gli sviluppatori BI e i business analyst ne hanno bisogno perché il solo nome della tabella non racconta mai tutta la storia.
Regola pratica: se un consumatore dipende da una colonna, il significato, il tipo e i vincoli di quella colonna devono stare nella descrizione dello schema, non nella memoria di qualcuno.
Il motivo per cui conta è semplice. La progettazione dello schema determina integrità, indicizzazione e comportamento delle query panoramica di IBM sugli schemi, e le modifiche allo schema possono propagarsi a report, applicazioni e pipeline a valle che dipendono dalle colonne o dai vincoli di una tabella panoramica di IBM sugli schemi. Ecco perché questo tema si trova al centro della governance e dell'osservabilità, non solo della modellazione dei database.
Ci sono tre idee principali da tenere a mente. Primo, lo schema deve essere descritto con chiarezza. Secondo, quella descrizione deve sopravvivere in un formato che i team possano usare. Terzo, le modifiche devono essere tracciate di continuo, perché gli schemi moderni non restano congelati. Le organizzazioni aggiungono colonne, modificano tipi e applicano nuove regole man mano che le esigenze di business evolvono, ed è proprio per questo che la descrizione deve restare vicina al sistema reale panoramica di IBM sugli schemi. Se fate le cose per bene, il debugging diventa più rapido, gli audit più semplici e la fiducia nei dati smette di dipendere da interventi eroici.
Che cos'è davvero una descrizione dello schema del database
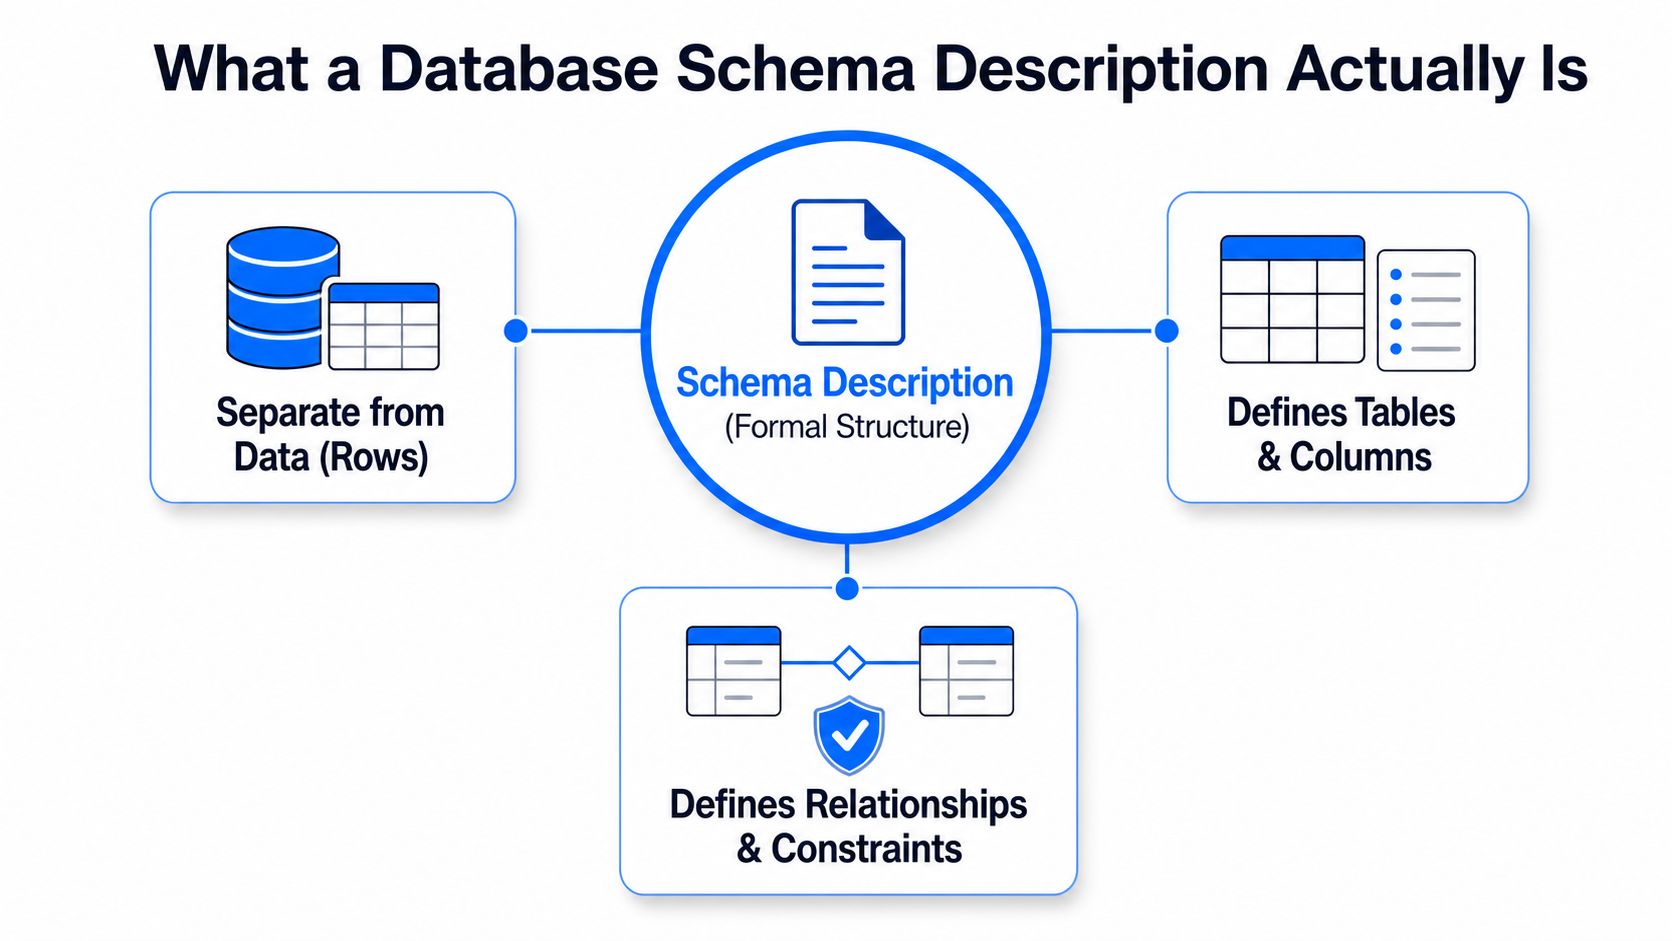
Pensate allo schema come alla planimetria e alle righe come alle persone che abitano nell'edificio. La planimetria vi dice quante stanze ci sono, dove si trovano le porte e quali regole segue la struttura. Gli abitanti cambiano ogni giorno, ma la pianta dell'edificio è un oggetto separato.
Questa distinzione è centrale nella teoria dei database relazionali, dove la struttura è separata dall'istanza o stato dispense UPJS. Uno schema di database è la descrizione formale della struttura di un database, compresi tabelle, campi, tipi di dato, vincoli e relazioni terminologia dei database di Purdue CS. È la descrizione del sistema, non dei dati in sé.
La guida di digna su schema e modello dei dati è utile se state cercando di separare l'idea di struttura dalle scelte di modellazione più ampie che la circondano.
Che cosa deve contenere la descrizione
Una vera descrizione dello schema richiede più dei nomi delle tabelle. Deve mostrare cosa memorizza il database, come si collegano le entità e quali valori sono ammessi. Un campo di tipo integer, date o text fa parte del significato dello schema, perché quella scelta vincola i valori che il database accetta terminologia dei database di Purdue CS. Lo stesso vale per unicità, regole not-null e relazioni referenziali.
Ecco perché le modifiche allo schema sono operative, non estetiche. Cambiare il tipo di una colonna o eliminare un vincolo modifica la struttura attesa del database, e le applicazioni possono fallire immediatamente quando si basano sul vecchio contratto terminologia dei database di Purdue CS. In pratica, una descrizione dello schema va letta come un artefatto di ingegneria. Vi dice cosa il sistema può fare, cosa deve rifiutare e dove le join sono sicure.
Le indicazioni moderne riflettono ancora la tradizione relazionale. Normalizzazione, chiavi primarie, chiavi esterne e vincoli restano gli strumenti standard per preservare la coerenza e rendere prevedibile il recupero dei dati sintesi di GeeksforGeeks sugli schemi. Una descrizione dello schema che tralascia questi elementi non descrive davvero il database. Descrive un'ipotesi.
Gli elementi fondamentali di ogni descrizione dello schema

Un buon documento di schema parte dai sostantivi del modello. Le tabelle o entità rappresentano le cose che vi interessano: clienti, ordini, prodotti, sinistri, conti. Quei nomi contano perché inquadrano il significato di business prima che qualcuno legga una sola query.
Tabelle e colonne
Le colonne sono le proprietà di ciascuna tabella. Vi dicono quali fatti vengono memorizzati su quell'entità, come customer_id, created_at o status. In una buona scrittura dello schema, il nome della tabella e i nomi delle colonne hanno abbastanza significato da permettere a un nuovo collega di dedurre la forma dei dati senza tirare a indovinare.
Tipi di dato e vincoli
I tipi di dato sono il livello del contratto. Un campo integer, date o text non descrive solo la memorizzazione, dice cosa conta come input valido terminologia dei database di Purdue CS. I vincoli svolgono lo stesso lavoro a un livello più rigoroso. Le regole PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL e CHECK mantengono i dati coerenti e applicabili.
Una descrizione dello schema che ignora i vincoli è scritta solo a metà.
È anche il motivo per cui le modifiche allo schema fanno danni così rapidamente. Un cambio di tipo può far fallire un cast. Eliminare una regola not-null può alterare il comportamento di un'applicazione. Rimuovere una chiave esterna può far entrare relazioni errate nella tabella senza alcun avviso. Il dettaglio dello schema non è ornamentale, incide direttamente sull'affidabilità a valle e sulla gestione delle modifiche voce di Wikipedia sullo schema.
Relazioni
Le relazioni sono il tessuto connettivo. I collegamenti uno-a-uno, uno-a-molti e molti-a-molti sono ciò che permette alle query di unire il significato tra le tabelle. La normalizzazione ha storicamente spinto i progettisti di schemi verso questa struttura perché riduce la ridondanza e preserva la coerenza sintesi di GeeksforGeeks sugli schemi. Anche le indicazioni di AWS sugli schemi riflettono lo stesso modello, identificando entità, chiavi e tabelle di relazione come i meccanismi di una progettazione pulita guida di AWS allo schema del database.
Elemento | Che cosa descrive | Ideale per | Dove si trova |
|---|---|---|---|
Tabelle | Entità principali e relative righe | Modellare gli oggetti di business | Documenti di progettazione del database |
Colonne | Attributi e campi | Definire la forma dei record | Documenti di schema e DDL |
Tipi di dato | Formati di valore ammessi | Validazione e casting | DDL, contratti, specifiche dei dati |
Vincoli | Regole e integrità referenziale | Prevenire dati errati | Motore del database e migrazioni |
Un modo utile per leggere una descrizione dello schema è porsi una domanda per ciascun elemento: che cos'è, quali valori accetta e che cosa dipende da esso? Se sapete rispondere a queste tre cose, state già ragionando come un data platform engineer.
Formati comuni per rappresentare una descrizione dello schema
Team diversi hanno bisogno di rappresentazioni diverse, e l'errore peggiore è considerarle intercambiabili. DDL, diagrammi ER, JSON Schema e schemi Avro o Parquet risolvono ciascuno un problema diverso, anche se descrivono tutti una struttura.
Il formato deve adattarsi al pubblico
Il DDL è la fonte di verità eseguibile perché è il motore del database ad applicarlo. Un diagramma ER è più adatto alle discussioni di progettazione perché rende le relazioni facili da scorrere. JSON Schema accompagna i payload degli eventi e i contratti delle API, mentre gli schemi Avro o Parquet sono comuni nelle pipeline di streaming e analitiche, dove il contratto deve muoversi insieme ai dati.
Formato | Che cosa descrive | Ideale per | Dove si trova |
|---|---|---|---|
DDL | Tabelle, colonne, vincoli, indici | Data warehouse e database operativi | File di migrazione o definizioni del database |
Diagramma ER | Entità e relazioni | Revisioni di progettazione e onboarding | Documentazione e presentazioni di architettura |
JSON Schema | Campi e regole di validazione in JSON | API e payload degli eventi | Codice applicativo e file di contratto |
Schema Avro o Parquet | Struttura delle colonne nei dati serializzati | Pipeline di streaming e lakehouse | File di dati, registry o configurazioni delle pipeline |
Alcuni piccoli frammenti rendono concreta la differenza.
CREATE TABLE customers (customer_id INT PRIMARY KEY, email TEXT NOT NULL UNIQUE);
Customer si collega a Order tramite Order_Item quando la relazione è molti-a-molti.
{"type":"object","properties":{"email":{"type":"string"},"customer_id":{"type":"integer"}}}
message Customer { required int32 customer_id; required string email; }
La scelta pratica è semplice. Usate il DDL quando il data warehouse o il database deve applicare il contratto. Usate i diagrammi ER quando le persone devono comprendere rapidamente la progettazione. Usate JSON Schema o gli schemi Avro/Parquet quando il contratto deve viaggiare con eventi o file. L'obiettivo non è il formato, è il pubblico.
Un esempio concreto di descrizione dello schema del database
Partite da una semplice configurazione e-commerce: i clienti effettuano ordini, gli ordini contengono prodotti e un ordine può includere molti prodotti. Questo vi dà subito le entità necessarie: clienti, ordini e prodotti.
Dai requisiti alle tabelle
Le indicazioni di AWS suggeriscono di identificare prima lo scopo e le informazioni chiave, per poi passare a entità, chiavi e relazioni guida di AWS allo schema del database. In questo caso ogni tabella ha bisogno di una chiave primaria, perché ogni riga necessita di un identificatore stabile. Creereste quindi le tabelle customers, orders e products, ciascuna con la propria chiave e i propri attributi di business.
La relazione molti-a-molti tra ordini e prodotti richiede una tabella di collegamento, spesso chiamata order_items. Quella tabella contiene order_id, product_id e la quantità, invece di ripetere i dettagli del prodotto su ogni riga d'ordine. È la normalizzazione in azione, lo stesso schema che AWS indica con le tabelle di relazione per evitare la ridondanza guida di AWS allo schema del database.
Se un valore appartiene allo stesso modo a più righe, smettete di ripeterlo e trasformate la relazione in una tabella.
Un semplice abbozzo di DDL rende visibile la struttura:
CREATE TABLE customers (customer_id INT PRIMARY KEY, email TEXT NOT NULL UNIQUE);
CREATE TABLE products (product_id INT PRIMARY KEY, sku TEXT NOT NULL UNIQUE, price DECIMAL(10,2) NOT NULL);
CREATE TABLE orders (order_id INT PRIMARY KEY, customer_id INT NOT NULL, created_at DATE NOT NULL, FOREIGN KEY (customer_id) REFERENCES customers(customer_id));
CREATE TABLE order_items (order_id INT NOT NULL, product_id INT NOT NULL, quantity INT NOT NULL, PRIMARY KEY (order_id, product_id), FOREIGN KEY (order_id) REFERENCES orders(order_id), FOREIGN KEY (product_id) REFERENCES products(product_id));
Una vista JSON di un record
Lo stesso cliente può essere descritto anche in JSON Schema quando il record viaggia attraverso un'API o un flusso di eventi.
{"type":"object","properties":{"customer_id":{"type":"integer"},"email":{"type":"string"},"created_at":{"type":"string","format":"date"}},"required":["customer_id","email","created_at"]}
Questa versione non sostituisce lo schema del database. Lo completa. La struttura della tabella, i vincoli e il contratto del record esprimono la stessa idea di fondo in luoghi diversi. Una volta che sapete costruire questo esempio in modo pulito, potete applicare lo schema a quasi qualsiasi data warehouse, archivio operativo o contratto di pipeline.
Come lo schema drift danneggia i consumatori a valle
Una modifica allo schema sembra innocua finché un altro team non dipende dalla vecchia forma. Una colonna rinominata, una piccola modifica a un tipo di dato o un vincolo rimosso possono rompere più cose contemporaneamente. Il raggio d'impatto si manifesta di solito in ETL, BI e input dei modelli prima ancora che qualcuno apra la tabella sorgente.
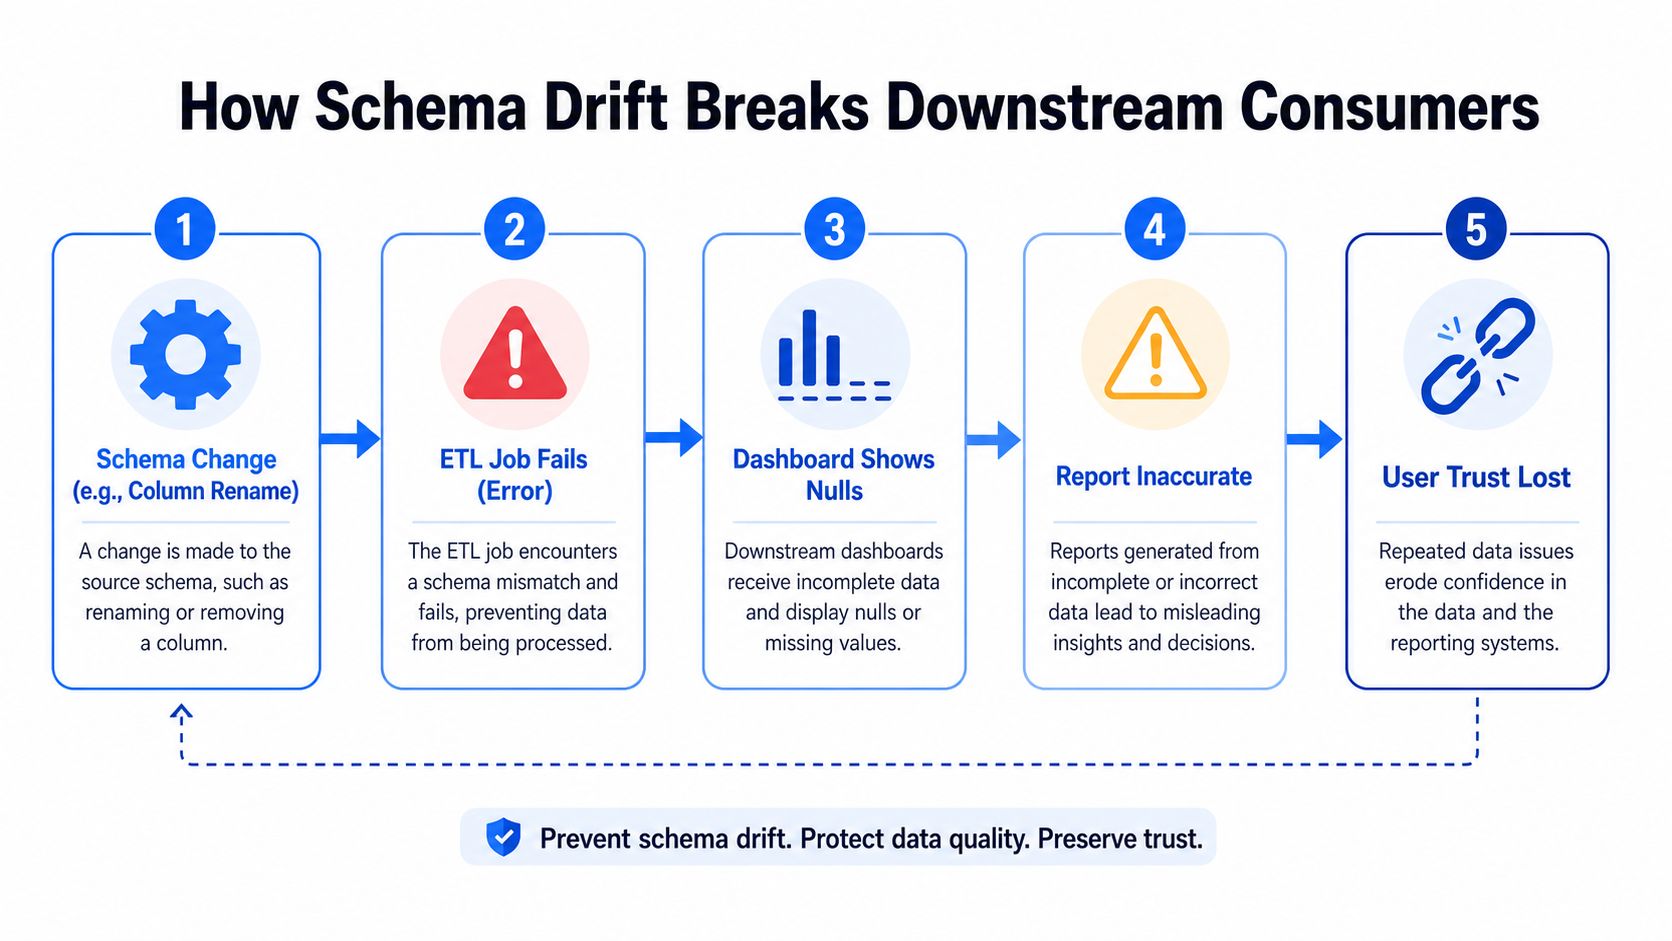
La catena dei guasti
Una colonna sorgente viene rinominata da status a order_status. Il job ETL che selezionava * ora scrive i campi nell'ordine sbagliato o fallisce del tutto. Il semantic layer della BI cerca ancora il vecchio nome del campo, quindi le dashboard mostrano spazi vuoti. Un modello dbt che esegue il cast della colonna può generare un errore, e un modello di machine learning a valle può acquisire una distribuzione diversa da quella su cui è stato addestrato senza sollevare alcun alert.
Ecco perché esiste il tracciamento dello schema. I team sorvegliano colonne aggiunte o rimosse, modifiche ai tipi di dato e deviazioni dei vincoli, perché sono le variazioni strutturali con la maggiore probabilità di danneggiare i consumatori Wikipedia schema article. Lo scopo non è solo individuare il cambiamento, ma individuarlo prima che se ne accorgano gli utenti di business.
Il ruolo del monitoraggio
Gli strumenti operativi contano. Il divario di documentazione tra i diagrammi di schema e i sistemi reali esiste davvero, e il tracciamento dello schema ne colma una parte collegando le modifiche strutturali alla risposta agli incidenti, alla validazione e ai controlli di tempestività. Schema Tracker di digna è un esempio di strumento in questa categoria. È adatto quando un team vuole un rilevamento continuo delle modifiche strutturali invece di affidarsi ad audit manuali.
Lo schema drift e le pipeline interrotte sono esattamente la modalità di guasto che molti team osservano nella pratica.
Una configurazione di osservabilità sana considera lo schema parte della superficie di monitoraggio. Se la struttura cambia, il responsabile della pipeline deve saperlo immediatamente, il responsabile della BI deve sapere quali campi sono interessati e l'analista deve sapere se il report di ieri è ancora affidabile. Non è un processo in più. È il minimo necessario per evitare che i consumatori di dati scoprano i guasti a cose fatte.
Best practice per scrivere e mantenere le descrizioni dello schema
Una descrizione dello schema diventa utile quando si legge come una risorsa di lavoro, non come una nota di progettazione una tantum. Tutto parte dai nomi. I nomi di tabelle e colonne devono veicolare un significato di business, perché un buon nome riduce la quantità di contesto di cui qualcuno ha bisogno prima di usare i dati.
Fate in modo che il documento spieghi i dati
I commenti alle colonne contano più di quanto molti team pensino. Un commento può dire a un nuovo analista se status indica lo stato del pagamento, della spedizione o dell'account. Un data dictionary o una vista del catalogo dovrebbe mostrare queste descrizioni accanto ai dati, così le persone non devono cercare tra Slack o i ticket per interpretare un campo.
Regola pratica: ogni colonna che può essere fraintesa dovrebbe avere un commento o una voce nel dizionario che ne renda esplicito il significato.
Tracciate le modifiche come codice
I log delle modifiche allo schema dovrebbero registrare autore, revisore, motivazione e timestamp di ogni modifica. Sei mesi dopo, quella cronologia è l'unico modo affidabile per ricostruire perché il tipo di un campo è cambiato o perché un vincolo è stato rimosso. Il versionamento del DDL o degli script di migrazione vi dà questa tracciabilità e rende inoltre la revisione parte del normale percorso di rilascio.
Alcune aggiunte vengono spesso trascurate ma meritano di essere documentate:
Query di esempio: mostrano come lo schema è pensato per essere unito o filtrato.
Note di sicurezza: registrano chi può leggere i campi sensibili e cosa deve restare riservato.
Collegamenti ai processi a monte: collegano lo schema al workflow di business che genera i dati.
Ownership: indicate il team responsabile dell'approvazione delle modifiche future.
Tenete la documentazione vicina al sistema
La documentazione si deteriora quando vive lontano dal codice. Lo schema più sicuro è tenere la descrizione dello schema vicino al DDL, alle migrazioni e alla voce del data catalog che descrive la tabella. In questo modo, lo stesso percorso di revisione che approva le modifiche al codice esamina anche le modifiche strutturali. Il risultato è più semplice per il lavoro di reperibilità, più agevole per gli audit e molto meno fragile per l'onboarding.
Costruire un workflow di documentazione e tracciamento
Un buon workflow trasforma la descrizione dello schema in un sistema operativo per il cambiamento. Partite da DDL o migrazioni sotto controllo di versione come definizione canonica, poi rendete la revisione dello schema parte della stessa disciplina che già usate per la code review. In questo modo ogni modifica strutturale lascia una traccia visibile prima di arrivare in produzione.
Chiudete il cerchio con l'osservabilità
Una volta che la definizione è sotto controllo di versione, il problema successivo è il drift. Il tracciamento dello schema, la validazione e il monitoraggio della tempestività intercettano le modifiche involontarie che la code review non può vedere dopo il deployment. È il punto in cui la data observability diventa operativa, perché il sistema deve confrontare ciò che intendevate con ciò che esiste nel data warehouse o nella pipeline.
La piattaforma di digna combina moduli per Schema Tracker, validazione, tempestività, anomalie e altre esigenze di monitoraggio all'interno dell'ambiente del cliente. La componente dello schema è importante qui perché verifica continuamente le modifiche strutturali, mentre il resto dello stack controlla che i dati si comportino ancora come previsto. Se il vostro team ha bisogno di un unico punto in cui sorvegliare un contratto di schema insieme ad altri segnali di affidabilità, è proprio questo il ruolo che svolge questo tipo di piattaforma.
Rendete il workflow ripetibile
Mantenete il ciclo abbastanza semplice da essere effettivamente usato.
Scegliete un unico formato canonico. Usate il DDL o un'altra definizione autorevole, così tutti sanno dove si trova la verità.
Documentate con intenzione. Aggiungete commenti, ownership e contesto di business invece di trattare lo schema come un semplice elenco di colonne.
Tracciate le modifiche come codice. Richiedete revisione, cronologia e una motivazione per ogni aggiornamento strutturale.
Monitorate il sistema reale. Confrontate lo schema atteso con quello osservato e generate alert in caso di drift.
Il messaggio principale è diretto. Una descrizione dello schema non è un diagramma da completare e archiviare. È al tempo stesso un contratto, un artefatto di progettazione e un obiettivo di monitoraggio. Se questi tre ruoli restano collegati, il data warehouse è più facile da considerare affidabile e molto più facile da sottoporre a debugging.
Se volete un modo pratico per riunire descrizioni dello schema, rilevamento del drift, validazione e controlli di tempestività in un unico ciclo operativo, visitate digna e scoprite come la sua piattaforma si integra con il vostro data warehouse e le vostre pipeline. È pensata per i team che hanno bisogno che lo schema documentato corrisponda allo schema letto dai loro consumatori.
Domande frequenti
Che cos'è una descrizione dello schema del database?
Una descrizione dello schema del database è la descrizione formale della struttura di un database: tabelle, campi, tipi di dato, vincoli e relazioni. Descrive il sistema, non i dati in sé, così come la planimetria di un edificio è diversa dalle persone che lo abitano. I team la leggono come un contratto condiviso su ciò che il database accetta.
Che cosa deve includere una descrizione dello schema del database?
Oltre ai nomi delle tabelle, deve coprire colonne, tipi di dato, vincoli come PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL e CHECK, e le relazioni tra le tabelle. La guida raccomanda anche commenti alle colonne, query di esempio, note di sicurezza, collegamenti ai processi a monte e un responsabile designato che approvi le modifiche future.
Quale formato usare per documentare uno schema di database?
Adattate il formato al pubblico. Il DDL è la fonte di verità eseguibile perché è il motore del database ad applicarlo, i diagrammi ER sono adatti alle discussioni di progettazione, mentre JSON Schema e gli schemi Avro o Parquet si prestano ai contratti che viaggiano con eventi, payload API o file attraverso pipeline di streaming e analitiche.
In che modo lo schema drift danneggia dashboard e pipeline?
Una singola modifica strutturale può avere un effetto a cascata. Nell'esempio dell'articolo, rinominare status in order_status fa fallire un job ETL che usa select * o ne scompagina i campi, il livello BI mostra spazi vuoti, un cast in dbt genera un errore e un modello di machine learning a valle può acquisire silenziosamente una distribuzione diversa.
Come si mantiene aggiornata una descrizione dello schema?
Trattatela come codice. Mantenete DDL o migrazioni sotto controllo di versione come definizione canonica, registrate autore, revisore, motivazione e timestamp di ogni modifica e conservate la documentazione vicino al DDL e alla voce del catalogo. Poi monitorate il sistema reale, confrontando lo schema atteso con quello osservato e generando alert in caso di drift.


