Definizione di pulizia dei dati: guida pratica per il 2026
|
6
min di lettura

Sono le 8:07. Ieri la dashboard sembrava a posto. Stamattina la previsione delle vendite è precipitata, un KPI regionale si è diviso in due categorie che non dovrebbero esistere e qualcuno della finanza sta già chiedendo se il caricamento del warehouse sia fallito durante la notte.
Il più delle volte non si è bloccato nulla. Un campo sorgente è cambiato. Un formato di data è derivato. Un'etichetta di paese è passata da una convenzione a un'altra. Un job di ingestione duplicato è stato eseguito e ha gonfiato i conteggi. La parte pericolosa è quanto questi guasti sembrino ordinari. Non si annunciano con un errore bloccante. Si presentano come assurdità dall'aria convincente.
Per questo non basta definire la pulizia dei dati (data cleaning) come "correggere le righe sbagliate". Nella pratica, la pulizia dei dati è il lavoro che mantiene report, modelli, alert e decisioni operative ancorati alla realtà. Se volete un utile approfondimento sull'idea più ampia di input affidabili, vale la pena leggere l'articolo di Market Edge sulla qualità dei dati. Per i team che lavorano a stretto contatto con dashboard e pipeline di reporting, è direttamente rilevante anche questa riflessione sul perché gli strumenti di business intelligence valgono quanto la qualità dei dati.
Indice
Definire la pulizia dei dati attraverso le sue attività fondamentali
Oltre la pulizia: dalle correzioni statiche all'osservabilità continua
Il guasto silenzioso dietro la vostra dashboard rotta
I guasti sui dati più costosi sono di solito silenziosi.
Uno dei più comuni si presenta così. Nel sistema sorgente il fatturato è stabile, ma la dashboard direzionale mostra improvvisamente un crollo in un mercato. Lo sviluppatore BI controlla il livello di trasformazione. Le tabelle del warehouse sono state caricate. L'SQL non ha dato errori. Ore dopo, qualcuno trova il problema: un'applicazione a monte ha smesso di inviare USA e ha iniziato a inviare United States. Nessun crash. Nessuna chiamata di reperibilità. Solo dimensioni frammentate e aggregazioni sbagliate.
Perché questo tipo di guasto è difficile da intercettare
I controlli statici intercettano i guasti evidenti. Non intercettano in modo affidabile il drift semantico.
Se la vostra pipeline verifica solo che una colonna esista e contenga stringhe, entrambi i valori passano. I dati sono sintatticamente validi e operativamente sbagliati. È esattamente lo spazio in cui i team si fanno male. Gli analisti passano la mattinata a riconciliare numeri. I dirigenti perdono fiducia nella dashboard. Gli ingegneri correggono il sintomo e vanno avanti, senza eliminare le condizioni che lo hanno reso possibile.
I dati sporchi raramente falliscono in modo rumoroso. Di solito attraversano i sistemi con un aspetto abbastanza valido da ispirare fiducia.
Spesso si chiede di definire la pulizia dei dati come se fosse una voce di glossario. Nei sistemi reali, la definizione migliore deriva dalla modalità di guasto che previene. La pulizia dei dati è la disciplina che rende i dati utilizzabili, confrontabili e affidabili prima che raggiungano analytics, reporting o modelli.
Perché la "pulizia una tantum" è il modello mentale sbagliato
La parola "ripulire" suggerisce un'attività con una data di fine. I dati di produzione non si comportano così.
I sistemi sorgente evolvono. Gli operatori inseriscono valori in modo incoerente. Le API cambiano il comportamento dei campi. Dopo il lancio di un prodotto compaiono nuovi pattern di null. Uno script di pulizia una tantum può sistemare il disordine di ieri e lasciarvi comunque ciechi davanti a quello di domani. Ecco perché i team esperti smettono di trattare la pulizia dei dati come igiene da foglio di calcolo e iniziano a trattarla come una funzione di affidabilità.
Quando una dashboard si rompe senza un'interruzione dei sistemi, di solito state osservando un problema di qualità dei dati sfuggito alla validazione. La soluzione non è solo un SQL migliore. È un processo di pulizia più solido, legato a monitoraggio, validazione e feedback rapido.
Definire la pulizia dei dati attraverso le sue attività fondamentali
Se volete definire la pulizia dei dati in un modo che regga in produzione, definitela attraverso i compiti che svolge.

La definizione tecnica è precisa. La pulizia dei dati è il processo sistematico di identificazione, correzione e rimozione di errori strutturali, record duplicati e osservazioni irrilevanti, per garantire che i dati soddisfino gli standard di qualità "Completi, Coerenti, Corretti" necessari per un'inferenza statistica affidabile, come descritto nella spiegazione di TechnologyAdvice sulla pulizia dei dati. Se scendete nei dettagli di implementazione, contano anche i controlli a livello di record, ed è per questo che una guida su che cos'è la validazione dei dati è così vicina al lavoro di pulizia nelle pipeline reali.
Che cosa significa la definizione nella pratica
Pensate a un dataset come a una casa che state ristrutturando per viverci davvero, non per una foto. Non vi limitate a spazzare il pavimento. Eliminate ciò che non dovrebbe esserci, riparate ciò che è rotto, uniformate ciò che dovrebbe corrispondere e verificate che la struttura sia solida prima che qualcuno ci vada ad abitare.
È ciò che una buona pulizia fa con i dati. Trasforma l'input grezzo in qualcosa di cui i sistemi a valle possono fidarsi.
Le attività fondamentali che puliscono davvero i dati
Una parte del lavoro di pulizia è meccanica. Un'altra richiede molto giudizio. La parte difficile è capire quale sia quale.
Gestite i valori mancanti in modo consapevole: i campi vuoti non sono tutti uguali. Un numero di telefono mancante, un codice di diagnosi mancante e un timestamp di transazione mancante hanno conseguenze molto diverse. A volte si rimuove il record. A volte lo si arricchisce. A volte si mantiene il null perché l'assenza ha un significato.
Rimuovete i duplicati con attenzione: i record duplicati gonfiano i conteggi, distorcono le coorti e rompono la logica di attribuzione. Negli ambienti con più sorgenti, i duplicati sono spesso corrispondenze approssimative più che copie esatte, quindi servono regole di matching basate su identificatori stabili anziché sui nomi visualizzati.
Correggete gli errori strutturali: refusi, maiuscole e minuscole incoerenti, spazi superflui e convenzioni di naming disomogenee creano categorie fittizie.
new york,New YorkeNEW YORKpossono sembrare dettagli banali, ma frammentano le aggregazioni e corrompono silenziosamente il reporting.Standardizzate i formati: date, valute, unità di misura ed etichette categoriali devono rispettare un unico formato. Se una sorgente usa
YYYY-MM-DDe un'altra invia varianti locali, ordinamenti e join diventano rapidamente inaffidabili.Validate rispetto alle regole di business: alcuni valori sono tecnicamente ben formati e tuttavia impossibili. Quantità negative dove i rimborsi non sono ammessi. Date di fine precedenti alle date di inizio. Valori di stato che non dovrebbero coesistere nello stesso record.
Ecco un confronto pratico:
Attività di pulizia | Che cosa corregge | Che cosa va storto se la saltate |
|---|---|---|
Gestione dei valori mancanti | Lacune e null | Join rotte, analisi distorte, esclusioni silenziose |
Deduplicazione | Entità o eventi ripetuti | Fatturato, conteggi di utenti e tassi di conversione gonfiati |
Correzione strutturale | Refusi e deriva delle etichette | Dimensioni frammentate e raggruppamenti errati |
Standardizzazione | Formati e unità misti | Parsing fallito, filtri errati, confronti inaffidabili |
Validazione | Record che violano le regole | Output dall'aspetto plausibile ma comunque sbagliati |
Regola pratica: se una decisione di pulizia cambia il significato di business, non automatizzatela alla cieca. Prevedete un passaggio di revisione.
Ciò che non funziona è trattare tutte e cinque le attività come un unico passaggio generico di "pulizia". I buoni team le separano. Prima profilano, poi applicano regole mirate e conservano intatti i dati grezzi per poter tracciare in seguito ogni correzione.
Il costo da migliaia di miliardi dei dati sporchi
I dati sporchi non sono una voce di fastidio a bilancio. Sono un moltiplicatore di perdite per il business.

I numeri sono già abbastanza grandi da non richiedere esagerazioni. La scarsa qualità dei dati impone un onere finanziario enorme alle aziende statunitensi, con un costo di circa 3.100 miliardi di dollari all'anno. Ulteriori ricerche indicano che le aziende stimano di perdere in media il 27 percento del proprio fatturato a causa di problemi di qualità dei dati, secondo l'analisi di DLC sulle sfide e sull'impatto della pulizia dei dati nelle aziende. Se vi serve un modo per inquadrare internamente l'esposizione operativa, un calcolatore del costo del data downtime può aiutarvi a tradurre problemi di qualità astratti in rischio di business.
Perché la finanza se ne accorge prima dell'ingegneria
L'ingegneria vede spesso il sintomo come un difetto tecnico. La finanza lo vede come erosione dei margini, reporting in ritardo, rilavorazioni e decisioni sbagliate.
Un'anagrafica clienti non aggiornata provoca contatti duplicati. Dati di inventario inaccurati generano false ipotesi sulle scorte. Dati di riferimento corrotti si riversano nel reporting, poi nelle previsioni, poi nella pianificazione. Quando qualcuno apre un ticket, il costo ha già attraversato più team.
Dove si manifestano le perdite
Queste perdite raramente si concentrano in un'unica voce evidente. Si diffondono.
Perdite di fatturato: i team di vendita e marketing lavorano su record incompleti o duplicati. Il targeting delle campagne peggiora. L'assegnazione degli account diventa confusa. Le previsioni diventano meno affidabili.
Freno operativo: analisti e ingegneri passano il tempo a riconciliare output invece di consegnare lavoro. Le dashboard richiedono avvertenze. I controlli manuali si accumulano prima di ogni review con il management.
Esposizione in termini di compliance: negli ambienti regolamentati, i record errati creano grattacapi in fase di audit. Se un campo è sbagliato, in ritardo o incoerente tra i sistemi, il problema non è solo analitico. Può diventare un problema di governance.
Fallimento dell'AI: i modelli addestrati su input di bassa qualità non diventano intelligenti per caso. Diventano sicuri di sé e sbagliati.
Una breve chiave di lettura aiuta:
Area di business | Effetto dei dati sporchi | Risultato tipico |
|---|---|---|
Reporting | Dimensioni incoerenti e caricamenti in ritardo | Dashboard rotte e KPI non aggiornati |
Operations | Correzioni manuali e passi indietro | Team più lenti e rilavorazioni evitabili |
Governance | Record incompleti o in conflitto | Attriti negli audit e lacune nei controlli |
AI e ML | Input scadenti per training e inferenza | Previsioni inaffidabili |
La conclusione pratica è semplice. La pulizia dei dati non è un costo accessorio. È una superficie di controllo per la protezione del fatturato, la stabilità operativa e la qualità delle decisioni.
Un workflow standard per la pulizia dei dati
Un buon lavoro di pulizia segue un workflow ripetibile. Le correzioni improvvisate sono rapide sul momento e costose in seguito.
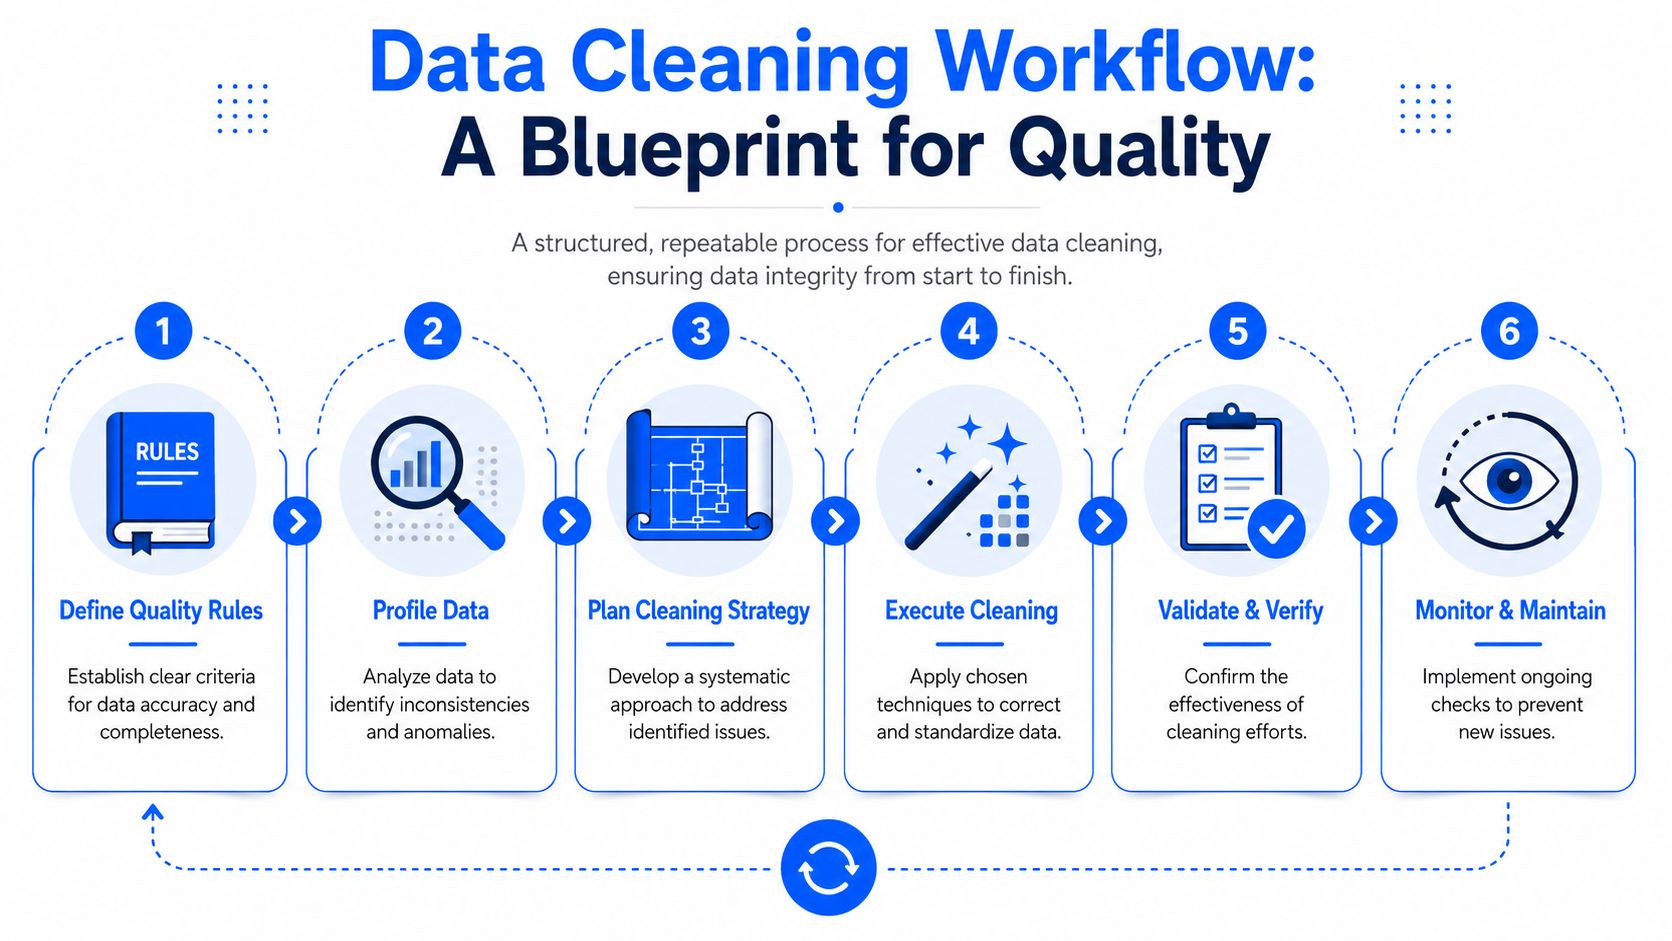
Un piano solido dovrebbe coprire più della rimozione dei duplicati e della correzione dei formati. Le specifiche tecniche degli esperti in materia di pulizia dei dati richiedono un "piano di pulizia dei dati approfondito" che integri otto passaggi critici: rimuovere le osservazioni indesiderate, uniformare la struttura, standardizzare i dati, rimuovere gli outlier, correggere gli errori tra dataset, risolvere gli errori di sintassi, gestire i dati mancanti ed eseguire la validazione finale, come illustrato nelle best practice di Monte Carlo per la pulizia dei dati.
Partite dalla profilazione, non dalle correzioni
Il primo errore dei team junior è modificare prima di ispezionare.
La profilazione vi dice che tipo di dataset avete. Osservate i pattern dei null, l'unicità, le distribuzioni dei valori, la coerenza dello schema, la deriva delle categorie e le relazioni tra tabelle. Per gran parte di questo lavoro basta l'SQL. Pandas, test dbt, query sul warehouse e campionamenti mirati funzionano tutti, purché rispondano alla stessa domanda: che cosa non va, dove e con quale frequenza?
Una sequenza pratica si presenta così:
Definite le regole di qualità: decidete che cosa significa "valido" prima di toccare i dati.
Profilate il dataset: misurate duplicati, null, incoerenze di tipo e valori anomali.
Scegliete la strategia di pulizia: difetti diversi richiedono regole di gestione diverse.
Prima profilate. Altrimenti correggerete le righe che sembrano brutte e vi sfuggirà il difetto che rompe davvero la metrica.
Pulire, validare, poi documentare
Una volta individuati i difetti, applicate la correzione minima che ripristina l'affidabilità.
Usate SQL per la standardizzazione e le join. Usate Python per il fuzzy matching, il parsing e le trasformazioni a livello di riga quando l'SQL diventa scomodo. Usate strumenti ETL o ELT quando il workflow deve essere eseguito ripetutamente e in modo verificabile. Lo strumento conta meno della disciplina.
È nella seconda metà del workflow che i team maturi si distinguono:
Eseguite la pulizia: rimuovete le osservazioni indesiderate, uniformate la struttura, standardizzate, risolvete gli errori di sintassi e di tipo e correggete le incongruenze tra dataset.
Validate il risultato: rieseguite i test dopo ogni trasformazione importante. Verificate conteggi delle righe, unicità, integrità referenziale e regole di business.
Documentate che cosa è cambiato: registrate che cosa è stato rimosso, modificato, imputato, unito o segnalato.
Questo è il workflow che molti team saltano:
Fase | Domanda principale | Risultato atteso |
|---|---|---|
Profilazione | Quali difetti esistono? | Valutazione di base della qualità |
Pulizia | Quale correzione è appropriata? | Dataset corretto o logica di trasformazione |
Validazione | La correzione ha funzionato senza danni collaterali? | Controlli superati e verifiche a campione |
Report | Un'altra persona può riprodurre questo lavoro? | Registro delle modifiche e regole di pulizia |
Ciò che non funziona è "pulire finché il grafico non sembra giusto". Questo produce pipeline fragili e discussioni che nessuno potrà risolvere in seguito.
Errori comuni che invalidano i vostri dati
Pulire i dati può migliorare il dataset e al tempo stesso rovinare l'analisi.

Sembra contraddittorio finché non lo si vede accadere. I team rimuovono outlier "sbagliati" che erano eventi reali. Riempiono i valori mancanti con valori predefiniti di comodo che appiattiscono la variabilità e introducono distorsioni. Standardizzano le categorie senza controllare la lineage, per poi scoprire più tardi che due etichette dovevano restare distinte.
Il tasso di fallimento legato a input deboli non è piccolo. I processi di pulizia dei dati eliminano circa il 20-30% degli errori nei dataset grezzi, ma si stima che il 60% dei progetti di data science fallisca principalmente a causa della scarsa qualità dei dati, originata da sorgenti di input non pulite o pulite in modo inadeguato, secondo questo report sui fallimenti dovuti alla qualità dei dati e sull'impatto della pulizia.
Quando la pulizia crea nuovi problemi
Tre errori si presentano di continuo nei team di produzione.
Il primo è l'eccesso di pulizia. Se ogni valore insolito viene rimosso, cancellate comportamenti legittimi. Picchi di frode, acquisti enterprise una tantum ed eventi clinici rari sembrano spesso rumore finché il contesto di business non dice il contrario.
Il secondo è una cattiva gestione dei dati mancanti. Se i valori mancanti sono sistematici, una semplice imputazione può fabbricare certezze dove non ce ne sono. Un campo assente per un segmento ma presente per un altro può distorcere un modello o un report.
Il terzo è la pulizia senza contesto di acquisizione. I dataset di campagne e attribuzione sono un esempio classico. Se i parametri di tracciamento sono incoerenti al momento della raccolta, la pulizia a valle diventa più difficile e meno difendibile. Un riferimento sintetico sulle best practice per gli UTM è utile qui, perché mostra come la disciplina a monte eviti che la pulizia a valle diventi un esercizio di congetture.
Alcuni "dati errati" sono in realtà un segnale valido accompagnato da una documentazione scarsa.
Che cosa fanno diversamente i team disciplinati
Non trattano la pulizia come un passaggio estetico. Preservano la tracciabilità.
Esaminano la lineage: prima di modificare un valore, si chiedono da dove provenga e quali trasformazioni lo abbiano già toccato.
Documentano le ipotesi: se imputano, uniscono, limitano o scartano valori, registrano la regola e la motivazione.
Conservano copie dei dati grezzi: la reversibilità conta quando qualcuno contesta una metrica in seguito.
Coinvolgono gli owner di dominio: un valore strano in un dataset ospedaliero o di trading può essere raro ma valido.
Una rapida tabella degli anti-pattern aiuta:
Errore | Perché fa danni | Approccio migliore |
|---|---|---|
Eccesso di pulizia degli outlier | Rimuove estremi validi | Prima segnalare, eliminare solo con il contesto |
Imputazione indiscriminata | Introduce distorsioni | Valutare perché i valori mancano |
Nessuna documentazione | Compromette la riproducibilità | Registrare ogni regola ed eccezione |
Mentalità della correzione una tantum | Lascia che i difetti ritornino | Costruire controlli ripetibili |
I team si mettono nei guai quando ottimizzano per una tabella ordinata anziché per un dataset fedele.
Oltre la pulizia: dalle correzioni statiche all'osservabilità continua
Il vecchio modello mentale dice che la pulizia dei dati avviene prima dell'analisi. Nei sistemi in esercizio, questo confine non regge.
I dati di produzione continuano a muoversi. Gli schemi evolvono. La freschezza varia. Le distribuzioni delle categorie derivano. Una pulizia batch può lasciare il dataset valido a mezzogiorno e inaffidabile la sera. Ecco perché la definizione moderna più solida della pulizia dei dati include il monitoraggio. Non è solo riparazione. È rilevamento, validazione e correzione continui all'interno di una pipeline che cambia.
La lacuna della maggior parte delle guide è già documentata. Le guide esistenti non affrontano l'aspetto cruciale che la pulizia dei dati è un processo di osservabilità continuo e ciclico. "I dati riparati possono generare nuove eccezioni nei dati", il che richiede una validazione iterativa e un monitoraggio in tempo reale per intercettare il drift silenzioso e le modifiche dello schema che rompono i modelli di AI a valle, come descritto in questa rassegna sulla qualità dei dati continua e sull'osservabilità. Se volete un inquadramento più ampio, questa panoramica su che cos'è la data observability collega bene il lato operativo.
Perché la pulizia una tantum non regge più
Un processo statico presuppone che i difetti siano già presenti e in attesa di essere rimossi. Le pipeline reali generano continuamente nuovi difetti.
Un team sorgente cambia il tipo di una colonna. Un fornitore inizia a inviare file in ritardo. Il rilascio di un'app mobile modifica i payload degli eventi. Una tabella delle dimensioni acquisisce nuove categorie senza preavviso. Niente di tutto questo è insolito. Sono condizioni operative normali nei sistemi dati moderni.
Questo cambia la risposta pratica quando vi chiedono di definire la pulizia dei dati. La risposta utile oggi è questa: la pulizia dei dati è il lavoro continuo di mantenere i dati completi, coerenti, corretti e utilizzabili man mano che le condizioni cambiano.
Che cosa aggiunge il monitoraggio moderno
La pulizia tradizionale risponde alla domanda: "Come sistemiamo questo dataset?"
L'osservabilità aggiunge una seconda domanda: "Come facciamo a sapere che il prossimo dataset sta derivando prima che una dashboard o un modello si rompano?"
Questo significa tenere d'occhio:
Anomalie di comportamento: variazioni improvvise nei conteggi delle righe, nelle distribuzioni o nei pattern delle metriche.
Problemi di tempestività: caricamenti che arrivano in ritardo, in modo parziale o non arrivano affatto.
Modifiche dello schema: colonne aggiunte, colonne rimosse e modifiche di tipo che invalidano le ipotesi.
Fallimenti di validazione: regole a livello di record che non dovrebbero mai passare inosservate.
I sistemi di pulizia dei dati più solidi non aspettano che uno stakeholder trovi il problema in un grafico.
È l'evoluzione pratica della disciplina. La pulizia include ancora deduplicazione, standardizzazione, gestione dei valori mancanti e validazione. Ma in produzione queste attività hanno bisogno di un ciclo di feedback: pulite, osservate, validate di nuovo e rispondete alle nuove eccezioni man mano che si presentano.
È il passaggio dall'igiene statica all'affidabilità operativa.
Se il vostro team è stanco di scoprire i problemi sui dati solo dopo che una dashboard si è rotta o un modello ha iniziato a derivare, digna è costruita per questa realtà. Aiuta i team a rilevare anomalie, validare record, monitorare la tempestività e tracciare le modifiche dello schema all'interno di ambienti controllati dal cliente, così la pulizia dei dati diventa una pratica di affidabilità continua invece di un'emergenza ricorrente.
Per trasformare il passaggio "validare rispetto alle regole di business" in controlli ripetibili a livello di record anziché in un intervento una tantum, scoprite come digna Data Validation applica queste regole all'interno del vostro database.
Domande frequenti
Qual è la definizione di pulizia dei dati?
La pulizia dei dati è il processo sistematico di identificazione, correzione e rimozione di errori strutturali, record duplicati e osservazioni irrilevanti, affinché i dati soddisfino lo standard "Completi, Coerenti, Corretti". In produzione, secondo l'articolo, è meglio definirla attraverso i compiti che svolge piuttosto che come una correzione una tantum delle righe errate.
Quali sono le attività principali della pulizia dei dati?
Cinque attività fondamentali svolgono la maggior parte del lavoro: gestire consapevolmente i valori mancanti, rimuovere i duplicati, correggere gli errori strutturali, standardizzare i formati e validare rispetto alle regole di business. Ad esempio, new york, New York e NEW YORK sembrano dettagli banali ma frammentano le aggregazioni, e una sorgente che usa YYYY-MM-DD mentre un'altra no rompe ordinamenti e join.
Quanto costano i dati sporchi alle aziende?
La scarsa qualità dei dati costa alle aziende statunitensi circa 3.100 miliardi di dollari all'anno e le aziende stimano di perdere in media il 27 percento del fatturato a causa di problemi di qualità dei dati. Le perdite si distribuiscono tra mancati ricavi, freno operativo dovuto alle riconciliazioni manuali, esposizione in termini di compliance negli ambienti regolamentati e modelli di AI che diventano sicuri di sé e sbagliati.
Quali sono i passaggi di un workflow di pulizia dei dati?
Iniziate definendo le regole di qualità e profilando il dataset prima di correggere qualsiasi cosa. Poi scegliete una strategia di pulizia, eseguitela, validate il risultato rieseguendo i test su conteggi delle righe, unicità e integrità referenziale e infine documentate che cosa è stato rimosso, modificato, imputato o unito, in modo che un'altra persona possa riprodurre il lavoro.
Perché una pulizia dei dati una tantum non basta?
Perché le pipeline reali generano continuamente nuovi difetti. Un team sorgente cambia il tipo di una colonna, un fornitore invia file in ritardo o il rilascio di un'app modifica i payload degli eventi, quindi una pulizia batch può essere valida a mezzogiorno e inaffidabile la sera. Monitorare anomalie, tempestività, modifiche dello schema e fallimenti di validazione trasforma la pulizia in un ciclo continuo.


