dbt vs Airflow: scegliere il flusso di lavoro dei dati giusto nel 2026
|
7
min di lettura

Se state valutando dbt vs Airflow, probabilmente non lo state facendo nel vuoto. Avete a che fare con caricamenti a monte in ritardo, job SQL fragili, analisti che vogliono una titolarità più chiara delle trasformazioni e ingegneri che hanno bisogno di un unico punto in cui vedere che cosa è andato storto e perché. Sulla carta la scelta sembra binaria. In produzione raramente lo è.
Spesso i team non si mettono nei guai perché hanno scelto lo strumento sbagliato. Si mettono nei guai perché hanno assegnato la responsabilità sbagliata allo strumento giusto. Airflow viene riempito di logica di trasformazione che non dovrebbe gestire. dbt viene trattato come uno scheduler per flussi di lavoro che non può vedere. A quel punto il debug diventa archeologia.
Questa confusione emerge di solito proprio quando un team cerca di standardizzare uno stack moderno e di semplificare le operazioni con l'elaborazione dei dati lungo ingestion, trasformazione e distribuzione a valle. La domanda utile non è quale logo vince. È quale livello del sistema dovrebbe controllare ciascuno strumento e come reggono quei confini quando qualcosa si rompe.
Indice
Introduzione: sbrogliare il vostro flusso di lavoro dei dati
L'errore più grande nel dibattito dbt vs Airflow è trattarli come alternative. Non lo sono. Operano a livelli diversi, affrontano modalità di errore diverse e creano valore per persone diverse all'interno del team.
Airflow gestisce il coordinamento dei flussi di lavoro tra sistemi. dbt gestisce la trasformazione SQL all'interno del data warehouse. Una volta chiarito questo confine, l'architettura inizia a semplificarsi. Job di estrazione, attese su API, retry, notifiche e sequenziamento appartengono a un orchestratore. Logica dei modelli, test, documentazione e lineage appartengono a un framework di trasformazione.
Sembra ovvio finché una pipeline reale non arriva sulla vostra scrivania. Un'ingestion da un SaaS termina in ritardo. Una tabella grezza arriva con null inattesi. Un export per il marketing dipende dall'aggiornamento di un data mart. Qualcuno chiede se la correzione vada nel DAG, nel progetto dbt o altrove. A quel punto la scelta dello strumento diventa una questione di modello operativo.
Regola pratica: se il problema riguarda l'ordine dei task, le tempistiche, i retry o il coordinamento tra sistemi, partite da Airflow. Se il problema riguarda la modellazione dei dati del data warehouse in modelli affidabili, partite da dbt.
Gli stack ibridi funzionano bene quando il confine è netto e il passaggio di consegne è esplicito. Diventano dolorosi quando i team confondono le responsabilità. Airflow non dovrebbe diventare un cimitero di SQL. dbt non dovrebbe diventare la vostra risposta per il controllo delle dipendenze a monte.
L'architettura che regge in produzione di solito ha tre caratteristiche:
Responsabilità chiare: gli ingegneri gestiscono la logica di orchestrazione. Analytics engineer e analisti gestiscono la logica di trasformazione.
Task di orchestrazione snelli: Airflow avvia il lavoro e lo monitora. Non diventa il luogo in cui si accumula la logica di business.
Trasformazione nativa nel data warehouse: dbt viene eseguito dove i dati risiedono già, il che mantiene il livello di trasformazione modulare e più facile da comprendere.
Che cos'è Apache Airflow: l'orchestratore generalista
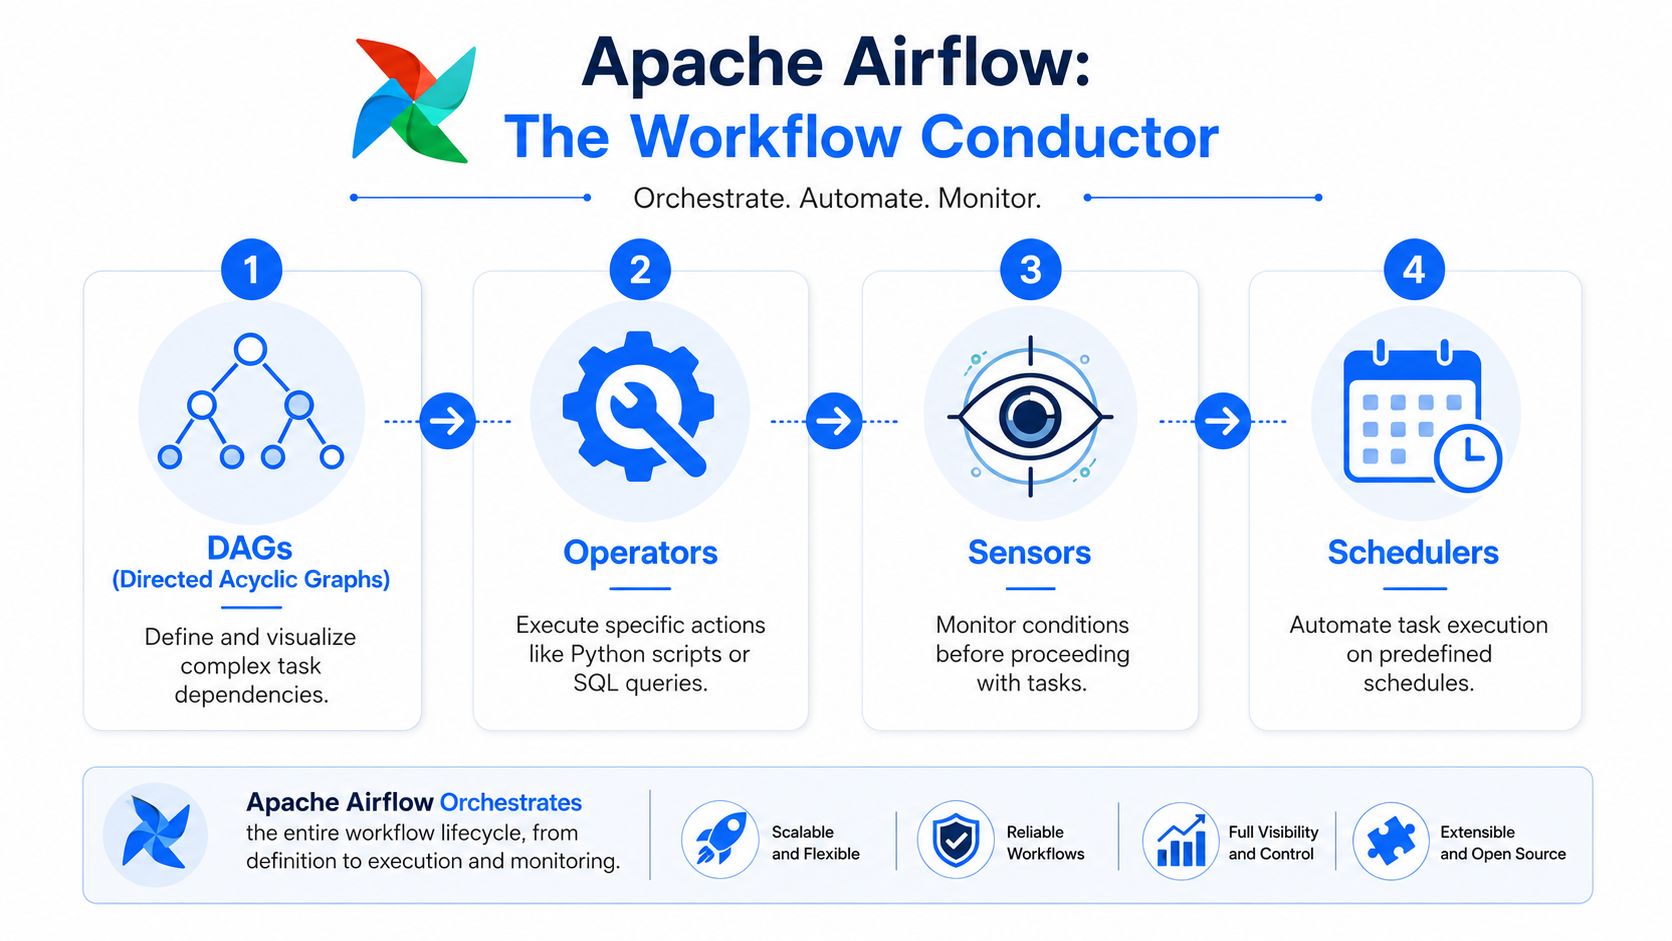
Apache Airflow è il livello a cui ricorrere quando il flusso di lavoro si estende oltre un singolo sistema. Non è solo uno scheduler. È il piano di controllo operativo che decide che cosa viene eseguito, in quale ordine, a quali condizioni e che cosa succede quando un passaggio fallisce.
Perché Airflow è diventato il piano di controllo
Apache Airflow è una piattaforma open source di orchestrazione dei flussi di lavoro che consente ai team di creare, pianificare e monitorare programmaticamente le pipeline di dati con Python e SQL, con un punteggio di soddisfazione degli utenti di 8,7 su 10 su TrustRadius secondo le recensioni della community riportate nel confronto tra Airflow e dbt di TrustRadius.
Questa definizione conta meno delle sue implicazioni. Airflow è diventato la scelta dominante per orchestrare pipeline complesse e multi-step che coinvolgono sistemi oltre il data warehouse, tra cui ingestion, processi di machine learning e fasi di attivazione che richiedono risoluzione delle dipendenze, retry e notifiche di errore. In altre parole, è pensato per ambienti in cui il completamento con successo di un job non significa che la pipeline sia terminata.
Una buona analogia è quella dell'impresa generale in un cantiere. L'impresa non getta personalmente il calcestruzzo, non installa l'impianto elettrico e non dipinge le pareti. Coordina specialisti, sequenze, ispezioni, ritardi e passaggi di consegne, così che l'intero progetto si concluda nell'ordine giusto.
Airflow dà il meglio quando ogni task ha una responsabilità circoscritta e il DAG esprime chiaramente il flusso di controllo.
Che cosa dovrebbe orchestrare Airflow
Airflow funziona meglio quando lo usate per coordinare sistemi specializzati invece di ricrearli all'interno di task Python. Questo significa:
Avviare gli strumenti di ingestion: far partire l'estrazione da API, connettori SaaS o servizi interni.
Gestire attese e dipendenze: mettere in pausa il flusso finché non arrivano i file, non si aggiornano le tabelle o non terminano i servizi a monte.
Eseguire i processi a valle: avviare caricamenti nel data warehouse, aggiornamenti dei modelli di ML, reverse ETL o notifiche.
Fornire visibilità operativa: usare l'interfaccia per esaminare la durata dei task, lo storico delle esecuzioni e i punti di errore.
La sua flessibilità è al tempo stesso il vantaggio e la trappola. Poiché Airflow può eseguire quasi qualsiasi cosa, i team spesso inseriscono troppa logica di business nel codice dei DAG. Questo rende il debug più difficile, soprattutto quando codice di orchestrazione e codice di trasformazione sono intrecciati.
Diventa ancora più evidente quando i flussi di lavoro si estendono a sistemi autonomi e interazioni tra servizi. Le stesse pressioni progettuali emergono nelle sfide dell'orchestrazione di agenti AI, dove la complessità del coordinamento cresce molto prima che la logica dei singoli task diventi il problema principale.
Che cos'è dbt: lo specialista della trasformazione
dbt è ciò che si usa quando le tabelle grezze del data warehouse devono diventare asset analitici affidabili. Non cerca di gestire ogni sistema della pipeline. Si concentra sul livello di trasformazione e svolge questo compito con una disciplina molto più rigorosa di quanto potrà mai fare un orchestratore generalista.

Perché dbt deve stare all'interno del data warehouse
dbt Core è un framework open source progettato specificamente per l'analytics engineering, che esegue trasformazioni di dati basate su SQL direttamente all'interno dei data warehouse e gestisce la "T" di ELT organizzando, pulendo, denormalizzando, filtrando, rinominando e pre-aggregando i dati grezzi per l'analisi, come descritto nella presentazione al FOSDEM sulla traduzione di dbt in Apache Airflow.
Questo modello di esecuzione all'interno del data warehouse è il punto architetturale chiave. dbt non estrae i dati verso un livello di elaborazione esterno solo per trasformarli. Compila l'SQL e lo esegue dove i dati risiedono già. In questo modo il percorso di trasformazione resta più vicino al motore, ai permessi e al profilo prestazionale del data warehouse.
L'analogia migliore è quella di un maestro falegname che lavora all'interno della casa, prendendo materiali grezzi e trasformandoli in strutture finite nel laboratorio in cui gli attrezzi sono già presenti. dbt non coordina l'intero cantiere. Produce i componenti interni finiti con una lavorazione ripetibile.
In che cosa dbt eccelle
Il fornitore afferma che dbt consente agli analisti di assumersi la responsabilità dell'intero flusso di analytics engineering, dalla scrittura del codice di trasformazione al deployment, alla documentazione e ai test. Questo spiega perché dbt tende a diffondersi rapidamente non appena un team inizia a fare modellazione seriamente.
I suoi punti di forza sono operativi tanto quanto tecnici:
Sviluppo SQL-first: analisti e analytics engineer possono contribuire senza spostare il loro linguaggio principale verso codice di orchestrazione Python-first.
Modelli modulari: ogni modello resta più piccolo, più facile da revisionare e più facile da testare.
Test e lineage integrati: il grafo delle trasformazioni diventa ispezionabile invece di restare conoscenza tribale.
Convenzioni condivise: nomenclatura, dipendenze e documentazione diventano parte del progetto stesso.
dbt è di solito il posto giusto per la logica di business che deve restare leggibile per le persone che definiscono le metriche e la semantica della reportistica.
I team incontrano difficoltà quando si aspettano che dbt agisca come un gestore completo dei flussi di lavoro. Non è stato pensato per questo. È uno specialista. Se il problema della vostra pipeline riguarda file, API, elaborazioni non SQL o tempistiche tra sistemi diversi, siete già fuori dall'ambito naturale di dbt.
Un confronto architetturale di fondo
La decisione dbt vs Airflow non riguarda la popolarità. Riguarda il modello di esecuzione, il dominio di errore e la titolarità all'interno del team. In produzione questi strumenti risultano compatibili proprio perché le loro filosofie di progettazione sono diverse, non perché si somiglino.
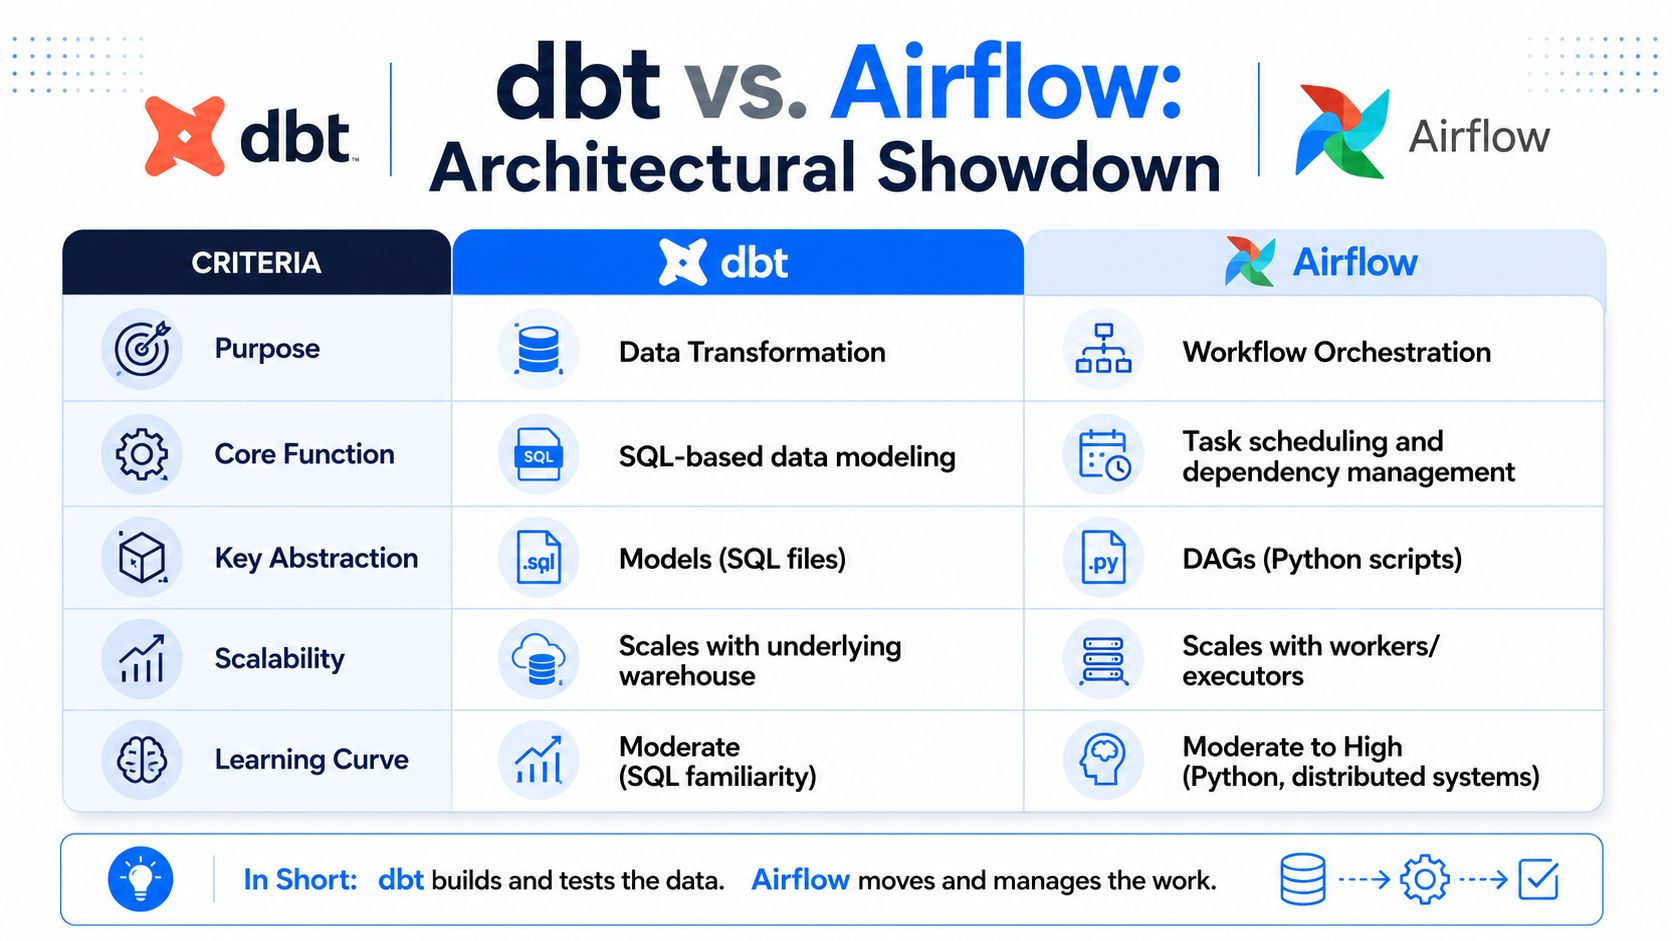
Tabella di confronto rapido
Dimensione | dbt | Apache Airflow |
|---|---|---|
Ruolo principale | Trasformazione dei dati all'interno del data warehouse | Orchestrazione dei flussi di lavoro tra sistemi |
Astrazione principale | Modelli | DAG |
Linguaggio tipico | SQL e Jinja | Python e SQL |
Luogo di esecuzione | All'interno del data warehouse | Worker ed executor esterni |
Punto di forza | Modellazione, test, documentazione, lineage | Pianificazione, dipendenze, retry, coordinamento |
Responsabile naturale | Analytics engineer, team fortemente orientati all'SQL | Data platform engineer, data engineer |
Punto debole | Controllo tra sistemi | Logica di trasformazione manutenibile all'interno dei task |
Che cosa significa l'architettura nella pratica
Un framework di trasformazione nativo del data warehouse e un orchestratore esterno producono comportamenti operativi molto diversi. dbt sfrutta il motore di calcolo del database e mantiene la consapevolezza dello stato all'interno del grafo delle trasformazioni. Airflow sfrutta un'ampia portata sui sistemi e può coordinare task arbitrari indipendentemente da dove vengano eseguiti.
Questa divisione crea compromessi pratici.
Il primo è flessibilità contro specializzazione. Airflow può orchestrare script Python, istruzioni SQL, chiamate API, sensor e fasi di machine learning in un unico flusso di lavoro. dbt è più circoscritto per scelta progettuale. Questa limitazione è un pregio quando si cerca di mantenere la logica di trasformazione leggibile e governata.
Il secondo è chi può contribuire in sicurezza. I team SQL-first di solito procedono più velocemente in dbt perché il modello mentale corrisponde al lavoro. Airflow richiede una disciplina di orchestrazione più solida, dimestichezza con Python e consapevolezza del comportamento in fase di deployment. Ecco perché uno stack ibrido spesso migliora la chiarezza nel team invece di aumentare la complessità.
Il terzo è dove finiscono i test. I benchmark prestazionali indicano che il Fusion Engine di dbt offre un parsing SQL più veloce e un'intelligente esclusione delle build superflue per ridurre al minimo le esecuzioni ridondanti, mentre Airflow riduce la contesa delle risorse tramite deferrable operator che liberano gli slot dei worker durante le lunghe attese su sistemi esterni. La stessa analisi osserva che la suite di test nativa di dbt copre le derive legate alla forma dello schema e la validazione YAML, ma non dispone esplicitamente di funzionalità per volumetrie, freschezza rispetto a sorgenti esterne o contratti tra sorgenti diverse, che spesso richiedono la validazione dei DAG di Airflow e unit test per i task, secondo l'analisi dbt vs Airflow di Airbyte.
Questa distinzione conta durante la gestione degli incidenti. Un'esecuzione dbt verde non garantisce che i dati a monte siano arrivati correttamente. Un DAG Airflow verde non garantisce che i dati trasformati abbiano ancora un aspetto sensato.
Verifica architetturale: se un team afferma che un solo strumento coprirà orchestrazione, trasformazione e qualità dall'inizio alla fine, di solito sta comprimendo responsabilità diverse in un unico livello e si sta preparando futuri grattacapi di debug.
Come dbt e Airflow lavorano insieme nel modern data stack
In uno stack sano, Airflow e dbt si incontrano in un passaggio di consegne pulito. Airflow coordina il flusso di lavoro. dbt esegue la fase di trasformazione nel data warehouse. È questa divisione che rende la combinazione scalabile dal punto di vista operativo.
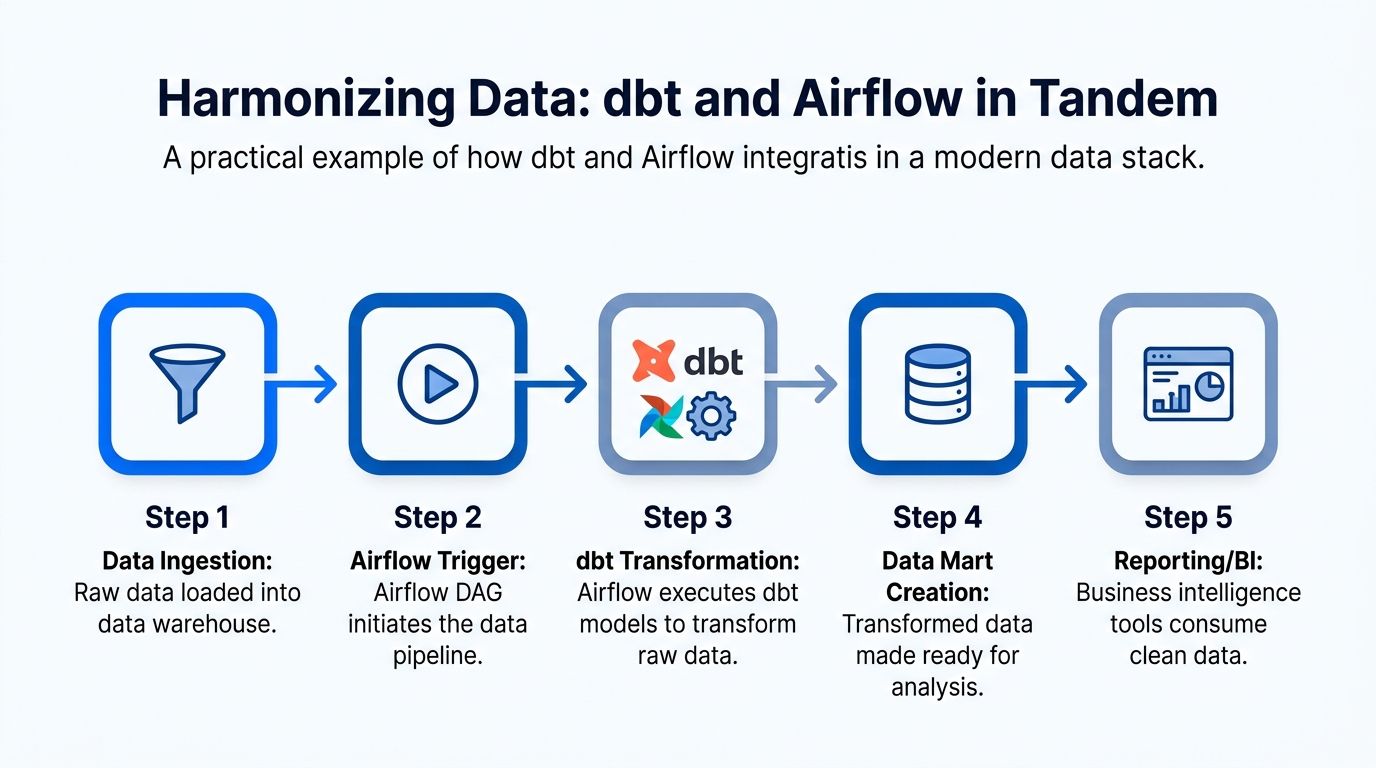
Il passaggio di consegne che mantiene puliti i sistemi
Una chiave di lettura utile è l'idea che dbt gestisce il "COSA" attraverso modellazione, test, documentazione e lineage, mentre Airflow gestisce il "QUANDO" e il "COME" attraverso pianificazione, risoluzione delle dipendenze e retry su sistemi eterogenei. La stessa fonte li descrive come componenti ortogonali anziché concorrenti e presenta come pattern di produzione del 2026 quello in cui Airflow o Dagster orchestrano la pipeline mentre dbt esegue i modelli SQL all'interno del data warehouse, come spiegato nell'articolo di DataDriven su dbt vs Airflow.
È questa l'architettura da ottimizzare. Lasciate che Airflow decida quando deve avvenire la trasformazione. Lasciate che dbt decida come i modelli vengono compilati ed eseguiti.
Un flusso standard si presenta così:
Estrazione da API, file o sistemi sorgente.
Caricamento dei dati grezzi nel data warehouse.
Avvio di dbt da Airflow una volta soddisfatte le condizioni a monte.
Esecuzione dei test e costruzione dei data mart all'interno del data warehouse.
Prosecuzione a valle verso dashboard, export o task di attivazione.
Quando la freschezza delle sorgenti grezze diventa parte del passaggio di consegne, i team hanno spesso bisogno di una visione più chiara di quella che può offrire il solo successo del DAG. Un riferimento pratico è il monitoraggio della freschezza delle sorgenti dbt, perché la disponibilità delle sorgenti è spesso il punto in cui le ipotesi dell'orchestrazione e la realtà del data warehouse divergono.
Un pattern di DAG pratico
Per molti stack di produzione basta un semplice pattern Airflow:
Task uno: avviare o monitorare l'ingestion.
Task due: confermare il completamento del caricamento nel data warehouse.
Task tre: eseguire
dbt build,dbt runo un job di dbt Cloud.Task quattro: diramare in base all'esito dei test o proseguire verso la distribuzione a valle.
La decisione progettuale principale riguarda la granularità. Alcuni team avviano dbt come un unico task. Altri mappano in modo più esplicito i modelli o i gruppi di modelli dbt nel DAG. La risposta sbagliata è di solito quella estrema. Un unico task dbt opaco può nascondere troppi dettagli. Un DAG con centinaia di task a livello di modello può diventare rumoroso e lento da comprendere.
Dove falliscono di solito i flussi di lavoro ibridi
La maggior parte dei problemi di integrazione deriva da uno di questi tre schemi:
Airflow gestisce troppo SQL: una logica di trasformazione corposa all'interno degli operator si allontana dalle convenzioni di dbt e diventa difficile da testare o documentare.
Ci si aspetta che dbt gestisca lo stato del flusso di lavoro: i team presumono che un grafo di modelli completato con successo significhi che l'intera pipeline è in salute, anche quando le consegne a monte erano parziali o in ritardo.
Il passaggio di consegne non ha un contratto: le tabelle grezze sono presenti, ma non abbastanza complete perché dbt produca output validi.
Il modo migliore per fare debug è separare le domande sugli errori. Airflow ha avviato i passaggi giusti nell'ordine giusto? dbt ha compilato ed eseguito i modelli attesi? I dati risultanti si sono comportati normalmente dopo l'esecuzione? Trattatele come verifiche distinte, non come un unico stato aggregato.
Scegliere il pattern di integrazione
Non esiste un unico modo corretto di far lavorare insieme dbt e Airflow. Esistono pattern più o meno adatti al vostro team, a seconda di chi scrive il codice, di chi gestisce la piattaforma e di quanto lavoro infrastrutturale siete disposti a sostenere.
Quando Airflow dovrebbe restare al comando
Un pattern nativo di Airflow è adatto quando le vostre pipeline coinvolgono molti sistemi e il livello di orchestrazione conta già più del solo livello di trasformazione. È una situazione comune quando i flussi di lavoro includono dipendenze di ingestion, attese di file, job Python personalizzati, reverse ETL o fasi di machine learning.
In questa configurazione, Airflow resta l'interfaccia operativa principale e dbt è un task ben definito all'interno del DAG. Funziona particolarmente bene quando i platform engineer gestiscono già Airflow e vogliono un unico piano di controllo per retry, alert e pianificazioni.
Scegliete questo pattern quando:
Le operazioni sono in mano all'engineering: il team è a suo agio nel mantenere DAG, executor e processi di deployment.
La pipeline va oltre l'analytics: la trasformazione nel data warehouse è solo una fase tra tante.
Conta la gestione degli errori tra sistemi: vi serve un punto centrale per esaminare il coordinamento dei task, non solo l'esecuzione dei modelli SQL.
Quando è più adatto un pattern incentrato su dbt Cloud
Un pattern incentrato su dbt Cloud può funzionare se la complessità immediata è concentrata nel livello di trasformazione e il vostro team di analytics ha bisogno di assumere più rapidamente la responsabilità di build, test e flussi di deployment. In questo modello dbt gestisce una parte maggiore del ciclo di vita delle trasformazioni, mentre Airflow continua a coordinare tutto ciò che a monte o a valle va oltre il perimetro di dbt.
Questo pattern è di solito più facile da adottare per i team fortemente orientati all'SQL, perché la superficie di trasformazione resta più vicina a dove lavorano già. Può anche ridurre l'attrito di gestire dbt Core interamente in autonomia.
Mantenete esplicito il confine di controllo. Anche se è dbt Cloud a eseguire il job di trasformazione, Airflow resta parte dell'architettura quando il flusso di lavoro va oltre la modellazione nel data warehouse.
I criteri di scelta che contano davvero
Il pattern giusto dipende di solito dall'adattamento operativo, non dall'ideologia.
Composizione del team: più analisti e analytics engineer di solito spingono la logica verso dbt. Più platform engineer di solito aumentano la dimestichezza con un'integrazione guidata da Airflow.
Preferenze di deployment: i team che vogliono il controllo in self-hosting accettano spesso un maggiore carico operativo di Airflow e dbt Core. I team che vogliono meno manutenzione della piattaforma tendono a preferire soluzioni più gestite.
Stile di debug: alcuni team vogliono un'unica console di orchestrazione. Altri preferiscono che il dettaglio delle trasformazioni resti più vicino agli artefatti dbt e alla semantica dei modelli.
Forma della pipeline: se il vostro flusso di dati inizia e finisce nel data warehouse, dbt può avere un ruolo più centrale. Se attraversa continuamente servizi diversi, dovrebbe essere Airflow a guidare.
Ciò che non funziona è l'ambiguità. Se nessuno sa dire se un controllo di freschezza fallito, un caricamento in ritardo o un data mart rotto spetti all'orchestratore o al livello di trasformazione, l'architettura non è finita.
Completare il quadro con la Data Observability
Anche un'architettura pulita Airflow più dbt lascia un punto cieco. Potete sapere che il flusso di lavoro è stato eseguito e che i modelli sono stati costruiti con successo, e tuttavia distribuire dati errati. Questo perché lo stato dell'orchestrazione e il successo delle trasformazioni non equivalgono a una fiducia continua nei dati stessi.
Che cosa sfugge ancora a orchestrazione e trasformazione
Airflow vi dice se i task sono stati eseguiti. dbt vi dice se i modelli sono stati compilati, eseguiti e hanno superato i test che avete definito. Nessuno dei due, da solo, offre un monitoraggio continuo e adattivo dei cambiamenti di comportamento dei dati che attraversano il sistema.
Questa lacuna diventa evidente con problemi come distribuzioni in deriva, variazioni di volume insolite, arrivi in ritardo o deviazioni silenziose che non violano un'asserzione dbt codificata. Questi problemi spesso emergono per primi nelle dashboard, nei report per gli stakeholder o nel comportamento dei modelli di ML a valle.
Qui aiuta un inquadramento più ampio, soprattutto se il vostro team sta formalizzando le pratiche di Data Observability come un livello operativo separato invece di considerare la qualità un sottoprodotto dell'orchestrazione.
Perché conta un livello di monitoraggio indipendente
Il livello mancante è il monitoraggio continuo del comportamento effettivo dei dati. La piattaforma digna calcola le metriche dei dati interamente in-database, apprendendo le baseline e segnalando le anomalie senza configurazione manuale, manutenzione delle regole o codice Python, con un machine learning che opera in modo trasparente, continuo e su larga scala sulle tabelle configurate. La sua esecuzione in-database mantiene i dati nell'ambiente del cliente, riducendo gli spostamenti di dati e supportando volumi di scala enterprise in data warehouse, data lake e pipeline complesse, come descritto nella panoramica di digna sulle tecniche di rilevamento delle anomalie in-database.
Questo conta perché integra entrambi gli strumenti senza sostituirne nessuno. Airflow continua a orchestrare. dbt continua a trasformare. Un livello di observability verifica in modo indipendente se i dataset risultanti continuano a comportarsi come dovrebbero.
Uno stack robusto non si ferma a "il job è andato a buon fine". Si chiede se i dati che arrivano al business corrispondono ancora al comportamento normale.
Se state progettando uno stack attorno ad Airflow e dbt, digna aggiunge il livello che spesso si rivela necessario dopo il primo incidente silenzioso sui dati. Monitora il comportamento dei dati in-database, apprende automaticamente gli schemi normali e aiuta i team a intercettare le anomalie prima che output errati raggiungano report, modelli od operazioni.
Domande frequenti
Qual è la differenza tra dbt e Airflow?
Airflow è un orchestratore generalista che pianifica e mette in sequenza i task tra sistemi diversi. dbt è uno strumento di trasformazione che esegue modelli SQL all'interno del vostro data warehouse, con test e documentazione. Risolvono problemi diversi, ed è per questo che il confronto è di solito una falsa scelta.
Conviene usare dbt o Airflow?
La maggior parte dei team li usa entrambi. Airflow orchestra il flusso end-to-end, comprese ingestion, dipendenze esterne e trigger a valle; dbt gestisce il livello di trasformazione all'interno del data warehouse. Usare Airflow per scrivere a mano DAG di trasformazione significa ricreare ciò che dbt fa già bene.
In che cosa dbt dà il meglio?
Nell'esprimere le trasformazioni come modelli SQL sotto controllo di versione, con risoluzione delle dipendenze, test integrati, documentazione e lineage. Poiché viene eseguito nel data warehouse, sfrutta la capacità di calcolo che già pagate invece di spostare i dati verso un motore separato.
Che cosa dovrebbe orchestrare Airflow?
Tutto ciò che dbt non può vedere: estrazione dai sistemi sorgente, arrivo dei file, chiamate API, job di machine learning e la sequenza tra di essi. Airflow è il piano di controllo; dbt è un task ben strutturato al suo interno.
Come si integrano dbt e Airflow con il monitoraggio della data quality?
I test dbt intercettano le violazioni che avevate previsto in fase di build. Nessuno dei due strumenti vi dice che i dati sono arrivati puntuali ma sbagliati, o che una distribuzione si è spostata. È questa la lacuna coperta dal monitoraggio continuo e dal rilevamento delle anomalie, che operano accanto al livello di trasformazione anziché al suo interno.


