Dati obsoleti: significato e come evitare disastri in analytics e AI
|
7
min di lettura

Dati obsoleti significa che i dati sono ancora tecnicamente validi, ma troppo vecchi per il compito che chiedete loro di svolgere. Non riflettono la realtà attuale perché il processo di acquisizione si è fermato, ha rallentato o è rimasto indietro, e questo tipo di invecchiamento silenzioso può compromettere le decisioni senza generare errori evidenti.
Di solito ci si accorge del problema quando il danno è già fatto. Una dashboard sembra normale. Un modello continua a restituire previsioni. Un report arriva puntuale al management. Poi qualcuno chiede perché la campagna ha colpito il pubblico sbagliato, perché l'inventario risultava disponibile quando non lo era o perché un flusso automatizzato ha agito su informazioni già cambiate a monte.
Ecco perché il significato di dati obsoleti va ben oltre una definizione da dizionario. I dati obsoleti non sono dati rotti. Sono dati vecchi che sembrano ancora sani. Nella pratica, questo li rende più pericolosi di molti errori evidenti di qualità dei dati. I team spesso rilevano rapidamente picchi di valori nulli, rotture dello schema o job falliti. L'obsolescenza invece sfugge, perché la tabella esiste ancora, la query continua a funzionare e i valori superano ancora i controlli di base.
Anche la soluzione dipende da una diagnosi corretta del problema. Non ogni incidente sui dati è un problema di freschezza. Alcuni record sono corrotti. Alcuni dataset non vengono usati. Alcune pipeline sono in ritardo. Se trattate tutto questo come “dati non aggiornati”, perderete tempo ad applicare il rimedio sbagliato e lascerete il rischio reale al suo posto.
Indice
Il rischio nascosto nel vostro ultimo report
Che cosa sono davvero i dati obsoleti
Perché i dati obsoleti sono difficili da individuare
Dati obsoleti, corrotti e dark data
Dati obsoleti, latenza e data drift a confronto
Un confronto pratico
Perché i team li confondono
L'impatto dei dati obsoleti sul business
Dove il danno emerge per primo
Perché l'AI alza la posta in gioco
Come rilevare e monitorare i dati obsoleti
Iniziare con i controlli di freschezza
Aggiungere un monitoraggio che rifletta l'operatività reale
Prevenire i dati obsoleti con la observability moderna
Come si presenta la prevenzione nella pratica
Dove aiutano le piattaforme di observability
Costruire una fiducia duratura nei propri dati
Il rischio nascosto nel vostro ultimo report
Un VP apre una dashboard di segmentazione il lunedì mattina e approva una campagna. La logica del pubblico sembra corretta. Il grafico si carica. Nessuno vede errori. Più tardi il team scopre che i dati dei clienti alla base di quella dashboard non venivano aggiornati da giorni.
È un tipico guasto da dati obsoleti. I dati non erano malformati. Non mancavano. Semplicemente non corrispondevano più allo stato del business.
Per questo i dati obsoleti vanno trattati prima di tutto come un rischio di business e solo in secondo luogo come un problema di pipeline. Quando un dataset smette di aggiornarsi, ogni artefatto a valle eredita lo stesso problema. Le dashboard diventano istantanee storiche che fingono di essere attuali. I job di reverse ETL spingono nei sistemi operativi le ipotesi di ieri. Le feature di ML invecchiano finché le previsioni perdono rilevanza.
I dati obsoleti sono pericolosi proprio perché sembrano ancora utilizzabili.
I team meno esperti si aspettano spesso che le pipeline guaste falliscano in modo evidente. In realtà, molte non lo fanno. Un job pianificato può continuare a riuscire mentre l'estrazione a monte si è bloccata. Una tabella del data warehouse può restare interrogabile mentre il ritardo di replica la tiene indietro rispetto alla realtà. Un livello di cache può restituire record strutturalmente corretti che non sono più tempestivi.
Alcune conseguenze pratiche emergono rapidamente:
I manager prendono decisioni urgenti su un contesto vecchio. Marketing, pricing, assistenza e operations dipendono tutti dalla tempistica, non solo dalla correttezza.
La fiducia si erode in modo disomogeneo. Gli utenti potrebbero non abbandonare l'intero stack dati, ma iniziano a dubitare dei report che li hanno già traditi in passato.
I team creano soluzioni manuali alternative. Quando la fiducia cala, le persone esportano CSV, mantengono fogli di calcolo paralleli o chiedono all'ingegneria validazioni una tantum.
È in quest'ultimo passaggio che i costi crescono. Gli ingegneri smettono di migliorare i sistemi e iniziano a dimostrare se l'ultimo numero è abbastanza aggiornato da poter essere usato. A quel punto i dati obsoleti non sono più un incidente isolato, ma un problema del modello operativo.
Che cosa sono davvero i dati obsoleti
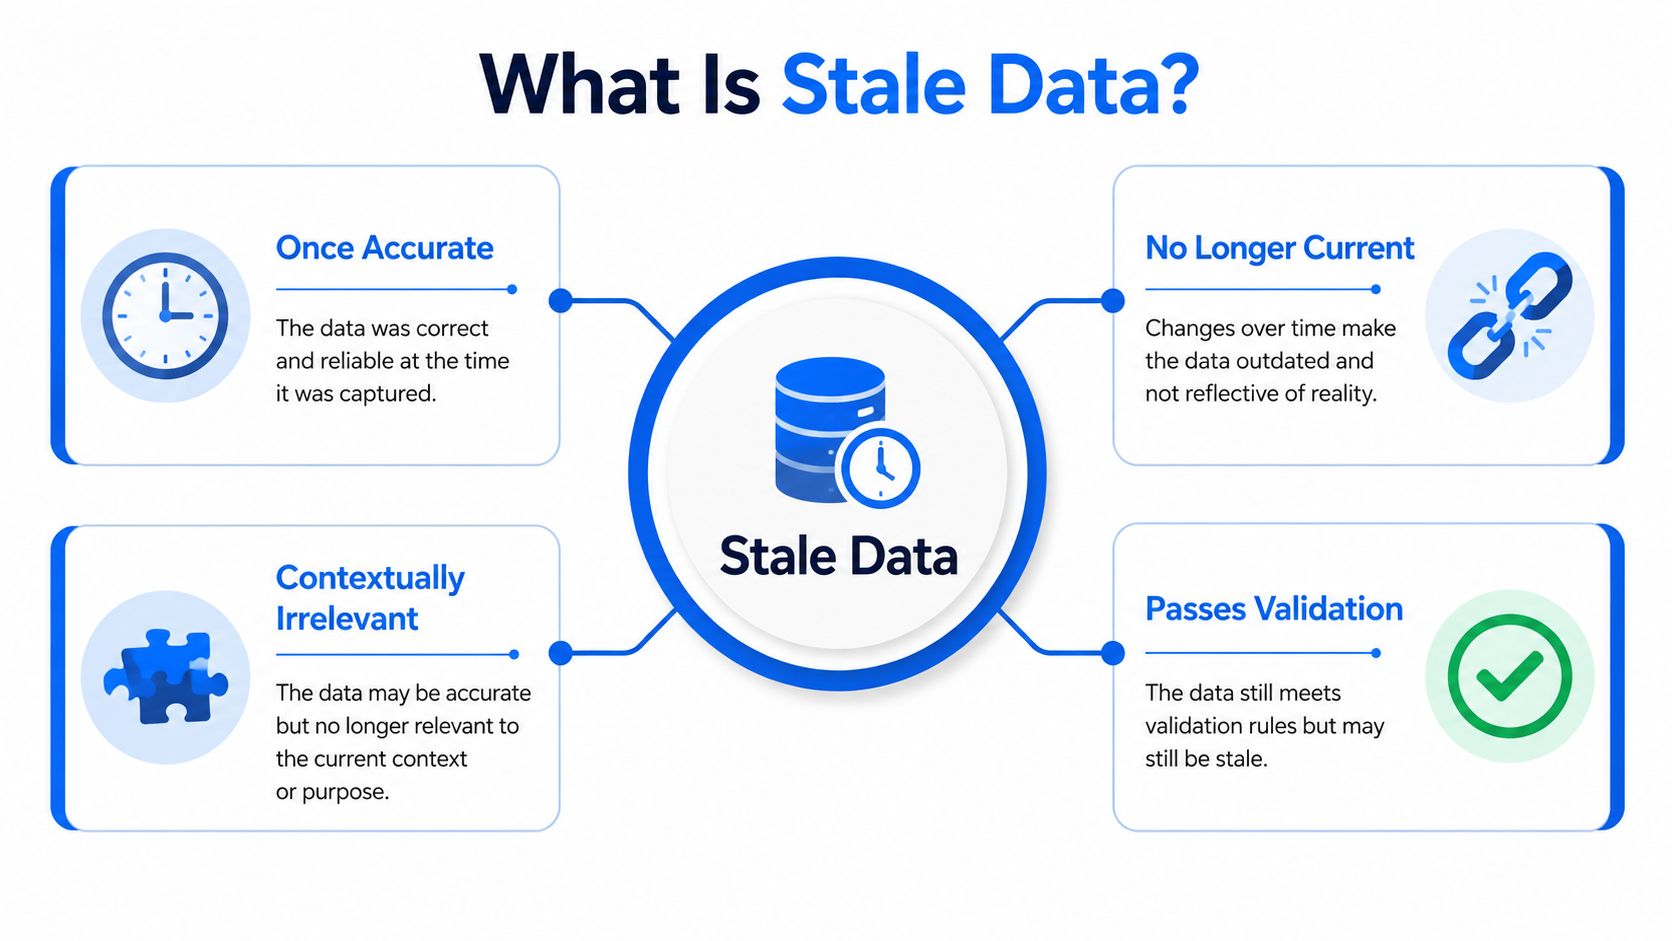
A livello tecnico, i dati obsoleti sono informazioni la cui età supera il ritardo massimo tollerabile per l'uso previsto. Tacnode li definisce come dati la cui età ha superato la soglia accettabile per l'uso operativo, spesso a causa della latenza delle pipeline batch, del ritardo di sincronizzazione delle cache o dei ritardi di replica, e osserva che nei sistemi di AI possono causare un data drift silenzioso senza i normali alert di errore (la spiegazione di Tacnode sui dati obsoleti).
Questa definizione è importante perché separa la validità dalla tempestività. Una riga può superare controlli di tipo, di unicità e di validazione delle regole di business, ed essere comunque sbagliata per la decisione da prendere, perché il mondo è cambiato dopo l'acquisizione.
Perché i dati obsoleti sono difficili da individuare
Spesso le organizzazioni scoprono il significato di dati obsoleti attraverso un errore. Un report “funziona” finché qualcuno non lo riconcilia con un sistema sorgente e nota lo scarto tra i timestamp. Questo perché i dati obsoleti di solito non violano le regole che già monitorate.
Una tabella con stati dei clienti vecchi ha ancora ID validi. I saldi vecchi sembrano comunque saldi. Gli eventi storici dei dispositivi vengono ancora deserializzati correttamente. Se i vostri controlli si concentrano solo su schema, valori nulli, intervalli o conteggi di righe, i dati obsoleti possono passare indisturbati.
Un modello mentale migliore è questo:
Il record un tempo era accurato
Il record sembra ancora strutturalmente corretto
Il record non riflette più lo stato attuale necessario per agire
Se volete un quadro più ampio su come la freschezza si inserisce nell'affidabilità dei dati, questa guida su freschezza dei dati e decisioni di business è un utile complemento.
Dati obsoleti, corrotti e dark data
È su questa distinzione che molti team sbagliano. Proofpoint distingue esplicitamente i dati obsoleti (stale data) dai dati corrotti (rotten data) e dai dark data, definendo i dati obsoleti come superati, inutilizzati o irrilevanti, i dati corrotti come inesatti o danneggiati e i dark data come informazioni non analizzate che restano nei sistemi senza essere usate (le definizioni di Proofpoint di stale, rotten e dark data).
Queste categorie richiedono risposte diverse.
Condizione dei dati | Che cosa significa | Sintomo tipico | Risposta corretta |
|---|---|---|---|
Dati obsoleti | Superati ma ancora validi | I valori sembrano corretti, ma la tempistica non lo è | Aggiornare la pipeline, imporre controlli di freschezza |
Dati corrotti | Inesatti o danneggiati | Valori non validi, logica errata, errori a livello di record | Validare i record, correggere le trasformazioni, risanare la qualità alla sorgente |
Dark data | Archiviati ma non analizzati | I dati si accumulano senza un responsabile né un utilizzo | Governare l'accesso, classificarli, archiviarli o attivarli |
Regola pratica: se un aggiornamento dei timestamp risolverebbe il problema, probabilmente si tratta di dati obsoleti. Se sono sbagliati i valori stessi, non lo sono.
Questo conta ancora di più nei sistemi di AI e ML. Un feature store obsoleto può fornire a un modello input che un tempo erano corretti ma non sono più attuali. Un set di feature corrotto crea una modalità di guasto diversa, perché i valori non sono validi al momento dell'inferenza. Un dataset di dark data crea un problema del tutto diverso, perché l'organizzazione archivia informazioni senza usarle né governarle bene.
Trattare tutte e tre come un'unica categoria porta a soluzioni generiche come “monitorare i timestamp ovunque”. Questo aiuta con l'obsolescenza, ma non ripara i record corrotti e non vi dice se i dati inutilizzati vadano conservati, analizzati o eliminati. È la precisione della diagnosi a rendere efficace la remediation.
Dati obsoleti, latenza e data drift a confronto
Questi termini vengono spesso confusi nelle revisioni degli incidenti, ma descrivono modalità di guasto diverse. Se li sovrapponete, l'analisi delle cause diventa confusa e i team iniziano a correggere i sintomi invece dei sistemi.
Un confronto pratico
Attributo | Dati obsoleti | Latenza dei dati | Data drift |
|---|---|---|---|
Problema principale | I dati sono troppo vecchi per il caso d'uso | I dati arrivano più tardi del previsto | Gli andamenti dei dati cambiano nel tempo |
Domanda principale | Questo dataset è ancora abbastanza aggiornato da poter essere usato? | Quanto tempo impiega un evento a comparire a valle? | Il comportamento sottostante è cambiato? |
Causa tipica | Aggiornamenti interrotti, refresh in ritardo, pipeline trascurate | Acquisizione lenta, elaborazione in coda, ritardi di rete o di sistema | Cambiamenti nei comportamenti reali, popolazioni che cambiano, input in evoluzione |
Che cosa vedono gli utenti | I report sembrano normali ma riflettono una realtà passata | Le dashboard restano indietro rispetto agli eventi in tempo reale | Gli output dei modelli si indeboliscono o perdono rilevanza |
Primo controllo consigliato | Timestamp dell'ultimo aggiornamento | Tempo tra l'evento e la disponibilità | Distribuzione e comportamento delle feature nel tempo |
La latenza riguarda il ritardo di trasporto. L'obsolescenza riguarda l'utilizzabilità rispetto a una soglia. Il drift riguarda un cambiamento nel processo che genera i dati.
Un buon esempio è l'inventario. Se avviene una vendita e l'aggiornamento compare nel data warehouse più tardi del previsto, si tratta di latenza. Se la tabella del data warehouse non si aggiorna da così tanto tempo che le giacenze non sono più utilizzabili per agire, si tratta di dati obsoleti. Se gli andamenti della domanda dei clienti cambiano e la vostra previsione della domanda non corrisponde più alla realtà, si tratta di data drift.
Perché i team li confondono
La confusione nasce perché questi problemi possono concatenarsi.
L'elaborazione batch introduce latenza per sua natura. Una latenza sufficiente può produrre dati obsoleti per un flusso sensibile ai tempi. Poi input del modello obsoleti possono contribuire a un silenzioso calo delle prestazioni che, dal lato del business, sembra drift.
Questa sequenza è particolarmente comune nei sistemi di ML. I team spesso monitorano se il modello è “attivo” e se le richieste di inferenza vanno a buon fine. Non sempre monitorano se i valori delle feature riflettono lo stato più recente di cui il modello ha bisogno. Il sistema continua a funzionare, ma non su un contesto attuale.
Un modo semplice per distinguerli durante il triage è porre tre domande, in quest'ordine:
Quando si è verificato l'evento alla sorgente?
Quando il sistema a valle lo ha ricevuto o reso disponibile?
Anche se è arrivato correttamente, è ancora abbastanza aggiornato per la decisione?
Queste domande scompongono il problema in modo netto. Prima la tempistica dello spostamento. Poi l'età al momento dell'uso. Infine il cambiamento di comportamento nel tempo.
L'impatto dei dati obsoleti sul business
Un report può essere tecnicamente corretto ed essere comunque sbagliato per la decisione da prendere.
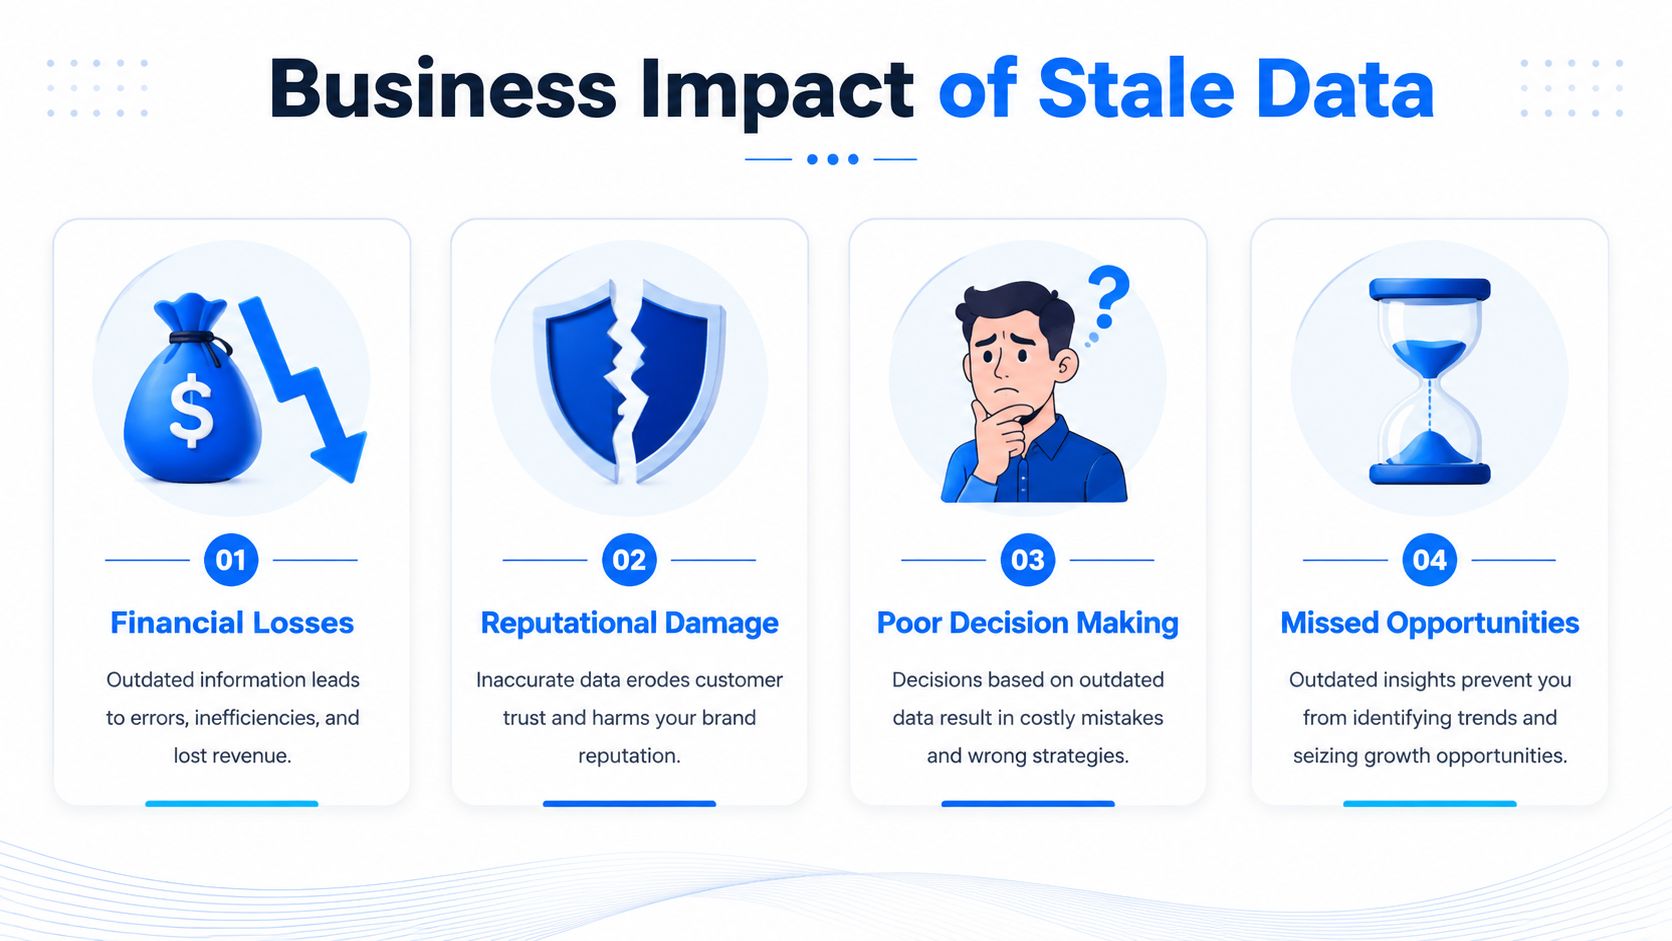
È così che i dati obsoleti danneggiano il business. I numeri tornano. La dashboard si carica. Il modello restituisce una previsione. Ma lo stato sottostante è già cambiato, quindi i team agiscono su una versione del business che non esiste più.
Dove il danno emerge per primo
Il primo impatto è di solito operativo. Le vendite lavorano sugli account sbagliati perché lo stato dell'account è cambiato dopo l'ultima sincronizzazione. Gli operatori dell'assistenza rispondono senza il contesto più recente su utilizzo del prodotto o fatturazione. La finanza chiude la settimana con report che riflettono uno stato precedente di ordini, rimborsi o movimenti di cassa. Ogni team prende una decisione ragionevole dal proprio punto di vista, ma il quadro condiviso non è aggiornato.
Il costo non è solo una scelta sbagliata. È il lavoro da rifare.
I team passano tempo a riconciliare sistemi, rieseguire analisi e spiegare perché azioni basate su dati “attuali” hanno dovuto essere annullate. Dopo che succede qualche volta, la fiducia crolla rapidamente. Gli utenti di business smettono di considerare le dashboard come strumenti per agire e iniziano a trattarle come indicazioni approssimative. Gli analisti vengono coinvolti in validazioni manuali, tornano i fogli di calcolo paralleli e i cicli decisionali rallentano.
L'effetto cambia a seconda del settore. Nel retail e nel marketing, dati di segmentazione o di inventario obsoleti portano a campagne mal indirizzate, promozioni inefficaci e problemi di scorte evitabili. Nella sanità, un contesto operativo o clinico obsoleto può spingere il personale verso priorità non sicure. Nella finanza, motori di regole e automazioni a valle continuano a funzionare finché qualcuno non li ferma esplicitamente, quindi input vecchi possono attivare il blocco, l'approvazione o l'escalation sbagliati.
È anche qui che conta la distinzione tra dati obsoleti, corrotti e dark data. I dati obsoleti possono essere ancora strutturalmente validi e pertinenti, ma sono troppo vecchi per la decisione. I dati corrotti sono dati di bassa qualità: sbagliati, danneggiati, duplicati o incompleti. I dark data sono dati che l'organizzazione archivia ma non usa né governa attivamente. Queste categorie richiedono risposte diverse. I dati obsoleti richiedono controlli di freschezza e SLA. I dati corrotti richiedono interventi sulla qualità. I dark data richiedono inventario, responsabili e decisioni sulla conservazione. Se un team tratta tutti e tre come lo stesso problema, di solito sceglie la soluzione sbagliata e lascia in piedi il rischio per il business.
Un modo utile per inquadrare la questione è la tempestività dei dati. L'età accettabile di un dataset dipende dalla decisione che supporta, non dal fatto che la pipeline si sia conclusa correttamente. Questa guida pratica alla tempestività dei dati nei sistemi operativi è un buon riferimento se il vostro team deve definire queste soglie in modo più chiaro.
Vale la pena guardare un breve video esplicativo se volete un inquadramento visivo semplice prima di costruire i controlli:
Perché l'AI alza la posta in gioco
IBM osserva che gli SLA di freschezza sono particolarmente importanti nei sistemi decisionali automatizzati e negli ambienti di dati in tempo reale, dove anche un ritardo modesto può peggiorare i risultati, e sottolinea che i sistemi di AI agentica creano nuove modalità di guasto perché possono avviare azioni automatiche sulla base di dati obsoleti; per questo gli SLA devono essere legati alla latenza delle azioni, non solo all'età dei dati (IBM su dati obsoleti e SLA di freschezza).
Nella pratica, i sistemi di AI sono meno indulgenti dei flussi di lavoro umani. Chi usa una dashboard può notare che i numeri di ieri sembrano strani e fare domande prima di agire. Un servizio di raccomandazione, un consumatore di un feature store o un flusso agentico di solito non si ferma per questa verifica. Consuma ciò che è disponibile e procede come se il contesto fosse attuale.
Questo trasforma la modalità di guasto da un'analisi sbagliata a un'azione sbagliata. Un modello di pricing può usare segnali di domanda scaduti. Un flusso antifrode può valutare una transazione rispetto a uno stato dell'account vecchio. Un copilota per l'assistenza clienti può generare consigli a partire da telemetria di abbonamenti o prodotti obsoleta. Il sistema sembra sano perché le richieste vanno a buon fine, ma la qualità dell'output cala in modi costosi e difficili da ricostruire.
La policy di freschezza dovrebbe essere commisurata alle conseguenze per il business. Un dataset di pianificazione settimanale può tollerare un'età maggiore rispetto a una tabella di feature usata per decisioni in tempo reale. Trattarli allo stesso modo è ciò che trasforma i dati obsoleti da un fastidio di reporting in un rischio operativo.
Come rilevare e monitorare i dati obsoleti
Il rilevamento parte da un'idea di base: dovete sapere quanto sono vecchi i dati in questo momento, non quando si riteneva che la pipeline fosse sana l'ultima volta.
DQOps descrive chiaramente il metodo principale di rilevamento: monitorare la freschezza calcolando il tempo trascorso dall'ultimo aggiornamento, di solito tramite una colonna di data o timestamp, ed esporre queste metriche di freschezza in dashboard, così che i team vedano quali tabelle contengono i dati più vecchi (DQOps sul rilevamento dei dati obsoleti con timestamp e dashboard).
Iniziare con i controlli di freschezza
Se partite da zero, iniziate con una breve lista di dataset critici e ponete per ciascuno una domanda semplice: quale timestamp rappresenta meglio l'ultimo aggiornamento affidabile?
Per alcune tabelle è un timestamp di acquisizione. Per altre è un timestamp dell'evento o una data di efficacia di business. Scegliete il campo che riflette l'effettiva attualità per il caso d'uso, non solo i meccanismi di caricamento.
Poi implementate alcuni controlli concreti:
Monitorate l'età del timestamp massimo. Confrontate l'orario del record più recente con l'ora attuale.
Separate la freschezza alla sorgente da quella nel data warehouse. Un caricamento riuscito non significa che i dati a monte fossero aggiornati.
Visualizzate per prime le tabelle più vecchie. I team hanno bisogno di una vista che renda evidenti i dataset trascurati.
Se considerate la freschezza come parte di una pratica di affidabilità più ampia, questa pagina sul monitoraggio della tempestività dei dati mostra come i team inquadrano la tempestività dal punto di vista operativo.
Aggiungere un monitoraggio che rifletta l'operatività reale
I controlli sui timestamp intercettano i blocchi evidenti. Un buon monitoraggio va oltre e riflette il comportamento abituale della pipeline.
Una configurazione pratica di solito include:
Finestre di arrivo previste
Se una tabella si aggiorna di solito secondo una pianificazione, monitorate se l'aggiornamento è arrivato entro la sua finestra normale. Così si intercettano i job in ritardo ma non ancora del tutto falliti.Controlli su volumi e andamenti
Una tabella può continuare ad aggiornarsi ma con volumi sospettosamente bassi, partizioni parziali o porzioni mancanti. Spesso è il segnale dell'inizio di un problema di freschezza.Consapevolezza delle modifiche allo schema
Modifiche alle colonne a monte, campi rinominati o cambi di tipo spesso rompono la logica di aggiornamento prima che qualcuno noti l'aumento dell'età a valle.Alert basati sull'impatto
L'instradamento degli alert dovrebbe riflettere chi è responsabile del problema e quali consumatori a valle sono interessati. Un alert di freschezza senza un percorso di responsabilità crea solo rumore.
Non monitorate la freschezza solo come proprietà delle tabelle. Monitoratela come proprietà delle decisioni che dipendono da quelle tabelle.
Questo cambia il significato di “abbastanza buono”. Una tabella dimensionale usata per un reporting che cambia lentamente può tollerare una soglia più permissiva. Una tabella di feature che alimenta azioni automatiche probabilmente no.
Prevenire i dati obsoleti con la observability moderna
Un incidente da dati obsoleti di solito inizia molto prima che qualcuno lo chiami incidente. La dashboard si carica ancora. La pipeline è ancora verde. Il modello continua a calcolare punteggi. Ma un flusso a monte si è fermato sei ore fa, un job di replica è in ritardo o una modifica allo schema ha fatto fallire parte dell'aggiornamento. Quando un utente di business se ne accorge, il team sta già lavorando con dati che sembrano validi e non lo sono.
Prevenire significa progettare in funzione di queste modalità di guasto, invece di trattare la freschezza come un controllo una tantum.
Come si presenta la prevenzione nella pratica
I controlli migliori sono operativi. Definiscono chi risponde, che cosa significa “abbastanza aggiornato” e come il team rileva i problemi prima che i dati obsoleti raggiungano un punto decisionale.
Assegnate responsabilità esplicite. Ogni dataset critico per il business ha bisogno di un responsabile designato per la freschezza. Senza, i dati obsoleti finiscono nella terra di nessuno tra i team di piattaforma, analytics e applicazioni.
Definite i requisiti di freschezza in base alla decisione, non alla tabella. Uno snapshot finanziario usato per la chiusura mensile ha una tolleranza diversa da una tabella di feature che alimenta raccomandazioni automatiche. È anche qui che conta la distinzione tra dati obsoleti, corrotti e dark data. I dati obsoleti possono essere ancora utilizzabili per alcuni report a basso rischio. I dati corrotti sono sbagliati o danneggiati e richiedono una risposta diversa. I dark data possono restare inutilizzati e andrebbero governati o dismessi, anziché aggiornati.
Usate timestamp e versionamento. Ogni caricamento dovrebbe lasciare traccia di quando è stato eseguito, di quale snapshot della sorgente ha usato e se le tabelle a valle sono state ricostruite dagli input corretti. Questo rende molto più rapidi rollback, revisione degli incidenti e analisi delle cause.
Riducete la verifica manuale. I controlli a campione aiutano durante il debug, ma non scalano su decine di pipeline, archivi replicati e input dei modelli.
I team devono anche scegliere dove investire gli sforzi. Lo streaming di ogni sorgente non è sempre giustificato. Aggiornamenti più frequenti aumentano i costi infrastrutturali, il carico sui sistemi a monte e il volume degli alert. L'obiettivo giusto è la configurazione più economica che mantenga i dati entro la tolleranza del processo di business che supportano.
Dove aiutano le piattaforme di observability
La observability funziona meglio quando segue l'intero percorso dalla sorgente al consumatore. Uno scheduler di job può dirvi che un'attività è stata completata. Non può dirvi se i dati sorgente erano già obsoleti, se è arrivata solo una parte di una partizione o se una tabella di feature a valle è ora fuori dal suo livello di servizio.
Un'utile guida alla data observability per la gestione moderna dei dati spiega perché i team hanno bisogno di visibilità a livello di pipeline invece di controlli isolati. Nella pratica, significa monitorare in un unico posto finestre di arrivo previste, anomalie nei conteggi di righe e nelle partizioni, modifiche allo schema, lineage e dipendenze a valle.
Questo conta ancora di più per i sistemi di AI e ML. Una dashboard di reporting con dati obsoleti può portare a una riunione sbagliata. Un modello addestrato o eseguito su feature obsolete può continuare a prendere decisioni sbagliate finché qualcuno non interviene. La soluzione raramente è “aggiornare tutto più in fretta”. Consiste nel definire aspettative di freschezza per ogni set di feature, osservare i cambiamenti a monte che le violano e bloccare le azioni automatiche quando i dati sono fuori tolleranza.
Per i team che valutano le piattaforme, digna è un esempio che combina monitoraggio della tempestività, rilevamento delle anomalie, validazione a livello di record e tracciamento dello schema, eseguendo le analisi all'interno dell'ambiente del cliente. Questo mix è utile perché i problemi di dati obsoleti si presentano spesso insieme ad altri segnali, come un caricamento in ritardo, un cambio di tipo e un calo di volume imprevisto causati dallo stesso problema a monte.
La stessa disciplina vale anche al di fuori dell'analisi interna. Negli ambienti di commercio, i dati su prodotti, inventario e clienti spesso passano attraverso app, cache ed esportazioni prima che qualcuno li usi. Questi approfondimenti sull'accuratezza dei dati nell'eCommerce ricordano che la prevenzione dipende dal mantenere i dati operativi abbastanza aggiornati per l'azione che guidano, non solo dal mantenere verdi le pipeline.
Le soglie di freschezza universali falliscono perché i processi di business non hanno tutti la stessa tolleranza ai ritardi. Una prevenzione efficace nasce da una observability legata all'utilizzo, da responsabilità legate alla risposta e da controlli che distinguono i dati obsoleti dagli altri problemi di qualità dei dati che richiedono un rimedio diverso.
Costruire una fiducia duratura nei propri dati
Il vero significato di dati obsoleti non è “dati vecchi”. Sono dati diventati inadatti a una decisione specifica pur sembrando ancora utilizzabili. Per questo causano più danni di molti guasti evidenti.
I team che gestiscono bene questo problema fanno tre cose con costanza. Distinguono i dati obsoleti dai dati corrotti e dai dark data. Monitorano la freschezza come requisito operativo, non come audit occasionale. E collegano la remediation all'impatto sul business, soprattutto dove modelli e flussi automatizzati agiscono più rapidamente di quanto le persone possano controllare.
Questa disciplina conta anche al di fuori dell'analytics. Se lavorate con dati di commercio o di clienti, questi approfondimenti sull'accuratezza dei dati nell'eCommerce offrono una prospettiva utile sul perché informazioni pulite e aggiornate incidano sull'esecuzione quotidiana tanto quanto sul reporting per il management.
La fiducia nei dati non nasce da una singola dashboard o da un'esecuzione riuscita della pipeline. Nasce da evidenze ripetibili che i dati sono abbastanza aggiornati, accurati e governati per l'azione che guidano.
Se report obsoleti, caricamenti in ritardo o modifiche silenziose allo schema continuano a costringere il vostro team a rincorrere le emergenze, digna merita una valutazione. Si concentra su tempestività, anomalie, validazione e tracciamento dello schema, così i team dati possono intercettare i problemi di freschezza prima che raggiungano dashboard, modelli e decisioni operative.
Domande frequenti
Che cosa si intende per dati obsoleti?
I dati obsoleti (stale data) sono ancora tecnicamente validi, ma troppo vecchi per il compito che chiedete loro di svolgere. Non riflettono più la realtà attuale perché l'acquisizione si è fermata, ha rallentato o è rimasta indietro, eppure ogni valore supererebbe un controllo di formato o di intervallo.
Perché i dati obsoleti sono difficili da individuare?
Perché nulla sembra rotto. Le righe sono ben formate, lo schema è intatto e il report si visualizza normalmente. Senza un'aspettativa esplicita di freschezza, una tabella che fornisce i numeri di ieri è indistinguibile da una che fornisce quelli di oggi.
Qual è la differenza tra dati obsoleti, latenza e drift?
La latenza è il ritardo normale e previsto tra un evento e la sua disponibilità. L'obsolescenza è una latenza che ha superato quanto il caso d'uso può tollerare. Il drift è un cambiamento delle caratteristiche statistiche dei dati, che può verificarsi anche quando i dati sono perfettamente aggiornati.
Come si rilevano i dati obsoleti?
Iniziate con controlli di freschezza che confrontano il timestamp più recente con una soglia derivata dalle esigenze di chi usa i dati. Poi aggiungete il monitoraggio dell'andamento effettivo degli arrivi, perché un flusso che di solito arriva ogni ora e improvvisamente arriva una volta al giorno è obsoleto molto prima che scatti una soglia assoluta.
Perché i dati obsoleti contano di più per l'AI?
Perché i modelli agiscono sugli input in modo automatico e su larga scala, senza che una persona noti che un numero sembra vecchio. Una feature obsoleta degrada silenziosamente le previsioni in ogni decisione toccata dal modello, e il danno si accumula prima che qualcuno riconcili un report.


