Dati affidabili sono dati validi: una guida pratica
|
7
min di lettura
È lunedì mattina. La dashboard per il management è verde, i ricavi sembrano stabili e la pipeline notturna si è conclusa senza errori. Martedì pomeriggio un product manager scopre che i tassi di conversione sono sbagliati da tre giorni, perché una modifica di schema a monte ha cambiato il modo in cui venivano gestiti i valori null. Dal punto di vista operativo non è fallito nulla. Il workflow è stato eseguito secondo il calendario e ha consegnato i dati in tempo. Erano i dati stessi a non essere più validi.
Questa distinzione è all'origine di alcuni degli incidenti più costosi nelle piattaforme dati moderne. Dati affidabili sono dati validi, ma una pipeline che gira con regolarità non produce automaticamente record di cui fidarsi. L'affidabilità in produzione dipende dal fatto che i dati restino corretti, aggiornati, strutturalmente compatibili e adatti alla decisione che supportano.
Indice
Come tempestività e stabilità dello schema completano il quadro
Controlli pratici per ottenere sia validità sia affidabilità
Perché la validazione statica non basta per le piattaforme dati moderne
Quando dati affidabili non superano il test di validità
Il primo alert di solito non è un alert. È una domanda su Slack.
“Perché la conversione è calata per un canale?”
La dashboard mostra ancora un aggiornamento riuscito. L'orchestrazione dei job non segnala errori. Il numero di righe sembra plausibile e il data warehouse ha accettato ogni record. Un rapido confronto rivela che un servizio a monte ha cambiato la rappresentazione dei valori mancanti. La trasformazione è stata comunque eseguita, ma la sua logica di join e di aggregazione ha trattato quei valori in modo diverso. Una metrica che sembrava stabile veniva calcolata su un significato cambiato.
È questo il pericoloso divario tra affidabilità della pipeline e validità dei dati. Una pipeline affidabile può completare ogni attività pianificata consegnando record che violano il significato di business. Anche un dataset valido può diventare inaffidabile dal punto di vista operativo se arriva troppo tardi, arriva incompleto o cambia forma senza preavviso.
Una pipeline verde può comunque essere sbagliata
Il monitoraggio di base risponde spesso a domande operative:
Il job è partito?
È terminato?
Il data warehouse ha accettato la query?
L'attività prevista ha prodotto un output?
La dashboard si è aggiornata?
Questi controlli sono importanti, ma non dicono se un identificativo cliente corrisponde ancora al cliente corretto, se un timestamp appartiene al periodo di rendicontazione previsto o se un codice di stato resta all'interno del vocabolario di business approvato.
La validità è il controllo che collega un'elaborazione riuscita a un output significativo. IBM descrive la validità come una dimensione distinta della qualità dei dati che riguarda vincoli di formato, tipo, intervallo e regole di business, osservando che dati plausibili possono comunque essere non validi quando violano aspettative strutturali o semantiche, come spiegato nella sua spiegazione delle dimensioni della qualità dei dati.
Un'email malformata, un'età negativa, un codice inatteso o una chiave di join null possono superare l'ingestione perché il livello di storage li consente. I modelli e i report a valle ereditano poi il difetto. Più il record viaggia, più diventa difficile individuarne la causa originaria.
Regola pratica: un'esecuzione riuscita dimostra che il software ha completato il suo lavoro. Non dimostra che il risultato meriti fiducia.
L'esposizione per il business è considerevole. Un articolo del 2017 della MIT Sloan Management Review citava ricerche secondo cui i dati di cattiva qualità costano alla maggior parte delle aziende tra il 15% e il 25% dei ricavi a causa di decisioni, reporting e performance finanziarie distorti (riferimento della MIT Sloan Management Review). Questa stima aiuta a spiegare perché la validità debba far parte dei controlli aziendali, e non solo delle checklist di ingegneria.
Validità e affidabilità dei dati
Una pipeline può completarsi correttamente alle 2 di notte e pubblicare comunque dati inutilizzabili entro l'ora di colazione. Un campo può essere interpretato correttamente, un job può diventare verde e una dashboard può aggiornarsi mentre i record violano le regole che danno loro significato. Validità e affidabilità descrivono controlli diversi per intercettare questo tipo di errore.
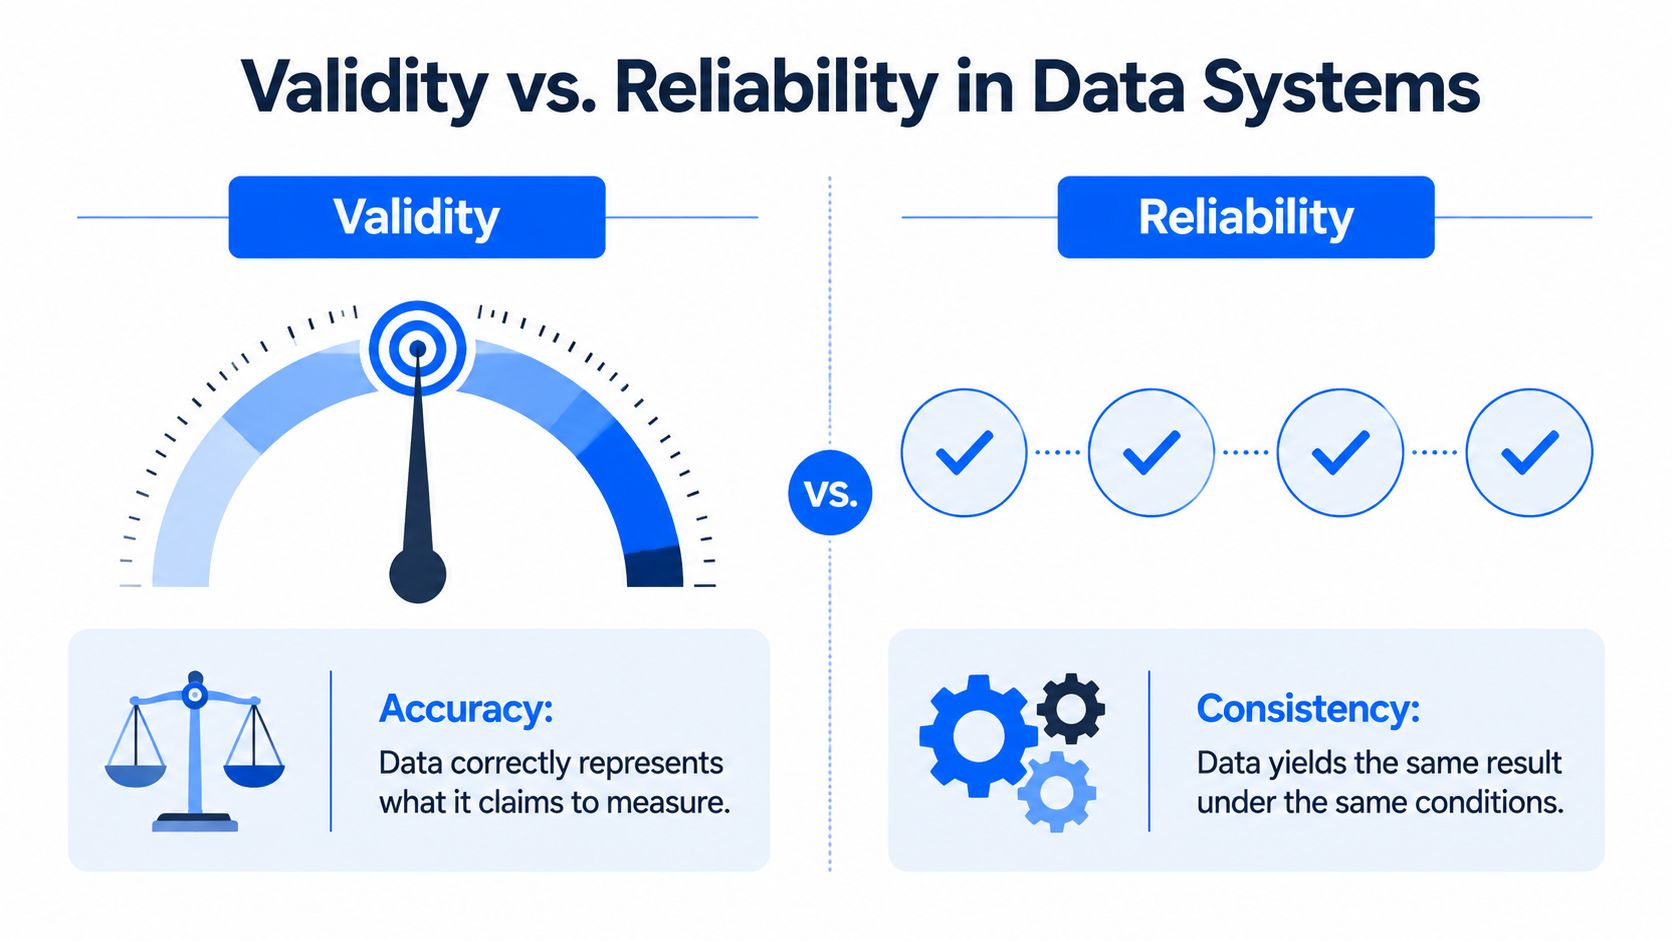
La validità si chiede se un record rappresenta ciò che dichiara di rappresentare e se rispetta le regole per i dati accettabili. L'affidabilità si chiede se i risultati restano coerenti nel tempo e al variare delle condizioni di misurazione. Il riferimento agli standard statistici delle Nazioni Unite tratta le due come proprietà correlate ma distinte.
Una bilancia che segna costantemente 5 libbre in più è affidabile perché produce risultati ripetibili, ma non è valida perché le sue letture non corrispondono al peso reale. Una bilancia che oscilla in modo casuale non è né affidabile né valida.
Che cosa significa validità in produzione
In una piattaforma dati la validità non riguarda solo il fatto che un valore sembri plausibile. Gli ingegneri verificano comunemente:
Conformità del tipo: i campi numerici contengono numeri, le date vengono interpretate correttamente e gli identificativi mantengono la rappresentazione richiesta.
Conformità dell'intervallo: i valori restano entro limiti inferiori e superiori significativi.
Conformità del formato: email, codici, numeri di telefono e timestamp corrispondono ai pattern accettati.
Integrità referenziale: le chiavi esterne rimandano a record nella dimensione o nella tabella di riferimento corretta.
Conformità alle regole di business: i campi correlati sono coerenti tra loro e con il processo che descrivono.
Un'età del cliente pari a 37 può essere accurata e valida. Un'età negativa non è valida anche se il database la accetta. Un timestamp può rispettare il formato richiesto pur rappresentando l'evento sbagliato, perché un sistema a monte ha applicato un fuso orario inatteso.
La distinzione tra accuratezza e validità conta in produzione. L'accuratezza riguarda il fatto che un valore rifletta la realtà. La validità riguarda la sua conformità al data contract e al disegno di misurazione. Un valore può sembrare ragionevole e tuttavia violare una regola che protegge l'interpretazione a valle. La guida alla validità dei dati spiega come i team possono valutare questa distinzione nella pratica.
Perché l'affidabilità richiede più della coerenza
L'affidabilità comprende disponibilità costante, consegna completa e arrivo entro i tempi richiesti da una decisione. Una pipeline che ripete ogni notte la stessa trasformazione difettosa è coerente, ma il suo output non è un'evidenza affidabile. Anche record validi che arrivano dopo una riunione di pianificazione possono risultare inutilizzabili.
I Worldwide Governance Indicators della Banca Mondiale raccolgono dati standardizzati e multi-fonte per oltre 200 economie dal 1996 al 2024, utilizzando 35 fonti internazionali come indagini sulle famiglie, indagini sulle imprese e valutazioni di esperti. I confronti tra mercati richiedono dati che restino strutturalmente validi e prodotti in modo coerente.
L'osservabilità collega queste proprietà sul piano operativo. Controlli di freschezza, alert sulle modifiche di schema, monitoraggio dei volumi e andamenti delle violazioni delle regole mostrano se i record validi continuano ad arrivare secondo uno schema affidabile. “La pipeline è affidabile” dovrebbe descrivere il comportamento di consegna. “I dati sono validi” dovrebbe descrivere conformità e significato. La fiducia in produzione richiede entrambe le cose.
Modalità di errore comuni che minano la fiducia nei dati
Una pipeline può superare i controlli di ingestione e corrompere comunque il dataset in seguito. Gli errori compaiono di solito quando i record incontrano trasformazioni, join, regole di business o strutture a monte che cambiano. I controlli in produzione devono testare queste interazioni, non solo campi isolati.
Schema drift silenzioso
Un servizio a monte aggiunge, rimuove, rinomina o cambia il tipo di un campo. Il consumer può continuare a funzionare perché la query viene ancora interpretata o perché un payload flessibile accetta la modifica. Una trasformazione può quindi mappare il campo sbagliato, scartare un nuovo stato o alterare il comportamento dei null senza sollevare alcun errore operativo. Le indicazioni di digna sullo schema drift descrivono come le modifiche strutturali possano compromettere i consumer senza essere rilevate.
Propagazione dei null
Una chiave di join obbligatoria diventa null in una piccola parte dei record in arrivo. I controlli di schema e di tipo a livello di sorgente vengono comunque superati, ma il join esclude quei record. Le tabelle dei fatti perdono righe correlate e gli aggregati risultano sottostimati senza un chiaro errore di ingestione. I controlli sulle distribuzioni e il monitoraggio delle corrispondenze dei join possono far emergere questa lacuna.
Disallineamenti di fuso orario
Un timestamp può restare sintatticamente valido mentre cambia l'interpretazione del suo fuso orario. Le aggregazioni orarie, giornaliere o mensili assegnano quindi gli eventi al periodo sbagliato. Un validatore di formato approva il valore anche se il suo significato analitico è cambiato. Il monitoraggio dovrebbe confrontare le ipotesi sul fuso orario e il comportamento ai limiti dei periodi, soprattutto in prossimità delle scadenze di rendicontazione.
Consegne duplicate
Lo streaming at-least-once può consegnare lo stesso evento più di una volta. La validazione a livello di riga approva ogni copia, perché ogni record è valido singolarmente. Senza idempotenza o deduplicazione, gli aggregati di ricavi, attività e transazioni risultano gonfiati. Gli identificativi degli eventi e gli alert sul tasso di duplicati forniscono un controllo a livello di evento di business.
Dimensioni obsolete
Un record dei fatti può contenere una chiave apparentemente valida che però non esiste nella tabella delle dimensioni corrente. La validazione di schema standard non mostra che i dati di riferimento sono vecchi. Dopo il join, gli analisti possono vedere categorie sconosciute, attributi mancanti o segmentazioni compromesse. I controlli di integrità referenziale e quelli di freschezza delle dimensioni intercettano parti diverse del problema.
Modalità di errore | Che cosa intercetta la validazione di base | Che cosa si rompe in produzione |
|---|---|---|
Schema drift silenzioso | Interpretabilità e tipi di campo attesi | Trasformazioni, join o mappature usano una struttura modificata |
Propagazione dei null | Tipo di colonna e formato di base | I join scartano record e i totali a valle diventano incompleti |
Disallineamento di fuso orario | Sintassi del timestamp | Le finestre delle serie temporali assegnano gli eventi al periodo sbagliato |
Consegne duplicate | Validità della singola riga | Gli aggregati contano più volte lo stesso evento di business |
Dimensioni obsolete | Struttura della tabella dei fatti | I join con i riferimenti perdono attributi o creano chiavi non risolte |
La lezione operativa è diretta: la validità dei record è necessaria ma non sufficiente. I test devono osservare anche relazioni, distribuzioni, comportamento di consegna e cambiamenti strutturali. L'osservabilità collega questi controlli ai risultati, mostrando se un dataset valido continua ad arrivare con la forma, il volume e le tempistiche attesi. Senza questa visione, i team validano i singoli elementi senza accorgersi del guasto del sistema.
Come tempestività e stabilità dello schema completano il quadro
Un record può superare ogni regola di validazione al momento della creazione ed essere comunque sbagliato per la decisione che supporta. Se lo snapshot delle scorte di ieri arriva dopo l'esecuzione dell'allocazione di oggi, tipi, intervalli e regole di business possono essere tutti validi. Il dataset resta comunque inadeguato, perché non rappresenta più lo stato operativo.
La freschezza è quindi un vincolo di validità temporale. Il monitoraggio dovrebbe verificare che i dati attesi siano arrivati, che nessun batch manchi e che i record più recenti restino all'interno della finestra operativa concordata. Questa guida alla tempestività dei dati, alle metriche e al monitoraggio spiega come rendere misurabile quella finestra. Una guida pratica al monitoraggio della freschezza offre lo stesso focus operativo: “i dati devono essere aggiornati” deve diventare una condizione che può essere superata, fallire e innescare un'azione.
Tre assi per la prontezza alla produzione
Valutate ogni dataset critico lungo tre assi collegati:
Correttezza: i valori soddisfano i requisiti di tipo, formato, intervallo, relazioni e regole di business.
Freschezza: i dati arrivano entro la finestra di consegna concordata e riflettono lo stato rilevante del business.
Stabilità strutturale: campi, tipi, tabelle e relazioni restano compatibili con i sistemi che li utilizzano.
Un dataset può soddisfare un asse e fallire su un altro. Un'esportazione clienti può contenere record corretti ma arrivare dopo l'inizio di una campagna. Un feed in streaming può arrivare in modo continuo duplicando però gli eventi. Una tabella può mantenere il proprio schema anche dopo che una sorgente ha cambiato il significato di un codice di stato.
La stabilità dello schema è un contratto attivo
Le modifiche di schema richiedono una valutazione d'impatto, non un rifiuto automatico. Una nuova colonna nullable può essere sicura per i consumer che ignorano i campi sconosciuti. Una colonna eliminata, un campo rinominato o un cambio di tipo possono invece compromettere una trasformazione o alterarne sottilmente l'output.
L'osservabilità collega freschezza, schema drift, variazioni di volume e guasti delle pipeline invece di trattarli come alert isolati. L'analisi di Ataccama su data quality e data observability descrive la freschezza come attualità, lo schema drift come cambiamento strutturale e le anomalie di volume come variazioni impreviste delle dimensioni del dataset.
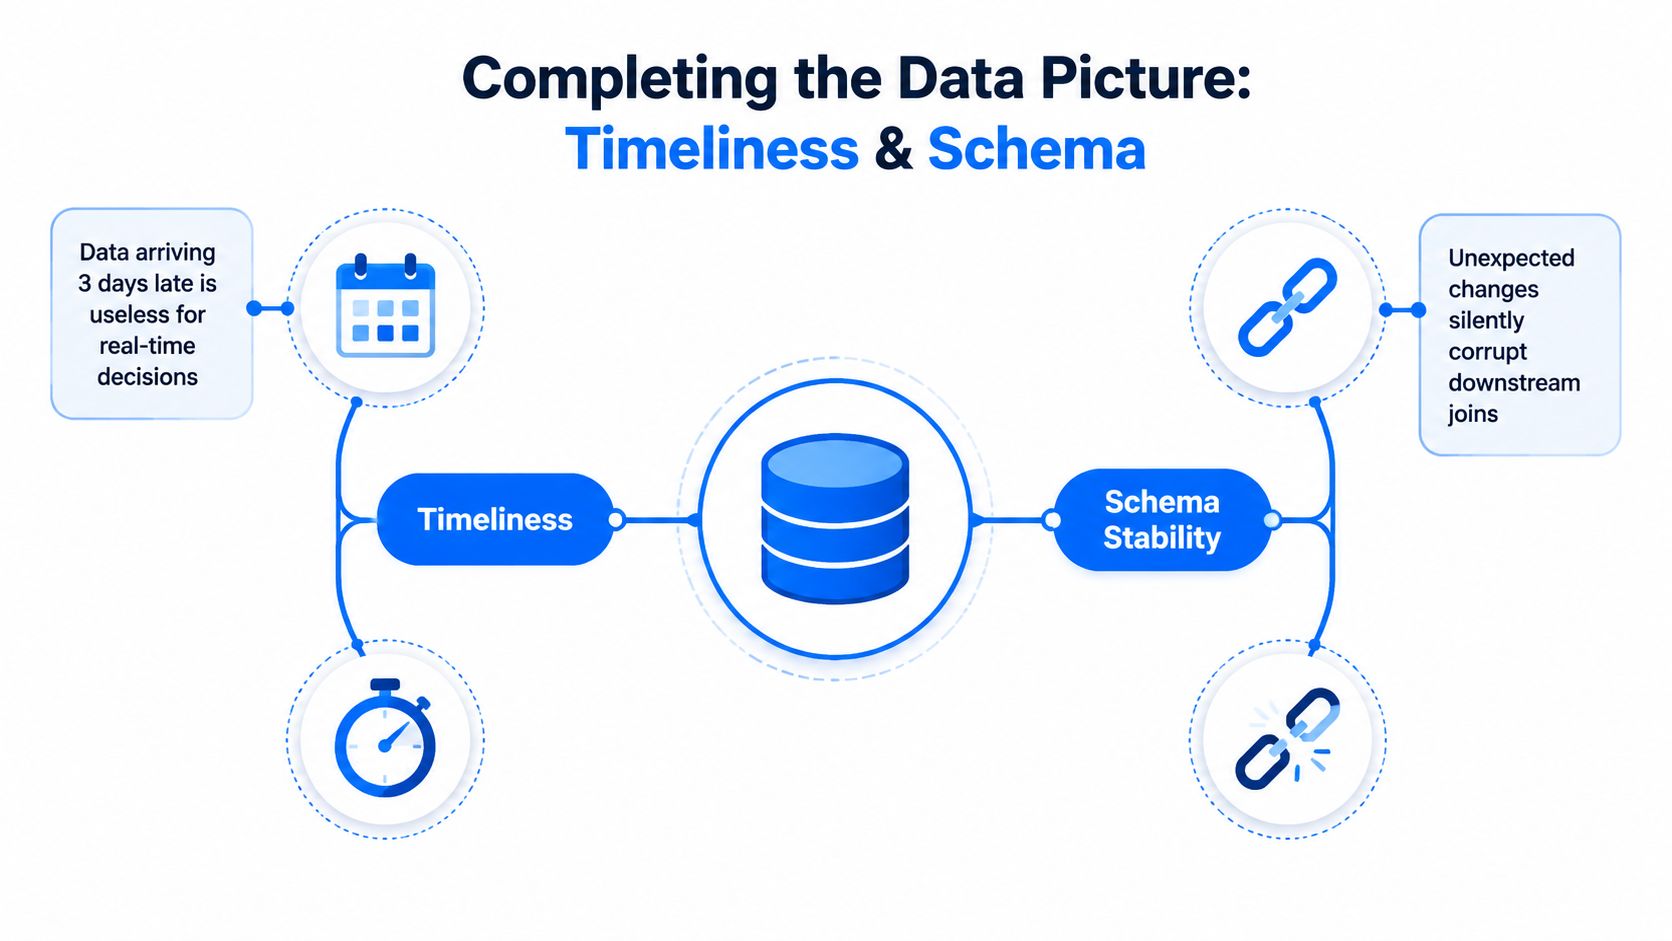
L'interazione conta più di qualsiasi singolo punteggio. La correttezza senza freschezza produce verità storiche nel momento decisionale sbagliato. La freschezza senza stabilità strutturale consegna dati attuali che i consumer possono interpretare male. La stabilità strutturale senza correttezza preserva una forma affidabile per valori difettosi.
Dati affidabili sono dati validi solo quando correttezza, freschezza e stabilità strutturale sono presenti insieme.
Controlli pratici per ottenere sia validità sia affidabilità
I controlli funzionano meglio quando si trovano vicino all'errore che devono intercettare. Un unico test alla fine della pipeline arriva troppo tardi per un contratto di sorgente violato, mentre decine di alert indifferenziati generano affaticamento e spingono i team a ignorare il sistema di monitoraggio.
Partite da controlli su più livelli
Al confine con la sorgente o con lo staging, applicate asserzioni a livello di colonna per campi obbligatori, tipi accettati, comportamento dei null, intervalli e valori di riferimento approvati. Aggiungete controlli sulle distribuzioni dove un record valido può comunque generare un dataset non valido, come un'improvvisa concentrazione in una categoria o un crollo inatteso dei valori popolati.
A livello di integrazione, testate le relazioni. I controlli di integrità referenziale dovrebbero confermare che le chiavi vengono risolte. I controlli di unicità dovrebbero individuare eventi di business duplicati. Le regole tra colonne dovrebbero verificare combinazioni come stato e data di completamento, invece di testare ogni campo isolatamente.
A livello di consumo, monitorate le metriche usate dagli stakeholder. Una dashboard può restare tecnicamente disponibile mentre la sua metrica principale di ricavi, clienti o rischio si comporta in modo anomalo. I controlli a livello di business forniscono un'ultima protezione contro difetti che le asserzioni di livello inferiore non sono in grado di comprendere.
Aggiungete l'osservabilità operativa
I monitor di freschezza dovrebbero osservare i pattern di arrivo attesi, i batch in ritardo, i caricamenti mancanti e le consegne anticipate. I rilevatori di differenze di schema dovrebbero segnalare campi aggiunti, rimossi, rinominati o con tipo modificato prima che una modifica incompatibile raggiunga i modelli dipendenti. La documentazione di Datadog sui monitor di data observability descrive il rilevamento a livello di database, schema, tabella e colonna.
Il rilevamento delle anomalie di volume colma un'altra lacuna importante. Può far emergere troncamenti silenziosi, picchi inattesi di duplicati ed estrazioni parziali anche quando ogni riga consegnata supera la validazione.
Controllo | Intercetta | Fase della pipeline | Gravità dell'alert |
|---|---|---|---|
Asserzioni su null e intervalli | Valori obbligatori mancanti e limiti non validi | Sorgente o staging | Alta quando falliscono campi critici |
Controlli referenziali | Chiavi di dimensione e di riferimento non risolte | Integrazione | Alta per i join interessati |
Monitoraggio della freschezza | Caricamenti in ritardo, mancanti o inaspettatamente anticipati | Sorgente e staging | Critica per i dataset legati al momento decisionale |
Rilevamento delle differenze di schema | Campi aggiunti, rimossi, rinominati o con tipo modificato | Contratto di sorgente | Critica per le modifiche incompatibili |
Rilevamento delle anomalie di volume | Troncamenti, picchi di duplicati e caricamenti parziali | Staging e consumo | Alta quando gli aggregati sono interessati |
Monitoraggio delle metriche di business | Comportamento inatteso dei KPI | Consumo | La gravità segue l'impatto sul business |
Le soglie dovrebbero riflettere il comportamento normale, non una perfezione arbitraria. Un avviso che scatta a ogni oscillazione del fine settimana insegna agli operatori a ignorare gli alert. Una dashboard di salute utile combina i segnali tecnici con ownership, asset interessati, ultima consegna riuscita e decisione di business a rischio. I team possono anche usare regole e controlli di validazione continua dei dati per collegare i controlli a livello di record al monitoraggio continuo della qualità.
Perché la validazione statica non basta per le piattaforme dati moderne
Le regole di validazione statiche sono filtri utili, ma diventano fragili quando i team le trattano come una strategia di affidabilità completa. Una regola scritta una volta può confermare che un campo non è null senza accorgersi di un nuovo valore enum, di un cambiamento semantico, di un pattern di eventi duplicati o di una sorgente che ha smesso di consegnare record aggiornati.
Le piattaforme moderne elaborano eventi in streaming, payload semi-strutturati e risposte di terze parti che evolvono al di fuori del ciclo di rilascio del team del data warehouse. Questo ambiente operativo richiede osservabilità continua, non solo una validazione puntuale.
Le conseguenze per il business possono essere gravi. In un incidente segnalato presso un retailer, un controllo statico dei null non ha rilevato un nuovo valore enum e ha dirottato 4 milioni di USD di attribuzione. Un altro esempio, nel fintech, ha riguardato un'asserzione di intervallo codificata a mano che non ha intercettato uno scambio di codici valuta, gonfiando i punteggi di rischio. Questi esempi illustrano il punto debole centrale delle regole statiche: possono verificare condizioni note senza accorgersi di comportamenti sconosciuti ma rilevanti.
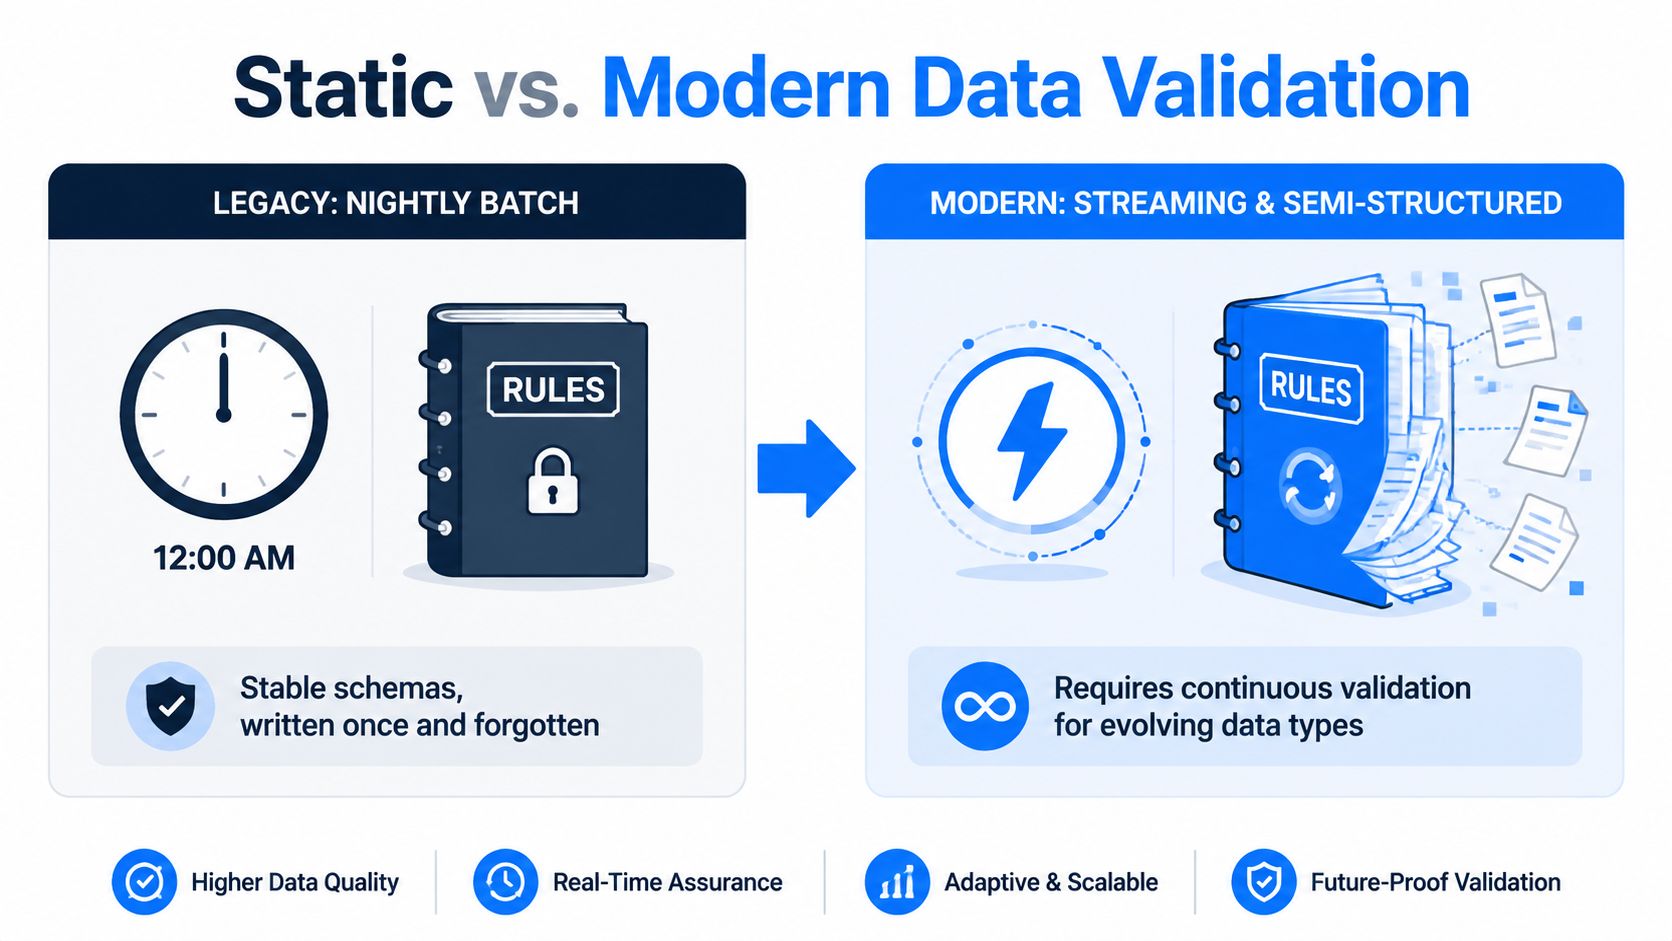
L'osservabilità continua osserva come si comportano i dati nel tempo. Combina contratti espliciti con rilevamento delle anomalie, monitoraggio della freschezza, analisi dei volumi e monitoraggio delle modifiche di schema. Questo modello non elimina le regole deterministiche, ma le inserisce in un ciclo di feedback in grado di riconoscere quando l'ambiente è cambiato.
Il cambiamento pratico è passare da “questo valore ha superato il test?” a “questo dataset si comporta ancora come previsto per il suo scopo?”. Questa domanda intercetta errori che la validazione statica non può descrivere in anticipo.
Costruire una strategia di affidabilità dei dati scalabile
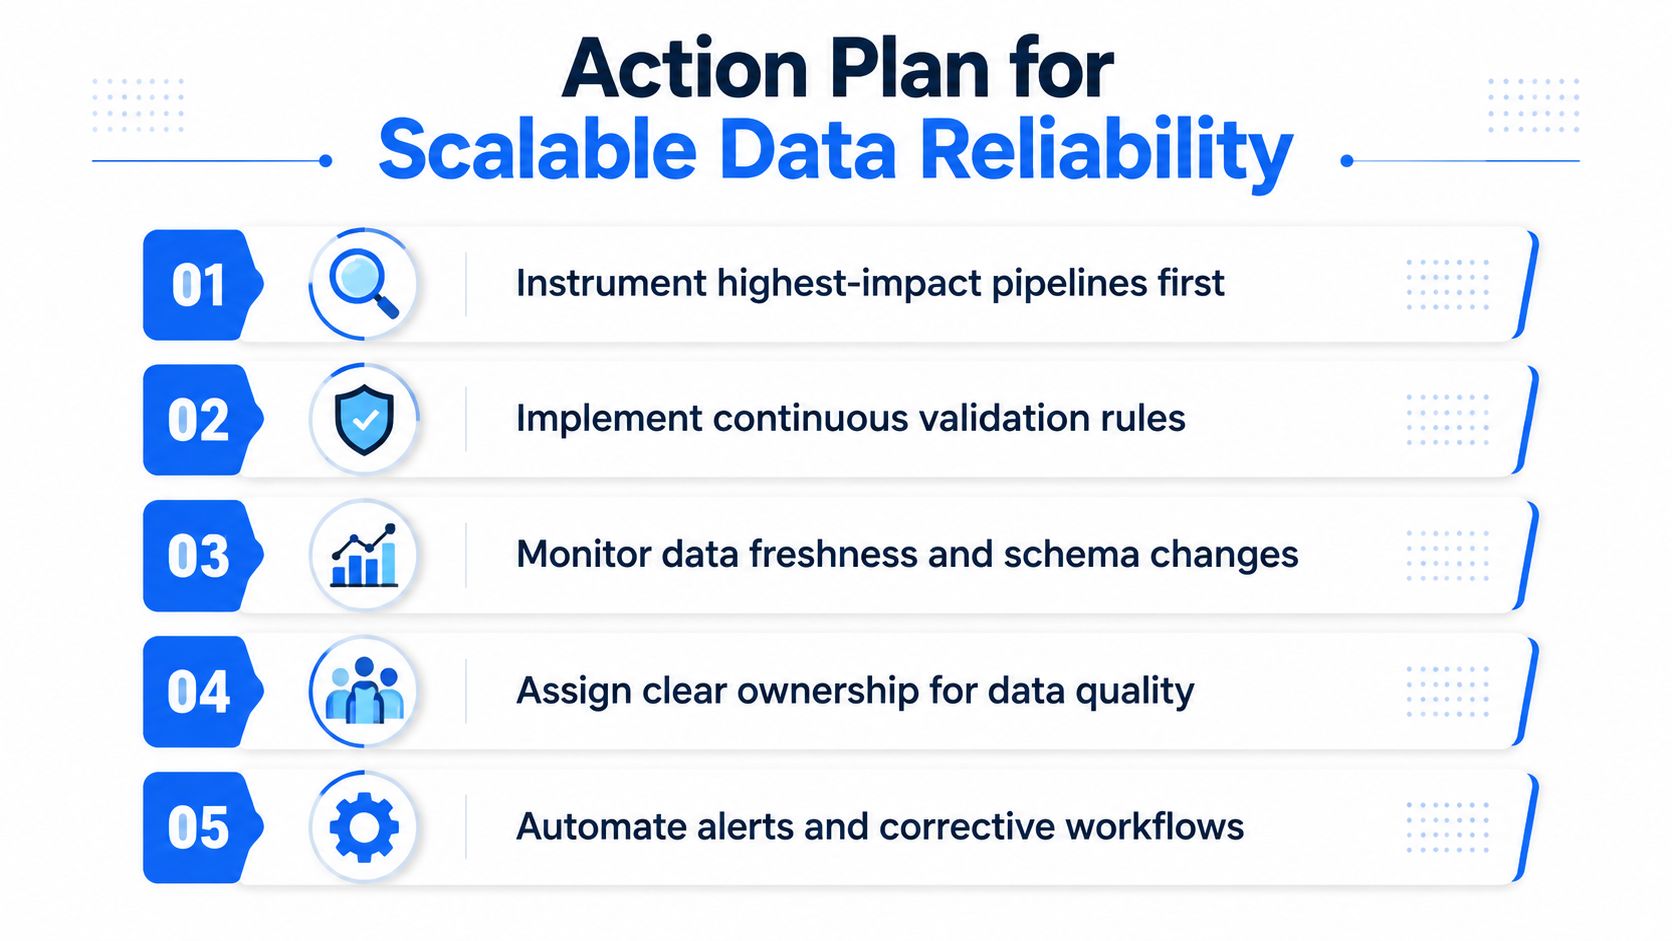
I team non devono strumentare ogni tabella prima di migliorare la fiducia. Partite dalle pipeline che alimentano reporting regolamentare, metriche per il management, operazioni con i clienti, decisioni finanziarie o funzionalità di AI.
Seguite questa sequenza:
Date priorità all'impatto: mappate i dataset critici sulle decisioni e sui modelli che dipendono da essi.
Definite i contratti di consegna: fissate le aspettative su freschezza, completezza e compatibilità dello schema.
Stratificate i controlli: combinate la validazione deterministica con il monitoraggio di anomalie, volumi e struttura.
Assegnate la ownership: fornite a ingegneri, analisti e stakeholder di business percorsi di escalation chiari.
Chiudete il ciclo: usate gli incidenti per affinare soglie, contratti e workflow di remediation.
Per i team che analizzano la comunicazione del management insieme ai dati operativi, gli insight linguistici sulle earnings call possono aggiungere contesto al modo in cui vengono interpretati il linguaggio aziendale e i segnali di performance. Anche questo tipo di analisi contestuale dipende da dati di origine che restano validi, tempestivi e strutturalmente stabili.
Lo standard operativo è ben riassunto dalla prospettiva di digna sull'affidabilità dei dati: l'osservabilità dovrebbe collegare la salute tecnica all'attendibilità dei dati che vengono utilizzati. Scalare l'affidabilità non significa accumulare regole statiche, ma costruire cicli di feedback che aiutino i team a rilevare i cambiamenti, comprenderne l'impatto e reagire prima che dati non validi raggiungano le decisioni.
digna aiuta i team dati a monitorare validità dei record, freschezza, modifiche di schema, anomalie e metriche di business all'interno del proprio ambiente dati. Visitate digna per vedere come l'osservabilità continua può aiutarvi a intercettare pipeline guaste e dati non validi prima che raggiungano dashboard, analytics e workflow di AI.
Domande frequenti
I dati possono essere affidabili ma non validi?
Sì, e questo divario è all'origine di alcuni degli incidenti più costosi nelle piattaforme dati moderne. L'affidabilità della pipeline significa che il job è stato eseguito e ha prodotto un output nei tempi previsti; la validità significa che i valori hanno ancora il significato che il business attribuisce loro.
A che cosa risponde davvero il monitoraggio di base?
A domande operative: il job è partito, è terminato, il data warehouse ha accettato la query, l'attività prevista ha prodotto un output, la dashboard si è aggiornata. Sono domande importanti, ma nessuna di esse dice se un identificativo cliente corrisponde ancora al cliente corretto.
Come appare dall'esterno un errore di validità?
Come una domanda, non come un alert. Qualcuno chiede perché la conversione sia calata per un canale mentre la dashboard mostra ancora un aggiornamento riuscito: a quel punto una pipeline apparentemente affidabile pubblica già da tempo dati non validi.
Quali controlli di validità intercettano ciò che il monitoraggio non vede?
Quelli legati al significato: se un identificativo cliente corrisponde ancora al cliente corretto, se un timestamp appartiene al periodo di rendicontazione previsto e se un codice di stato resta all'interno del vocabolario di business approvato.
Come si combinano tempestività e validità?
Coprono due metà diverse della fiducia. La tempestività conferma che i dati sono presenti quando la decisione ne ha bisogno; la validità conferma che i dati presenti descrivono ciò che dichiarano. Un dataset ha bisogno di entrambe prima che qualcuno possa definirlo attendibile.


