Data observability vs qualità dei dati: la guida completa
|
5
min di lettura
Ieri la dashboard sembrava a posto. Oggi i ricavi non tornano, la finanza non riesce a riconciliare il numero di clienti e le vendite vogliono risposte prima della prossima riunione. All'improvviso tutti, sotto pressione, si fanno la stessa domanda: sono sbagliati i dati o sta fallendo la pipeline?
Questa tensione è esattamente il motivo per cui il confronto tra data observability e qualità dei dati è più di un dibattito terminologico. Negli incidenti reali, il confine tra le due si confonde rapidamente. Un file a monte mancante può sembrare un problema di qualità dei dati. Una modifica silenziosa allo schema può manifestarsi come un'incongruenza in una dashboard. Un dataset perfettamente valido può comunque arrivare troppo tardi per essere utile.
I team hanno bisogno di entrambe le prospettive. Una vi dice se i dati sono adatti all'uso di business. L'altra vi dice se il sistema che li consegna si sta comportando normalmente. Affidatevi a una sola e i punti ciechi critici resteranno nascosti finché la fiducia non sarà già compromessa.
Indice
L'alto costo del data downtime
L'incidente di solito inizia sempre allo stesso modo. Uno stakeholder di business nota un numero che non convince. Un analista controlla il layer di BI e dice che la logica non è cambiata. Un data engineer ispeziona la pipeline e vede che l'esecuzione è stata completata. Poi nella stanza cala il silenzio, perché nessuno è ancora in grado di dire se il problema siano dati sorgente errati, una trasformazione rotta, un caricamento in ritardo o un problema semantico a valle.
Quel periodo di incertezza è ciò che i team vivono come data downtime. I dati possono ancora esistere nello storage, le pipeline possono essere ancora in esecuzione e le dashboard possono ancora caricarsi. Ma il sistema non è abbastanza affidabile da supportare le decisioni.
Perché l'impatto sul business cresce in fretta
Il costo diretto è solo una parte del problema. Secondo Gartner, la scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di dollari all'anno. Gartner osserva inoltre che i dati inaffidabili erodono la fiducia e ostacolano il processo decisionale basato sui dati in tutta l'azienda.
Nella pratica, questa perdita di fiducia si diffonde più velocemente di quanto le organizzazioni prevedano:
I dirigenti rimandano le decisioni: aspettano una conferma manuale invece di agire sulla base delle dashboard.
Gli analisti duplicano il lavoro: riconvalidano i numeri prima di ogni riunione.
Gli ingegneri vengono trascinati nel triage: il tempo che dovrebbe andare al miglioramento della piattaforma viene consumato dalla risposta agli incidenti.
I team di governance perdono fiducia: i controlli sembrano più deboli quando le eccezioni continuano a emergere in produzione.
Una stima approssimativa aiuta a rendere tangibile il rischio. Strumenti come questo calcolatore del costo del data downtime sono utili perché costringono i team a tradurre “la dashboard era sbagliata” in impatto operativo e di business.
La parte costosa di un incidente sui dati non è solo la tabella rotta. Sono le ore di incertezza per tutte le persone che ne dipendono.
Perché una sola disciplina non basta
La qualità dei dati aiuta a stabilire se i dati in sé sono accurati, completi, validi e adatti all'uso. La data observability aiuta a stabilire se il sistema che sposta e trasforma i dati funziona come previsto. Una ispeziona lo stato. L'altra monitora il comportamento.
Quando i team le confondono, acquistano gli strumenti sbagliati, indirizzano gli incidenti ai responsabili sbagliati e continuano a risolvere i sintomi anziché le cause.
Comprendere i concetti fondamentali
La qualità dei dati verifica lo stato dei dati
La qualità dei dati è la pratica di valutare i dati rispetto ad aspettative note. Queste aspettative derivano di solito da regole di business, standard di governance o vincoli tecnici. La domanda centrale è semplice: questi dati sono accettabili per l'attività che supportano?
I controlli tipici si concentrano sulla condizione del dataset in sé:
Accuratezza: il valore riflette l'evento o l'entità reale?
Completezza: i campi obbligatori sono compilati?
Validità: i valori rispettano i formati, gli intervalli o gli insiemi consentiti previsti?
Coerenza: i sistemi correlati rappresentano la stessa cosa nello stesso modo?
Unicità: compaiono record duplicati dove non dovrebbero?
È il layer che intercetta cose come date di transazione non valide, identificativi cliente mancanti, codici prodotto malformati o integrità referenziale violata. Dà il meglio quando il business sa già che aspetto ha il dato “corretto”.
Un modo utile per pensarci è che la qualità dei dati gestisce le incognite note. Sapete già che la modalità di guasto è possibile, quindi codificate una regola per intercettarla. Se il vostro dataset finanziario non deve mai contenere null in una chiave di registrazione, la qualità dei dati è il controllo giusto.
Per un'introduzione concreta alle aspettative e ai controlli lato business, questa panoramica su che cos'è la qualità dei dati e perché è importante è un riferimento pratico.
La data observability osserva il comportamento dei dati
La data observability affronta un problema diverso. Si chiede se il sistema dati nel suo complesso si stia comportando normalmente mentre i dati si spostano dalla sorgente alla destinazione. Questo include pipeline, trasformazioni, tabelle, pianificazioni e dipendenze.
I segnali riguardano meno le regole di business esplicite e più gli schemi operativi:
Freschezza: i dati sono arrivati quando arrivano di solito?
Volume: il numero di righe è aumentato o diminuito in modo inatteso?
Distribuzione: i valori si sono spostati in modi che suggeriscono una deriva o una corruzione?
Schema: una colonna è scomparsa, è stata rinominata o ha cambiato tipo?
Contesto di lineage: dove ha avuto origine il problema e cos'altro ne dipende?
In questi scenari la visibilità sul sistema dati è essenziale. Senza di essa, i team spesso scoprono i guasti solo dopo che una dashboard si è rotta o che uno stakeholder ha segnalato qualcosa di strano.
Regola pratica: la qualità dei dati vi dice se i dati superano uno standard. La data observability vi dice se il sistema di consegna sta iniziando a discostarsi dalla normalità.
L'osservabilità è particolarmente utile per le incognite sconosciute. Non potete scrivere una regola per ogni guasto futuro. Potete però monitorare gli schemi che rivelano quando qualcosa è cambiato, prima che gli utenti ne sentano l'impatto.
Questa differenza è il motivo per cui i team non dovrebbero trattare questi termini come sinonimi. Si sovrappongono negli obiettivi, ma non ispezionano la stessa cosa e non intercettano la stessa classe di problemi.
Qualità dei dati vs osservabilità: un confronto dettagliato
I team chiedono spesso quale delle due serva per prima. È la domanda di partenza sbagliata. Una migliore è: quale tipo di guasto continua a danneggiarci? Se il vostro problema principale sono valori di business non validi, iniziate dai controlli di qualità. Se il vostro problema principale sono pipeline obsolete, in ritardo o soggette a derive sottili, l'osservabilità di solito ripaga più in fretta.

Tabella di confronto rapido
Criterio | Qualità dei dati | Data observability |
|---|---|---|
Preoccupazione principale | Se i dati sono corretti e adatti all'uso | Se il sistema dati si sta comportando normalmente |
Cosa monitora | Lo stato dei dati a livello di campo, record o tabella | Il comportamento dei dati attraverso pipeline, tabelle e dipendenze |
Ideale per | Regole note e standard di business | Anomalie inattese e guasti operativi |
Segnali tipici | Null, formati non validi, duplicati, violazioni di regole | Variazioni di freschezza, spostamenti di volume, modifiche allo schema, derive |
Modello operativo | Validazione e applicazione delle regole | Monitoraggio e alerting continui |
Responsabili tipici | Data governance, analytics engineering, data steward, team di dominio | Data engineering, piattaforma, affidabilità, DataOps |
Una risorsa pratica per costruire il lato delle regole di questo modello operativo è il playbook operativo sulla qualità dei dati di Querio, soprattutto se il vostro team ha buone definizioni di business ma una disciplina di implementazione debole.
Come si presentano le differenze operative
Ambito
La qualità dei dati di solito valuta i dati a riposo o in checkpoint controllati all'interno di una pipeline. Ispeziona tabelle, record e colonne rispetto agli standard previsti.
La data observability abbraccia il sistema più ampio. Segue ciò che accade mentre i dati scorrono attraverso job di ingestion, trasformazioni nel warehouse, pianificazioni di orchestrazione e asset a valle. Se vi serve una panoramica generale di questi segnali a livello di sistema, questa introduzione alla data observability per la gestione moderna dei dati è una cornice utile.
Focus
La qualità chiede: “Questo campo è conforme alla regola?” L'osservabilità chiede: “Perché oggi questo dataset ha iniziato a comportarsi in modo diverso?”
Sembra una sottigliezza finché non siete in produzione. Un controllo sul tasso di null in una colonna dei ricavi è un controllo di qualità. Un improvviso cambiamento nella distribuzione dei valori dopo l'aggiornamento di un'API sorgente è un evento di osservabilità. Il primo è esplicito. Il secondo è comportamentale.
Metriche principali
Le metriche di qualità sono deterministiche. Superato o fallito. Valido o non valido. Duplicato o univoco. Sono facili da spiegare agli auditor e agli utenti di business.
Le metriche di osservabilità si basano sugli schemi. Ritardi di freschezza, numero di righe che cambia, distribuzioni spostate, evoluzione degli schemi e catene di dipendenze interrotte. Non significano sempre che i dati siano sbagliati, ma vi dicono dove indagare per primo.
Se la qualità è la checklist, l'osservabilità è il cruscotto degli strumenti.
Processo principale
I programmi di qualità si basano spesso su test pianificati, asserzioni nelle pipeline, criteri di accettazione e flussi di remediation. Funzionano bene quando le regole di business sono stabili e hanno responsabili chiari.
L'osservabilità funziona in modo continuo. Osserva telemetria, metadati, baseline storiche e anomalie nel tempo. È pensata per far emergere i problemi prima che una persona apra la dashboard sbagliata.
Ownership dei team
La ownership della qualità tende a stare più vicina al significato di business dei dati. Responsabili della governance, data steward, analytics engineer e responsabili di dominio spesso definiscono cosa significa “buono”.
La ownership dell'osservabilità di solito spetta a chi è responsabile dell'affidabilità delle pipeline e delle operations della piattaforma. Data engineer e team di piattaforma ne hanno bisogno perché sono loro a dover spiegare perché un dataset affidabile è improvvisamente diventato inaffidabile.
Nessuna delle due parti dovrebbe operare in isolamento. Ma la distinzione conta, perché strumenti, modelli di alerting e percorsi di escalation dipendono tutti da essa.
Dove si sovrappongono e come lavorano insieme
L'impostazione “vs” è utile per fare chiarezza, ma diventa fuorviante se i team trattano le due come alternative. In produzione funzionano meglio come un ciclo.
L'osservabilità trova il segnale
Una configurazione di osservabilità efficace potrebbe rilevare un improvviso picco di valori null, un ritardo negli arrivi o un cambiamento di forma in una tabella critica. A quel punto non ha ancora stabilito se i dati violano uno standard di business. Ha stabilito qualcosa di altrettanto importante: il comportamento normale è cambiato, e il cambiamento conta.
Quel segnale precoce restringe l'area di ricerca. Invece di controllare manualmente ogni trasformazione e ogni sorgente, gli ingegneri possono partire dal dataset, dalla finestra temporale o dalla catena di dipendenze che si è mossa per prima.
L'osservabilità vi dice che il paziente ha la febbre. La qualità dei dati aiuta a diagnosticare la malattia specifica.
Per questo l'osservabilità accorcia il percorso verso la causa principale anche quando il problema finale si rivela un classico difetto di qualità.
La qualità rende la risposta duratura
Una volta che il team ha individuato il difetto effettivo, la qualità dei dati trasforma quell'incidente isolato in un controllo ripetibile. Se un sistema sorgente inizia a inviare ID contratto malformati, l'osservabilità potrebbe intercettare l'anomalia per prima. La qualità dovrebbe poi codificare lo schema come regola di validazione, così che lo stesso problema non possa passare inosservato la volta successiva.
È in questo ciclo di feedback che si vede la maturità. I team smettono di trattare ogni incidente come una novità e iniziano a convertire gli incidenti in controlli.
Un esempio pratico è il seguente:
Compare un'anomalia: la freschezza o la distribuzione cambiano in una tabella che alimenta il reporting per il management.
Gli ingegneri indagano: riconducono il problema a una modifica nell'estrazione dalla sorgente.
L'impatto sul business diventa chiaro: campi specifici non rispettano più il contratto previsto.
Viene aggiunta una regola di qualità: i caricamenti futuri falliscono subito o vengono messi in quarantena prima di propagarsi.
I risultati condivisi contano più della purezza delle categorie
Il modello operativo migliore non discute di etichette durante un incidente. Instrada il problema in base al segnale e all'impatto. L'osservabilità rileva e contestualizza. La qualità convalida e applica le regole.
L'osservabilità senza la qualità può dirvi che qualcosa è cambiato, ma non sempre se ciò viola l'intento di business.
La qualità senza l'osservabilità può verificare le regole note, ma non intercetterà ogni comportamento inatteso in uno stack in rapida evoluzione.
Operazioni sui dati affidabili nascono dalla combinazione tra consapevolezza del sistema e correttezza di business.
È per questo che i team maturi non scelgono una parte nel dibattito tra data observability e qualità dei dati. Le integrano entrambe nella stessa strategia di salute dei dati.
Il modello di maturità della salute dei dati
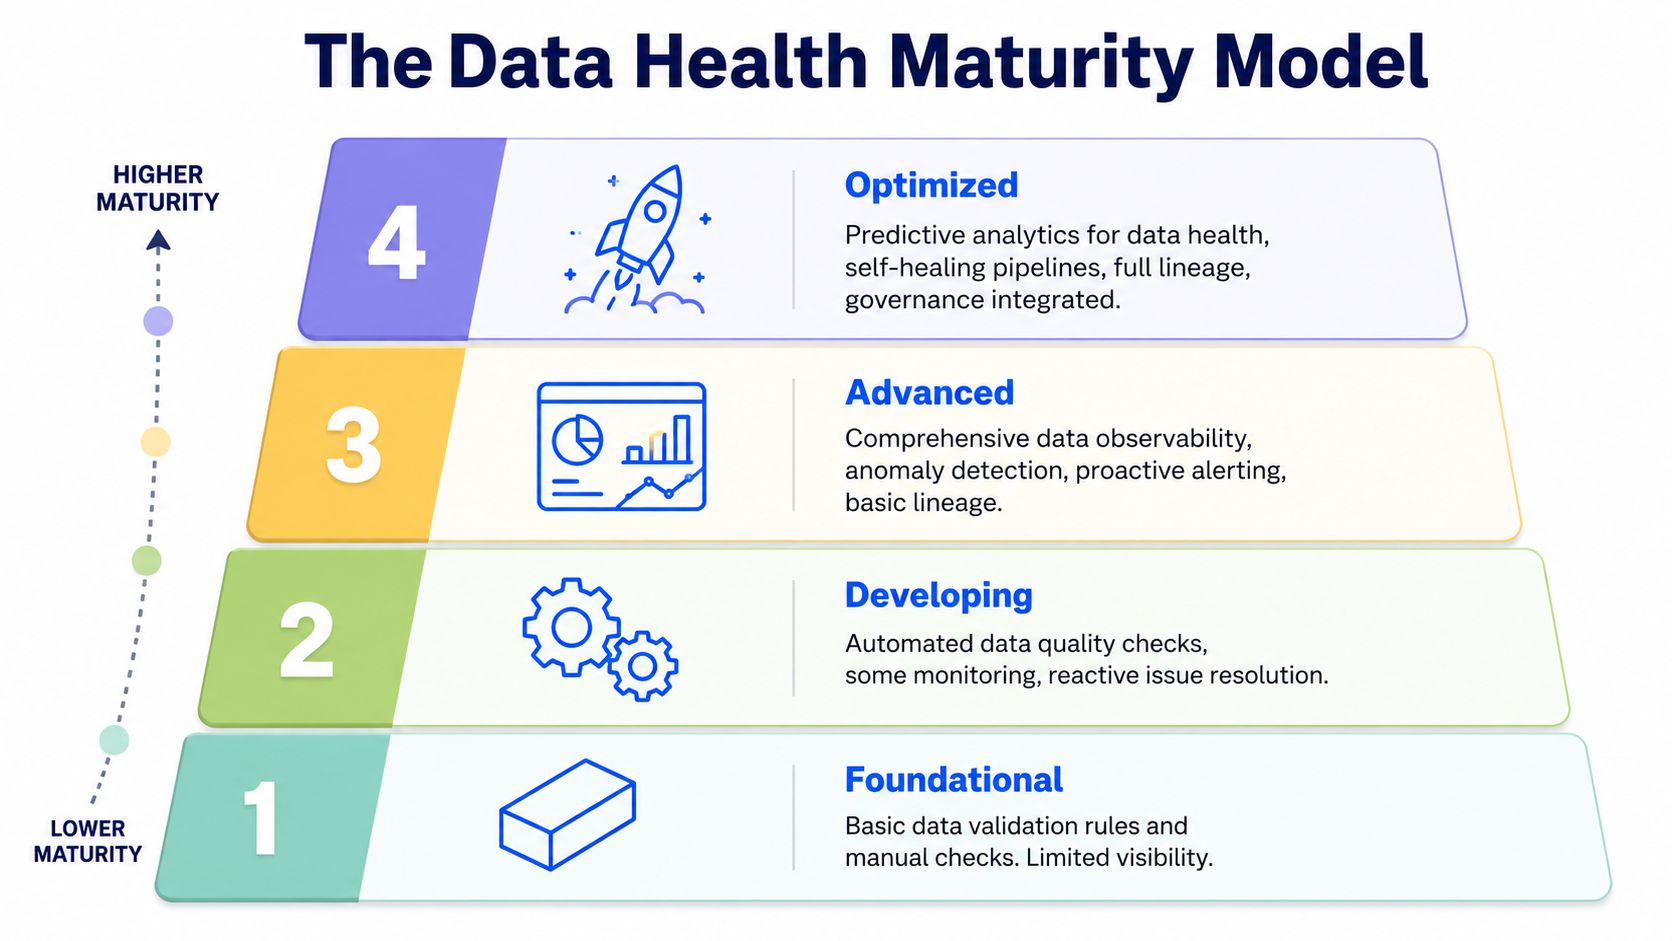
La maggior parte delle organizzazioni non passa dai controlli SQL improvvisati a un programma unificato di salute dei dati in un solo passo. Sale attraverso fasi ben riconoscibili, e ogni fase risolve un collo di bottiglia diverso.
Livello uno e livello due
Livello uno: reattivo
In questa fase, i problemi vengono scoperti da utenti di business, analisti o dirigenti. La risposta è manuale. Qualcuno scrive una query ad hoc, confronta ieri con oggi e cerca di dedurre cosa si è rotto.
Funziona per team piccoli e sistemi stabili. Fallisce quando aumentano il numero di dataset, la profondità delle dipendenze o la pressione del business. Il problema più grande non è la mancanza di impegno. È che ogni indagine parte da zero.
Livello due: qualità proattiva
Qui i team iniziano a codificare le aspettative di business note. Aggiungono controlli sui null, test di integrità referenziale, valori ammessi, vincoli di formato e asserzioni di base nelle pipeline.
È un grande passo avanti, perché i guasti ricorrenti diventano visibili e gestibili tramite regole. Ma ha ancora un limite. Se la regola non è stata scritta, il problema può comunque passare inosservato. Ecco perché molti team a questo livello si sentono ancora reattivi, pur avendo automatizzato parte della validazione.
Livello tre e livello quattro
Livello tre: osservabilità automatizzata
In questa fase, i team smettono di affidarsi solo a regole predefinite e iniziano a monitorare il comportamento dei sistemi dati. Osservano freschezza, evoluzione degli schemi, anomalie di volume e spostamenti negli schemi storici.
Il cambiamento operativo è significativo. Gli ingegneri non aspettano più un reclamo su una dashboard per sapere dove guardare. Ricevono segnali più precoci e un contesto più chiaro. La risposta agli incidenti diventa più rapida perché è il sistema stesso a indicare la probabile origine del cambiamento.
Livello quattro: unificato
I team più maturi non gestiscono qualità e osservabilità come programmi separati con flussi di lavoro separati. Le combinano in un unico layer di salute dei dati con metadati condivisi, ownership condivisa e gestione condivisa degli incidenti.
Di solito si riconosce questa fase da alcune caratteristiche:
Regole di business e segnali di anomalia convivono: i team vedono in un unico posto sia i fallimenti espliciti sia le deviazioni comportamentali.
La ownership è coordinata: governance, analytics ed engineering non si rimpallano gli incidenti alla cieca.
La prevenzione migliora nel tempo: le nuove regole di qualità si basano sui risultati ricorrenti dell'osservabilità.
Il contesto viene preservato: storico dei trend, puntualità, modifiche agli schemi e risultati delle validazioni supportano lo stesso flusso di indagine.
La maturità non significa avere più alert. Significa ridurre la distanza tra rilevamento, diagnosi e prevenzione.
Se state decidendo dove investire, non chiedetevi se avete “adottato l'osservabilità” o “fatto data quality”. Chiedetevi cosa costringe ancora il vostro team a un'incertezza gestita a mano.
Come digna unifica qualità dei dati e osservabilità
Uno schema di fallimento comune si manifesta dopo che i team hanno già investito in un "monitoraggio migliore". Uno strumento di freschezza dice che una tabella è in ritardo. Uno strumento di validazione separato dice che alcuni campi chiave sono null. I log di orchestrazione stanno in un sistema, le query del warehouse in un altro, e il team di business continua a porsi una domanda di base. È un problema della pipeline, dei dati o di entrambi?
Un unico modello operativo invece di due scollegati
Una piattaforma unificata aiuta perché gli incidenti di qualità e di osservabilità raramente restano a lungo su binari separati. digna combina la validazione basata su regole con i segnali di osservabilità all'interno di ambienti controllati dal cliente, così i team possono indagare su un problema di salute dei dati attraverso un unico flusso di lavoro.
Sul fronte della qualità, digna Data Validation supporta regole definite dall'utente a livello di record per logica di business, applicazione delle policy e requisiti di audit. È il layer deterministico. I team definiscono che aspetto devono avere i dati validi e li testano direttamente.
Sul fronte dell'osservabilità, la piattaforma traccia il comportamento dei dati nel tempo:
digna Data Anomalies rileva cambiamenti inattesi rispetto agli schemi storici.
digna Timeliness monitora i tempi di arrivo e il comportamento dei ritardi.
digna Schema Tracker segnala modifiche strutturali come colonne aggiunte, rimosse o modificate.
digna Data Analytics offre ai team visibilità sui trend dei segnali storici.
Dove una piattaforma unificata aiuta di più
Il vantaggio è massimo negli ambienti in cui i team non possono giustificare la copia dei dati di produzione in un sistema gestito dal vendor. digna calcola le metriche nel database del cliente e supporta il deployment in private cloud oppure on-premises. Questo è importante per le aziende che hanno bisogno di un controllo più stretto su accessi, residenza dei dati e confini operativi.
Il vantaggio pratico va oltre il consolidamento degli strumenti. Cambia la gestione degli incidenti. Lo stesso percorso di alert può iniziare con il rilevamento comportamentale, proseguire con la validazione delle regole e concludersi con una visione condivisa dell'impatto sul business.
Un'indagine tipica si svolge così:
Compare un alert di puntualità: una tabella chiave per il reporting è in ritardo.
Compare il contesto dello schema: una sorgente a monte ha cambiato struttura.
La validazione conferma l'impatto: i campi di business obbligatori ora non superano le regole a livello di record.
I team rispondono con un contesto condiviso: l'engineering vede il guasto del sistema e i responsabili dei dati vedono la conseguenza per il business.
È questo il valore strategico di trattare qualità dei dati e osservabilità come due layer di un unico programma di salute dei dati. I controlli di qualità confermano se i dati sono accettabili. L'osservabilità mostra come si comporta il sistema prima e durante un guasto. Gestirle entrambe in un'unica piattaforma colma la distanza tra rilevamento, diagnosi e azione.
Guida all'implementazione e prossimi passi
Di solito le organizzazioni non hanno bisogno di un ampio programma di trasformazione per iniziare. Serve loro una prima mossa controllata che riduca l'incertezza in un flusso di lavoro critico per il business.
Iniziate da un flusso di lavoro critico
Scegliete una dashboard, un modello o un dataset operativo a cui le persone tengono già. Non iniziate dalla pipeline più rumorosa del warehouse, a meno che non sia anche importante per il business. Volete un impatto visibile e un perimetro gestibile.
Usate questa checklist:
Individuate gli asset critici
Scegliete le tabelle, le pipeline e i report che incidono direttamente sul reporting per il management, sui processi finanziari, sulle operations con i clienti o sugli input dei modelli.Valutate la vostra maturità attuale
Siate onesti: il vostro team si affida ancora a controlli manuali, ha una discreta copertura di regole o monitora già le anomalie comportamentali?Definite l'impatto sul business in termini semplici
Mettete per iscritto cosa succede quando questi dati sono in ritardo, errati o strutturalmente modificati. Concentratevi sulle decisioni bloccate, sui report ritardati e sui team costretti a rifare il lavoro.Avviate un pilota mirato
Aggiungete i controlli adatti allo schema di guasto. Se il problema sono violazioni ripetute delle regole di business, date priorità ai controlli di qualità. Se il problema sono pipeline obsolete o imprevedibili, date priorità ai segnali di osservabilità.
Scegliete in base al vostro schema di guasto
Una semplice regola decisionale funziona bene:
Date priorità alla qualità dei dati quando il problema principale sono valori errati, requisiti di compliance, definizioni non rispettate o difetti ricorrenti basati su regole.
Date priorità all'osservabilità quando il problema principale sono caricamenti in ritardo, anomalie inspiegabili, schema drift e guasti delle pipeline difficili da rintracciare.
Implementatele entrambe insieme quando lo stesso asset è sia critico per il business sia fragile dal punto di vista operativo.
Iniziate da dove la fiducia si rompe più spesso, non da dove gli strumenti sembrano più impressionanti.
Mantenete il rollout abbastanza circoscritto da permettere al team di calibrare gli alert, assegnare i responsabili e documentare i passi di risposta. Il successo iniziale dipende meno dall'ampiezza delle funzionalità e più dall'avere un percorso d'azione chiaro quando scatta un segnale.
La prova finale è semplice. Quando il prossimo stakeholder dirà “Questi numeri sembrano sbagliati”, il vostro team dovrebbe poter rispondere rapidamente a tre domande: cosa è cambiato, dove è cambiato e se il business può fidarsi del risultato. Se servono ancora ore di messaggi su Slack, screenshot di dashboard e controlli SQL manuali, il problema non è più solo un brutto incidente. È un modello operativo di salute dei dati debole.
L'obiettivo non è aggiungere più alert o più strumenti. È accorciare la distanza tra rilevamento, diagnosi e azione sicura. I team che ci riescono non perdono tempo a discutere se un problema appartenga alla qualità dei dati o all'osservabilità. Le usano entrambe insieme per proteggere la fiducia prima che si rompa.
Se volete un reporting più affidabile, un'analisi delle cause più rapida e meno emergenze, il passo successivo è semplice: iniziate da un flusso di lavoro critico, mettetegli attorno i segnali giusti e costruite da lì.
Se il vostro team ha bisogno di un layer per la validazione a livello di record e di un altro per il comportamento delle pipeline, fissate un incontro con digna per valutare come una configurazione unificata di qualità dei dati e osservabilità si adatterebbe al vostro ambiente, ai vostri controlli e al vostro flusso di gestione degli incidenti.
Domande frequenti
Qual è la differenza tra qualità dei dati e data observability?
La qualità dei dati verifica lo stato dei dati rispetto ad aspettative definite, stabilendo se i valori sono corretti, completi e validi. La data observability osserva come dati e pipeline si comportano nel tempo, stabilendo se qualcosa è cambiato in modo inatteso. Una verifica regole note, l'altra rileva deviazioni sconosciute.
Servono sia la qualità dei dati sia l'osservabilità?
Sì, perché ciascuna non vede ciò che l'altra intercetta. Le regole non possono segnalare un guasto che nessuno aveva previsto, e l'osservabilità non può dirvi che un valore viola un vincolo di business di cui non è mai stata informata. Insieme coprono sia i guasti previsti sia quelli imprevisti.
Che cos'è il data downtime e perché costa così tanto?
Il data downtime è qualsiasi periodo in cui i dati sono mancanti, errati o in ritardo. È costoso perché il costo si accumula in silenzio: si prendono decisioni su numeri sbagliati, la fiducia si erode e il tempo degli ingegneri viene consumato a rintracciare un difetto entrato giorni prima.
Quale implementare per prima?
Iniziate dall'osservabilità se non sapete da dove provengono i vostri guasti, perché offre un'ampia copertura senza richiedere di prevedere i problemi. Iniziate dalla validazione se sapete già quali specifici vincoli di business vengono violati e da chi.
Come lavorano insieme osservabilità e qualità nella pratica?
L'osservabilità individua il segnale che qualcosa è cambiato, e le regole di qualità rendono la risposta duratura. Una volta compreso un incidente, viene codificato come regola di validazione, così la volta successiva lo stesso guasto viene intercettato in modo deterministico anziché essere riscoperto.


