Che cos'è una piattaforma di observability: la guida 2026
|
7
min di lettura

Una piattaforma di data observability offre ai team una visibilità approfondita e in tempo reale sullo stato di salute e sul comportamento dei dati stessi, non solo dei server e delle applicazioni che li trasportano. Gartner prevede che il 50% delle aziende con architetture dati distribuite adotterà strumenti di data observability entro il 2026, rispetto a circa il 20% del 2024, perché i team devono intercettare problemi come il degrado della qualità, i ritardi delle pipeline e le modifiche dello schema prima che raggiungano report, dashboard o modelli di AI.
Se state cercando che cos'è una piattaforma di observability, probabilmente state già affrontando la versione più frustrante di questo problema. Il job è stato eseguito. La dashboard si è aggiornata. Nulla si è bloccato. Ma i numeri sono sbagliati.
È proprio per questo divario che la vecchia definizione di observability non basta più. L'observability dell'infrastruttura vi dice se i sistemi sono in funzione. La data observability vi dice se i dati consegnati da quei sistemi sono utilizzabili, tempestivi, strutturalmente integri e ancora affidabili per le decisioni di business.
Indice
Quando i dati buoni si guastano in silenzio
Un guasto tipico inizia con un report che sembra abbastanza normale da superare un controllo superficiale. I ricavi sono leggermente in calo, la conversione è stabile, il numero di clienti sembra plausibile. Nessuno viene allertato perché il livello di orchestrazione mostra un'esecuzione riuscita e il warehouse è online.
Una settimana dopo qualcuno si accorge che un filtro non funziona correttamente perché un campo sorgente ha cambiato tipo. Il job di ingestion non è mai fallito. Il livello BI non si è mai rotto. La pipeline ha consegnato i dati nei tempi previsti, ma una modifica strutturale ha alterato in modo sottile la logica di business a valle.
È esattamente questo tipo di incidente che spinge i team a chiedersi che cos'è una piattaforma di observability. Non hanno bisogno di un'altra dashboard che dica loro che la CPU è in salute. Hanno bisogno di un sistema in grado di dire che i dati sono in ritardo, incompleti, malformati, soggetti a drift o non più statisticamente normali.
I guasti silenziosi sono guasti di business
Il monitoraggio tradizionale intercetta i guasti evidenti. Rileva un servizio non attivo, un picco di timeout, un problema di storage o un'interruzione di un'API. Non rileva in modo affidabile la ridenominazione di una colonna, un calo improvviso in un segmento di record o uno spostamento della distribuzione che contamina l'input di un modello senza generare un errore applicativo.
Regola pratica: se una pipeline può andare a buon fine mentre la risposta di business è sbagliata, il solo monitoraggio dell'infrastruttura non vi proteggerà.
Ecco perché la data observability è passata da optional a capacità fondamentale della piattaforma. Secondo la sintesi di Atlan della previsione di Gartner sull'adozione della data observability, si prevede che il 50% delle aziende con architetture dati distribuite adotti strumenti di data observability entro il 2026, rispetto a circa il 20% del 2024, il che corrisponde a una crescita dell'adozione del 250% in due anni. La stessa analisi collega questa crescita a una realtà semplice: le organizzazioni devono rilevare e prevenire le anomalie dei dati prima che colpiscano modelli di AI, report finanziari e dashboard per i clienti.
Che cosa cercano davvero di evitare i team
Nella pratica, gli incidenti più dolorosi sono di solito questi:
Dati in ritardo: le dashboard direzionali si aprono puntuali, ma l'ultima partizione non è arrivata.
Schema drift: i sistemi a monte cambiano nomi, tipi o strutture dei campi senza preavviso.
Degrado della qualità: valori nulli, duplicati, valori malformati o strani cambiamenti di categoria si diffondono inosservati.
Propagazione degli errori: un singolo difetto a monte attraversa modelli del warehouse, notebook e livelli BI.
Una moderna piattaforma di observability esiste per rendere visibili questi guasti finché sono ancora piccoli.
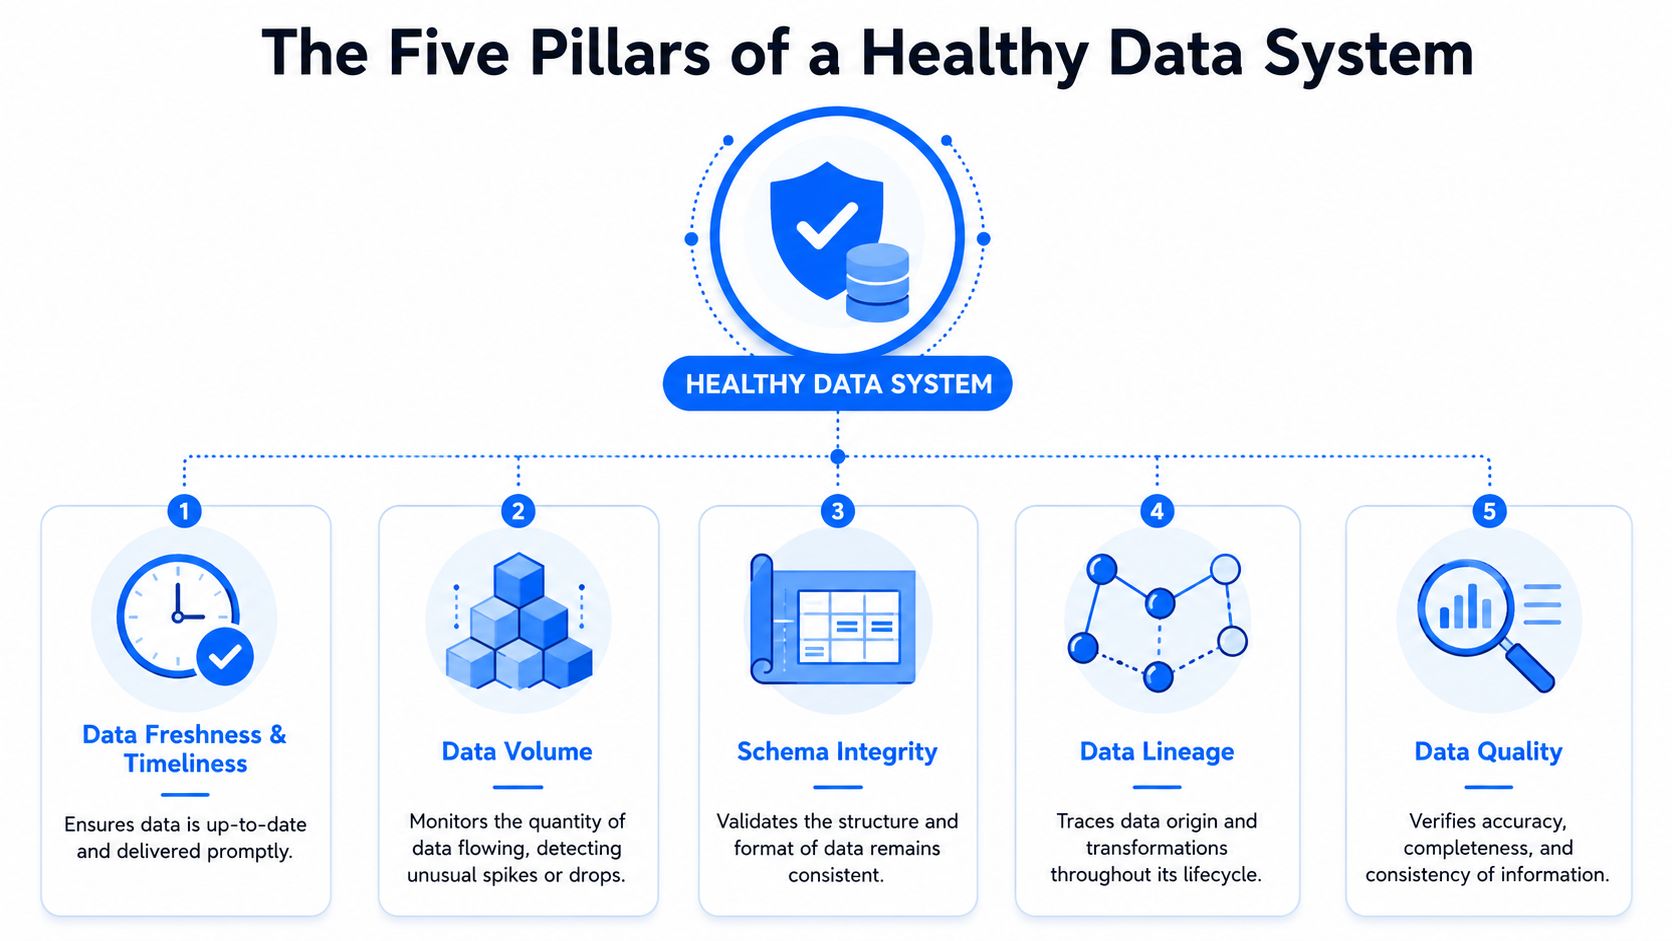
I cinque pilastri di un sistema dati in salute
Un buon modo di pensare alla data observability è paragonarla a un'auto moderna. Il tachimetro e l'indicatore del carburante dicono qualcosa, ma non abbastanza. Un vero sistema di diagnostica vi dice se il motore si sta surriscaldando, se un sensore sta cedendo, se un componente dei freni è usurato o se un sottosistema ha smesso di comunicare correttamente.
I sistemi di dati funzionano allo stesso modo. Lo stato di successo di una pipeline è il tachimetro. La vera observability va molto più in profondità.
Come si riconoscono davvero dati in salute
I cinque pilastri comunemente utilizzati nella data observability sono freschezza, volume, schema, distribuzione e lineage, come descritto nella spiegazione di Atlan sugli strumenti di data observability.
Freschezza significa che i dati sono arrivati quando dovevano.
Una tabella delle vendite giornaliere che si carica a mezzogiorno invece che alle 6 del mattino potrà anche essere corretta alla fine, ma non è utile dal punto di vista operativo quando il reparto finance apre il report al mattino.Volume verifica se la quantità di dati corrisponde alle aspettative.
Un calo improvviso nel numero di righe può indicare che un'estrazione è fallita per una regione. Un picco improvviso può indicare un'ingestion duplicata o un replay.Schema sorveglia la coerenza strutturale. Vi aiuta a intercettare colonne aggiunte, campi rimossi, modifiche di tipo o attributi rinominati prima che le trasformazioni e i consumatori a valle inizino a comportarsi in modo imprevedibile.
Distribuzione controlla se i valori restano coerenti con sé stessi nel tempo.
Una colonna può essere completamente popolata e strutturalmente valida e diventare comunque sospetta. Magari un punteggio di rischio che di solito copre un ampio intervallo improvvisamente si concentra in una fascia ristretta, oppure un segmento di clienti scompare.Lineage mostra da dove provengono i dati, che cosa li ha trasformati e che cosa dipende da essi.
Quando qualcosa si rompe, la lineage vi dice se il problema è nato nell'ingestion, nella trasformazione o in un modello a valle.
Dati in salute non sono semplicemente presenti. Sono puntuali, correttamente strutturati, statisticamente plausibili e tracciabili.
Perché questi pilastri funzionano insieme
Osservare un solo pilastro crea punti ciechi. Dati freschi possono essere sbagliati. Uno schema corretto può comunque nascondere valori errati. Una validazione rigorosa su una tabella non vi dirà dove ha avuto origine un problema a monte.
Ecco perché gli strumenti monofunzione spesso deludono dopo i primi incidenti. Un controllo sul numero di righe può intercettare dati mancanti, ma non una conversione di tipo che trasforma valori significativi in nulli. Un monitor dello schema può intercettare modifiche strutturali, ma non coglierà un drift sottile nel mix di categorie o cambiamenti insoliti nella distribuzione dei valori.
Una piattaforma matura combina questi segnali affinché i team possano rispondere rapidamente a tre domande pratiche:
Domanda | Che cosa deve mostrare la piattaforma |
|---|---|
I dati sono abbastanza aggiornati da poter essere usati? | Freschezza e tempestività |
Il dataset appare ancora strutturalmente e statisticamente valido? | Volume, schema e distribuzione |
Se è rotto, dove è iniziato il problema e che cosa ne dipende? | Lineage |
Questi cinque pilastri costituiscono la mappa minima indispensabile della salute dei dati. Qualsiasi cosa in meno lascia troppo all'ispezione manuale.
Observability, monitoraggio e data quality a confronto
Gran parte della confusione su questo tema nasce dal fatto che si usa un'unica espressione per descrivere tre attività diverse. Observability dell'infrastruttura, monitoraggio e data quality sono tutti importanti. Semplicemente risolvono problemi diversi.
Dove si ferma l'observability MELT
Nel mondo dell'infrastruttura e delle applicazioni, una piattaforma di observability aggrega di solito metriche, eventi, log e trace (MELT) affinché gli ingegneri possano comprendere lo stato interno dei sistemi distribuiti a partire dai loro output esterni. La guida all'architettura di SigNoz descrive questo schema come un sistema end-to-end per raccogliere, acquisire, archiviare e interrogare la telemetria negli ambienti cloud-native moderni.
Questo modello è utile. Aiuta i team a indagare sulla latenza delle applicazioni, sulle dipendenze tra servizi e sui comportamenti imprevisti a runtime. Il problema è che MELT vi parla del sistema che trasporta i dati, non necessariamente dello stato dei dati stessi.
Una pipeline può emettere log, trace e metriche in perfetta salute pur consegnando dati di business errati. È il divario che molti team scoprono troppo tardi.
Il divario è più ampio di quanto molti team di piattaforma si aspettino. L'analisi di Embrace sui punti ciechi delle piattaforme di observability osserva che il 73% dei team di data engineering riferisce che le pipeline di dati guaste causano più downtime per il business dei crash applicativi, mentre le piattaforme legacy non offrono ancora un supporto nativo per schema drift, tempestività dei dati e qualità a livello di record senza manutenzione manuale delle regole.
Per le organizzazioni più piccole che stanno costruendo il loro primo stack di analytics serio, i consigli di Up North Media sulla data analytics sono un utile promemoria del fatto che un reporting affidabile parte da dati sottostanti affidabili, non solo da dashboard accattivanti.
Un confronto pratico
Ecco il modo più rapido per distinguere queste categorie nel lavoro reale:
Categoria | Obiettivo principale | Metodo tipico | Punto cieco comune |
|---|---|---|---|
Monitoraggio | Intercettare guasti noti | Soglie, health check, alert di stato | Modalità di guasto sconosciute |
Observability applicativa | Indagare sul comportamento del sistema | Telemetria MELT e correlazione | Difetti silenziosi nei dati |
Strumenti di data quality | Applicare regole esplicite | Test e logica di validazione | Drift al di fuori delle regole predefinite |
Data observability | Rilevare problemi imprevisti di salute dei dati | Baseline, rilevamento delle anomalie, lineage, monitoraggio del comportamento dei dati | Copertura debole se implementata senza contesto di dominio |
Qui contano due aspetti pratici.
Primo, il monitoraggio è reattivo per definizione. Presuppone che sappiate che cosa osservare. Funziona per la saturazione dei dischi o per i job falliti. Funziona meno bene per sottili cambiamenti di categoria e per caricamenti riusciti ma in ritardo.
Secondo, gli strumenti classici di data quality hanno un ambito ristretto. Possono essere molto efficaci per regole di business come valori ammessi, unicità o campi obbligatori. Ma spesso dipendono dal fatto che i team aggiornino continuamente le regole man mano che sistemi sorgente e processi di business cambiano. Proprio questo onere di manutenzione spinge molti team a considerare data observability e data quality come discipline distinte ma complementari.
L'observability applicativa risponde alla domanda "che cosa è successo nel sistema?". La data observability risponde alla domanda "posso fidarmi dei dati prodotti dal sistema?".
Come sono progettate le piattaforme di data observability
Una volta superata la definizione, la domanda successiva è di solito architetturale. Dove gira la piattaforma, dove avviene l'elaborazione e quanti dati devono uscire dall'ambiente?

La pipeline sotto la piattaforma
A livello tecnico, una piattaforma di observability non è una singola funzionalità. È uno stack. La spiegazione di Selector sulle piattaforme di observability descrive il modello generale come un sistema unificato che correla log, metriche e trace affinché i team possano diagnosticare i problemi più rapidamente in ambienti complessi.
Per la data observability, l'architettura aggiunge un secondo requisito: deve ispezionare i dati stessi. Ciò significa raccogliere metadati, profilare il comportamento delle tabelle, apprendere baseline e far emergere anomalie in modo collegato alla lineage e al contesto operativo.
Un utile punto di riferimento è l'analisi di Kevin Slin sull'architettura dell'observability moderna, che spiega come le piattaforme su scala enterprise si integrino con la strumentazione, scoprano continuamente la telemetria, stabiliscano baseline basate su ML e unifichino i segnali in un'unica pipeline che supporta query in linguaggio naturale e rilevamento delle anomalie consapevole della topologia.
La stessa idea architetturale vale per i sistemi di dati. Servono un livello di raccolta, un modo per calcolare o recuperare le metriche di salute, uno storage per i pattern temporali e un'interfaccia di query che consenta agli ingegneri di indagare su che cosa è cambiato e dove.
Perché il modello di deployment è importante
Nei contesti enterprise, l'architettura non riguarda solo la scala. Riguarda il controllo.
I team dei settori finanziario, sanitario, delle telecomunicazioni e pubblico di solito non possono trattare l'observability come un semplice componente aggiuntivo SaaS. Dataset sensibili, carichi di lavoro regolamentati e policy di governance interne richiedono spesso modelli di deployment private cloud o on-premises. Se la piattaforma funziona solo esportando grandi quantità di dati operativi in un ambiente gestito dal fornitore, molte organizzazioni interromperanno la valutazione a quel punto.
Un modello di esecuzione in-database è spesso la risposta più pulita. L'elaborazione avviene dove i dati si trovano già. Ciò riduce lo spostamento dei dati, mantiene i record sensibili all'interno dell'ambiente del cliente ed evita di creare una seconda copia di dataset operativamente sensibili solo per monitorarli. È anche il motivo per cui i platform engineer esaminano spesso i pattern di architettura delle pipeline di dati prima di scegliere uno strumento. Il livello di observability deve adattarsi al warehouse, al lake, all'orchestrazione e al modello di governance già in uso.
La scelta architetturale non è estetica. Determina se sicurezza, costi e scalabilità funzionano in produzione o solo in una demo.
Dagli alert sulle anomalie all'impatto sul business
Sono i team tecnici ad acquistare l'observability. È il business a subirne le conseguenze.
Una buona piattaforma è importante perché i dati errati non restano all'interno del data team. Si diffondono nelle decisioni sui prezzi, nella chiusura contabile, nel reporting verso i clienti, nelle operazioni di servizio e negli output del machine learning.
Tre ambiti in cui la fiducia si rompe per prima
Le pipeline di AI e ML sono uno dei punti in cui si perde fiducia più rapidamente. Un modello può continuare a fornire previsioni mentre i suoi input si allontanano dai pattern su cui è stato addestrato. Nulla si blocca. L'output diventa semplicemente meno affidabile. Quando i team monitorano pattern di anomalie e stagionalità nei segnali temporali, hanno più possibilità di individuare il drift prima che le discussioni sulle prestazioni del modello si trasformino in gestione degli incidenti. È il valore pratico delle tecniche utilizzate nei workflow di rilevamento delle anomalie nelle serie temporali.
Il reporting finanziario è un altro caso ad alto rischio. Il reparto finance non ha bisogno solo di pipeline che vengano completate. Ha bisogno di numeri completi, tempestivi, strutturalmente coerenti e spiegabili. I caricamenti in ritardo possono rendere obsoleto il reporting del mattino. Le modifiche dello schema possono rompere la logica di mapping. La validazione a livello di record è importante perché alle domande di audit raramente interessa che lo stato della pipeline fosse verde.
Le dashboard operative falliscono più spesso per dati non aggiornati che per interruzioni evidenti. I team di vendita, supporto e operations prendono decisioni sulla base di quelli che sembrano dati attuali. Se un feed è arrivato in ritardo o una sorgente ha duplicato dei record, la dashboard può comunque essere visualizzata perfettamente mentre induce ad azioni sbagliate.
Che cosa cambia quando gli alert portano ad azioni concrete
Il cambiamento importante avviene quando gli alert diventano abbastanza specifici da poter essere instradati e risolti.
Invece di "pipeline non in salute", una piattaforma utile dice che la tabella degli eventi dei clienti è in ritardo rispetto alla consegna prevista, che un campo chiave ha cambiato tipo e che un modello a valle ne dipende. Questo accorcia il percorso dal rilevamento all'assegnazione della responsabilità.
Il rilevamento delle anomalie basato sull'AI fa parte di questo cambiamento. La panoramica di Plixer sul rilevamento delle anomalie basato sull'AI descrive lo schema tipico: i dati vengono raccolti e normalizzati, i modelli apprendono le baseline storiche e i dati in arrivo in tempo reale vengono confrontati con il comportamento normale appreso anziché solo con soglie statiche.
In termini di business è importante perché la maggior parte degli incidenti sui dati più costosi non si presenta ogni volta allo stesso modo. I team hanno bisogno di sistemi che si adattino al cambiare dei pattern dei dati.
Come valutare una piattaforma di observability enterprise
Un processo di acquisto di solito va fuori strada quando i team valutano screenshot ed elenchi di funzionalità invece dell'aderenza al modello operativo. La domanda giusta non è se uno strumento abbia il rilevamento delle anomalie. La domanda giusta è se sia in grado di rilevare anomalie utili nel vostro ambiente senza creare un onere di manutenzione che il vostro team non può sostenere.
Le domande da porre in un proof of concept
Iniziate da queste:
Come apprende il comportamento normale? Chiedete se la piattaforma è in grado di adattarsi a stagionalità, cambi di trend e baseline in evoluzione invece di basarsi solo su soglie fisse.
Dove avviene l'elaborazione? Per molte aziende l'esecuzione privata è un requisito, non una preferenza.
Copre sia il rilevamento automatico sia le regole di business esplicite? Di solito servono entrambi.
Come gestisce le modifiche dello schema e la tempestività? Sono modalità di guasto frequenti negli ambienti warehouse reali.
Chi può usarla? Se solo uno specialista è in grado di interpretare i risultati, l'adozione si bloccherà.

Che cosa fallisce di solito nei rollout enterprise
Il fallimento più comune è l'eccessivo affidamento sulle regole manuali. All'inizio funzionano. Poi i sistemi sorgente evolvono, le pianificazioni cambiano e l'insieme delle regole diventa un progetto di manutenzione a sé stante.
Ecco perché i metodi adattivi sono importanti. La spiegazione di Oracle sul rilevamento delle anomalie osserva che i sistemi basati sull'AI creano baseline dinamiche del comportamento normale e si adattano nel tempo a nuovi pattern, invece di dipendere interamente da regole statistiche statiche.
Un secondo punto di fallimento è la scarsa flessibilità di deployment. Se vincoli di sicurezza, compliance o residenza dei dati impongono eccezioni, il rollout diventa una questione politica prima ancora di diventare utile.
Un terzo è la frammentazione degli strumenti. Uno strumento sorveglia le pipeline, un altro applica le regole sui dati, un terzo profila le metriche di qualità, e nessuno condivide abbastanza contesto da accelerare l'analisi delle cause profonde.
Le piattaforme enterprise più solide riducono la manutenzione manuale delle regole, si adattano a modelli di deployment regolamentati e offrono sia agli analisti sia agli ingegneri una visione utilizzabile della salute dei dati.
L'approccio di digna a una salute dei dati unificata
Un esempio pratico di questo nuovo modello è digna, che combina observability e data quality in un'unica piattaforma invece di trattarle come silos operativi separati.
I suoi componenti corrispondono chiaramente alle esigenze operative discusse sopra: Data Anomalies per i cambiamenti di comportamento, Timeliness per arrivi in ritardo o mancanti, Schema Tracker per le modifiche strutturali, Data Validation per regole esplicite a livello di record e viste di analytics per l'analisi dei trend. La piattaforma esegue le analisi all'interno dei database dei clienti e supporta il deployment private cloud o on-premises, in linea con i vincoli architetturali che molti team enterprise devono affrontare.
Questa combinazione è importante perché in produzione observability e data quality di solito si intersecano. I team non vogliono un prodotto per lo schema drift, un altro per l'applicazione delle regole e un altro ancora per l'analisi dei trend, se questi strumenti non possono condividere il contesto.
Merita attenzione anche l'approccio al rilevamento delle anomalie. Secondo la descrizione di digna delle sue tecniche di rilevamento delle anomalie con AI, il modulo Data Anomalies utilizza Isolation Forest, autoencoder e soglie adattive per apprendere il comportamento normale, inclusi stagionalità e trend, e quindi segnalare le deviazioni senza manutenzione manuale delle regole né competenze di ML.
La lezione generale è semplice. Una piattaforma di observability utile non si ferma ai segnali dell'infrastruttura. Rende lo stato dei dati visibile, gestibile e governabile nell'ambiente in cui i dati risiedono.
Se il vostro team si trova ad affrontare dashboard non aggiornate, schema drift silenzioso o incidenti sui dati che non compaiono mai negli alert dell'infrastruttura, digna è un'opzione da valutare. Si concentra su data observability e data quality in-database per ambienti enterprise, con supporto per rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema e validazione a livello di record in configurazioni private cloud o on-premises.
Poiché in produzione observability e data quality di solito si intersecano, scoprite come digna riunisce rilevamento delle anomalie, tempestività, tracciamento dello schema e validazione a livello di record nella sua soluzione di data quality management.
Domande frequenti
Che cos'è una piattaforma di data observability?
Una piattaforma di data observability offre ai team una visibilità approfondita e in tempo reale sullo stato di salute e sul comportamento dei dati stessi, non solo dei server e delle applicazioni che li trasportano. Intercetta degrado della qualità, ritardi delle pipeline e modifiche dello schema prima che raggiungano report, dashboard o modelli di AI, anche quando tutti i job sono andati a buon fine.
Quali sono i cinque pilastri della data observability?
I cinque pilastri sono freschezza, volume, schema, distribuzione e lineage. La freschezza conferma che i dati sono arrivati in tempo, il volume confronta il numero di righe con le aspettative, lo schema sorveglia la coerenza strutturale, la distribuzione verifica che i valori appaiano ancora normali e la lineage mostra da dove provengono i dati e che cosa ne dipende a valle.
Qual è la differenza tra observability, monitoraggio e data quality?
Il monitoraggio intercetta guasti noti con soglie e health check. L'observability applicativa utilizza la telemetria MELT (metriche, eventi, log e trace) per indagare sul comportamento del sistema, ma non rileva i difetti silenziosi nei dati. Gli strumenti di data quality applicano regole esplicite, mentre la data observability usa baseline, rilevamento delle anomalie e lineage per individuare problemi imprevisti di salute dei dati.
Perché è importante il modello di deployment di una piattaforma di observability?
I team dei settori finanziario, sanitario, delle telecomunicazioni e pubblico spesso non possono esportare dati sensibili verso un servizio gestito dal fornitore. Un modello di esecuzione in-database esegue l'elaborazione dove i dati si trovano già, riducendo lo spostamento dei dati, mantenendo i record sensibili nell'ambiente del cliente ed evitando di creare una seconda copia solo per monitorarli.
Che cosa chiedere in un proof of concept di data observability?
Chiedete come la piattaforma apprende il comportamento normale, inclusi stagionalità e cambi di trend, e dove avviene l'elaborazione. Verificate poi se copre sia il rilevamento automatico sia le regole di business esplicite, come gestisce le modifiche dello schema e la tempestività e se anche persone non specialiste sono in grado di interpretare i risultati che produce.


