Cos'è una piattaforma dati
|
8
min di lettura

Una piattaforma dati è l'insieme integrato di strumenti e infrastrutture che un'organizzazione utilizza per acquisire, archiviare, elaborare, governare e rendere disponibili i dati per l'analisi e l'AI. Il mercato globale delle piattaforme dati è stato stimato in 82,4 miliardi di USD nel 2024 e si prevede che superi i 210 miliardi di USD entro il 2031, con un tasso di crescita annuo composto del 14,5% nel periodo di previsione, secondo la panoramica di 6Wresearch sul mercato delle piattaforme dati.
Il vostro team di prodotto potrebbe già convivere con il problema. Un export del CRM arriva come foglio di calcolo, una replica Postgres contiene i dati applicativi, le piattaforme pubblicitarie consegnano file CSV e una dashboard Looker si rompe all'improvviso perché qualcuno ha rinominato un campo. Ogni sorgente funziona da sola, ma nessuno sa spiegare facilmente quale versione sia quella attuale, chi possa usarla, se sia arrivata in tempo o perché una metrica sia cambiata.
Di solito il problema non sono i dati in sé. È l'assenza di un unico sistema operativo connesso per i dati.
Indice
Una definizione semplice di piattaforma dati
I livelli fondamentali di ogni piattaforma dati
L'ingestion è la banchina di carico
Lo storage è la dispensa e la cella frigorifera
Il compute è la cucina
La governance è l'ispettore e il ricettario
L'observability è il pannello di controllo della cucina
Come le piattaforme dati sono diventate ciò che sono oggi
Data warehouse, data lake e lakehouse a confronto
Perché l'observability deve far parte della piattaforma
I guasti che i team non vedono in tempo
Qualità e observability rispondono a domande diverse
Le piattaforme dati nella pratica in diversi settori
Una checklist pratica per valutare la vostra piattaforma
Ingestion e storage
Compute e modellazione
Governance e accesso
Observability e affidabilità
Una definizione semplice di piattaforma dati
Pensate a una piattaforma dati come alla supply chain condivisa dei dati dell'organizzazione. Riceve informazioni dai sistemi operativi, le archivia in forme adeguate, le prepara per l'uso, applica regole di accesso e di significato ed espone output affidabili ad analisti, applicazioni e sistemi di AI.
Questa definizione ha un'implicazione importante: una piattaforma dati non è necessariamente un singolo prodotto. È un insieme integrato di infrastrutture, servizi, policy e interfacce. Un data warehouse può fornire storage ed elaborazione SQL, mentre servizi separati gestiscono ingestion, trasformazione, catalogazione, controllo degli accessi e monitoraggio. Questi elementi diventano una piattaforma quando lavorano insieme come un sistema affidabile anziché come strumenti scollegati.
In pratica, ponetevi cinque domande:
I dati arrivano in modo affidabile? È il livello di ingestion, che copre file, API, eventi applicativi e change data capture.
Dove risiedono? Lo storage può includere tabelle di data warehouse, object storage, tabelle lakehouse o archivi specializzati in tempo reale.
Come vengono preparati? Il compute esegue query, trasformazioni, aggregazioni e carichi di lavoro di machine learning.
Cosa significano i dati e chi può usarli? La governance gestisce definizioni, lineage, catalogazione, permessi e registri di audit.
Come fanno i team a sapere che il sistema è sano? L'observability tiene traccia di freschezza, modifiche di schema, anomalie, comportamento delle pipeline e impatto a valle.
Le linee guida di architettura enterprise descrivono comunemente questo tipo di piattaforma come software che aiuta gli utenti ad archiviare, accedere, gestire e governare i dati aziendali sia sul data plane sia sul data control plane, come descritto nell'analisi di IDC sul mercato delle piattaforme dati.
Una piattaforma dati quindi non è solo un database, perché un database può archiviare dati senza gestirne l'intero ciclo di vita. Non è solo uno strumento di BI, perché le dashboard consumano dati già preparati anziché gestire ingestion e governance. E non è automaticamente una suite di un unico vendor. La caratteristica che la definisce è l'integrazione.
Per un inquadramento enterprise più ampio, è utile questa panoramica sulle piattaforme dati enterprise. La domanda centrale resta semplice: la vostra organizzazione riesce a passare dal sistema sorgente a una decisione affidabile senza dover cucire manualmente ogni fase?
I livelli fondamentali di ogni piattaforma dati
Un ristorante aiuta a comprendere meglio l'architettura. I fornitori consegnano gli ingredienti, il personale li ripone, i cuochi preparano i piatti, gli ispettori fanno rispettare gli standard e i responsabili sorvegliano l'attività per cogliere i segnali di problemi. Una piattaforma dati segue lo stesso schema.
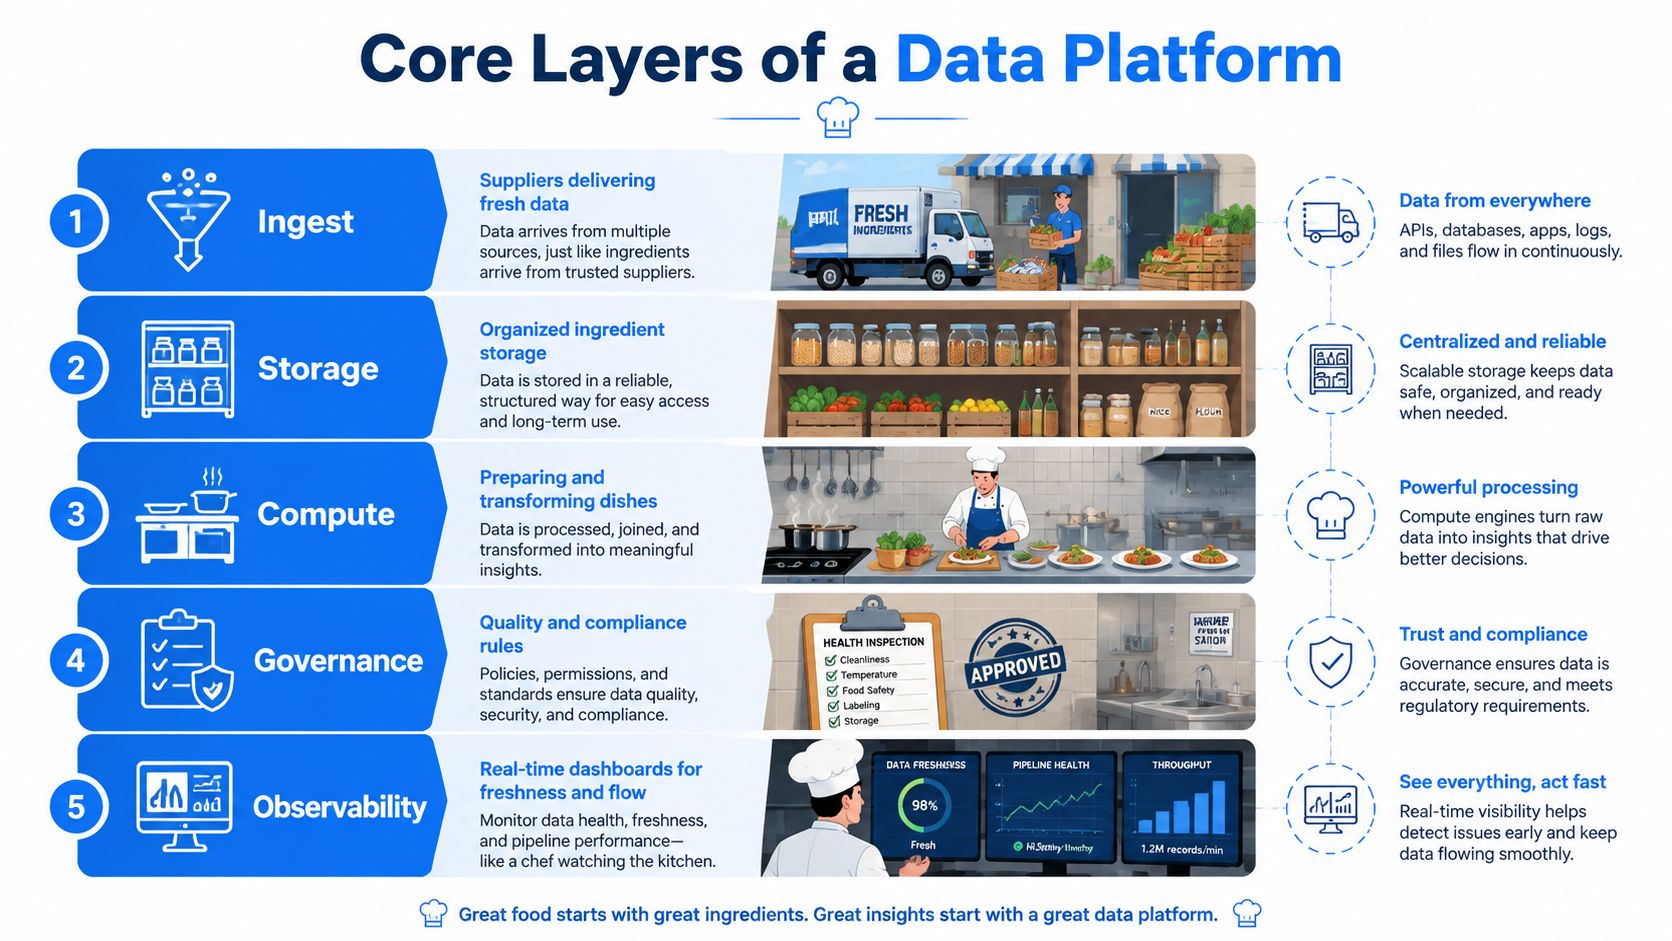
L'ingestion è la banchina di carico
L'ingestion porta la materia prima nella piattaforma. Le sorgenti possono includere eventi applicativi, API, file, repliche di database o flussi di change data capture. Kafka può trasportare flussi di eventi, mentre connettori e job pianificati possono caricare file e record operativi.
La banchina di carico ha bisogno di più di una porta. Servono orari di ricevimento, identificazione delle sorgenti, gestione degli errori e un registro di ciò che è arrivato. Senza questi controlli, una piattaforma può accettare i dati lasciando comunque il team incapace di dire se una consegna era completa.
Le organizzazioni che devono collegare sistemi esterni spesso valutano servizi di Data API insieme a connettori nativi e strumenti per gli eventi. La scelta giusta dipende dalla varietà delle sorgenti, dalle esigenze di latenza e da quanta logica di pipeline il team interno vuole gestire in proprio.
Lo storage è la dispensa e la cella frigorifera
Lo storage conserva gli ingredienti in forme adatte a compiti diversi. Amazon S3 può contenere oggetti strutturati e non strutturati, mentre Snowflake può organizzare tabelle analitiche curate. Un lakehouse può applicare formati di tabella transazionali sopra l'object storage, così i team possono lavorare con dataset grandi ed eterogenei mantenendo una gestione delle tabelle più solida.
Le decisioni sullo storage influiscono su costi, velocità di accesso, conservazione e governance. I dati grezzi possono dover restare vicini alla loro forma originale per l'esplorazione, mentre i dati curati dovrebbero essere organizzati per un uso di business ripetibile.
Il compute è la cucina
Il compute trasforma i dati archiviati in qualcosa di utile. I motori SQL rispondono alle domande, i framework di trasformazione come dbt costruiscono dataset modellati e i motori di elaborazione distribuita preparano i dati per carichi di lavoro complessi o per il machine learning.
La distinzione importante è che lo storage conserva gli ingredienti, mentre il compute fa il lavoro. Separarli può permettere ai team di scalare elaborazione e storage in modo indipendente, ma crea anche confini operativi che richiedono responsabilità chiare.
La governance è l'ispettore e il ricettario
La governance definisce chi può accedere ai dati, cosa significa una metrica, da dove proviene un dataset e quali controlli vi si applicano. Unity Catalog, il controllo degli accessi basato sui ruoli, il controllo degli accessi basato sugli attributi, l'audit logging, i cataloghi e gli strumenti di lineage possono supportare queste responsabilità.
La governance protegge anche la coerenza. Se un team definisce “cliente attivo” in modo diverso da un altro, entrambe le dashboard possono essere tecnicamente corrette pur portando a decisioni contrastanti.
L'observability è il pannello di controllo della cucina
L'observability mostra se le consegne sono arrivate, se lo storage è disponibile, se le trasformazioni sono state completate correttamente e se gli output restano affidabili. Strumenti come Monte Carlo possono monitorare il comportamento dei dati, mentre le metriche e gli alert nativi della piattaforma forniscono il contesto operativo.
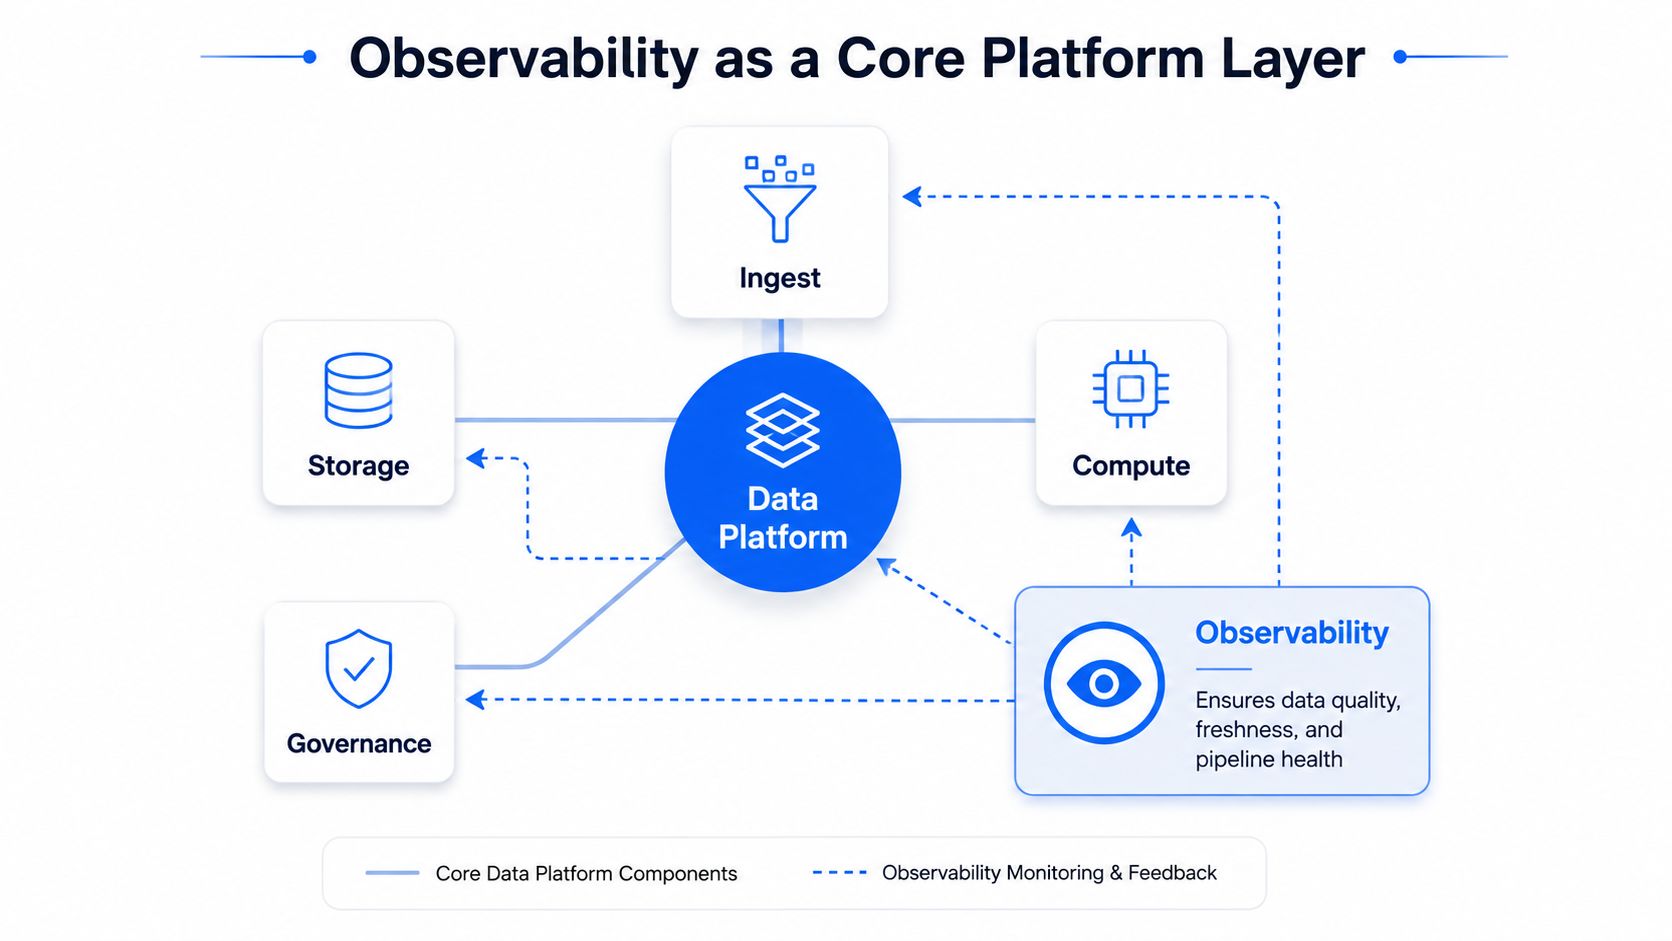
Le linee guida di architettura di impostazione IBM trattano l'observability come un livello fondamentale della piattaforma dati, perché i team hanno bisogno di visibilità su affidabilità, freschezza e comportamento delle pipeline, non solo sul successo dei job. Una pipeline può terminare con successo e pubblicare comunque dati obsoleti, incompleti o strutturalmente modificati.
Una visione architetturale utile è presentata in questa guida all'architettura dei sistemi di dati. La lezione è semplice: spostare i dati è solo una parte del lavoro. Una piattaforma funzionante deve anche spiegare, proteggere e ispezionare continuamente ciò che sposta.
Come le piattaforme dati sono diventate ciò che sono oggi
Le piattaforme dati si sono evolute attraverso compromessi ricorrenti, non attraverso una sequenza ordinata di tecnologie che si sostituiscono a vicenda. I team hanno ripetutamente dovuto bilanciare disciplina dello schema, flessibilità, velocità analitica, costi dell'infrastruttura e governance.
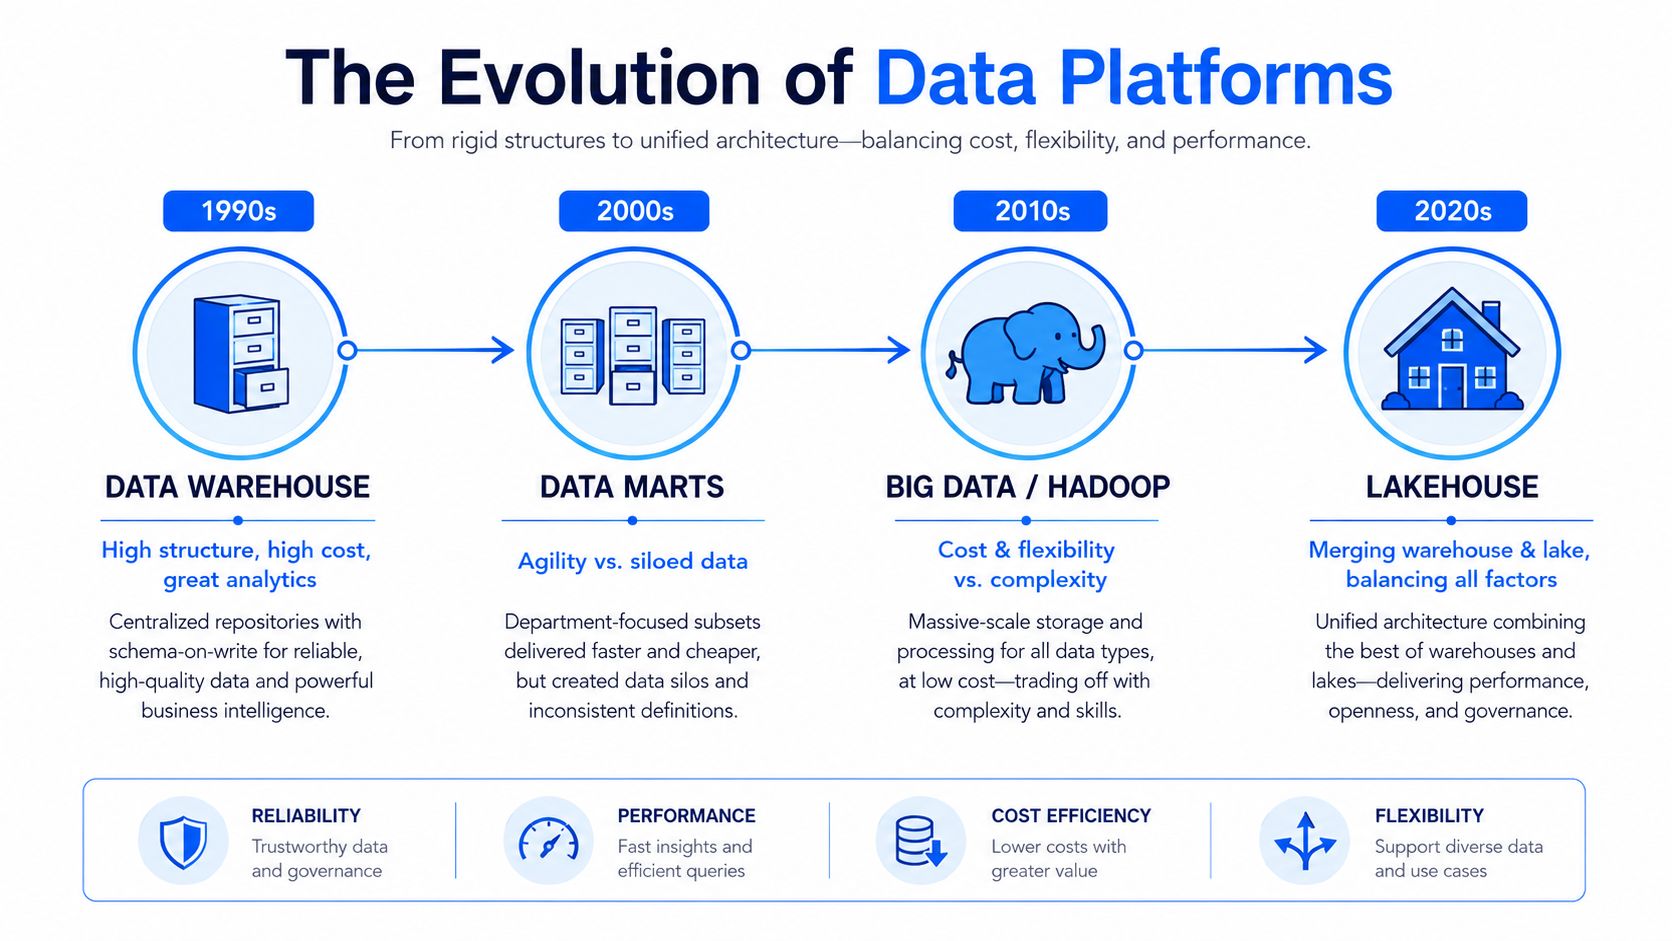
Il data warehouse ha introdotto un modello centralizzato per il reporting. Le organizzazioni hanno consolidato le informazioni di più sistemi in schemi strutturati, offrendo agli analisti una visione unificata del business. Questo approccio supportava analisi SQL affidabili, ma schemi rigidi e costose appliance on-premises rendevano le modifiche difficili e lente.
I data mart hanno introdotto una maggiore flessibilità locale. I singoli reparti potevano modellare i dati in base alle proprie esigenze di reporting, ma la stessa flessibilità poteva generare logiche duplicate e definizioni concorrenti. Un data mart della finanza e uno del marketing potevano calcolare ciascuno in modo diverso la stessa misura di business, anche attingendo a sorgenti simili.
Il data lake è nato dall'esigenza di uno storage più economico e più ampio. L'object storage e Hadoop hanno reso pratico conservare file grezzi, log, eventi e altri formati senza modellare tutto prima dell'arrivo. Il prezzo da pagare era la complessità. Senza responsabilità, catalogazione, controlli di qualità e regole sul ciclo di vita, un data lake poteva diventare una raccolta di file di cui nessuno si fidava.
Il lakehouse è emerso come risposta pragmatica. Formati di tabella come Delta Lake, Apache Iceberg e Apache Hudi aggiungono gestione dello schema e comportamento transazionale sopra uno storage aperto, aiutando un unico ambiente a supportare sia carichi di lavoro analitici sia di machine learning.
L'architettura è ancora in fase di convergenza. I data warehouse gestiti supportano sempre più dati semi-strutturati e formati di file aperti, mentre i data lake moderni adottano transazioni, governance e gestione delle tabelle tipiche dei data warehouse. Questa storia è riassunta in una panoramica sull'evoluzione storica delle piattaforme dati.
La conclusione utile non è che un'architettura abbia vinto. È che ogni piattaforma eredita dei compromessi. Un team che sceglie un'architettura dovrebbe chiedersi quali vincoli contano di più: SQL rapido e governato, conservazione economica dei dati grezzi, accesso flessibile per il machine learning, formati aperti o semplicità operativa.
Data warehouse, data lake e lakehouse a confronto
Data warehouse, data lake e lakehouse possono tutti supportare l'analisi, ma organizzano il lavoro in modo diverso. La scelta migliore dipende dai formati dei vostri dati, dai carichi di lavoro, dalle aspettative di governance e dalle competenze che i vostri team già possiedono.
Dimensione | Data warehouse | Data lake | Lakehouse |
|---|---|---|---|
Formati tipici | Tabelle strutturate curate, con un supporto crescente per i dati semi-strutturati | File grezzi, log, eventi, oggetti strutturati e non strutturati | Tabelle strutturate e semi-strutturate su object storage aperto |
Carichi di lavoro principali | BI, reporting SQL, analisi di business governata | Conservazione dei dati grezzi, esplorazione, data science, elaborazioni eterogenee | BI, analytics, machine learning e data engineering condiviso |
Approccio allo schema | Lo schema viene di solito definito prima o durante il caricamento | Lo schema può essere applicato in seguito, il che aumenta la flessibilità | Controlli di schema e di tabella vengono aggiunti sopra uno storage flessibile |
Modello di governance | Spesso centralizzato e maturo per i dataset curati | Può variare molto e richiede una progettazione consapevole di catalogazione e policy | Punta a combinare storage aperto e una governance delle tabelle più solida |
Profilo dei costi | Ottimizzato per prestazioni analitiche gestite, con costi determinati dall'uso di compute e storage | Spesso conveniente per uno storage ampio, ma richiede ulteriore engineering per renderlo utilizzabile | Bilancia l'economia di uno storage condiviso con le esigenze di elaborazione e gestione |
Team che lo utilizzano | Analisti, sviluppatori BI, analytics engineer, finance e operations | Data engineer, data scientist, ricercatori e utenti esplorativi | Team trasversali di piattaforma, analytics, engineering e AI |
Un data warehouse è spesso la scelta più naturale quando la maggior parte dei carichi di lavoro riguarda tabelle curate e SQL veloce. Offre agli analisti un ambiente controllato, ma i team potrebbero aver bisogno di sistemi aggiuntivi per file grezzi, elaborazioni specializzate o sperimentazione di machine learning.
Un data lake è utile quando l'organizzazione deve conservare dati eterogenei prima di conoscerne tutti gli usi futuri. Questa flessibilità comporta una responsabilità. Catalogazione, responsabilità sui dati, tracciamento dello schema e policy di accesso devono impedire che l'ambiente diventi un archivio non gestito.
Un lakehouse cerca di combinare i due modelli. Può offrire storage aperto e ampio accesso ai dati aggiungendo una semantica delle tabelle più solida, gestione delle transazioni e governance. Questo però non elimina la complessità. I team devono comunque comprendere layout dei file, scelte di compute, manutenzione delle tabelle, permessi e isolamento dei carichi di lavoro.
La distinzione tra un data lake e un data mart più mirato è approfondita in questo confronto tra data lake e data mart. La decisione dovrebbe seguire la realtà dei carichi di lavoro, non le mode. Una piattaforma ibrida può essere sensata quando la finanza ha bisogno di un reporting governato sul data warehouse, la data science ha bisogno di accedere agli eventi grezzi e le operations hanno bisogno di dati a bassa latenza da un archivio specializzato.
Perché l'observability deve far parte della piattaforma
L'observability va collocata accanto a ingestion, storage, compute e governance perché ogni livello può introdurre un guasto che dall'esterno sembra corretto. Uno stato verde della pipeline non dimostra che i dati siano freschi, completi, strutturalmente compatibili o significativi per chi li consuma.
La data observability è il monitoraggio continuo di pipeline, tabelle, job e pattern di consumo. Cerca cambiamenti di freschezza, schema drift, anomalie di volume, trasformazioni fallite e variazioni di runtime, invece di basarsi solo sul successo di un task pianificato. Le linee guida enterprise sulla data observability descrivono questo perimetro operativo più ampio.
I guasti che i team non vedono in tempo
Lo schema drift è un guasto silenzioso molto comune. Un sistema sorgente può aggiungere una colonna, rimuovere un campo o cambiare un tipo di dato senza preavviso. Un modello a valle potrebbe fallire subito, oppure continuare a funzionare producendo risultati incompleti o fuorvianti. La ricerca sul monitoraggio dello schema identifica queste modifiche strutturali come segnali che i sistemi di observability dovrebbero monitorare nel tempo.
La freschezza crea un altro rischio. Un dataset può essere valido nella struttura ed essere comunque inutilizzabile perché la sua ultima consegna è arrivata in ritardo. I team confrontano l'arrivo effettivo con le pianificazioni o le aspettative di livello di servizio per rilevare i ritardi prima che i dati obsoleti raggiungano dashboard e report operativi, una distinzione illustrata nelle indicazioni di digna sulla tempestività.
Duplicati, variazioni di volume inattese e distribuzioni che cambiano possono creare un'altra classe di incidenti. Una tabella dei ricavi può essere caricata correttamente pur contenendo record ripetuti, e una feature di ML può esistere tecnicamente pur riflettendo una popolazione superata.
Qualità e observability rispondono a domande diverse
I controlli di qualità convalidano regole note. Ad esempio, un test a livello di record può richiedere che un identificativo esista o che un valore rientri in un intervallo accettato. L'observability rileva comportamenti inattesi, traccia l'impatto lungo il lineage e aiuta a diagnosticare cambiamenti che le regole predefinite non avevano previsto.
Regola pratica: usate la validazione deterministica per le regole che conoscete già e l'observability per i cambiamenti che non sapevate di dover aspettare.
I due approcci lavorano insieme. Una strategia unificata di qualità dei dati e observability spiega perché le aziende combinano la validazione con rilevamento delle anomalie, lineage e tracciamento dello schema.
Rendere l'observability parte della piattaforma cambia le responsabilità. I data engineer ricevono alert con il contesto della sorgente e dei sistemi a valle, gli analytics engineer possono vedere se un modello è coinvolto e i team di governance ottengono evidenze sul comportamento dei dati. Invece di scoprire un problema attraverso una dashboard rotta, i team possono indagare il punto di ingestion o di schema in cui il cambiamento ha avuto origine. Le pratiche di data observability forniscono un quadro utile per valutare questa capacità.
Le piattaforme dati nella pratica in diversi settori
L'architettura diventa più chiara quando gli stessi livelli risolvono problemi operativi diversi.
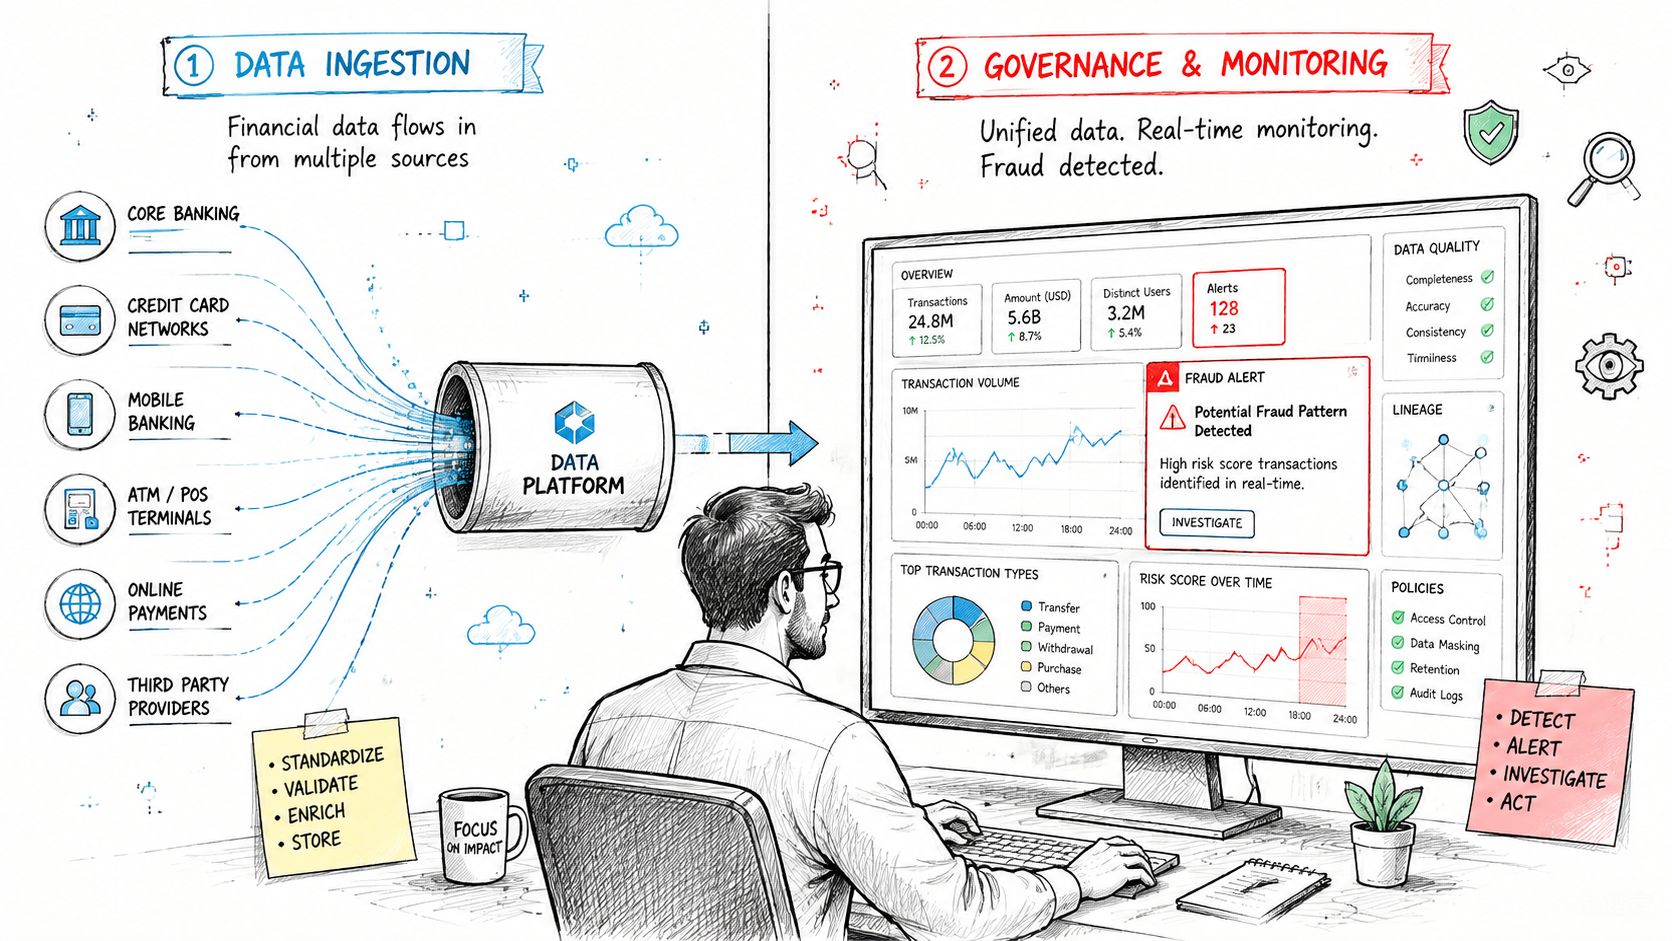
Una banca retail può acquisire eventi di transazione, anagrafiche dei clienti e segnali dei dispositivi in una piattaforma che supporta l'analisi delle frodi quasi in tempo reale. Il livello di ingestion deve gestire eventi tempestivi, il compute deve confrontare il comportamento attuale con i pattern rilevanti, la governance deve limitare l'accesso ai dati finanziari sensibili e l'observability deve individuare consegne mancanti o modifiche strutturali prima che i flussi antifrode utilizzino input difettosi. Il compromesso è una maggiore complessità operativa in cambio di un rilevamento più rapido e di un uso più controllato delle informazioni sensibili.
Una rete ospedaliera affronta una diversa combinazione di vincoli. Cartelle cliniche, dati sui rimborsi, sistemi operativi e dati dei dispositivi possono dover essere riuniti, ma l'accesso non può essere uniforme. La governance stabilisce quali ruoli possono vedere quali dataset, il lineage aiuta gli utenti a capire come è stato prodotto un report e la validazione aiuta a far rispettare le regole sui record critici. L'organizzazione accetta un maggiore onere di controllo perché tracciabilità e accesso limitato contano quanto la comodità analitica.
I team delle telecomunicazioni hanno spesso bisogno sia della prospettiva del cliente sia di quella della rete. Un lakehouse può fornire una base comune per le dashboard sul churn e per i modelli di anomalia della rete, mentre modelli di compute separati servono gli utenti SQL e i team di machine learning. L'observability aiuta i platform engineer a distinguere un reale cambiamento nel comportamento dei clienti da una pipeline guasta o da un feed incompleto.
Le organizzazioni del settore pubblico possono condividere dati tra enti mantenendo requisiti di residenza, accesso e audit. Una piattaforma modulare può centralizzare la catalogazione e la definizione delle policy, consentendo ai diversi dipartimenti di mantenere la responsabilità dei propri dataset. Il compromesso accettato è che l'accesso tra enti richiede controlli più formali di uno scambio informale di file, ma il risultato è un'analisi più riproducibile e responsabilità più chiare.
Questi esempi non indicano un'unica architettura universale. Mostrano perché la progettazione della piattaforma deve partire dalle conseguenze dei guasti. Un feed di telecomunicazioni in ritardo, un campo clinico esposto, una metrica bancaria inspiegabile e un dataset del settore pubblico incompleto richiedono tutti controlli diversi, anche quando i livelli sottostanti sembrano simili.
Una checklist pratica per valutare la vostra piattaforma
Usate le domande seguenti per valutare il vostro stack attuale. Un “no” non significa automaticamente che l'architettura sia sbagliata. Identifica un confine in cui integrazione, responsabilità o visibilità potrebbero essere deboli.
Ingestion e storage
Copertura delle sorgenti: la piattaforma può accettare input sia batch sia in streaming senza creare un modello operativo su misura per ogni sorgente?
Collocazione dei dati: sapete quali dataset appartengono a tabelle curate del data warehouse, allo storage flessibile del data lake o a tabelle lakehouse?
Controllo del ciclo di vita: i responsabili sono in grado di indicare le aspettative di conservazione, accesso e freschezza per i dataset importanti?
Compute e modellazione
Base condivisa: analytics SQL, flussi di trasformazione e carichi di lavoro di machine learning possono usare dati governati senza copie non necessarie?
Riproducibilità: gli analisti possono ricondurre una metrica dalla sua definizione semantica, attraverso le trasformazioni, fino ai dati sorgente?
Adeguatezza ai carichi di lavoro: il livello di compute supporta la latenza, la scala e i modelli di elaborazione di cui i vostri team hanno bisogno?
Governance e accesso
Chiarezza dei permessi: la piattaforma può applicare un controllo degli accessi basato sui ruoli o sugli attributi anziché affidarsi ad accordi informali?
Lineage e catalogazione: un utente può scoprire cosa significa un dataset, chi ne è responsabile e quali prodotti a valle dipendono da esso?
Verificabilità: il vostro team può ricostruire chi ha avuto accesso a dati sensibili e come è stato prodotto un numero riportato?
Observability e affidabilità
Visibilità sulla freschezza: il team saprà che una consegna è in ritardo o mancante prima che un utente della dashboard segnali il problema?
Protezione strutturale: la piattaforma è in grado di rilevare colonne aggiunte, campi rimossi e cambi di tipo di dato?
Segnali comportamentali: è in grado di far emergere anomalie in volumi, valori, metriche di business, esecuzione delle pipeline e consumo della piattaforma?
Una piattaforma matura non deve necessariamente provenire da un unico vendor. Deve però essere integrata a sufficienza perché un team possa rispondere alla domanda “da dove viene questo numero?” senza condurre un'indagine su sei strumenti diversi. La checklist sull'affidabilità dei dati per i data team può aiutare a trasformare queste domande in una valutazione più formale.
digna offre una piattaforma enterprise di qualità dei dati e observability che viene eseguita nell'ambiente del cliente, con controlli all'interno del database per anomalie, tempestività, validazione e modifiche di schema su data warehouse, data lake e pipeline. Visitate digna per scoprire come il suo approccio modulare al monitoraggio può inserirsi in una piattaforma dati governata.
Domande frequenti
Che cos'è una piattaforma dati?
L'insieme integrato di strumenti e infrastrutture che un'organizzazione utilizza per acquisire, archiviare, elaborare, governare e rendere disponibili i dati per l'analisi e l'AI. L'implicazione importante è che una piattaforma dati non è necessariamente un singolo prodotto e non è solo un database.
Quali sono i livelli fondamentali?
Ingestion, storage, compute, governance e observability, che corrispondono a un ristorante: l'ingestion è la banchina di carico, lo storage è la dispensa e la cella frigorifera e il compute è la cucina. Ogni livello comporta conseguenze proprie in termini di costi, velocità di accesso, conservazione e governance.
Quali cinque domande rivelano se ne avete una?
I dati arrivano in modo affidabile? Dove risiedono? Come vengono preparati? Cosa significano i dati e chi può usarli? Come fanno i team a sapere che il sistema è sano? Uno stack che non sa rispondere alle ultime due è una raccolta di strumenti, non una piattaforma.
In cosa una piattaforma dati è diversa da un database?
Un database può archiviare dati senza gestirne l'intero ciclo di vita. Le linee guida di architettura enterprise descrivono una piattaforma come software che aiuta gli utenti ad archiviare, accedere, gestire e governare i dati aziendali sia sul data plane sia sul data control plane, ovvero la parte che un database da solo non fornisce.
Quanto è grande il mercato delle piattaforme dati?
È stato stimato in 82,4 miliardi di USD nel 2024 e si prevede che superi i 210 miliardi di USD entro il 2031, con un tasso di crescita annuo composto del 14,5% nel periodo di previsione. La crescita riflette il consolidamento di strumenti separati in piattaforme governate, più che un semplice aumento dello storage.


