Che cos'è la residenza dei dati: guida alla compliance 2026
|
7
min di lettura

Molti team pensano di aver già risolto la questione della residenza dei dati perché hanno scelto la regione cloud “giusta”. Poi l'ufficio legale inoltra un questionario di un cliente che chiede la prova che dati personali, backup, log ed elaborazioni a valle non escano mai da una specifica giurisdizione.
È in quel momento che la risposta facile crolla.
Si inizia a ricostruire il percorso effettivo dei dati. Le scritture dell'applicazione finiscono in una regione. I backup gestiti vengono replicati altrove. Gli eventi di analytics confluiscono in una piattaforma di terze parti. Un export del supporto viene scaricato da un team in un altro paese. Un workflow di machine learning copia una porzione dei dati in un ambiente diverso. Nessuno ha pianificato una violazione, ma l'architettura l'ha comunque creata.
Ecco perché “che cos'è la residenza dei dati” non è più una semplice domanda da glossario. È una questione di design dei sistemi. Influisce su come strutturate storage, pipeline, observability, disaster recovery, selezione dei fornitori ed evidenze di audit. I team che la gestiscono bene la trattano come un vincolo operativo fin dal primo giorno, non come una casella da spuntare dopo il procurement.
Indice
Progettare per la conformità alla residenza dei dati: una guida pratica
Garantire la residenza dei dati con la data observability in-database
La residenza dei dati è una disciplina continua, non un interruttore
I vostri dati non sono dove pensate
Lo scenario tipico è familiare. Un team di prodotto lancia il servizio in Europa, seleziona una regione cloud nell'UE e presume che la questione della residenza sia chiusa. Mesi dopo, il procurement di un cliente enterprise chiede una garanzia scritta che i dati dei clienti resteranno entro i confini europei per storage, elaborazione, ripristino e monitoraggio.
È allora che i team si rendono conto di sapere dove si trova il database principale, ma non dove finisce tutto il resto.
La policy di backup potrebbe replicare gli snapshot in una seconda area geografica. Una coda di messaggi gestita potrebbe eseguire il failover tra regioni. Uno strumento di BI potrebbe memorizzare in cache estrazioni al di fuori della giurisdizione prevista. Un workflow di supporto potrebbe includere export CSV manuali. Persino i metadati possono diventare un problema se gli strumenti inviano campioni di tabelle o tracce delle query a un backend SaaS controllato dal fornitore.
La mappa nascosta che nessuno aggiorna
La maggior parte delle organizzazioni possiede frammenti della verità in luoghi diversi. L'infrastruttura conosce le regioni cloud. La sicurezza conosce i fornitori. Il data engineering conosce le pipeline. I team applicativi conoscono i servizi che hanno integrato. Nessuno è responsabile della mappa completa degli spostamenti, a meno che l'azienda non abbia costruito questa disciplina in modo deliberato.
Ecco perché il lavoro sulla residenza dei dati inizia spesso con una fase di scoperta, non di configurazione.
Se vi serve un modo chiaro per ragionare su spostamenti, storage e trasformazioni, è utile separare l'origine dal flusso. Questa panoramica su data provenance e data lineage è utile perché i problemi di residenza si nascondono di solito nel percorso tra i sistemi, non solo nella tabella finale.
Il modo più rapido per non superare una verifica sulla residenza dei dati è rispondere indicando la regione dello storage primario e ignorando backup, log, file temporanei ed effetti collaterali dei fornitori.
Cosa si rompe nella pratica
Ciò che funziona male è una visione ristretta della “posizione dei dati” che controlla solo il database di produzione.
Ciò che funziona meglio è porsi domande più difficili:
Dove vengono acquisiti i dati: web app, app mobile, importazione batch, API, feed dei partner.
Dove vengono elaborati: job ETL, feature engineering, indicizzazione per la ricerca, analytics, alerting.
Dove vengono copiati: snapshot, ripristini, ambienti di test, archivi, condivisioni di dati.
Chi può spostarli: amministratori, fornitori, personale di supporto, automazioni, servizi gestiti.
Il cambio di prospettiva importante è pratico. La residenza dei dati non è un documento che il vostro ufficio legale archivia. È una proprietà dell'architettura che gestite.
La residenza dei dati e il suo principio fondamentale
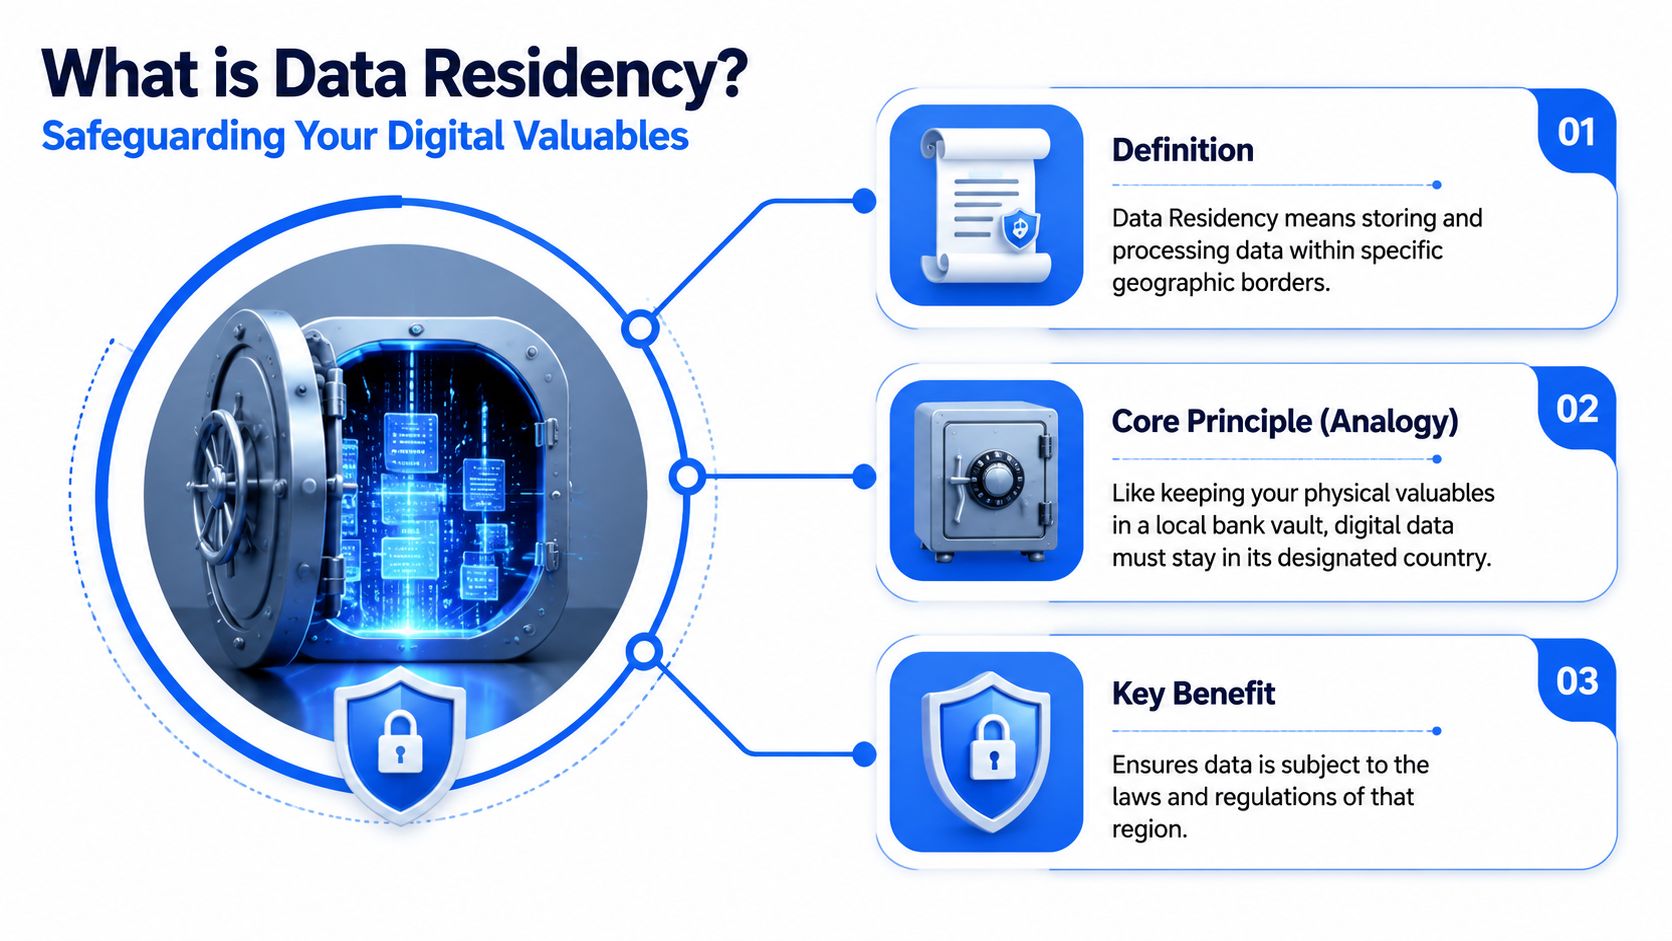
La residenza dei dati è la posizione fisica o geografica in cui i dati vengono conservati ed elaborati. È diventata più importante per la compliance perché i flussi di dati transfrontalieri sono aumentati di oltre il 300% nell'ultimo decennio, secondo la spiegazione della residenza dei dati fornita da StratoKey.
Pensate al caveau di una banca
Un'analogia semplice aiuta. Se depositate oggetti di valore in una cassetta di sicurezza, la posizione del caveau conta. Un caveau a Parigi si trova in un determinato contesto giuridico e operativo. Un caveau a Toronto in un altro. La stessa logica vale per i sistemi digitali.
Quando ci si chiede che cos'è la residenza dei dati, la risposta utile più breve è questa: è l'impegno a mantenere i dati entro un confine geografico definito per la loro conservazione ed elaborazione.
Sembra semplice, ma la parola chiave è definito. Il confine può essere un paese, una regione come l'UE o una giurisdizione specifica di settore legata a un contratto o a una normativa. Gli ingegneri hanno bisogno che questo confine sia abbastanza concreto da poter essere implementato nell'infrastruttura e nelle policy.
Perché la posizione fisica conta
La posizione fisica determina quali norme locali si applicano ai sistemi che contengono i dati. Questo rende la residenza un requisito di design, non solo un'espressione giuridica. Se la vostra architettura scrive i dati in una regione ma i job batch li arricchiscono in un'altra, il sistema potrebbe violare il requisito di residenza anche se lo storage “principale” sembra conforme.
Un modello mentale utile è considerare la residenza come un vincolo di collocazione.
Lo storage deve essere vincolato all'area geografica approvata.
L'elaborazione deve avvenire nell'area geografica approvata.
Le copie operative devono restare nell'area geografica approvata.
Le evidenze devono dimostrare che queste regole vengono applicate.
Regola pratica: se non sapete dire dove i dati vengono conservati, elaborati, sottoposti a backup, ripristinati e osservati, non avete ancora un design di residenza dei dati.
Dove i team inciampano
I team di solito hanno chiara la prima copia. Si perdono le copie derivate.
Tra i punti critici più comuni ci sono log applicativi, estrazioni dal warehouse, bucket di staging, code di replay, dump del supporto, analisi basate su notebook e file temporanei creati dagli strumenti per i dati. Ognuno è abbastanza piccolo da poter essere ignorato se preso singolarmente. Insieme formano la reale postura di residenza della piattaforma.
Ecco perché il principio fondamentale è più ampio di “scegliere una regione locale”. State definendo dove i dati possono esistere durante tutto il loro ciclo di vita operativo.
Residenza, sovranità e localizzazione a confronto
Questi termini vengono confusi di continuo, e questo porta a decisioni sbagliate. Un team sente “mantenete i dati nell'UE” e presume che la questione legale sia risolta. Spesso non lo è.
La versione breve
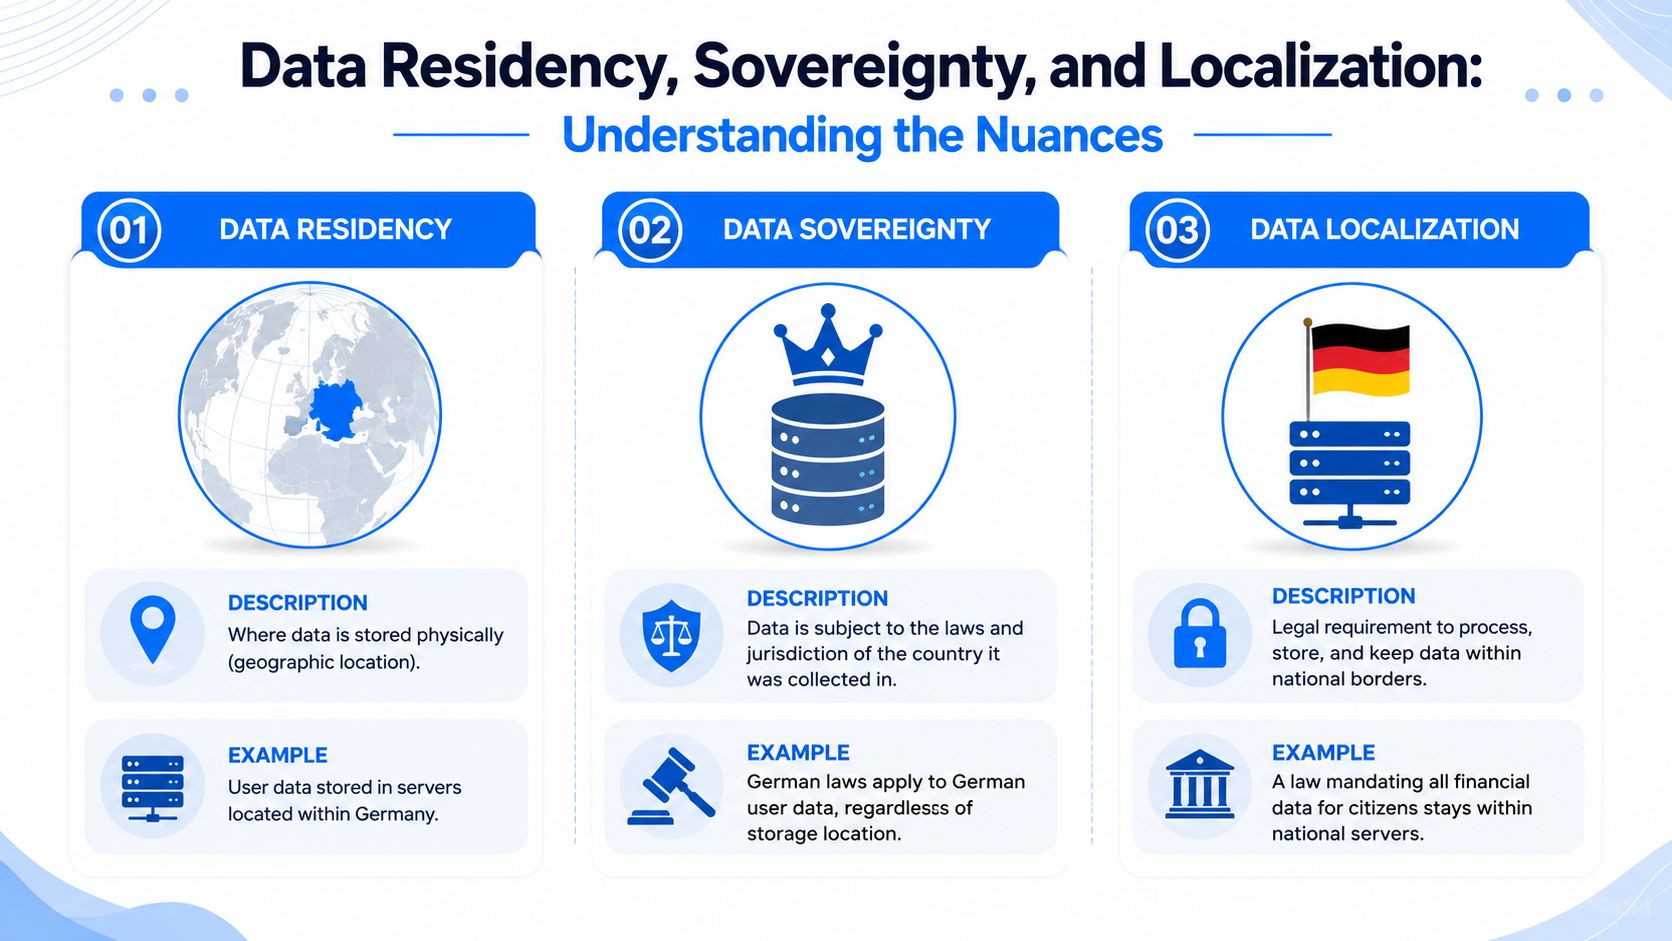
La residenza dei dati riguarda dove i dati vengono fisicamente conservati ed elaborati.
La sovranità dei dati riguarda quale autorità giuridica può rivendicare la giurisdizione su quei dati.
La localizzazione dei dati è la posizione normativa più rigida, che impone ai dati di restare entro i confini nazionali, spesso per legge o per norme di settore.
Un esempio concreto chiarisce la distinzione. Un'azienda statunitense può conservare i dati dei clienti in Germania e soddisfare un requisito tedesco di residenza per quanto riguarda la posizione. Ma possono comunque restare questioni di sovranità, perché l'accesso legale può dipendere dalla struttura di controllo del provider e dalla legge straniera applicabile.
Confronto fianco a fianco
Concetto | Focus principale | Esempio | Domanda chiave |
|---|---|---|---|
Residenza dei dati | Posizione fisica di storage ed elaborazione | Record dei clienti conservati su server in Germania | Dove risiedono e vengono elaborati i dati? |
Sovranità dei dati | Giurisdizione e autorità legale sui dati | I dati in Germania possono comunque essere soggetti a richieste di accesso legale straniere, a seconda del controllo del provider | Le leggi di chi possono raggiungere questi dati? |
Localizzazione dei dati | Conservazione ed elaborazione obbligatorie nel paese | Una norma nazionale che impone ai dati regolamentati di restare su infrastrutture nazionali | I dati devono restare sempre all'interno di questo paese? |
Il livello giuridico conta più di quanto ammettano molti diagrammi di architettura. L'analisi di F5 su sovranità, resilienza e residenza osserva che l'accesso sovrano da parte di governi stranieri può prevalere sulla residenza fisica e cita analisi di settore del 2025–2026 secondo cui il 42% delle aziende dell'UE è esposto a rischi di sovranità anche quando i dati sono conservati in regioni UE.
Perché dovrebbe interessare agli ingegneri
Se progettate solo in funzione della posizione, rischiate di non vedere il reale rischio di compliance. Contano la scelta del provider, il controllo societario, i subappaltatori, la gestione delle chiavi, l'accesso del supporto e gli obblighi di risposta alle richieste legali.
Questo significa che le revisioni dell'architettura richiedono domande sia tecniche sia giuridiche:
Tecniche: quale regione conserva i dati? Dove girano i job? Dove finiscono le repliche?
Giuridiche: quale entità controlla il servizio? Quale giurisdizione si applica all'accesso del fornitore?
Operative: potete dimostrare che i dati sono rimasti entro i confini approvati durante incidenti e ripristini?
Ecco una breve spiegazione, se volete un riepilogo non testuale prima di portare il tema agli stakeholder.
La localizzazione cambia l'onere di implementazione
Con la localizzazione la flessibilità cala rapidamente. La residenza può consentire elaborazioni regionali approvate a determinate condizioni. La localizzazione spesso richiede una risposta molto più rigorosa: hosting nazionale, elaborazione nazionale, controlli nazionali sul supporto e meccanismi di trasferimento limitati o rigidamente regolati.
Se la residenza vi dice dove collocare il sistema, la localizzazione vi dice quanta poca libertà avete di spostarne una qualsiasi parte.
Ecco perché i team non dovrebbero usare questi termini come sinonimi in contratti, documenti di architettura o valutazioni dei fornitori. Comportano impegni tecnici diversi.
I fattori normativi e di business della residenza dei dati
La spinta normativa è evidente. Quella di business è altrettanto forte.

La normativa impone precisione
Il GDPR è il punto di riferimento che molti team conoscono per primo. Come riassunto nelle indicazioni verificate, il GDPR richiede che i dati dei cittadini dell'UE siano conservati nell'UE o in paesi con standard di protezione dei dati equivalenti, e le sanzioni per la non conformità possono arrivare fino al 4% del fatturato annuo mondiale. Questo inquadramento è descritto in questa spiegazione della residenza dei dati e degli obblighi del GDPR.
Anche quando la legge consente trasferimenti tramite meccanismi controllati, l'onere operativo resta. Le aziende devono comunque sapere dove si trovano i dati, dove si spostano e come giustificano ogni spostamento. Nella sanità, nella finanza e nel settore pubblico questo onere è spesso ancora più stringente, perché i contratti con i clienti e le norme di settore vanno oltre la normativa privacy di base.
I clienti chiedono prima degli auditor
Anche il lato commerciale è cambiato. Oggi gli acquirenti enterprise pongono domande dettagliate durante il procurement. Vogliono sapere dove sono conservati i dati, da dove viene fornito il supporto, se i backup restano nella regione e se i sub-responsabili possono spostare metadati o contenuti al di fuori del confine approvato.
Queste domande non riguardano solo i settori fortemente regolamentati. Qualsiasi azienda che venda a clienti di grandi dimensioni le incontrerà.
Una risposta chiara crea fiducia. Una risposta vaga rallenta le trattative, allunga le revisioni legali e solleva dubbi sul fatto che la piattaforma sia abbastanza matura per carichi di lavoro sensibili.
Il business case pratico
La residenza dei dati incide su molto più della postura di compliance.
Accesso al mercato: alcuni clienti non firmano se i dati non restano in uno specifico paese o regione.
Selezione dei fornitori: controllo della regione, gestione delle chiavi e modello di supporto diventano criteri di acquisto.
Risposta agli incidenti: è più facile rispondere ad autorità di controllo e clienti quando i confini dei sistemi sono espliciti.
Reputazione: i team in grado di dimostrare una gestione disciplinata dei dati appaiono più sicuri agli acquirenti e ai consigli di amministrazione.
Le organizzazioni più solide non trattano la residenza dei dati come un ripensamento legale. La considerano parte della governance della piattaforma, insieme a sicurezza, controllo degli accessi e pianificazione del ripristino.
Progettare per la conformità alla residenza dei dati: una guida pratica
La maggior parte delle violazioni della residenza non nasce da un unico errore clamoroso. Nasce da automazioni ordinarie che fanno esattamente ciò per cui sono state configurate.
Un problema particolarmente importante è l'esportazione silenziosa. La residenza è un requisito che riguarda l'intero ciclo di vita, inclusi backup, disaster recovery e pipeline di elaborazione, non solo lo storage primario. Una guida HIPAA del 2026 riporta che il 68% delle organizzazioni sanitarie ha subito trasferimenti transfrontalieri di dati non intenzionali a causa di repliche dei backup che ignoravano le regole di residenza, come descritto nella guida di Konfirmity alla residenza dei dati secondo HIPAA.
Partite dalla mappatura dei dati, non dal marketing dei provider
“Regione UE disponibile” non è un'architettura di residenza dei dati.
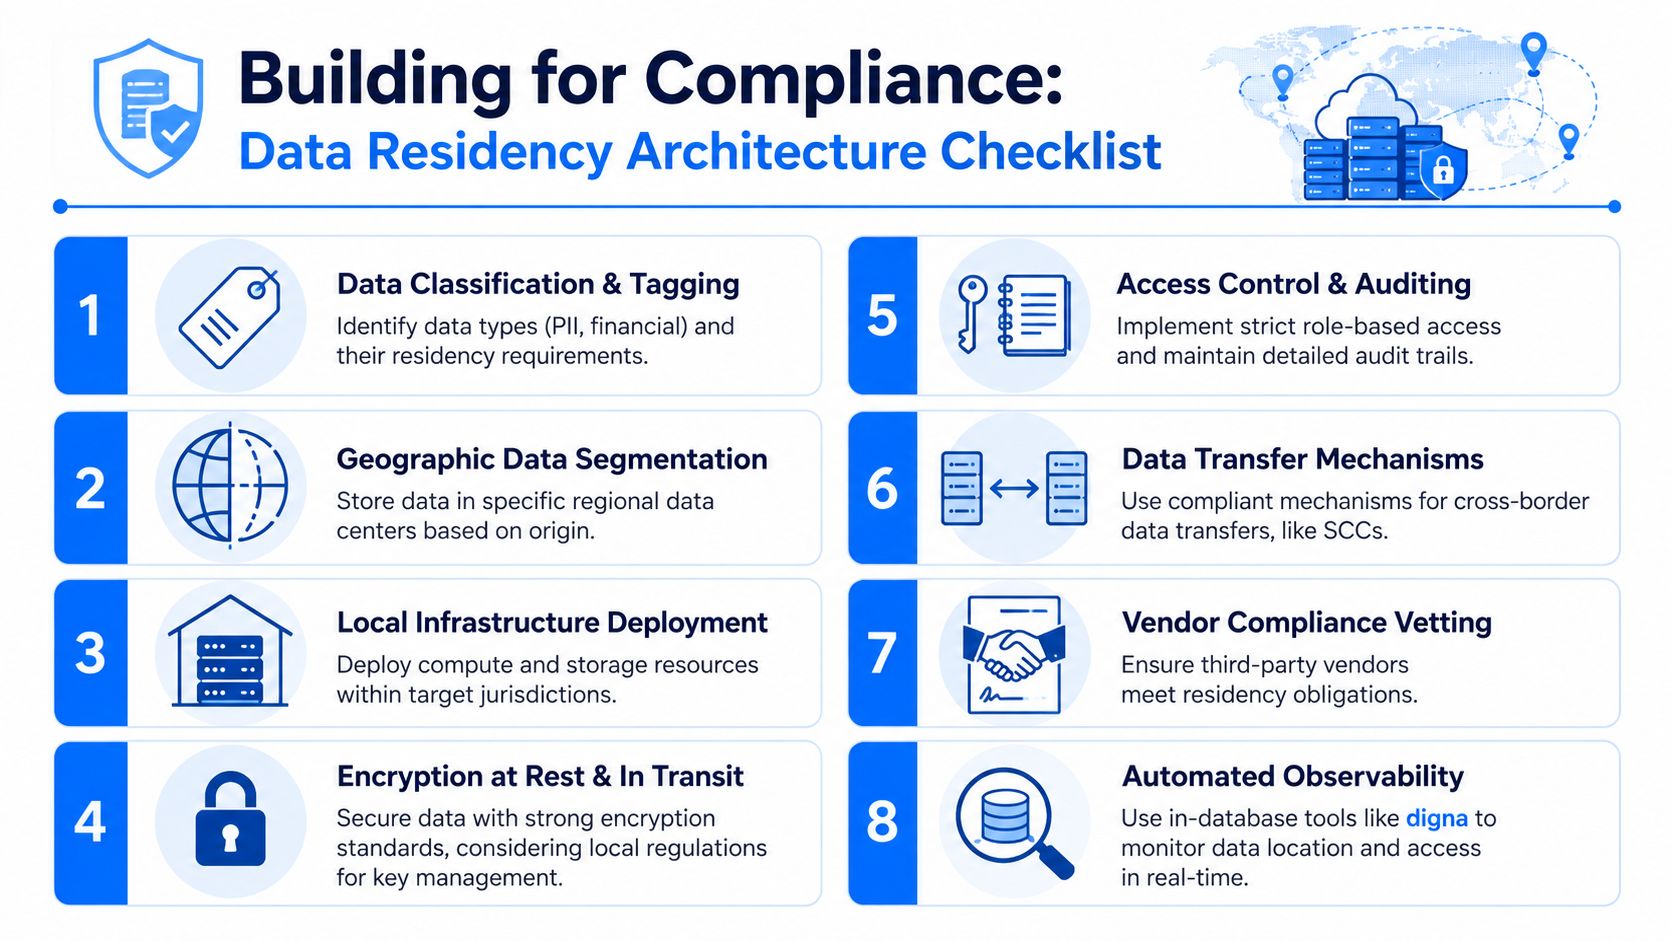
Iniziate costruendo una mappa dei reali spostamenti dei dati:
Identificate i dataset regolamentati. Etichettate dati personali, dati finanziari, dati sanitari, dati del settore pubblico e dataset soggetti a restrizioni contrattuali.
Tracciate tutti i percorsi di elaborazione. Includete job ETL, stream processor, trasformazioni nel warehouse, feature dei modelli, export e reverse ETL.
Elencate ogni copia. Database primari, repliche, snapshot, archivi, cache, workspace di data science e aggiornamenti degli ambienti di test.
Documentate i fornitori. Analytics, supporto, monitoraggio, strumenti antifrode, CDP e servizi di trasferimento file spesso spostano più dati di quanto i team immaginino.
È un lavoro noioso, ma non ha sostituti. I controlli sulla residenza funzionano solo quando sono legati ai flussi reali.
Progettate per ogni copia, non solo per quella primaria
Gli ingegneri spesso mettono in sicurezza il database e dimenticano il sistema che lo circonda.
Un design conforme alla residenza dei dati include di solito i seguenti schemi:
Isolamento regionale: separate storage, calcolo ed esecuzione delle pipeline per giurisdizione, invece di centralizzare tutto sperando che le policy si adeguino.
Instradamento in base alla posizione: indirizzate i dati degli utenti verso il percorso regionale corretto già in fase di ingestione.
Backup vincolati alla regione: mantenete snapshot, repliche e destinazioni di disaster recovery entro il confine approvato.
Analytics controllate: evitate strumenti che estraggono o replicano i dati in ambienti SaaS non gestiti.
Uso limitato dei dati di test: non aggiornate gli ambienti inferiori con dati di produzione, a meno che tali ambienti non seguano le stesse regole di residenza.
Controllo locale delle chiavi: allineate la strategia di cifratura ai requisiti giurisdizionali e all'esposizione verso i fornitori.
Ciò che di solito non funziona è un compromesso ibrido in cui la produzione è regionale ma tutti i servizi “operativi” restano globali. Log, monitoraggio, workspace di addestramento dei modelli e strumenti di supporto possono vanificare il design.
I backup sono il punto in cui molte architetture di residenza si tradiscono. I team documentano la regione primaria, poi scoprono che la policy di ripristino era globale per impostazione predefinita.
Usate una checklist operativa che i team possano seguire
I controlli sulla residenza devono sopravvivere ai normali cambiamenti della piattaforma. Una checklist operativa aiuta più di un PDF con le policy.
Verificate regolarmente i deployment: nuovi servizi, funzionalità gestite e impostazioni predefinite del cloud possono introdurre repliche tra regioni.
Vincolate esplicitamente i job di elaborazione: non date per scontato che il calcolo serverless o gestito resti locale senza vincoli chiari.
Esaminate i percorsi dei dati dei fornitori: chiedete dove avvengono telemetria, metadati, artefatti del supporto ed elaborazioni temporanee.
Testate i piani di failover: un'esercitazione di disaster recovery dovrebbe dimostrare che la regione di ripristino è conforme, non solo disponibile.
Tenete d'occhio gli export temporanei: download CSV, estrazioni da notebook e trasferimenti di file ad hoc sono punti deboli comuni.
Registrate le evidenze in modo continuo: impostazioni delle regioni, audit trail e diagrammi dei flussi dovrebbero restare abbastanza aggiornati da poter essere verificati.
Un'architettura pratica ha bisogno anche di observability. Se i team non vedono dove si sono spostati i dati, non intercetteranno presto le violazioni. È qui che lineage, telemetria dello storage, log di accesso e monitoraggio a livello di pipeline diventano utili come meccanismi di controllo, e non solo come strumenti di debug.
Garantire la residenza dei dati con la data observability in-database
Gli strumenti di observability possono aiutare a rispettare la residenza dei dati, ma possono anche comprometterla.
Perché gli strumenti di observability possono creare il problema
Uno schema comune nel monitoraggio SaaS è semplice: raccogliere metadati, risultati delle query, campioni, log o dettagli dello schema e inviarli al cloud del fornitore per l'analisi. Può essere comodo dal punto di vista operativo, ma solleva subito una questione di residenza. Anche se le tabelle sorgente restano nella regione, il layer di monitoraggio può esportare abbastanza informazioni da creare un'esposizione in termini di compliance.
Questo è uno dei motivi per cui i team devono capire la differenza tra data observability e data quality. La categoria dello strumento conta meno del modello di esecuzione. Se la piattaforma dipende dallo spostamento di dati o metadati al di fuori del vostro ambiente controllato, la verifica sulla residenza diventa più difficile.
Cosa cambia con l'esecuzione in-database
Un approccio in-database cambia il profilo di rischio. L'analisi gira all'interno dell'ambiente controllato dal cliente, che si tratti di cloud privato o di on-prem, e l'interfaccia della piattaforma mostra i risultati senza che il fornitore debba accedere ai dataset di produzione.
Questo modello si adatta agli ambienti sensibili alla residenza dei dati perché riduce per design gli spostamenti di dati.
In termini pratici, i team dovrebbero cercare strumenti che supportino:
Funzionalità | Perché conta per la residenza dei dati |
|---|---|
Esecuzione all'interno dell'ambiente | Mantiene controlli e calcolo delle metriche entro il confine approvato |
Opzioni di deployment privato | Evita di inviare dati operativi in una regione SaaS gestita dal fornitore |
Monitoraggio di schema e pipeline | Rileva modifiche che possono innescare trasferimenti non intenzionali o usi impropri a valle |
Output adatti agli audit | Fornisce ai team evidenze per verifiche, questionari dei clienti e analisi degli incidenti |
Un esempio è digna, che offre rilevamento delle anomalie, validazione, monitoraggio della tempestività, analytics e tracciamento dello schema eseguendo le analisi all'interno dei database del cliente, in ambienti di cloud privato o on-prem. Questa architettura è utile quando l'obiettivo è ottenere visibilità senza esportare dati operativi verso un control plane separato.
Un buon strumento per la residenza dei dati non si limita a indicare dove risiedono i dati primari. Aiuta a dimostrare che il monitoraggio stesso non sta creando un canale laterale al di fuori della giurisdizione.
Il punto più profondo è architetturale. Se la residenza riguarda il controllo degli spostamenti dei dati, allora l'observability dovrebbe seguire le stesse regole di storage ed elaborazione. Altrimenti la lacuna di compliance si sposta semplicemente dalla pipeline allo stack di monitoraggio.
La residenza dei dati è una disciplina continua, non un interruttore
La residenza dei dati non è un'impostazione da attivare una volta e dimenticare. È una disciplina operativa che deve reggere lungo ingestione, storage, elaborazione, backup, ripristino, analytics e strumenti.
I team che la gestiscono bene non si chiedono solo dove si trovi il database. Si chiedono dove può comparire ogni copia significativa, chi può accedervi, quali automazioni possono spostarla e come dimostreranno il controllo durante un audit o una verifica da parte di un cliente.
Questo cambia il modo in cui progettate le piattaforme. La residenza diventa parte della revisione dell'architettura, del procurement dei fornitori, del deployment delle pipeline e dei test di disaster recovery. Negli ambienti maturi si colloca accanto a sicurezza e affidabilità come normale tema di engineering.
Se la trattate ancora come un'appendice legale, siete già in ritardo. Se la trattate come una proprietà del sistema lungo l'intero ciclo di vita, diventa gestibile.
Se il vostro team ha bisogno di data quality e observability senza esportare dati di produzione al di fuori del vostro ambiente controllato, vale la pena valutare digna. Il suo modello di esecuzione in-database è adatto alle organizzazioni che necessitano di monitoraggio, rilevamento delle anomalie, validazione e visibilità sulle pipeline mantenendo i dati residenti in infrastrutture di cloud privato o on-prem.
Per capire come i controlli di data quality possano girare all'interno dei vostri database invece che nel cloud di un fornitore, leggete la pagina sulla gestione della data quality in-database con digna.
Domande frequenti
Che cos'è la residenza dei dati?
La residenza dei dati è la posizione fisica o geografica in cui i dati vengono conservati ed elaborati, insieme all'impegno a mantenerli entro un confine definito, come un paese o l'UE. L'articolo osserva che i flussi di dati transfrontalieri sono cresciuti di oltre il 300% nell'ultimo decennio, rendendo la posizione dei dati una questione di compliance.
Qual è la differenza tra residenza, sovranità e localizzazione dei dati?
La residenza riguarda dove i dati vengono fisicamente conservati ed elaborati. La sovranità riguarda quale autorità giuridica può rivendicare la giurisdizione su di essi. La localizzazione è la posizione più rigida, che impone ai dati di restare entro i confini nazionali. Un'azienda statunitense che conserva i dati dei clienti in Germania può soddisfare la residenza ma trovarsi comunque di fronte a questioni di sovranità.
Scegliere una regione cloud nell'UE risolve la residenza dei dati?
Non da solo. Backup, repliche, log, cache della BI, export del supporto e strumenti dei fornitori possono comunque spostare i dati altrove. L'articolo cita una guida HIPAA del 2026 secondo cui il 68% delle organizzazioni sanitarie ha subito trasferimenti transfrontalieri non intenzionali perché le repliche dei backup ignoravano le regole di residenza.
Come si progetta un'architettura dei dati conforme alla residenza?
Partite mappando i reali spostamenti dei dati: etichettate i dataset regolamentati, tracciate ogni percorso di elaborazione, elencate ogni copia e documentate i fornitori. Applicate poi schemi come isolamento regionale, instradamento in base alla posizione in fase di ingestione, backup vincolati alla regione, analytics controllate, uso limitato dei dati di test e controllo locale delle chiavi di cifratura.
Gli strumenti di data observability possono compromettere la residenza dei dati?
Sì, se inviano metadati, risultati delle query, campioni o dettagli dello schema al cloud di un fornitore per l'analisi. L'esecuzione in-database evita questo problema eseguendo i controlli all'interno del cloud privato o dell'ambiente on-prem controllato dal cliente, così il monitoraggio non crea un canale laterale al di fuori della giurisdizione approvata.


