Controllo qualità automatico spiegato per dati affidabili
|
7
min di lettura

La vostra dashboard del mattino è verde, eppure l'andamento dei ricavi sembra sbagliato. Un feed pianificato è arrivato in ritardo, una colonna ha cambiato tipo oppure un sistema sorgente ha alterato la distribuzione di un campo. La pipeline è stata completata con successo, quindi il consueto controllo di stato è stato superato. Quando qualcuno si accorge dell'impatto sul business, gli analisti hanno già condiviso numeri inaffidabili e gli ingegneri stanno risalendo il problema a ritroso.
La revisione manuale non riesce a tenere il passo con il volume e la varietà delle pipeline di dati moderne. Il controllo qualità automatico cambia il modello operativo: osserva i dati in modo continuo, individua le deviazioni significative, applica le regole essenziali e fornisce alle persone giuste evidenze su cui agire. Le conseguenze del lasciare questi guasti non rilevati sono descritte chiaramente in questa panoramica sulle conseguenze della scarsa qualità dei dati.
Indice
Introduzione: perché la qualità dei dati si rompe senza automazione
Dall'ispezione alle operazioni continue
La decisione di design centrale
Che cosa significa davvero controllo qualità automatico
Il fondamento statistico
Che cosa osserva il sistema
Come funzionano i controlli automatici, dalle regole al rilevamento con l'AI
Validazione basata su regole
Soglie statistiche
Rilevamento con AI e machine learning
Scegliere il tipo di controllo giusto per ogni segnale
Mettere l'automazione in funzionamento continuo
Mantenete l'elaborazione vicina ai dati
Collegate tempo, struttura e significato
Benefici misurabili e tangibili nelle operazioni quotidiane
Che cosa cambia per il team
Dove il controllo qualità automatico genera valore nella pratica
Finanza
Sanità
Telecomunicazioni
Settore pubblico
Decidere quando automatizzare e come iniziare con digna
Checklist per l'adozione
Introduzione: perché la qualità dei dati si rompe senza automazione
Un team dati potrebbe ispezionare alcune tabelle critiche dopo un rilascio, confermare che una trasformazione sia stata eseguita e passare al compito successivo. Questo processo può intercettare i guasti evidenti, come una tabella vuota o un job interrotto. Non intercetterà in modo affidabile uno spostamento graduale nell'attività dei clienti, una sorgente che arriva in ritardo o un valore apparentemente valido che non ha più senso per il business.
Il problema non è che ai team manchino i test. Gli ambienti moderni combinano data warehouse, data lake, sistemi di streaming, feed di fornitori, strumenti di trasformazione e dashboard. Ogni livello può sembrare sano mentre il risultato diventa sempre meno affidabile. Un'esecuzione riuscita della pipeline dimostra che il codice è stato eseguito. Non dimostra che i dati rappresentino ancora il business.
Dall'ispezione alle operazioni continue
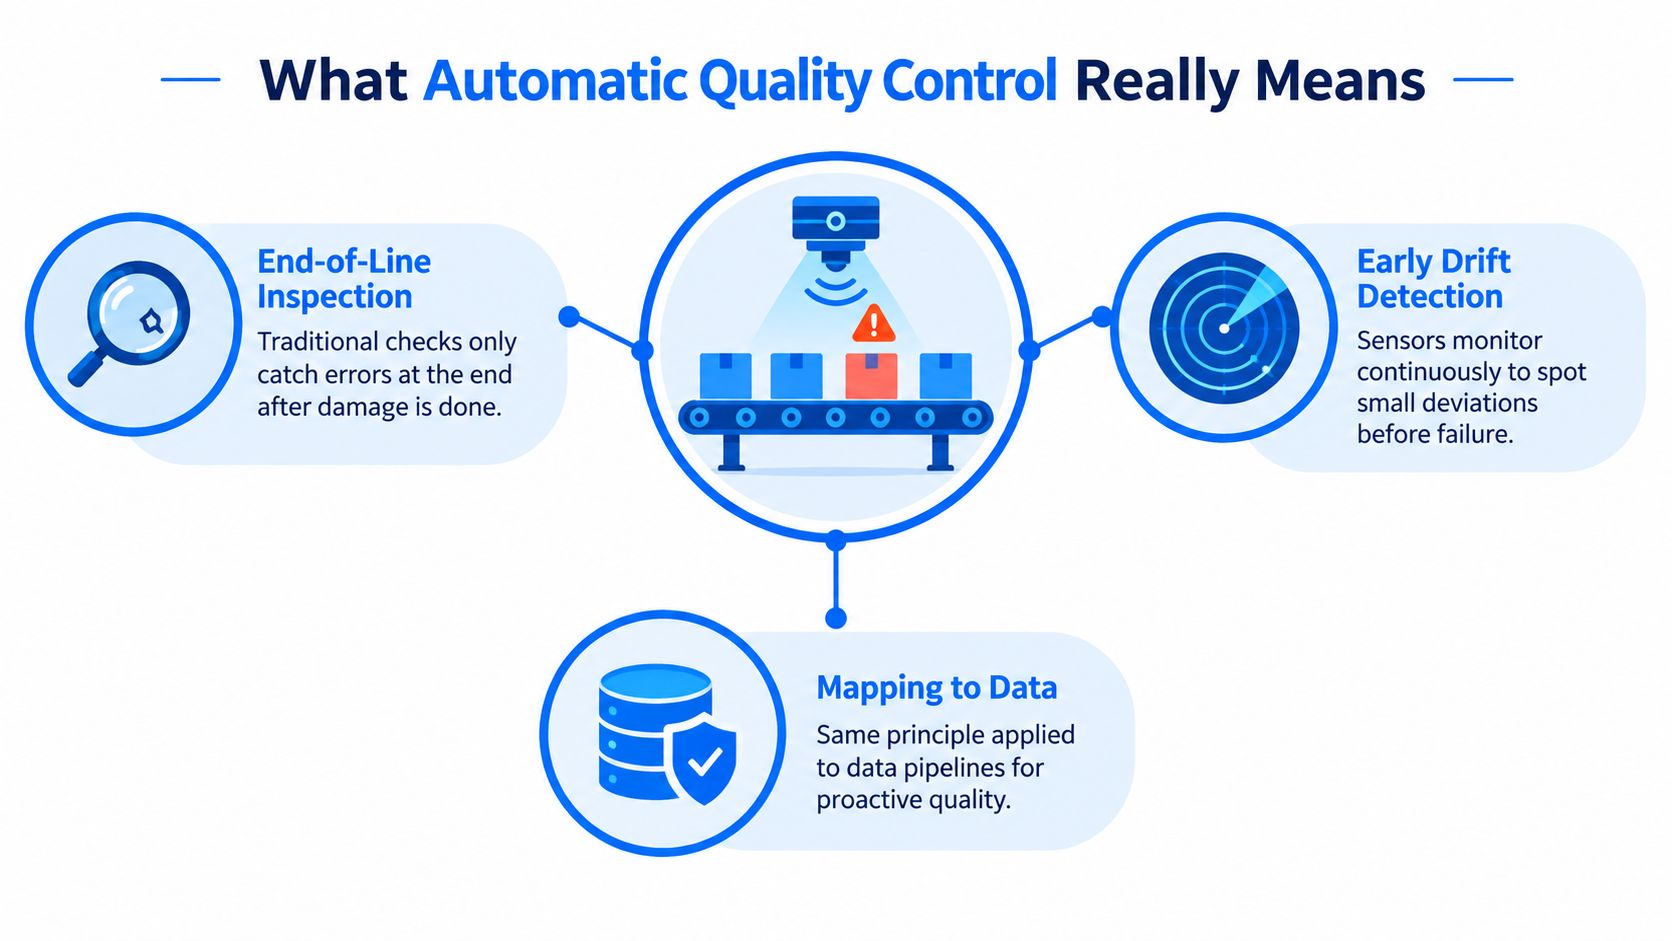
La manifattura offre un'analogia utile. Un'ispezione finale può scartare i prodotti difettosi, ma sensori posizionati lungo tutta la linea di produzione possono individuare la deriva del processo prima che i difetti si accumulino. I team dati hanno bisogno dello stesso ciclo di feedback. Invece di trattare la qualità come un cancello alla fine della pipeline, possono monitorare record, comportamento di consegna, struttura, metriche di business e attività della piattaforma come parte delle operazioni quotidiane.
Questo cambiamento chiarisce anche le responsabilità. Un data engineer potrebbe dover indagare su una modifica allo schema, un analista potrebbe dover spiegare un movimento insolito di un KPI e un responsabile della governance potrebbe aver bisogno di prove che un controllo sia stato eseguito. Il controllo qualità automatico dovrebbe collegare queste attività, non creare un ulteriore report isolato.
La decisione di design centrale
Automazione non significa sostituire ogni regola con un modello. Alcuni segnali dovrebbero essere appresi dal comportamento storico, come il volume normale o l'orario di consegna previsto. Altri segnali devono restare deterministici, come un campo obbligatorio, uno stato ammesso o un vincolo normativo.
La domanda pratica è quindi precisa: quali condizioni il sistema dovrebbe apprendere statisticamente e quali deve invece applicare in modo esatto? La risposta determina se l'automazione riduce il rumore o genera ancora più alert.
Che cosa significa davvero controllo qualità automatico
Immaginate un nastro trasportatore in una fabbrica che porta pezzi identici. Un sensore registra temperatura, peso e posizione mentre una telecamera controlla la superficie. Il sistema non aspetta che l'ultima scatola sia imballata per scoprire un problema. Confronta le letture attuali con il comportamento atteso, segnala movimenti insoliti e può fermare o deviare il processo prima che passino altri pezzi difettosi.
La qualità dei dati funziona allo stesso modo. Un sistema di monitoraggio osserva tabelle e pipeline, stabilisce quale sia il comportamento normale e verifica i dati in arrivo rispetto a quella baseline. Può anche applicare validazioni esplicite quando l'organizzazione ha una regola che deve valere sempre.
Il controllo qualità automatico è l'uso continuo di software per osservare il comportamento dei dati, applicare requisiti di qualità definiti, rilevare deviazioni significative e inoltrare le evidenze alle persone o ai sistemi responsabili dell'intervento.
Il fondamento statistico
Il controllo statistico di processo, o SPC, offre un fondamento utile. Usa carte di controllo e dati di misura per distinguere la variazione normale dalla variazione da cause speciali, cioè un cambiamento che suggerisce l'ingresso di qualcosa di insolito nel processo. In un processo con distribuzione normale, un limite di controllo a 3 sigma, spesso citato, porta la probabilità che un pezzo buono cada fuori dalla banda a circa 1 su 1.000, mentre un limite a 6 sigma riduce tale probabilità a circa 1 su 1.000.000 (ricerca SPC sul rilevamento automatico).
La lezione non è che ogni tabella di dati abbia bisogno di una regola six sigma. La lezione è che i sistemi di qualità dovrebbero rilevare presto la deriva, invece di affidarsi solo all'ispezione a fine linea. Una baseline fornisce contesto al sistema. Senza contesto, una soglia può segnalare una normale stagionalità o non accorgersi di un cambiamento significativo.
Che cosa osserva il sistema
Il controllo qualità automatico copre diversi livelli di comportamento:
Qualità dei record: valori obbligatori, formati validi, intervalli, valori di riferimento, duplicati e relazioni di business.
Tempestività delle pipeline: se i dati arrivano quando gli utenti e i job a valle se li aspettano.
Stabilità dello schema: se colonne vengono aggiunte, rimosse, rinominate o cambiano tipo.
Comportamento del business: se ricavi, transazioni, attività dei clienti o un altro KPI escono dagli schemi attesi.
Comportamento della piattaforma: se carichi di lavoro, disponibilità, consumi o metriche legate alle prestazioni cambiano in modo inatteso.
Un singolo test non può coprire tutto questo. Il sistema operativo combina misure, regole, storico, responsabilità, alert e contesto per la correzione. È questa combinazione a trasformare il testing in controllo continuo.
Come funzionano i controlli automatici, dalle regole al rilevamento con l'AI
Tre famiglie di controlli coprono la maggior parte dei design di controllo qualità automatico. Non sono in concorrenza in ogni situazione. Ognuna risponde a una domanda diversa, e le implementazioni più solide assegnano ciascun segnale al metodo adatto al suo rischio.
Validazione basata su regole
I controlli deterministici sono espliciti e ripetibili. Una regola potrebbe richiedere un identificatore cliente, rifiutare una quantità negativa, limitare uno stato a un elenco di riferimento approvato o verificare che un timestamp segua un formato richiesto. Se la condizione non è soddisfatta, il risultato è chiaro: il record o il dataset viola un requisito dichiarato.
Le regole sono particolarmente preziose per logica di business, controlli di audit e aspettative contrattuali. Costituiscono anche evidenze utili, perché un responsabile può spiegare esattamente cosa è stato superato, cosa non lo è stato e perché. Il loro limite è la manutenzione. Una regola non può dedurre una baseline che cambia a meno che qualcuno non la aggiorni, e una regola troppo generica può creare lavoro operativo inutile.
Soglie statistiche
I controlli statistici verificano se una misura si è allontanata in modo insolito dal suo comportamento consolidato. La misura potrebbe essere il volume di righe, la densità dei null, la distribuzione dei valori o l'orario di consegna. Le bande di controllo possono adattarsi a schemi che una soglia fissa tratterebbe in modo errato.
Il sistema richiede comunque una configurazione ponderata. Una metrica di business può variare in base al giorno della settimana, al ciclo di rilascio o al periodo di reporting. Una baseline che ignora questi schemi può generare troppi alert. Una baseline troppo permissiva può non accorgersi di un problema reale.
Rilevamento con AI e machine learning
Il rilevamento basato sull'AI è utile quando i dati hanno relazioni complesse o quando scrivere regole a mano sarebbe impraticabile. Un modello può apprendere gli schemi di un dataset e segnalare deviazioni in volume, distribuzione o valori. Questo non rende il risultato automaticamente corretto. Il modello ha bisogno di uno storico sufficiente, di un monitoraggio adeguato e di un processo di revisione dei falsi positivi.
Un esercizio di benchmarking sui profili oceanici dimostra perché la scelta dei test conta. I ricercatori hanno valutato 60 controlli automatici distinti e hanno rilevato che era necessario scegliere un sottoinsieme ottimale, perché le diverse regole di controllo qualità bilanciano in modo diverso sensibilità e segnalazioni eccessive (benchmarking dei controlli qualità automatici). Più test non creano automaticamente una qualità migliore. Possono generare alert fatigue se il team non riesce a distinguere un segnale significativo dalla variazione ordinaria.
Scegliere il tipo di controllo giusto per ogni segnale
Famiglia di controlli | Ideale per | Punti di forza | Attenzione a |
|---|---|---|---|
Validazione basata su regole | Campi obbligatori, formati, intervalli, elenchi di riferimento e vincoli di business | Risultati chiari di superamento o fallimento, logica spiegabile, solide evidenze di audit | Richiede manutenzione quando cambiano i requisiti di business |
Soglie statistiche | Volumi, distribuzioni, comportamento dei null e schemi di consegna | Si adattano al comportamento osservato e mettono in evidenza la deriva | Possono generare troppi alert quando stagionalità o qualità della baseline non sono ben comprese |
Rilevamento con AI | Schemi sottili, multivariati o mutevoli tra dataset | Individua comportamenti che sarebbe difficile esprimere come singole regole | Richiede governance, revisione e controlli contro decisioni opache |
La strategia giusta non è scrivere meno regole. È decidere quali segnali meritano un'applicazione esatta, quali richiedono soglie adattive e quali traggono vantaggio dal rilevamento appreso. Per una spiegazione pratica del rilevamento delle anomalie nelle pipeline, leggete come l'AI rileva le anomalie nei dati.
Mettere l'automazione in funzionamento continuo
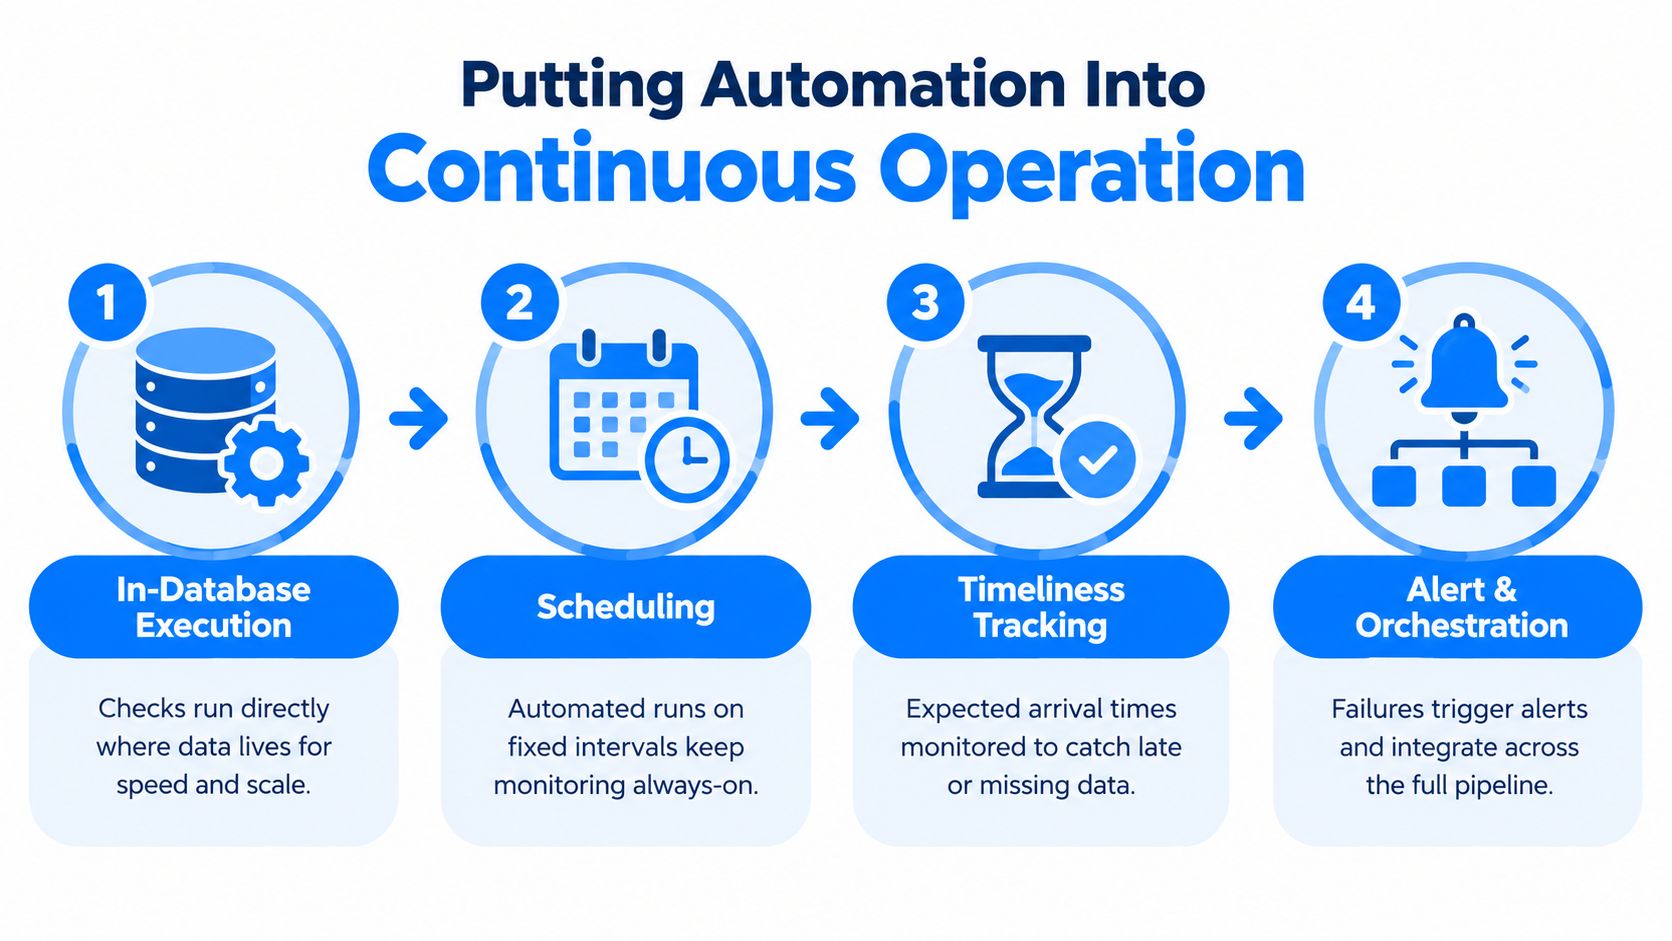
Una raccolta di controlli diventa utile solo quando funziona come un ciclo operativo. Il ciclo dovrebbe osservare i dati dove già risiedono, essere eseguito secondo una pianificazione affidabile, confrontare il comportamento effettivo con quello atteso e inoltrare i fallimenti a un responsabile con contesto sufficiente per rispondere.
Mantenete l'elaborazione vicina ai dati
L'esecuzione in-database permette ai team di calcolare metriche ed eseguire analisi all'interno del database del cliente. I dati restano dove sono, il che può ridurre i movimenti superflui e supportare i requisiti di privacy e governance. Questo approccio è particolarmente rilevante quando i dati di produzione non possono essere copiati in un servizio di monitoraggio esterno.
Il design richiede comunque controlli di accesso, logging e una netta separazione tra i metadati di monitoraggio e i record sensibili. L'esecuzione locale non sostituisce la governance. Le offre però una base più solida, perché l'organizzazione può definire dove avviene l'elaborazione e quali evidenze escono dall'ambiente.
Collegate tempo, struttura e significato
Un ciclo di monitoraggio affidabile combina diverse forme di evidenza:
Pianificate l'osservazione. Intervalli fissi o eventi della pipeline garantiscono che i controlli vengano eseguiti senza che qualcuno debba ricordarsi di avviarli.
Monitorate la consegna attesa. Il monitoraggio della tempestività può apprendere il comportamento di arrivo previsto e segnalare dati in ritardo, mancanti o in anticipo.
Rilevate i cambiamenti strutturali. Lo schema tracking individua colonne aggiunte o rimosse e modifiche ai tipi di dati prima che i consumer a valle falliscano.
Osservate le metriche di business. Il monitoraggio dei KPI collega il comportamento tecnico dei dati a risultati che i responsabili di business riconoscono.
Inoltrate l'incidente. Gli alert dovrebbero includere l'asset interessato, la condizione non soddisfatta, il cambiamento osservato e la persona o il team responsabile.
I dati delle indagini indicano un divario di strategia. SYNQ ha rilevato che la “conoscenza insufficiente di come testare bene” era la principale sfida per la qualità dei dati, mentre la grande maggioranza dei team si affidava soprattutto ai test integrati del proprio strumento di trasformazione e solo circa il 10% usava spesso l'AI nei workflow di data quality (indagine benchmark SYNQ sulla qualità dei dati). Ciò suggerisce che i team hanno bisogno di indicazioni operative, non di un'ennesima libreria di test.
Una dashboard condivisa, un data catalog, uno scheduler e un workflow di collaborazione possono trasformare un alert in un incidente gestito. Gli ingegneri possono esaminare le evidenze tecniche, gli analisti possono vedere l'impatto sul business e gli stakeholder possono seguirne lo stato senza spostare i dati di produzione al di fuori dell'ambiente del cliente. Ulteriori indicazioni pratiche su validazione e controlli continui sono disponibili in regole di validazione dei dati e data quality continua.
Benefici misurabili e tangibili nelle operazioni quotidiane
Il beneficio più utile del controllo qualità automatico non è il numero di controlli configurati. È la riduzione dell'incertezza nel lavoro di tutti i giorni. I team possono individuare la deriva prima che un refresh della dashboard la renda evidente, capire se un feed in ritardo ha causato un buco nel reporting e distinguere una pipeline guasta da un cambiamento reale del business.
I sistemi di visione industriale mostrano il valore dell'ispezione continua rispetto al solo campionamento finale. Le rassegne sul controllo qualità basato sulla visione integrato con PLC descrivono sistemi che acquisiscono l'immagine di ogni prodotto, classificano i difetti in tempo reale e supportano un'ispezione al 100% alla velocità della linea. Un'integrazione documentata ha raggiunto circa il 96,2% di accuratezza, con 95,4% di precision, 96,8% di recall e un F1-score del 96,1% (rassegna sul controllo qualità industriale basato sulla visione).
Che cosa cambia per il team
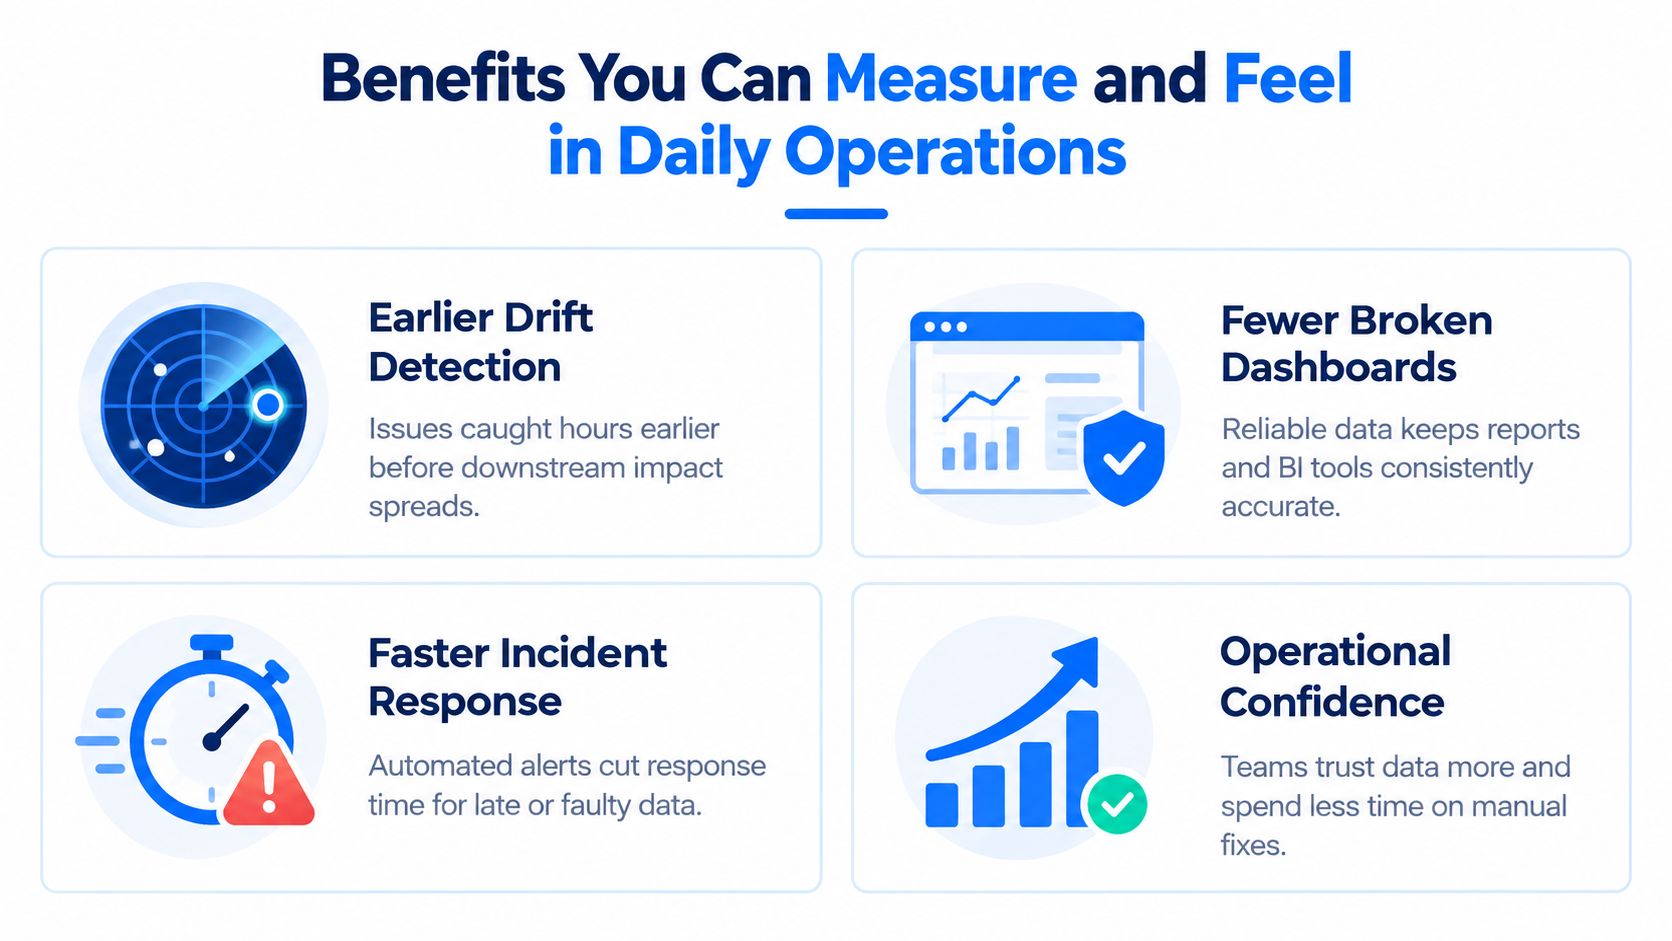
Un rilevamento più precoce della deriva dà agli ingegneri il tempo di indagare su una sorgente o una trasformazione prima che i consumer a valle moltiplichino l'impatto. Una piccola deviazione diventa un evento visibile invece di un presupposto nascosto.
Meno dashboard rotte è la conseguenza del monitoraggio sia dei dati sia della struttura. Una dashboard può restare tecnicamente disponibile pur mostrando informazioni obsolete o distorte. I segnali di qualità aiutano i team a cogliere questa differenza.
Una risposta più rapida ai caricamenti mancanti deriva dal monitoraggio della consegna attesa. Invece di aspettare che un analista noti un report vuoto, il sistema può rilevare che un dataset non è arrivato entro il suo normale schema operativo.
Evidenze di compliance più solide derivano da controlli deterministici, storico delle esecuzioni, responsabilità e risultati documentati. Auditor e responsabili di business hanno bisogno di più di uno stato verde. Devono sapere cosa è stato eseguito e cosa è successo.
Per chi esplora il ruolo dei dati predittivi per il QA, il principio generale è simile: il comportamento storico può aiutare i team ad anticipare i rischi per la qualità, ma i segnali predittivi richiedono comunque percorsi d'azione chiari. L'automazione supporta il controllo dei costi, l'affidabilità dei modelli e la fiducia negli analytics solo quando gli alert sono comprensibili e qualcuno è responsabile della risposta.
Il risultato pratico è la fiducia. I team passano meno tempo a verificare se i dati esistono e più tempo a decidere cosa significano. Questo beneficio svanisce se ogni alert è rumoroso, duplicato o scollegato da un team responsabile, per cui tuning e responsabilità restano parte integrante del sistema di qualità. Ulteriore contesto su questi risultati operativi si trova in i benefici della qualità dei dati.
Dove il controllo qualità automatico genera valore nella pratica
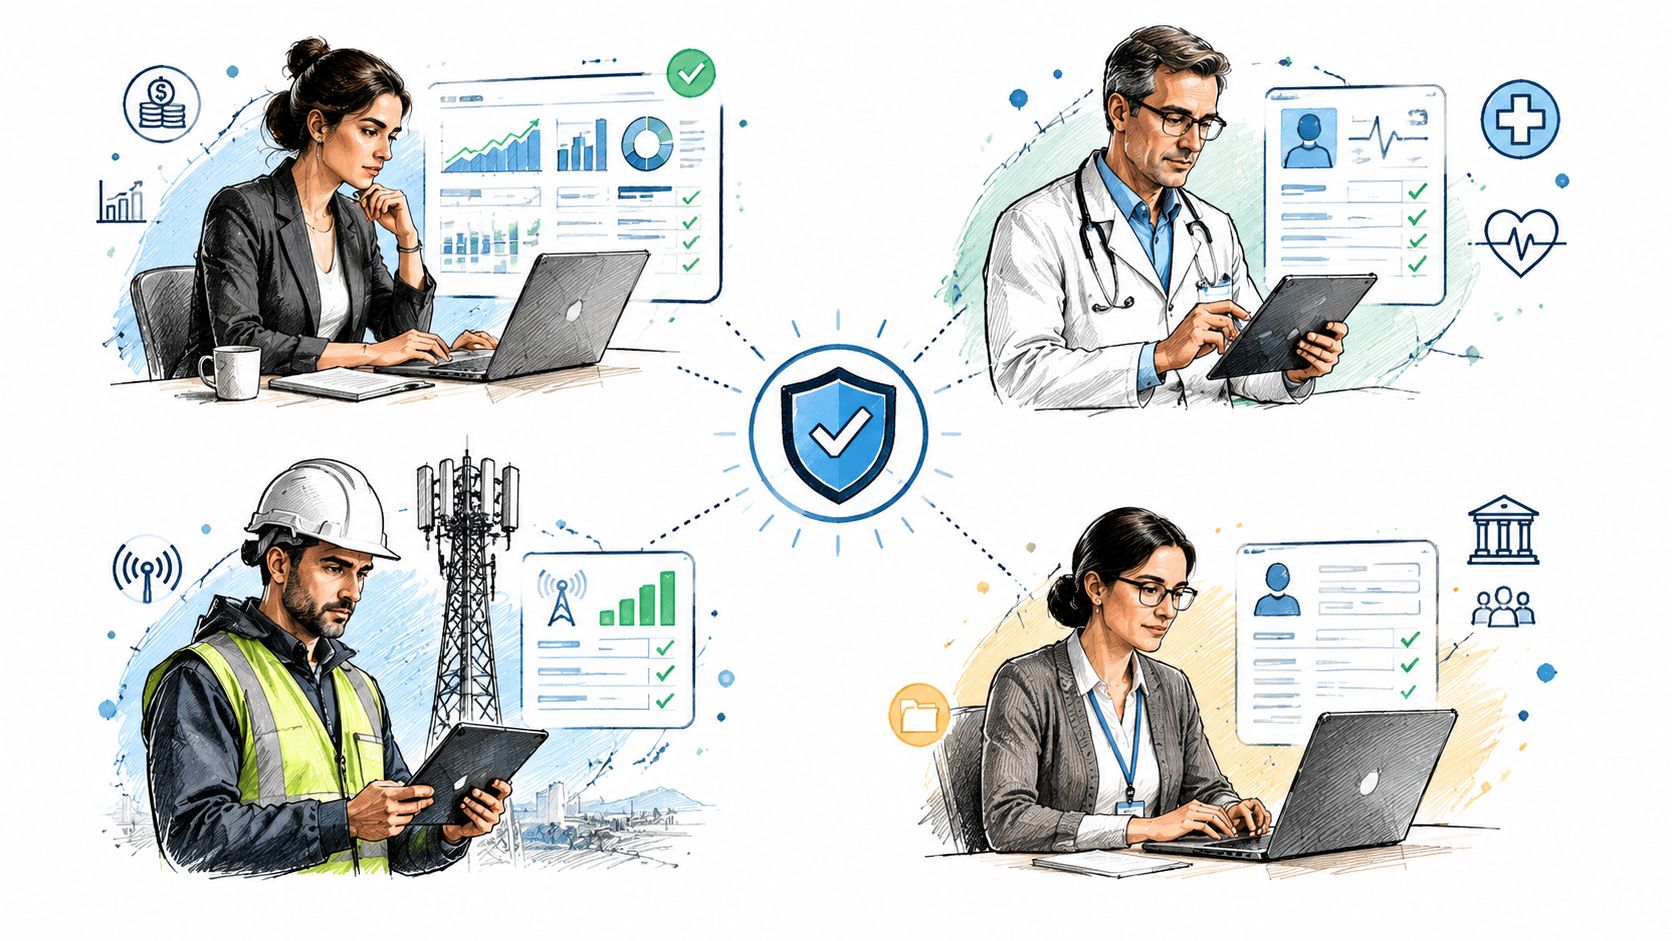
La stessa architettura di controllo si comporta in modo diverso nei vari settori perché i rischi sono diversi. Un team finance può avere a cuore il reporting regolamentare e la completezza delle transazioni. Un'organizzazione sanitaria può dare priorità all'affidabilità dei dati clinici e alla privacy. Un operatore di telecomunicazioni può tenere d'occhio eventi dei clienti ad alto volume, mentre un ente del settore pubblico può aver bisogno di record coerenti e tracciabili per gli audit.
Finanza
Un feed di rischio arriva ogni mattina e alimenta i report usati dai team finance e compliance. Un job completato non garantisce che il feed contenga i record attesi o che una modifica alla sorgente non abbia alterato un campo critico. Il monitoraggio della tempestività può individuare un arrivo in ritardo, la validazione deterministica può applicare le regole sulle transazioni e lo schema tracking può far emergere un cambiamento strutturale prima che il reporting si rompa.
Indicazione pratica: iniziate dai dataset che supportano decisioni regolamentari, di rischio o finanziarie, poi assegnate un responsabile esplicito a ogni controllo.
Sanità
Un team di operazioni cliniche combina informazioni provenienti da diversi sistemi. Un campo mancante può influire sull'interpretazione, mentre un cambiamento strutturale può interrompere un'applicazione a valle senza produrre un errore evidente nella pipeline. La validazione continua e il monitoraggio degli schemi offrono un modo per individuare queste condizioni mantenendo l'elaborazione all'interno dell'ambiente controllato dell'organizzazione.
Indicazione pratica: separate la gestione dei dati sensibili per la privacy dalle evidenze di monitoraggio e definite quali controlli richiedono una prova deterministica.
Telecomunicazioni
Una piattaforma di telecomunicazioni elabora eventi operativi e dei clienti ad alto volume. I responsabili di business possono aver bisogno di sapere se un movimento inatteso riflette il reale comportamento dei clienti o un problema della pipeline. Monitorare le metriche di business sottostanti insieme alla disponibilità dei dati e al carico della piattaforma aiuta i team a indagare sul livello giusto.
Indicazione pratica: abbinate il monitoraggio dei KPI all'osservabilità della piattaforma, così che i movimenti insoliti del business possano essere verificati rispetto alle evidenze operative.
Settore pubblico
I dati della pubblica amministrazione passano spesso tra dipartimenti e sistemi con modelli di responsabilità diversi. Un programma di controllo deve garantire coerenza, tracciabilità ed evidenze pronte per l'audit, invece di affidarsi a controlli informali nei singoli team.
Indicazione pratica: documentate regola, esecuzione, risultato e responsabile per ogni dataset critico.
Negli ambienti regolamentati, l'architettura di deployment conta quanto il rilevamento. digna può essere eseguita nel private cloud, nel VPC o nel data center del cliente, con l'elaborazione svolta in-database, così che le organizzazioni possano limitare il movimento dei dati mantenendo una visione condivisa di incidenti, tendenze e stato.
Decidere quando automatizzare e come iniziare con digna
Partite dal rischio, non dal catalogo di funzionalità più ampio. Un dataset critico con frequenti aspettative di consegna e diversi consumer a valle merita attenzione prima di una tabella a basso impatto che usano in pochi.
Usate quattro domande per definire il primo perimetro:
Impatto sulle decisioni: quale decisione di business, clinica, finanziaria o di servizio pubblico dipende da questi dati?
Visibilità del guasto: gli utenti noterebbero subito un guasto, o potrebbe restare nascosto?
Complessità operativa: i dati attraversano più pipeline, responsabili o piattaforme?
Pressione di governance: requisiti di privacy, compliance o audit richiedono evidenze?
Un primo progetto sensato affronta un unico problema ad alto impatto, come il rilevamento delle anomalie o la tempestività. Ampliate il perimetro dopo che il team ha compreso qualità degli alert, responsabilità e correzione. Mantenete il rollout modulare, aggiungendo validazione deterministica, schema tracking, monitoraggio del business o osservabilità della piattaforma dove il rischio lo giustifica.
Checklist per l'adozione
Esecuzione locale: mantenete l'elaborazione all'interno del cloud, del VPC o del data center dell'organizzazione quando il movimento dei dati crea rischi.
Usate il database: preferite il calcolo delle metriche in-database dove sicurezza e scala lo richiedono.
Separate segnali appresi e segnali fissi: lasciate che le baseline individuino i comportamenti insoliti, mentre le regole deterministiche fanno rispettare gli obblighi.
Registrate le evidenze: conservate il controllo, il contesto di esecuzione, il risultato, il responsabile e lo storico della risoluzione.
Collegate il workflow: integrate gli alert con scheduler, catalogo, dashboard e processo di collaborazione.
Rivedete i falsi allarmi: trattate il tuning degli alert come una responsabilità di ingegneria continua.
Un approccio mirato all'implementazione della data quality aiuta i team a trasformare queste decisioni in un modello operativo. L'obiettivo non è automatizzare il testing fine a sé stesso. È rendere la qualità un processo continuo e trasparente di cui ingegneri e responsabili di business possano fidarsi.
digna offre un monitoraggio modulare di anomalie, validazione, tempestività, modifiche agli schemi, metriche di business e comportamento della piattaforma dati all'interno dell'ambiente del cliente. Visitate digna per valutare un punto di partenza mirato e vedere come un controllo qualità automatico continuo possa adattarsi al vostro patrimonio di dati.
Ecco come funziona in pratica con digna: monitoraggio automatizzato della data quality dove risiedono i vostri dati.
Domande frequenti
Che cos'è il controllo qualità automatico dei dati?
Il controllo qualità automatico è la verifica continua dei dataset senza che una persona debba avviarla. Combina la validazione basata su regole per i requisiti che si possono formulare in modo esatto, soglie statistiche per tolleranze misurabili e machine learning che segnala le deviazioni dal comportamento appreso di ciascun dataset.
In cosa il controllo qualità automatico differisce dai controlli manuali?
L'ispezione manuale campiona i dati periodicamente e dipende da chi è disponibile a controllare. L'automazione osserva ogni caricamento rispetto a una baseline, quindi la copertura non varia in base ai turni e il tempo di rilevamento scende da giorni a minuti, ed è proprio questo a determinare quanti danni un problema causa a valle.
Quando usare le regole e quando il rilevamento con l'AI?
Usate le regole dove il requisito si può mettere per iscritto: una colonna non deve essere NULL, un valore deve rispettare un formato, una tabella deve arrivare entro una scadenza. Usate il rilevamento statistico e con l'AI per tutto ciò che non potete elencare in anticipo, come un calo di volume, uno spostamento della distribuzione o un caricamento che arriva ogni notte un po' più tardi.
Il controllo qualità automatico richiede di copiare i dati su un'altra piattaforma?
Non dovrebbe. Mantenere l'elaborazione vicina ai dati significa che solo metriche e metadati escono dall'ambiente, il che è importante ovunque data residency, privacy o normative di settore limitino il luogo in cui i dati di produzione possono essere elaborati.
Come si inizia ad automatizzare il controllo della qualità dei dati?
Partite dai dataset il cui guasto ha conseguenze reali, lasciate che il sistema ne apprenda il comportamento normale e automatizzate i controlli che il vostro team esegue già a mano. Ampliate la copertura quando gli alert sono considerati affidabili: l'adozione fallisce più spesso per il rumore degli alert che per la mancanza di funzionalità.


