Come si validano i dati? Guida per le pipeline moderne
|
8
min di lettura

Probabilmente vi state ponendo questa domanda perché qualcosa si è già rotto. Un numero della dashboard è balzato durante la notte, un modello ha iniziato a produrre output strani o una riconciliazione è fallita e nessuno si fida della pipeline finché qualcuno non scava nei log. È questo il contesto reale dietro la domanda come si validano i dati. Non è una questione accademica. È una questione operativa.
Una buona validazione non significa aggiungere qualche controllo sui null e considerare il lavoro finito. Significa decidere che cosa deve essere vero a livello di record, che cosa deve restare stabile lungo la pipeline, che cosa può variare senza rischi e che cosa deve fermare immediatamente la linea. Negli stack moderni significa anche proteggersi da problemi che le guide di base ignorano, in particolare lo schema drift silenzioso e il costo di applicare con eccessiva rigidità regole che per il business non contano.
Indice
Perché la validazione dei dati è più di una semplice checklist
Implementare la validazione a livello di record e di pipeline
Perché la validazione dei dati è più di una semplice checklist
Una dashboard dei ricavi raramente si rompe perché un ingegnere ha dimenticato un controllo. Si rompe perché i team trattano la validazione come un'operazione di pulizia una tantum anziché come parte della progettazione della pipeline. Quando qualcuno si accorge che i numeri sono sbagliati, i dati errati sono già passati attraverso trasformazioni, join, modelli BI e report a valle.
Ecco perché la validazione dei dati va collocata in più punti di controllo, non solo sull'output finale. Il pattern più solido è mettere la prevenzione al primo posto. Le regole di validazione dovrebbero intercettare i problemi nel punto in cui i dati entrano nel sistema, e poi di nuovo dopo le fasi di trasformazione in cui la logica può introdurre nuovi errori. La panoramica di Great Expectations sulla validazione delle pipeline lo spiega chiaramente, sottolineando la validazione in fase di ingestion e dopo ogni trasformazione, insieme a una documentazione ripetibile ai fini dell'auditabilità.
Il vero risultato è la fiducia
Le organizzazioni dicono di volere dati puliti. Ciò che vogliono davvero sono decisioni affidabili. Se il reparto finance deve mettere in discussione ogni report, se gli analisti devono ispezionare manualmente ogni aggiornamento o se gli ML engineer non si fidano degli input di training, la piattaforma tecnicamente funziona ma operativamente fallisce.
La validazione protegge la fiducia in alcuni modi concreti:
Blocca input errati noti: campi obbligatori, formati validi e regole di business fermano presto i difetti evidenti.
Restringe il perimetro degli incidenti: quando i controlli vengono eseguiti in ogni punto critico, i team sanno dove è entrato il problema.
Rende i fallimenti azionabili: una regola fallita è più utile di una vaga lamentela del tipo “la dashboard sembra sbagliata”.
Supporta la compliance: una validazione ripetibile e metadati pubblicati forniscono ai team un processo verificabile.
Regola pratica: non validate i dati solo in base a ciò che avete visto in passato. Validateli rispetto a ciò che il business dice debba essere vero.
La pulizia reattiva arriva troppo tardi
Molti team si affidano ancora alla pulizia a valle. Sembra pratico finché un campo errato non è già stato aggregato nei report o inviato a sistemi rivolti ai clienti. Pulire a posteriori è più lento, più costoso e più difficile da sottoporre ad audit.
Un modello operativo migliore si presenta così:
Definite le aspettative di business prima del codice.
Applicatele in fase di ingestion.
Ricontrollatele dopo ogni trasformazione significativa.
Registrate i risultati, così che i fallimenti siano tracciabili e riproducibili.
La validazione non è burocrazia. È il controllo ingegneristico che impedisce a record errati, dati obsoleti e schemi rotti di trasformarsi in decisioni di business.
Le dimensioni fondamentali della validazione dei dati
Una pipeline può superare ogni controllo di base e danneggiare comunque la fiducia. Il guasto tipico non è un null in un campo obbligatorio. Sono dati che sembrano accettabili, attraversano lo stack e smettono di corrispondere alla realtà del business senza che nessuno se ne accorga, dopo una modifica della sorgente, un caricamento in ritardo o un nuovo percorso di codice a monte.
Ecco perché la validazione ha bisogno di più struttura di un semplice cancello superato/non superato. I team hanno bisogno di un modo per decidere che cosa deve essere imposto, che cosa va monitorato e che cosa può essere tollerato per breve tempo, perché il costo del blocco è superiore al costo della revisione. Un utile punto di partenza sono sei dimensioni della qualità. Forniscono ai team un vocabolario comune per decidere dove si trova il rischio e quanto rigoroso debba essere ciascun controllo.
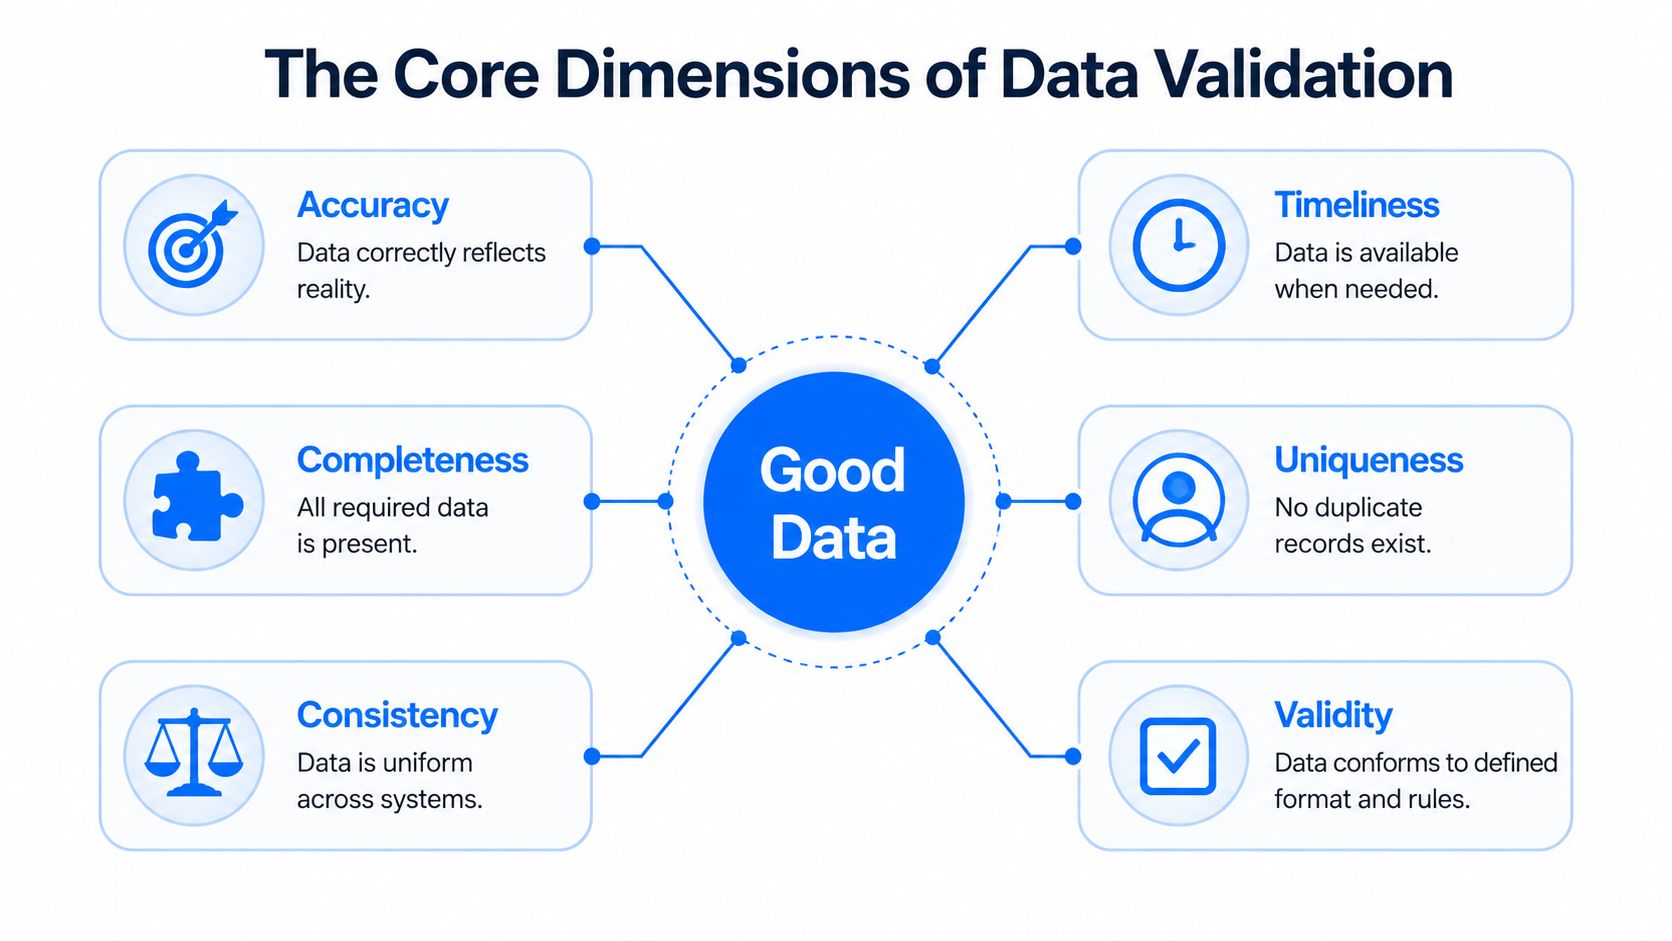
I dati di qualità hanno sei dimensioni
Queste dimensioni suonano familiari perché lo sono. L'errore è trattarle come una checklist anziché come classi di guasto distinte, con costi di business diversi.
Dimensione | Che cosa significa nella pratica | Impatto tipico quando fallisce |
|---|---|---|
Accuratezza | Il valore riflette l'evento o l'entità del mondo reale | Prezzi errati, saldi errati, stato del cliente errato |
Completezza | I dati obbligatori sono presenti dove il processo ne dipende | Join rotti, report inutilizzabili, feature del modello mancanti |
Coerenza | Lo stesso concetto è rappresentato allo stesso modo in tutti i sistemi | Problemi di riconciliazione, logica duplicata, contestazioni sui report |
Tempestività | I dati arrivano entro la finestra che il business si aspetta | Dashboard obsolete, operazioni in ritardo, SLA mancati |
Unicità | Un record o un'entità compare una sola volta quando deve | Clienti duplicati, addebiti duplicati, conteggi gonfiati |
Validità | I valori rispettano formati, domini e regole consentiti | Errori di parsing, eventi rifiutati, transazioni non valide |
La tempestività merita più attenzione di quanta ne riceva di solito. Ho visto team approvare un dataset perché ogni campo superava i controlli di tipo e di intervallo, mentre le operazioni lavoravano sui dati del giorno prima. La tabella era valida. La decisione era comunque sbagliata.
Lo stesso vale per unicità e coerenza. Una transazione duplicata può costare di più di un campo opzionale mancante. Un codice di stato che significa una cosa nel sistema sorgente e un'altra nel warehouse può superare la validazione dello schema e rompere comunque il reporting finanziario. La validazione funziona meglio quando la gravità segue l'impatto sul business, non l'ordine tecnico.
Tipi di validazione diversi intercettano classi di rischio diverse
Ogni dimensione richiede un tipo di controllo diverso. Se i team validano solo la struttura, perdono il significato. Se osservano solo le distribuzioni, perdono le violazioni delle regole rigide. Una buona copertura nasce dalla combinazione di diversi tipi di controlli, assegnando a ciascuno una modalità di applicazione.
Usate questa mappatura:
La validazione dello schema controlla la struttura. Presenza delle colonne, tipo di dato, nullabilità e modifiche al contratto.
La validazione sintattica controlla il formato. Date, codici valuta, identificativi, booleani e pattern di testo standardizzati.
La validazione semantica controlla il significato di business. Data di fine successiva alla data di inizio, transizioni di stato coerenti con il flusso di lavoro, prezzi allineati alle regole di prodotto.
La validazione relazionale controlla l'integrità tra tabelle. Chiavi esterne, record orfani e completezza padre-figlio.
La validazione statistica controlla le derive comportamentali. Variazioni di volume, cambiamenti nel tasso di null, variazioni di cardinalità e anomalie nelle distribuzioni.
Lo schema drift silenzioso si colloca tra queste categorie e causa alcuni degli incidenti più difficili da diagnosticare. Un team sorgente può allargare un campo, riutilizzare un enum per un altro scopo, cambiare la gestione dei fusi orari o iniziare a inviare una nuova colonna opzionale che il codice a valle ignora. Nulla si blocca. I numeri semplicemente smettono di tornare. In queste situazioni, i controlli automatici sui contratti e i monitor basati sui profili dimostrano il loro valore. I team che valutano strumenti gratuiti di validazione dei dati per controlli sullo schema e monitoraggio del drift dovrebbero cercare sia l'applicazione di regole rigide sia alert basati sui trend, perché l'una senza l'altra lascia punti ciechi.
Un campo può essere valido per tipo ed essere comunque non valido per la decisione che supporta.
È questa la lacuna che le guide di base spesso trascurano.
Un processo pratico di progettazione delle regole parte dal linguaggio naturale. Definite che cosa deve essere vero, chi ne dipende, che cosa succede se fallisce e se la pipeline deve bloccare, mettere in quarantena, avvisare o registrare l'evento per una revisione. La panoramica di IBM sulle dimensioni chiave della qualità dei dati è utile qui perché inquadra la qualità come idoneità all'uso, che è esattamente il criterio con cui la validazione andrebbe prioritizzata nei sistemi di produzione.
La scelta di progettazione finale è economica. Bloccare ogni anomalia sembra disciplinato, ma può fermare le operazioni che generano ricavi, ritardare i consumatori a valle e sommergere i team di alert di scarso valore. Lasciar passare tutto è peggio. I programmi di validazione solidi separano i fallimenti ad alto rischio dalle variazioni tollerabili, impongono automaticamente i primi e monitorano le seconde con un'ownership chiara. È così che la validazione migliora l'affidabilità senza trasformare la pipeline in un generatore costante di incidenti.
Implementare la validazione a livello di record e di pipeline
La validazione funziona meglio quando la applicate contemporaneamente su due livelli. Prima, ispezionate ogni record alla ricerca di violazioni delle regole. Poi, ispezionate la pipeline come sistema per individuare perdite, mancate corrispondenze e rotture strutturali. Se fate solo una delle due cose, le lacune restano aperte.
Partite dalle regole a livello di riga
A livello di record, la base è semplice. Le best practice del settore prevedono una validazione a livello di riga che applichi a ogni record otto regole specifiche, ovvero campi obbligatori, controllo del tipo, validazione del formato, vincoli di intervallo, unicità, integrità referenziale, logica di business e validazione tra campi, insieme a un audit logging che tracci i conteggi di superamento/fallimento per ogni esecuzione a fini di compliance e debug, come descritto nella guida di Flatfile alla validazione dei dati.
Un pattern SQL pratico si presenta così:
Non è affascinante, ma è efficace. L'obiettivo è rendere ogni fallimento esplicito e classificabile.
Di solito vi servirà un mix di controlli:
Campi obbligatori: bloccate i null in chiavi, date e attributi critici dal punto di vista operativo.
Controlli di tipo e di formato: imponete che le date siano date, i booleani siano booleani e i codici rispettino i formati di riferimento.
Vincoli di intervallo: intercettate valori impossibili o pericolosi prima che distorcano la logica a valle.
Regole tra campi: validate relazioni come date di inizio e di fine, segni di dare e avere o combinazioni di paese e formato del codice postale.
Poi validate la pipeline come sistema
I controlli sulle righe non intercettano tutto. Una pipeline può superare le regole a livello di record ed essere comunque rotta se metà dei dati non è mai arrivata, se un join ha moltiplicato le righe duplicate o se i conteggi di sorgente e destinazione non si riconciliano più.
È qui che contano i controlli a livello di pipeline:
Confronto del numero di righe: confrontate i conteggi di sorgente e destinazione dopo caricamenti e trasformazioni.
Monitoraggio dei duplicati: verificate che le chiavi che dovrebbero essere univoche lo restino dopo join o union.
Integrità referenziale: confermate che i valori delle chiavi esterne esistano nelle tabelle referenziate.
Controlli di plausibilità sugli aggregati: confrontate totali, distribuzioni e pattern di null tra le diverse fasi.
Controlli di parità nelle migrazioni: per i campi critici durante le migrazioni, validate ogni riga quando il business non può tollerare perdite silenziose.
Le indicazioni di digna sulla validazione delle migrazioni sono particolarmente utili in questo caso. Evidenziano che per i campi critici durante le migrazioni di dati è necessaria una validazione al 100% a livello di riga per confermare che i conteggi dei record corrispondano tra sorgente e destinazione, verificando al tempo stesso che non siano stati creati duplicati, che nessun record sia andato perso inosservato e che non esistano record parziali, mentre per i dataset di grandi dimensioni si può ricorrere a un campionamento statisticamente significativo con rilevamento delle anomalie quando un controllo manuale completo non è praticabile.
Lasciate i controlli pesanti nel warehouse
La validazione di tabelle di grandi dimensioni spesso fallisce perché i team estraggono troppi dati dal warehouse e li ispezionano nel codice applicativo. È lento, costoso e difficile da scalare. Spostate il lavoro pesante nel database ogni volta che è possibile.
La validazione nel database è più adatta per:
controlli di unicità su chiavi di business composte
integrità referenziale tra dataset
controlli di soglia e di intervallo su tabelle di grandi dimensioni
confronti di profilo su tassi di null o distribuzioni delle categorie
Se volete un punto di partenza leggero prima di costruire un vostro framework, vale la pena valutare questi strumenti gratuiti di validazione dei dati di digna insieme ad opzioni come i test dbt, Great Expectations e i controlli SQL nativi del warehouse.
Il warehouse è già ottimizzato per scansionare, confrontare, aggregare ed eseguire join. Lasciate che la validazione avvenga lì, invece di esportare il problema altrove.
Automatizzare la validazione e gestire i fallimenti
I controlli manuali a campione vanno bene per il debug. Non sono un modello operativo. Se la validazione non viene eseguita automaticamente ogni volta che i dati cambiano, il vostro team si affida alla fortuna e alla curiosità.
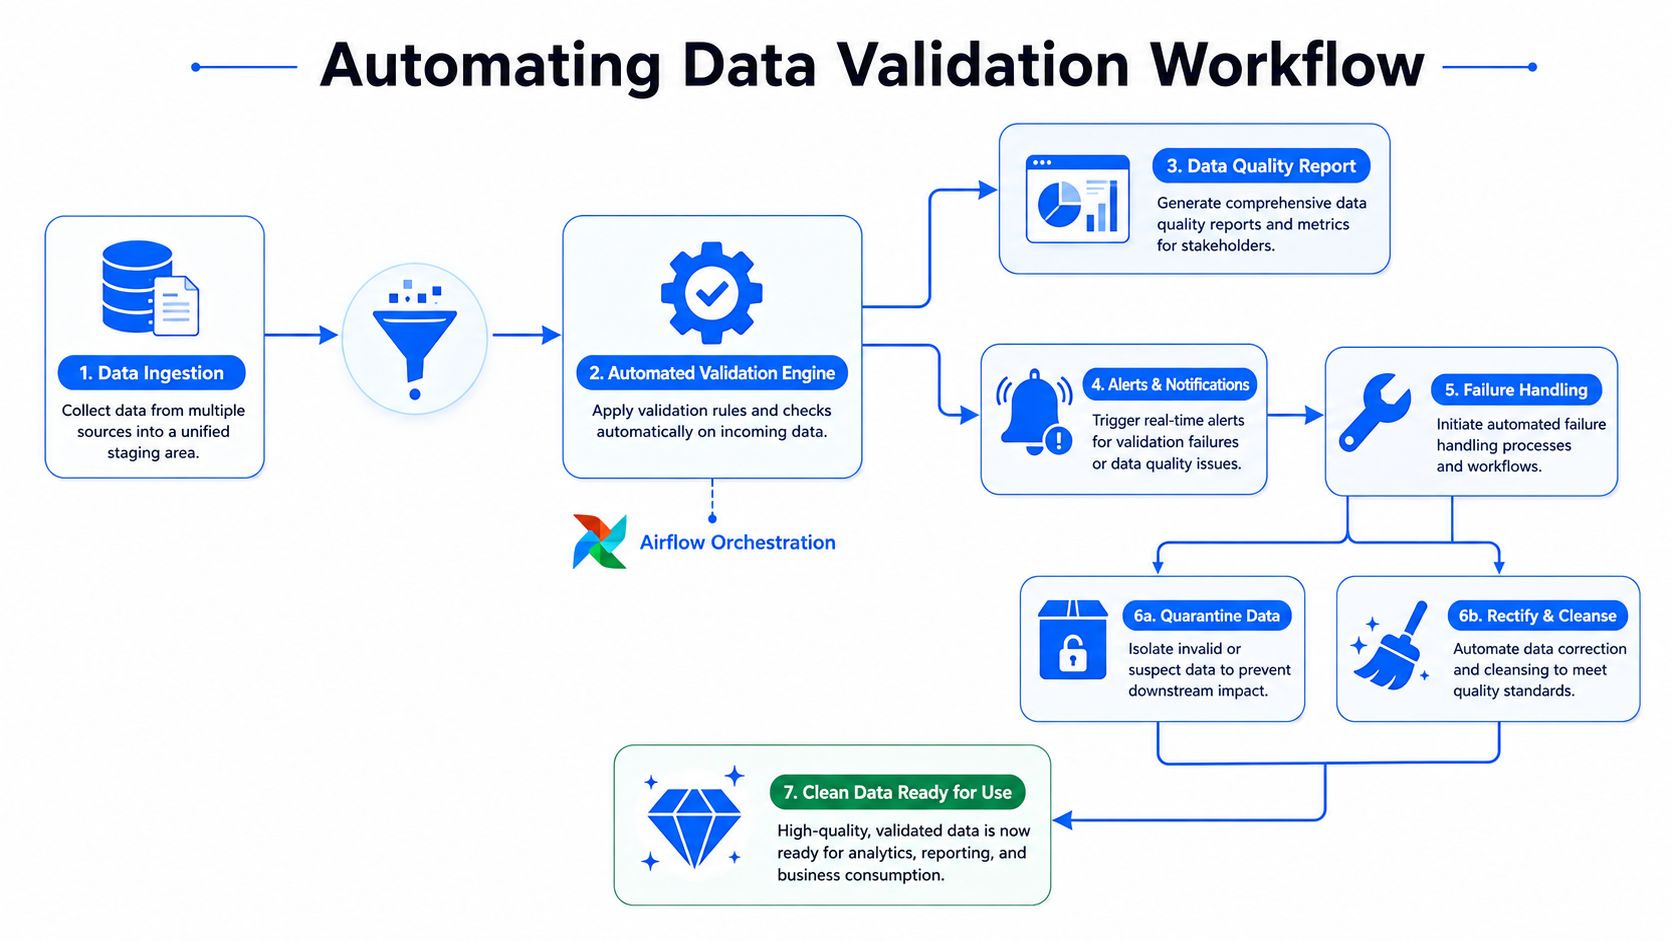
Automatizzate i controlli dove i dati cambiano
Il pattern di automazione più pulito è guidato dagli eventi o dall'orchestrazione. Eseguite i controlli dopo l'ingestion, dopo le trasformazioni principali e prima di pubblicare i dati nei livelli di serving. Airflow, dbt e i task del warehouse supportano tutti questo pattern.
Una sequenza solida si presenta così:
Acquisite i dati e validate subito lo schema.
Eseguite le regole a livello di record sulle tabelle di atterraggio.
Eseguite controlli sugli aggregati e di parità dopo le trasformazioni.
Scrivete i risultati superato/fallito in una tabella di audit.
Attivate l'azione appropriata in caso di fallimento.
Osservabilità e validazione iniziano a convergere. La validazione vi dice se una regola è stata superata. L'osservabilità vi aiuta a capire le variazioni dei trend, i ritardi nella tempestività e se lo stesso fallimento si ripete tra un'esecuzione e l'altra. Un'utile introduzione è questa panoramica sui concetti di data observability e sulla progettazione dei flussi di lavoro.
Una breve demo può aiutare a rendere concreto il pattern di orchestrazione:
Scegliete le azioni in caso di errore in base al rischio di business
Non tutti i controlli falliti meritano la stessa risposta. È a questo punto che i team spesso reagiscono in modo eccessivo o insufficiente.
Un modello decisionale utile consiste nel classificare i fallimenti in tre categorie:
Tipo di fallimento | Esempio | Azione migliore |
|---|---|---|
Arresto immediato | Chiave primaria mancante, periodo contabile non valido, rottura referenziale in una tabella dei fatti critica | Fermare la pipeline |
Quarantena | Un sottoinsieme di righe viola il formato o la logica di business | Inoltrare i record errati per la revisione |
Avvisare e proseguire | Deriva minore in un campo descrittivo non critico | Inviare un alert e monitorare |
Il compromesso è economico, non solo tecnico. I dati di settore mostrano che i problemi di qualità dei dati causano il 20-30% della perdita di ricavi nei settori finanziario e sanitario, eppure non esiste un framework standard per calcolare il punto di rottura in cui lo sforzo di validazione supera la riduzione marginale del rischio, secondo la discussione di Twilio sulle tecniche di validazione e sul loro impatto sul business. Questa lacuna è importante. I team devono decidere dove un'applicazione rigorosa si ripaga da sola e dove crea attrito senza ridurre granché il rischio.
Se il vostro stack alimenta anche sistemi generativi, qualità dei dati e monitoraggio dei modelli iniziano a sovrapporsi. Quando valutate i controlli a valle, è utile trovare la piattaforma di monitoraggio LLM giusta, così da capire come si integrano affidabilità degli input, comportamento dei prompt e monitoraggio in produzione.
Evitate l'alert fatigue
Troppi team inondano Slack e la posta elettronica di alert di scarso valore finché nessuno li legge più. Una buona automazione crea segnali, non rumore.
Alcune abitudini funzionano bene:
Instradate in base alla gravità: le chiamate di reperibilità dovrebbero essere rare. La maggior parte dei problemi va in dashboard o code di ticket.
Raggruppate i fallimenti correlati: se dieci tabelle falliscono perché è cambiato uno schema a monte, inviate un solo incidente.
Includete il contesto: ogni alert dovrebbe indicare che cosa è fallito, dove, quando e che cosa ha fatto il sistema dopo.
Rivedete periodicamente i pattern: la guida di Cube alle best practice di validazione descrive una cadenza utile in contesti enterprise, in cui i team rivedono i pattern di errore ogni trimestre e aggiornano le regole ogni anno, anziché lasciare in vigore soglie obsolete.
Gli alert dovrebbero dire a un ingegnere che cosa è successo e che cosa fare dopo. Se si limitano ad annunciare “validazione fallita”, sono lavoro non finito.
Strategie avanzate per la scala enterprise
Su scala enterprise, le regole statiche contano ancora, ma non bastano più. Servono controlli per cambiamenti che nessuno ha esplicitamente previsto nel codice, soprattutto quando strumenti BI, servizi ETL e applicazioni sorgente continuano a evolversi sotto di voi.
Lo schema drift silenzioso è il problema enterprise che le guide di base trascurano
Molti fallimenti non derivano da un null o da un valore fuori intervallo. Derivano da una sottile modifica strutturale. Una colonna viene rinominata, un tipo passa da intero a stringa oppure uno strumento a monte adatta automaticamente uno schema in un modo che mantiene attiva l'ingestion ma rompe la logica a valle.
Ecco perché il tracciamento dello schema dovrebbe essere trattato come validazione, non solo come igiene dei metadati. Il rischio è maggiore di quanto molti team pensino. Recenti report di settore del 2025-2026 indicano che il 65% dei fallimenti delle pipeline di ML deriva da modifiche dello schema non rilevate anziché da errori nei valori dei dati, eppure i protocolli di validazione standard includono raramente il tracciamento delle versioni dello schema, come citato in questa discussione sullo schema drift e sui fallimenti delle pipeline.
Una pratica matura di validazione dello schema include:
Tracciamento delle versioni: registrate le modifiche strutturali nel tempo.
Controlli di compatibilità: decidete quali modifiche sono retrocompatibili e quali dovrebbero bloccare la pubblicazione.
Ownership: rendete un team responsabile dell'approvazione delle modifiche allo schema.
Controlli dell'impatto a valle: collegate gli alert sulle modifiche dello schema ai modelli, alle dashboard o alle API interessati.
Aggiungete rilevamento delle anomalie e tempestività
Le regole codificate intercettano solo ciò che sapete già di dover cercare. I sistemi enterprise hanno bisogno di un ulteriore livello che rilevi cambiamenti inattesi nelle distribuzioni, nei pattern di null, nel mix di categorie e nei tempi di consegna.
È uno dei casi in cui il supporto di una piattaforma aiuta. Strumenti come i test dbt e Great Expectations gestiscono bene la validazione basata su regole. Per il monitoraggio nel database di anomalie, tempestività, regole a livello di record e modifiche allo schema, un'opzione è digna, che esegue le analisi all'interno dell'ambiente del cliente e mette in evidenza trend, ritardi e cambiamenti strutturali senza esportare i dati di produzione.
La tempestività merita lo stesso trattamento dei controlli sui contenuti. Dati in ritardo possono invalidare le dashboard anche quando ogni riga supera le regole di tipo e di formato. Monitorate le finestre di arrivo previste e segnalate i caricamenti in ritardo prima che siano gli stakeholder a scoprire da soli report obsoleti.
I team che costruiscono flussi di supporto basati sull'AI incontrano un problema simile a livello applicativo. I dati possono essere strutturalmente validi e portare comunque a output inaffidabili se input e istruzioni non sono controllati. Ecco perché le indicazioni sul prompt design per un'AI di supporto affidabile sono utili in parallelo alla validazione dei dati. Affrontano un'altra versione della stessa disciplina: definire gli input accettabili e ridurre le modalità di guasto silenziose.
La governance impedisce alle regole di deteriorarsi
Le regole di validazione invecchiano male quando nessuno ne è responsabile. Un team le scrive, un altro modifica il processo sorgente e sei mesi dopo i controlli sono rumorosi o irrilevanti.
Un modello sostenibile include:
Definizioni delle regole in linguaggio naturale: gli stakeholder di business dovrebbero poterle revisionare senza leggere SQL.
Responsabili assegnati: un data owner, uno steward o un team di governance dovrebbe mantenere ciascuna regola.
Audit logging: conservate i conteggi superato/fallito e i metadati delle esecuzioni.
Revisione programmata: riesaminate regolarmente soglie, ipotesi ed eccezioni.
È questo livello di governance a trasformare la validazione da una raccolta di script in un sistema di controllo operativo.
Un framework pragmatico per la validazione dei dati
Un programma di validazione pratico parte dal rischio, non dalla copertura. I team finiscono nei guai quando scrivono decine di controlli per dati a basso impatto e poi si lasciano sfuggire le poche modalità di guasto che possono corrompere il reporting dei ricavi, rompere i flussi di lavoro dei clienti o inviare feature errate ai modelli. Un framework migliore pone prima due domande: che cosa può fallire senza essere rilevato, e qual è il costo per il business se succede?

Un modello operativo per i team che hanno bisogno di risultati
Partite dagli asset di dati che comportano il rischio operativo o normativo più elevato. Nella pratica, di solito si tratta di misure finanziarie, identificativi dei clienti, campi di compliance e input dei modelli. Definite un piccolo insieme di regole per ciascuno, poi associate ogni regola a un'azione. Se un controllo fallisce, decidete se la pipeline deve fermarsi, mettere in quarantena i dati interessati o proseguire con un alert.
Adottate un modello di applicazione misto, perché non tutti i difetti vanno trattati allo stesso modo:
Applicate regole rigide agli invarianti: chiavi primarie, campi obbligatori, integrità referenziale e formati fissi.
Usate il rilevamento delle anomalie per i cambiamenti difficili da elencare in anticipo: spostamenti delle distribuzioni, picchi di null, variazioni di volume e arrivi in ritardo.
Tracciate esplicitamente lo schema drift: le modifiche silenziose a colonne e tipi spesso rompono la logica a valle prima che qualcuno se ne accorga.
Assegnate un responsabile a ogni regola: qualcuno deve esaminare il rumore, approvare le eccezioni e dismettere i controlli obsoleti.
Molte guide di base sono carenti proprio su questo punto. Trattano la validazione come un cancello superato/non superato. I sistemi di produzione hanno invece bisogno di un modello basato sul rischio. Una chiave primaria mancante in una tabella finanziaria merita un arresto immediato. Una variazione minore in un attributo a bassa priorità può richiedere solo un avviso e un ticket. L'obiettivo non è la massima applicazione delle regole. L'obiettivo sono dati affidabili a un costo che il team può sostenere.
Che cosa fare per primo questa settimana
Partite da una pipeline contestata. Scegliete quella che le persone già mettono in discussione nelle riunioni, perché ha già un impatto visibile sul business e un ciclo di feedback naturale.
Poi fate cinque cose:
Indicate le cinque condizioni di business che devono essere vere.
Associate ogni condizione a un controllo tecnico a livello di record o di pipeline.
Classificate ogni fallimento in base all'impatto: arresto, quarantena, avviso o sola registrazione.
Aggiungete uno storico delle esecuzioni, così che il team possa vedere fallimenti ripetuti e derive nel tempo.
Esaminate i falsi positivi dopo la prima settimana e affinate le regole rumorose.
Questa sequenza funziona perché obbliga a fare dei compromessi fin dall'inizio. I team imparano quali controlli proteggono la fiducia e quali creano solo alert fatigue. Inoltre fa emergere le modalità di guasto reali prima che qualcuno investa in un grande catalogo di regole che sarà costoso da mantenere.
La validazione dei dati funziona meglio come un sistema operativo per l'affidabilità. Combina regole deterministiche, rilevamento del drift, consapevolezza dello schema, ownership e gestione dei fallimenti in un unico processo in grado di resistere al cambiamento delle sorgenti e alla crescente complessità delle pipeline.
Se cercate un modo pratico per combinare in un unico flusso di lavoro validazione nel database, rilevamento delle anomalie, monitoraggio della tempestività e tracciamento dello schema, date un'occhiata a digna. È pensato per i team che devono validare i record, intercettare il drift e monitorare l'affidabilità delle pipeline senza spostare i dati di produzione fuori dal proprio ambiente.
Poiché lo schema drift silenzioso sfugge alle regole a livello di record, digna Schema Tracker copre il lato della validazione legato al tracciamento delle versioni, rilevando colonne aggiunte, rimosse o con tipo modificato prima che la logica a valle si rompa.
Domande frequenti
Come si validano i dati in una pipeline?
Validate in più punti di controllo, non solo sull'output. La sequenza proposta nell'articolo è: validare lo schema in fase di ingestion, eseguire le regole a livello di record sulle tabelle di atterraggio, eseguire controlli sugli aggregati e di parità dopo le trasformazioni, scrivere i risultati superato/fallito in una tabella di audit e poi attivare l'azione in caso di fallimento adeguata al rischio di business.
Quali sono le sei dimensioni della qualità dei dati?
Le sei dimensioni sono accuratezza, completezza, coerenza, tempestività, unicità e validità. L'articolo le tratta come classi di guasto distinte con costi di business diversi: una transazione duplicata può costare più di un campo opzionale mancante, e una tabella può superare ogni controllo di tipo mentre le operazioni lavorano ancora sui dati del giorno prima.
Quali regole di validazione a livello di riga dovrebbe superare ogni record?
La guida di Flatfile, citata nell'articolo, ne elenca otto: campi obbligatori, controllo del tipo, validazione del formato, vincoli di intervallo, unicità, integrità referenziale, logica di business e validazione tra campi. Abbinatele a un audit logging dei conteggi superato/fallito per ogni esecuzione. Un semplice pattern SQL con CASE può segnalare ID ordine null, importi negativi o date d'ordine future.
Che cosa dovrebbe succedere quando un controllo di validazione dei dati fallisce?
Adeguate la risposta al rischio di business. Gli arresti immediati fermano la pipeline per problemi come una chiave primaria mancante o un periodo contabile non valido. La quarantena inoltra un sottoinsieme di righe errate per la revisione. L'approccio “avvisare e proseguire” è adatto a una deriva minore in un campo descrittivo non critico, che riceve un alert e un monitoraggio anziché un blocco.
Perché lo schema drift è un problema di validazione dei dati?
Le modifiche strutturali spesso sfuggono ai controlli sui valori: una colonna rinominata o un cambio di tipo da intero a stringa possono mantenere attiva l'ingestion rompendo al contempo la logica a valle. I report citati nell'articolo attribuiscono il 65% dei fallimenti delle pipeline di ML a modifiche dello schema non rilevate, quindi tracciamento delle versioni, controlli di compatibilità e ownership fanno parte della validazione.


