Che cos'è un data catalog? Guida al suo potenziale nel 2026
|
7
min di lettura

Probabilmente lo state già vivendo. Qualcuno chiede “la tabella dei ricavi” e tre team diversi indicano tre dataset diversi. Un analista trova una dashboard ma non riesce a capire se è aggiornata. Un data engineer conosce il nome della pipeline ma non chi è responsabile del report a valle. Un team di ML vuole dati di addestramento, ma nessuno sa dire con certezza se la sorgente è approvata, aggiornata o persino ancora in uso.
È proprio questa la lacuna che un data catalog dovrebbe colmare.
Al livello più elementare, un data catalog aiuta le persone a trovare e comprendere i dati. Nella pratica, un catalogo moderno fa molto più che inventariare tabelle e dashboard. Diventa il luogo in cui si incontrano metadati, lineage, ownership, significato di business e governance. Nel 2026 questo ruolo conta ancora di più, perché gli esseri umani non sono più gli unici consumatori. Anche gli agenti AI hanno bisogno di contesto, segnali di affidabilità e lineage chiaro per poter usare in sicurezza i dati aziendali.
Indice
Oltre l'analogia della biblioteca: che cos'è un data catalog nel 2026
Sotto il cofano: l'architettura di base di un data catalog moderno
Data catalog, data dictionary e strumento di data lineage a confronto
Oltre l'analogia della biblioteca: che cos'è un data catalog nel 2026
L'analogia della biblioteca funziona ancora come punto di partenza. Un classico schedario aiutava a trovare un libro senza percorrere ogni corridoio. Un data catalog fa qualcosa di simile per dataset, dashboard, report, pipeline e modelli.
Ma in uno stack dati moderno l'analogia crolla in fretta.
Una scheda di biblioteca non si aggiornava da sola quando un libro cambiava scaffale, titolo o veniva citato da altri dieci libri. Un catalogo moderno deve fare esattamente questo tipo di lavoro. Si collega a warehouse, lake, piattaforme di BI, livelli di trasformazione e strumenti di orchestrazione. Acquisisce automaticamente i metadati, collega gli asset tra loro e fornisce agli utenti un contesto sufficiente per decidere se un dataset è utilizzabile.
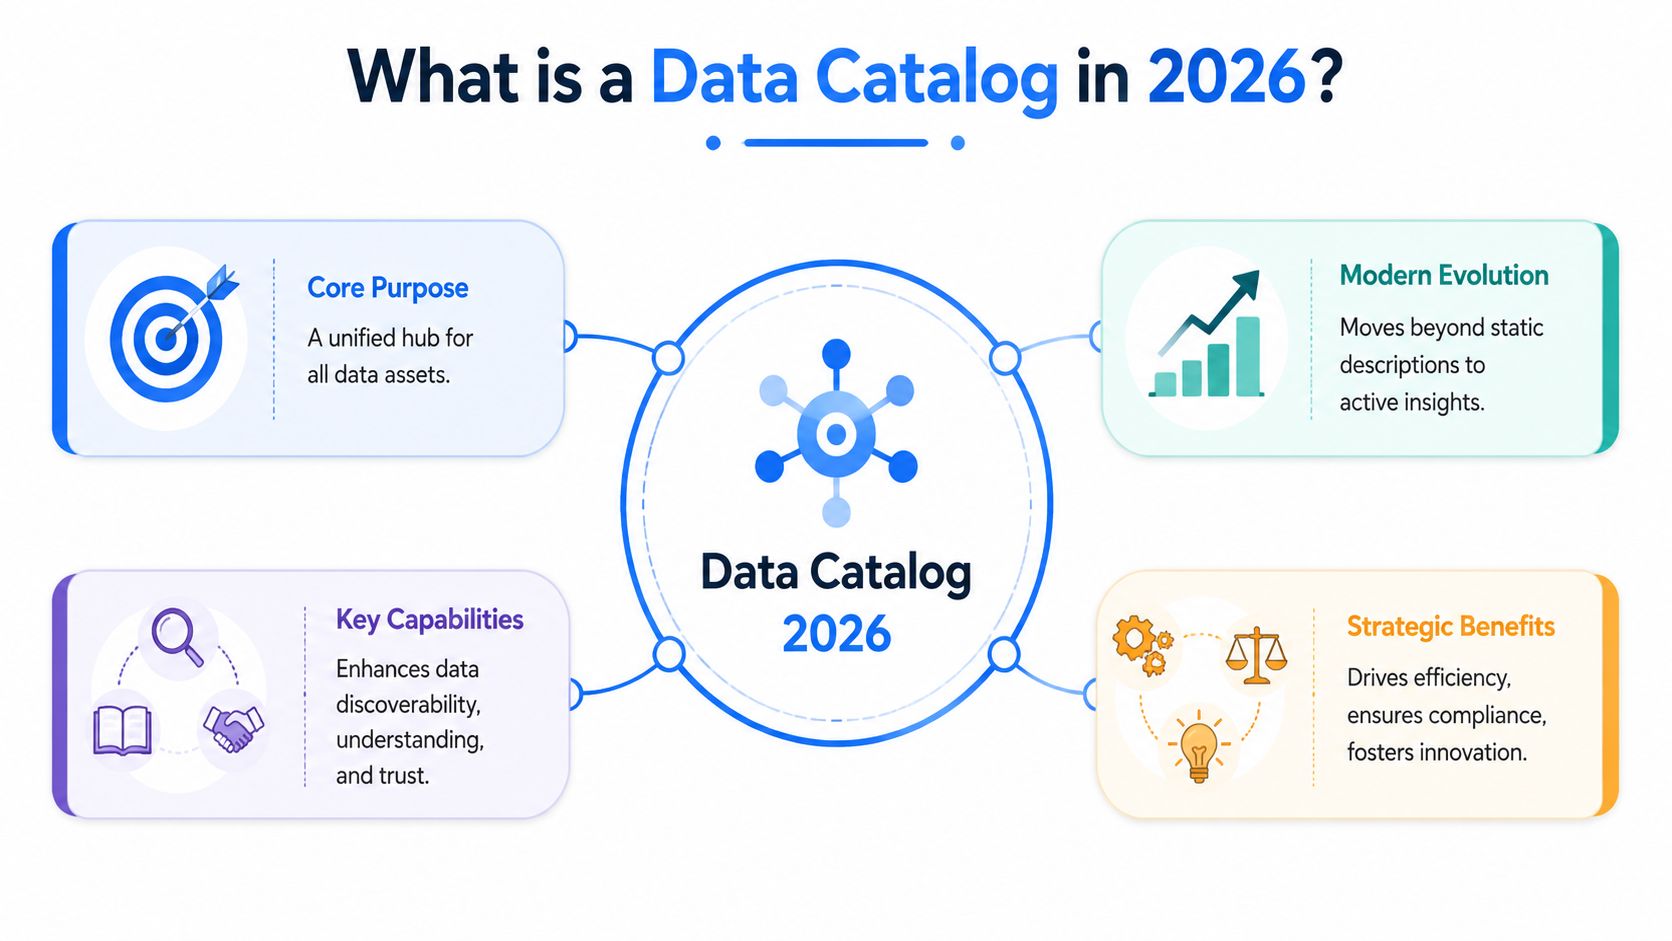
Che cosa contiene davvero il catalogo
Un catalogo utile non si limita a elencare nomi. Organizza diversi livelli di metadati attorno a ciascun asset:
I metadati tecnici descrivono la forma fisica dell'asset, come schema, colonne, tipi di dati, sistema di origine e modalità di aggiornamento.
I metadati di business spiegano in linguaggio semplice che cosa significa l'asset, incluse definizioni come “ricavi netti” o “cliente attivo”.
I metadati di governance registrano classificazioni, controlli di accesso, ownership e contesto delle policy.
I metadati operativi mostrano come si comporta l'asset nell'uso reale, ad esempio pattern di utilizzo, dipendenze delle pipeline e attività di aggiornamento.
Ecco perché un catalogo è importante. Trasforma un inventario grezzo in contesto utilizzabile.
Perché la vecchia definizione è troppo limitata
Storicamente, i data catalog si sono evoluti dai sistemi manuali a schede degli anni '70 fino alle piattaforme automatizzate e basate sull'AI di oggi, con una tappa significativa nel 2020, quando il settore ha ufficialmente riconosciuto il data catalog come il livello di discovery e governance dello stack dati, distinto dai tradizionali repository di metadati.
Questo cambiamento è importante perché la maggior parte delle organizzazioni non ha difficoltà ad archiviare i dati. Ha difficoltà a sapere che cosa possiede, se può fidarsene e come usarlo correttamente.
Un foglio di calcolo con i nomi delle tabelle non è un catalogo. È un elenco di cose su cui nessuno può agire in sicurezza.
Il modo migliore per capire che cos'è oggi un data catalog è questo: è un livello di conoscenza operativo per il vostro patrimonio dati. Aiuta un analista a trovare la dashboard giusta, aiuta un engineer a tracciare l'impatto a monte e aiuta un responsabile della governance a sapere chi è il proprietario di un dataset e perché esiste.
C'è anche uno stretto parallelismo con l'evoluzione della documentazione tecnica. La documentazione statica invecchia in fretta. I sistemi che restano utili attingono a un contesto aggiornato, riflettono lo stato attuale e collegano le spiegazioni ad artefatti operativi reali. Un buon catalogo fa lo stesso per i dati.
Sotto il cofano: l'architettura di base di un data catalog moderno
Un catalogo può sembrare una barra di ricerca con qualche diagramma di lineage, ma sotto la superficie è un sistema di metadati con diverse parti strettamente collegate. Se una sola di esse è debole, gli utenti se ne accorgono immediatamente.
Un'interfaccia pulita non può salvare una base di metadati debole.

Le quattro parti che contano
Un'architettura di data catalog ben progettata si basa su quattro componenti essenziali: un metadata store che preserva le connessioni, un motore di ricerca per l'indicizzazione, un'applicazione backend per acquisizione e integrazione e un'applicazione frontend come portale per gli utenti. Questi componenti devono gestire metadati tecnici, di governance, operativi, di qualità e di utilizzo per consentire una discovery completa.
Ecco che cosa significa nella pratica.
Componente | Che cosa fa | Che cosa si rompe senza di esso |
|---|---|---|
Metadata store | Tiene insieme definizioni degli asset, relazioni, cronologia e ownership | Il contesto si frammenta tra gli strumenti |
Motore di ricerca | Indicizza i metadati in modo che gli utenti possano davvero trovare gli asset | La discovery si trasforma in conoscenza tribale |
Applicazione backend | Estrae i metadati dai sistemi di origine e li mantiene sincronizzati | Il catalogo si allontana dalla realtà |
Applicazione frontend | Presenta agli utenti asset, lineage, documentazione e workflow | L'adozione si blocca perché nessuno vuole usarlo |
Perché le scelte architetturali si riflettono sulla fiducia degli utenti
Il metadata store è il cuore del sistema. Se memorizza solo schemi e nomi di tabelle, il catalogo sembrerà sempre superficiale. I cataloghi solidi catturano un quadro più ricco: chi è il proprietario dell'asset, quali policy si applicano, quali oggetti a valle ne dipendono e come le persone lo usano.
La ricerca è più tecnica di quanto molti team si aspettino. Una buona ricerca non è un semplice abbinamento di parole chiave. Deve indicizzare metadati strutturati e non strutturati, supportare i sinonimi e ordinare i risultati probabili in modo coerente sia con il linguaggio di business sia con la nomenclatura tecnica.
Per i team che stanno definendo una strategia sui metadati, questa guida su come i metadati migliorano la qualità dei dati e l'efficienza è utile perché collega le decisioni architetturali all'affidabilità quotidiana.
Più avanti nello stack, il livello di acquisizione del backend è il punto in cui molte implementazioni falliscono. Se i connettori funzionano in modo inaffidabile, o non riescono a riflettere rapidamente le modifiche a monte, il catalogo inizia a mostrare ownership obsolete, schemi non aggiornati o lineage mancante. È allora che gli utenti smettono di fidarsene.
Una breve panoramica aiuta a renderlo concreto:
Regola pratica: se il vostro livello di acquisizione si aggiorna lentamente e i vostri utenti lavorano in un warehouse in rapida evoluzione, il catalogo diventerà un archivio storico anziché uno strumento operativo.
Anche il frontend è importante, ma non per motivi estetici. È il punto in cui utenti di business, data steward ed engineer incontrano gli stessi metadati da angolazioni diverse. Una persona vuole la definizione certificata di un KPI. Un'altra vuole il lineage di dbt. Una terza vuole sapere a chi scrivere quando una dashboard è sbagliata. L'interfaccia deve servire tutte e tre.
Funzionalità e capacità chiave da cercare
I team chiedono spesso che cos'è un data catalog come se la risposta fosse l'etichetta di una categoria. La domanda più utile è più semplice: in che modo il catalogo può aiutare le persone in un brutto martedì pomeriggio?
È lì che le funzionalità smettono di essere voci di una checklist e iniziano a diventare un vantaggio operativo.
Funzionalità di discovery che fanno risparmiare tempo reale
Il primo compito è aiutare gli utenti a trovare rapidamente l'asset giusto e poi a valutare se è davvero quello corretto.
Cercate queste capacità:
Raccolta automatica dei metadati, così che il catalogo individui gli asset da piattaforme come Snowflake, BigQuery, Databricks, dbt, Tableau e Power BI senza la manutenzione manuale di fogli di calcolo.
Una ricerca che comprende l'intento, così che gli utenti possano cercare per termine di business, nome del sistema, proprietario, tag o dominio invece di memorizzare i nomi delle tabelle.
Filtri a faccette che consentono di restringere i risultati per sorgente, sensibilità, stato di certificazione, freschezza e team responsabile.
Anteprime degli asset che mostrano schema, metadati di esempio, descrizioni e asset correlati prima che qualcuno richieda l'accesso o inizi un'analisi.
Governance e segnali di affidabilità
La sola discovery non basta. I team devono anche decidere se un risultato è sicuro e appropriato da usare.
Un catalogo solido dovrebbe supportare:
La visualizzazione del lineage, che mostra i movimenti a monte e a valle tra pipeline, modelli e report.
Campi di ownership e stewardship, con una persona o un team designato associato a ogni asset importante.
Workflow di certificazione, così che dataset e metriche affidabili si distinguano da quelli sperimentali o deprecati.
Contesto delle policy per i dati regolamentati, inclusi tag e classificazioni che accompagnano l'asset.
Se gli utenti trovano i dati ma non riescono a capire se sono approvati, aggiornati o sensibili, il catalogo ha risolto la ricerca ma ha mancato la fiducia.
Una collaborazione che cattura la conoscenza istituzionale
L'insieme di funzionalità più sottovalutato è la collaborazione. Commenti, valutazioni, note d'uso e collegamenti al glossario sembrano piccole cose, ma sono il modo in cui la conoscenza tribale diventa riutilizzabile.
Questo è particolarmente rilevante quando i team vogliono mantenere il contesto utilizzabile tra formati e pubblici diversi. La stessa disciplina alla base del riutilizzo efficace dei contenuti si applica anche qui. I metadati dovrebbero essere strutturati una volta sola ed essere utili in molti contesti, dai workflow degli analisti alle revisioni di governance.
Ciò che non funziona è un catalogo che si aspetta che ogni descrizione venga scritta a mano da zero e curata costantemente da un unico team centrale. Questo modello crolla su larga scala. Lo schema migliore è prima l'automazione, poi la cura umana dove il giudizio conta di più.
Data catalog, data dictionary e strumento di data lineage a confronto
Questi termini vengono confusi di continuo. Si sovrappongono, ma non sono intercambiabili.
Un data dictionary di solito definisce campi e valori. Uno strumento di lineage mostra come si muovono i dati. Un data catalog si colloca a un livello più ampio. Riunisce inventario, contesto, discovery, ownership e governance attorno agli asset di tutto lo stack.
Confronto tra strumenti dati
Strumento | Scopo principale | Ambito | Differenza chiave rispetto a un catalogo |
|---|---|---|---|
Data catalog | Aiutare gli utenti a scoprire, comprendere e governare gli asset di dati | Dataset, dashboard, pipeline, modelli, termini del glossario, ownership, lineage, contesto delle policy | Il livello di contesto più ampio, tra uso tecnico e di business |
Data dictionary | Definire campi, colonne, valori e termini di business | Di solito definizioni a livello di campo o di tabella | Strumento di riferimento più ristretto, incentrato sulle definizioni |
Strumento di data lineage | Mostrare da dove provengono i dati e dove fluiscono | Percorsi delle pipeline, trasformazioni, dipendenze | Incentrato su movimento e impatto, non su discovery e stewardship complete |
Data marketplace | Aiutare gli utenti a consultare data product curati e a richiederne l'accesso | Dataset sotto forma di prodotto e workflow di accesso | Spesso costruito su concetti di catalogo, ma più incentrato su distribuzione e accesso |
Dove i team di solito si confondono
Gli stakeholder di business usano spesso “data dictionary” quando in realtà intendono “il posto dove trovo dati di reporting affidabili”. Gli engineer a volte usano “lineage” quando in realtà intendono “il sistema che mi aiuta a capire che cos'è questa tabella e chi ne è il proprietario”. Entrambe le cose sono comprensibili. Entrambe generano errori di implementazione.
Ecco la distinzione pratica:
Usate un data dictionary quando l'esigenza principale sono definizioni precise di colonne e termini.
Usate uno strumento di lineage quando l'esigenza principale è l'analisi d'impatto e il troubleshooting dei movimenti dei dati.
Usate un data catalog quando l'esigenza comprende insieme discovery, contesto di business, governance, ownership e lineage.
Per i team che stanno approfondendo concetti affini, questa spiegazione su data provenance e data lineage e le loro differenze chiave aiuta a definire meglio il confine tra origine, movimento e contesto più ampio dei metadati.
Acquistare un visualizzatore di lineage e chiamarlo catalogo di solito lascia a piedi gli utenti di business. Acquistare un glossario e chiamarlo catalogo di solito lascia indifferenti gli engineer.
La distinzione conta perché lo strumento sbagliato crea aspettative sbagliate. Se il management si aspetta analytics self-service, un repository di definizioni delle tabelle non basterà. Se gli engineer hanno bisogno di un'analisi del raggio d'impatto prima di una modifica dello schema, un glossario di business non risolverà il problema.
I vantaggi di business e tecnici nel dettaglio
Le ragioni a favore di un catalogo diventano più forti quando si smette di parlare di “gestione dei metadati” e si inizia a parlare di ore sprecate, lavoro duplicato, pressione degli audit e passaggi di consegne interrotti tra i team.
Il segnale del mercato è già chiaro. Si prevede che il mercato globale dei data catalog raggiunga 1,8 miliardi di dollari entro il 2027, mentre la scarsa reperibilità dei dati comporta una stimata riduzione del 30% della produttività dei team dati. La stessa ricerca afferma che l'85% delle aziende globali ha accelerato l'adozione dei data catalog proprio per rispettare le leggi sulla privacy dei dati come GDPR e CCPA, secondo le statistiche sul mercato dei data catalog.
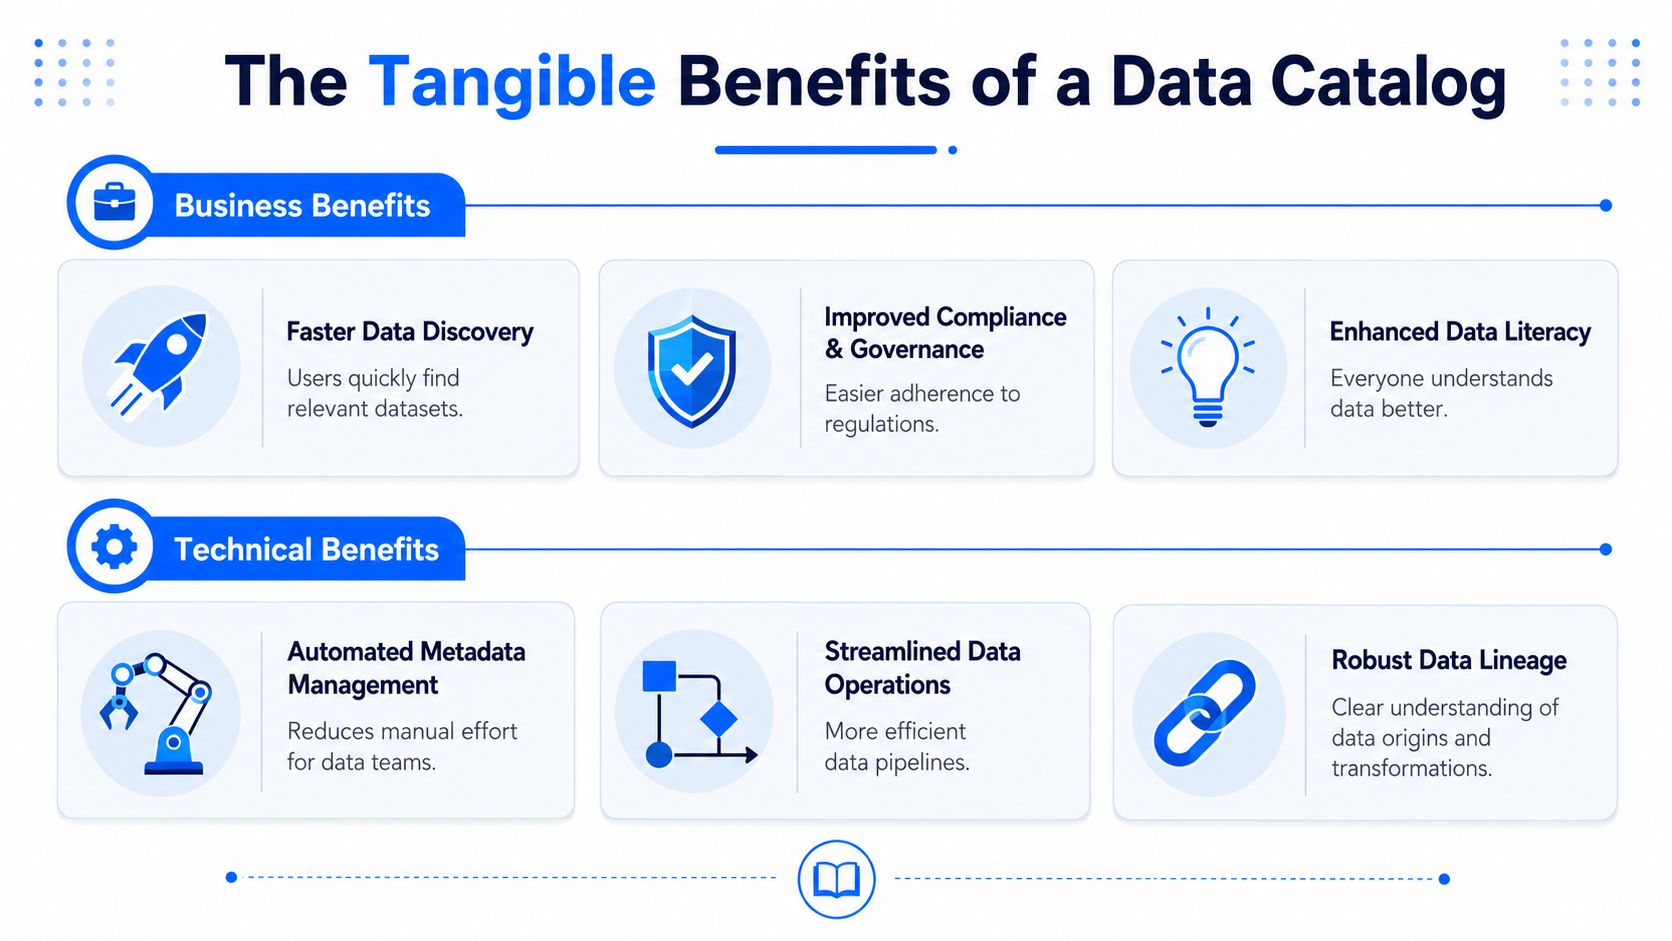
Che cosa ci guadagnano i team di business
Per gli utenti di business, il vantaggio più grande è una distanza più breve tra domanda e risposta.
Un accesso più rapido ad asset affidabili significa che gli analisti passano meno tempo a chiedere nei canali Slack quale dashboard sia aggiornata.
Un supporto decisionale migliore deriva dal vedere in un unico posto definizioni, ownership e sorgenti approvate.
Una postura di compliance più solida ne consegue quando classificazioni di privacy e lineage non sono sepolti in sistemi separati.
Una maggiore data literacy cresce perché i termini di business sono collegati alle tabelle, alle dashboard e alle metriche che le persone usano davvero.
Questo è uno dei motivi per cui i cataloghi stanno entrando nelle discussioni più ampie su come affrontare le sfide operative dell'AI. Quando l'AI entra nei workflow di analytics, l'ambiguità nelle definizioni delle metriche o nell'affidabilità delle sorgenti diventa molto più costosa.
Che cosa ci guadagnano i team tecnici
Engineer, analytics engineer e responsabili della governance hanno a cuore risultati diversi.
Meno lavoro di supporto ripetitivo, perché le domande più comuni su ownership, lineage e utilizzo approvato trovano risposta nel catalogo.
Modifiche più sicure, perché i team possono vedere le dipendenze a valle prima di modificare schemi o pipeline.
Meno asset ridondanti, perché tabelle, data mart e dashboard simili diventano visibili invece di restare nascosti in team separati.
Un onboarding più ordinato, perché i nuovi membri del team possono consultare il sistema di riferimento invece di ereditare una tradizione orale.
C'è anche un vantaggio tecnico meno evidente. Un catalogo crea un luogo in cui più strumenti possono convergere. Metadati del warehouse, modelli dbt, dashboard di BI e tag di governance smettono di essere visioni isolate della realtà.
I cataloghi migliori non riducono la complessità fingendo che non esista. La riducono rendendola visibile, navigabile e affidata a un responsabile.
Come i data catalog generano risultati concreti
Il valore diventa evidente quando si guarda al lavoro quotidiano invece che ai diagrammi della piattaforma.
Un business analyst che prepara una revisione trimestrale cerca “vendite regionali” nel catalogo. Invece di aprire cinque dashboard e chiedere al reparto finanza quale sia quella giusta, trova una dashboard certificata, vede la definizione di business della metrica dei ricavi e verifica quale team ne è responsabile. Non è niente di spettacolare. È semplicemente la differenza tra tirare a indovinare e lavorare a partire da una fonte nota.
Un data engineer riceve un alert che segnala una dashboard errata dopo una modifica a una pipeline. Apre il lineage nel catalogo e traccia il percorso dalla tabella del warehouse al livello di trasformazione e poi all'asset di BI. L'obiettivo immediato non è la documentazione. È circoscrivere il raggio d'impatto e individuare quali asset a valle richiedono attenzione.
Team diversi usano lo stesso sistema in modo diverso
Un data scientist affronta lo stesso catalogo da un'altra prospettiva. Cerca un dataset adatto all'addestramento di un modello. Ha bisogno di significato di business, lineage e contesto di governance prima di fidarsene. Se il catalogo mostra solo uno schema, deve comunque rincorrere le persone per avere risposte. Se mostra ownership, modelli correlati e contesto d'uso, può procedere in modo responsabile.
Un responsabile della governance usa il catalogo durante una revisione della privacy. Deve sapere dove si trovano i campi sensibili, chi ne è il proprietario e quali report o modelli a valle li utilizzano. Questa visibilità trasforma un audit da una caccia al tesoro in un processo di revisione controllato.
Che cosa fanno di diverso i team di successo
I team che traggono valore dai cataloghi di solito fanno bene tre cose:
Assegnano l'ownership in modo chiaro, così che ogni asset importante abbia un vero referente umano.
Certificano in modo selettivo, così che l'etichetta “affidabile” abbia un significato.
Mantengono il catalogo vicino ai workflow di delivery, integrandolo con gli strumenti di trasformazione, BI e governance.
Ciò che fallisce è trattare il catalogo come un repository secondario. Se gli engineer non lo vedono mai durante l'analisi delle modifiche e gli analisti non lo usano mai durante la discovery, diventa in fretta un software inutilizzato.
Potenziare il catalogo con data quality e observability
Un catalogo vi dice che cosa esiste. Spesso vi dice chi ne è il proprietario, da dove proviene e che cosa dovrebbe significare. Ma non sempre vi dice se i dati sono in buona salute in questo momento.
È questo il divario di maturità in cui si imbattono molti team.
Un inventario senza stato di salute non basta
In termini operativi, la fiducia dipende da qualcosa di più della documentazione. I team hanno bisogno di segnali su anomalie, tempestività, validazioni fallite e modifiche degli schemi. Se un catalogo mostra una tabella come “gold” ma l'ultimo caricamento è arrivato in ritardo o una colonna chiave ha cambiato tipo, gli utenti hanno bisogno di questo contesto prima di farvi affidamento.
Questo conta ancora di più per l'AI. Un analista umano potrebbe notare che qualcosa non torna. Un agente automatizzato potrebbe non accorgersene. Userà qualsiasi contesto la piattaforma gli metta a disposizione.
La ricerca 2025 di Snowflake rivela che il 74% delle organizzazioni che prevedono di implementare sistemi di AI in produzione richiede cataloghi che espongano i metadati in formati utilizzabili dalle macchine e includano il lineage degli asset di AI, eppure solo il 29% dei cataloghi attuali soddisfa questi criteri, secondo la ricerca di Snowflake sui metadati utilizzabili dalle macchine e il lineage degli asset di AI.
Questo divario è il punto centrale. Il catalogo non è più solo un luogo in cui gli esseri umani effettuano ricerche. Sta diventando un livello di contesto per i processi decisionali delle macchine.
Di che cosa hanno bisogno i cataloghi pronti per l'AI
Per supportare bene gli agenti AI, i cataloghi hanno bisogno di qualcosa di più dei metadati statici.
Segnali operativi aggiornati, così che gli agenti possano preferire asset attuali e stabili a quelli obsoleti.
Indicatori di qualità, così che i sistemi a valle possano distinguere gli input approvati da quelli discutibili.
Lineage tra gli asset di AI, inclusi modelli, feature, vector store e input di addestramento.
Metadati leggibili dalle macchine, esposti tramite API e strutture semantiche e non solo tramite pagine dell'interfaccia.
È qui che i sistemi di observability e di qualità aggiungono un valore reale. Il rilevamento delle anomalie può individuare cambiamenti sospetti monitorando continuamente i flussi di dati e isolando i comportamenti insoliti, anziché basarsi solo su soglie statiche, come descritto nella spiegazione di FirstEigen sul rilevamento delle anomalie. Gli approcci basati sull'AI possono inoltre apprendere nel tempo le baseline normali e valutare i nuovi dati rispetto a questi pattern in tempo reale, come spiega Plixer nella sua discussione sulle baseline per il rilevamento delle anomalie basato sull'AI.
Un modo utile per inquadrarlo è semplice:
Un catalogo risponde a “che cos'è?”. Gli strumenti di affidabilità rispondono a “posso fidarmene adesso?”.
I team che confrontano queste discipline traggono spesso vantaggio da una distinzione più netta tra data observability e data quality. Le due si sovrappongono, ma non sono identiche. Insieme creano quel livello di metadati arricchito su cui sia le persone sia i sistemi di AI possono agire con maggiore fiducia.
Domande frequenti sui data catalog
I team piccoli hanno bisogno di un data catalog?
Se il vostro ambiente ha solo pochi dataset ben compresi, forse non ancora. Quando più team creano dashboard, trasformazioni e metriche condivise, l'esigenza emerge rapidamente. Il punto di svolta non è la dimensione dell'azienda. Sono la complessità e l'attrito nei passaggi di consegne.
Un data catalog è solo per i team di governance?
No. La governance può esserne lo sponsor, ma engineer, analisti, sviluppatori BI e team di ML lo usano tutti in modo diverso. Se ne vede il valore una sola funzione, probabilmente l'implementazione è troppo ristretta.
Un catalogo può sostituire la documentazione?
No. Migliora la documentazione collegandola a metadati aggiornati e ad asset reali. Non sostituisce buone definizioni, note d'uso o il giudizio architetturale.
Che cosa fa fallire un catalogo?
La maggior parte dei fallimenti deriva da metadati obsoleti, ownership debole e scarsa rilevanza per i workflow. Se il catalogo non è integrato con il warehouse, il livello di trasformazione, gli strumenti di BI e i processi di accesso, le persone smettono di consultarlo.
Che cosa dovrebbero valutare per prima cosa i team?
Iniziate da copertura, freschezza, profondità del lineage, modello di ownership, qualità della ricerca e da quanto bene il sistema espone i metadati sia agli esseri umani sia al software.
Se il vostro team vuole andare oltre i metadati statici e comprendere lo stato di salute in tempo reale di pipeline, tabelle e dati di business critici, digna merita un'attenta valutazione. Aiuta i team a rilevare anomalie, validare i record, monitorare la tempestività e tracciare le modifiche degli schemi in ambienti controllati dal cliente, il che lo rende un complemento pratico a qualsiasi strategia di catalogo costruita attorno alla fiducia e alla preparazione per l'AI.
Se il vostro catalogo risponde già a "che cos'è?" ma non a "posso fidarmene adesso?", la data platform observability con digna aggiunge agli asset che avete catalogato segnali in tempo reale su anomalie, tempestività, validazioni e modifiche degli schemi.
Domande frequenti
Che cos'è un data catalog?
Un data catalog è un livello di conoscenza operativo che aiuta le persone a trovare, comprendere e governare asset di dati come dataset, dashboard, pipeline e modelli. A differenza dello schedario di una biblioteca, si collega a warehouse, lake e strumenti di BI, acquisisce automaticamente i metadati e collega gli asset a ownership, lineage e significato di business.
Quali metadati memorizza un data catalog?
Un catalogo utile organizza quattro livelli di metadati attorno a ciascun asset. I metadati tecnici riguardano schema, colonne e tipi di dati; i metadati di business spiegano termini come ricavi netti; i metadati di governance registrano classificazioni, controlli di accesso e ownership; i metadati operativi mostrano pattern di utilizzo, dipendenze delle pipeline e attività di aggiornamento.
Quali sono i componenti principali dell'architettura di un data catalog?
Contano quattro componenti: un metadata store che preserva le connessioni, un motore di ricerca per l'indicizzazione, un'applicazione backend per acquisizione e integrazione e un'applicazione frontend come portale per gli utenti. Se i connettori del backend funzionano in modo inaffidabile, il catalogo inizia a mostrare ownership obsolete e schemi non aggiornati, e gli utenti smettono di fidarsene.
Qual è la differenza tra un data catalog e un data dictionary?
Un data dictionary definisce campi, colonne, valori e termini di business, di solito a livello di tabella o di campo. Un data catalog è più ampio e riunisce discovery, contesto di business, governance, ownership e lineage in tutto lo stack. Come avverte l'articolo, acquistare un glossario e chiamarlo catalogo di solito lascia indifferenti gli engineer.
Perché i data catalog hanno bisogno di data quality e observability?
Un catalogo vi dice che cosa esiste, ma non sempre se è in buona salute in questo momento. Se una tabella è etichettata come gold ma l'ultimo caricamento è arrivato in ritardo o una colonna chiave ha cambiato tipo, utenti e agenti AI hanno bisogno di questo segnale. La ricerca di Snowflake citata mostra che solo il 29% dei cataloghi attuali soddisfa i criteri di preparazione per l'AI.


