Correggere le anomalie nel database per un'AI affidabile
|
6
min di lettura

Probabilmente in questo momento state affrontando uno di due sintomi. Una tabella transazionale continua a produrre duplicati, chiavi esterne nulle o record che non si riescono a inserire correttamente. Oppure il vostro data warehouse sembra strutturalmente a posto, eppure una dashboard ha subito una deriva, le previsioni di un modello sono peggiorate o un caricamento giornaliero è arrivato così in ritardo da rendere sbagliato il report di ieri.
Entrambi i problemi vengono chiamati “anomalie del database”, ma non sono lo stesso problema. Uno compromette l'integrità dei dati all'interno della progettazione relazionale. L'altro compromette la fiducia nei dati lungo pipeline, analytics e sistemi di AI. I team che li trattano come un'unica categoria di solito investono troppo nella progettazione dello schema e troppo poco nel monitoraggio, oppure fanno il contrario e cercano di uscire con l'osservazione da un modello relazionale difettoso.
Questa distinzione conta se siete responsabili dell'affidabilità degli analytics. Le anomalie classiche nella progettazione dei database esistono ancora e la normalizzazione conta ancora. Ma gli stack moderni hanno bisogno anche di osservabilità su deriva, freschezza e comportamento dello schema, aspetti che non compaiono in un diagramma ER da manuale.
Indice
Rendere operativi il monitoraggio delle anomalie e gli alert
Dal rilevamento alla risoluzione: pattern di analisi delle cause
I due volti delle anomalie del database
Lunedì mattina, una dashboard mostra un calo dei ricavi del 18 percento. Il data warehouse è attivo, le pipeline sono verdi e nessuna tabella ha fallito il caricamento. Entro mezzogiorno il team individua due problemi distinti. Una tabella sorgente contiene ancora attributi dei clienti duplicati, retaggio di una vecchia progettazione, che hanno causato aggiornamenti incoerenti. Allo stesso tempo, un nuovo tipo di campo a monte ha cambiato il modo in cui una trasformazione gestiva i valori nulli, quindi i numeri erano sbagliati anche se i job erano andati a buon fine. Entrambe sono anomalie del database. Appartengono semplicemente a epoche diverse dello stack.
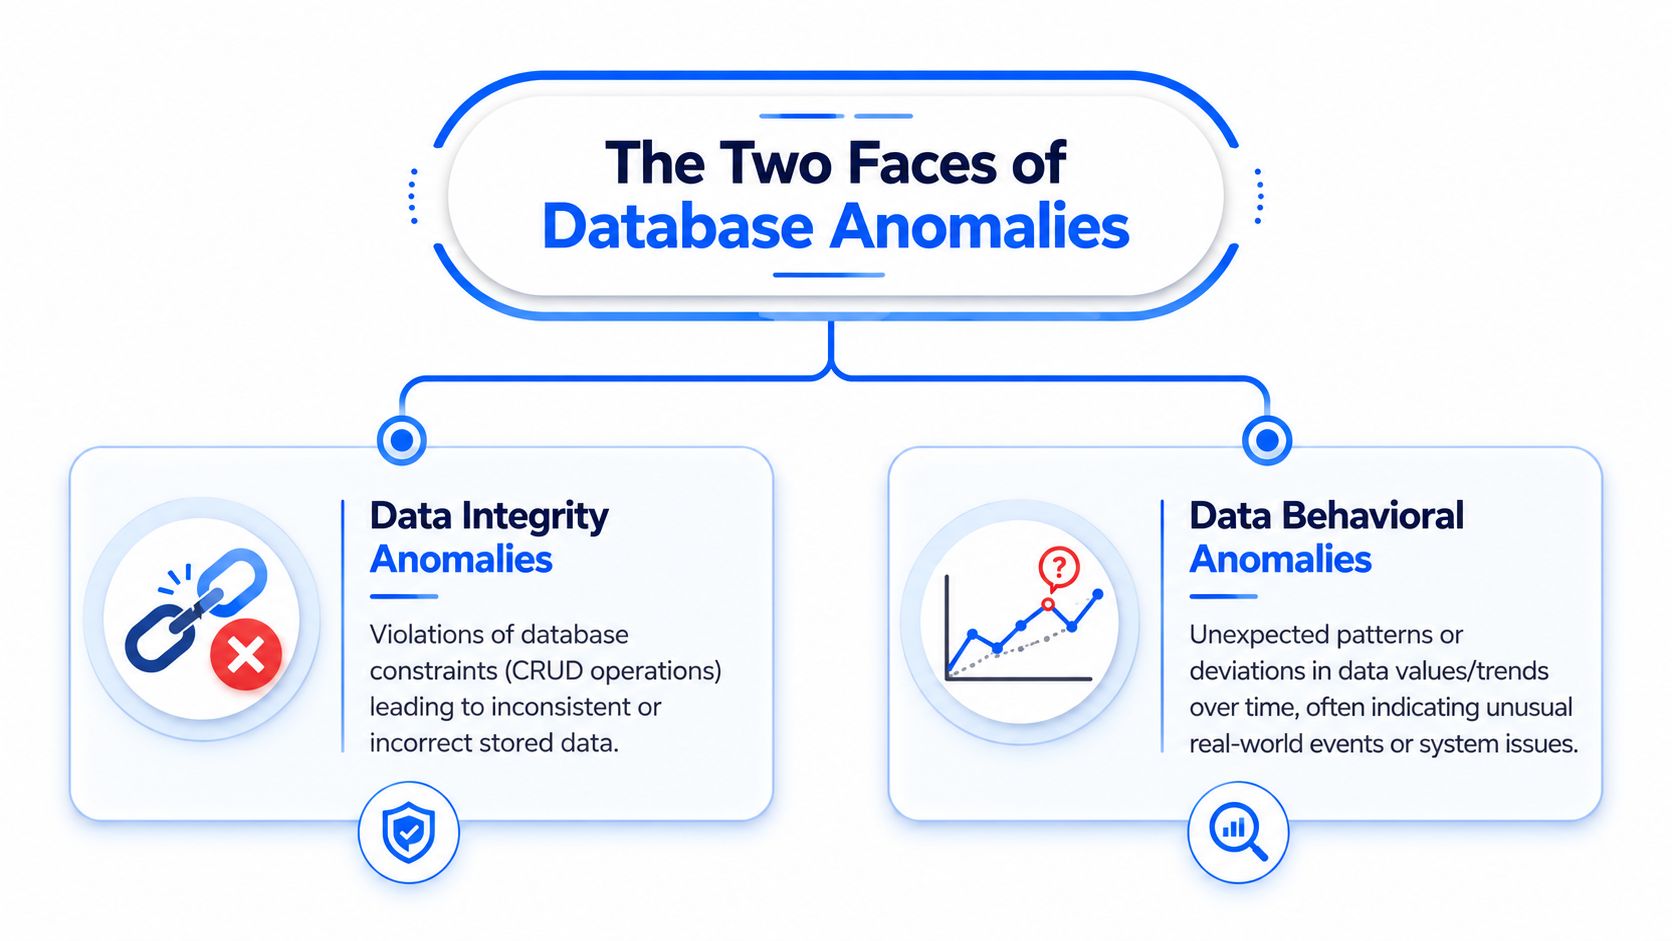
Anomalie classiche nella progettazione relazionale
La definizione da manuale resta il punto di partenza giusto. Nei sistemi relazionali le anomalie compaiono quando la progettazione delle tabelle mescola più fatti nello stesso posto, ripete i dati su più righe o non impone relazioni chiare tra le chiavi. Il risultato è un insieme prevedibile di violazioni dell'integrità durante le operazioni di inserimento, aggiornamento e cancellazione, come descritto in questa spiegazione di GeeksforGeeks sulle anomalie relazionali.
Queste tre categorie restano utili perché corrispondono direttamente agli errori di progettazione che gli ingegneri ereditano ancora in produzione:
Anomalia di inserimento: non è possibile aggiungere una riga senza fornire dati non correlati.
Anomalia di aggiornamento: una singola modifica di business deve essere ripetuta su più righe, il che favorisce le incoerenze.
Anomalia di cancellazione: eliminando un record si elimina anche un fatto di cui il business ha ancora bisogno.
Di solito i team individuano questi problemi in tabelle operative denormalizzate, strumenti interni realizzati in fretta o schemi di reporting legacy cresciuti senza una chiara ownership. Un indirizzo del cliente copiato in ogni riga d'ordine funziona finché un indirizzo non cambia e cinque record non concordano più. Una tabella prodotti incorporata in una tabella vendite funziona finché non viene cancellata l'ultima vendita e lo storico del prodotto scompare con essa.
La normalizzazione è stata pensata proprio per prevenire questa classe di guasti. Separate i fatti in tabelle distinte, assegnate la ownership con chiavi primarie ed esterne e lasciate che i vincoli rifiutino gli stati non validi prima che i dati errati si diffondano. Per un ripasso pratico, consultate questa guida per comprendere cause e soluzioni delle anomalie del database.
Una regola ha retto bene nei sistemi reali. Se lo stesso fatto di business può essere modificato in più di una riga, lo schema sta già creando un rischio.
Anomalie moderne nei data product
La stessa parola, anomalia, oggi copre una seconda classe di problemi. Lo schema può essere valido. Le chiavi possono essere corrette. I vincoli possono essere rispettati. Il guasto si manifesta nel comportamento anziché nell'integrità relazionale.
Gli esempi sono familiari a qualsiasi team che gestisca analytics o ML in produzione. Una metrica giornaliera esce dal suo intervallo atteso. Una sorgente arriva con sei ore di ritardo. Una colonna esiste ancora, ma il suo tipo o il suo pattern di valori nulli cambia abbastanza da invalidare le ipotesi a valle. La distribuzione degli input di un modello si sposta mentre la pipeline continua a produrre punteggi. Questi problemi non somigliano ad anomalie di inserimento, aggiornamento o cancellazione, ma minano comunque la fiducia nel database come sistema decisionale.
Questa distinzione conta nella pratica.
Famiglia di anomalie | Cosa si rompe | Causa tipica | Prima risposta migliore |
|---|---|---|---|
Anomalie relazionali | Integrità dei dati memorizzati | Normalizzazione carente, ridondanza, progettazione debole delle chiavi | Riprogettare tabelle, chiavi e vincoli |
Anomalie comportamentali | Affidabilità degli output di analytics e AI | Deriva, modifiche di schema, lacune di freschezza, guasti delle dipendenze | Monitorare pattern, lineage, contratti e tempi di consegna |
Le anomalie classiche danneggiano la correttezza dei fatti memorizzati. Le anomalie moderne danneggiano l'affidabilità delle conclusioni costruite su quei fatti.
I team di ingegneria devono coprire entrambe. Progettazione dello schema e normalizzazione riducono i difetti strutturali al momento della scrittura. L'osservabilità intercetta i guasti silenziosi che compaiono dopo ingestione, trasformazione e consumo. È il ponte che molti team non vedono, soprattutto quando il monitoraggio del data warehouse viene trattato come separato dalla progettazione della piattaforma. I team che costruiscono sistemi fortemente basati sul ML spesso si scontrano per primi con questo divario, uno dei motivi per cui gli approfondimenti sull'intelligenza artificiale più ampi si sovrappongono sempre di più all'architettura delle piattaforme dati.
Perché analytics e AI moderni sono così vulnerabili
Un inserimento non riuscito di solito fallisce in modo evidente. Un problema di freschezza spesso no. Ecco perché gli stack moderni vengono colti alla sprovvista.
I guasti silenziosi fanno più danni di quelli evidenti
Le anomalie più difficili non sono quelle che mandano in crash un job. Sono quelle che producono output plausibili ma sbagliati. Un modello continua ad assegnare punteggi ai record, ma la distribuzione dei suoi input ha subito una deriva. Una dashboard finanziaria continua a essere visualizzata, ma il flusso è arrivato in ritardo e tutti stanno guardando numeri obsoleti. Una tabella a valle ha ancora le colonne attese, ma una modifica di tipo a monte ha cambiato il modo in cui vengono interpretati valori nulli o categorie.
Ecco perché il divario tra il vecchio e il nuovo modo di pensare alle anomalie è diventato costoso. Il divario critico tra le anomalie DBMS tradizionali e le moderne "anomalie dei dati" (deriva statistica, cambiamenti di schema, problemi di freschezza) lascia i data engineer impotenti di fronte alla deriva silenziosa nei modelli ML e nelle pipeline in tempo reale, dove l'85% dei problemi dei dati ha origine a monte ma resta non rilevato dai sistemi basati su regole.
Per gli analytics, questo significa che i decisori si fidano di report già degradati. Per l'AI, significa che il sistema può restare tecnicamente disponibile pur diventando inaffidabile sul piano operativo.
Una pipeline sana può comunque fornire un significato malato.
Perché i soli controlli basati su regole non vedono il vero problema
I team spesso iniziano con conteggi di righe, controlli sui valori nulli, valori ammessi e qualche asserzione di business. Sono necessari. Non sono sufficienti.
I controlli basati su regole funzionano meglio quando conoscete già la modalità di guasto. Sono deboli contro deriva graduale, stagionalità mutevole, arrivi in ritardo o interazioni tra più sorgenti. È qui che gli ingegneri hanno bisogno di baseline apprese e di un rilevamento consapevole del tempo. Nella pratica, è lo stesso passaggio che molti team stanno facendo più in generale nei sistemi di AI. Se volete un inquadramento utile di come i sistemi adattivi differiscono dalla logica statica, vale la pena leggere questi approfondimenti sull'intelligenza artificiale insieme ai moderni pattern di monitoraggio dei dati.
Alcuni scenari di guasto moderni rendono evidente il rischio:
Deriva degli input del modello: la tabella delle feature continua a caricarsi, ma le distribuzioni dei valori non somigliano più a quelle del regime di addestramento.
Problema di freschezza: il batch notturno arriva in ritardo e ogni dashboard dipendente sembra completa pur raccontando la storia di ieri.
Cambiamento del comportamento dello schema: una colonna rinominata o un cambio di tipo non rompe del tutto le trasformazioni, ma ne cambia la semantica a valle.
Disallineamento tra sistemi: una dipendenza a monte fallisce e i sistemi a valle producono dati incompleti ma sintatticamente validi.
La vecchia lezione era “normalizzate per prevenire le anomalie”. La lezione più recente è “osservate il comportamento in modo continuo, perché una struttura pulita non garantisce output affidabili”.
Un toolkit moderno per il rilevamento delle anomalie
Il rilevatore giusto dipende dal pattern di guasto e dal contesto operativo. Una tabella finanziaria batch, una pipeline di clickstream e un feature store possono fallire in modi diversi pur sembrando "sani" a prima vista.
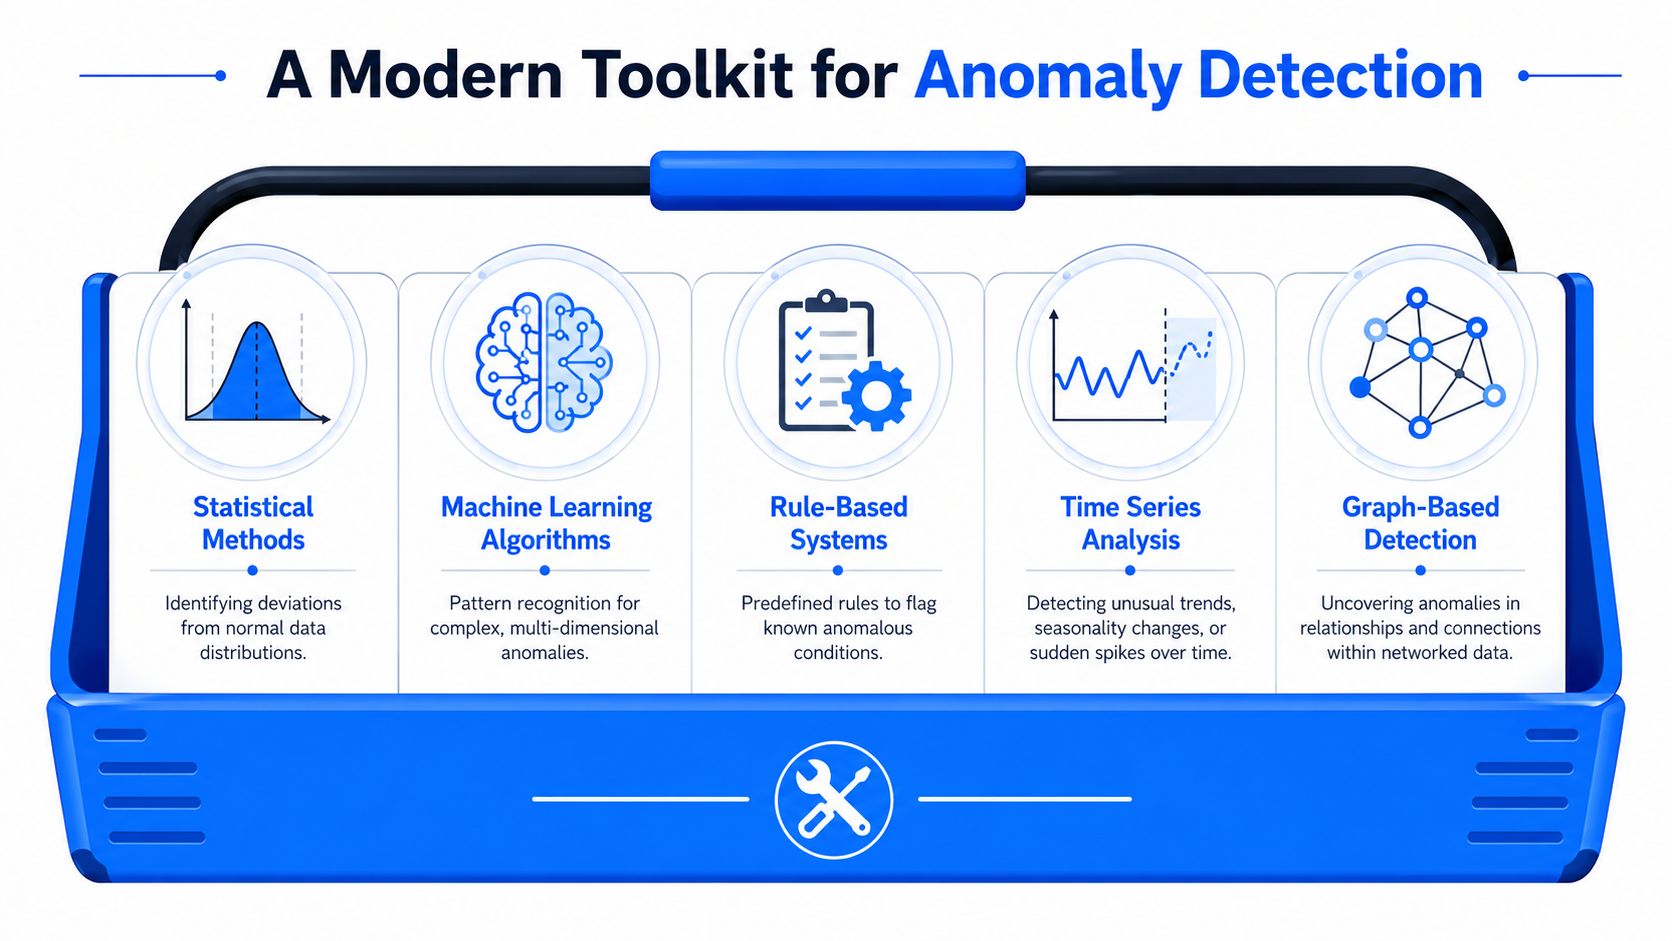
Le anomalie classiche del database hanno insegnato ai team a prevenire gli stati errati attraverso la progettazione dello schema e i vincoli. Gli stack di dati moderni aggiungono un secondo requisito: rilevare nel tempo i comportamenti anomali, anche quando le tabelle continuano a caricarsi e l'SQL continua a girare. Un toolkit pratico deve coprire entrambi gli aspetti.
Quando bastano semplici controlli statistici
Partite dalla statistica per i segnali che dovrebbero restare entro un intervallo operativo ristretto. Per molti controlli sul data warehouse, resta il modo più rapido per stabilire una baseline e il più facile da spiegare durante la revisione di un incidente.
Le opzioni comuni sono semplici:
Z-score: utili per metriche abbastanza stabili, in cui grandi scostamenti dalla media indicano di solito un problema reale.
Controlli IQR: utili per distribuzioni asimmetriche e per individuare valori molto al di fuori della dispersione normale.
Confronto dei trend: efficace quando il dato di oggi dovrebbe somigliare alla storia recente entro una fascia ragionevole.
Questi controlli sono economici da eseguire e facili da rendere operativi in SQL. Funzionano bene per volumi di righe, picchi del tasso di valori nulli, crescita dei duplicati e variazioni improvvise dei valori aggregati.
Falliscono in modi prevedibili. Stagionalità, arrivi in ritardo a monte, promozioni, lanci di prodotto e interazioni tra più tabelle possono far sembrare sospetto un dataset sano, oppure nascondere un problema reale dentro un picco atteso.
Dove trova posto il monitoraggio basato su regole
Le regole vanno usate ovunque il business possa formulare chiaramente un'invariante. Unicità della chiave primaria, campi obbligatori, enumerazioni ammesse, integrità referenziale e aspettative di schema a livello di contratto restano le fondamenta.
Questo conta perché le anomalie classiche di inserimento, aggiornamento e cancellazione non sono mai davvero scomparse. Si presentano solo in forme nuove. Un merge difettoso può duplicare i record dei clienti. Una sincronizzazione parziale può aggiornare un sistema ma non un altro. Una cancellazione logica può rimuovere fatti dal reporting a valle lasciando abbastanza struttura perché il job vada a buon fine.
Metodo | Adatto per | Punto di forza | Limite |
|---|---|---|---|
Controlli statistici | Outlier e variazioni improvvise | Rapidi e interpretabili | Deboli con comportamenti fortemente dipendenti dal contesto |
Controlli basati su regole | Vincoli di business noti | Precisi e verificabili | Non vedono le modalità di guasto sconosciute |
Rilevamento basato su ML | Pattern complessi e sottili | Si adatta a comportamenti multidimensionali | Più difficile da calibrare e spiegare |
Usate le regole per proteggere le verità note. Applicatele in modo deciso alle tabelle ad alto rischio. Non aspettatevi però che intercettino la deriva della freschezza, i cambiamenti semantici o il lento spostamento delle distribuzioni negli input dei modelli.
Quando il machine learning ripaga l'investimento
Il machine learning inizia a contare quando il comportamento normale ha troppe dimensioni per una soglia calibrata a mano. Succede con flussi di eventi, feature store, telemetria d'uso e qualsiasi metrica con stagionalità mutevole o dipendenze tra sistemi.
Alcuni metodi si rivelano costantemente utili nella pratica:
Isolation Forest: adatti a individuare record o periodi insoliti in grandi dataset senza un pesante lavoro di feature engineering.
Modelli LSTM: utili per il monitoraggio delle serie temporali quando i pattern temporali contano e le semplici medie mobili producono troppi falsi allarmi.
Metodi k-NN e Naive Bayes: scelte comuni quando il rilevamento delle anomalie dipende dal comportamento del vicinato o da relazioni probabilistiche tra i campi.
Rilevamento non supervisionato: utile quando le anomalie etichettate scarseggiano, situazione comune nei sistemi di produzione reali.
Il compromesso è operativo, non accademico. I rilevatori basati su ML possono far emergere i guasti silenziosi che le regole non vedono, ma richiedono calibrazione, decisioni sul riaddestramento e una ownership più stringente. Se nessuno sa spiegare perché è scattato un alert, i team iniziano a ignorare il sistema.
Un modello più solido consiste nel combinare i metodi nello stesso livello di monitoraggio. Usate i vincoli per i guasti netti, la statistica per uno screening rapido e le baseline apprese per i comportamenti che cambiano nel tempo. I team che valutano questo approccio possono esaminare le tecniche di rilevamento delle anomalie con AI native per il data warehouse, incentrate sul monitoraggio appreso all'interno della piattaforma dati anziché solo su test statici.
Usate rilevatori diversi per compiti diversi. I vincoli intercettano gli stati non validi. I controlli statistici intercettano le variazioni visibili. Il ML aiuta a intercettare le anomalie silenziose che superano ogni regola e compromettono comunque le decisioni a valle.
Rendere operativi il monitoraggio delle anomalie e gli alert
Il rilevamento senza processi operativi diventa rumore. Spesso i team non falliscono perché mancano gli alert. Falliscono perché nessuno si fida degli alert abbastanza da agire rapidamente.
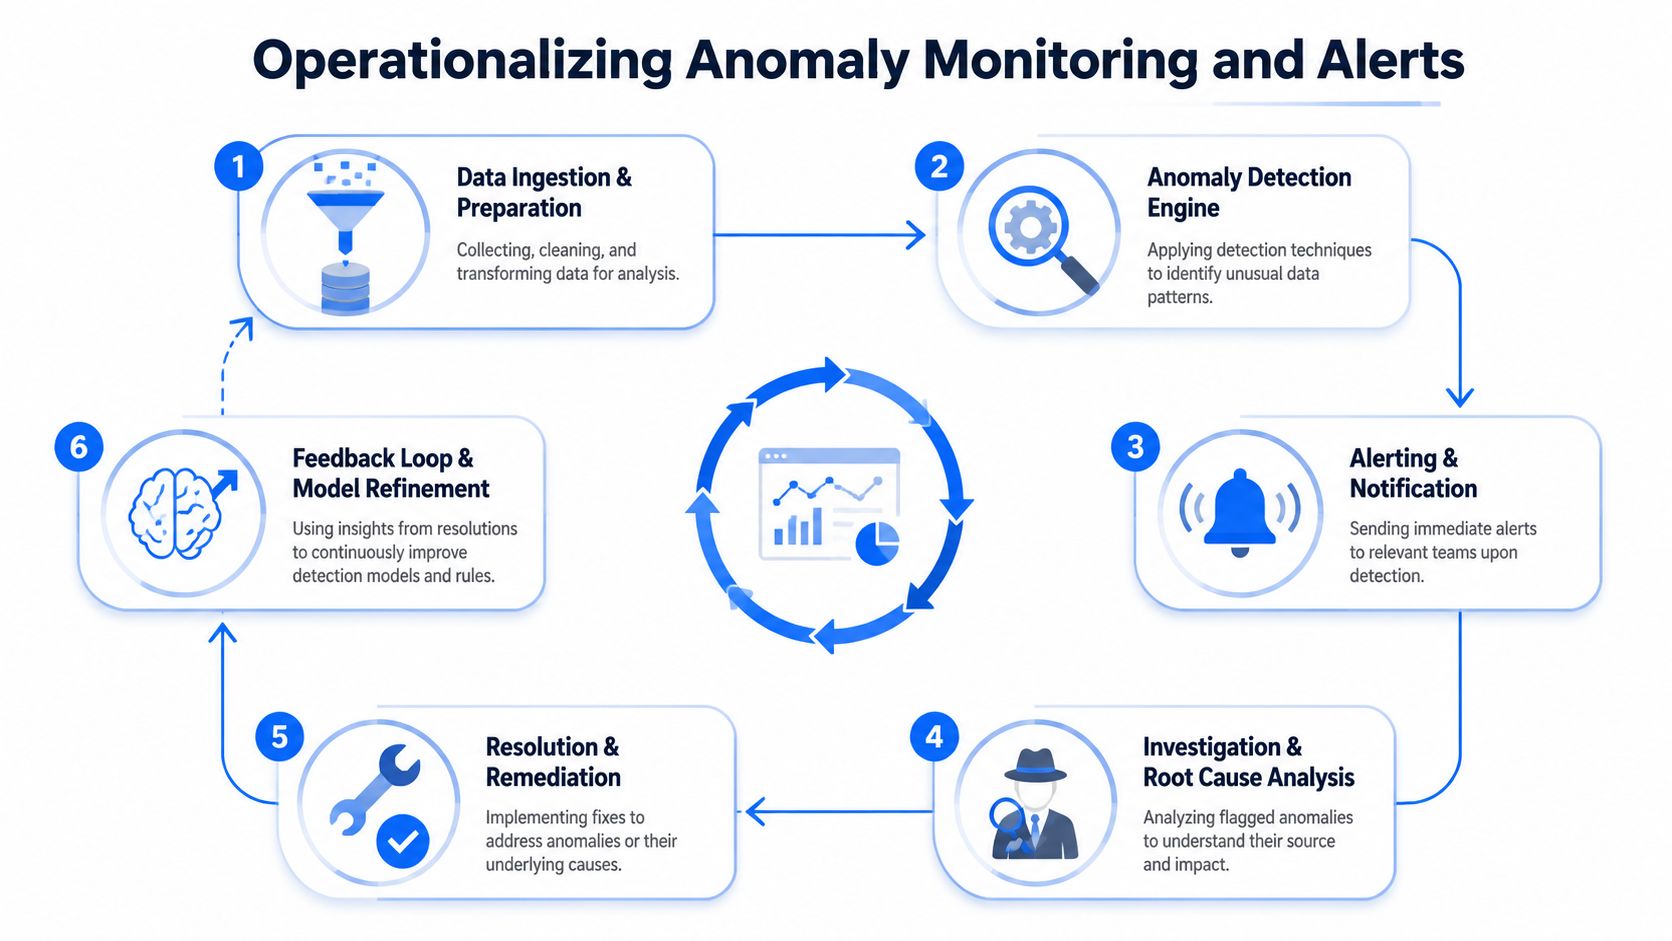
Costruite un percorso di alerting di cui le persone si fidino davvero
Una configurazione di monitoraggio efficace parte dalla ownership, non dagli strumenti. Ogni dataset critico, tabella di feature e flusso di dashboard ha bisogno di un team responsabile chiaro e di una definizione chiara di cosa significhi “anomalo”.
Il modello ingegneristico che funziona è più mirato di quanto molte organizzazioni si aspettino:
Date priorità alle tabelle critiche per il business. Partite dai dataset che alimentano dashboard direzionali, fatturazione, reporting regolamentato o modelli in produzione.
Monitorate più dimensioni. Anomalie nei valori, tempestività, comportamento dello schema ed errori di validazione vanno trattati come segnali distinti.
Usate baseline dinamiche dove il comportamento cambia. Le soglie statiche vanno bene per i limiti rigidi. Sono deboli per le metriche cicliche.
Instradate gli alert per dominio. Il team responsabile del sistema sorgente dovrebbe vedere per primo le anomalie della sorgente. I consumatori dovrebbero vedere gli alert d'impatto.
Eliminate i duplicati. Un unico problema di fondo non dovrebbe generare dieci incidenti scollegati.
Una breve checklist aiuta a mantenere alta la qualità degli alert:
Rendete gli alert spiegabili: includete il dataset interessato, la finestra temporale, la metrica e lo scostamento osservato.
Distinguete il sintomo dalla sorgente: indicate se il problema compare in ingestione, trasformazione, schema o output finale.
Aggiungete contesto: mostrate la storia recente, così che un ingegnere possa capire se si tratta di un picco, un calo, un ritardo o una rottura di trend.
Privilegiate l'azionabilità: se l'alert non indica un responsabile chiaro o un passo successivo, perfezionatelo prima di estenderlo.
Usate un workflow di risposta invece del debugging improvvisato
Il processo di risoluzione dovrebbe essere standardizzato. Il processo di risoluzione delle anomalie segue una sequenza standardizzata: registrare l'anomalia con i relativi metadati, consultare gli stakeholder per confermare la logica di business, validare il problema in ambienti di staging, distribuire correzioni retrocompatibili con piani di rollback e documentare le soluzioni per evitare che il problema si ripresenti (panoramica di Gable sui workflow di risoluzione delle anomalie).
Questa sequenza conta perché previene un errore comune. Un ingegnere vede un picco, corregge una trasformazione a valle e chiude il problema senza verificare se la sorgente a monte sia cambiata intenzionalmente. La metrica si riprende temporaneamente, ma la causa di fondo sopravvive.
Ho visto team migliorare la qualità degli alert trattando la gestione delle anomalie come una risposta agli incidenti anziché come manutenzione delle dashboard. Quando gli alert includono metadati, ownership, validazione in staging e pianificazione del rollback, le persone smettono di discutere se l'anomalia sia “reale” e iniziano a tracciarla.
Nota dal campo: se la vostra prima reazione a un'anomalia è aprire l'SQL e cambiare la logica, probabilmente state andando troppo veloci. Confermate prima l'aspettativa di business.
Dal rilevamento alla risoluzione: pattern di analisi delle cause
Quando scatta un'anomalia, il lavoro cambia. Il rilevamento chiede: “È insolito?”. L'analisi delle cause chiede: “Che cosa è cambiato, dove, e doveva succedere?”.
I team più rapidi non indagano a caso. Seguono pattern ricorrenti basati su come le anomalie si propagano di solito.
Pattern uno: tracciate la lineage prima di toccare il codice
Per le anomalie contestuali, la lineage è spesso la strada più breve verso la verità. La tendenza emergente è l'integrazione di un rilevamento delle anomalie consapevole dei metadati, che risale la lineage a monte per trovare la vera origine, riducendo i tempi di analisi delle cause del 60%: una capacità essenziale per le anomalie contestuali, dove i metodi statistici standard falliscono.
Questo conta perché la tabella che mostra l'anomalia spesso non è quella che la causa. Un data mart di reporting può mostrare un calo dei ricavi, mentre la vera rottura si trova in un job di ingestione a monte in ritardo o in una chiave di join modificata in un livello di staging.
Un'indagine pratica che parte dalla lineage spesso si presenta così:
Partite dall'asset interessato: riquadro della dashboard, tabella di servizio o set di feature del modello.
Risalite a monte una dipendenza alla volta: verificate freschezza, storico dello schema ed esecuzioni delle trasformazioni.
Fermatevi al primo confine anomalo: il primo punto in cui un input sano diventa un output non sano di solito contiene la causa.
Pattern due: distinguete gli eventi di business dai difetti dei dati
Non ogni picco è un dato errato. A volte l'anomalia è il business stesso.
Gli ingegneri sbagliano quando indagano solo dal lato del data warehouse. Se una metrica fa un balzo, ponetevi due domande in parallelo. Sono cambiati il codice o lo schema? Il business ha lanciato una promozione, un prodotto, migrato clienti o modificato un workflow? Entrambe le cose possono produrre la stessa forma del grafico.
Un modello mentale utile è classificare le evidenze in tre gruppi:
Tipo di evidenza | Cosa suggerisce |
|---|---|
Deployment, modifica di schema o della pipeline | Probabile difetto tecnico |
Evento esterno o azione di business | Il segnale reale potrebbe essere valido |
Nessun cambiamento evidente da nessuna parte | Cercate una dipendenza nascosta o un problema di tempestività |
Questa distinzione evita che i team “correggano” un segnale legittimo o ignorino una regressione tecnica che sembra plausibile dal punto di vista commerciale.
Trattate ogni anomalia come una questione sia di dati sia di business, finché uno dei due lati non viene escluso.
Pattern tre: verificate insieme struttura e tempistiche
I problemi di schema e di freschezza spesso viaggiano insieme. Un flusso che arriva in ritardo può attivare valori predefiniti, caricamenti parziali o trasformazioni a valle saltate. Una modifica di tipo può far sembrare normali le metriche di tempestività mentre i valori si degradano in modo sottile.
Quando indagate, abbinate questi controlli invece di eseguirli in modo isolato:
Controllo dello schema: colonne aggiunte o rimosse, modifiche di tipo, nullabilità cambiata, chiavi alterate.
Controllo delle tempistiche: consegna attesa rispetto all'arrivo effettivo, completamento parziale dei batch, comportamento dei retry.
Controllo dei valori: spostamenti della distribuzione, improvvise concentrazioni di valori nulli, squilibri tra categorie, join interrotti.
Gli ingegneri di livello intermedio spesso crescono più rapidamente quando smettono di vedere le anomalie come eventi isolati su un grafico e iniziano a leggerle come comportamento del sistema. L'anomalia nella metrica è solo l'indizio visibile. La causa di solito risiede nel contratto tra i sistemi, non nel grafico stesso.
Il vantaggio in-database: architettura e governance
Dal punto di vista architetturale, la gestione delle anomalie diventa più semplice quando il rilevamento viene eseguito vicino ai dati. Non è solo una preferenza di prestazioni. Cambia privacy, governance e carico operativo.

Perché l'osservabilità in-database cambia il modello operativo
Quando il monitoraggio richiede di esportare grandi dataset verso un servizio esterno, i team aggiungono spostamenti, duplicazioni e revisioni di governance a un problema che richiede già una diagnosi rapida. L'esecuzione in-database evita gran parte di questo attrito.
I principali vantaggi architetturali sono semplici:
Controllo della privacy: i dati di produzione sensibili restano nell'ambiente controllato dal cliente invece di essere copiati altrove per l'analisi.
Minori costi di spostamento: calcolate le metriche dove le tabelle si trovano già, invece di inviare i dati grezzi altrove.
Semplicità operativa: i data engineer lavorano con asset, permessi e pianificazioni nativi del data warehouse.
Governance più solida: è più facile allineare l'osservabilità ai controlli di accesso, ai requisiti di audit e alle aspettative di residenza dei dati.
Questo modello è particolarmente utile negli ambienti della finanza, della sanità, delle telecomunicazioni e del settore pubblico, dove ai team importa chi può esaminare i dati tanto quanto rilevare le anomalie.
Come una piattaforma unificata copre le classi reali di anomalie
Una buona architettura di osservabilità dovrebbe coprire entrambi i volti delle anomalie discussi in precedenza. Le salvaguardie strutturali restano compito della progettazione dello schema e delle regole di validazione. Il monitoraggio comportamentale spetta all'analisi continua di valori, tempistiche e struttura.
Ecco perché un approccio unificato è più utile di un insieme di controlli scollegati. Un esempio è digna, che esegue le analisi all'interno dei database del cliente e combina diverse funzionalità che corrispondono direttamente alle classi di anomalie più comuni:
Data Anomalies: baseline apprese per i cambiamenti comportamentali inattesi nelle tabelle configurate.
Timeliness: monitoraggio degli arrivi in ritardo o mancanti rispetto a pattern appresi e pianificazioni attese.
Schema Tracker: rilevamento di colonne aggiunte o rimosse e di modifiche dei tipi di dati.
Data Validation: applicazione di regole a livello di record per la logica di business e i requisiti di audit.
Data Analytics: metriche storiche di osservabilità per l'analisi dei trend e la definizione delle priorità.
Questo conta dal punto di vista della governance, perché i team possono esaminare variazioni dei trend, tempestività e modifiche strutturali in un'unica superficie operativa senza consegnare i dati di produzione a un fornitore. Conta anche dal punto di vista architetturale, perché la stessa piattaforma può supportare tabelle di data warehouse, dati di data lake ed ecosistemi di pipeline mantenendo l'analisi principale dove risiedono i dati.
Il vantaggio pratico non è che un unico strumento elimini magicamente ogni anomalia nei sistemi di database. È che il modello operativo diventa coerente. Gli ingegneri possono mantenere nel modello la classica igiene relazionale, usare la validazione dove il business conosce le regole e aggiungere un monitoraggio consapevole del comportamento per le classi di guasti che la normalizzazione non è mai stata pensata per intercettare.
Un'AI affidabile parte da un comportamento affidabile dei dati, non solo da schemi puliti. Se il vostro team ha bisogno di rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema e validazione in un ambiente controllato dal cliente, digna è un'opzione in-database da valutare.
Se le anomalie comportamentali descritte sopra sono il vostro rischio principale, guardate come digna Data Anomalies apprende le baseline per i cambiamenti inattesi direttamente all'interno del vostro database.
Domande frequenti
Quali sono le tre anomalie classiche nella progettazione dei database?
Sono le anomalie di inserimento, di aggiornamento e di cancellazione. Un'anomalia di inserimento impedisce di aggiungere una riga senza dati non correlati, un'anomalia di aggiornamento obbliga a ripetere una modifica di business su molte righe e un'anomalia di cancellazione elimina fatti di cui il business ha ancora bisogno, come lo storico di un prodotto che scompare quando viene cancellata l'ultima riga di vendita.
In che cosa un'anomalia dei dati moderna differisce da un'anomalia relazionale?
Le anomalie moderne compromettono l'affidabilità delle conclusioni più che l'integrità dei dati memorizzati. Schema, chiavi e vincoli possono essere tutti rispettati mentre una metrica subisce una deriva, una sorgente arriva con sei ore di ritardo o il tipo o il pattern di valori nulli di una colonna cambia. La prima risposta migliore è monitorare pattern, lineage, contratti e tempi di consegna, non riprogettare le tabelle.
Perché i controlli basati su regole non bastano a rilevare le anomalie del database?
Le regole intercettano solo le modalità di guasto già note. Conteggi di righe, controlli sui valori nulli e valori ammessi proteggono le invarianti conosciute, ma sono deboli contro deriva graduale, stagionalità mutevole, arrivi in ritardo e interazioni tra sorgenti. L'articolo raccomanda vincoli per i guasti netti, Z-score o controlli IQR per uno screening rapido e baseline apprese per i comportamenti che cambiano.
Quali metodi di machine learning si usano per il rilevamento delle anomalie nei database?
L'articolo evidenzia gli Isolation Forest per record o periodi insoliti, i modelli LSTM per le serie temporali in cui le medie mobili causano falsi allarmi, i metodi k-NN e Naive Bayes per relazioni di vicinato o probabilistiche e il rilevamento non supervisionato quando le anomalie etichettate scarseggiano. Il compromesso è operativo: calibrazione, decisioni sul riaddestramento e una ownership chiara.
Come si trova la causa di un'anomalia dei dati?
Partite dall'asset interessato e risalite a monte una dipendenza alla volta, verificando freschezza, storico dello schema ed esecuzioni delle trasformazioni fino a raggiungere il primo confine anomalo. In parallelo, chiedetevi se un deployment o un evento di business come una promozione spieghi il cambiamento, e abbinate controlli su schema, tempistiche e valori.


