Analisi dei trend dei dati: una guida pratica per il 2026
|
7
min di lettura

Una dashboard mostra una linea ascendente pulita. Il fatturato sembra in crescita, l'utilizzo appare sano e la revisione settimanale si fa ottimista. Poi qualcuno controlla i log della pipeline e trova un caricamento duplicato, uno schema modificato o un batch arrivato in ritardo che ha fatto sembrare reale un trend che non lo era.
Questa situazione è abbastanza comune da rendere impossibile trattare l'analisi dei trend dei dati come un semplice esercizio di creazione di grafici. Se i dati sottostanti sono instabili, anche il trend è instabile. Ai team non servono solo metodi per individuare i movimenti nel tempo. Serve un modo per verificare che il movimento derivi dal business e non dalla pipeline.
La maggior parte delle guide salta questa distinzione. Spiegano smoothing, forecasting e anomaly detection come se i dati fossero già affidabili. Nella pratica, l'analisi dei trend inizia prima. Inizia con la validazione dei record, il monitoraggio della struttura e la verifica della tempestività, prima che chiunque interpreti una linea.
Indice
Perché l'analisi dei trend dei dati spesso fallisce
Un'analisi dei trend fallita di solito inizia con una storia credibile. Gli ordini aumentano dopo una campagna. Il churn cala dopo il rilascio di un prodotto. Il volume di richieste al supporto diminuisce dopo una modifica a un workflow. Il grafico corrisponde alla narrazione che le persone vogliono sentire, quindi nessuno mette in discussione gli input con sufficiente rigore.
Il problema non è l'idea di analisi dei trend. Il problema è che i team spesso la eseguono su dati di cui non è stata dimostrata la stabilità. Un job di ingestione duplicato può creare un falso picco. Un tipo di colonna modificato può azzerare una metrica senza che nessuno se ne accorga. Un caricamento in ritardo può far sembrare un crollo un'attività del tutto normale per mezza giornata.
La modalità di errore nascosta
L'analisi dei trend dei dati dovrebbe rispondere a una domanda legata al tempo con una disciplina statistica e operativa sufficiente perché la risposta regga a un esame approfondito. Ciò significa molto più che tracciare punti nel tempo. Significa separare il movimento reale dalla stagionalità, dalla variazione casuale e dai difetti della pipeline.
Regola pratica: se non sapete spiegare se una variazione deriva dal comportamento del business, dall'arrivo dei dati o da una modifica dello schema, non avete ancora un insight sul trend. Avete un segnale irrisolto.
Le organizzazioni stanno investendo molto nei sistemi che supportano questo lavoro. Il mercato globale della big data analytics ha raggiunto 41,05 miliardi di USD nel 2022 e si prevede che arrivi a 279,31 miliardi di USD entro il 2030, con un CAGR del 27,3% secondo le proiezioni sul mercato della big data analytics. Questa crescita chiarisce una cosa: l'analisi dei trend è ormai un'infrastruttura operativa centrale, non un'attività marginale per specialisti.
Perché i team interpretano male i grafici
Alcuni schemi si ripetono di continuo:
Si fidano troppo presto delle dashboard. Un grafico viene esaminato prima che qualcuno verifichi freschezza, completezza o modifiche strutturali.
Confondono la visibilità con la validità. Vedere una metrica nella BI non significa che la metrica sia corretta.
Danno troppo peso al contesto di business. Se la linea si adatta alla storia attesa, i team smettono di chiedersi se sia stata la pipeline dei dati a introdurre il cambiamento.
Molti programmi di qualità falliscono per ragioni strutturali ben prima della fase di analisi. Questo cedimento è ben descritto in tre correzioni strutturali per le iniziative di data quality che falliscono, in particolare il punto secondo cui i controlli devono essere integrati nei workflow operativi, non aggiunti dopo che il danno si è manifestato.
Comprendere i concetti fondamentali
L'analisi dei trend diventa più semplice quando si smette di considerare un grafico a linee come un'unica cosa. Non lo è. Una serie temporale è di solito un insieme di più forze sovrapposte.

Che cosa contiene davvero un trend
Usate un'analogia semplice. Pensate all'affluenza giornaliera in una caffetteria.
Il livello è la baseline generale. Se la caffetteria serve abitualmente un flusso costante di clienti ogni giorno, quello è il punto di partenza. Il trend è il movimento più lungo nel tempo, come un aumento graduale man mano che il quartiere cresce. La stagionalità è lo schema ricorrente, come i picchi dei pendolari nei giorni feriali, il brunch del fine settimana o i rallentamenti durante le festività. Il rumore è tutto ciò che è disordinato e di breve durata, come un martedì piovoso o un evento locale che cambia l'andamento di un solo giorno.
Questa scomposizione è importante perché ogni componente richiede una risposta diversa. Uno spostamento di livello può indicare un problema nella pipeline o un reale cambiamento operativo. La stagionalità di solito va modellata, non indagata come un incidente. Il rumore va tollerato, a meno che non persista.
Per i team che lavorano con dati di campagne, web o attribuzione, questa guida agli insight di marketing azionabili è utile perché ancora l'analisi a domande operative invece di trattare le metriche come un output astratto.
Reporting e analisi a confronto
Il semplice reporting risponde alla domanda: "Che cosa è successo oggi?". L'analisi dei trend risponde a: "Che cosa sta cambiando nel tempo, e il cambiamento è reale?".
Ecco la differenza nella pratica:
Approccio | Domanda di esempio | Output tipico | Limite principale |
|---|---|---|---|
Reporting | Quanti visitatori abbiamo avuto oggi? | Un KPI puntuale | Non tiene conto di schemi ricorrenti né di difetti nei dati |
Analisi dei trend | Il traffico medio sta aumentando dopo aver corretto per i cicli settimanali e i giorni anomali? | Direzione, intensità e grado di confidenza del movimento | Richiede una preparazione e una validazione dei dati più rigorose |
Un team può riportare i totali di ieri da una dashboard di BI in pochi minuti. Un'analisi dei trend dei dati fatta bene richiede più attenzione, perché si sta facendo un'inferenza, non semplicemente mostrando un valore.
Un trend non è "più di ieri". Un trend è una direzione persistente dopo aver tenuto conto di cadenza, contesto e dati errati.
Quando i team faticano con questa distinzione, spesso hanno bisogno di un modello mentale più solido della qualità delle serie temporali in sé. A questo scopo è utile l'analisi delle serie temporali per schemi nascosti e data quality, che inquadra il lavoro sui trend come un problema congiunto di rilevamento degli schemi e di fiducia nei dati.
Metodi per rilevare i trend
Un metodo di analisi dei trend vale quanto i dati che lo alimentano. Se i timestamp degli eventi si spostano, i record arrivano in ritardo o la definizione di una metrica è cambiata la settimana scorsa, il metodo produrrà comunque una linea. Ma quella linea potrebbe essere sbagliata.
Ecco perché la scelta del metodo parte dalle modalità di errore nei dati, non dalla sofisticazione del modello. Scegliete una tecnica in base a due domande: quale schema state cercando di rilevare e quali difetti nei dati potrebbero imitarlo?

In cosa eccellono i metodi semplici
I metodi statistici tradizionali sostengono ancora gran parte del lavoro in produzione, perché sono interpretabili, rapidi da implementare e facili da mettere in discussione quando qualcosa non torna.
Le medie mobili riducono il rumore giornaliero e rendono più leggibili le dashboard operative. Funzionano bene per avere visibilità sulla baseline, ma reagiscono in ritardo ai cambiamenti reali. Se un feed presenta arrivi tardivi intermittenti, una media mobile può trasformare il difetto in una falsa ripresa o in un falso calo.
La regressione lineare offre una sintesi chiara della direzione quando la serie è abbastanza stabile da rendere valida questa ipotesi. Molte metriche operative non lo sono. Presentano intervalli mancanti, salti dovuti ai deployment, backfill e outlier causati dal comportamento dei sistemi anziché da quello del business. In questi casi, la pendenza può essere tecnicamente corretta e operativamente fuorviante.
Lo smoothing esponenziale attribuisce più peso alle osservazioni recenti, il che è utile quando i dati più recenti devono contare più di quelli meno recenti. Spesso è più adatto di una semplice media per monitorare l'attività recente, ma presuppone comunque che la serie in ingresso sia abbastanza coerente da poter essere smussata, anziché strutturalmente compromessa.
Negli ambienti fortemente orientati all'osservabilità, la somma cumulativa (CuSum) è spesso uno strumento di allerta precoce migliore rispetto a un alert basato su soglia. Snowflake descrive la CuSum nell'analisi dei trend come un modo per aggregare piccole deviazioni da una baseline, così che una deriva lenta diventi visibile prima di trasformarsi in un picco o in un calo evidente.
La CuSum è adatta alle metriche che si degradano gradualmente, come i tassi di fallimento delle validazioni, la latenza di ingestione o la perdita parziale di dati nella pipeline. Piccole variazioni giornaliere possono accumularsi per giorni prima che scatti una soglia della dashboard.
Dove i metodi avanzati dimostrano il loro valore
I metodi avanzati sono utili quando la serie ha una struttura reale che un semplice smoothing appiattirebbe o non coglierebbe.
La scomposizione stagionale separa gli schemi ricorrenti dalla direzione di fondo. È utile per dati di traffico, domanda e utilizzo con forti cicli settimanali o mensili. È meno utile se gli effetti di calendario sono incoerenti perché le scadenze di reporting o i ritardi delle fonti si spostano.
I modelli di tipo ARIMA sono utili quando la storia recente influenza fortemente il futuro prossimo e l'autocorrelazione è rilevante. Possono essere efficaci per serie operative stabili, ma richiedono più disciplina di quanto molti team si aspettino in termini di stazionarietà, tuning dei parametri e riaddestramento.
Gli approcci neurali e di machine learning in generale possono modellare comportamenti non lineari su molte metriche contemporaneamente. Il compromesso è la manutenzione. Richiedono dati di addestramento più puliti, regole di riaddestramento più chiare e un monitoraggio più solido, perché possono apprendere l'instabilità delle fonti come se fosse un reale schema di business.
Per i dati operativi asimmetrici, la regressione quantilica è spesso più informativa dei metodi basati sulla media. Mostra se le code della distribuzione stanno cambiando anche quando la mediana appare stabile. Questo è importante per i tempi di esecuzione delle pipeline, i ritardi di consegna e i tassi di difettosità, dove è la fascia peggiore degli eventi a determinare l'impatto sugli utenti. Le indicazioni su questo metodo sono state citate in precedenza, quindi rimando a quel riferimento invece di ripetere qui la stessa fonte.
Per chi vuole confrontare opzioni di modellazione più ampie, questa panoramica delle tecniche di analisi dei dati è un utile complemento, perché colloca i metodi per i trend accanto agli approcci diagnostici e predittivi.
Scegliere il metodo in base al rischio sui dati
La scelta del metodo dovrebbe corrispondere al tipo di errore che potete tollerare.
Usate le medie mobili o lo smoothing esponenziale quando l'obiettivo è un monitoraggio leggibile e vi fidate della definizione della metrica e del modello di arrivo dei dati.
Usate la regressione quando vi serve una sintesi difendibile della direzione e la serie è già stata controllata per outlier, lacune e rotture strutturali.
Usate la CuSum quando la deriva lenta conta più dei picchi improvvisi.
Usate metodi basati sui quantili quando le medie nascondono i problemi operativi nella coda della distribuzione.
Usate rilevatori automatici quando vi serve copertura su molte tabelle, colonne e metriche contemporaneamente.
In produzione, i team di solito combinano questi metodi. Una semplice linea di trend supporta la comunicazione. Un test statistico più robusto supporta l'indagine. Un livello di osservabilità verifica innanzitutto se il segnale può essere interpretato in sicurezza. Gli strumenti progettati per l'anomaly detection automatizzata per le data operations aiutano a scalare questo approccio monitorando continuamente molte metriche e facendo emergere le variazioni che meritano un'analisi più approfondita del trend.
Un workflow pratico per l'analisi dei trend
Alle 9:00 la dashboard mostra un calo netto delle registrazioni. Alle 9:20 il team di prodotto pensa che un rilascio abbia compromesso la conversione. Alle 10:00 si scopre che il vero problema è una pipeline in ritardo e una modifica silenziosa dello schema nello stream di eventi. Questa sequenza è comune. L'analisi dei trend fallisce meno spesso perché i team hanno scelto il modello sbagliato e più spesso perché si sono fidati di input instabili.
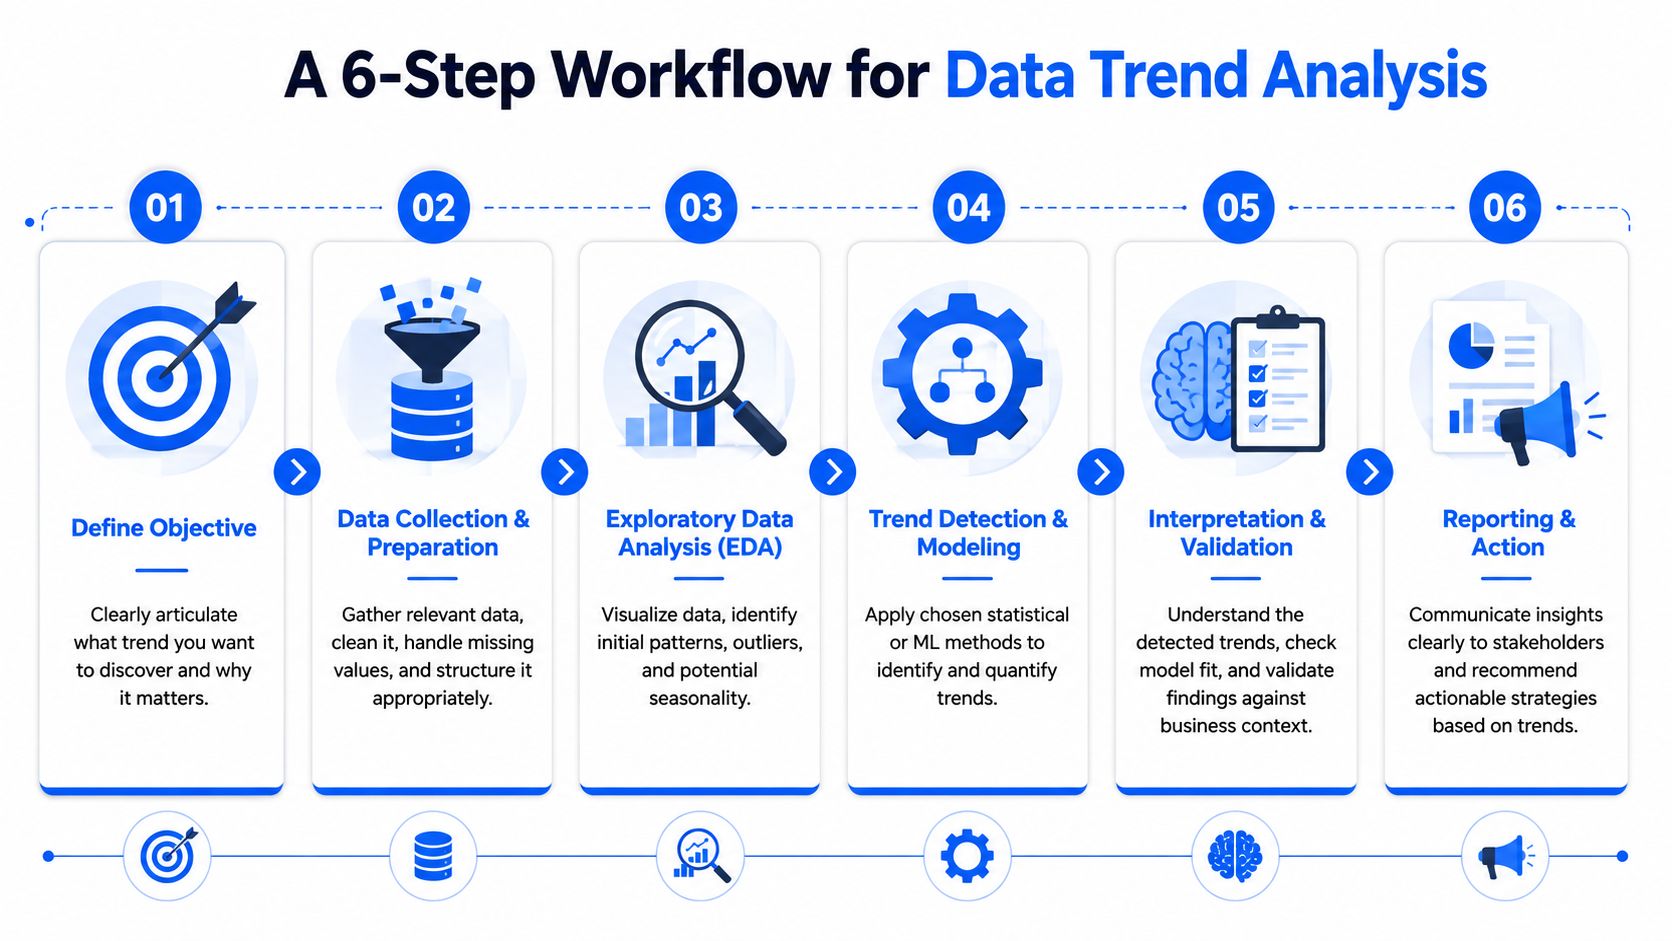
Il workflow che regge in produzione parte dalla validità dei dati, non dai grafici. Offre agli analisti una baseline che possono difendere e agli ingegneri un percorso rapido da un movimento sospetto alla modifica di sistema che lo ha causato.
Partire dalla validità, non dalla modellazione
Definite la domanda in termini che la pipeline sia in grado di supportare. "Le registrazioni dei clienti stanno aumentando?" è troppo vaga per essere verificata bene. "La baseline giornaliera delle registrazioni si sta spostando dopo aver tenuto conto della stagionalità dei giorni feriali, del ritardo di attribuzione e dei ritardi di ingestione noti?" è abbastanza specifica da poter essere validata.
Poi verificate se i dati di origine possono essere interpretati in sicurezza. Io cerco innanzitutto tre modalità di errore:
Validità dei record. Le righe soddisfano ancora le regole di business alla base della metrica?
Stabilità dello schema. Un campo è scomparso, ha cambiato tipo o ha iniziato ad avere un significato diverso?
Tempestività. I dati sono arrivati entro la loro normale finestra di latenza?
Se uno di questi controlli fallisce, interrompete la lettura del trend e contrassegnate la serie come non affidabile. Un grafico pulito costruito su dati tardivi, parziali o ridefiniti genera una falsa sicurezza.
Più avanti nel workflow, le video guide possono aiutare i team a standardizzare questo processo tra i ruoli di engineering e analytics:
Costruire una baseline di cui le operations possano fidarsi
Una volta che gli input hanno superato la validazione, stabilite una baseline per il comportamento normale. In pratica, ciò significa scegliere una finestra storica che rifletta le operations attuali, separare gli schemi ricorrenti dalla deriva reale e definire quale intervallo di variazione sia ancora accettabile.
Una singola media raramente è sufficiente. Nasconde proprio i problemi che emergono per primi nei sistemi complessi, soprattutto quando ritardi o guasti parziali colpiscono solo una parte della distribuzione. Negli ambienti volatili preferisco metodi che esaminano la distribuzione, non solo il centro. Le baseline basate sui quantili sono utili in questo caso, perché possono mostrare che i job di ingestione più lenti, i tempi di elaborazione più lunghi o le transazioni di valore più elevato stanno peggiorando anche quando la media appare ancora stabile.
Questo è importante durante le migrazioni di schema e gli incidenti di consegna. Un trend della media può restare piatto mentre la latenza ai percentili superiori, i tassi di valori nulli o le discrepanze di riconciliazione peggiorano. Il problema non è il metodo. È il benchmark a essere troppo grossolano per le condizioni operative.
Indagare le variazioni con evidenze
Una volta rilevata una variazione, l'indagine dovrebbe restringersi rapidamente e seguire il sistema nell'ordine in cui può guastarsi.
Iniziate dai tempi della pipeline. I dati arrivati in ritardo spiegano molti cali e recuperi apparenti. Poi esaminate le modifiche strutturali, come colonne rinominate, payload degli eventi modificati o join cambiati. Successivamente, rivedete le regole di qualità a livello di record per individuare vincoli violati, valori mancanti, eventi duplicati o stati non validi. Solo quando questi controlli sono superati il team dovrebbe trattare il cambiamento come un trend di business.
Questo ordine fa risparmiare tempo perché rispecchia il modo in cui le metriche di produzione si rompono. I team commerciali spesso chiedono prima un'interpretazione. I team di engineering spesso partono dai log. Una pratica migliore è collegare metrica, pipeline e controlli di qualità in un unico percorso di indagine.
Gli strumenti di osservabilità integrati aiutano perché l'analista non deve saltare tra query sul data warehouse, log dell'orchestratore, report di validazione e dashboard di BI. digna ne è un esempio. Combina anomaly detection, analisi storica, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema, eseguendo l'analisi all'interno dell'ambiente di database del cliente.
La revisione di un incidente è più rapida quando il trend, il ritardo e l'evento di schema sono visibili insieme.
Visualizzare e comunicare i trend
Anche un'analisi solida fallisce se il grafico risponde alla domanda sbagliata. Uno stakeholder non ha bisogno di ogni componente della scomposizione né di ogni dettaglio del modello. Ha bisogno della giusta evidenza visiva per la decisione che deve prendere.
Abbinare il grafico alla domanda
Usate un grafico a linee quando il punto principale è la direzione nel tempo. È la scelta predefinita per un motivo: le persone colgono rapidamente pendenza, punti di inflessione e cambiamenti duraturi. Ma i grafici a linee sono deboli quando la storia principale è concentrata in fasce orarie specifiche o in cicli ricorrenti.
Usate una heatmap quando la stagionalità è rilevante. Se una metrica si comporta in modo diverso a seconda dell'ora, del giorno della settimana o del mese, una heatmap mostra gli schemi ricorrenti più rapidamente di una serie di grafici a linee. È particolarmente utile per le viste su tempestività e latenza, dove contano le finestre operative.
Usate i small multiples quando vi serve un confronto senza sovrapposizioni. Più entità su un unico grafico diventano spesso un groviglio. Pannelli separati preservano la forma e permettono ai lettori di confrontare i trend senza dover indovinare quale linea appartenga a quale fonte.
Usate le annotazioni senza risparmio. Se una variazione coincide con un deployment, una revisione dello schema o un ritardo, segnalatelo. Le persone interpretano i grafici privi di annotazioni con troppa libertà.
Progettare per il pubblico che utilizza il trend
I colleghi tecnici di solito vogliono incertezza, diagnostica e contesto. Gli stakeholder di business di solito vogliono rilevanza, causa probabile e azione richiesta.
Una struttura utile per il passaggio di consegne è:
Indicare il segnale. Che cosa è cambiato, in linguaggio semplice.
Indicare il grado di confidenza. È stabile, emergente o in fase di revisione per dubbi sulla qualità degli input?
Indicare il fattore probabile. Evento di business, problema di tempestività, validazione fallita o modifica strutturale.
Indicare l'azione. Monitorare, indagare o decidere.
Un grafico dovrebbe ridurre le discussioni, non crearne di nuove.
I team risparmiano fatica anche quando non costruiscono ogni visualizzazione da zero. Le interfacce di osservabilità unificate aiutano perché organizzano già anomalie, viste dei trend, segnali di tempestività e indicatori di salute attorno all'indagine operativa anziché al reporting statico.
Governare l'analisi dei trend per evitare gli errori comuni
Lunedì mattina. Il fatturato è in calo del 18 percento nella dashboard settimanale, Slack è pieno di messaggi di escalation e la prima domanda nella riunione del management è se la domanda si sia indebolita. Un'ora dopo, la causa principale risulta essere un batch in ritardo e una modifica silenziosa nella mappatura di un campo.
Questo scenario è comune perché la governance di solito inizia dopo che qualcuno ha notato un grafico sbagliato. Un'analisi dei trend affidabile inizia prima. Prima che qualcuno interpreti una pendenza, il team ha bisogno di evidenze che gli input siano completi, aggiornati e strutturalmente coerenti.
La prima domanda di governance
La prima domanda di governance non è se un trend sia statisticamente significativo. È se i dati sottostanti fossero adatti all'analisi nel momento in cui il trend è stato prodotto.
Sembra banale, ma cambia il modo in cui i team operano. Se la freschezza della fonte non era garantita, se i tassi di valori nulli sono aumentati dopo un deployment o se un join ha iniziato a scartare record, il risultato del trend va trattato come un'evidenza condizionata, non come un insight pronto per le decisioni. Ho visto team passare giorni a spiegare un cambiamento di mercato che si è poi rivelato un difetto di ingestione.
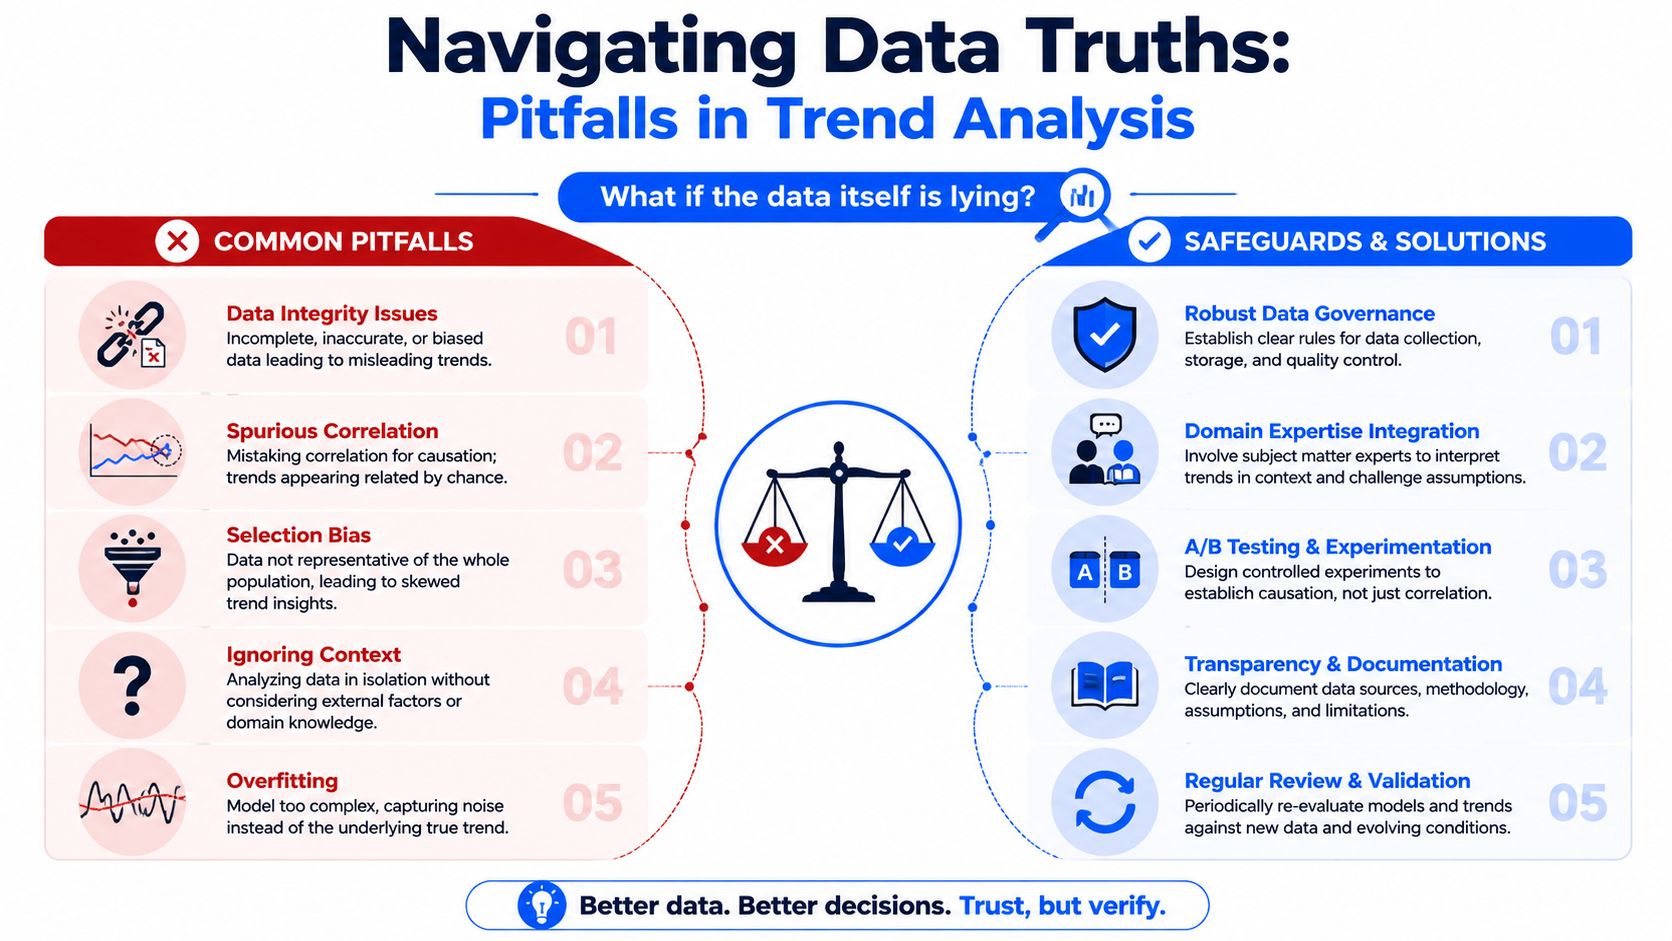
L'analisi dei trend fallisce in modi prevedibili quando la governance è debole. Di solito il problema non sono i metodi. Il controllo mancante è un punto di approvazione tra la produzione dei dati e la loro interpretazione.
Controlli che impediscono ai dati errati di diventare un falso trend
Un modello di governance funzionante è operativo. Definisce che cosa deve essere superato prima che un grafico, una metrica o l'output di un modello sia considerato affidabile.
Errore | Come si manifesta | Controllo di governance |
|---|---|---|
Difetto della pipeline scambiato per movimento del business | Picco o calo netto senza alcun evento di business corrispondente | Bloccare la pubblicazione finché i controlli su freschezza, volume e numero di righe non sono superati |
Modifica strutturale nascosta in una metrica apparentemente valida | Il trend cambia dopo la ridenominazione di un campo, un cambio di tipo o un nuovo valore enum | Tracciare le modifiche dello schema e associarle a dataset, dashboard e modelli interessati |
Stagionalità regolare trattata come un incidente | I team aprono indagini ogni fine settimana o a ogni fine mese | Mantenere baseline per ora, giorno della settimana, mese o altro ciclo operativo noto |
Correlazione presentata come causa | Due metriche si muovono insieme e il report lascia intendere un rapporto di causalità | Richiedere una revisione di dominio, evidenze sperimentali o una motivazione causale documentata |
Medie stabili che mascherano guasti localizzati | La media resta piatta mentre una regione, una fascia di clienti o un segmento della coda lunga peggiora | Esaminare le distribuzioni e i trend segmentati prima dell'approvazione |
Questi controlli sono semplici da descrivere e più difficili da far rispettare. Ed è proprio farli rispettare il punto.
Cosa dovrebbe richiedere la governance prima di interpretare un trend
Usate una checklist pre-analisi che i sistemi possano valutare automaticamente:
Stato della validazione: le regole obbligatorie a livello di record sono state superate, altrimenti l'output viene etichettato come non affidabile.
Stato della freschezza: le tabelle di origine sono arrivate entro la finestra prevista per il periodo di reporting.
Stato dello schema: nessuna modifica strutturale non revisionata ha interessato i campi utilizzati nella metrica.
Stato della completezza: numero di righe, tassi di valori nulli e copertura delle chiavi sono rimasti entro la tolleranza.
Stato del contesto: incidenti noti, backfill ed eventi di business sono allegati al record dell'analisi.
La data observability diventa parte dell'analisi dei trend anziché una pratica di igiene della piattaforma a sé stante. Se i segnali di osservabilità si trovano in uno strumento separato che gli analisti non consultano mai, la governance esiste sulla carta e fallisce nella pratica. L'interfaccia di revisione dei trend deve mostrare freschezza, cronologia dello schema, validazioni fallite e contesto delle anomalie accanto alla metrica stessa.
Definire le responsabilità prima che si verifichino incidenti
La governance cede più rapidamente nei punti di passaggio di consegne. Il data engineering presume che l'analytics individuerà gli input errati. L'analytics presume che il team di piattaforma monitori la qualità delle fonti. Il prodotto o la finanza presumono che il responsabile della dashboard abbia verificato tutto a monte.
Assegnate responsabilità esplicite per quattro decisioni:
chi definisce le regole di qualità per ogni metrica di origine
chi approva le modifiche alla baseline
chi può pubblicare un trend con eccezioni di qualità note
chi indaga quando un trend e un segnale di qualità divergono
Senza questo modello, ogni incidente diventa un problema di smistamento.
Mantenere onesti i risultati
Una buona governance non sopprime l'analisi. Le attribuisce un grado di confidenza.
Una policy pratica consiste nel classificare i risultati dei trend come affidabili, provvisori o bloccati. Affidabile significa che i controlli di qualità sono stati superati e che non ci sono problemi strutturali irrisolti. Provvisorio significa che il segnale potrebbe essere reale, ma una o più condizioni degli input devono essere riesaminate. Bloccato significa che i dati non hanno superato i controlli obbligatori e non dovrebbero ancora supportare decisioni.
Questa disciplina previene una modalità di errore ben nota. Un grafico sembra pulito, viene copiato in una presentazione di pianificazione e acquisisce più autorevolezza di quanta la pipeline sottostante si sia mai guadagnata.
Conclusione: mettere insieme tutti i pezzi
Un'analisi dei trend dei dati affidabile non è principalmente una questione di scelta dell'algoritmo. È un modello operativo.
La sequenza che funziona è coerente. Validate prima i record e la struttura. Verificate la tempestività. Stabilite una baseline che rifletta il comportamento reale anziché una media semplicistica. Rilevate le variazioni con metodi adatti alla modalità di errore. Poi indagate il segnale con un contesto operativo sufficiente a distinguere un cambiamento del business da un cambiamento dei dati.
I team che saltano questi passaggi finiscono di solito per discutere sui grafici invece di risolvere i problemi. I team che li integrano nel workflow possono muoversi più velocemente, perché si fidano prima delle evidenze.
Il cambiamento pratico consiste nel trattare l'osservabilità e i controlli di qualità come parte dell'analisi, non come un lavoro di igiene separato. Quando rilevamento dei trend, consapevolezza dello schema, validazione e monitoraggio della tempestività convivono nella stessa pratica, l'organizzazione smette di reagire alle dashboard rotte e inizia a prendere decisioni su dati che si sono guadagnati la fiducia.
Se state costruendo un workflow di analisi dei trend incentrato sulla qualità, vale la pena valutare digna come opzione. Si concentra su data observability e data quality insieme, includendo anomaly detection, analisi storica, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema in ambienti controllati dal cliente.
Domande frequenti
Che cos'è l'analisi dei trend dei dati?
L'analisi dei trend dei dati è lo studio di come una metrica si muove nel tempo, separando la direzione di fondo dalla stagionalità e dal rumore, così da distinguere un cambiamento reale dalla normale variazione.
Perché l'analisi dei trend dei dati spesso fallisce?
Di solito perché un grafico viene letto anziché analizzato: una finestra breve viene scambiata per un trend, la stagionalità viene ignorata o una modifica nella pipeline dei dati viene interpretata come un cambiamento del business.
Quali metodi si usano per rilevare i trend?
Metodi semplici come le medie mobili e le regressioni lineari funzionano bene per le serie stabili. I metodi avanzati, tra cui la scomposizione e il machine learning, dimostrano il loro valore quando i dati presentano stagionalità, molteplici fattori trainanti o una raccolta irregolare.
Qual è il rapporto tra analisi dei trend e data quality?
Un trend è affidabile solo quanto i dati che lo alimentano. Un caricamento arrivato in ritardo o con righe perse produce un trend tecnicamente corretto e del tutto fuorviante: per questo il lavoro sui trend dovrebbe basarsi su dati monitorati.
Come si evitano i falsi trend?
Confrontate con lo stesso periodo dei cicli precedenti, mantenete una finestra abbastanza lunga da coprire la stagionalità e verificate che il dataset sottostante si sia comportato normalmente (volumi, tassi di valori nulli e freschezza) nel periodo analizzato.


