Affidabilità dei dati
|
6
min di lettura

Probabilmente vi state già confrontando con questa situazione. Una dashboard è sullo schermo, il management aspetta una risposta e qualcuno dice: “Questi numeri non mi convincono”. La riunione smette di riguardare la strategia e si trasforma in un'indagine forense. Quale tabella è stata caricata in ritardo? L'esportazione dal CRM ha perso dei record? Una modifica dello schema ha rotto una trasformazione tre livelli più a monte?
Quel momento è ciò che l'affidabilità dei dati rappresenta nella pratica. Non un punteggio di qualità astratto. Non uno slogan di governance. È la possibilità per le persone di agire senza mettere in dubbio le evidenze che hanno davanti.
Di solito i team avvertono questo problema prima nei contesti più ordinari: aggregazioni della pipeline commerciale, reporting di chiusura contabile, feed di inventario, product analytics e feature di machine learning. Anche il lavoro di estrazione di routine può creare lacune di fiducia se nessuno verifica che cosa è uscito dal sistema di origine e che cosa è arrivato a valle. Per i team che stanno sistemando fragili estrazioni dal CRM, la guida all'esportazione SFDC di Tutorial AI è un riferimento pratico, perché le meccaniche di esportazione sono spesso all'origine di problemi di affidabilità più grandi. Il lato di business di questi guasti è ben trattato in questa analisi su scarsa qualità dei dati e decisioni di business.
Indice
Definire l'affidabilità dei dati al di là delle parole d'ordine
Come i dati buoni diventano cattivi: le modalità di guasto più comuni
Perché le vostre decisioni valgono quanto i vostri dati
Un numero sbagliato raramente si annuncia in modo chiaro. Più spesso si manifesta come esitazione. Il marketing vede un calo che le vendite non sanno spiegare. La finanza chiede perché i totali di ieri sono cambiati stamattina. Il team di prodotto nota un picco di utilizzo che scompare dopo una nuova esecuzione. Nessuno si fida della prima risposta, quindi tutti chiedono una seconda estrazione, un backfill o un controllo su foglio di calcolo.
Questa incertezza costa più dell'errore stesso. Rallenta le approvazioni, ritarda i lanci e insegna ai team a conservare copie ombra dei dati “affidabili” al di fuori della piattaforma. Una volta che questo comportamento prende piede, ogni metrica diventa negoziabile.
La posta in gioco non riguarda solo il reporting aziendale. Una valutazione del 2020 sui dati COVID-19 di 202 paesi ha rivelato che circa il 69% dei paesi mostrava deviazioni statistiche che suggerivano dati non affidabili, compromettendo gravemente la modellazione della sanità pubblica globale e le decisioni politiche. Se il reporting nazionale durante un'emergenza globale può crollare sotto pressione, dovrebbe essere evidente che possono farlo anche i sistemi aziendali.
Che cosa vivono davvero i team di business
Dati affidabili sostengono la rapidità delle decisioni. Dati inaffidabili impongono una tassa su ogni funzione aziendale.
I dirigenti sospendono le decisioni: chiedono una riconciliazione invece di agire in base alla dashboard.
Gli analisti perdono credibilità: anche un'analisi corretta viene contestata se gli input sottostanti hanno già fallito in passato.
Gli engineer vengono coinvolti nel triage: invece di costruire, passano il tempo a dimostrare se i dati sono affidabili.
Gli operatori creano soluzioni di ripiego: esportazioni CSV, controlli manuali e fogli di calcolo paralleli colmano il vuoto.
Regola pratica: se un numero può cambiare un budget, una previsione o una decisione su un cliente, ha bisogno di controlli espliciti di affidabilità, non di una fiducia informale.
Il punto chiave è semplice. L'affidabilità dei dati non è un dettaglio di reporting. È una condizione operativa per decisioni solide.
Definire l'affidabilità dei dati al di là delle parole d'ordine
Molti team dicono “qualità dei dati” quando in realtà intendono qualcosa di più circoscritto e più urgente. Intendono: “Possiamo fidarci di questo dataset adesso, per questa decisione?”. È questa la definizione operativa di affidabilità dei dati.
Una definizione utile con cui le persone possono lavorare
Pensate ai dati affidabili come pensereste a un'auto affidabile. Si avvia quando ne avete bisogno. L'indicatore del carburante è onesto. Il tachimetro riflette la realtà. Il GPS vi porta nel posto giusto. Non avete bisogno di aprire il cofano ogni mattina per decidere se è sicuro guidarla.
I dati inaffidabili sono l'opposto. La dashboard dice una cosa, il sistema si comporta in un altro modo e ogni viaggio inizia con un dubbio. Forse i dati sono arrivati in ritardo. Forse mancano dei record. Forse un campo ha cambiato tipo e la trasformazione ha convertito automaticamente i valori in null. Il risultato è lo stesso. Le persone smettono di fidarsi del cruscotto.
In termini tecnici, affidabilità significa che i dati sono disponibili quando servono, abbastanza stabili da poter essere usati ripetutamente e attendibili in normali condizioni operative. In termini di business, significa che i responsabili possono agire senza avviare un audit ogni volta che un numero conta.
Affidabilità e qualità dei dati in generale
La qualità dei dati è il concetto ombrello più ampio. L'affidabilità è la parte che determina se i dati possono supportare il lavoro reale in modo costante.
Questa distinzione è importante perché i team investono spesso in bonifiche una tantum lasciando irrisolto il problema operativo. Correggono i duplicati in una tabella ma ignorano i file che arrivano in ritardo. Validano i record ma non si accorgono delle modifiche degli schemi. Profilano le distribuzioni ogni mese mentre le dashboard diventano obsolete ogni giorno.
Un modo pratico per separare i concetti è questo:
Focus | Domanda |
|---|---|
Qualità dei dati | Questi dati sono in generale ben strutturati e adatti all'uso? |
Affidabilità dei dati | Questi dati resteranno attendibili quando il business ne avrà bisogno? |
Il costo nascosto si manifesta nella capacità di ingegneria. I problemi di qualità dei dati nelle pipeline enterprise fanno sì che in media il 15% del tempo totale di data engineering venga dedicato alle correzioni, con il 40% delle dashboard critiche che diventano obsolete a causa di caricamenti in ritardo o mancanti. Non sono problemi astratti della piattaforma. Sono SLA mancati, reporting in ritardo e team impegnati in lavori di riparazione invece che nella realizzazione di nuove funzionalità.
I dati affidabili non sono dati “puliti una volta per tutte”. Sono dati utilizzabili in modo costante in condizioni di produzione.
Se un team non sa dire quando dovrebbero arrivare i dati, che cosa dovrebbe essere presente, quali valori sono validi e se la struttura è cambiata, non ha affidabilità. Ha speranza.
I quattro pilastri dell'affidabilità misurabile dei dati
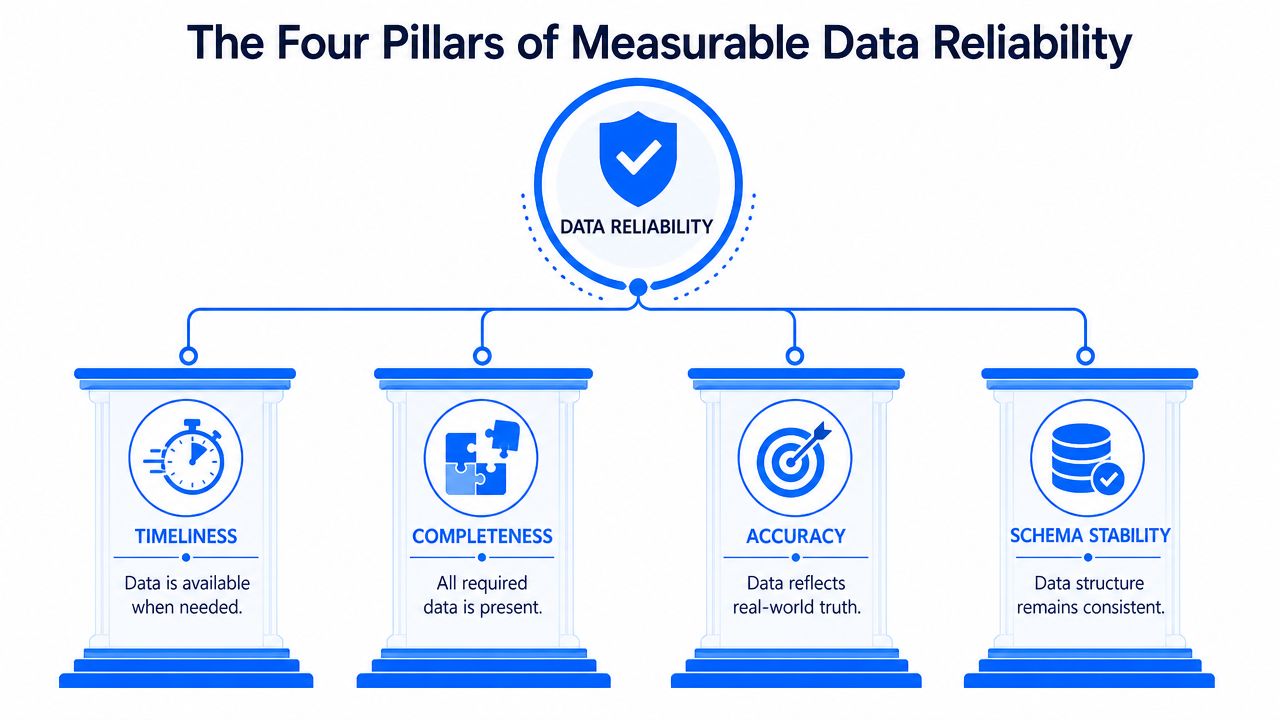
L'affidabilità dei dati diventa gestibile quando si smette di trattarla come un vago problema di fiducia e la si scompone in pilastri misurabili. Nella maggior parte degli ambienti di produzione ne contano quattro: tempestività, completezza, accuratezza e stabilità dello schema.
Tempestività
La tempestività pone una sola domanda: i dati sono arrivati quando il business se li aspettava?
Una dashboard di vendita che si aggiorna dopo la revisione dei ricavi è di fatto sbagliata, anche se ogni riga è tecnicamente corretta. Lo stesso vale per i segnali antifrode, le code dell'assistenza e i feed della supply chain. I dati in ritardo generano decisioni superate.
Nella pratica, i team misurano la tempestività tramite finestre di arrivo previste, freschezza e rilevamento dei ritardi. Se i vostri sistemi a monte pubblicano secondo una pianificazione, monitorate quella pianificazione. Se non lo fanno, apprendete i pattern di arrivo normali e generate un alert quando il pattern si interrompe.
Per approfondire gli indicatori di affidabilità che i team monitorano, le metriche di qualità dei dati per freschezza, distribuzione e schema sono il punto di partenza giusto.
Completezza
La completezza riguarda la presenza. Ci sono tutti i record, i campi e le partizioni richiesti?
Questo pilastro intercetta guasti che a prima vista sembrano innocui. Il file mancante di una regione può distorcere un KPI aziendale. Un gruppo di record di eventi perso può far sembrare la retention più debole di quanto sia. Un identificativo cliente pieno di null può rompere i join a valle, mentre i job della pipeline risultano tecnicamente “riusciti”.
I controlli di completezza includono di solito il confronto del numero di righe, la copertura dei campi obbligatori, il monitoraggio delle partizioni e la riconciliazione tra i conteggi di origine e di destinazione.
Accuratezza
L'accuratezza verifica se i dati riflettono la realtà operativa. In questo contesto, i team validano valori, distribuzioni e logica di business.
Una tabella può essere aggiornata e completa ed essere comunque sbagliata. I campi dei prezzi possono essere alterati da un bug in una trasformazione. I codici valuta possono essere mappati in modo errato. I timestamp degli eventi possono essere interpretati nel fuso orario sbagliato. Nell'analytics questi errori distorcono i trend. Nelle operations generano azioni sbagliate.
Un concetto complementare utile è la ridondanza. Non perché copiare i dati risolva di per sé la qualità, ma perché le copie di riserva e i sistemi replicati cambiano il modo in cui i guasti vengono assorbiti. Se vi serve un ripasso in parole semplici, che cos'è la ridondanza dei dati spiega bene i compromessi.
Più avanti nella sezione è utile vedere il concetto illustrato visivamente.
Stabilità dello schema
La stabilità dello schema è il pilastro più sottovalutato. I team notano spesso rapidamente i dati mancanti, ma le modifiche strutturali possono passare inosservate finché un modello, una dashboard o un'API a valle non iniziano a comportarsi in modo strano.
Una colonna rinominata, un tipo di dato modificato o un campo annidato aggiunto possono invalidare le trasformazioni senza causare un errore bloccante. Ecco perché il monitoraggio degli schemi deve essere esplicito e non lasciato al caso.
Perché la prioritizzazione è importante
Non tutte le tabelle meritano lo stesso livello di monitoraggio. I benchmark di settore indicano che circa il 20% delle tabelle di dati genera in genere l'80% di tutti i problemi di qualità dei dati, ed è per questo che un monitoraggio mirato di freschezza, volume, distribuzione e schema sui dataset ad alto impatto di solito funziona meglio che distribuire lo sforzo in modo uniforme su tutto.
I team ottengono più valore proteggendo i dati che guidano le decisioni che cercando di valutare tutte le tabelle del warehouse in una volta sola.
Un approccio maturo tratta questi quattro pilastri come un unico sistema operativo. La tempestività senza accuratezza è pericolosa. L'accuratezza senza completezza è fuorviante. La completezza senza stabilità dello schema è fragile. L'affidabilità richiede l'insieme.
Come i dati buoni diventano cattivi: le modalità di guasto più comuni
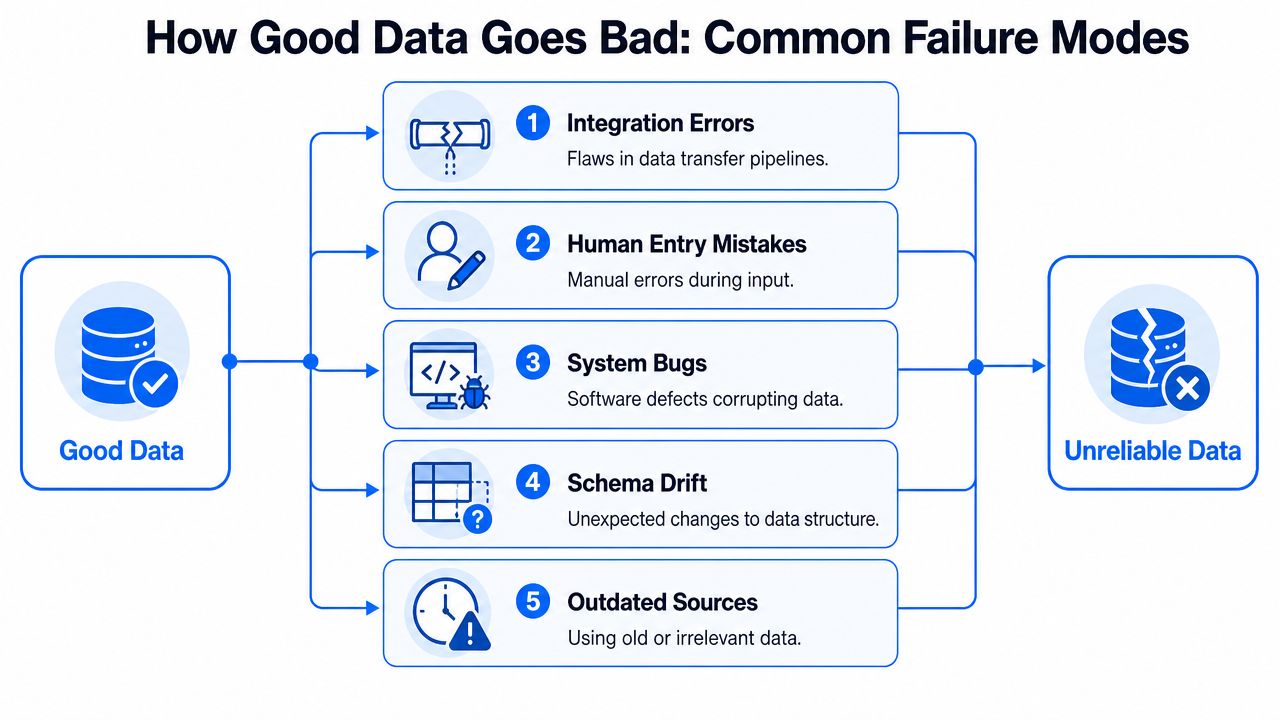
I dati buoni di solito si degradano in modi ordinari. Un connettore cambia comportamento. Un produttore aggiunge una colonna. Un file arriva in ritardo. Una regola di business che prima era valida non lo è più. La pipeline può continuare a girare, ma la fiducia è svanita.
I guasti silenziosi che fanno più danni
La prima classe di guasti è il drift silenzioso. Si verifica quando distribuzioni o relazioni cambiano in modo così graduale che all'inizio nessuno se ne accorge. Un segmento di clienti inizia a essere sovrarappresentato. I valori dei sensori cambiano intervallo. Le frequenze degli eventi si allontanano dalle norme storiche. Poiché nulla “si rompe”, il drift spesso raggiunge gli utenti di business prima degli engineer.
La seconda classe riguarda ritardi e caricamenti mancanti. Sono facili da capire e comunque difficili da gestire. Un sistema di origine pubblica in ritardo, un batch manca la sua finestra o un orchestratore segnala il successo mentre una dipendenza a valle non ha materializzato i dati previsti.
Poi ci sono le modifiche degli schemi. Sono particolarmente pericolose perché possono preservare l'operatività della pipeline corrompendo al tempo stesso il significato dei dati. Una conversione di tipo può trasformare valori validi in null. Un campo rinominato può deviare un ramo di trasformazione. Il sistema resta verde mentre gli output marciscono.
Collegare i guasti all'impatto sul business
Un modo utile per diagnosticare i guasti è collegarli al pilastro che compromettono e al sintomo di business che generano.
Modalità di guasto | Pilastro interessato | Sintomo di business |
|---|---|---|
Consegna a monte in ritardo | Tempestività | Dashboard non aggiornata durante una scadenza di reporting |
Record o partizioni persi | Completezza | KPI sottostimati e falsi segnali di trend |
Valori non validi e violazioni delle regole | Accuratezza | Segmentazione, pricing od output di compliance errati |
Modifiche inattese di colonne o tipi | Stabilità dello schema | Trasformazioni rotte e report fuorvianti |
Non è solo un problema di analytics. Il drift silenzioso dei dati e le modifiche degli schemi non monitorate sono responsabili del 32% del degrado delle prestazioni dei modelli di AI nei sistemi di produzione, mentre il 28% dei guasti dell'analytics è riconducibile ad anomalie a livello di record non validate. Se gestite pipeline di machine learning, l'affidabilità delle feature e il tracciamento degli schemi non sono salvaguardie facoltative. Fanno parte dell'ingegneria di produzione.
I guasti dei dati più costosi sono spesso quelli che non generano un errore evidente.
La lezione pratica è che i controlli isolati non reggono. Un alert sul numero di righe non intercetta il drift. Un confronto degli schemi non intercetta i record non validi. Un singolo “punteggio di qualità” non dirà a un dirigente se la metrica è in ritardo, incompleta o strutturalmente modificata. I team hanno bisogno di una visione integrata di come falliscono i dati, non di una pila di avvisi scollegati.
Un playbook pratico per migliorare la fiducia nei dati
I team hanno bisogno di una routine operativa ripetibile più che dell'ennesima definizione filosofica. Lo schema più efficace è un ciclo continuo con tre fasi: valutare, monitorare, correggere.

Valutare
Partite dalla criticità per il business, non dall'eleganza tecnica. Individuate i dataset che alimentano direttamente il reporting dei ricavi, le dashboard per il management, i workflow operativi, gli output regolamentati e gli input dei modelli. Questi asset meritano definizioni esplicite di affidabilità.
Scrivete queste definizioni come aspettative misurabili. Quando dovrebbero arrivare i dati? Quali record devono essere presenti? Quali campi sono obbligatori? Quali regole di business non devono mai essere violate? Se un produttore cambia la struttura, chi viene avvisato e quali asset a valle sono a rischio?
Una valutazione pratica di solito include:
Mappatura delle decisioni: elencate i report, i modelli e i processi che si basano su ciascun dataset critico.
Aspettative di affidabilità: definite freschezza, finestre di arrivo, campi obbligatori e ipotesi strutturali.
Ownership: stabilite chi indaga sui problemi e chi approva la risoluzione.
Impatto dei guasti: documentate che cosa succede al business se quel dataset è sbagliato o in ritardo.
Monitorare
Una volta definite le aspettative, automatizzate i controlli in base a esse. Il controllo manuale non scala e di solito avviene solo dopo che uno stakeholder ha già notato qualcosa di sospetto.
Il monitoraggio dovrebbe coprire i quattro pilastri in modi diversi, perché ognuno fallisce in modo diverso:
Per la tempestività: controllate freschezza, rispetto delle pianificazioni e orari di arrivo previsti.
Per la completezza: verificate volumi di righe, presenza delle partizioni e popolamento dei campi obbligatori.
Per l'accuratezza: validate le regole di business e monitorate le distribuzioni alla ricerca di variazioni insolite.
Per la stabilità dello schema: tracciate le colonne aggiunte, rimosse, rinominate e con tipo modificato.
È anche qui che conta la rappresentatività. Un dataset può essere tecnicamente pulito ed essere comunque inaffidabile per il processo decisionale se esclude le persone interessate dalla decisione. La discussione delle National Academies su copertura e gruppi sottorappresentati lo chiarisce bene: l'affidabilità non dipende solo dalla correttezza, ma anche dal fatto che i dati includano le popolazioni giuste.
Correggere
Il rilevamento conta solo se la risposta è rapida e disciplinata. I team che migliorano la fiducia nel tempo trattano gli incidenti sui dati in modo molto simile agli incidenti di servizio. Fanno il triage, contengono, indagano, correggono e documentano ciò che dovrebbe impedire che si ripetano.
Un semplice ciclo di correzione funziona bene:
Triage del sintomo: il problema riguarda dati in ritardo, dati mancanti, drift, record non validi o una modifica dello schema?
Contenere l'impatto a valle: sospendete l'aggiornamento di una dashboard, mettete in quarantena i record sospetti o contrassegnate gli output come degradati.
Trovare la causa principale: controllate le estrazioni dalla sorgente, le trasformazioni, i contratti e le recenti modifiche al codice o agli schemi.
Correggere ed eseguire il backfill: ripristinate la pipeline, correggete la logica e rielaborate le finestre interessate.
Rafforzare il sistema: aggiungete il controllo, l'alert, la regola di ownership o il canale di comunicazione mancante.
I team bravi non si limitano a correggere i dati errati. Correggono la condizione che ha permesso ai dati errati di raggiungere chi prende le decisioni.
Ciò che funziona è la disciplina operativa. Ciò che non funziona è affidarsi agli atti eroici, all'SQL estemporaneo e alla memoria di chi era reperibile il trimestre scorso.
Rendere operativa l'affidabilità con digna
Un playbook diventa reale quando i controlli vivono in un'unica superficie operativa invece che in un mosaico di script, avvisi sulle dashboard e conoscenza tribale. È qui che una piattaforma di observability unificata cambia il lavoro quotidiano.
Che cosa cambia con una piattaforma unificata
Strumenti separati tendono a frammentare il problema. Un sistema sorveglia le pipeline. Un altro profila le tabelle. Un terzo valida le regole di business. Qualcuno deve comunque correlare manualmente i segnali e spiegarli agli stakeholder di analytics, ingegneria e business.
Un approccio unificato riunisce in un unico posto tempestività, anomalie, validazione, pattern storici e monitoraggio degli schemi. Questo conta perché i guasti di business raramente sono circoscritti a una sola metrica. Una dashboard non aggiornata può risalire a un arrivo in ritardo a monte. Un problema di un modello può iniziare con un drift ed essere amplificato da una modifica dello schema. Un incidente di governance può nascere come un errore di validazione a livello di record.
Per i team che valutano questo modello, questa panoramica su una piattaforma di data quality facile da usare per il business moderno è un utile punto di riferimento.
Come le funzionalità rispondono a problemi reali
digna è un esempio di questo modello unificato. I suoi componenti corrispondono da vicino alle modalità di guasto che contano sul piano operativo.
Monitoraggio della tempestività: il calcolo delle consegne previste e il rilevamento dei ritardi affrontano il problema delle dashboard non aggiornate e dei caricamenti a monte in ritardo.
Anomalie dei dati: l'apprendimento delle baseline basato sull'AI fa emergere drift silenziosi e cambiamenti insoliti senza richiedere una costante manutenzione manuale delle regole.
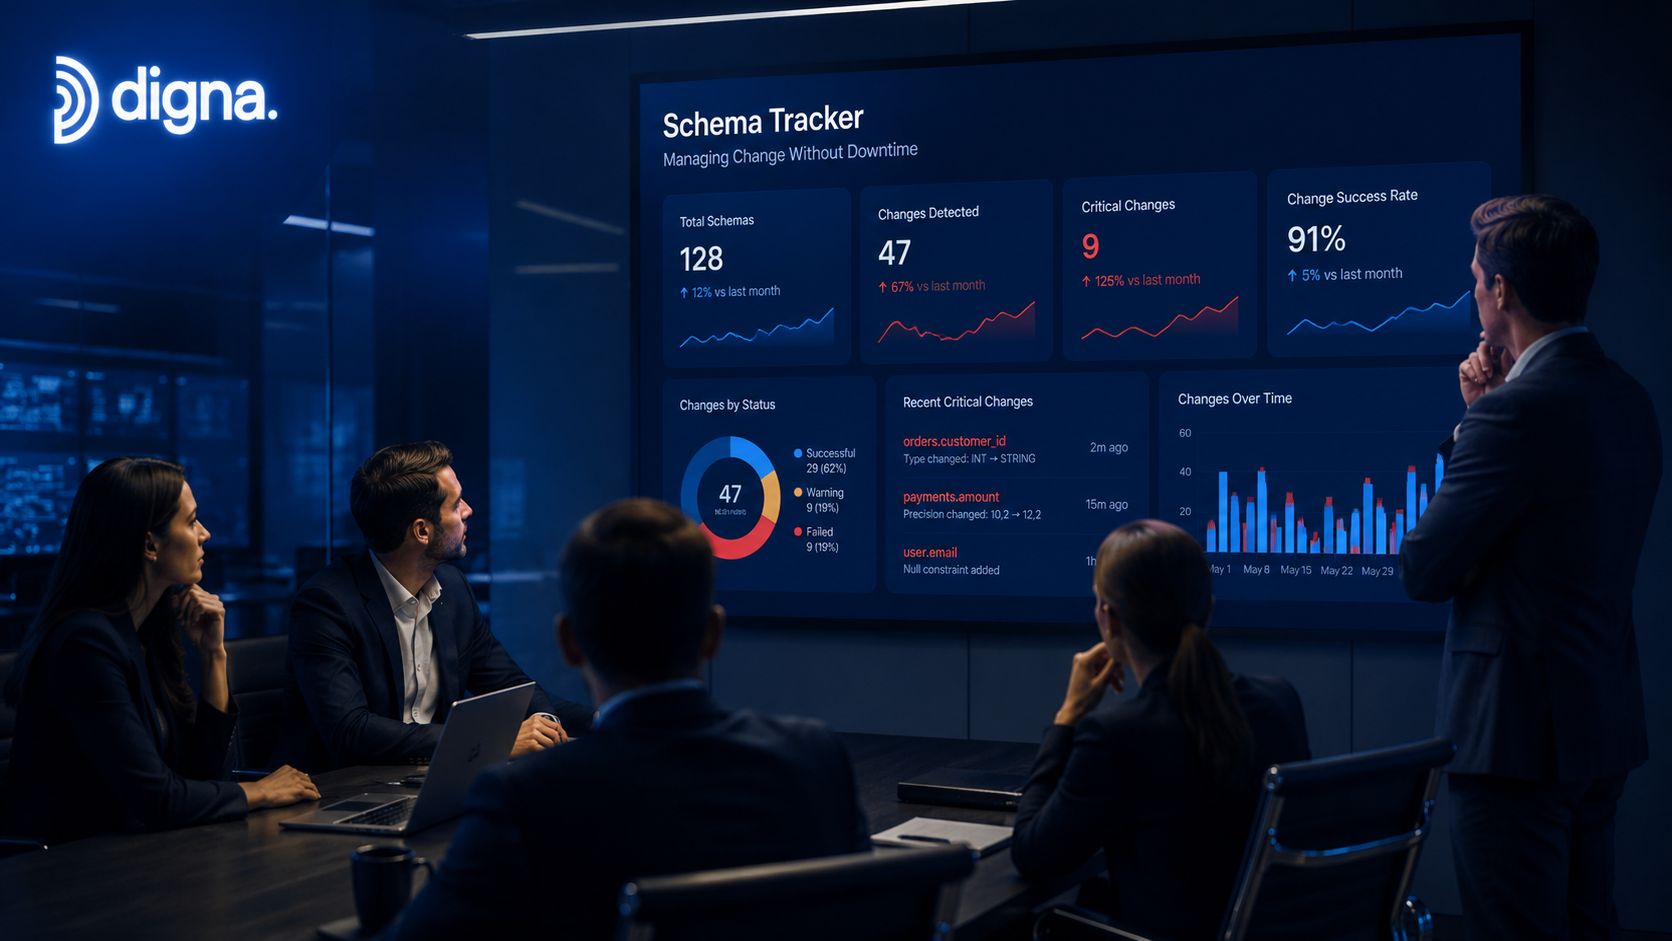
Schema Tracker: le modifiche strutturali, come colonne aggiunte o rimosse e cambi di tipo di dato, vengono segnalate prima che compromettano gli asset a valle.
Data Validation: i controlli a livello di record applicano la logica di business e supportano controlli orientati agli audit.
Analytics storica: le viste sui trend aiutano i team a distinguere un'anomalia isolata da un pattern ricorrente.
Anche l'architettura conta. Il calcolo delle metriche in-database riduce lo spostamento dei dati fino al 70% rispetto alla validazione esterna basata su ETL, il che supporta un modello in cui le analisi vengono eseguite all'interno dell'ambiente database del cliente invece di copiare i dati di produzione verso il sistema di un fornitore. In contesti fortemente regolamentati o sensibili alla privacy, questo cambia sia la postura di sicurezza sia il carico operativo.
Anche la velocità di rilevamento cambia quando le soglie si adattano. Le organizzazioni che usano il rilevamento delle anomalie basato sull'AI con soglie autoregolanti rilevano le deviazioni dei dati 4,5 volte più velocemente di quelle che si affidano a sistemi statici basati su regole, con avvisi tempestivi emessi entro 12 minuti dall'inizio della deviazione. Questo conta perché la differenza tra un problema contenuto e un incidente di business visibile dipende spesso dal fatto che il team abbia visto il problema prima dell'aggiornamento della dashboard, della revisione con il management o dell'esecuzione del modello.
Un'operatività dei dati affidabile ha bisogno di meno controlli scollegati e di più evidenze collegate.
Il vantaggio pratico non è solo un alerting migliore. È un contesto condiviso. Engineer, analisti e stakeholder di business possono esaminare lo stesso incidente da prospettive diverse senza discutere su quale strumento dica la verità.
Dai dati inaffidabili alle decisioni sicure
L'affidabilità dei dati non è una bonifica una tantum. È una disciplina operativa. I team si guadagnano la fiducia quando definiscono aspettative misurabili, monitorano i pilastri che contano e rispondono ai guasti con un'ownership chiara e la correzione della causa principale.
I sistemi affidabili non eliminano ogni incidente. Rendono gli incidenti visibili presto, comprensibili rapidamente e recuperabili senza trasformare ogni decisione in un dibattito. È questo il cambiamento che conta di più. I dati smettono di essere fonte di esitazione e diventano qualcosa che il business può usare con fiducia.
Se il vostro team deve fare i conti con dashboard non aggiornate, drift silenziosi, sorprese negli schemi o continue emergenze sui dati, vale la pena valutare digna come modo pratico per monitorare tempestività, anomalie, validazione e modifiche degli schemi in un unico ambiente, mantenendo i dati all'interno di un'infrastruttura controllata dal cliente.
Poiché la stabilità dello schema è il pilastro che i team sottovalutano più spesso, guardate come digna Schema Tracker segnala le colonne aggiunte, rimosse o con tipo modificato prima che rompano silenziosamente le trasformazioni a valle.
Domande frequenti
Che cos'è l'affidabilità dei dati?
L'affidabilità dei dati risponde a una domanda pratica: possiamo fidarci di questo dataset adesso, per questa decisione? Tecnicamente significa che i dati sono disponibili quando servono, abbastanza stabili da poter essere usati ripetutamente e attendibili in normali condizioni operative, così che i responsabili possano agire senza avviare un audit ogni volta che un numero conta.
Qual è la differenza tra qualità dei dati e affidabilità dei dati?
La qualità dei dati è il concetto ombrello più ampio, che si chiede se i dati siano in generale ben strutturati e adatti all'uso. L'affidabilità si chiede se resteranno attendibili quando il business ne avrà bisogno. L'articolo osserva che i problemi di qualità assorbono circa il 15% del tempo di data engineering, con il 40% delle dashboard critiche che diventano obsolete per caricamenti in ritardo o mancanti.
Quali sono i quattro pilastri dell'affidabilità dei dati?
Tempestività, completezza, accuratezza e stabilità dello schema sono i quattro pilastri misurabili. La tempestività verifica l'arrivo rispetto alle aspettative, la completezza verifica che record e partizioni siano presenti, l'accuratezza confronta i valori con la realtà operativa e la stabilità dello schema intercetta colonne rinominate o tipi modificati che rompono silenziosamente le trasformazioni. Ogni pilastro fallisce in modo diverso, quindi ognuno ha bisogno di controlli propri.
Come si migliora la fiducia nei dati?
Con un ciclo continuo in tre fasi: valutare, monitorare, correggere. Valutare significa collegare i dataset critici alle decisioni che alimentano e definire aspettative e responsabili. Monitorare significa automatizzare i controlli su tutti e quattro i pilastri. Correggere significa trattare gli incidenti sui dati come incidenti di servizio: triage, contenimento dell'impatto a valle, ricerca della causa principale, correzione e backfill, quindi rafforzamento del sistema.
Quali tabelle andrebbero monitorate per prime per l'affidabilità dei dati?
Concentratevi prima sui dataset ad alto impatto che alimentano il reporting dei ricavi, le dashboard per il management, gli output regolamentati e gli input dei modelli. I benchmark di settore citati nell'articolo mostrano che circa il 20% delle tabelle genera l'80% dei problemi di qualità dei dati, quindi un monitoraggio mirato di freschezza, volume, distribuzione e schema funziona meglio che distribuire lo sforzo in modo uniforme su tutto il warehouse.


