Validation des données d'une API REST : Un guide d'implémentation pratique
|
8
minute de lecture

Vous ne regardez généralement pas une couche de validation propre lorsque les choses tournent mal. Vous regardez un tableau de bord rempli de lignes bizarres, une boucle de relance de webhook cassée, ou un rapport qui est « presque correct » jusqu'à ce que quelqu'un remarque que les chiffres ne concordent pas. C'est le coût réel de la validation des données de l'API REST : les mauvaises requêtes ne échouent pas simplement en périphérie, elles peuvent se glisser dans les pipelines, fausser les analyses en aval et transformer un simple décalage de contrat en un nettoyage coûteux.
La démarche pratique consiste à traiter la validation comme faisant partie du Data Contract de l'API, et non comme un simple contrôle préalable de courtoisie. Ce changement modifie la façon dont vous concevez les schémas, l'endroit où vous rejetez les requêtes, ce que vous consignez dans les journaux et le niveau de détail que vous exposez en cas d'échec. Cela change également la façon dont les équipes perçoivent la fiabilité, car une requête malformée est rarement une simple entrée incorrecte, c'est souvent le premier signal qu'un contrat lisible par machine est en train de se désynchroniser avec les systèmes qui en dépendent.
Table des matières
Pourquoi la validation des API REST est un problème de contrat
Le modèle de validation à deux couches
Ce qui relève de la validation syntaxique
Ce qui relève de la validation sémantique
Concevoir des schémas qui fonctionnent en production
Règles de schéma qui tiennent la route en production
Contrôle des performances et de la dérive
Choisir des bibliothèques de validation et des middlewares
La gestion des erreurs que les développeurs utilisent
Ce qu'il faut renvoyer et ce qu'il faut cacher
Où se situent les codes d'état
Connecter la validation à la qualité des données et à l'Observability
Ce qu'il faut surveiller après le rejet de la requête
Comment les plateformes s'intègrent dans la boucle
Pourquoi la validation des API REST est un problème de contrat
Une requête corrompue n'échoue pas toujours en périphérie. Dans les systèmes d'entreprise, elle peut passer par un contrôleur, atterrir dans une file d'attente et réapparaître plus tard sous la forme d'une tendance trompeuse sur un tableau de bord ou d'un rapport opérationnel auquel personne ne fait confiance. C'est pourquoi la validation des données de l'API REST consiste réellement à appliquer le contrat dont dépendent les systèmes en aval, et pas seulement à filtrer les entrées désordonnées.
Le validateur REST d'AWS API Gateway rend cet état d'esprit de contrat concret. Il vérifie si l'URI requis, la chaîne de requête et les paramètres d'en-tête sont présents et non vides, et il peut valider une charge utile par rapport à un schéma JSON configuré. S'il n'y a pas de type de contenu correspondant, la validation est ignorée, ce qui rappelle utilement que la validation ne fonctionne que lorsque le contrat est suffisamment explicite pour que la plateforme puisse l'appliquer. Détails de la validation des requêtes AWS API Gateway
Cela est important car, dans les environnements d'entreprise, les échecs de validation ne restent pas localisés. Une seule requête non valide peut contaminer les flux de travail d'analyse, de surveillance et de reporting si le système l'accepte trop tard ou pas du tout. Les directives de l'API REST d'Eurostat décrivent les requêtes comme un modèle d'URL structuré composé de l'hôte, du service, de la version, du type de réponse, du code du jeu de données, du format, de la langue et des filtres. Directives de l'API REST d'Eurostat
Règle pratique : si les systèmes en aval ne peuvent pas supposer en toute sécurité la forme et la signification d'une requête, vous n'avez pas encore de contrat, vous avez une suggestion.
La validation a commencé comme une simple vérification des entrées, puis s'est transformée en application des contrats, en hygiène de sécurité et en contrôle des performances pour les API à grande échelle. Cette évolution se traduit par des conseils qui mettent l'accent sur un comportement d'échec rapide, des erreurs claires et l'évitement des fuites techniques. Conseils de validation d'API REST
Pour les équipes qui gèrent des pipelines de données, le modèle est encore plus strict. La validation n'est qu'une couche de l'histoire de la fiabilité, et les data contracts représentent la discipline plus large qui rend le contrat explicite entre producteurs et consommateurs.
Le modèle de validation à deux couches
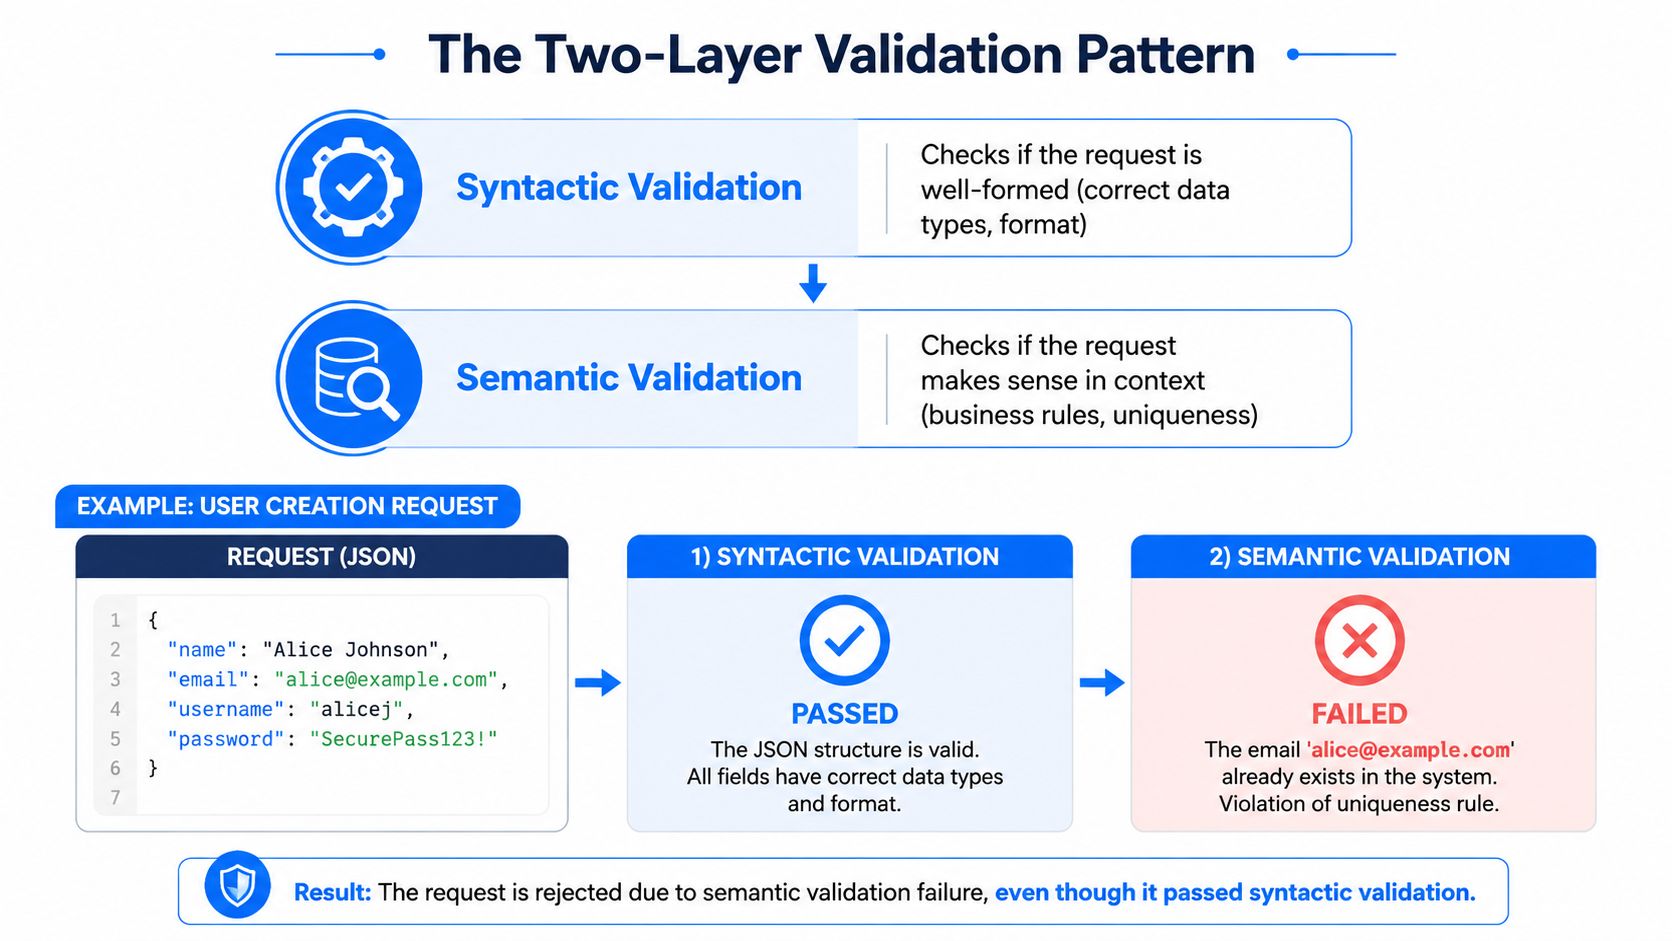
La façon la plus propre de concevoir la validation d'une API REST est de séparer la validation syntaxique de la validation sémantique. Les contrôles syntaxiques répondent à une question : cette requête est-elle bien formée ? Les contrôles sémantiques répondent à la question la plus difficile : cette requête a-t-elle du sens pour cette ressource et ce domaine métier ?
Ce qui relève de la validation syntaxique
La validation syntaxique détecte le JSON malformé, les champs obligatoires manquants, les types de données incorrects, les échecs d'analyse, les chaînes vides et les valeurs qui violent les limites déclarées. Le but est de rejeter les requêtes manifestement erronées avant qu'elles n'atteignent une logique métier coûteuse. C'est la couche où les schémas OpenAPI, les validateurs de schémas JSON et les gardes au niveau du contrôleur justifient leur présence.
Le flux de travail est simple. Validez au niveau de la passerelle ou du contrôleur, appliquez un schéma strict, rejetez les incompatibilités de types et les valeurs hors plage, et exécutez des tests négatifs pour les JSON malformés, les valeurs nulles, les chaînes vides et les charges utiles surdimensionnées avant que le traitement en aval ne commence. Les recommandations de type OWASP préconisent également un typage fort, des contraintes d'expressions régulières, le rejet de contenus illicites et des limites de taille de requête qui renvoient un code HTTP 413 en cas de dépassement. Pratiques de validation et de gestion des entrées
Ce qui relève de la validation sémantique
La validation sémantique vérifie la signification métier. Un identifiant utilisateur peut être syntaxiquement valide et ne pas exister pour autant. Une valeur d'énumération peut être structurellement valide et pourtant incorrecte pour l'état actuel de la ressource. C'est là que vous vérifiez l'intégrité référentielle, l'unicité, l'état du flux de travail, la propriété ou toute règle qui dépend de données de domaine en direct.
Un arbre de décision utile est simple :
L'analyseur peut-il le lire ? Placez cela dans la syntaxe.
Le type, le champ requis ou la plage sont-ils incorrects ? Placez cela dans la syntaxe.
La valeur fait-elle référence à une entité réelle ou à un état valide ? Placez cela dans la sémantique.
La règle dépend-elle du contexte métier, des autorisations ou de l'état actuel de la base de données ? Placez cela dans la sémantique.
Commencez par les contrôles les plus économiques. Si une requête échoue à la validation de forme de base, ne dépensez pas de lectures de base de données pour prouver une règle métier pour une charge utile qui aurait dû être rejetée deux millisecondes plus tôt.
Cet enchaînement est ce que l'on appelle la validation progressive. Vérifiez d'abord les champs critiques, rejetez tôt et réservez les contrôles coûteux aux requêtes qui ont déjà franchi la barrière structurelle. Les guides pratiques séparent les deux couches précisément pour cette raison : la syntaxe vous apporte la rapidité et la sécurité, la sémantique vous apporte l'exactitude. Validation syntaxique versus sémantique
Concevoir des schémas qui fonctionnent en production
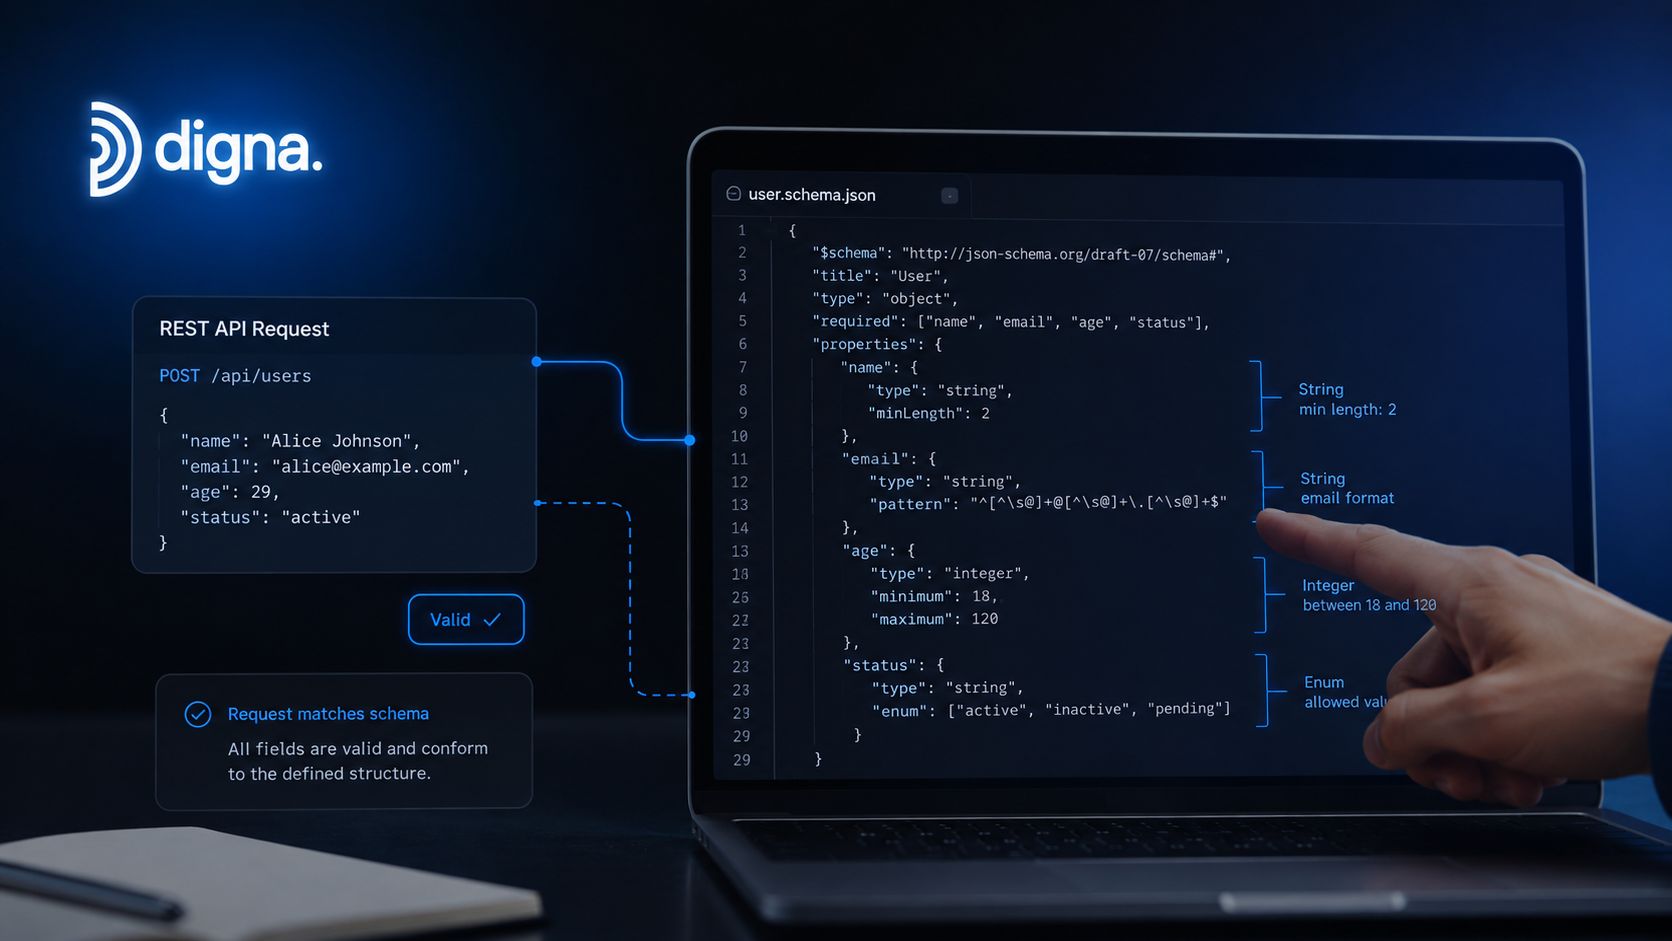
Un schéma qui accepte tout n'est pas flexible, il est inutile. Une bonne conception de schéma commence par les champs que les clients doivent envoyer, puis resserre le contrat avec des types, des modèles, des plages et des énumérations qui correspondent à l'objet métier que l'API est censée accepter. En pratique, JSON Schema et OpenAPI fonctionnent bien ensemble car le schéma décrit la forme de la requête tandis que la spécification de l'API décrit où et comment cette forme est utilisée.
Règles de schéma qui tiennent la route en production
Définissez explicitement les champs obligatoires, puis contraignez chaque propriété avec le type pratique le plus étroit. Pour les chaînes, utilisez des modèles de regex lorsque le format importe plus que le texte libre. Pour les nombres, déclarez des plages au lieu de compter sur le code en aval pour intercepter les cas limites. Pour les ensembles fermés, utilisez des énumérations afin que les clients ne puissent pas inventer de nouvelles valeurs par accident.
Cette discipline évite les modes de défaillance qui apparaissent en production. Les équipes font souvent l'impasse sur les vérifications de format pour les e-mails et les dates, ou écrivent des schémas qui ne reflètent pas les règles métier réelles du point de terminaison. Il en résulte un contrat qui laisse entrer des données erronées dans les étapes ultérieures et oblige la couche applicative à compenser le manque de structure. L'utilisation de descriptions de schémas qui restent alignées avec les structures de données stockées permet de maintenir la validation des requêtes proche du modèle de données qu'elle est censée protéger.
Un modèle pratique de conception de schéma ressemble à ceci :
Des objets de base partagés pour les champs réutilisés sur plusieurs points de terminaison.
Des superpositions spécifiques aux points de terminaison pour les exigences propres à chaque action.
Des énumérations et regex explicites pour les valeurs contraintes.
Des fichiers de schéma versionnés lorsqu'une modification de contrat risquerait sinon de perturber les consommateurs.
Contrôle des performances et de la dérive
La compilation des schémas est importante lorsque le volume de requêtes est élevé. Les analyses répétées ajoutent du bruit que vous ne voulez pas dans les chemins critiques, et les validateurs compilés réduisent ce coût. Le versionnage des schémas est important pour la même raison, car les exigences métier évoluent et les anciens clients ne disparaissent pas selon votre calendrier.
Le mode de défaillance à éviter est la dérive silencieuse des schémas, où le code, le document OpenAPI et la forme réelle de la charge utile cessent de correspondre.
La surveillance structurelle devient alors utile. Schema Tracker de digna est conçu pour surveiller les changements structurels en production afin que les équipes puissent détecter la dérive avant qu'elle ne perturbe la validation, ce qui est le bon problème à résoudre lorsque le contrat de votre API n'est qu'une partie d'un pipeline de données plus large. Gardez le schéma proche du service, maintenez un versionnage explicite et ne laissez pas le « on mettra à jour plus tard » devenir la stratégie de publication par défaut.
Choisir des bibliothèques de validation et des middlewares
Le choix de la bibliothèque est principalement un compromis entre rapidité, expressivité et charge de maintenance. Les validateurs JSON Schema comme Ajv sont performants lorsque vous souhaitez des schémas compilés et une application prévisible des règles. Les outils basés sur OpenAPI sont préférables lorsque vos besoins de validation doivent rester étroitement couplés à un contrat d'API qui existe déjà pour la documentation et la génération de clients. Les systèmes de types tels que TypeScript aident au moment de la compilation, mais ils ne remplacent pas la validation au moment de l'exécution car les requêtes externes se moquent de ce que croit votre compilateur.
Le middleware de framework est l'endroit où les équipes font souvent une mauvaise optimisation. Le middleware Express est facile à intégrer, FastAPI offre une analyse puissante des requêtes dès le départ, et la validation au niveau de la passerelle peut stopper le trafic malformé avant qu'il n'atteigne le code applicatif. La bonne répartition dépend de l'endroit où vous souhaitez que la défaillance se produise et de qui doit gérer la surface d'erreur.
Approche | Performances | Qualité des erreurs | Courbe d'apprentissage | Idéal pour |
|---|---|---|---|---|
Validateur de schéma JSON | Excellente une fois compilé | Bonne si bien mappée | Modérée | Contrats de requête stricts |
Outils basés sur OpenAPI | Solide | Bonne, alignée sur le contrat | Modérée | Équipes axées sur l'API-first |
TypeScript plus vérifications à l'exécution | Variable, dépend de la couche d'exécution | Variable | Plus faible pour les équipes TS | Bases de code partagées |
Middleware de framework | Bonne pour les cas simples | Souvent spécifique au framework | Faible | Intégration rapide |
Validation au niveau de la passerelle | Excellente en périphérie | Généralement standardisée | Modérée à élevée | API à fort trafic |
Les schémas compilés et la validation progressive devraient être obligatoires dans les systèmes très sollicités. Vérifiez d'abord les champs les plus économiques, échouez rapidement et n'invoquez des validateurs plus profonds que lorsqu'une requête a déjà mérité ce temps de processeur. Ce modèle importe plus que la marque de la bibliothèque.
Il y a aussi une question de maintenance que les équipes sous-estiment. Les validateurs personnalisés semblent faciles à mettre en œuvre lors du déploiement du premier point de terminaison, puis deviennent fragiles lorsque dix autres points de terminaison ont besoin des mêmes règles avec des exceptions légèrement différentes. Les bibliothèques établies réduisent cette dérive, en particulier lorsqu'elles vous fournissent des schémas réutilisables, des messages au niveau du champ et une possibilité d'échappement pour les vérifications spécifiques au domaine qui n'ont pas leur place dans la bibliothèque elle-même.
La gestion des erreurs que les développeurs utilisent
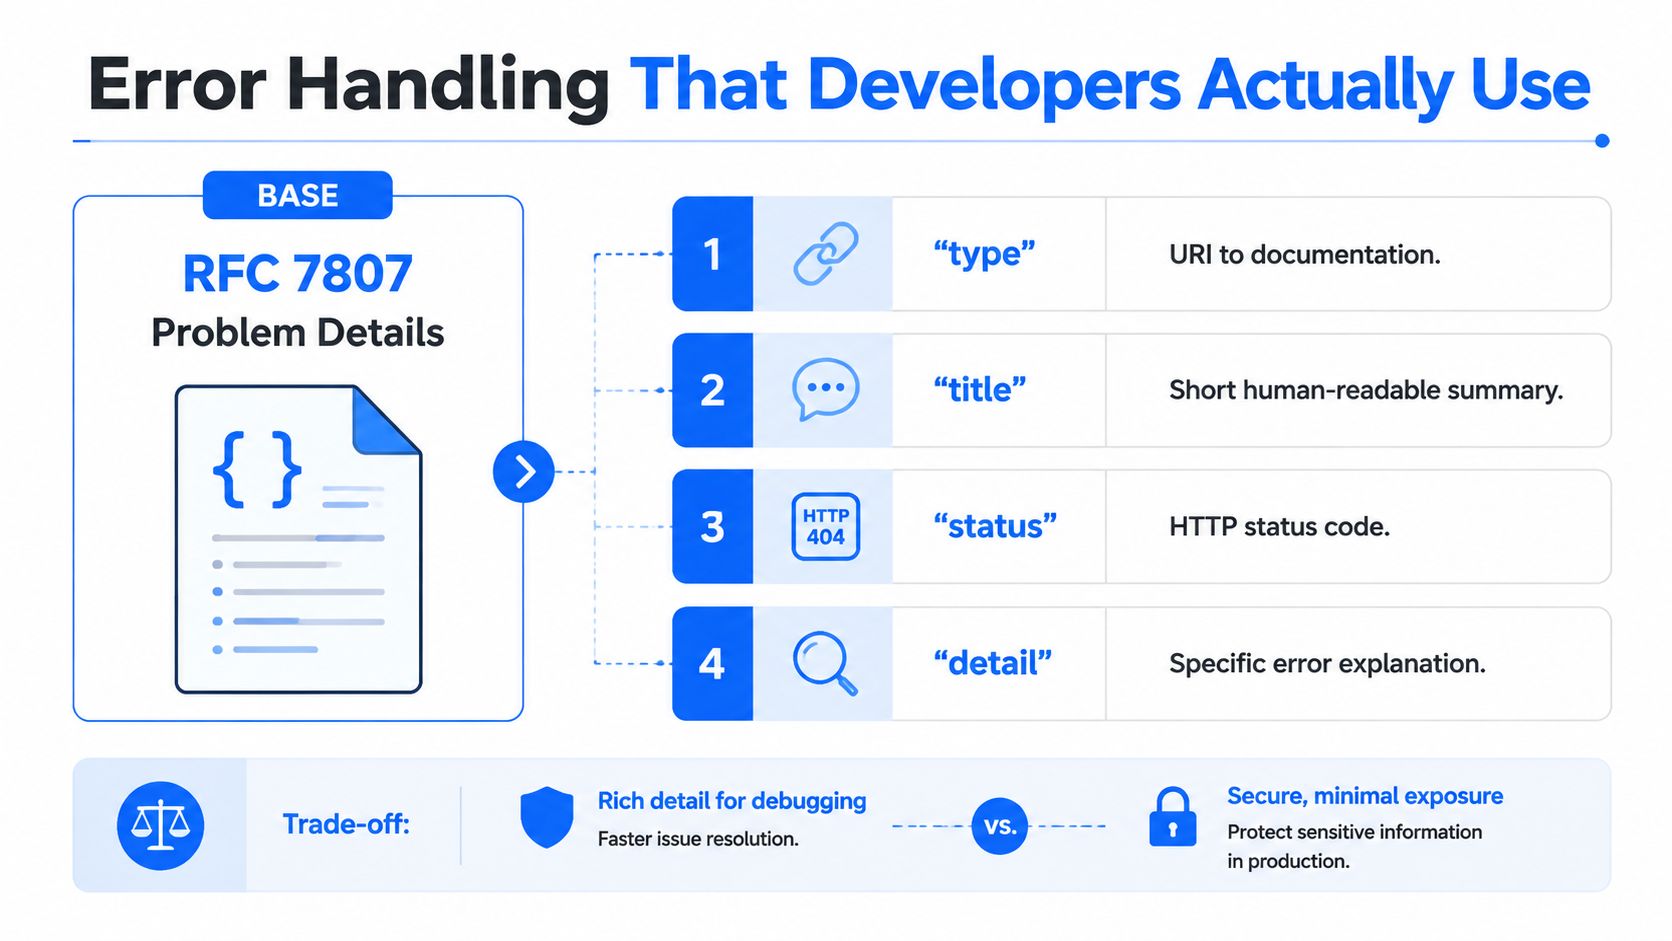
La validation n'est utile que si la réponse fournit aux clients des éléments sur lesquels ils peuvent agir. La norme RFC 7807 fonctionne bien comme base de référence car elle offre aux consommateurs d'API une structure lisible par machine pour analyser les échecs sans les obliger à rétroconcevoir un format personnalisé. Les champs qui importent sont type, title, status et detail, ainsi que des informations au niveau du champ lorsqu'une charge utile échoue à la validation. Réponses de validation de style RFC 7807
Ce qu'il faut renvoyer et ce qu'il faut cacher
Utilisez le code HTTP 400 Bad Request lorsque la charge utile échoue à la validation du schéma ou des champs. Gardez le corps de la réponse sûr, spécifique et cohérent. Incluez le nom du champ, la raison et le format attendu pour que les développeurs front-end et les clients automatisés puissent corriger la requête sans deviner.
Une bonne réponse est descriptive sans être bavarde. Les erreurs spécifiques aux champs fonctionnent mieux qu'un message générique « entrée invalide » car elles pointent directement vers la propriété incriminée. Les erreurs agrégées sont encore meilleures lorsque plusieurs champs échouent en même temps, car elles permettent aux clients de tout corriger en un seul aller-retour. Les recommandations publiques préconisent également d'éviter les détails d'implémentation interne, ce qui vous protège contre la fuite de traces de pile, de détails internes de champs ou de la structure du backend. Conseils de gestion des erreurs de validation d'API
Où se situent les codes d'état
Il existe un véritable arbitrage sémantique entre les codes 400 and 422, et les ressources publiques ne tranchent pas encore totalement la frontière. La règle pratique consiste à être cohérent au sein de votre propre API et à la documenter clairement pour les consommateurs. Si votre équipe utilise le code 400 pour tous les échecs de forme de requête, conservez cette approche et rendez le corps de la réponse suffisamment précis pour compenser.
La journalisation côté serveur doit être beaucoup plus riche que les réponses clients. Enregistrez le contexte de validation, l'identifiant de la requête et la règle interne qui a échoué, mais ne consignez jamais les mots de passe, les jetons ou d'autres champs de charge utile sensibles. Cette séparation permet aux équipes d'assistance de déboguer rapidement tout en protégeant les réponses en production contre des clients malveillants. Dans une API réelle, cet équilibre importe plus qu'une parfaite pureté théorique.
La meilleure réponse d'erreur est celle que le client peut corriger et qu'un attaquant ne peut pas exploiter pour obtenir des informations supplémentaires.
Connecter la validation à la qualité des données et à l'Observability
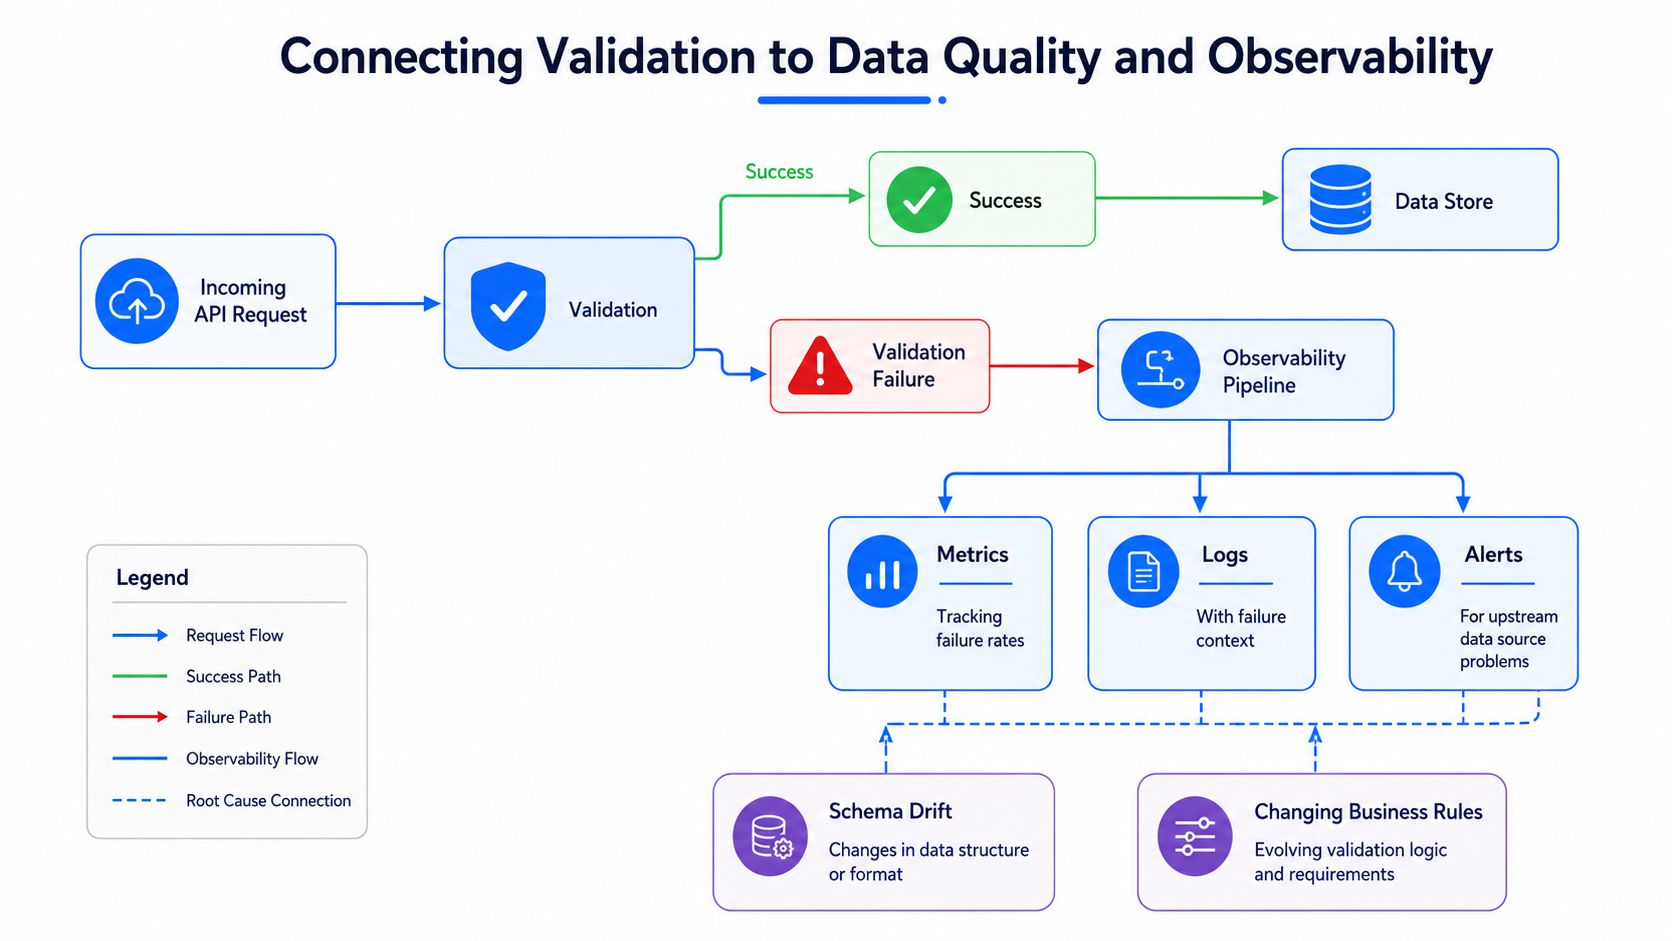
Les échecs de validation ne sont pas seulement des problèmes d'API, ce sont des signaux sur la santé du système de données qui entoure l'API. Un pic de requêtes rejetées peut indiquer des changements de source en amont, une dérive des schémas ou une règle métier qui a changé plus rapidement que les clients. Si vous traitez uniquement la validation comme un filtre d'entrée, vous passez à côté de l'un des premiers avertissements indiquant que le pipeline commence à se désaligner.
Ce qu'il faut surveiller après le rejet de la requête
Les échecs de validation devraient alimenter l'Observability de la même manière que les écritures réussies alimentent le stockage. Suivez les modèles d'échec, conservez les journaux contextuels et déclenchez des alertes lorsqu'un point de terminaison spécifique commence à rejeter une nouvelle classe de charges utiles. C'est ainsi que les équipes distinguent un mauvais déploiement client d'un problème de compatibilité plus profond.
Ce point s'étend également en aval. Si l'API est la porte d'entrée d'un entrepôt, d'un lac ou d'un magasin opérationnel, la validation des requêtes et les contrôles de qualité des données après chargement devraient se renforcer mutuellement plutôt que de se dupliquer aveuglément. La validation au niveau de l'API intercepte les requêtes malformées avant l'ingestion, tandis que les contrôles en aval détectent les anomalies qui n'apparaissent qu'une fois les données combinées, transformées ou comparées à d'autres systèmes.
Comment les plateformes s'intègrent dans la boucle
Les modules de validation des données et de suivi des schémas de digna s'intègrent naturellement dans cette couche car ils permettent aux équipes de surveiller les règles métier et les changements structurels sur l'ensemble du pipeline, et pas seulement au point d'entrée. C'est utile lorsque le contrat de l'API est stable mais que le comportement de la source ne l'est pas, ou lorsque plusieurs producteurs alimentent les mêmes tables en aval. Observability des données digna
Une boucle d'Observability pratique ressemble à ceci :
Des métriques de validation pour signaler de nouveaux modèles d'erreur.
Des journaux pour capturer le champ rejeté et la raison.
Des alertes pour informer les propriétaires des problèmes de source en amont.
Une surveillance des changements de schéma pour détecter la dérive avant qu'elle ne se propage.
Des contrôles de règles métier pour confirmer que les données ont toujours du sens après l'ingestion.
Traitez les échecs de validation comme de la télémétrie opérationnelle, et pas seulement comme du bruit applicatif.
C'est cet état d'esprit qui permet de maintenir la couche API connectée à la fiabilité des données. Lorsque la validation, l'Observability et les contrôles de qualité en aval sont alignés, les équipes cessent de débattre pour savoir si une défaillance incombe à l'équipe API ou à l'équipe de données. Elles peuvent voir le même signal, l'interpréter dans son contexte et corriger la bonne couche plus rapidement.
Si vous resserrez les contrats de requête, réduisez les charges utiles incorrectes ou essayez d'empêcher la dérive des schémas de perturber votre pipeline, digna offre aux équipes de données un moyen de surveiller la validation, les modifications de schéma et le comportement des données au sein de leur propre environnement. Visitez digna pour voir comment ses modules d'Observability et de validation des données s'intègrent dans la même couche de fiabilité dont dépendent déjà vos API.


