Les 9 types de pipeline de données : choisir le meilleur en 2026
|
10
minute de lecture

Au-delà de l’ETL : choisir la bonne architecture de pipeline de données
Vos tableaux de bord sont obsolètes. Vos modèles de ML dérivent. Vos parties prenantes perdent confiance dans les données. Ce sont des symptômes courants d’une inadéquation architecturale, d’un pipeline de données qui ne parvient plus à suivre le rythme des besoins métier. Choisir le bon pipeline n’est pas qu’une décision technique. C’est une décision stratégique qui influe sur la fraîcheur, la fiabilité, l’effort d’exploitation et le degré de confiance que les utilisateurs accordent à chaque indicateur qu’ils utilisent.
Les pipelines échouent rarement à cause d’un mauvais choix d’outil. L’échec vient plutôt d’une architecture mal adaptée à la tâche. Un chargement nocturne de l’entrepôt ne peut pas soutenir la prévention de la fraude. Une pile de streaming est démesurée pour un rapprochement financier hebdomadaire. Ce guide se concentre sur la réalité opérationnelle des principaux types de pipeline de données : là où chaque modèle se brise, ce que les équipes sous-estiment généralement et comment rendre chacun observable dès le premier jour.
Si vous constituez votre équipe tout en définissant cette architecture, ce guide sur les postes de data engineer en Amérique latine offre un contexte utile sur les compétences qu’exigent ces systèmes.
Table des matières
1. Pipelines de traitement par lots
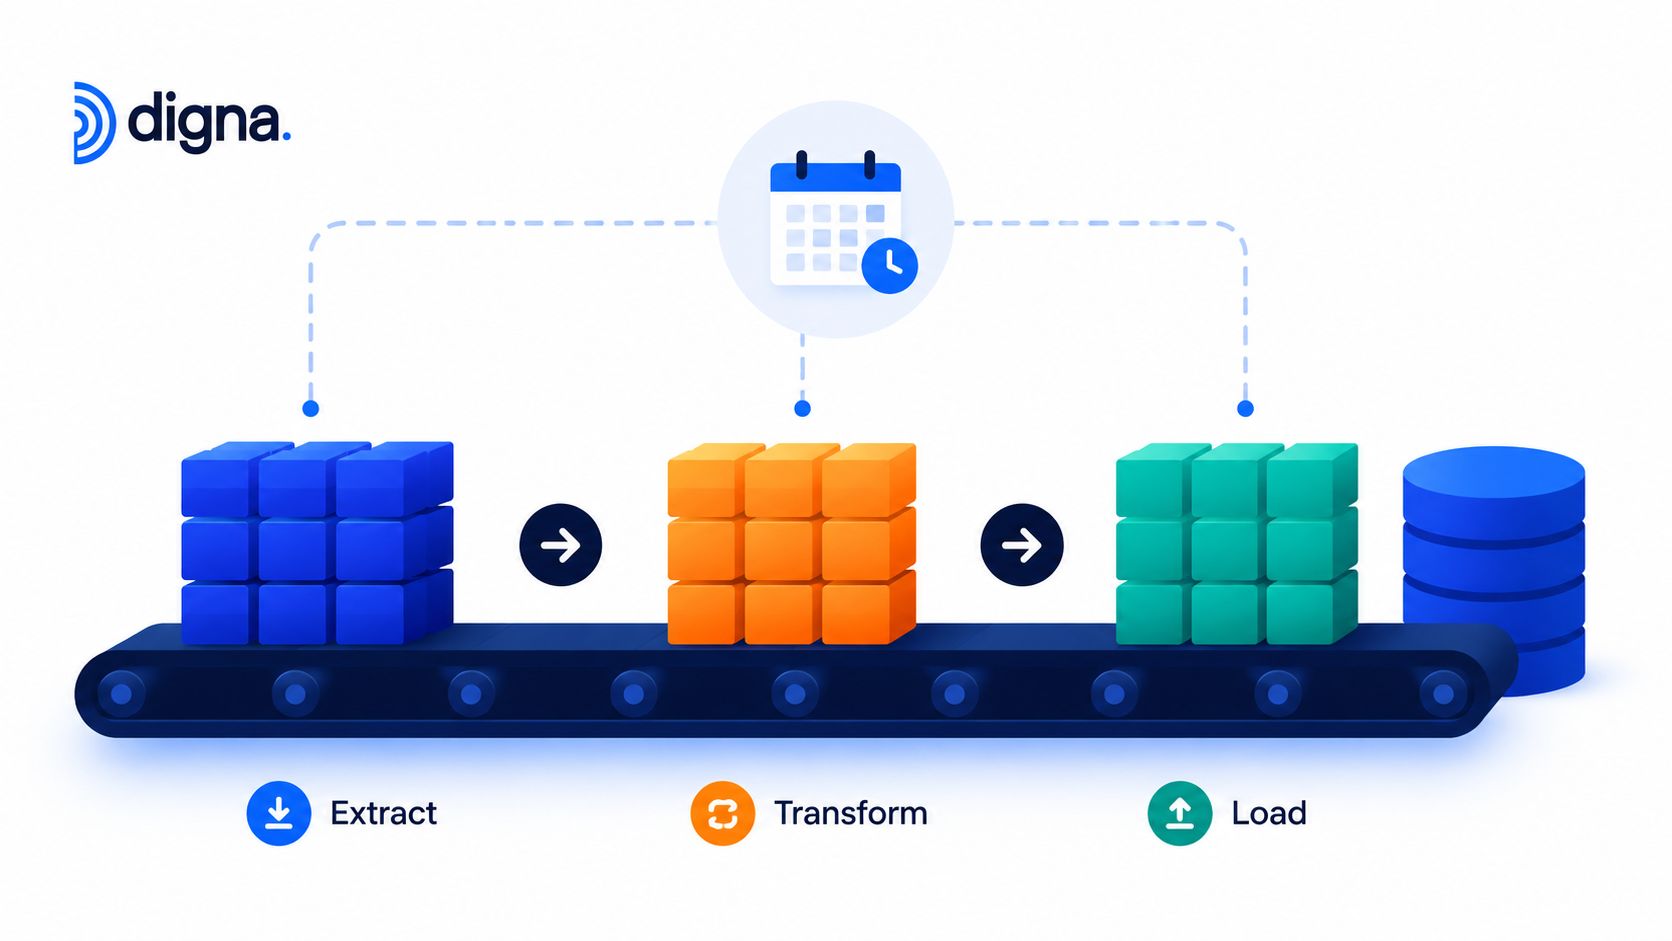
Les pipelines par lots restent l’épine dorsale de l’analytique d’entreprise. IBM souligne que les pipelines de traitement par lots demeurent l’architecture dominante pour l’analytique traditionnelle et la prise de décision fondée sur l’historique : ils traitent les données selon des calendriers fixes, par exemple toutes les heures, tous les jours ou toutes les semaines, et alimentent le reporting, la facturation et l’analyse historique à grande échelle grâce à des modèles ETL éprouvés dans les entrepôts et datamarts d’entreprise (IBM sur les architectures de pipeline de données).
Cela correspond aux observations courantes en production. Les chargements nocturnes de l’entrepôt Snowflake, la segmentation client quotidienne dans les systèmes marketing, le rapprochement hebdomadaire des stocks dans la distribution et le reporting financier de fin de journée se prêtent tous bien au traitement par lots. Si la décision métier est prise demain matin et non dans les prochaines secondes, le traitement par lots est souvent la conception la plus simple et la moins coûteuse.
Pour les équipes qui conçoivent les fondations, une référence claire de digna sur l’architecture de pipeline de données aide à déterminer où le traitement par lots a sa place et où il ne l’a pas.
Là où le traitement par lots reste gagnant
Le traitement par lots vous offre des points de contrôle clairs. Vous savez quand une exécution démarre, quand elle se termine et quelle partition ou quel ensemble de fichiers elle a traité. Cette structure facilite grandement les rechargements historiques, les rapprochements et les échanges liés aux audits, bien plus que dans des systèmes fonctionnant en continu.
Il fonctionne aussi bien lorsque les règles métier sont lourdes. Si vous normalisez des données financières issues de plusieurs grands livres ou calculez des modèles dimensionnels de niveau entrepôt, il est souvent préférable de traiter une tranche complète plutôt que de viser l’exactitude événement par événement.
Règle pratique : si le consommateur demande une exhaustivité historique fiable plutôt qu’une réaction immédiate, le traitement par lots est généralement le meilleur choix par défaut.
Ce qui tourne généralement mal
Le principal mode de défaillance n’est pas que le traitement par lots soit ancien. C’est que les équipes surveillent l’infrastructure plutôt que les données. Le DAG Airflow peut réussir alors qu’une table source arrive en retard, qu’un fichier arrive vide ou qu’une nouvelle colonne casse subtilement un modèle en aval.
Utilisez digna Timeliness pour détecter les lots retardés ou manquants avant qu’un tableau de bord ne devienne obsolète. Utilisez digna Data Validation pour appliquer des règles métier au niveau des enregistrements pendant les chargements, et Schema Tracker pour repérer les changements de colonnes ou de types avant qu’ils ne provoquent des défaillances en cascade dans la BI. Je recommande également de segmenter les lots par domaine logique afin qu’une extraction marketing défectueuse ne bloque pas la reprise de la paie ou de la finance.
2. Pipelines de streaming en temps réel
Le streaming est la solution vers laquelle se tournent les équipes lorsque la fraîcheur des données conditionne l’action, et pas seulement l’analyse. Hevo décrit les pipelines de streaming comme des systèmes d’ingestion continue qui mettent à jour les indicateurs, les rapports et les statistiques de synthèse en quelques secondes, voire quelques millisecondes, ce qui les rend essentiels pour la détection de la fraude, les tableaux de bord en direct, les moteurs de recommandation et d’autres charges de travail sensibles au temps dans des secteurs comme la finance et les télécommunications (Hevo sur les types de pipeline par lots et de streaming).
Cela semble séduisant, mais la vraie question est de savoir si vous avez suffisamment besoin de cette vitesse pour en payer la complexité. La surveillance des paiements, les alertes IoT, la visibilité des stocks en temps réel et les recommandations de produits fondées sur le parcours de navigation la justifient généralement. Un rapport hebdomadaire sur les KPI commerciaux, non.
Ce que le streaming vous apporte réellement
Le streaming réduit l’écart entre la création d’un événement et la décision. Les contrôles de paiement à la Stripe, les mises à jour logistiques alimentées par Kinesis ou les tableaux de bord opérationnels reposant sur Kafka dépendent tous de cette propriété.
L’architecture modifie aussi les comportements au sein de l’entreprise. Les équipes opérationnelles cessent d’attendre la synthèse de la veille et commencent à réagir à ce qui se passe en ce moment même.
Les difficultés opérationnelles
Les systèmes de streaming ne tombent pas en panne de la même manière que le traitement par lots. Vous n’obtenez pas simplement un « job en échec ». Vous obtenez des consommateurs en retard, des événements dans le désordre, des doublons, des enregistrements arrivés tardivement et une dérive de schéma dans un topic dont dépendent de nombreux services en aval.
Une configuration pratique avec digna se présente ainsi :
Détecter tôt les variations de débit : digna Data Anomalies peut apprendre le comportement normal des événements et faire apparaître des baisses ou des pics inattendus sans réglage permanent des seuils.
Surveiller la fraîcheur en continu : le calcul des métriques dans la base de données par digna est utile pour suivre les signaux de latence et de fraîcheur dont les opérateurs ont besoin au quotidien.
Se protéger contre l’évolution des topics : digna Schema Tracker aide à repérer les changements de schéma des événements avant qu’ils ne cassent les transformations de flux ou les couches de service.
Les systèmes de streaming ne tombent généralement pas en panne de manière bruyante. Ils se dégradent discrètement, puis quelqu’un remarque que le tableau de bord ne correspond plus à la réalité.
Si votre flux contient des événements opérationnels sensibles, le déploiement en cloud privé est important. Les équipes de la finance, de la santé et des télécommunications ont souvent besoin d’une observabilité au sein de leur propre environnement, et non d’une copie des données envoyée ailleurs.
3. Architecture lambda
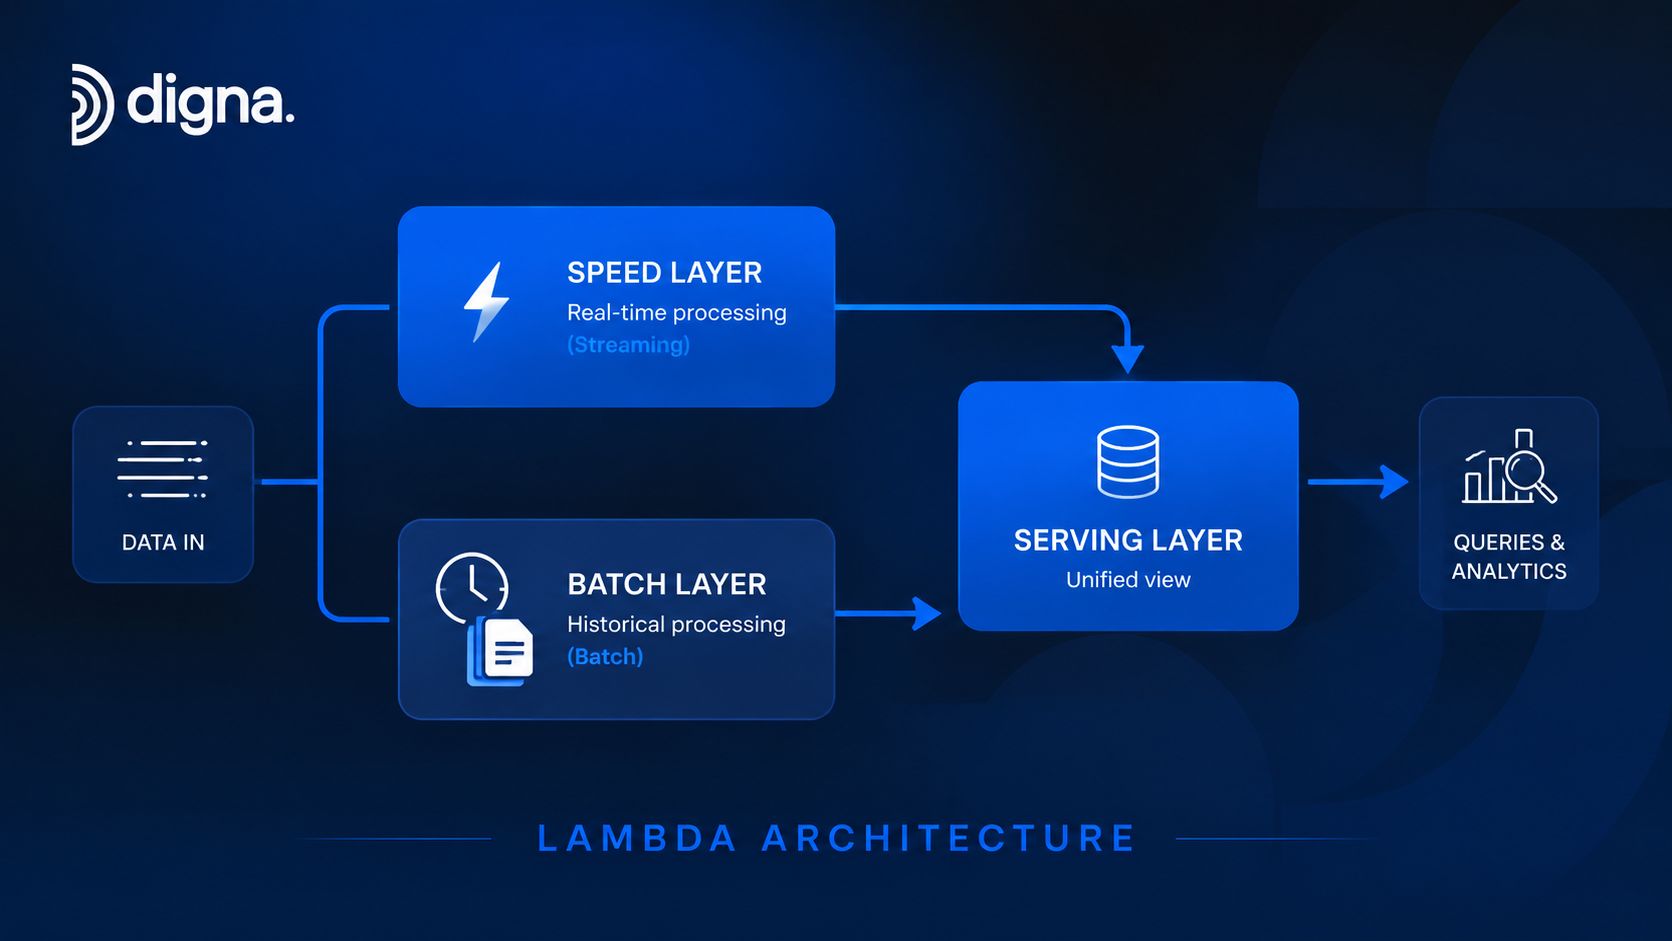
L’architecture lambda existe parce que certaines organisations ont besoin de deux choses à la fois : des réponses rapides maintenant et des réponses exactes plus tard. Elles combinent donc une couche de vitesse en streaming avec une couche par lots qui recalcule la vérité complète, puis fusionnent les deux dans une couche de service.
Ce modèle se retrouve encore dans l’analyse des risques, les systèmes de recommandation et les grandes plateformes analytiques où les chiffres intrajournaliers peuvent être approximatifs, mais où ceux de fin de journée doivent être corrigés. L’attrait est évident : vous n’avez pas à choisir entre latence et exhaustivité.
Pourquoi les équipes choisissent lambda
Lambda est utile lorsque le métier peut tolérer une approximation temporaire mais n’accepte pas une incohérence permanente. Un desk de gestion des risques peut avoir besoin immédiatement d’estimations d’exposition intrajournalières, puis s’appuyer sur un recalcul par lots plus complet pour le reporting officiel. Une équipe e-commerce peut diffuser des mises à jour comportementales en direct tout en réentraînant ou en recalculant par lots des signaux de recommandation plus larges.
Cette séparation peut réduire la pression sur chaque moteur. Le chemin de streaming gère l’immédiateté. Le chemin par lots gère la lourde vérité historique.
Quand lambda devient coûteuse
Le coût caché, c’est la logique dupliquée. Les équipes finissent souvent par implémenter deux fois des règles métier similaires, puis découvrent que le « suffisamment proche » de la couche de vitesse ne correspond pas au « correct » de la couche par lots. Dès que ces résultats divergent, la confiance s’érode rapidement.
Utilisez digna pour comparer les résultats des deux chemins, et pas seulement pour vérifier que chacun est au vert de son côté. Schema Tracker doit surveiller les deux couches, car une dérive dans l’une ou l’autre crée des incohérences subtiles. Data Validation a également sa place dans les deux flux, afin que les règles clés concernant les devises, les identifiants, les valeurs de statut ou la sémantique comptable ne divergent pas avec le temps.
Une bonne configuration lambda traite la divergence comme un signal de premier plan. digna Data Analytics est utile ici, car il aide les opérateurs à examiner où les approximations du streaming diffèrent systématiquement des corrections ultérieures par lots.
4. Architecture kappa
Kappa réduit lambda à un seul modèle de traitement. Tout est un flux. Les nouveaux événements passent par le même processeur de flux et, si vous devez retraiter l’historique, vous rejouez le journal avec la même logique au lieu de maintenir une couche par lots distincte.
Les ingénieurs l’apprécient parce que le chemin de code est plus simple. Kafka avec Kafka Streams ou Flink en est la forme habituelle. La télémétrie mobile, les plateformes SaaS orientées événements et les systèmes IoT s’y prêtent souvent bien lorsque le journal d’événements est durable et que le rejeu est réaliste.
Pourquoi les ingénieurs apprécient kappa
Le principal avantage est la cohérence. Un seul chemin de transformation signifie moins de risques de dérive de la logique métier. Si vous faites confiance à votre journal d’événements, le rejeu devient votre stratégie de reprise et de rechargement historique.
Cela fonctionne particulièrement bien dans les organisations qui raisonnent déjà en événements. L’analytique produit, les flux d’interactions utilisateur et les flux d’activité des microservices sont souvent plus faciles à gérer dans un modèle kappa que dans une conception séparant lots et streaming.
Ce qui peut faire échouer les systèmes fondés sur le rejeu
Le rejeu semble simple jusqu’à ce que vous vous heurtiez à la réalité opérationnelle. Les événements historiques peuvent ne plus correspondre au schéma actuel. Les consommateurs en aval peuvent ne pas être idempotents. Le retraitement peut submerger des systèmes dimensionnés uniquement pour le trafic en direct.
digna est le plus utile lorsque vous traitez le rejeu comme un mode d’exploitation observable, et non comme une urgence exceptionnelle. Définissez des références de ponctualité à la fois pour le flux en direct et pour les fenêtres de rejeu. Utilisez Schema Tracker sur le journal d’événements avant qu’un changement de version ne transforme le retraitement historique en cascade de défaillances. Appliquez aux événements rejoués les mêmes règles Data Validation qu’aux événements en direct, sinon vous certifierez un chemin tout en affaiblissant l’autre par inadvertance.
Retraiter ne consiste pas simplement à « relancer ». C’est un scénario de fiabilité à part entière, qui nécessite ses propres attentes.
5. Pipelines de capture des données modifiées (CDC)
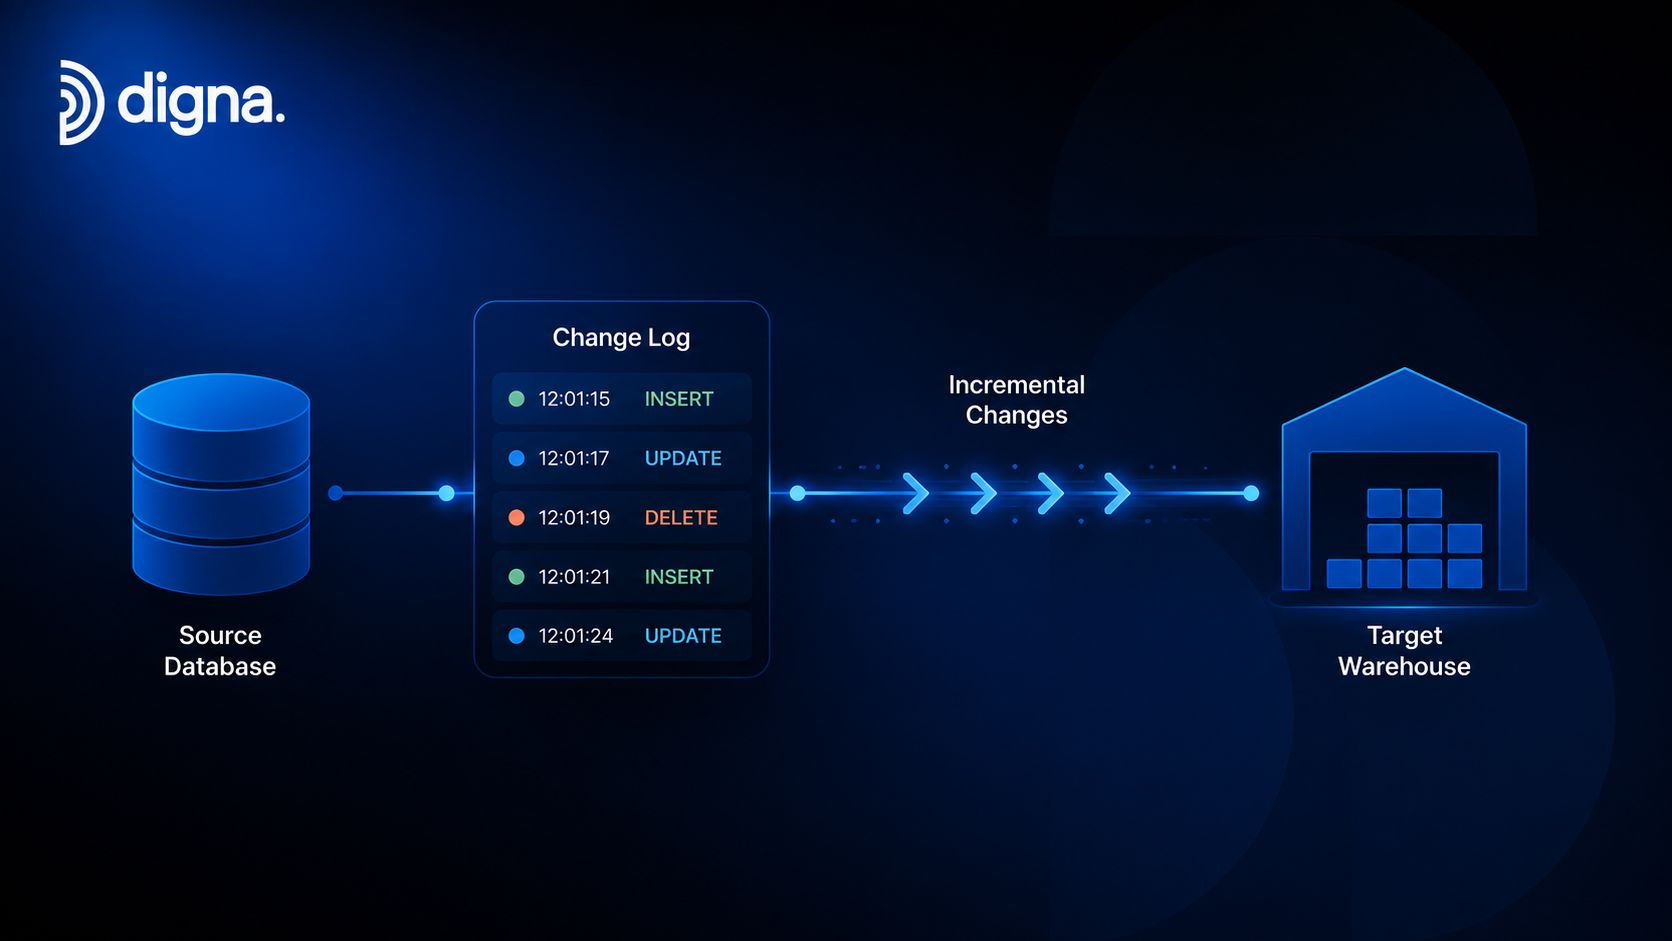
Les pipelines CDC ne déplacent que ce qui a changé. Au lieu de parcourir des tables entières à chaque exécution, ils capturent les insertions, mises à jour et suppressions des bases de données opérationnelles et propagent ces changements en aval. Debezium, AWS DMS et les mécanismes de réplication natifs sont des choix courants.
C’est l’un des types de pipeline de données les plus pratiques, car il réduit les recalculs inutiles et permet une synchronisation à plus faible latence entre les systèmes. Les datamarts de reporting, les synchronisations vers des entrepôts cloud et l’analytique opérationnelle obtiennent souvent de bien meilleurs résultats avec le CDC qu’avec des extractions complètes répétées.
Pourquoi le CDC progresse rapidement
Research and Markets prévoit que les pipelines CDC constitueront le deuxième segment à la croissance la plus rapide parmi les types de pipeline de données, avec un TCAC projeté de 18 % à 20 % jusqu’en 2030, à mesure que les entreprises recherchent une synchronisation à faible latence pour des cas d’usage tels que les mises à jour de stocks et de grands livres sans recalcul complet des tables (Research and Markets sur les segments d’outils de pipeline).
Cette croissance est logique. Les chargements de tables complètes sont un gaspillage lorsque seule une petite partie a changé, et ils sont risqués sur le plan opérationnel lorsque les systèmes sources sont sensibles à la charge d’extraction.
Le plus difficile n’est pas la capture
Le plus difficile, c’est de préserver le sens. Les suppressions doivent rester visibles en aval. L’ordre des mises à jour doit rester correct. Les modifications de clés primaires et les changements de schéma peuvent créer des doublons ou des enregistrements orphelins si le pipeline les traite comme de simples ajouts.
Un modèle d’exploitation CDC solide comprend :
Valider explicitement les suppressions : digna Data Validation peut confirmer que les systèmes en aval représentent les suppressions comme vos consommateurs l’attendent.
Mesurer le retard de réplication : digna Timeliness aide les opérateurs à voir quand les changements de la source arrivent trop lentement pour soutenir le processus métier.
Suivre l’évolution de la source : digna Schema Tracker est important pour le CDC, car les changements de la base de données source surviennent souvent hors du contrôle de l’équipe analytique.
Les rafales de suppressions suspectes ou les schémas de mise à jour anormaux méritent également d’être signalés avec digna Data Anomalies. En production, ces schémas révèlent souvent des bogues applicatifs avant que les développeurs ne les remarquent.
6. Pipelines de virtualisation des données
Tous les pipelines n’ont pas besoin de déplacer physiquement les données. La virtualisation des données crée une couche logique qui présente une vue unifiée de plusieurs systèmes tout en laissant les données en place. Denodo, les requêtes fédérées d’entrepôt, les tables externes Snowflake et la fédération BigQuery en sont des exemples familiers.
Ce modèle est utile lorsque la copie des données est lente, politiquement délicate ou restreinte par la gouvernance. Les établissements de santé peuvent avoir besoin d’une vue unifiée des patients à travers plusieurs systèmes hospitaliers. Les institutions financières peuvent avoir besoin d’une vue client transversale sans devoir d’abord intégrer chaque source historique dans un même entrepôt.
Quand la virtualisation est le bon choix
La virtualisation fonctionne bien lorsque l’accès compte davantage que les transformations lourdes. Elle offre rapidement aux équipes une interface sémantique commune et peut soutenir l’autonomie des domaines lorsqu’une consolidation centrale prendrait trop de temps ou déclencherait des conflits de propriété.
Elle réduit aussi les déplacements de données, ce qui est intéressant lorsque les systèmes sont volumineux, réglementés ou en évolution fréquente.
Où les couches virtuelles échouent en pratique
La plus grande erreur consiste à croire que la couche virtuelle élimine les problèmes des systèmes sources. Ce n’est pas le cas : elle les expose plus vite. Si une source est en retard, lente ou structurellement incohérente, le résultat fédéré hérite de cette faiblesse.
C’est pourquoi la surveillance de la qualité doit commencer à la périphérie des sources, et pas uniquement au niveau de la couche sémantique. digna, déployé en cloud privé, est utile ici, car les équipes peuvent surveiller la qualité et les changements de schéma des sources fédérées sans déplacer d’enregistrements sensibles. La surveillance de la ponctualité aide également à identifier quelle source dégrade les performances des requêtes ou la fraîcheur avant que le résultat virtualisé ne devienne inutilisable.
Une couche virtuelle peut unifier l’accès. Elle ne peut pas unifier la fiabilité si vous n’observez pas chaque source séparément.
7. Streaming d’événements avec event sourcing
L’event sourcing change la notion d’enregistrement de référence. Au lieu de ne stocker que l’état actuel, le système stocke chaque changement d’état sous forme d’événement immuable. Les abonnés construisent ensuite des projections, des vues matérialisées et des modèles de lecture en aval à partir de cet historique.
Cette architecture est donc intéressante pour la gestion des commandes, les pistes d’audit bancaires, le suivi du cycle de vie des courses et les systèmes CQRS où l’historique temporel compte autant que l’état présent. Si quelqu’un demande « Que savions-nous à ce moment-là ? », l’event sourcing peut y répondre clairement.
Ce que vous apportent les événements immuables
L’auditabilité est l’avantage le plus visible, mais le gain pratique est la reconstructibilité. Les équipes peuvent reconstruire des projections, examiner des transitions et comprendre exactement quels événements ont produit un état final.
Cela compte dans les environnements réglementés et dans les systèmes transactionnels complexes. Lorsqu’une commande passe de passée à emballée, puis à expédiée et enfin à remboursée, chaque transition a une signification opérationnelle.
Pourquoi l’observabilité compte davantage ici
Un système fondé sur l’event sourcing ne pardonne pas les événements malformés. Si un mauvais événement entre dans le journal, les projections en aval peuvent toutes l’interpréter différemment ou échouer à des endroits différents. La gestion des versions est également difficile, car anciens et nouveaux consommateurs peuvent coexister longtemps.
Utilisez digna Data Validation pour imposer la structure des événements et les champs obligatoires avant que les dégâts ne se propagent dans les chaînes d’abonnés. Utilisez Timeliness pour détecter les abonnés en retard, et Schema Tracker pour surveiller les transitions de version des événements afin que les producteurs ne cassent pas les anciennes projections sans prévenir. Data Anomalies est également utile pour repérer des séquences d’événements suspectes pouvant indiquer une fraude, un abus ou des bogues applicatifs.
Dans ces systèmes, « qualité du pipeline » et « exactitude applicative » se recoupent. C’est pourquoi une surveillance générique de l’infrastructure ne suffit pas.
8. Data mesh avec pipelines décentralisés
Le data mesh est moins un modèle de pipeline unique qu’un modèle d’exploitation pour de nombreux pipelines. Les équipes de domaine possèdent leurs produits de données et les pipelines qui les sous-tendent, tandis qu’une couche de gouvernance définit des normes communes en matière de découvrabilité, de qualité, de contrats et d’accès.
Cette approche séduit les grandes organisations où une équipe centrale de plateforme de données est devenue un goulet d’étranglement. Les équipes produit, finance, risques, marketing et opérations peuvent avancer plus vite lorsqu’elles sont propriétaires de leurs propres données.
Ce que la décentralisation résout
Elle résout la perte de contexte local. L’équipe de domaine comprend généralement mieux qu’une équipe centrale éloignée la signification des annulations, des utilisateurs actifs, des renouvellements de contrats ou des paiements échoués. Cela améliore les décisions de modélisation et le temps de réaction lorsque quelque chose change.
Elle permet aussi de passer la livraison à l’échelle. Vous n’avez pas un backlog central unique pour chaque extraction, mise à jour de schéma et demande de consommateur.
Un examen plus approfondi de l’architecture data mesh et de son impact actuel est utile si votre organisation s’éloigne d’une propriété centralisée.
Ce qui transforme le data mesh en chaos
Sans observabilité partagée, le data mesh devient une collection de défaillances isolées. Une équipe définit la fraîcheur d’une manière, une autre ignore les contrats de schéma, et les consommateurs se retrouvent face à cinq normes de qualité différentes selon le domaine qu’ils interrogent.
digna fonctionne bien ici comme couche unificatrice. Chaque domaine peut conserver son autonomie sur ses pipelines tout en utilisant les mêmes modèles Data Validation, le même cadre Timeliness et la même discipline Schema Tracker. Le déploiement en cloud privé ou sur site compte également, car les équipes décentralisées travaillent souvent dans des domaines métier sensibles qui ne peuvent pas envoyer de données de production hors d’environnements contrôlés.
Il ne s’agit pas de recentraliser la propriété. Il s’agit de standardiser la fiabilité sans gommer l’expertise des domaines.
9. Pipelines de features de machine learning
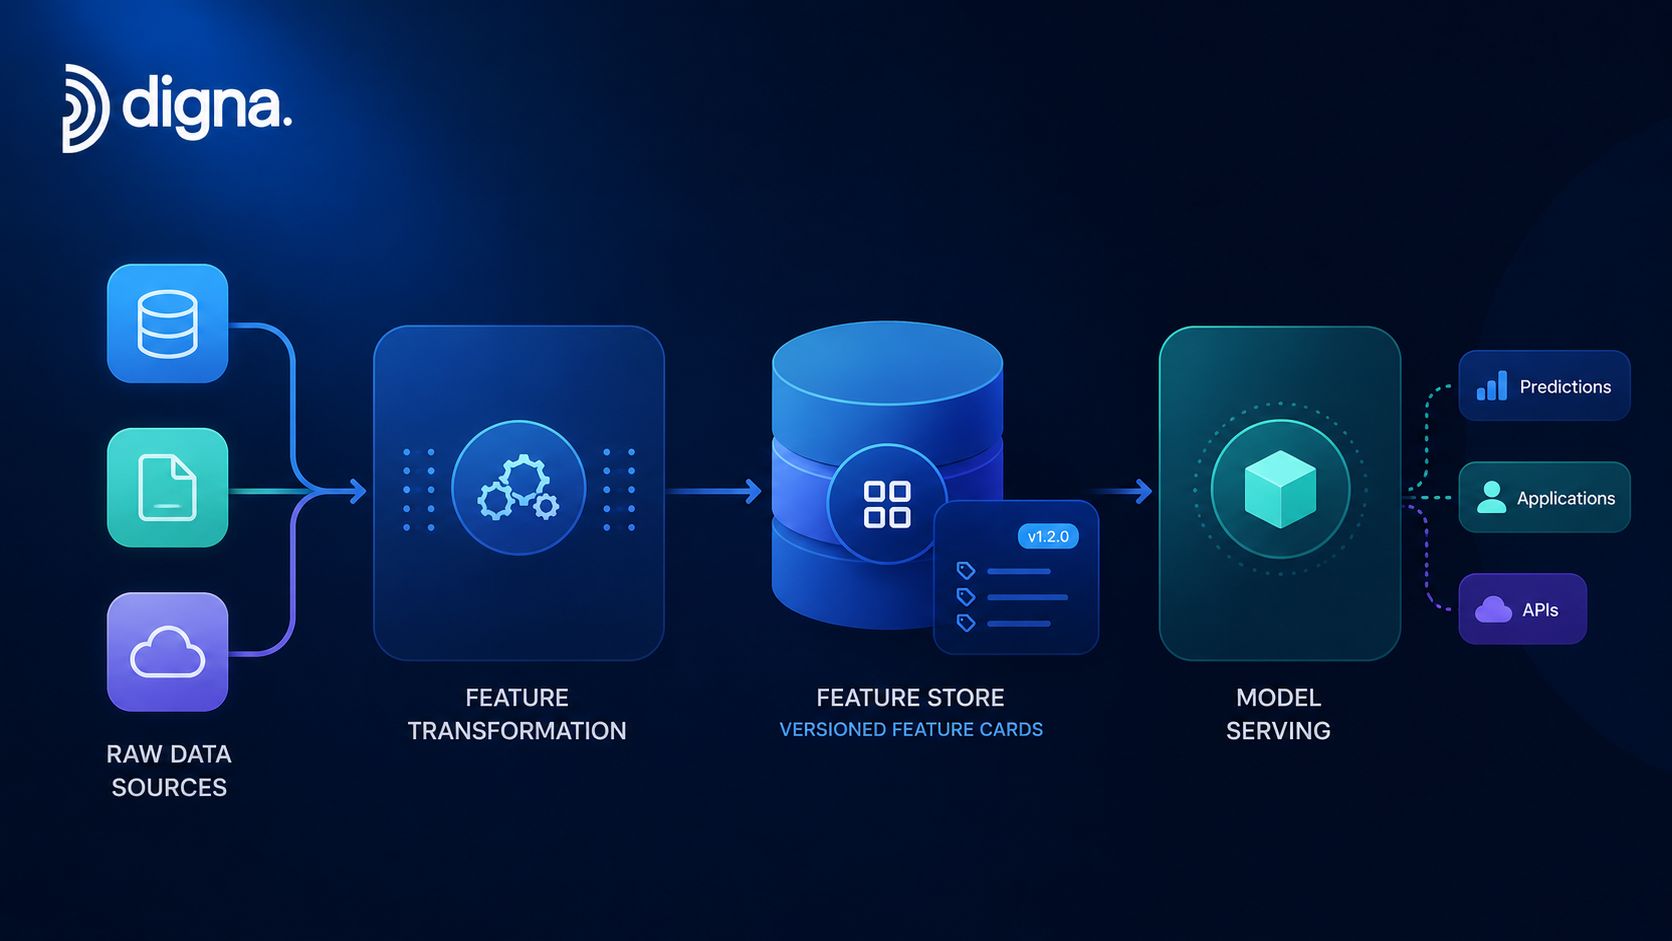
Les pipelines de features se situent entre l’ingénierie des données et les opérations de ML. Ils calculent, versionnent, stockent et servent les variables construites que les modèles utilisent pour l’entraînement et l’inférence. Feast, Databricks Feature Store et Tecton en sont des exemples courants.
Vus de loin, ils ressemblent aux autres types de pipeline de données, mais l’exigence opérationnelle est plus élevée. Un tableau de bord peut tolérer un indicateur obsolète pendant un certain temps. Un modèle en production peut se dégrader sans que personne ne s’en aperçoive si la fraîcheur des features, le traitement des valeurs nulles ou la distribution des valeurs changent et que personne ne le détecte.
Pourquoi les pipelines de features sont différents
Ils ont deux consommateurs aux besoins différents. Les systèmes d’entraînement ont besoin de reproductibilité et de cohérence historique. L’inférence en ligne a besoin de valeurs actuelles et d’une faible latence de service.
L’architecture varie aussi selon l’approche de transformation. GII Research note que l’ELT a largement dépassé l’ETL traditionnel dans les environnements cloud natifs, car la puissance de calcul évolutive des entrepôts permet une transformation efficace après chargement, tandis que l’ETL reste dominant là où un nettoyage strict avant chargement et l’application du schéma sont requis ; le déploiement dans le cloud est le mode dominant, et les approches hybrides utilisant des processus serverless comme AWS Glue et Azure Data Factory deviennent la norme pour les organisations qui doivent concilier passage à l’échelle et intégration de l’existant (GII Research sur le déploiement et l’ETL face à l’ELT).
La défaillance que les équipes remarquent trop tard
L’erreur courante consiste à surveiller le modèle tout en ignorant le pipeline de features. Lorsque les performances du modèle baissent, le problème sous-jacent des features peut être présent depuis plusieurs jours.
Une configuration d’observabilité pratique comprend :
Surveiller les comportements de type dérive dans les entrées : digna Data Anomalies peut signaler des changements inattendus dans les distributions des features avant qu’ils ne se traduisent par de mauvais résultats du modèle.
Surveiller la fraîcheur du service : digna Timeliness aide à repérer les features obsolètes avant que le store en ligne ne serve des valeurs dépassées.
Suivre les changements structurels : digna Schema Tracker est utile lorsque les définitions de features évoluent, que des colonnes apparaissent ou disparaissent, ou que les sorties de transformation changent de forme.
Les pipelines de features ont aussi besoin de contraintes métier strictes. Si une feature dérivée d’un prix devient négative ou si un champ de catégorie arrive vide, Data Validation doit bloquer le problème à la frontière du pipeline. Pour les équipes qui construisent des systèmes de personnalisation destinés aux clients, cela compte autant que le choix du modèle lui-même. Cette même discipline opérationnelle concerne aussi des systèmes voisins qui façonnent l’expérience, notamment les initiatives visant à optimiser les visuels e-commerce grâce à l’IA.
Comparaison des 9 types de pipeline de données
Pipeline / architecture | Complexité de mise en œuvre 🔄 | Ressources nécessaires & charge opérationnelle ⚡ | Résultats attendus (fraîcheur / exactitude) ⭐📊 | Cas d’usage idéaux 📊 | Principaux avantages & conseil rapide 💡 |
|---|---|---|---|---|---|
Pipelines de traitement par lots | Faible → modérée (jobs planifiés, exploitation plus simple) 🔄 | Efficace pour de gros volumes ; pics de contention des ressources pendant les fenêtres ⚡ | Grande exactitude ⭐⭐⭐, latence élevée (heures → jours) 📊 | Reporting nocturne, ETL à grande échelle, analytique périodique | Fiabilité éprouvée ; conseil : surveillez la ponctualité pour repérer les fenêtres manquées 💡 |
Pipelines de streaming en temps réel | Élevée (processeurs de flux & brokers distribués) 🔄 | Coûts de calcul & d’exploitation continus élevés ; nécessite du personnel spécialisé ⚡ | Latence très faible, fraîcheur quasi temps réel ⭐⭐📊 (l’exactitude dépend des garanties) | Détection de la fraude, tableaux de bord opérationnels, analytique en direct | Permet une détection instantanée ; conseil : utilisez la détection d’anomalies pour les schémas de streaming 💡 |
Architecture lambda | Très élevée (double chemin de code + couche de service) 🔄 | Très élevées (maintenir l’infrastructure par lots + streaming) ⚡ | Approximations à faible latence + corrections exactes par lots ⭐⭐⭐📊 | Charges de travail nécessitant à la fois une vue immédiate et un recalcul historique exact | Combine vitesse et exactitude ; conseil : validez la cohérence entre les couches grâce à la surveillance 💡 |
Architecture kappa | Élevée (streaming uniquement, capacité de rejeu) 🔄 | Élevées (stockage du broker pour l’historique et pics de retraitement) ⚡ | Logique cohérente, fraîcheur en temps réel ; retraitement possible ⭐⭐📊 | Systèmes orientés événements où le flux peut gérer le retraitement (Kafka/Flink) | Simplicité opérationnelle par rapport à lambda ; conseil : assurez la rétention du journal d’événements et surveillez les rejeux 💡 |
Pipelines de capture des données modifiées (CDC) | Modérée → élevée (accès aux journaux, mapping) 🔄 | Faible transfert réseau ; infrastructure modérée pour le traitement et l’ordonnancement ⚡ | Mises à jour incrémentielles à faible latence, haute fidélité ⭐⭐⭐📊 | Synchronisations incrémentielles, entrepôts en temps réel, datamarts de reporting | Minimise les déplacements de données ; conseil : suivez attentivement les changements de schéma et la gestion des suppressions 💡 |
Pipelines de virtualisation des données | Modérée (couche sémantique & connecteurs) 🔄 | Stockage faible mais exécution dépendante des performances des sources ; coûts variables ⚡ | Fraîcheur en temps réel mais performances de requête variables ⭐⭐📊 | Analytique ad hoc, requêtes fédérées, démonstrations rapides de gouvernance | Rapide à déployer avec un minimum de déplacements ; conseil : surveillez les SLA des sources et les performances des jointures 💡 |
Streaming d’événements avec event sourcing | Élevée (journal immuable, projections, versionnage) 🔄 | Stockage élevé pour l’historique complet ; complexité opérationnelle des projections ⚡ | Auditabilité et reconstructibilité complètes, analyse temporelle ⭐⭐⭐📊 | Pistes d’audit, CQRS, systèmes nécessitant l’historique complet et le rejeu | Excellent pour la conformité & le débogage ; conseil : validez les schémas d’événements et la ponctualité de leur arrivée 💡 |
Data mesh avec pipelines décentralisés | Élevée (complexité organisationnelle + technique) 🔄 | Infrastructure totale plus importante entre les domaines ; coûts d’outillage fédéré ⚡ | Résultats alignés sur les domaines et évolutifs ; qualité variable selon le domaine ⭐⭐📊 | Grandes organisations recherchant l’autonomie des domaines et des données conçues comme des produits | Passe à l’échelle grâce à l’autonomie ; conseil : imposez une observabilité fédérée et des contrats communs 💡 |
Pipelines de features de machine learning | Élevée (versionnage des features, exactitude à un instant donné) 🔄 | Stockage & calcul modérés → élevés ; exploitation du feature store ⚡ | Features cohérentes entre entraînement et service, réduit la dérive des modèles ⭐⭐⭐📊 | Feature stores, service de modèles, workflows de ML reproductibles | Améliore la fiabilité du ML ; conseil : surveillez en continu la fraîcheur et la dérive des features 💡 |
De l’architecture à l’exploitation : rendre votre pipeline fiable
Choisir la bonne architecture est la première décision importante. Ce n’est pas la dernière. Les pipelines par lots, de streaming, CDC, fondés sur l’event sourcing et orientés ML résolvent tous des problèmes de livraison différents, mais chaque architecture introduit aussi ses propres risques en matière de qualité et de fiabilité.
Les pipelines par lots masquent les retards jusqu’à ce qu’une exécution planifiée manque sa fenêtre. Les systèmes de streaming restent actifs tout en s’éloignant imperceptiblement du comportement attendu. Lambda crée des problèmes de cohérence entre les chemins. Kappa fait de l’exactitude du rejeu une préoccupation de premier plan. Le CDC peut répliquer rapidement les changements tout en gérant mal les suppressions ou l’ordre des mises à jour. La virtualisation peut unifier l’accès tout en masquant les faiblesses des systèmes sous-jacents. Le data mesh peut accélérer les domaines tout en fragmentant les normes. Les pipelines de features peuvent continuer à servir des données longtemps après que les entrées du modèle sont devenues mauvaises.
Cette réalité opérationnelle explique pourquoi les schémas d’architecture ne suffisent pas. Chaque pipeline en production a besoin d’une couche de contrôle qui vous indique si les données arrivent à temps, si les enregistrements respectent toujours les règles métier, si les schémas ont changé et si les tendances des données paraissent toujours normales. Si vous ne surveillez que les jobs, les conteneurs ou les dépenses de l’entrepôt, vous passerez à côté des défaillances qui ruinent la confiance.
Les meilleures équipes intègrent l’observabilité et la validation dans le pipeline dès le premier jour. Elles n’attendent pas la première panne d’un tableau de bord de direction ni le premier incident de modèle. Elles définissent le comportement d’arrivée attendu. Elles suivent les changements de schéma avant que les systèmes en aval ne cassent. Elles valident les enregistrements clés au moment de leur déplacement, et non après que les analystes ont ouvert des tickets. Elles examinent les anomalies dans leur contexte au lieu de s’appuyer uniquement sur des seuils fragiles réglés à la main.
C’est là que digna s’intègre bien dans tous les grands types de pipeline de données. Sa combinaison de Timeliness, Data Validation, Schema Tracker, Data Anomalies et Data Analytics répond aux schémas de défaillance auxquels les ingénieurs sont confrontés en pratique. Comme il calcule les métriques au sein de la base de données du client et prend en charge le déploiement en cloud privé ou sur site, les équipes peuvent surveiller des environnements sensibles sans confier leurs données de production à un fournisseur externe.
Il y a aussi un avantage stratégique. Lorsque les parties prenantes peuvent avoir confiance dans le fait que la fraîcheur, la structure et la validité des enregistrements sont activement surveillées, les discussions d’architecture s’améliorent. Les équipes cessent de débattre des styles de pipeline dans l’abstrait et commencent à choisir la conception adaptée au besoin métier, avec un plan clair pour l’exploiter en toute sécurité.
Des pipelines de données fiables ne se limitent pas à déplacer des données d’un point A à un point B. Il s’agit de fournir des données sur lesquelles les utilisateurs peuvent agir sans les remettre en question. C’est l’exigence pour laquelle il vaut la peine de concevoir.
Si vous souhaitez ce niveau de contrôle sur les pipelines par lots, de streaming, CDC, de features et les produits de données décentralisés, digna est conçu pour cela. Il offre aux équipes data une plateforme unique pour la détection d’anomalies, la validation au niveau des enregistrements, la surveillance de la ponctualité, le suivi des changements de schéma et l’analyse historique de l’observabilité, tout en conservant les données dans des environnements contrôlés par le client.
Les exécutions par lots qui manquent leur fenêtre et les flux CDC dont le retard de réplication augmente partagent un même symptôme : des données qui arrivent plus tard que ne l’attend le métier. C’est précisément ce que digna Timeliness apprend et signale par des alertes.
Questions fréquentes
Quels sont les principaux types de pipeline de données ?
L’article en présente neuf : le traitement par lots, le streaming en temps réel, lambda, kappa, la capture des données modifiées, la virtualisation des données, le streaming d’événements avec event sourcing, le data mesh avec pipelines décentralisés et les pipelines de features de machine learning. Chacun résout un problème de livraison différent et comporte ses propres risques en matière de qualité et de fiabilité, qu’il faut surveiller dès le premier jour.
Quand faut-il utiliser le traitement par lots plutôt que le streaming ?
Choisissez le traitement par lots lorsque la décision métier est prise demain matin plutôt que dans les prochaines secondes. Les chargements nocturnes de l’entrepôt Snowflake, le rapprochement hebdomadaire des stocks dans la distribution et le reporting financier de fin de journée s’y prêtent bien, tandis que la détection de la fraude, les alertes IoT et les tableaux de bord en direct justifient généralement le coût et la complexité supplémentaires du streaming.
Quelle est la différence entre l’architecture lambda et l’architecture kappa ?
Lambda fait fonctionner deux chemins : une couche de vitesse en streaming pour des réponses rapides et approximatives, et une couche par lots qui recalcule la vérité complète, les deux étant fusionnées dans une couche de service. Kappa traite tout comme un flux et retraite l’historique en rejouant le journal d’événements avec la même logique, généralement avec Kafka et Kafka Streams ou Flink.
Qu’est-ce qui tourne généralement mal avec les pipelines de capture des données modifiées ?
La capture pose rarement problème ; c’est la préservation du sens qui en pose. Les suppressions doivent rester visibles en aval, l’ordre des mises à jour doit rester correct, et les modifications de clés primaires ou les changements de schéma peuvent créer des doublons ou des enregistrements orphelins lorsqu’ils sont traités comme de simples ajouts. Research and Markets prévoit une croissance des pipelines CDC à un TCAC de 18 % à 20 % jusqu’en 2030.
Comment surveiller les pipelines de features de machine learning ?
Surveillez le pipeline de features lui-même, et pas uniquement le modèle, car des problèmes de features peuvent passer inaperçus pendant des jours avant que les performances ne baissent. L’article recommande de surveiller la dérive des distributions des features, de vérifier la fraîcheur du service afin que le store en ligne ne serve jamais de valeurs obsolètes, de suivre les changements de schéma et de valider des contraintes strictes, comme des features de prix non négatives.



