Table système des métriques : schéma, requêtes et bonnes pratiques
|
9
minute de lecture

Le propriétaire d'un tableau de bord ouvre son rapport matinal et constate que les chiffres n'ont pas changé depuis deux jours. Le pipeline lui-même est au vert, l'entrepôt est disponible et aucune tâche n'a échoué. Plus tard, quelqu'un découvre qu'une colonne en amont a changé de type, qu'une transformation a omis une partie de ses données d'entrée ou que la dernière partition n'est jamais arrivée. L'incident n'a pas été causé par un tableau de bord manquant, mais par un manque de preuves opérationnelles.
Une table de métriques système fournit ces preuves sous une forme requêtable. Au lieu de disperser les vérifications dans des notebooks, des scripts shell, des métadonnées d'entrepôt et des outils de surveillance externes, les équipes peuvent enregistrer les signaux au niveau des tables et des colonnes dans un registre opérationnel unique. Ce registre peut prendre en charge les vérifications de fraîcheur, l'analyse des volumes, la détection des changements de schéma, l'investigation historique, les flux de travail de responsabilité (ownership) et les pistes d'audit, sans transformer chaque investigation en un projet d'ingénierie sur mesure.
Table des matières
Pourquoi les équipes de données ont besoin d'une table de métriques système
L'écart pratique entre la collecte et l'action
Qu'est-ce qu'une table de métriques système ?
Pourquoi la séparation est importante
Métadonnées du fournisseur versus registre interne contrôlé
Schéma de référence et modèles de conception de colonnes
Un modèle de référence
Clés et chemins d'accès
Requêtes SQL pratiques pour les tâches courantes d'Observability
Violations de fraîcheur
Anomalies de volume
Écart de schéma
Stratégies de rétention et d'agrégation
Rétention des données brutes uniquement
Résumés par tranches de temps
Rétention hiérarchisée (tiered)
Connecter les métriques aux signaux de fraîcheur et d'écart de schéma
Corrélation des signaux
Une matrice de décision pour des réponses à faible bruit
Quand l'excès de métriques réduit l'efficacité de l'Observability
Prioriser par les conséquences
Supprimer les vérifications qui n'influencent pas les décisions
Instrumentation des tables de métriques dans les plateformes d'entreprise
Un modèle de déploiement robuste
Protéger les performances
Governance et auditabilité dans les secteurs réglementés
Séparer les rédacteurs des lecteurs
Référence rapide pour la conception de tables de métriques système
Modèles de requêtes de production
Les seuils ont besoin de contexte
Pourquoi les équipes de données ont besoin d'une table de métriques système
Une équipe de données remarque généralement les problèmes de fiabilité via ses utilisateurs finaux. Un analyste signale qu'un tableau de bord des revenus n'est pas à jour. Un utilisateur de la finance repère un changement inattendu dans un rapport. Un ingénieur en machine learning constate qu'une table de caractéristiques (feature table) contient un type inconnu ou une concentration inhabituelle de valeurs manquantes. À ce stade, le système a déjà failli à sa mission opérationnelle, même si toutes les tâches d'orchestration se sont déroulées avec succès.
La couche manquante est souvent un ensemble restreint de primitives d'Observability durables. Une table de métriques système peut capturer le nombre de lignes, le taux de valeurs manquantes, le comportement des valeurs distinctes, les horodatages, la latence et les empreintes de schéma au niveau de la table ou de la colonne. Ces valeurs transforment un changement invisible en un enregistrement que le SQL peut inspecter, comparer, conserver et attribuer à un responsable.
Cette distinction est essentielle car le statut du pipeline ne répond qu'à une seule question : la tâche a-t-elle été exécutée ? Il ne dit pas si les données sont arrivées à temps, si le volume produit est plausible, si une colonne critique a changé, ou si un processus métier en aval peut faire confiance au résultat. Une fondation de Data Observability intègre ces signaux à la vue opérationnelle globale.
L'écart pratique entre la collecte et l'action
Les scripts ad-hoc conviennent souvent pour une première vérification. Ils deviennent difficiles à gouverner lorsque chaque équipe met en œuvre ses propres conventions de nommage, seuils, calendriers et destinations d'alerte. Les outils externes peuvent élargir la couverture, mais ils risquent de diviser les définitions de métriques, le contexte historique et les métadonnées de propriété (ownership) entre plusieurs systèmes.
Une table centralisée offre aux ingénieurs une interface stable :
Détection : stocker la valeur observée et l'heure à laquelle elle a été calculée.
Comparaison : l'évaluer par rapport à une référence (baseline), à un niveau de service attendu (SLA) ou à une période précédente.
Escalade : associer un niveau de gravité, un responsable, une procédure opérationnelle (runbook) et un statut.
Preuve : conserver la trace de ce qui a été vérifié, du moment de l'exécution et du résultat produit.
Règle pratique : Une métrique n'est pas opérationnelle tant que l'on ne peut pas l'interroger, identifier son responsable, décider de l'action qu'elle doit déclencher et analyser son historique.
Les tables de métriques d'Oracle illustrent ce passage d'une inspection ponctuelle et manuelle à un suivi standardisé, en temps réel et historique. Oracle 10g a introduit des tables de métriques calculant des deltas et des taux, simplifiant par exemple l'analyse du taux d'E/S de la base de données en temps réel. Les vues historiques associées facilitent l'analyse des tendances, notamment DBA_HIST_SYSMETRIC_SUMMARY pour les analyses sur plusieurs jours et DBA_HIST_METRIC_NAME pour identifier les métriques dans un dépôt AWR partagé. L'historique des tables de métriques d'Oracle et le suivi opérationnel démontrent pourquoi cette approche reste d'actualité : les équipes ont besoin à la fois de l'état actuel et des preuves nécessaires pour comprendre comment cet état s'est constitué.
Sans table de métriques système, les équipes subissent les plaintes des utilisateurs. Avec une telle table, elles peuvent détecter les dégradations avant même qu'un utilisateur n'ouvre un ticket, corréler plusieurs signaux et générer des preuves conformes aux exigences de gouvernance à partir d'un même registre opérationnel.
Qu'est-ce qu'une table de métriques système ?
Une table de métriques système est un registre opérationnel à faible latence d'observations calculées sur les actifs de données. Elle enregistre des mesures issues des tables utilisateurs, des pipelines ou des métadonnées de plateforme, sans remplacer les données sous-jacentes ni créer de copie supplémentaire dans l'entrepôt.
Une table orientée utilisateur contient des entités métier (commandes, utilisateurs, événements, réclamations). Une table de métriques enregistre des observations sur ces entités, comme le nombre de lignes à un instant t, l'horodatage du dernier événement, le ratio de valeurs manquantes, l'estimation de la cardinalité, l'empreinte du schéma ou le résultat d'une validation. La valeur mesurée a sa place dans l'enregistrement de la métrique ; les lignes sources restent dans l'application ou dans la table analytique.
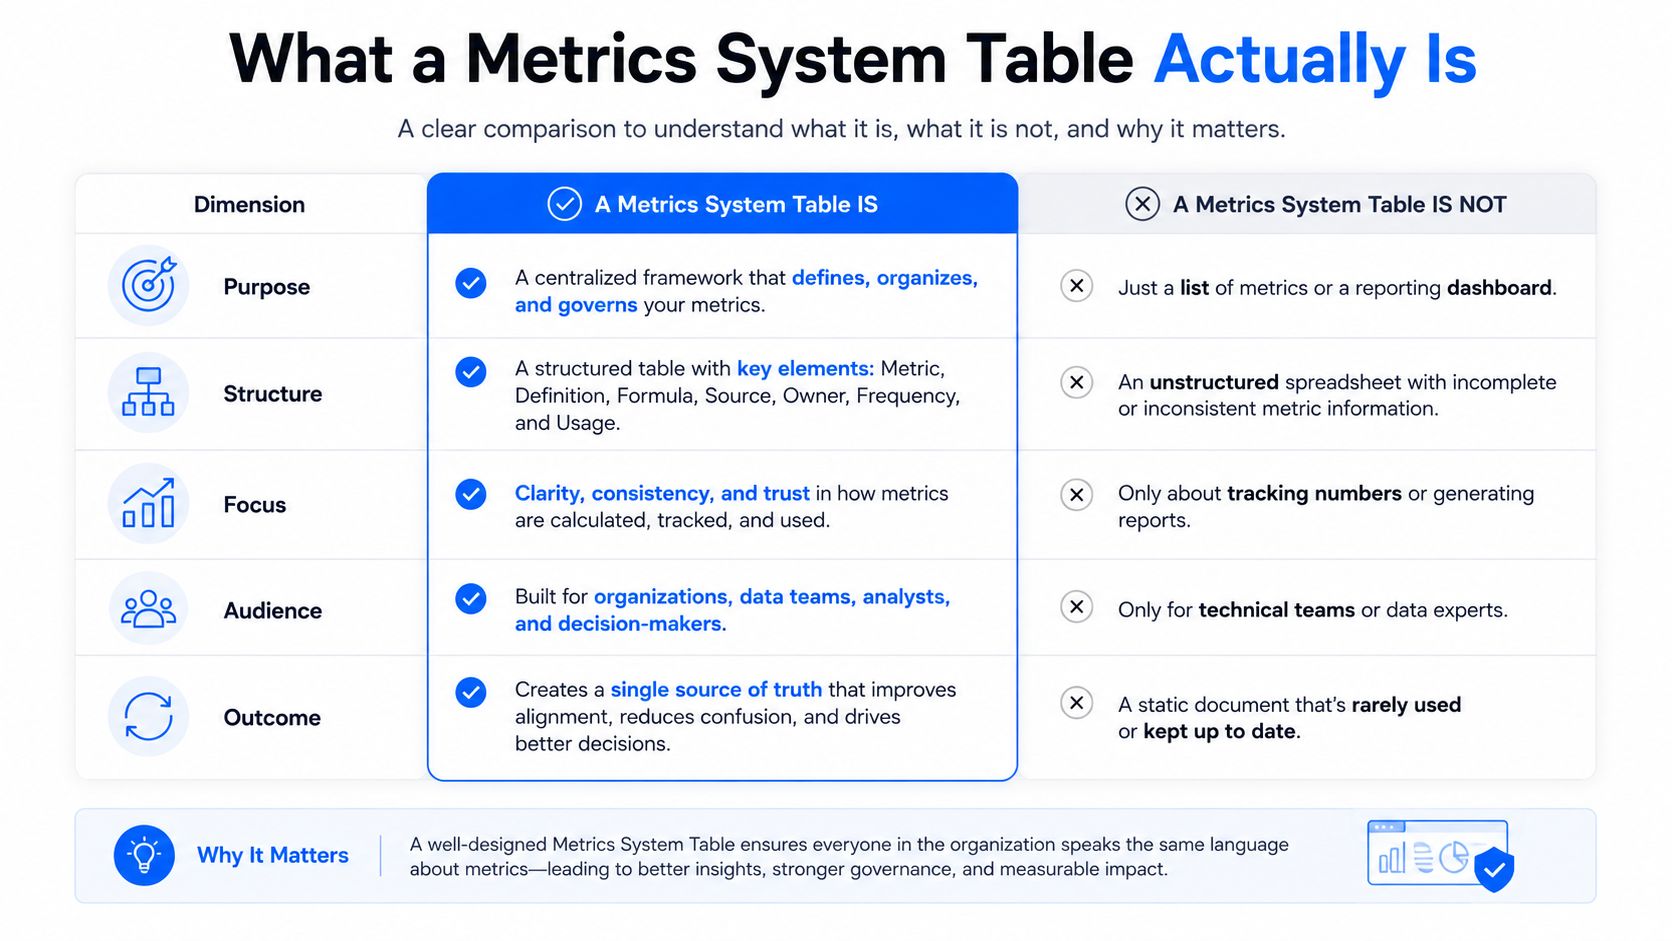
Pourquoi la séparation est importante
Les deux charges de travail présentent des profils différents. Les tables utilisateurs gèrent des transactions, des jointures, des agrégations ou des flux d'ingestion. Une table de métriques système est généralement conçue pour des requêtes par fenêtre temporelle, des recherches filtrées, des écritures de type ajout uniquement (append-only) et des comparaisons historiques. La traiter comme une table de faits transactionnelle alourdirait le stockage et les requêtes sans améliorer les décisions opérationnelles.
Un enregistrement pratique peut inclure :
Dimensions : base de données, schéma, table, colonne, type de métrique, environnement et domaine métier.
Mesures : valeur observée, nombre de lignes affectées, utilisation des ressources ou score d'anomalie.
Métadonnées d'exécution : heure du calcul, identifiant de la requête ou de la tâche source, version de la vérification et statut du résultat.
Contexte de gouvernance : responsable, gravité, référence de lignage (lineage) et état de remédiation.
La table doit également permettre la priorisation. Un flux volumineux de mesures ne constitue pas en soi un processus d'alerte. Les équipes ont besoin de seuils, de définitions de responsabilités et de champs de statut pour filtrer les variations normales et isoler les incidents nécessitant une intervention. Conserver ces décisions au plus près de l'observation enregistrée favorise des opérations à faible bruit, prêtes pour l'audit, et permet d'exécuter les contrôles directement sur les données de la base sans avoir à tout exporter.
Cette conception correspond au rôle de couche de métadonnées dévolu aux tables système relationnelles. Elles exposent des signaux de profilage et de surveillance plutôt que de simples lignes applicatives. Un agrégat compact et horodaté peut faire office de registre opérationnel tout en maîtrisant le stockage et le coût des requêtes, conformément aux directives de conception des tables système.
Métadonnées du fournisseur versus registre interne contrôlé
Snowflake, BigQuery et Databricks fournissent des métadonnées générées par le système, un historique des requêtes, un historique des tables et des vues sur les schémas d'information (information-schema). Ces sources facilitent l'inspection spécifique à chaque plateforme, mais elles ne proposent pas nécessairement la politique de rétention, le modèle de nommage, les règles métier, les champs de propriété ou le schéma multiplateforme requis par une grande entreprise.
Une table personnalisée permet à une équipe de définir :
quelles métriques font foi,
la fréquence de calcul de chaque métrique,
la durée de disponibilité des enregistrements bruts et résumés,
les seuils qui déclenchent des incidents,
et quelles métadonnées peuvent être consultées par les auditeurs et les délégués aux données (data stewards).
Ce contrôle est primordial lorsqu'un résultat de fraîcheur, un événement de schéma ou une validation métier doit rester compréhensible même après la modification du pipeline d'origine. Une couche sémantique peut standardiser le sens métier au-dessus de ces signaux sans masquer le registre opérationnel. Les équipes qui s'interrogent sur cette frontière peuvent comparer l'approche par registre avec une couche sémantique dbt.
Schéma de référence et modèles de conception de colonnes
Un schéma efficace distingue clairement ce qui a été mesuré, la valeur observée et la manière dont l'observation a été produite. Combiner ces rôles dans une seule colonne surchargée complique le filtrage, la rétention et le déclenchement des alertes.
Privilégiez d'abord un modèle d'événements restreint. Des dimensions statiques identifient l'actif de données et la métrique. Des champs dynamiques stockent le résultat à un instant donné. Les métadonnées d'exécution expliquent le calcul et fournissent aux opérateurs le contexte nécessaire pour reproduire ou résoudre le résultat.
Un modèle de référence
Nom de la colonne | Type de données | Objectif | Exemple de valeur |
|---|---|---|---|
|
| Nom complet de la table mesurée |
|
|
| Colonne mesurée (valeur nulle possible pour les métriques de table) |
|
|
| Identifiant de la métrique |
|
|
| Heure à laquelle la métrique a été calculée |
|
|
| Résultat numérique |
|
|
| Seuil minimal acceptable |
|
|
| Seuil maximal acceptable |
|
|
| Résultat de l'évaluation |
|
|
| Définition de la vérification et contexte de diagnostic |
|
Les types précis varient selon les plateformes, mais le principe de conception reste le même. Utilisez DECIMAL pour les ratios dès que la précision est requise, TIMESTAMP WITH TIME ZONE pour les heures d'observation, et un champ structuré d'extension comme JSONB pour stocker des détails évolutifs (raisons d'un échec, définitions de filtres ou identifiants de tâche source). Ne placez pas les dimensions de filtrage essentielles à l'intérieur du JSON si les opérateurs les interrogent régulièrement : intégrez-les plutôt sous forme de colonnes indexées.
Une implémentation de type PostgreSQL pourrait se présenter ainsi :
Clés et chemins d'accès
La clé composite empêche la création d'observations en double pour un même actif, une même métrique et une même heure de calcul. Dans les systèmes où plusieurs exécutions successives peuvent générer différents résultats légitimes, ajoutez un identifiant d'exécution (run identifier) afin que la règle d'unicité reflète ce modèle d'exécution au lieu d'écraser les preuves.
Configurez des chemins d'accès adaptés aux questions réelles des opérateurs :
Une requête recherchant les défauts de fraîcheur récents peut ainsi filtrer par type de métrique et plage horaire, évitant ainsi d'analyser des contrôles sans rapport. Les conseils de MySQL sur les schémas d'information soulignent ce même enjeu opérationnel sous un autre angle : les métadonnées dynamiques (nombre de lignes, taille des données, taille des index, heure de mise à jour et cardinalité) peuvent générer un surcoût important. Les équipes doivent donc limiter leurs requêtes aux objets requis et éviter les analyses globales. Les recommandations d'optimisation des schémas d'information préconisent ainsi un accès filtré par schéma, table, type de métrique et fenêtre temporelle.
Le schéma doit également étre documenté en parallèle des contrôles qui l'alimentent. Si un catalogue de schémas d'entrepôt aide à comprendre les dépendances, le registre de métriques doit rester optimisé pour l'accès opérationnel, et non pour l'exhaustivité descriptive. Reportez-vous aux schémas dans un entrepôt de données pour définir la frontière entre métadonnées structurelles et preuves de surveillance.
Requêtes SQL pratiques pour les tâches courantes d'Observability
Le SQL révèle son utilité lorsque chaque requête apporte une réponse opérationnelle précise avec le contexte nécessaire à la prise de décision. Les modèles suivants s'appuient sur la table de référence de la section précédente et emploient la syntaxe de type PostgreSQL. Snowflake, BigQuery et Redshift nécessiteront de légères adaptations syntaxiques pour les horodatages, les centiles et les fonctions de date.
Violations de fraîcheur
Enregistrez le dernier horodatage observé de la source sous forme de metric_value pour une métrique de fraîcheur, ou stockez-le dans des métadonnées structurées si la plateforme exige une valeur d'âge numérique distincte. La requête ci-dessous compare la dernière observation avec un SLA stocké dans une table de configuration.
Partitionnez la table par computed_at si la plateforme le permet. L'utilisation d'un prédicat temporel limité active l'exclusion de partitions (partition pruning) et évite de parcourir tout l'historique.
Anomalies de volume
Une référence glissante (rolling baseline) doit refléter les variations normales plutôt qu'une seule exécution passée. Cet exemple utilise une moyenne et un écart-type glissants appliqués aux métriques historiques du nombre de lignes.
Appliquez une clé de partition ou de clustering sur le nom de la table et l'heure d'observation. La marge exacte doit correspondre au risque métier et à la saisonnalité, plutôt qu'à une constante universelle.
Écart de schéma
La détection des écarts de schéma est facilitée lorsqu'un instantané de référence (baseline snapshot) est conservé sous la forme d'une famille de métriques dédiée. La requête ci-dessous compare l'empreinte actuelle du schéma avec le dernier instantané validé.
Les équipes qui souhaitent mesurer l'écart de schéma de manière opérationnelle peuvent suivre la fréquence d'écart (drift frequency) et la latence de détection d'écart (drift detection latency), définies comme le nombre de modifications de schéma sur une période donnée et le délai s'écoulant entre une modification et sa détection. Les directives de surveillance des écarts de schéma détaillent ces mesures sans imposer que chaque modification structurelle devienne systématiquement un incident.
Tâche d'Observability | Modèle SQL principal | Fonctions clés | Seuil classique |
|---|---|---|---|
Fraîcheur | Dernière observation versus âge configuré |
| SLA dédié à la table |
Anomalie de volume | Référence glissante et bande d'écart |
| Dépendant de la référence |
Écart de schéma | Instantané actuel comparé à la référence |
| Ajout, suppression ou changement de type |
Suivi du taux de valeurs nulles | Ratio actuel versus référence |
| Tolérance spécifique à la colonne |
Suivi de la latence | Intervalle entre exécutions et durée d'exécution |
| Attentes spécifiques au pipeline |
Conservez ces requêtes dans un système de contrôle de version et révisez-les comme du code de production. Les pratiques d'optimisation des requêtes SQL s'avèrent particulièrement utiles dès lors que la table de métriques accumule plusieurs mois d'observations.
Stratégies de rétention et d'agrégation
Les observations brutes sont précieuses lors de la résolution d'un incident, mais elles deviennent coûteuses si elles sont conservées sans planification. Une table de métriques qui enregistre chaque exécution, actif et vérification peut croître rapidement ; la rétention doit donc correspondre aux questions réelles des opérateurs.
Trois grands modèles couvrent la majorité des déploiements.
Rétention des données brutes uniquement
Ce modèle conserve des enregistrements détaillés et les purge à l'aide d'une politique de durée de vie (TTL). Il garantit un excellent niveau de détail pour les analyses après-coup, notamment le contexte exact de l'exécution et l'enchaîne d'un incident. L'inconvénient réside dans le fait que les requêtes sur les tendances historiques doivent analyser davantage de lignes, ce qui exige une gestion rigoureuse du partitionnement de la table.
La rétention brute convient particulièrement lorsque l'investigation d'incidents est l'usage principal ou lorsque la plateforme propose déjà un partitionnement économique. Elle est moins adaptée si les équipes de gouvernance ont besoin d'analyser des tendances sur le long terme et que les opérateurs interrogent régulièrement l'ensemble de la table.
Résumés par tranches de temps
Les synthèses horaires ou quotidiennes stockent des agrégats (minimum, maximum, moyenne, nombre total, dernière valeur et nombre d'anomalies). Elles accélèrent l'analyse des tendances et réduisent la quantité de données historiques devant rester disponibles dans l'entrepôt principal. Le compromis réside dans l'irréversibilité : un résumé quotidien peut signaler qu'une table a présenté un comportement anormal, mais il ne permettra pas de déterminer précisément quelle exécution, colonne ou vérification a provoqué le premier écart.
Utilisez des vues matérialisées ou des modèles dbt incrémentaux pour générer ces résumés. Effectuez un partitionnement par date de tranche (bucket date) et conservez les dimensions requises par les filtres les plus fréquents (table, type de métrique, domaine et environnement).
Rétention hiérarchisée (tiered)
Ce modèle hybride conserve les enregistrements bruts pendant une courte période opérationnelle, tout en stockant des synthèses agrégées pour les analyses à plus long terme. Il concilie le besoin de détails lors d'un incident et la visibilité des tendances globales, tandis qu'un archivage à froid peut conserver les preuves de conformité lorsque la latence des requêtes n'est pas un facteur critique.
Décision de rétention : Conservez les détails bruts dès lors qu'ils influent sur l'issue d'une investigation. Agrégez les enregistrements lorsque les questions portent uniquement sur des évolutions globales, des comparaisons ou des enjeux de gouvernance.
Adaptez la rétention aux habitudes de requêtage. Si les opérateurs filtrent par table et par période récente, partitionnez par date d'observation et appliquez un clustering ou un index sur le nom de la table. Si les auditeurs filtrent par contrôle, responsable ou période de rapport, veillez à préserver ces champs dans les résumés plutôt que de les contraindre à reconstituer le contexte à partir des événements bruts.
Les fonctionnalités d'historique natifs des entrepôts complètent cette approche, mais elles ne dispensent pas de sélectionner les métriques devant rester directement accessibles par requête. Les modèles d'historique de données de Snowflake offrent des perspectives intéressantes pour distinguer l'historique opérationnel de l'analyse à long terme.
Connecter les métriques aux signaux de fraîcheur et d'écart de schéma
Une métrique isolée suffit rarement à garantir qu'une table peut être consommée en toute sécurité. Une arrivée tardive de données peut être sans incidence si le calendrier source a changé. Une variation du nombre de lignes peut s'expliquer par un événement saisonnier. Une modification de schéma peut étre rétrocompatible. Le signal devient réellement pertinent lorsque plusieurs observations concordent vers le même scénario de défaillance.
Les enregistrements de fraîcheur, de volume et de schéma peuvent être combinés grâce à un identifiant de table et une fenêtre temporelle partagée. Les équipes peuvent alors concevoir un indice de fiabilité composite, mais celui-ci doit servir à hiérarchiser les priorités d'investigation plutôt qu'à prétendre représenter une vérité absolue.
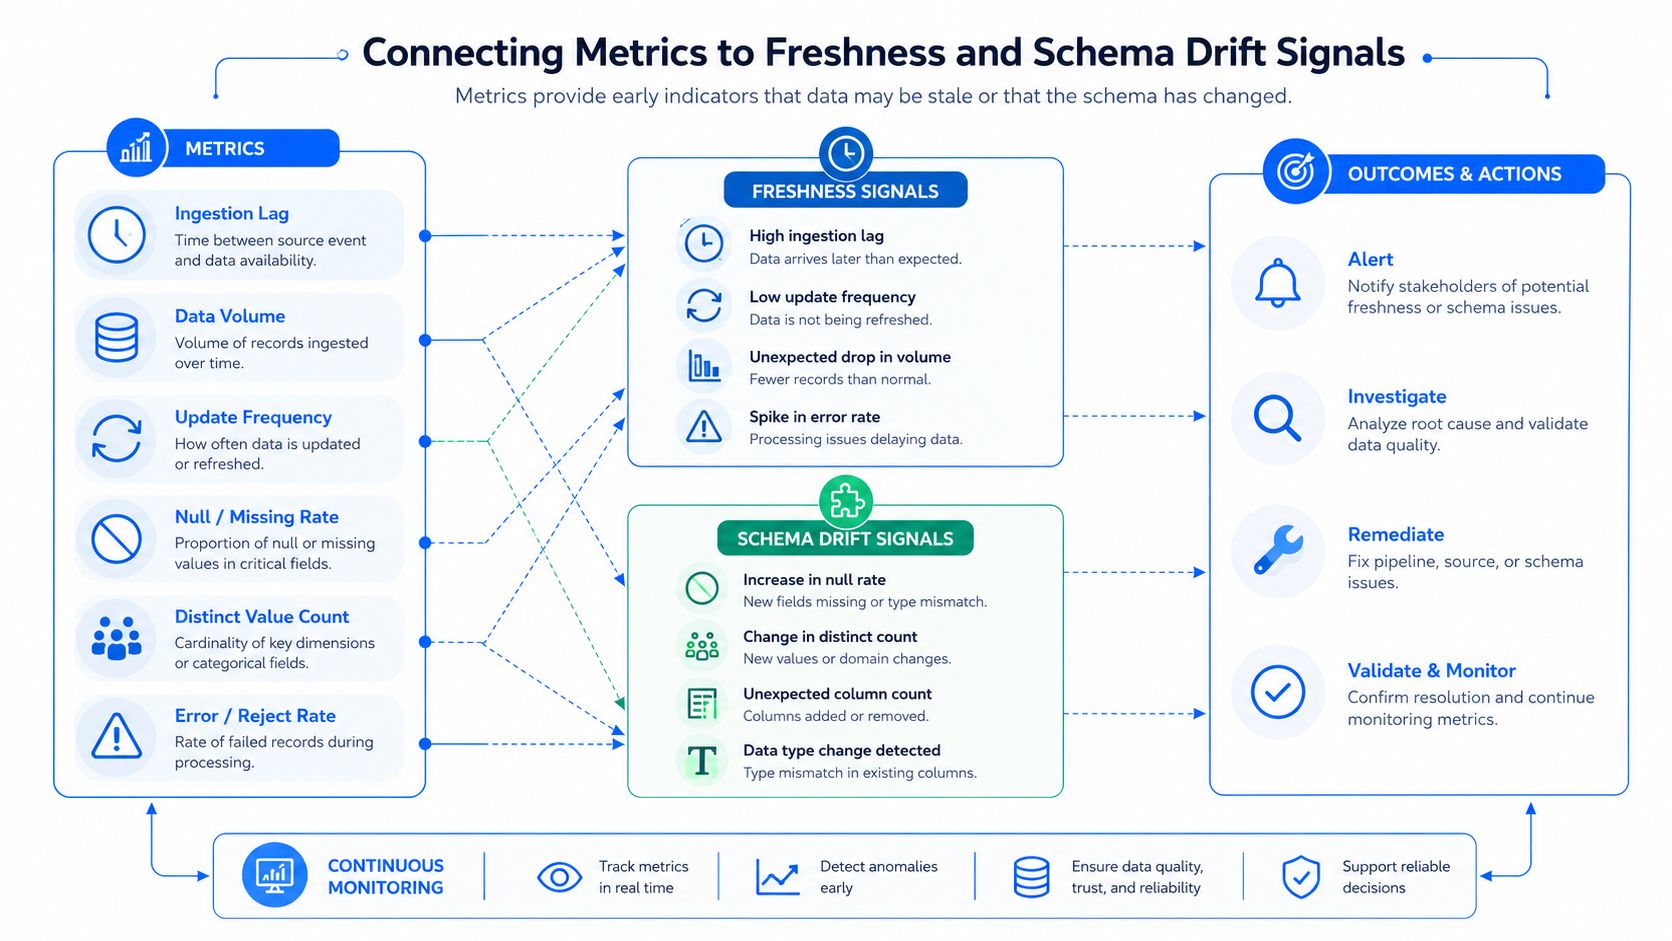
Corrélation des signaux
Une requête de corrélation simple permet d'identifier les tables présentant simultanément plusieurs anomalies :
La règle d'escalade doit étre proportionnelle aux conséquences. Un défaut de fraîcheur cumulé à un probléme de volume justifie généralement une tentative automatique de réexécution ou une vérification de la source. Un changement de schéma associé à un modèle sensible aux types en aval doit bloquer la publication et requérir l'avis d'un data steward. Une fluctuation isolée du taux de valeurs nulles nécessite une simple surveillance plutôt qu'un appel d'urgence.
Une matrice de décision pour des réponses à faible bruit
Combinaison de signaux | Interprétation probable | Réponse |
|---|---|---|
Fraîcheur uniquement | Livraison tardive ou manquante | Vérifier la planification en amont, puis relancer dès que possible |
Volume uniquement | Variation de charge ou extraction partielle | Comparer les totaux de la source avec l'historique récent |
Schéma uniquement | Modification structurelle | Vérifier la compatibilité et les dépendances en aval |
Fraîcheur et volume | Chargement incomplet ou retardé | Transmettre au propriétaire du pipeline |
Schéma et volume | Changement de contrat d'interface ou de transformation | Bloquer la publication en aval et analyser la modification |
Les trois signaux | Panne généralisée de l'actif | Ouvrir un incident de priorité haute avec le contexte de lignage (lineage) |
Le suivi des écarts de schéma permet de savoir si une colonne a été ajoutée, supprimée ou modifiée sans notification. Le contrôle de fraîcheur s'assure que les données arrivent dans les temps. Ces notions sont opérationnellement différentes, et les recommandations relatives aux signaux de Data Observability facilitent l'établissement d'une taxonomie précise des métriques.
Les équipes peuvent exécuter ces vérifications directement dans la base de données, évitant ainsi les transferts inutiles et limitant la distance entre l'observation et la décision. L'exécution de l'Observability en base de données préconise ce modèle de tests au plus près des données, ce qui s'accorde idéalement avec une table de métriques système dédiée au stockage de résultats légers.
Quand l'excès de métriques réduit l'efficacité de l'Observability
Chercher une couverture maximale semble rassurant, jusqu'à ce que la table de métriques se transforme en un inventaire exhaustif de tout ce qui peut être quantifié. Les coûts des requêtes augmentent, les flux d'alertes deviennent impossibles à trier et les anomalies critiques se trouvent noyées au milieu de fluctuations bénignes.
Une équipe peut déployer de nombreuses statistiques sur les colonnes tout en passant à côté d'un défaut de logique métier. Elle risque également de saturer les ingénieurs de notifications qu'ils finiront par valider sans les analyser. Le problème ne réside pas dans la mesure, mais dans le fait de traiter chaque résultat avec le même niveau d'urgence.
Prioritize by consequence
Concentrez-vous d'abord sur les signaux qui affectent directement la capacité d'utilisation des données par les clients :
Fraîcheur de premier niveau : Vérifiez que les tables dédiées aux décisions stratégiques, réglementaires, opérationnelles ou dédiées aux clients arrivent à l'heure prévue.
Volume globale au niveau de la table : Identifiez les chargements vides, les extractions incomplètes et les modifications imprévues de la source avant d'ajouter des contrôles plus précis.
Compatibilité des schémas : Surveillez la structure sur les chemins critiques où une modification de type ou de colonne peut bloquer les modèles.
Contrôles ciblés de colonnes : Ajoutez des vérifications sur le taux de valeurs nulles, la cardinalité ou les distributions lorsqu'une colonne spécifique alimente un calcul financier, un paramètre de modèle ou un contrôle de conformité.
Cette progression maintient la table de métriques système dans son rôle de registre opérationnel, plutôt que de catalogue de données généraliste. Une surveillance au niveau global des tables couvre efficacement la fraîcheur, les anomalies de volume et les écarts de schéma sans imposer des centaines de règles détaillées, tout en permettant des validations plus poussées sur les actifs à fort enjeu. Les directives unifiées sur la qualité des données et l'Observability soutiennent cette démarche par étapes.
Supprimer les vérifications qui n'influencent pas les décisions
Chaque contrôle doit être associé à un responsable, une réponse définie et une justification de maintien. Si une métrique ne déclenche aucune action concrète au cours de sa période d'analyse, déterminez si le seuil défini est inadapté, si l'actif est peu prioritaire ou si le contrôle n'a plus sa place dans le plan de surveillance continue.
Test opérationnel : Si une alerte ne désigne aucune équipe responsable ni d'action immédiate, elle ne devrait probablement pas solliciter d'opérateur.
Réservez les tableaux de bord aux analyses exploratoires et les alertes aux décisions opérationnelles. Un défaut de fraîcheur au niveau d'une table appelle l'intervention directe du responsable. Un léger glissement de distribution peut simplement rester visible dans l'analyse des tendances jusqu'à ce qu'il se combine à un autre signal. Les analyses de Snowflake sur la remédiation de la qualité des données rappellent ce principe fondamental : élargir la couverture n'est utile que si les équipes disposent des ressources pour traiter les résultats, plutôt que de générer de nouveaux rapports non consultés. Voir les flux de travail de correction de la qualité des données.
L'objectif n'est pas d'accumuler un volume maximal de métriques, mais de sélectionner le plus petit ensemble de signaux capable de détecter précocement les dégradations significatives, de guider le diagnostic et de constituer un registre de preuve exploitable.
Instrumentation des tables de métriques dans les plateformes d'entreprise
L'instrumentation de production doit s'exécuter au plus près des données et être intégrée au gestionnaire de versions. Des tâches SQL planifiées, des post-hooks dbt, des procédures stockées natives et l'orchestration générale peuvent alimenter la table de métriques système sans requérir l'exportation des données brutes vers un outil tiers.
Le choix de l'implémentation dépend du type de contrôle. Un test de fraîcheur peut s'exécuter immédiatement après l'ingestion. Un instantané de schéma peut s'activer juste avant le déploiement des modèles en aval. Un calcul de distribution plus lourd peut s'exécuter selon un calendrier adapté à son coût et son niveau de risque. L'essentiel est que la planification, la requête, le seuil, le responsable et la politique de rétention soient déclarés de manière unifiée.
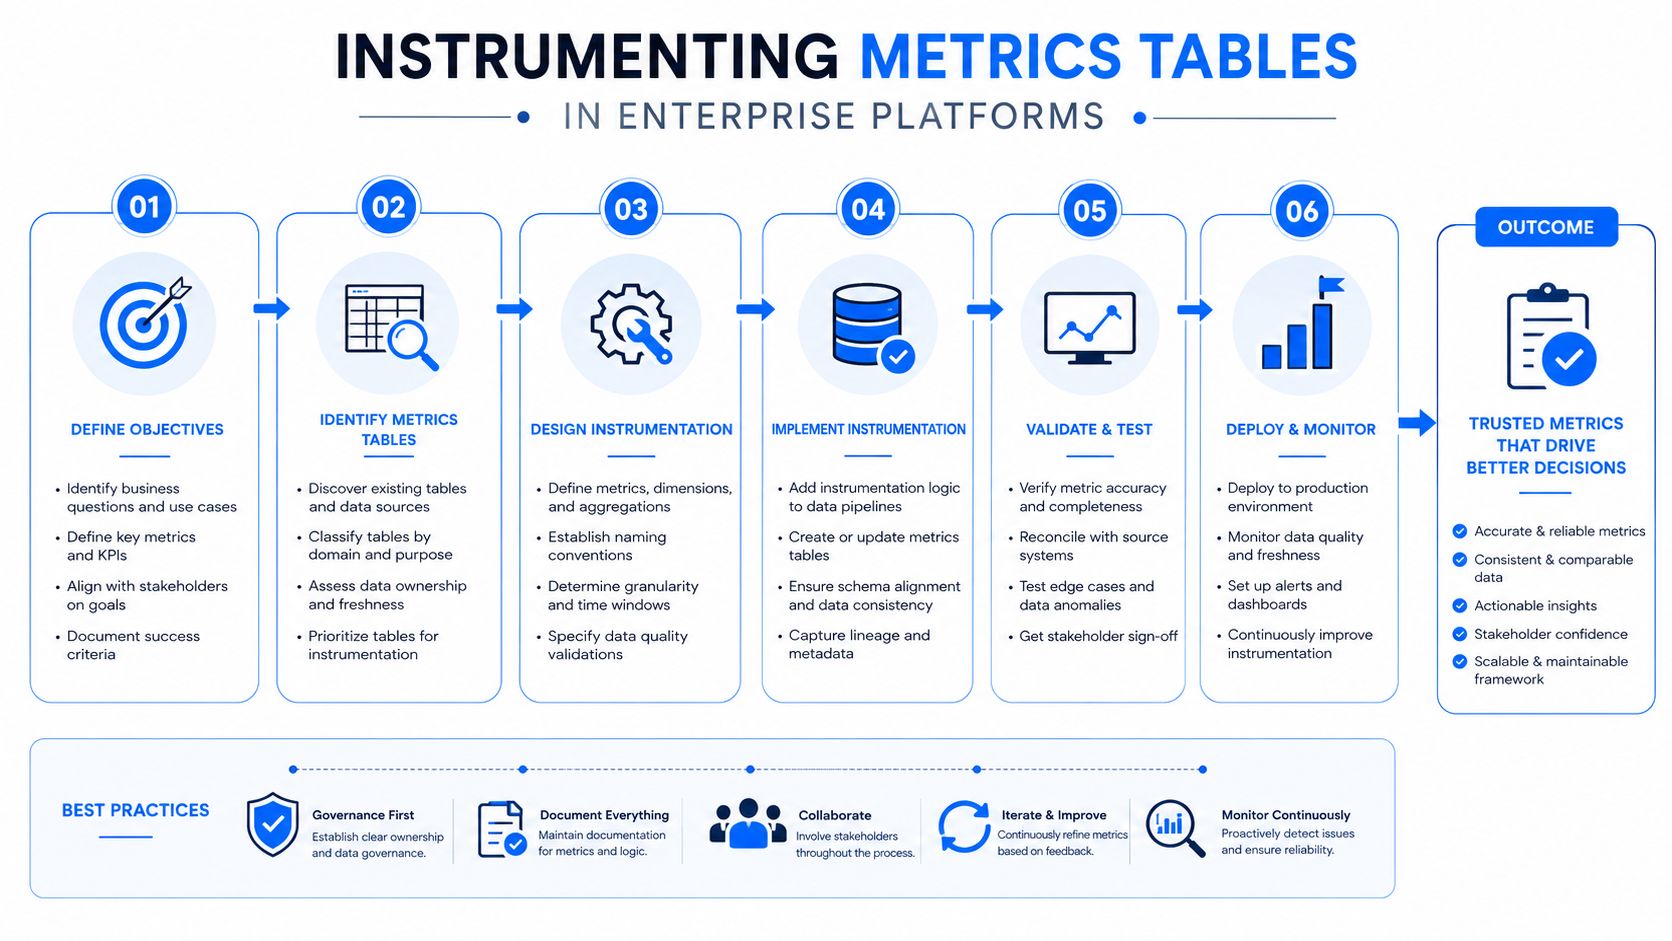
Un modèle de déploiement robuste
Créer le registre. Déployez la table de métriques, la table de configuration, les informations de propriété (ownership) et le mécanisme de rétention avant d'activer les alertes.
Enregistrer les actifs critiques. Documentez les identifiants de table, le domaine métier, la sévérité, le calendrier attendu et l'équipe responsable.
Alimenter depuis la base de données. Utilisez des requêtes SQL planifiées, des hooks dbt ou des tâches natives pour calculer des résumés compacts sur place.
Établir une référence (baseline) avant d'alerter. Accumulez les observations sur une période suffisante pour caractériser le comportement normal, puis définissez des seuils spécifiques à l'actif.
Acheminer les résultats exploitables. Envoyez les incidents validés vers Slack, PagerDuty, des tableaux de bord de gouvernance ou des outils d'observabilité déjà en place.
Associer les procédures (runbooks). Intégrez les références de résolution dans la configuration de la métrique afin que chaque alerte s'ouvre immédiatement avec le contexte approprié.
Une solution telle que Monte Carlo peut consommer les signaux de l'entrepôt, tandis qu'un service dédié peut interroger directement le registre de métriques. digna propose un calcul de métriques intégré à la base de données pour les volumes d'enregistrements, les taux de valeurs manquantes, les statistiques de distribution, les agrégations de KPI et les défauts de fraîcheur, avec des modules dédiés à la détection d'anomalies, la validation et le suivi des schémas.
Protéger les performances
Indexez ou regroupez (cluster) prioritairement les champs les plus couramment utilisés pour le filtrage par les opérateurs. Partitionnez par date d'observation lorsque le système le permet. Évitez de recalculer des métriques coûteuses sur toutes les tables lors de chaque exécution, et veillez à ce qu'une requête d'alerte ne scanne pas l'ensemble des données historiques si les preuves recherchées se trouvent déjà dans une partition récente.
Conservez les définitions de contrôles dans un dépôt et validez leurs modifications en suivant le même processus rigoureux que pour le code de transformation. Les logiques dispersées dans des notebooks ou des scripts isolés s'avèrent difficiles à auditer, à reproduire ou à archiver. Une configuration versionnée garantit la transparence des changements de propriété, des modifications de seuils et des évolutions de schémas.
Governance et auditabilité dans les secteurs réglementés
Dans les secteurs de la finance, de la santé, des télécommunications et du secteur public, les preuves d'observabilité doivent persister bien au-delà de la résolution de l'incident qui les a générées. Une table de métriques système est en mesure de certifier qu'une vérification a été effectuée, d'en détailler la mesure, la version appliquée, le résultat obtenu et l'identité de l'équipe responsable.
Ce registre sert d'autres objectifs que le simple traitement d'incidents. Il permet par exemple d'apporter la preuve à un auditeur qu'une table financière sensible a été validée avant d'être intégrée à un rapport, ou de démontrer qu'une colonne délicate est restée dans les limites de qualité tolérées. La valeur réside dans la conservation de preuves d'exécution exploitables et explicables.
Séparer les rédacteurs des lecteurs
L'écriture doit être réservée aux pipelines automatisés. Les auditeurs, les data stewards, les responsables de contrôles et les ingénieurs de plateforme doivent bénéficier d'un accès limité en lecture seule. Évitez d'accorder aux utilisateurs opérationnels des droits de modification sur les résultats historiques, car toute altération des preuves affaiblit la fiabilité de la piste d'audit.
Les champs essentiels pour l'audit incluent :
check_executed_at, l'heure à laquelle le contrôle s'est exécuté.observed_at, l'heure associée à la donnée mesurée.check_version, identifiant la logique métier appliquée.owner_team, désignant l'équipe responsable.lineage_reference, reliant le résultat aux actifs amont et aval.result_statusetfailure_reason, explicitant l'issue de la vérification.remediation_status, précisant si l'anomalie a été analysée ou résolue.
Nom de la colonne | Type de données | Objectif | Exigence de rétention |
|---|---|---|---|
|
| Identifie le contrôle de gouvernance | Conserver avec l'enregistrement du contrôle |
|
| Prouve l'heure d'exécution | Conserver pendant toute la période d'audit |
|
| Identifie l'état de la donnée mesurée | Conserver avec le résultat |
|
| Établit la responsabilité opérationnelle | Conserver tant que le contrôle est actif |
|
| Rassemble les dépendances de l'actif | Conserver pour les phases d'analyse et de révision |
|
| Stocke la valeur d'observation | Conserver avec la preuve de contrôle |
|
| Enregistre le statut de succès ou d'échec | Conserver sous forme de preuve immuable |
|
| Pointe vers les éléments justificatifs | Conserver conformément aux directives internes |
La durée de rétention imposée par la réglementation peut dépasser largement la fenêtre des requêtes opérationnelles courantes. Conservez les preuves récentes dans l'entrepôt pour un accès opérationnel rapide, compressez les partitions plus anciennes et archivez les enregistrements immuables dans un stockage d'objets sécurisé lorsque l'accès interactif n'est plus requis. Appliquez des règles de chiffrement, de suivi des accès et de suppression alignées sur la classification des données concernées.
Une table de métriques système devient un véritable pilier de la gouvernance dès lors que ses données sont immuables, traçables, reproductibles et connectées au lignage (lineage) des données associées. Elle ne doit pas simplement signaler l'échec d'un contrôle : elle doit être capable d'expliquer quel test s'est exécuté, sur quel actif, selon quelle définition métier et quelles ont été les actions entreprises par la suite.
Référence rapide pour la conception de tables de métriques système
Un modèle conçu pour la production doit être simple à analyser en cas de crise. Le tableau suivant synthétise les champs indispensables.
Colonne clé | Type recommandé | Rôle opérationnel | Fréquence de mise à jour |
|---|---|---|---|
|
| Identifie l'actif analysé | À chaque observation |
|
| Identifie le signal | À chaque observation |
|
| Stocke la valeur d'observation | Selon la planification du contrôle |
|
| Identifie l'état de la donnée | À chaque observation source |
|
| Permet de comparer les empreintes de schéma | Lors des contrôles de schéma |
|
| Suit le volume de la table | Selon le chargement ou la planification |
Modèles de requêtes de production
Contrôles de fraîcheur : Filtrez les enregistrements récents avec
metric_type = 'freshness'et comparez la dernière valeur observée avec la limite d'âge définie pour cet actif.Anomalies de volume : Utilisez une fenêtre historique limitée, des fonctions d'analyse temporelle et une référence dédiée à la table, plutôt que de comparer systématiquement le résultat avec la seule exécution précédente.
Alertes d'écart de schéma : Comparez l'instantané de schéma actuel avec une référence validée et classez séparément les ajouts, les retraits et les modifications de type.
Suivi du taux de valeurs nulles : Filtrez par colonne et par type de métrique, puis analysez le ratio obtenu au regard de la plage attendue pour cette colonne.
Suivi de latence : Utilisez la fonction
LAGsur les observations ordonnées pour évaluer l'intervalle entre les exécutions et détecter les livraisons tardives.
Les filtres conçus pour la production doivent d'abord s'appliquer sur les champs table_name, metric_type et sur la fenêtre d'observation avant de lancer les calculs. Cette méthode garantit une bonne utilisation du partitionnement et des index, tout en réduisant le coût des analyses.
Les seuils ont besoin de contexte
Il n'existe pas de SLA de fraîcheur, de plage de volume ou de règle sur les valeurs nulles qui puisse s'appliquer uniformément à l'ensemble des tables d'une entreprise. Une table de premier niveau requiert des exigences de livraison beaucoup plus strictes qu'un jeu de données exploratoire. Une source quotidienne présente des variations de volume très différentes d'un flux d'événements à haute fréquence. Un changement de schéma peut étre anodin pour un utilisateur de données mais bloquant pour une mise en production en aval.
Analysez le comportement historique pour définir des références cohérentes, puis associez vos seuils aux enjeux opérationnels et à des responsables clairs. Exigez la confirmation par plusieurs signaux concordants avant de déclencher des alertes sur des éléments instables, et veillez à ce que chaque enregistrement d'alerte contienne le niveau d'information requis pour une prise en main efficace. Révisez régulièrement vos contrôles, supprimez les mesures inutiles et conservez les éléments historiques indispensables à la gouvernance.
digna accompagne les équipes dans le calcul et l'analyse de leurs métriques de table directement en base de données, facilitant le suivi de la fraîcheur, la détection des anomalies, la validation des données et la surveillance des schémas sans exiger le transfert des données de production hors de l'environnement de l'utilisateur. Rendez-vous sur digna pour découvrir comment ses fonctions modulaires d'observabilité transforment une simple table de métriques système en un flux de travail contrôlé pour les ingénieurs de données, les data stewards et les responsables de plateformes.
Questions fréquentes
Qu'est-ce qu'une metrics system table ?
Un registre opérationnel à faible latence d'observations calculées sur les actifs de données. Elle est volontairement séparée des tables métier contenant commandes, utilisateurs, événements ou sinistres, car les deux charges ont des formes et des profils de requête différents.
Pourquoi les scripts ponctuels ne suffisent-ils pas ?
Ils font l'affaire pour un premier contrôle et cessent ensuite de passer à l'échelle. Une table centralisée offre aux ingénieurs une interface stable pour la détection, la comparaison à une ligne de base ou une période antérieure, l'escalade avec sévérité et responsable, et la preuve de ce qui a été vérifié, quand et avec quel résultat.
Que doit contenir chaque enregistrement ?
Quatre groupes : dimensions comme base, schéma, table, colonne, type de métrique, environnement et domaine métier ; mesures comme valeur observée, nombre de lignes touchées ou score d'anomalie ; métadonnées d'exécution comme heure de calcul, job source et version du contrôle ; et contexte de gouvernance comme responsable, sévérité, référence de lineage et état de remédiation.
Quand une métrique devient-elle réellement opérationnelle ?
Quand quelqu'un peut l'interroger, identifier son responsable, décider de l'action qu'elle doit déclencher et consulter son historique. En deçà, c'est un chiffre collecté et non un contrôle exécuté, et le statut du pipeline ne répond jamais qu'à la question de savoir si la tâche a tourné.
Ce design a-t-il un précédent ?
Oui, dans les tables système relationnelles servant de couche de métadonnées. Oracle 10g a introduit des tables de métriques calculant deltas et taux, simplifiant des questions comme le débit d'E/S courant de la base : le même basculement d'une inspection manuelle ponctuelle vers un suivi normalisé courant et historique.


