Signification de l'ingestion de données : pipeline, outils et bonnes pratiques
|
6
minute de lecture

L'ingestion de données consiste à collecter des données brutes à partir de multiples sources et à les transférer dans un référentiel centralisé avec un minimum de transformation, préservant ainsi la fidélité de la source pour que les équipes en aval puissent s'appuyer sur des analyses et de l'IA fiables. Cela semble simple, mais en pratique, c'est la première barrière de fiabilité du pipeline, et les équipes en ressentent le coût plus tard lorsque les tableaux de bord sont à la traîne, que les fonctionnalités des modèles deviennent obsolètes ou que les modifications de schéma se rompent silencieusement.
Table des matières
Introduction à la raison pour laquelle la qualité de l'ingestion détermine tout en aval
Meilleures pratiques pour les ingénieurs de données qui construisent des pipelines d'ingestion
Conclusion de l'ingestion comme transfert à l'ingestion comme confiance
Introduction à la raison pour laquelle la qualité de l'ingestion détermine tout en aval
L'ingestion est plus qu'un travail de copie, c'est une discipline de fiabilité qui détermine ce sur quoi les équipes en aval peuvent compter. Si les enregistrements bruts arrivent en retard, incomplets ou malformés, le problème ne reste pas en périphérie du pipeline. Il se manifeste plus tard sous forme de BI obsolète, d'alertes bruyantes, d'entrées de modèles faibles et d'équipes qui se disputent pour savoir quels chiffres sont corrects.
La signification pratique de l'ingestion de données est simple. Il s'agit du processus de collecte de données brutes à partir de sources et de leur transfert vers un système cible avec le moins de transformation possible, afin que les étapes ultérieures puissent les nettoyer, les valider, les modéliser et les régir pendant que l'enregistrement source est encore intact. Cette idée de base apparaît dans les directives des fournisseurs de Databricks, IBM et Microsoft.
La confusion commence parce que les gens entendent « ingestion » et pensent « transfert ». Dans un pipeline réel, le transfert n'est qu'une partie du travail. Un bon chemin d'ingestion doit respecter les budgets de latence, préserver l'exhaustivité, garder les doublons sous contrôle et rendre les modifications de schéma visibles avant que les consommateurs en aval ne l'apprennent à leurs dépens. C'est la différence entre des données qui arrivent simplement et des données qui peuvent soutenir des décisions. Cela se traduit également dans le travail opérationnel tel que le fonctionnement de la transcription par IA, où le timing, la structure et la précision affectent la possibilité d'utiliser la sortie.
Règle pratique : si la donnée n'est pas fiable à son arrivée, aucune modélisation en aval ne la rendra fiable plus tard.
C'est pourquoi les sections ci-dessous passent de la définition aux modes de fonctionnement, puis aux composants du pipeline, aux cas d'utilisation réels, aux schémas de défaillance et aux habitudes qui maintiennent l'ingestion utilisable à l'échelle. Si vous souhaitez obtenir une vue concrète de la façon dont ces pièces de pipeline s'assemblent, commencez par un aperçu du pipeline d'ingestion de données.
Ce que signifie l'ingestion de données
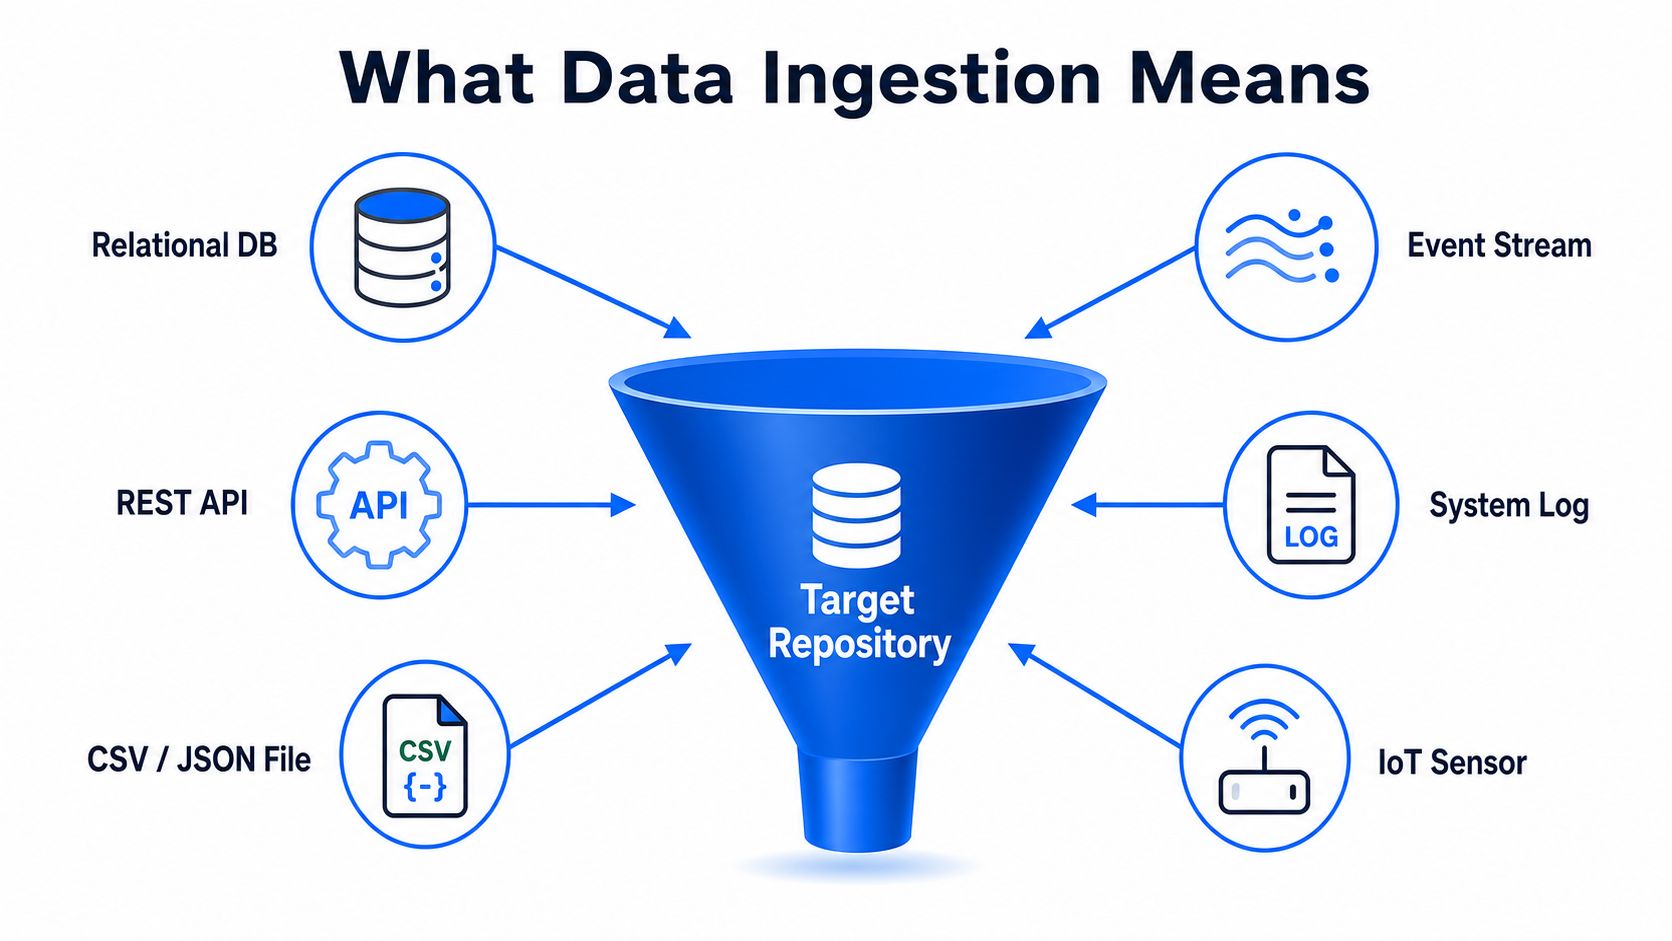
L'ingestion est le bureau de réception d'un système de données. Il reçoit l'enregistrement, vérifie ce qui est arrivé, capture les éléments de base et l'oriente vers le bon endroit pour une utilisation ultérieure. Ce travail est pratique, répétitif et facile à sous-estimer, c'est pourquoi les équipes n'en découvrent souvent le coût qu'après une panne en aval.
C'est le cœur de la signification de l'ingestion de données dans une pile moderne. Le travail consiste à collecter des données brutes à partir de systèmes sources, de bases de données, d'applications SaaS, d'API, de systèmes de fichiers, de journaux, d'appareils IoT et de flux en continu, puis à les placer dans un lac de données, un entrepôt ou un lakehouse où l'analyse et l'automatisation peuvent avoir lieu. La véritable mesure n'est pas de savoir si les données ont été déplacées, mais si le système cible peut les utiliser sans devinettes. Si des modifications de schéma, des enregistrements en double ou des écarts temporels passent à travers, le pipeline peut toujours sembler actif alors que la fiabilité des analyses et des modèles d'IA diminue régulièrement.
Une bonne couche d'ingestion protège également la fidélité de la source. Les données arrivent dans un état minimalement transformé afin que le nettoyage, la validation et la gouvernance puissent se faire avec l'enregistrement d'origine toujours disponible pour comparaison. Cela importe lorsqu'un analyste a besoin de remonter d'une métrique jusqu'à la ligne source exacte, ou lorsqu'une équipe de modélisation a besoin de comparer l'entrée brute aux fonctionnalités structurées avant de faire confiance à la sortie.
La valeur opérationnelle dépasse le cadre du stockage. À mesure que les organisations sont passées de bases de données cloisonnées à des plateformes d'analyse basées sur le cloud, l'ingestion est devenue le pont qui copie les informations dispersées vers des systèmes partagés à un rythme que l'entreprise peut utiliser. Informatica décrit cette transition comme étant plus qu'un simple chargement, c'est la couche qui prend en charge le transfert sécurisé, la préparation du pipeline et des analyses fiables.
Si vous souhaitez un guide pratique de la façon dont ces pièces s'assemblent, le guide du pipeline d'ingestion de données trace le chemin de la collecte à l'utilisation en aval. La même réflexion opérationnelle se retrouve dans le fonctionnement de la transcription par IA, où l'entrée brute doit être préparée avec soin avant de pouvoir générer un résultat utile.
Core Modes and Methods of Data Ingestion
La première décision concerne la fréquence à laquelle les données doivent être déplacées. La seconde concerne qui initie le mouvement. Ces deux choix, lot contre streaming, et push contre pull, façonnent le reste du pipeline plus que ne s'y attendent de nombreuses équipes.
Batch Versus Streaming
L'ingestion par lots déplace les données par blocs programmés. Elle convient aux rapports, aux analyses historiques et à de nombreux flux de travail de ML où le système peut tolérer un délai. L'ingestion en continu déplace les données en continu, ce qui convient mieux lorsque l'entreprise a besoin de données fraîches pour la détection des fraudes, les tableaux de bord opérationnels ou les systèmes pilotés par des événements.
Mode ou Méthode | Latence typique | Idéal pour | Compromis clé |
|---|---|---|---|
Ingestion par lots | Planifié, non continu | Rapports, analyses historiques, rafraîchissements réguliers du ML | Moins de complexité opérationnelle, mais fraîcheur plus lente |
Ingestion en continu | Arrivée continue | Détection de fraude, tableaux de bord en direct, flux de travail pilotés par des événements | Complexité plus élevée, besoins de surveillance plus stricts |
Ingestion Push | La source envoie les données automatiquement | Pipelines à faible latence avec des producteurs capables | Plus de responsabilité sur les systèmes sources |
Ingestion Pull | Le pipeline récupère les données selon un calendrier | Intégrations contrôlées et systèmes hérités | Plus facile à gérer de manière centralisée, mais plus de retard |
Ce tableau est en fait un filtre de décision. Si votre consommateur en aval n'a pas besoin de données fraîches toutes les quelques secondes, le mode par lots est souvent le choix le plus raisonnable. Si un délai modifie l'action entreprise par une équipe, le streaming commence à avoir du sens.
Push Versus Pull
L'ingestion push réduit la latence car la source émet les données dès qu'elles sont prêtes. L'inconvénient est que les producteurs doivent être fiables, ce qui signifie qu'un mauvais comportement de la source peut se répercuter directement dans le pipeline. L'ingestion pull place la charge d'orchestration du côté du consommateur. Vous gagnez plus de contrôle sur le timing, mais vous héritez également du délai entre les récupérations.
Pour les équipes travaillant dans des environnements fortement axés sur l'IA, cette distinction importe plus qu'auparavant. Un flux de travail de surveillance de marque, par exemple, peut nécessiter une capture rapide des signaux provenant de nombreuses sources, tandis que d'autres ensembles de données peuvent attendre une récupération planifiée. Le guide de GetIntel sur la surveillance de marque par l'IA est une référence utile si vous comparez les exigences de fraîcheur sur plusieurs flux et alertes destinées aux utilisateurs.
Règle de décision : choisissez le mode le plus lent qui prend toujours en charge le résultat commercial, puis surveillez la fraîcheur de manière assez agressive pour prouver que cela fonctionne.
Composants du pipeline qui rendent l'ingestion fiable
Un chemin d'ingestion fiable fonctionne comme une chaîne de relais. Si un maillon est faible, la rupture peut rester cachée tant que les volumes sont faibles, puis se manifester plus tard sous forme de latence, d'enregistrements manqués ou de mauvaises jointures en aval une fois que les systèmes en amont changent.
Collecte et transport
Le collecteur de données ou connecteur est l'endroit où réside la réalité propre à la source. Il gère les protocoles, l'authentification et la découverte de schémas, c'est pourquoi les équipes utilisent des connecteurs au lieu de coder manuellement chaque intégration. La couche de transport déplace les enregistrements en toute sécurité vers la destination, et dans les systèmes réels, elle doit souvent gérer la mise en mémoire tampon et la contre-pression afin que les pics de trafic ne submergent pas le pipeline.
Staging et orchestration
La zone de staging est l'endroit où les enregistrements bruts attendent avant d'être transformés. Ce tampon est important car il préserve la charge utile d'origine si les travaux en aval échouent ou doivent être rejoués, et il donne aux équipes un endroit pour inspecter les doublons, les champs malformés ou les enregistrements arrivant en retard avant qu'ils n'atteignent les rapports et les modèles. Le planificateur ou orchestrateur gère les tentatives, les dépendances et le timing, afin que le système se comporte de manière prévisible au lieu de dépendre de quelqu'un qui se souvient d'une tâche cron.
Pour les modèles d'architecture, la page sur l'architecture des pipelines de données est un point de référence utile car elle place l'ingestion dans le flux opérationnel plus large au lieu de l'isoler comme une étape de copie autonome.
Surveillance et Observability
La dernière pièce est celle dans laquelle de nombreuses organisations sous-investissent. La surveillance doit couvrir la ponctualité, l'exhaustivité, les modifications de schéma, les doublons et les anomalies, et pas seulement si un travail s'est terminé correctement. C'est la différence entre un pipeline qui a fonctionné et un pipeline qui prouve que son résultat est utilisable.
digna est une option dans cette couche. Sa plateforme fonctionne au sein de l'environnement client et se concentre sur les calendriers d'arrivée, les modifications de schéma, la validation et la détection d'anomalies, ce qui correspond à la façon dont la fiabilité de l'ingestion est mesurée en production. Comme les vérifications s'exécutent dans la base de données, les données restent en place, ce qui aide les équipes à maintenir l'Observability à proximité des systèmes qu'elles régissent déjà.
Une façon pratique d'appréhender ces composants est de se demander où un mauvais enregistrement est arrêté. Si le collecteur manque un changement de champ, le staging devrait l'exposer. Si les tentatives de transport créent des doublons, l'Observability devrait signaler le pic avant que les travaux d'analyse ou d'IA ne commencent à faire confiance aux mauvaises lignes.
Si une étape est manquante, la défaillance apparaît souvent ailleurs, généralement sous la forme d'une plainte commerciale plutôt que d'une alerte technique.
Exemples concrets d'ingestion de données en pratique
Une façon utile de juger de l'ingestion est de se demander ce qui se casse quand elle est défectueuse. La réponse change selon que les données alimentent une logique de fraude, des rapports de direction ou l'entraînement de modèles.
Détection de fraude
Dans un flux de paiement, l'ingestion en continu à partir des journaux de transactions et des API de paiement doit arriver assez rapidement pour que les décisions automatisées comptent encore. Si le pipeline prend du retard, le modèle de fraude examine l'histoire au lieu du flux d'événements en direct. Le signal opérationnel à surveiller est la fraîcheur, car des données obsolètes peuvent signifier un blocage manqué ou une réponse retardée.
Rapports de direction
L'ingestion par lots est courante pour les données ERP et CRM car les rapports de direction se soucient généralement plus de la cohérence et du timing que des mises à jour instantanées. La question clé est de savoir si les données arrivent avant le gel des rapports. Si ce n'est pas le cas, le tableau de bord peut toujours sembler soigné alors que les chiffres sous-jacents sont déjà obsolètes.
Pipelines de fonctionnalités ML
Les pipelines de fonctionnalités vivent et meurent de leur fraîcheur. Si l'ingestion ralentit, l'ensemble d'entraînement commence à s'écarter de l'état du système et le modèle apprend à partir de conditions anciennes. C'est particulièrement risqué lorsque l'entreprise dépend de modèles qui changent rapidement, car des fonctionnalités obsolètes peuvent rendre un modèle tout à fait correct en test mais peu fiable en production.
Ces exemples se connectent à un point qui apparaît constamment dans les orientations modernes, y compris la discussion d'Unstructured sur la qualité de l'ingestion. Les équipes passent d'une logique de « déplacement des données » à une logique de « preuve de l'utilisabilité des données », en particulier lorsque les décisions en aval dépendent de la ponctualité, des chargements manquants et des schémas stables.
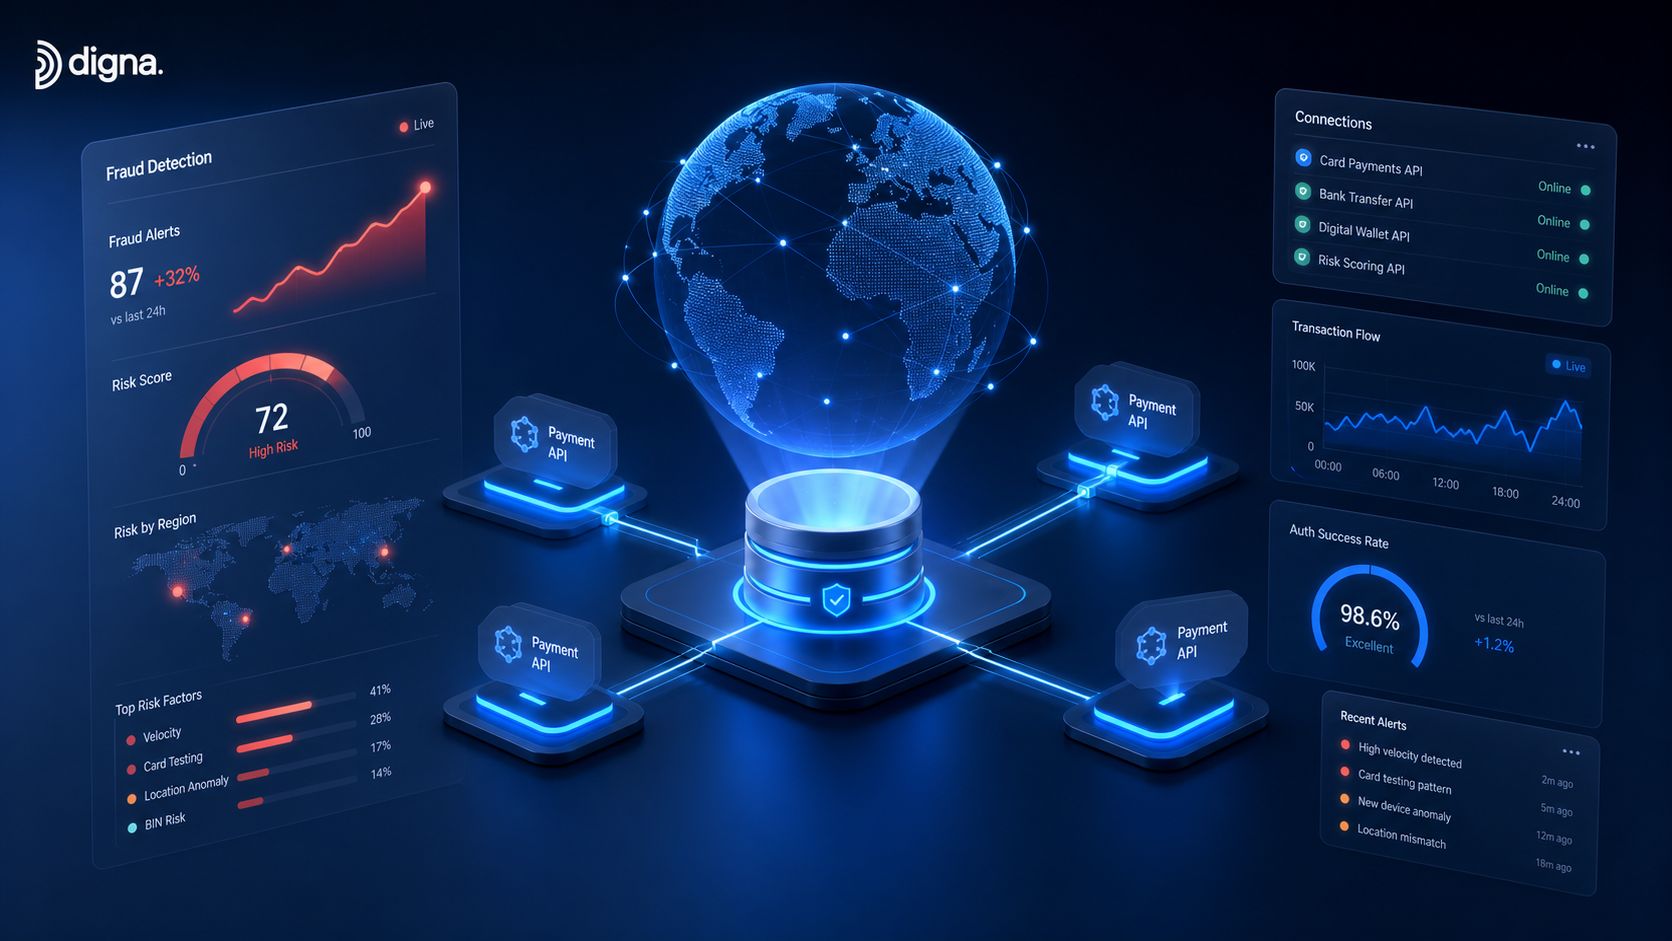
Dans les trois cas, la question d'ingénierie reste la même. Comment savoir si les données sont arrivées à temps, au complet et dans une forme que le système suivant peut utiliser ?
Pièges courants de l'ingestion et comment ils se propagent
Le coût élevé des problèmes d'ingestion réside dans le fait qu'ils restent rarement locaux. Un petit problème à la source peut devenir un problème commercial plusieurs couches plus tard, et à ce moment-là, la cause d'origine semble sans rapport.
Dérive de latence
La dérive de latence se produit lorsque les données commencent à arriver plus tard que prévu et que personne ne s'en aperçoit immédiatement. Le symptôme immédiat est souvent un tableau de bord qui semble « correct » mais reflète des conditions anciennes. Pour une équipe qui prend des décisions quotidiennes, ce retard peut suffire à modifier sa prochaine action.
Enregistrements en double
Les enregistrements en double sont plus subtils car ils peuvent donner l'impression que les chiffres sont meilleurs qu'ils ne le sont. La livraison au moins une fois est utile pour la fiabilité, mais elle peut gonfler les comptes si le pipeline ne déduplique pas intelligemment. Les dommages apparaissent généralement dans les entonnoirs, les totaux de revenus et les métriques basées sur les événements que les gens supposent propres.
Dérive de schéma
La dérive de schéma est la défaillance la plus silencieuse des trois. Une équipe en amont ajoute une colonne, modifie un type ou renomme un champ, et les consommateurs en aval soit plantent, soit continuent de fonctionner sur la base de mauvaises hypothèses. Le pire est que la défaillance peut être partielle, de sorte que certaines requêtes réussissent tandis que d'autres échouent ou renvoient des absurdités.
Vérité opérationnelle : les données en retard, les doublons et les changements de forme sont souvent moins liés à des bogues de transport qu'à un manque de visibilité.
C'est pourquoi les équipes de la finance, de la santé, des télécoms et du secteur public se tournent vers des contrôles d'ingestion basés sur des preuves. Elles ont besoin de preuves que le chemin d'ingestion est suffisamment fiable pour des décisions réglementées ou critiques, et pas seulement de preuves que des octets ont été déplacés. Lorsque l'Observability est faible, le pipeline peut toujours « réussir » alors que l'entreprise voit des résultats obsolètes, gonflés ou incomplets.
Meilleures pratiques pour les ingénieurs de données qui construisent des pipelines d'ingestion
Les équipes d'ingestion les plus performantes ne s'en remettent pas à la chance ou à une configuration unique. Elles adoptent des habitudes qui rendent les pannes visibles tôt et la récupération banale.
Commencer par la préservation des données brutes
Conservez les données sources brutes dans la zone de staging avant la transformation. Cela vous donne une issue de secours propre lorsqu'un travail en aval échoue ou qu'une règle métier change. Cela facilite également l'audit et le retraitement, car la charge utile d'origine est toujours disponible.
Rendre les tentatives sécurisées
Utilisez des chargements idempotents pour que la relance d'un travail ne crée pas de doublons artificiels. Si un pipeline doit s'exécuter deux fois, la seconde exécution ne doit pas réécrire la réalité. Ce simple choix de conception évite bien des confusions de métriques par la suite.
Surveiller avant que les utilisateurs ne se plaignent
Définissez des SLA de ponctualité avec des fenêtres d'arrivée réalistes, puis générez des alertes lorsque le système les manque. Suivez en continu les modifications de schéma et n'attendez pas qu'une requête en aval découvre un champ rompu. En pratique, les meilleures équipes combinent des vérifications déterministes avec un apprentissage de référence basé sur l'IA afin de repérer à la fois les pannes connues et les nouveaux schémas.
Garder la liste de contrôle opérationnelle courte
Préserver les données brutes : stockez les originaux en staging pour pouvoir les rejouer ou les auditer plus tard.
Utiliser des chargements idempotents : concevez des tentatives pour qu'elles ne créent pas de doublons.
Surveiller tôt : configurez des alertes avant que le pipeline ne devienne critique pour l'entreprise.
Suivre l'évolution du schéma : signalez rapidement les champs ajoutés, supprimés ou modifiés.
Documenter la responsabilité : attribuez des guides opérationnels, des chemins d'escalade et des vérifications de régression.
Une plateforme comme le logiciel d'ingestion de données de digna s'intègre dans ce type de modèle opérationnel car elle se concentre sur le comportement à l'arrivée, la dérive de schéma et la validation au niveau de l'enregistrement au sein de l'environnement du client. Cette conception en base de données est importante lorsque les exigences de sécurité et de gouvernance rendent les mouvements de données plus difficiles à justifier.
Le point principal est simple. N'attendez pas que le pipeline soit « assez grand » pour vous soucier de l'Observability. À ce moment-là, le coût de l'ignorance fait déjà partie de l'architecture.
Conclusion de l'ingestion comme transfert à l'ingestion comme confiance
L'ingestion de données commence comme une étape de transfert, mais elle devient une couche de confiance dès que d'autres équipes en dépendent. Dès lors que les tableaux de bord BI, les magasins de fonctionnalités et les décisions automatisées s'appuient sur ces enregistrements, le chemin d'ingestion cesse d'être de la tuyauterie pour devenir un point de contrôle commercial.
Les choix fondamentaux restent les mêmes d'un environnement à l'autre. Le traitement par lots et le streaming définissent le modèle de fraîcheur. Le push et le pull définissent le modèle de responsabilité. Les cinq composants du pipeline (collecte, transport, staging, orchestration et Observability) déterminent si le système peut survivre aux changements du monde réel. Les pièges courants (dérive de latence, doublons et dérive de schéma) se traduisent par une rupture de confiance si vous ne les interceptez pas tôt.
Ce passage du déplacement des données à la preuve de l'utilisabilité est déjà visible dans les programmes de données modernes, en particulier là où les décisions comportent un risque réglementaire ou opérationnel. Les équipes ne veulent pas seulement des enregistrements dans un entrepôt. Elles veulent des preuves que le chemin d'ingestion est opportun, complet et suffisamment stable pour soutenir l'action suivante.
Si vous renforcez cette partie de votre pile, concentrez-vous sur les signaux qui importent le plus à vos utilisateurs, puis construisez des contrôles autour d'eux. Les équipes qui s'en sortent bien passent moins de temps à se disputer sur les tableaux de bord et plus de temps à les utiliser.
Si vous êtes prêt à rendre la fiabilité de l'ingestion visible plutôt que supposée, découvrez digna. Elle est conçue pour surveiller la ponctualité, les modifications de schéma, la validation et les anomalies au sein de votre propre environnement, ce qui en fait une solution pratique pour les équipes qui ont besoin de pipelines fiables sans mouvement de données supplémentaire.


