S3 comme système de fichiers
|
7
minute de lecture

Monter S3 en tant que système de fichiers est généralement un mauvais choix par défaut. Les équipes s'y tournent parce que le chemin d'accès semble familier, que les outils existants continuent de fonctionner et que la promesse de « monter simplement le bucket » semble moins coûteuse que de réécrire des pipelines. Ce raccourci masque une inadéquation sémantique, et dans l'analytique d'entreprise, cette inadéquation se traduit par des pics de latence, des comportements de cohérence étranges, une governance désordonnée et des coûts opérationnels imprévus.
La règle la plus sûre est simple. Utilisez S3 pour ce qu'il est, un stockage d'objets, à moins d'avoir une charge de travail très spécifique nécessitant une sémantique de fichiers. Si vous traitez le montage comme une couche de commodité plutôt que comme une décision d'architecture, vous finirez par déboguer l'abstraction au lieu de fournir des données.
Table des matières
Pourquoi monter S3 en tant que système de fichiers est généralement un mauvais choix par défaut
Comparaison entre le stockage d'objets et les systèmes de fichiers POSIX
Faire correspondre l'opération de fichier au comportement S3
Un comportement de cohérence que vous ne pouvez pas ignorer
Les opérations qui piègent encore les utilisateurs
Options de montage de s3fs et FUSE à S3 Files
Comparez la pile, pas le marketing
Charges de travail analytiques sur une couche de système de fichiers S3
Ajustez en fonction de la charge de travail réelle que vous avez
Governance d'entreprise et Observability pour l'accès aux fichiers S3
Auditez la couche d'objets, pas seulement le montage
Quand S3 en tant que système de fichiers est réellement pertinent
Utilisez-le lorsque le compromis est délibéré
Pourquoi monter S3 en tant que système de fichiers est généralement un mauvais choix par défaut
L'erreur courante consiste à supposer que si un bucket peut ressembler à un répertoire, il doit se comporter comme tel. Cette hypothèse met les équipes en difficulté car le montage masque le fait que S3 reste un stockage d'objets en dessous, avec des performances, une cohérence et un comportement de métadonnées différents de ceux d'un disque local ou d'un partage NFS. Le stockage d'objets stockera volontiers vos octets, mais il n'héritera pas des garanties sur lesquelles votre application pourrait s'appuyer.
En production, c'est là que les difficultés commencent. Les ingénieurs utilisent des montages pour maintenir en vie d'anciens scripts, puis découvrent que les tâches gourmandes en renommages, les écritures partagées et les parcours de métadonnées se comportent comme une couche de traduction, et non comme un système de fichiers natif. Le résultat est souvent un plus grand nombre de pièces mobiles, davantage de tentatives masquées et davantage de risques de fuites de coûts en raison de la multiplication des requêtes et de l'instabilité du cache.
Règle pratique : si la charge de travail a seulement « besoin d'un dossier », cela ne signifie pas qu'elle a besoin d'un système de fichiers.
AWS lui-même a fait évoluer S3 d'une manière qui prouve ce point. Depuis son lancement le 14 mars 2006 avec environ 1 pétaoctet de capacité sur environ 400 nœuds de stockage répartis dans 15 baies et 15 Gbit/s de bande passante totale, S3 est devenu une plateforme stockant plus de 500 billions d'objets et traitant plus de 200 millions de requêtes par seconde à l'échelle mondiale en mars 2026, à travers 123 zones de disponibilité dans 39 régions AWS (AWS S3 history and scale). Cette échelle rend S3 excellent pour les charges de travail d'objets, mais elle ne le transforme pas par magie en un disque POSIX. Si votre architecture dépend d'un comportement de fichier local, vous devez prouver pourquoi le montage a sa place ici.
Pour les équipes qui conçoivent une plateforme à partir de zéro, la première question n'est pas « pouvons-nous le monter ? » mais plutôt « quel mode de défaillance sommes-nous en train d'accepter ? » Si vous souhaitez un examen clair de la conception du système autour de cette question, le bon point de départ est this data system architecture guide.
Comparaison entre le stockage d'objets et les systèmes de fichiers POSIX
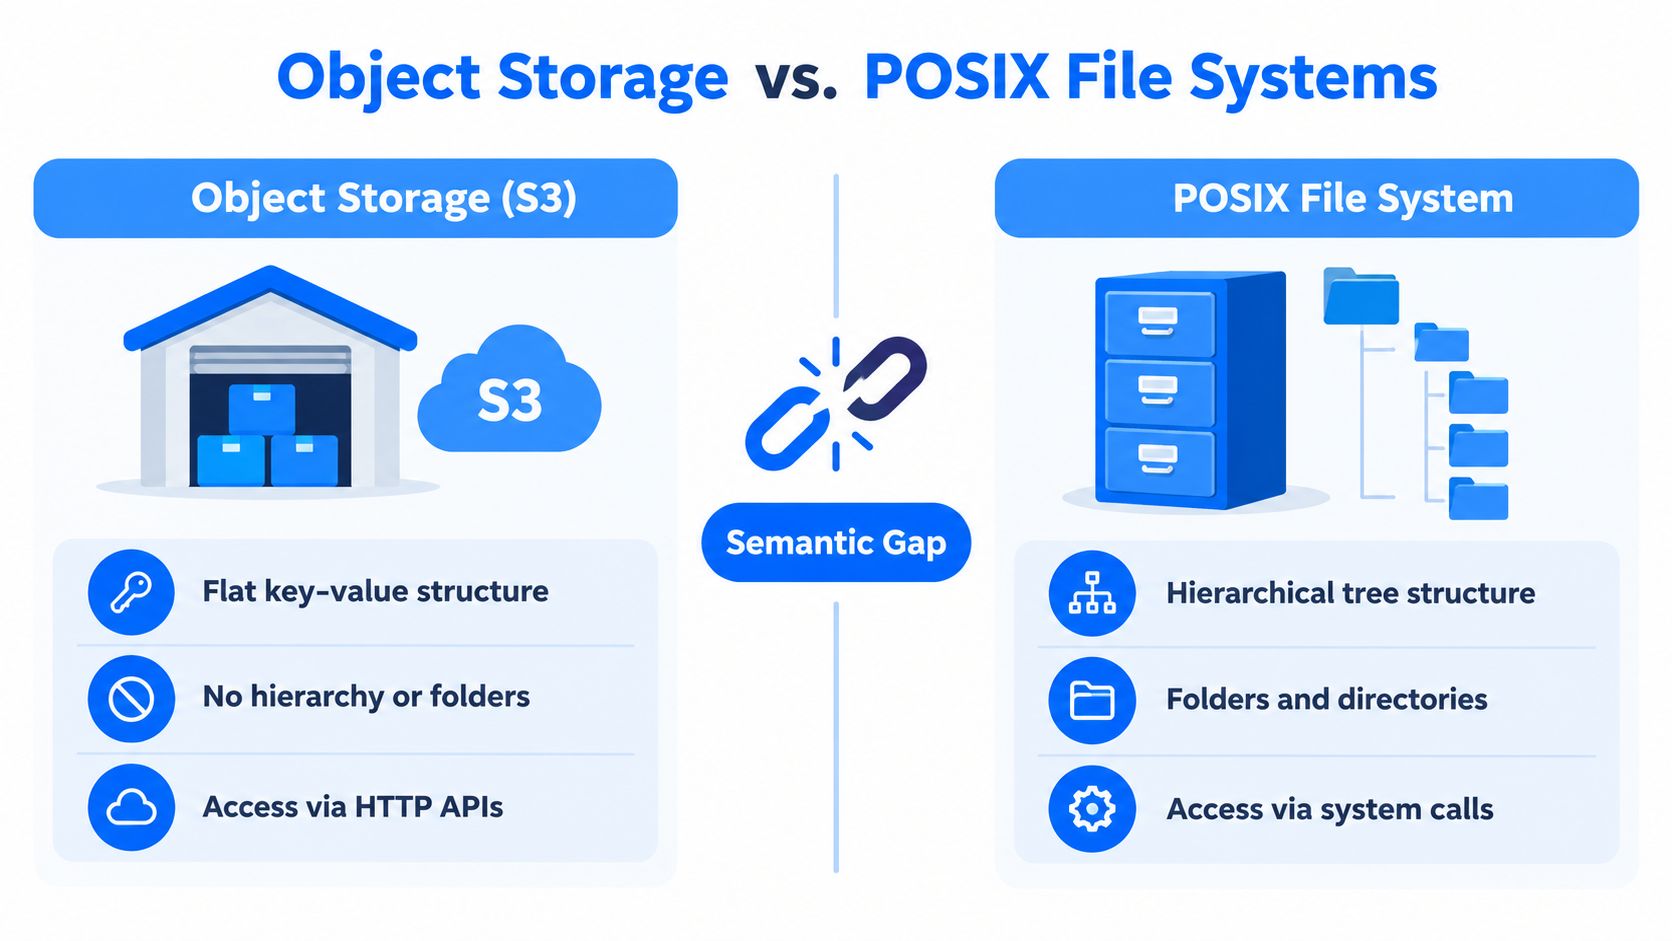
Pensez-y en termes d'entrepôt. Un bucket est un entrepôt, un objet est une caisse scellée, et la clé est l'étiquette sur la caisse. Vous pouvez déplacer des caisses, remplacer des caisses et lister des étiquettes, mais vous ne pouvez pas ouvrir une caisse et modifier une seule page à l'intérieur comme vous le feriez avec un document sur un ordinateur portable. C'est ce décalage sémantique que chaque couche de montage doit masquer.
Faire correspondre l'opération de fichier au comportement S3
Commencez par l'opération open. Sur POSIX, l'ouverture d'un fichier est un appel système normal dans un système de fichiers hiérarchique. Sur S3, « l'ouverture » est en réalité une décision du client de récupérer un objet ou de préparer un chemin d'écriture via une couche de traduction. Le système peut rendre l'opération familière, mais le mécanisme reste basé sur les objets.
À présent, cartographiez les opérations partial write (écriture partielle) et overwrite (remplacement). Sur un système de fichiers, vous pouvez souvent modifier des octets sur place. Sur S3, l'objet est remplacé. C'est pourquoi les flux de travail orientés fichiers qui supposent des modifications incrémentielles peuvent devenir coûteux ou fastidieux lorsqu'ils sont traduits en opérations d'objets (object-store behavior and overwrite differences). Le modèle de stockage ne se comporte pas comme un bloc de mémoire partagée mutable.
Enfin, considérez les opérations rename et atomic rename. Dans POSIX, la sémantique de renommage fait partie du contrat du système de fichiers. Dans S3, le renommage est un modèle d'émulation, généralement une copie suivie d'une suppression ou une réécriture de métadonnées dans la couche de montage. C'est là que les surprises apparaissent, car un déplacement de répertoire peut se transformer en une rafale d'opérations sur les objets plutôt qu'en une seule action atomique.
Un montage peut traduire des noms. Il ne peut pas inventer une sémantique.
L'explication en une minute pour un décideur est directe. S3 est un espace de noms d'objets plat avec une présentation de type fichier superposée. POSIX est un système de fichiers hiérarchique avec une sémantique native de répertoire et de mutation. Plus votre charge de travail s'appuie sur des modifications atomiques, des verrous et des comportements de renommage, plus la couche de traduction doit simuler ce que le backend de stockage n'a jamais promis.
Un comportement de cohérence que vous ne pouvez pas ignorer
La cohérence de S3 est le point où de nombreuses hypothèses liées aux systèmes de fichiers commencent à s'effondrer. Amazon S3 offre désormais une cohérence forte après écriture (read-after-write) pour les requêtes GET, PUT et LIST dans toutes les régions AWS, et AWS garantit que ce que vous écrivez est ce que vous lirez (S3 consistency model). Cela élimine une classe importante de surprises, mais cela ne transforme pas pour autant S3 en un système de fichiers POSIX.
Les opérations qui piègent encore les utilisateurs
Un lecteur peut toujours rencontrer des problèmes lorsque l'application suppose une coordination du système de fichiers qui n'existe pas. Les flux de travail de réécriture, les modèles de renommage de type répertoire et les chemins d'accès lourds en métadonnées dépendent toujours de la couche de montage pour ajouter un comportement de synchronisation ou de mise en cache que S3 lui-même ne fournit pas. Lorsque les équipes ignorent cela, elles finissent par constater des lectures obsolètes, des situations de compétition (race conditions) ou des scénarios de divergence (split-brain) dans les flux de travail multi-clients, en particulier lorsque plusieurs scripteurs accèdent au même espace de noms.
Le risque n'est pas théorique. Une tâche peut écrire des données, une seconde tâche peut lister le même préfixe, et les deux tâches peuvent croire qu'elles possèdent le même chemin logique. Si le pipeline attend un remplacement de répertoire atomique ou un verrouillage de fichier, l'abstraction doit fournir une coordination en plus de la sémantique d'objet, et cette coordination devient une surface de défaillance supplémentaire.
Opération | Comportement POSIX | Comportement S3 | Risque pour les utilisateurs de systèmes de fichiers |
|---|---|---|---|
Créer et lire | Création de fichier native, puis lecture immédiate | Fortement cohérent pour les nouveaux objets | Risque plus faible, mais le comportement du montage compte toujours |
Remplacer (Overwrite) | Sémantique de mise à jour de fichier sur place | Sémantique de remplacement d'objet | Les lecteurs peuvent ne pas obtenir un comportement de mise à jour de type fichier |
Renommer un répertoire | Déplacement d'espace de noms d'apparence atomique | Émulé par des opérations d'objets ou une couche de métadonnées | Clés orphelines, déplacements partiels, tentatives masquées |
Lister un répertoire | Métadonnées de répertoire natives | Liste de clés d'objets basée sur des préfixes | Les listes volumineuses peuvent devenir lentes et générer du bruit opérationnel |
AWS S3 Files apporte un autre signal indiquant que l'abstraction a des limites. La documentation expose des quotas explicites tels que 25 000 connexions par système de fichiers et 10 000 points d'accès par système de fichiers, ce qui rappelle que le montage n'est pas la même chose qu'un disque local (S3 Files limits and behavior). Concevez en fonction de ces limites, ne tentez pas de les ignorer.
Pour les équipes chargées des pipelines, l'habitude la plus sûre consiste à acheminer chaque flux de travail sensible à la cohérence par le biais d'un propriétaire clair et d'une étape de validation explicite. Si vous avez besoin d'une liste de contrôle pratique pour ce type de détection de dérive, utilisez data consistency checks comme modèle de réflexion sur le problème.
Options de montage de s3fs et FUSE à S3 Files
Tous les montages S3 ne sont pas conçus de la même manière. Certaines options existent pour maintenir en vie les outils existants, d'autres pour réduire les frictions opérationnelles, et certaines sont plus fidèlement décrites comme des couches d'accès que comme de véritables systèmes de fichiers. Le bon choix dépend de vos besoins : accès en lecture, comportement d'écriture directe (write-through), mutation partagée ou moyen plus propre d'alimenter les moteurs analytiques qui gèrent déjà nativement le stockage d'objets.
Comparez la pile, pas le marketing
s3fs et les montages similaires basés sur FUSE sont généralement la première étape pour les équipes qui ont besoin d'une passerelle de compatibilité rapide. Ils sont pratiques, mais ils ajoutent une couche de processus supplémentaire, de la latence supplémentaire et davantage de risques de goulots d'étranglement lorsqu'un seul nœud devient le point d'étranglement. Ils peuvent convenir pour un usage interactif léger ou comme structure de migration temporaire, mais ils constituent un mauvais choix par défaut pour les pipelines d'entreprise très sollicités.
Goofys et Mountpoint for S3 font partie de la même grande famille de couches de compatibilité. Ils peuvent améliorer des modèles d'accès spécifiques, mais ils ne suppriment toujours pas l'inadéquation sémantique entre le stockage d'objets et la sémantique de fichiers. Utilisez-les lorsque l'objectif principal est de « faire fonctionner cet outil maintenant », et non de « construire la plateforme autour de cela indéfiniment ».
Le plus récent S3 Files d'AWS a une intention différente. AWS le positionne comme un système de fichiers partagé pour EC2, Lambda, EKS et ECS, avec un accès NFS 4.1 et 4.2 et une synchronisation bidirectionnelle entre le système de fichiers monté et le bucket (S3 Files behavior and regions). Cela le rend plus natif qu'un simple adaptateur FUSE, mais cela n'en fait pas pour autant un disque POSIX. Ce compromis de conception est plus adapté à l'accès partagé qu'aux écritures aléatoires de type base de données.
Les API natives de stockage d'objets sont la réponse la plus propre lorsque votre moteur les prend déjà en charge. Spark, Trino et DuckDB bénéficient d'un meilleur parallélisme et d'une mise à l'échelle plus propre lorsqu'ils communiquent directement avec S3 au lieu de passer par un montage qui tente d'imiter des répertoires. Si l'outil sait déjà effectuer un listage parallèle, des lectures vectorisées ou du pushdown de prédicats, ne le forcez pas à passer par une interface de type fichier.
Option | Pile | Support d'écriture | Plafond de débit | Idéal pour |
|---|---|---|---|---|
s3fs | Client basé sur FUSE | Limité, orienté compatibilité | Souvent limité par le nœud client | Outils existants et travaux de migration de courte durée |
Autres montages FUSE | Couche de compatibilité | Varie selon l'implémentation | Dépend de la surcharge de traduction | Accès intensif en lecture avec faible concurrence |
S3 Files | Interface de système de fichiers gérée par AWS sur S3 | Synchronisation bidirectionnelle | Meilleur pour l'accès partagé, toujours pas natif POSIX | Calcul partagé et collaboration orientée fichiers |
API d'objets natives | Intégration directe du SDK S3 ou du moteur | Sémantique d'objet complète | Évolue avec le parallélisme du stockage d'objets | Spark, Trino, DuckDB et analytique moderne |
La recommandation est claire. Utilisez des montages en lecture seule lorsque vous devez impérativement préserver d'anciens outils. N'utilisez des montages à écriture directe (write-through) qu'avec des tentatives explicites, des règles de propriété et des chemins de retour en arrière (rollback). Privilégiez les API d'objets natives chaque fois que l'outil les prend en charge, car c'est la voie qui s'adapte proprement pour l'analytique. Si vous souhaitez une vision plus large de la conception de pipelines, le ETL data pipeline guide est le type de cadre que votre équipe plateforme devrait utiliser avant d'approuver un montage.
Charges de travail analytiques sur une couche de système de fichiers S3
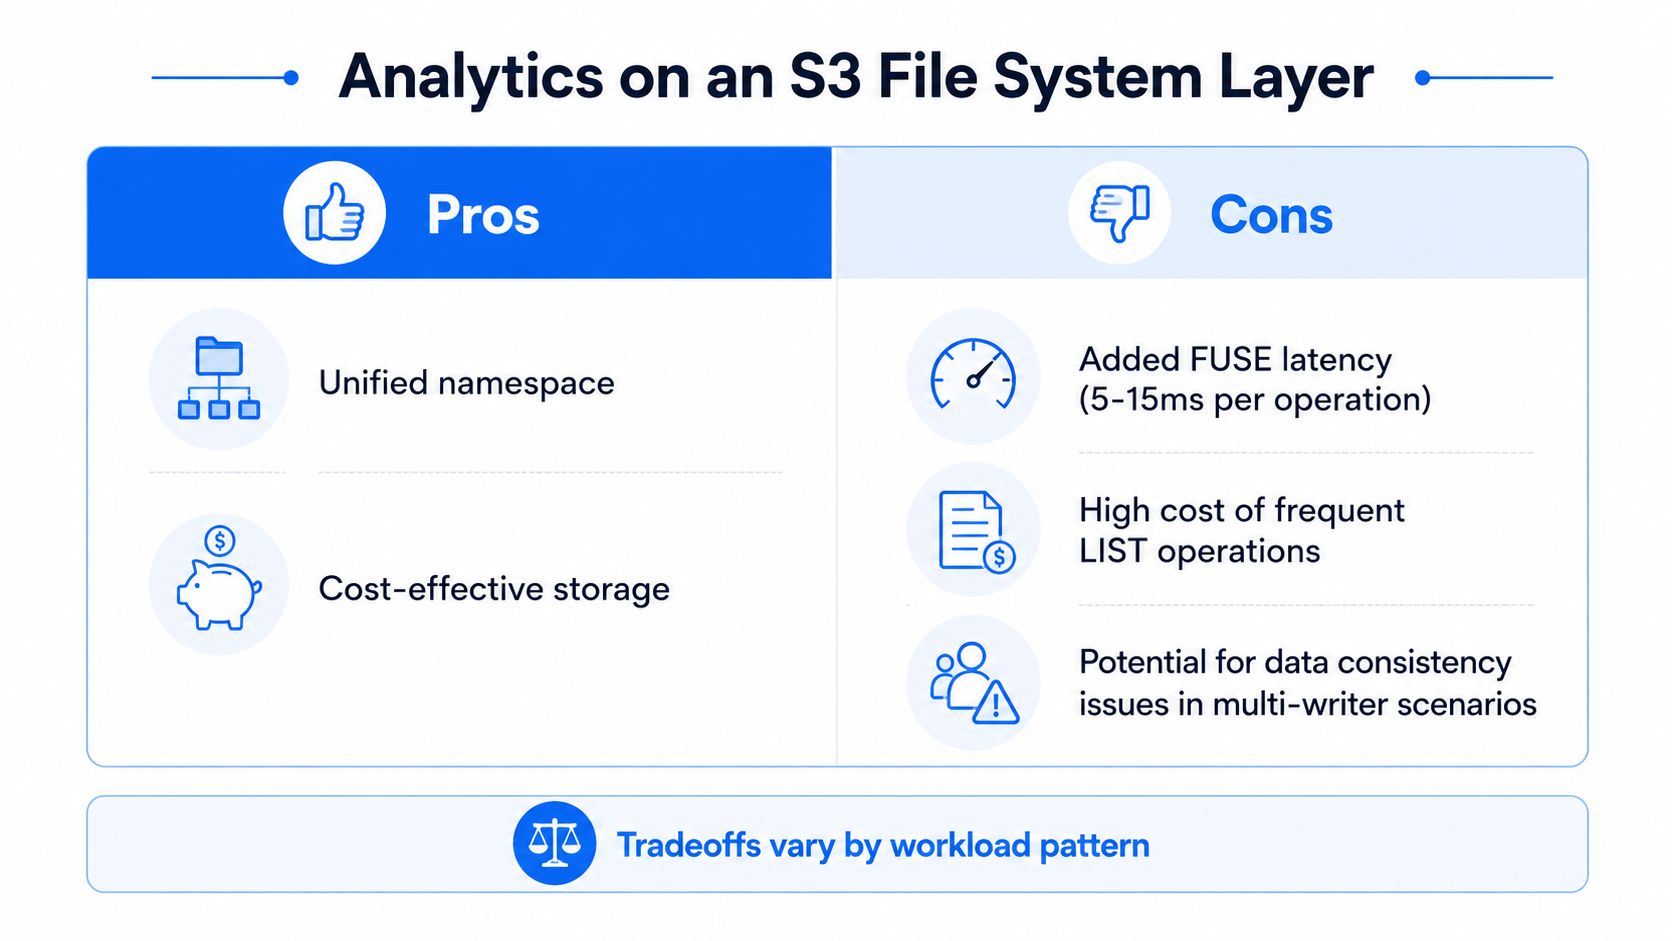
Les charges de travail analytiques exposent rapidement les points faibles car elles touchent à la fois aux octets et aux métadonnées. Les tâches Spark et Hive peuvent tolérer des lectures par étapes si le modèle d'accès est principalement séquentiel, mais dès que la charge de travail commence à analyser des répertoires, à renommer des partitions ou à générer un grand nombre de petits fichiers, la couche de montage devient coûteuse en temps et en échanges avec le plan de contrôle. Trino et DuckDB s'en sortent généralement mieux lorsqu'ils peuvent communiquer directement avec S3, car ils évitent une abstraction de fichier qui n'a jamais été conçue pour des métadonnées à forte instabilité.
Ajustez en fonction de la charge de travail réelle que vous avez
Si la tâche est orientée par lots, le transit des données par S3 peut toujours s'avérer pertinent lorsque le modèle de lecture est prévisible et que la sortie est écrite en une seule fois. Dans ce cas, concentrez-vous sur la réduction des parcours de répertoires inutiles et laissez le moteur lire des blocs plus volumineux au lieu de faire comme si chaque ligne méritait un accès indépendant au fichier. Les outils qui prennent en charge le read-ahead, les plages GET parallèles ou le pushdown de prédicats surpasseront généralement un montage générique car ils restent plus proches de la sémantique d'objet.
L'autre point critique concerne les petits fichiers. Une couche de système de fichiers fait paraître la prolifération de petits fichiers inoffensive jusqu'à ce que les opérations de listage et de métadonnées dominent la tâche. Les écritures de tables lourdes en renommages deviennent également un problème, car le montage doit émuler un comportement que le stockage d'objets ne fournit pas nativement. C'est là que les formats de table comme Iceberg et Hudi justifient leur utilisation, car ils encodent leurs propres couches de cohérence et de métadonnées plutôt que de s'appuyer sur des astuces de répertoire.
Règle pratique : si l'organisation de vos données s'appuie sur le renommage comme mécanisme de validation (commit), vous résolvez un problème de format de table avec de la plomberie de stockage.
La question du coût importe également. Les opérations LIST fréquentes sur de grands buckets sont un anti-pattern pour l'analytique basée sur des montages, car chaque commodité orientée fichiers peut se transformer en requêtes supplémentaires et en latence accrue. C'est pourquoi un accès direct à S3 est généralement le meilleur choix pour les grands ensembles de données d'entreprise, en particulier lorsque l'équipe plateforme dispose déjà d'un suivi des modèles de requêtes, du nombre de fichiers et du renouvellement des objets.
Pour les équipes qui ont besoin de mesurer ces compromis, la vision opérationnelle importe autant que le moteur de requête. Le bon modèle de surveillance doit s'intégrer dans le data lake monitoring, et non dans un script de montage ponctuel.
Enterprise Governance et Observability pour l'accès aux fichiers S3
Une fois S3 exposé en tant que système de fichiers, la governance doit suivre les données, et non l'illusion des dossiers. Les limites IAM comptent toujours au niveau du bucket ou du préfixe, le chiffrement KMS compte toujours au repos, et les politiques de points d'accès VPC comptent toujours si vous voulez empêcher les sorties publiques accidentelles. Le chemin du fichier peut sembler familier aux utilisateurs, mais le plan de contrôle sous-jacent reste le stockage d'objets, votre modèle de politique doit donc correspondre à la sémantique d'objet.
Auditez la couche d'objets, pas seulement le montage
Les journaux d'audit du système de fichiers ne suffisent pas ici. Le montage peut masquer les opérations au niveau des objets pour les personnes qui ne regardent que les traces de type POSIX, ce qui signifie que l'équipe de sécurité a besoin des journaux d'accès S3, des événements de données CloudTrail et de la télémétrie de stockage dans le même pipeline de surveillance. Sans cela, vous risquez de manquer des dérives, des montages obsolètes, des identifiants divulgués sur des hôtes bastions et des modèles de requêtes GET qui semblent normaux pour le client de fichiers mais suspects pour un analyste en cybersécurité.
La classification des données devient également plus difficile. Un chemin de fichier dans un espace de noms monté ne correspond pas de manière biunivoque à une ACL ou à une politique d'objet, les équipes ont donc besoin de règles explicites pour définir qui peut voir quoi, et où ces règles sont appliquées. Si le même bucket est manipulé par plusieurs outils, vous devez également établir des conventions de propriété pour éviter les chemins d'écriture ambigus et les collisions accidentelles d'espaces de noms.
AWS S3 Files ajoute une règle opérationnelle particulièrement utile. Si un même élément est modifié à la fois dans le système de fichiers et directement dans le bucket, AWS traite le bucket comme la source de vérité et déplace le fichier conflictuel vers un répertoire d'éléments perdus et retrouvés (lost-and-found), et AWS recommande de choisir soit le système de fichiers, soit S3 comme scripteur principal (S3 Files best practices). C'est autant une politique de governance qu'un détail technique, car cela oblige les équipes à choisir une source de vérité avant de créer des incohérences.
Pour les plateformes de données d'entreprise, le travail consiste à surveiller en continu la couche elle-même. Si un montage dérive, qu'un identifiant est divulgué ou qu'une charge de travail commence à multiplier les requêtes GET d'une manière non conforme au modèle attendu, l'équipe plateforme doit s'en apercevoir avant les utilisateurs métiers. C'est exactement le genre de visibilité qu'une plateforme de data observability est censée offrir.
Quand S3 en tant que système de fichiers est réellement pertinent
N'utilisez S3 comme système de fichiers que lorsque la charge de travail justifie cette abstraction. Une zone de transit éphémère pour une seule tâche par lots convient très bien. Des outils existants liés à POSIX qui ne peuvent pas être réécrits dans le calendrier du projet conviennent également. Des analyses principalement en lecture sur du Parquet ou des formats de table qui gèrent déjà leurs propres métadonnées sont également adaptées, en particulier lorsque le but est d'éviter les copies en double et les mouvements de données inutiles.
Utilisez-le lorsque le compromis est délibéré
Ce qui n'a pas sa place sur un montage basé sur S3, c'est une base de données à écritures aléatoires, un espace de travail partagé à forte instabilité ou une architecture de microservices qui utilise le montage comme s'il s'agissait d'un disque partagé à faible latence. Ces systèmes requièrent une sémantique de fichiers plus forte que ce que le stockage d'objets peut fournir à travers une couche de traduction, et ils ont tendance à échouer précisément là où la concurrence et la mutation importent le plus.
Le modèle de décision le plus propre consiste à évaluer la charge de travail candidate à l'aide de six questions.
Fréquence d'écriture. Si les écritures sont fréquentes et de petite taille, passez votre chemin.
Modèles de listage. Si l'application parcourt constamment les répertoires, passez votre chemin.
Tolérance à la latence. Si quelques allers-retours supplémentaires bloquent le flux de travail, passez votre chemin.
Plafond de coût. Si la croissance des requêtes importe plus que le coût du stockage, passez votre chemin.
Posture de sécurité. Si l'application des politiques dépend uniquement de la sémantique des chemins, passez votre chemin.
Plan de secours (Rollback). Si vous ne pouvez pas basculer vers les API directes de S3 ou un autre stockage, ne commencez pas.
La recommandation honnête est simple. Utilisez le montage lorsque la compatibilité est l'objectif et que la charge de travail est limitée. Évitez-le lorsque la mutation partagée, la concurrence complexe ou un comportement de type base de données sont requis. S3 est une excellente primitive de plateforme de données, mais un adaptateur de système de fichiers n'en fait pas pour autant un NAS à usage général.

Si votre équipe doit décider d'exposer ou non S3 sous forme de montage, digna peut vous aider à maintenir l'intégrité de la couche de données grâce à une Observability qui suit la Timeliness, les changements de schéma, les anomalies et le comportement de la plateforme au sein de votre propre environnement. Visitez digna pour voir comment sa plateforme de Data Observability peut vous aider à surveiller les effets en aval de choix d'architecture comme celui-ci, avant qu'un montage ne se transforme en incident de production.
Questions fréquentes
Faut-il monter S3 comme système de fichiers ?
Le plus souvent non. Monter est le mauvais réflexe par défaut car cela masque qu'il reste en dessous un stockage objet, au comportement de performance, de cohérence et de métadonnées différent d'un disque local ou d'un partage NFS. Utilisez S3 comme stockage objet, sauf si une charge bien délimitée exige vraiment une sémantique de fichiers.
Pourquoi un bucket qui ressemble à un répertoire ne se comporte-t-il pas comme tel ?
Parce que l'apparence de répertoire est une émulation. L'erreur fréquente est de supposer que si un bucket peut ressembler à un dossier, il devrait se comporter comme tel, et c'est exactement là que la douleur commence en production.
Comment les opérations POSIX se traduisent-elles sur S3 ?
Imparfaitement. Ouvrir est en réalité une décision du client de récupérer un objet ou de préparer un chemin d'écriture via une couche de traduction, l'écriture partielle et l'écrasement remplacent l'objet entier, et le renommage est un motif d'émulation, généralement copie puis suppression ou réécriture de métadonnées dans la couche de montage.
Quelle question doit remplacer « peut-on le monter ? »
« Quel mode de défaillance achetons-nous ? » Si une charge n'a besoin que d'un dossier, cela ne signifie pas qu'elle a besoin d'un système de fichiers, et répondre d'abord à la question du mode de défaillance retire généralement le montage de la conception.
De combien S3 a-t-il grandi depuis son lancement ?
D'environ 1 pétaoctet réparti sur quelque 400 nœuds de stockage dans 15 baies et 15 Gbit/s de bande passante totale lors de son lancement le 14 mars 2006, à plus de 500 000 milliards d'objets et plus de 200 millions de requêtes par seconde dans le monde en mars 2026, sur 123 zones de disponibilité dans 39 régions AWS.



