Riche en données, pauvre en informations : guide pratique
|
7
minute de lecture

Vous pouvez assister à une revue du lundi avec un tableau de bord impeccable à l'écran sans savoir pour autant si le chiffre a bougé parce que la campagne a fonctionné, parce que la table source a cassé ou parce que quelqu'un a modifié la définition la semaine dernière. Les graphiques sont soignés. La réunion se termine pourtant sur la même question inconfortable : à quoi pouvons-nous nous fier ?
Cet écart, c'est le fait d'être riche en données mais pauvre en informations. Il apparaît lorsque les équipes collectent quantité de lignes, d'événements et de journaux, sans parvenir à les transformer assez vite en informations exploitables pour décider. Le problème ne tient pas seulement au volume. Il tient au temps et à la confiance nécessaires pour convertir des signaux bruts en éléments sur lesquels un responsable peut agir sans remettre la source en question.
Table des matières
Le coût réel, pour l'entreprise, d'être riche en données mais pauvre en informations
Des usines à règles à l'observabilité pilotée par l'IA en pratique
Le piège du tableau de bord et le problème DRIP
Un tableau de bord du chiffre d'affaires peut sembler sain et échouer pourtant au seul test qui compte : l'équipe peut-elle expliquer pourquoi le pipeline commercial a évolué ? Le marketing affirme que la campagne a généré de la demande, les ventes estiment que la composition des leads a changé, la finance voit un chiffre qui ne correspond pas aux prévisions de la semaine précédente, et l'analyste se retrouve à assembler des tables de l'entrepôt de données, des exports SaaS et des corrections manuelles dans des tableurs. C'est le piège du tableau de bord : beaucoup d'affichage, pas assez de décision.
DRIP signifie data rich, information poor, c'est-à-dire riche en données, pauvre en informations. L'expression décrit l'écart croissant entre la quantité de données qu'une entreprise collecte et la quantité d'informations exploitables pour décider auxquelles elle peut se fier. Une donnée brute est une ligne dans une table, un événement dans un flux ou une ligne de journal dans un fichier. Une information est ce même signal, une fois doté d'un contexte, d'une fraîcheur, d'un responsable et d'explications suffisantes pour guider l'action.
Cette distinction est importante, car les équipes considèrent souvent qu'un surcroît de données est la réponse à un manque d'enseignements. En pratique, cela peut creuser l'écart. Plus de tables signifie plus de jointures, plus d'outils signifie plus de transmissions, et plus de transmissions signifie plus d'occasions pour quelqu'un de poser une question à laquelle personne ne peut répondre avec assurance. Si vous souhaitez voir concrètement comment les tableaux de bord s'inscrivent dans ce problème, le guide interne sur les tableaux de bord de qualité des données montre pourquoi une visibilité de surface s'arrête souvent avant un véritable contrôle.
Règle pratique : si une métrique nécessite une réunion pour être expliquée, ce n'est pas encore une information.
Le bon modèle mental est la latence, et non le volume. Une entreprise peut disposer de nombreuses données et rester lente à décider, parce que les données arrivent en retard, manquent de contexte ou n'ont pas été vérifiées au regard des règles métier qui les rendent fiables. C'est pourquoi le DRIP relève moins du stockage que du chemin qui mène du signal à l'action.
D'où vient l'expression et pourquoi elle reste d'actualité
L'expression « riche en données et pauvre en informations » existe depuis des décennies, car ce mode de défaillance revient sans cesse sous de nouveaux habits. Elle a été popularisée en 1983 par le livre de management In Search of Excellence, où elle résumait un problème de gestion simple : les organisations peuvent accumuler des données sans les convertir en informations utilisables. Des commentaires ultérieurs sur la même idée l'ont rattachée à une estimation de 2010 selon laquelle l'économie américaine perdait 997 milliards de dollars par an à cause de la surcharge d'informations, en prenant pour base 78,6 millions de travailleurs du savoir à temps plein, ce qui explique pourquoi l'expression trouve encore un écho aujourd'hui dans les conseils d'administration et les équipes d'analytique (historique de l'expression et de l'estimation de 2010).
Pourquoi la formule survit à chaque génération d'outils
La formule a survécu à la BI, au big data et désormais à l'IA, car les outils ont évolué plus vite que le problème de fond. Un entrepôt de données peut centraliser les données, un tableau de bord peut les synthétiser et un modèle peut leur attribuer un score, mais aucune de ces étapes ne garantit que le résultat soit à jour, explicable ou suffisamment fiable pour agir. C'est pourquoi l'expression a toujours sa place dans toute discussion sérieuse sur l'analytique en 2025, en particulier lorsque les équipes ajoutent des systèmes plus vite qu'elles n'améliorent le processus de décision.
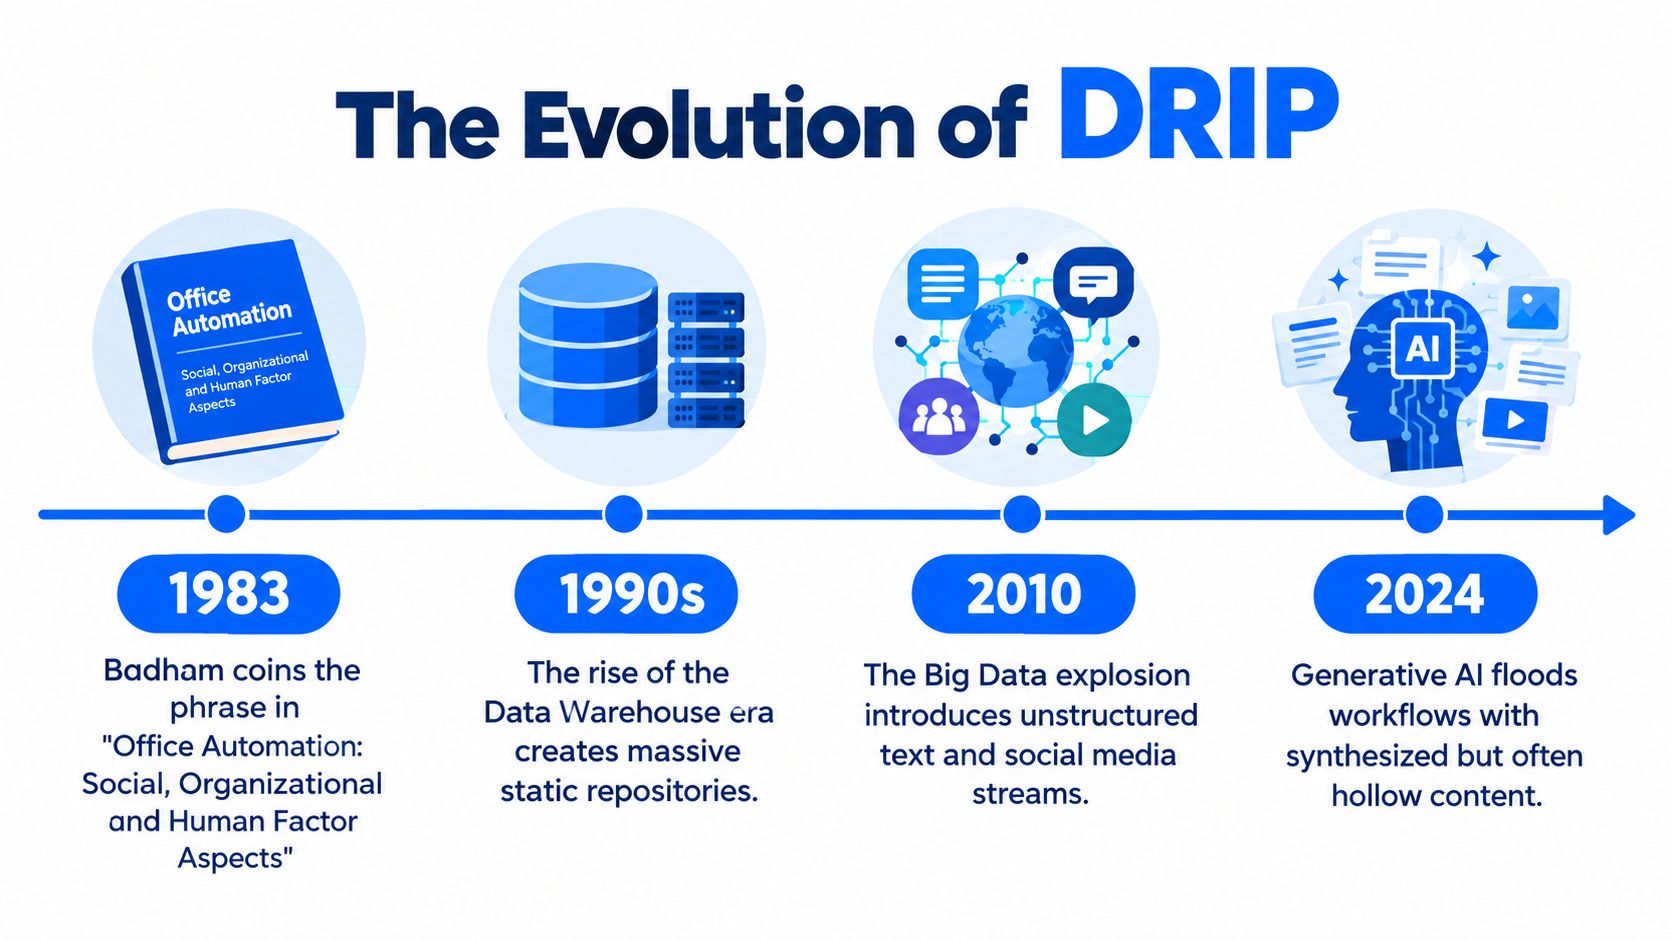
L'expression perdure parce que le symptôme change sans cesse de forme, et non parce que le diagnostic serait dépassé.
L'évolution moderne, c'est l'IA. Les outils génératifs peuvent produire davantage de synthèses, de prévisions et de texte, mais si les données sous-jacentes sont obsolètes ou peu fiables, le résultat reste creux. DRIP demeure le bon raccourci, car il désigne la véritable défaillance : l'information n'arrive pas sous une forme que les humains peuvent utiliser en toute sécurité.
Ce qui crée l'écart entre données et informations
La cause la plus fréquente est la fragmentation. Une seule question métier dépend souvent de données réparties entre des entrepôts de données, des applications SaaS, des bases opérationnelles et des tableurs, ce qui signifie que la réponse doit franchir plusieurs périmètres de responsabilité avant que quiconque puisse s'y fier. Dans cette situation, le retard n'est pas seulement technique, il est aussi interprétatif, car chaque transmission offre une nouvelle occasion aux définitions de diverger.
Quatre causes structurelles observées dans les équipes
L'écart résulte généralement d'une combinaison de fragmentation, de prolifération des outils, de surcharge et de latence. Pour analyser le problème, il est utile de rapprocher chaque cause structurelle du symptôme qu'elle engendre.
Cause | Ampleur typique en 2025 | Symptôme opérationnel |
|---|---|---|
Fragmentation des données | De nombreux systèmes, chacun détenant une partie de la réponse | Les équipes débattent de la table qui fait autorité |
Prolifération des outils | Plusieurs outils d'analytique et d'observabilité utilisés en parallèle | Aucune vue partagée de la qualité, de la fraîcheur ou du lignage |
Surcharge d'informations | Trop de tableaux de bord et de métriques qui se disputent l'attention | Les réunions se remplissent de chiffres, mais aucune décision n'est prise |
Latence de traitement | Les données arrivent une fois la fenêtre de décision passée | Les responsables agissent sur des chiffres obsolètes ou attendent une actualisation manuelle |
Le problème de surcharge n'a rien d'abstrait. Les études récentes sur le travail indiquent que les travailleurs du savoir sont constamment interrompus et que de nombreuses équipes passent du temps à chercher d'une application à l'autre au lieu d'agir sur le résultat (synthèse sur la surcharge au travail). Autrement dit, l'entreprise ne dispose pas seulement de plus de données : elle subit davantage de frictions entre la question et la réponse.
Une lecture connexe utile est l'analyse du blog Artul.ai expliquant pourquoi les synthèses de conférences sur les résultats échouent, car elle montre le même schéma dans un autre contexte : la matière première existe, mais le récit exploitable n'émerge pas clairement.
Pourquoi la latence compte davantage que le volume de données
Les pipelines batch dominent encore de nombreux environnements, si bien que la décision est souvent prise avant l'arrivée des données les plus récentes. Il en résulte un décalage temporel. Un responsable consulte un KPI, suppose qu'il reflète la situation actuelle et tranche sur la base de données peut-être déjà dépassées. Le problème n'est pas que l'entreprise manque de signaux. C'est que le signal parvient trop tard à la décision, dépourvu du contexte nécessaire pour l'interpréter.
Si vous souhaitez réduire cet écart, la présentation interne des sources de données disparates offre un éclairage utile, car elle rend plus visible le coût de données d'entrée dispersées.
Le coût réel, pour l'entreprise, d'être riche en données mais pauvre en informations
Une mauvaise qualité des données ne se contente pas d'agacer les analystes. Elle crée une échelle de coûts qui s'accentue chaque fois que des données erronées progressent en aval. Une estimation sectorielle largement citée indique qu'une mauvaise qualité des données coûte en moyenne 12,9 millions de dollars par an aux organisations, et l'étude D&B citée par la même source décrit une progression 1 $, 10 $, 100 $ : la prévention coûte environ 1 $ par enregistrement, l'identification et la résolution d'un problème environ 10 $ par enregistrement, et la correction d'une erreur après coup environ 100 $ par enregistrement (escalade des coûts et impact sur l'entreprise).
Un coût d'abord modeste, qui s'accumule rapidement
Cette escalade explique pourquoi une détection tardive coûte si cher. Une valeur erronée repérée lors de la validation coûte peu. La même valeur utilisée dans un tableau de bord coûte davantage. Une fois qu'elle atteint un moteur de tarification, un rapport de conformité ou un processus en contact avec les clients, la facture de réparation s'envole, car il faut retracer le problème, expliquer son impact sur l'activité et annuler les décisions prises en aval.
Étape | Coût par enregistrement | Déclencheur typique | Exemple |
|---|---|---|---|
Prévention | 1 $ | Validation avant que les données erronées n'entrent dans le pipeline | Une règle bloque un code invalide lors de l'ingestion |
Identification et correction | 10 $ | Les analystes repèrent et corrigent le problème après son apparition | Un chargement échoué est attribué à un fichier mal formé |
Correction après impact | 100 $ | L'erreur atteint un rapport, un processus métier ou une procédure réglementaire | Une valeur erronée modifie une décision de tarification ou de conformité |
Une correction peu coûteuse est celle que l'on applique avant que le problème ne se propage.
Le coût caché est le manque à gagner. Si une équipe passe des jours à rapprocher les versions de la vérité, elle manque l'occasion d'agir tant que le marché évolue encore. Un distributeur dont le moteur de tarification repose sur une table de coûts vieille de six mois peut ne pas remarquer l'erreur avant que ses marges ne dérivent ou qu'un concurrent ne l'y oblige. À ce stade, le préjudice ne se limite pas au mauvais prix. C'est la confiance de la direction dans les chiffres qui est perdue.
C'est pourquoi le DRIP est une taxe sur la latence décisionnelle. Vous la payez en réactions plus lentes, en travail de rapprochement supplémentaire et en réunions consacrées à prouver que les données sont réelles au lieu de décider de la suite. Le business case de la qualité des données interne est pertinent ici, car l'équation économique ne s'améliore que lorsque les équipes réduisent la propagation des erreurs, et pas seulement leur nettoyage.
Comment diagnostiquer votre propre situation DRIP
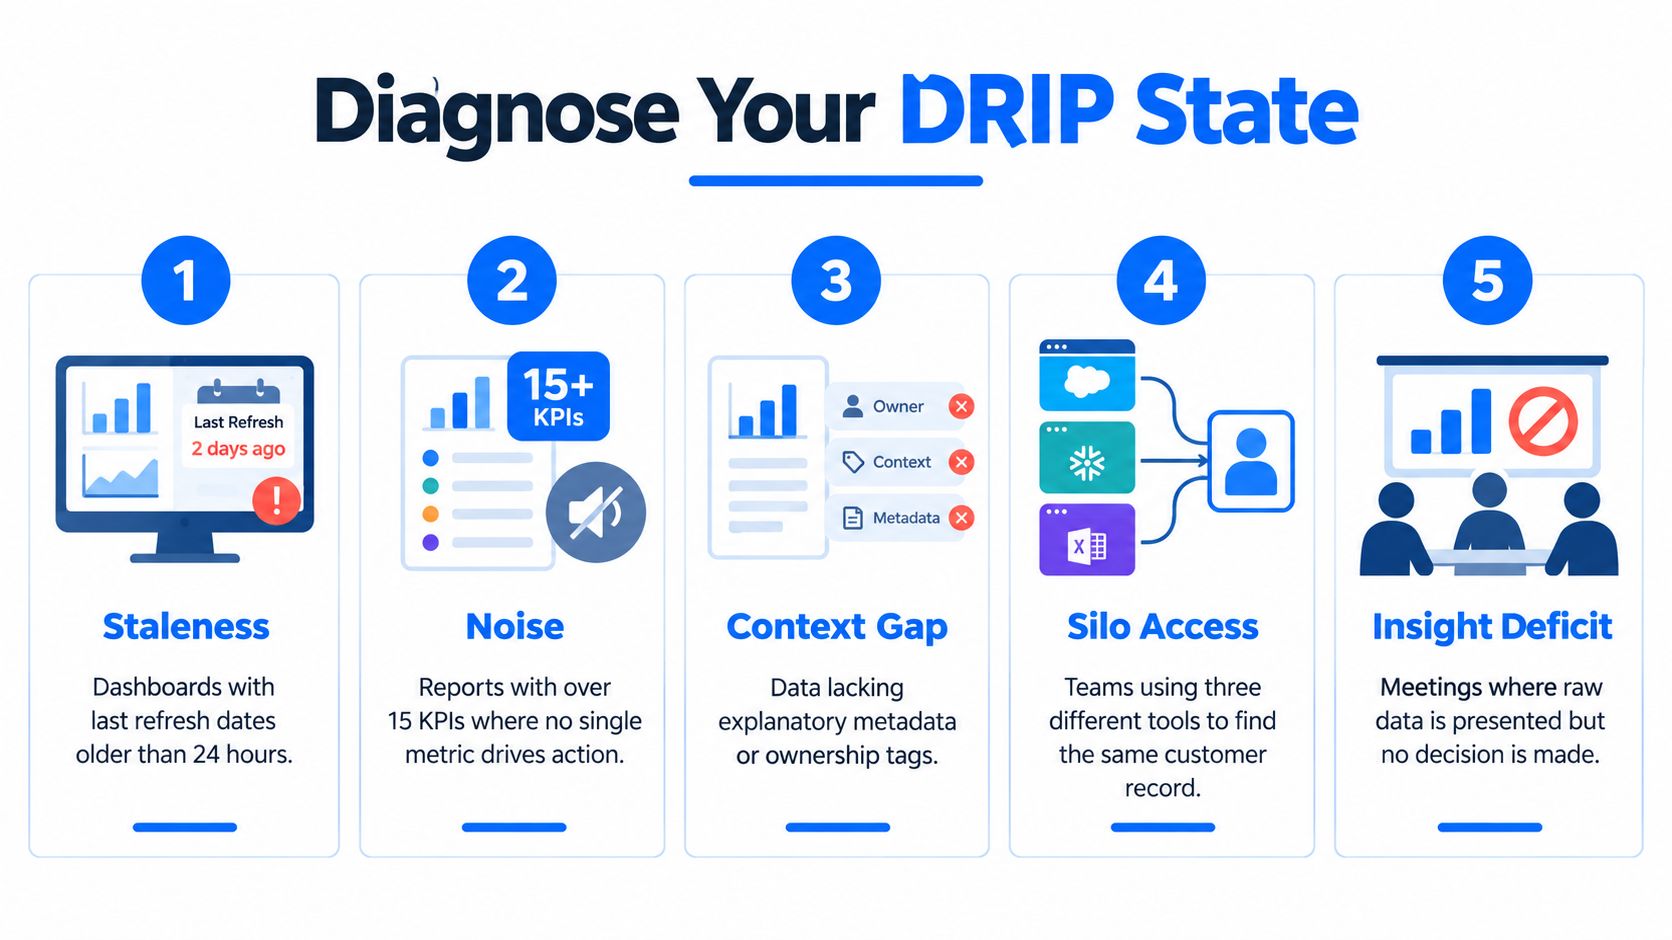
Nul besoin d'une enquête pour savoir si votre équipe est en situation de DRIP. Il suffit de repérer les symptômes qui apparaissent dans le travail quotidien. Le plus évident est l'obsolescence, facile à repérer lorsque l'actualisation d'un tableau de bord dépasse son niveau de service sans que personne ne le remarque, ou lorsque l'horodatage d'un rapport n'a pas bougé depuis des semaines. Si le chiffre semble à jour mais que le chargement qui le sous-tend ne l'est pas, le tableau de bord n'est que décoratif.
Cinq signaux qui apparaissent généralement ensemble
Obsolescence : l'actualisation est en retard, l'horodatage n'a pas changé ou la dernière exécution n'a pas abouti à temps.
Changements de distribution silencieux : un KPI change d'allure sans raison métier évidente.
Dérive de schéma : une table source ajoute, supprime ou renomme des champs, et la logique en aval continue de s'exécuter.
Échecs de livraison corrigés à la main : quelqu'un recharge le fichier, modifie l'extraction ou relance le job sans corriger la cause profonde.
Variations de KPI inexpliquées : les réunions tournent en rond autour du même chiffre, car personne ne se fie à la hausse ou à la baisse.
Les contrôles les plus rapides sont aussi les plus utiles. Les contrôles de fraîcheur indiquent si les données sont arrivées au moment prévu. Le scoring statistique des anomalies indique si le schéma a changé d'une manière qui mérite un examen humain. La comparaison de schémas révèle les changements structurels avant qu'ils ne cassent les consommateurs en aval. Le tri fondé sur le lignage indique où la rupture a commencé, au lieu de laisser les équipes deviner. La référence interne sur les métriques d'observabilité des données est un bon complément si vous souhaitez associer ces contrôles à des signaux opérationnels.
Un petit exemple dans le commerce de détail qui révèle le schéma
Une équipe d'analytique dans le commerce de détail constate une baisse du chiffre d'affaires, un flux d'entrepôt en retard et une colonne renommée dans la table produits en amont. Aucun de ces signes ne prouve à lui seul que le pipeline est cassé. Ensemble, ils désignent un seul job ETL en échec que personne n'a signalé, car le rapport s'affichait toujours et l'erreur était masquée par une correction manuelle.
Si plus de deux de ces cinq signaux sont présents, vous êtes déjà en situation de DRIP. À ce stade, la question n'est pas de savoir si les données existent. Elle est de savoir si l'organisation peut s'y fier assez vite pour agir.
Cinq contrôles opérationnels pour combler l'écart
Un tableau de bord peut paraître sain alors que le pipeline sous-jacent dérive déjà. Ce sont les contrôles qui détectent cette dérive avant que les équipes ne commencent à débattre du chiffre réel. Chacun couvre un mode de défaillance différent. La gouvernance clarifie les responsabilités et le lignage. L'observabilité fait ressortir les comportements inattendus. Le contrôle de la ponctualité garde la latence visible. La validation bloque les enregistrements erronés avant qu'ils ne se propagent. Le suivi de schéma détecte les changements structurels avant que les systèmes en aval n'interprètent mal les données.
Contrôle | Symptôme DRIP traité | Mise en œuvre minimale viable | Mode de défaillance en son absence |
|---|---|---|---|
Gouvernance | Confusion sur les responsabilités et le lignage | Désigner des responsables, définir les éléments de données critiques, maintenir le lignage | Une gouvernance de façade, sans responsabilité opérationnelle |
Observabilité | Anomalies silencieuses et chargements manquants | Contrôles continus des anomalies et de la fraîcheur sur les tables critiques | Les équipes ne remarquent les problèmes qu'une fois les tableaux de bord faussés |
Ponctualité | Résultats obsolètes | Définir des SLA de fraîcheur pour les pipelines clés et des alertes en cas de fenêtre manquée | Des données exactes arrivent malgré tout trop tard pour être utiles |
Validation | Enregistrements erronés qui se propagent en aval | Contrôles des règles métier lors de l'ingestion et avant la transformation | Les erreurs se propagent dans le reporting, la conformité et les données d'entrée de l'IA |
Suivi de schéma | Dérive structurelle | Comparer le schéma entrant à la structure attendue à chaque chargement | Les jobs en aval échouent silencieusement ou interprètent mal les données |
Les contrôles fonctionnent ensemble, pas par paliers
La gouvernance sans observabilité se réduit à de la paperasserie. L'observabilité sans validation repère un symptôme tout en laissant passer les données erronées. La validation sans contrôle de la ponctualité produit des données propres qui arrivent après la fermeture de la fenêtre de décision. Le suivi de schéma sans responsabilités définies déclenche une alerte, mais personne n'est clairement chargé de la correction.
C'est pourquoi les équipes ont besoin d'un ensemble de contrôles, et non d'une solution unique. Un modèle pratique est digna, qui exécute des contrôles de qualité et d'observabilité des données dans l'environnement du client, couvrant les anomalies, la ponctualité, la validation, le suivi de schéma et la surveillance métier.
L'objectif est de réduire l'écart entre un changement dans les données et une décision sûre sur la marche à suivre. Un pipeline lent, un changement de schéma caché ou un chargement échoué doivent apparaître comme un problème de confiance, et non comme une surprise lors de la revue hebdomadaire. Lorsque ces contrôles fonctionnent ensemble, le tableau de bord cesse d'être une sonnette d'alarme et devient un socle de confiance pour l'entreprise.
Des usines à règles à l'observabilité pilotée par l'IA en pratique
Un fabricant multinational peut passer ses vendredis à écrire manuellement des contrôles de seuils pour les flux de capteurs, puis découvrir le lundi que ces règles étaient déjà obsolètes. Ce modèle ne passe pas à l'échelle lorsque l'environnement compte des millions de signaux, d'autant que des analyses récentes du secteur industriel affirment que moins de 1 % des données quotidiennes des usines servent à la prise de décision (le DRIP et le problème du contexte dans l'industrie). Les usines à règles manuelles transforment les ingénieurs en personnel de maintenance, et elles passent malgré tout à côté des moments qui comptent.
Ce qui change lorsque l'observabilité apprend la référence
L'observabilité pilotée par l'IA remplace les seuils rigides par des références apprises, de sorte qu'un moniteur peut signaler une nouvelle rupture lorsque la cardinalité, la fraîcheur ou le comportement du schéma sortent des schémas normaux. C'est essentiel lorsque la défaillance est inédite. Une règle écrite pour le pipeline du mois dernier ne détectera pas une nouvelle organisation des champs ou un schéma de retard inattendu, mais un moniteur adaptatif peut tout de même le signaler, comme l'explique ce guide sur la manière dont l'IA détecte les anomalies de données dans les pipelines.
Voici un contraste utile :
Capacité | Usine à règles | Observabilité pilotée par l'IA |
|---|---|---|
Définition des seuils | Rédigés manuellement par les ingénieurs | Apprend le comportement normal à partir des données |
Détection des changements | Ne détecte que les modes de défaillance connus | Signale les changements inédits de volume, de fraîcheur ou de schéma |
Charge de maintenance | Élevée, car les règles vieillissent vite | Plus faible, car les références se mettent à jour avec le jeu de données |
Qualité des alertes | Souvent bruyantes ou fragiles | Davantage centrées sur les écarts les plus significatifs |
Utilisation par les équipes | Centralisée au sein de l'ingénierie | Suffisamment modulaire pour être utilisée par les équipes métier |
Le compromis est réel. L'IA réduit la fatigue d'alerte et détecte des schémas inconnus, mais elle nécessite toujours une supervision. Les références peuvent dériver, les modèles peuvent vieillir, et un système intelligent a toujours besoin d'humains pour examiner les exceptions, confirmer la cause profonde et réintégrer le résultat dans la gouvernance. Cette boucle de rétroaction compte davantage que l'alerte elle-même.
Une meilleure automatisation ne supprime pas la responsabilité, elle la fait intervenir plus tôt.
Les dispositifs les plus solides combinent une détection fondée sur des modèles, un scoring de fraîcheur tenant compte du lignage et des moniteurs modulaires que les équipes métier peuvent assembler sans ouvrir un ticket pour chaque nouvelle règle. C'est une approche praticable à grande échelle, car le coût du contrôle manuel dépasse déjà la valeur qu'il apporte.
Vos premiers pas pour devenir riche en informations
Ajouter un tableau de bord supplémentaire aggrave généralement le DRIP si le nouveau graphique ne s'appuie pas sur une validation, un lignage ou un contrat de fraîcheur. Chaque vue supplémentaire peut devenir un nouveau lieu de débat sur le chiffre plutôt qu'un nouveau moyen de s'y fier. La première étape ne consiste pas à produire davantage de rapports, mais à raccourcir la boucle de rétroaction.
Un plan pratique sur 90 jours
Désignez les responsables : attribuez un responsable humain à chaque jeu de données critique et à chaque KPI métier.
Rédigez le contrat : définissez ce que signifie « correct » pour les tables clés, notamment en matière de fraîcheur et de valeurs acceptées.
Instrumentez le pipeline le plus à risque : ajoutez une détection d'anomalies et des contrôles de fraîcheur au flux de chiffre d'affaires ou d'opérations le plus important.
Ajoutez une validation en bordure : contrôlez les enregistrements dans la CI ou lors de l'ingestion avant que les valeurs erronées ne se propagent.
Suivez les changements de schéma : déclenchez des alertes sur les champs nouveaux, manquants ou renommés avant que les consommateurs ne cassent.
Choisissez un KPI de bout en bout : suivez-le de la source jusqu'au tableau de bord afin que chaque étape soit visible.
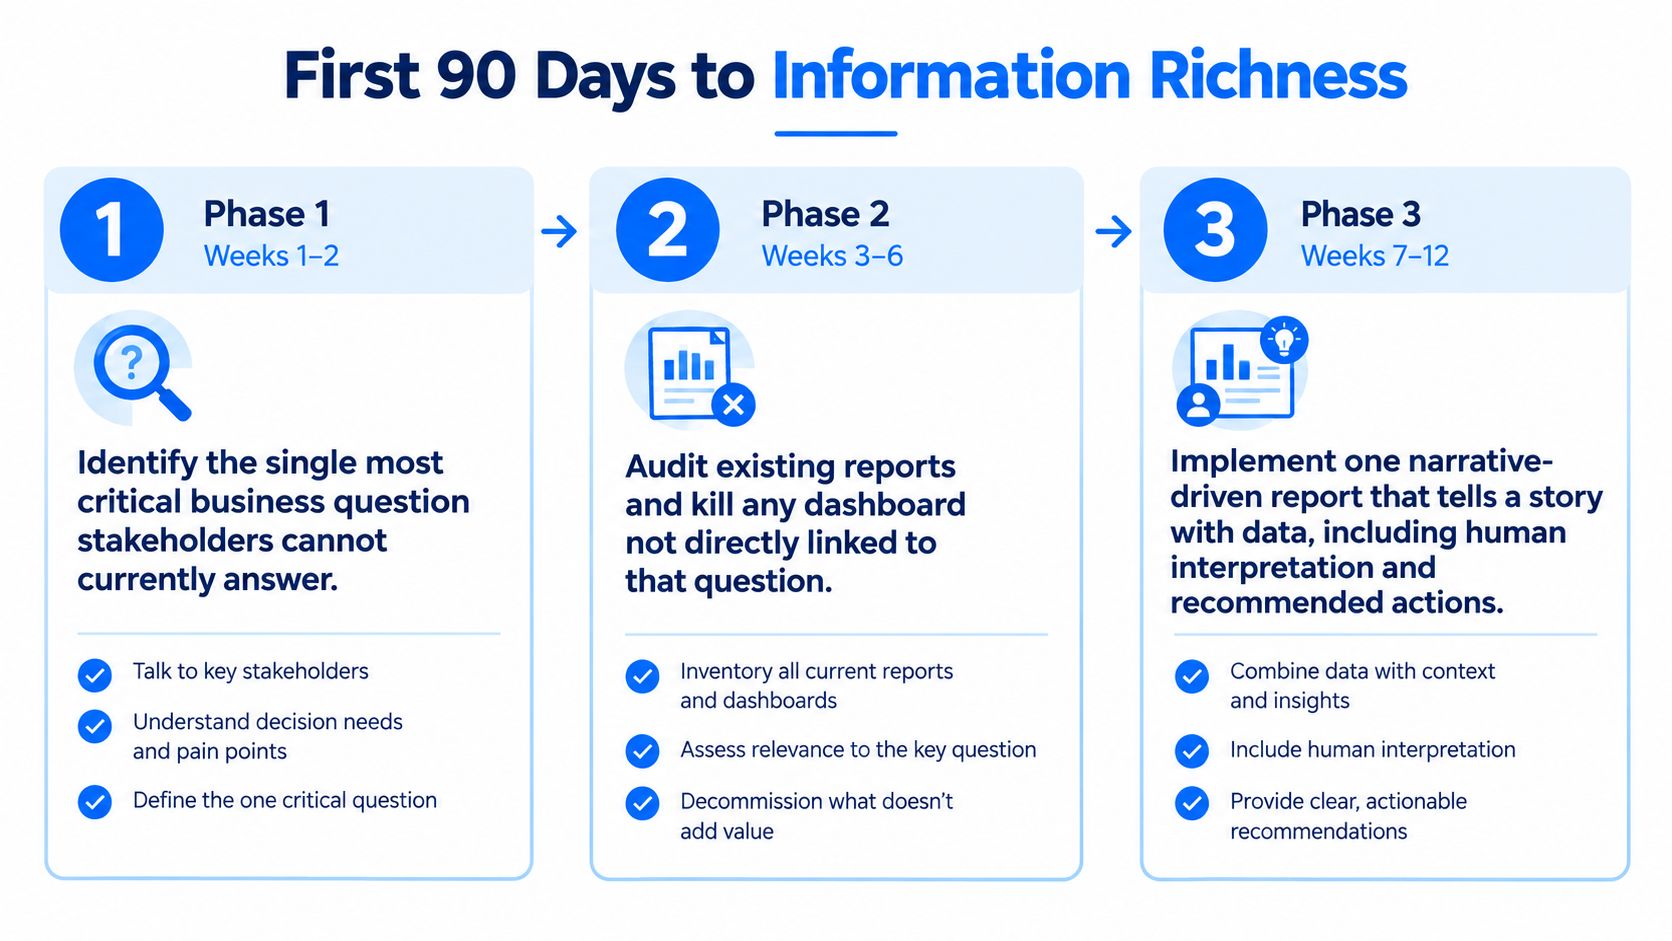
Le point de départ le plus simple est une décision hebdomadaire que l'équipe prend déjà. Instrumentez les données qui la sous-tendent afin que la réponse puisse être défendue sans branle-bas de combat. Si l'équipe peut expliquer le chiffre, s'y fier et agir en conséquence au cours de la même réunion, vous sortez du DRIP pour entrer dans la richesse informationnelle.
Si vous cherchez à transformer vos données en éléments auxquels l'entreprise peut se fier, digna vous en donne les moyens : détection d'anomalies, surveillance de la ponctualité, validation, suivi de schéma et surveillance métier, au sein de votre propre environnement. Rendez-vous sur digna pour découvrir comment ces contrôles peuvent aider à combler l'écart entre les données brutes et la prochaine décision.
Pour rendre visibles les fenêtres de fraîcheur et les chargements manqués avant qu'un KPI obsolète n'arrive en revue hebdomadaire, découvrez comment digna Timeliness apprend à quel moment chaque jeu de données est censé arriver.
Questions fréquentes
Que signifie être riche en données mais pauvre en informations ?
Être riche en données mais pauvre en informations, ou DRIP, désigne l'écart entre la quantité de données qu'une entreprise collecte et la quantité d'informations exploitables pour décider auxquelles elle peut se fier. Une donnée brute est une ligne, un événement ou une ligne de journal ; une information est ce même signal doté d'un contexte, d'une fraîcheur, d'un responsable et d'explications suffisantes pour guider l'action.
D'où vient l'expression « riche en données, pauvre en informations » ?
Elle a été popularisée en 1983 par le livre de management In Search of Excellence. Des commentaires ultérieurs l'ont rattachée à une estimation de 2010 selon laquelle la surcharge d'informations coûtait 997 milliards de dollars par an à l'économie américaine, sur la base de 78,6 millions de travailleurs du savoir à temps plein, ce qui explique pourquoi l'expression trouve encore un écho auprès des équipes d'analytique.
Pourquoi les organisations sont-elles riches en données mais pauvres en informations ?
Quatre causes structurelles se combinent généralement : la fragmentation des données entre entrepôts de données, applications SaaS et tableurs ; la prolifération des outils sans vue partagée de la qualité ou du lignage ; la surcharge d'informations due à un trop grand nombre de tableaux de bord ; et la latence de traitement, lorsque les pipelines batch livrent les données une fois la fenêtre de décision passée.
Combien coûte une mauvaise qualité des données à une entreprise ?
Une estimation largement citée chiffre le coût moyen à 12,9 millions de dollars par an. Ce coût augmente aussi avec le temps : environ 1 $ par enregistrement pour prévenir une erreur, 10 $ pour l'identifier et la corriger, et 100 $ pour la rectifier une fois qu'elle a atteint un rapport, un moteur de tarification ou une procédure de conformité.
Comment savoir si mon équipe est riche en données mais pauvre en informations ?
Repérez cinq signaux : des tableaux de bord obsolètes, des changements de distribution silencieux, une dérive de schéma, des échecs de livraison corrigés à la main et des variations de KPI que personne ne sait expliquer. Selon la règle de l'article, si plus de deux de ces signaux sont présents, votre équipe est déjà en situation de DRIP et ne peut pas se fier assez rapidement à ses données.



