Qu'est-ce que la simulation de Monte-Carlo
|
7
minute de lecture

Vous êtes en réunion avec une date limite, un tableau de bord vacille et quelqu'un demande un chiffre unique. Le responsable de la plateforme souhaite une prévision de la latence du pipeline, le responsable financier a besoin d'une vue budgétaire pour un lancement, et le responsable de la logistique scrute le trafic, la météo et les retards aux quais. Une estimation unique semble ordonnée, mais elle cache la partie la plus importante : l'éventail des résultats plausibles.
La simulation de Monte-Carlo est la méthode qui transforme cette supposition unique en une distribution de futurs. Pour ce faire, elle remplace la certitude par un échantillonnage aléatoire répété, puis laisse les résultats montrer ce qui est probable, ce qui est risqué et ce qui n'est que du bruit. C'est pourquoi elle continue d'apparaître dans la finance, l'ingénierie et les systèmes de données d'entreprise qui doivent prendre des décisions dans l'incertitude.
Table des matières
Une question pour laquelle vous avez déjà besoin de Monte-Carlo
Pourquoi cela change la conversation
L'idée centrale de la simulation de Monte-Carlo
La formule mathématique sans le brouillard
Comment se déroule réellement une simulation de Monte-Carlo
Les quatre étapes en langage clair
Monte-Carlo par rapport aux formes analytiques et à l'analyse de sensibilité
Une règle de décision rapide
Où la simulation de Monte-Carlo apparaît dans le travail réel
Les quatre domaines où elle fait ses preuves
Compromis honnêtes et pièges courants
Les pièges qui déforment discrètement les résultats
Une check-list de notebook pour rester honnête
Des concepts de Monte-Carlo à l'Data Observability d'entreprise avec digna
Pourquoi l'approche de Monte-Carlo convient à l'observabilité
Ce qu'une équipe peut faire en premier
Une question pour laquelle vous avez déjà besoin de Monte-Carlo
Un responsable d'équipe de plateforme se fait demander la latence de fin de mois lors d'une revue de direction, mais l'équipe ne dispose que de deux semaines d'historique bruyant. Un responsable financier doit défendre le maintien du budget d'un lancement de produit alors que les dépenses publicitaires et les délais des fournisseurs ne cessent de varier. Un responsable logistique a besoin d'un délai de livraison prévu alors que le trafic, la météo et la disponibilité des quais évoluent tous en même temps. Dans chaque cas, une estimation unique semble confiante et est probablement fausse.
Le piège est que cette estimation réduit tout le problème à un seul chiffre. Elle ne dit rien sur la fréquence des dérives, sur la gravité des retards ou sur la stabilité du résultat pour pouvoir s'y fier. Une simulation de Monte-Carlo remplace ce chiffre unique par des milliers de futurs plausibles, tous issus de la même incertitude.
Pourquoi cela change la conversation
Une fois que vous voyez une distribution au lieu d'une estimation ponctuelle, la question change. Vous arrêtez de demander : « Quelle est la réponse ? » et vous commencez à demander : « Quelle est la largeur de la bande de risque et qu'est-ce qui la génère ? » C'est une bien meilleure question pour les budgets, les calendriers et les SLA opérationnels.
La méthode est simple à décrire, même si la modélisation demande du soin. Vous définissez les variables incertaines, vous y effectuez de nombreux prélèvements, vous calculez le résultat à chaque fois et vous résumez la dispersion. Si vous souhaitez une introduction connexe sur la façon dont les distributions de données brutes alimentent cette réflexion, la distribution de données est essentielle avant de pouvoir faire confiance à toute simulation.
Un modèle de Monte-Carlo ne promet pas la certitude. Il vous donne une image plus honnête de l'incertitude que vous rencontrez déjà.
L'idée centrale de la simulation de Monte-Carlo
Un bon modèle mental commence par une cible de fléchettes. Lancez des points de manière aléatoire sur un carré, comptez combien tombent à l'intérieur du cercle et utilisez ce ratio pour estimer π. C'est le cœur de la pensée de Monte-Carlo : des essais aléatoires répétés peuvent révéler des éléments difficiles à calculer directement. L'histoire ancienne de la méthode comprend des idées précurseurs comme l'aiguille de Buffon au XVIIIe siècle, puis une utilisation systématique au XXe siècle pour les problèmes d'intégration difficiles et d'incertitude Revue PMC.
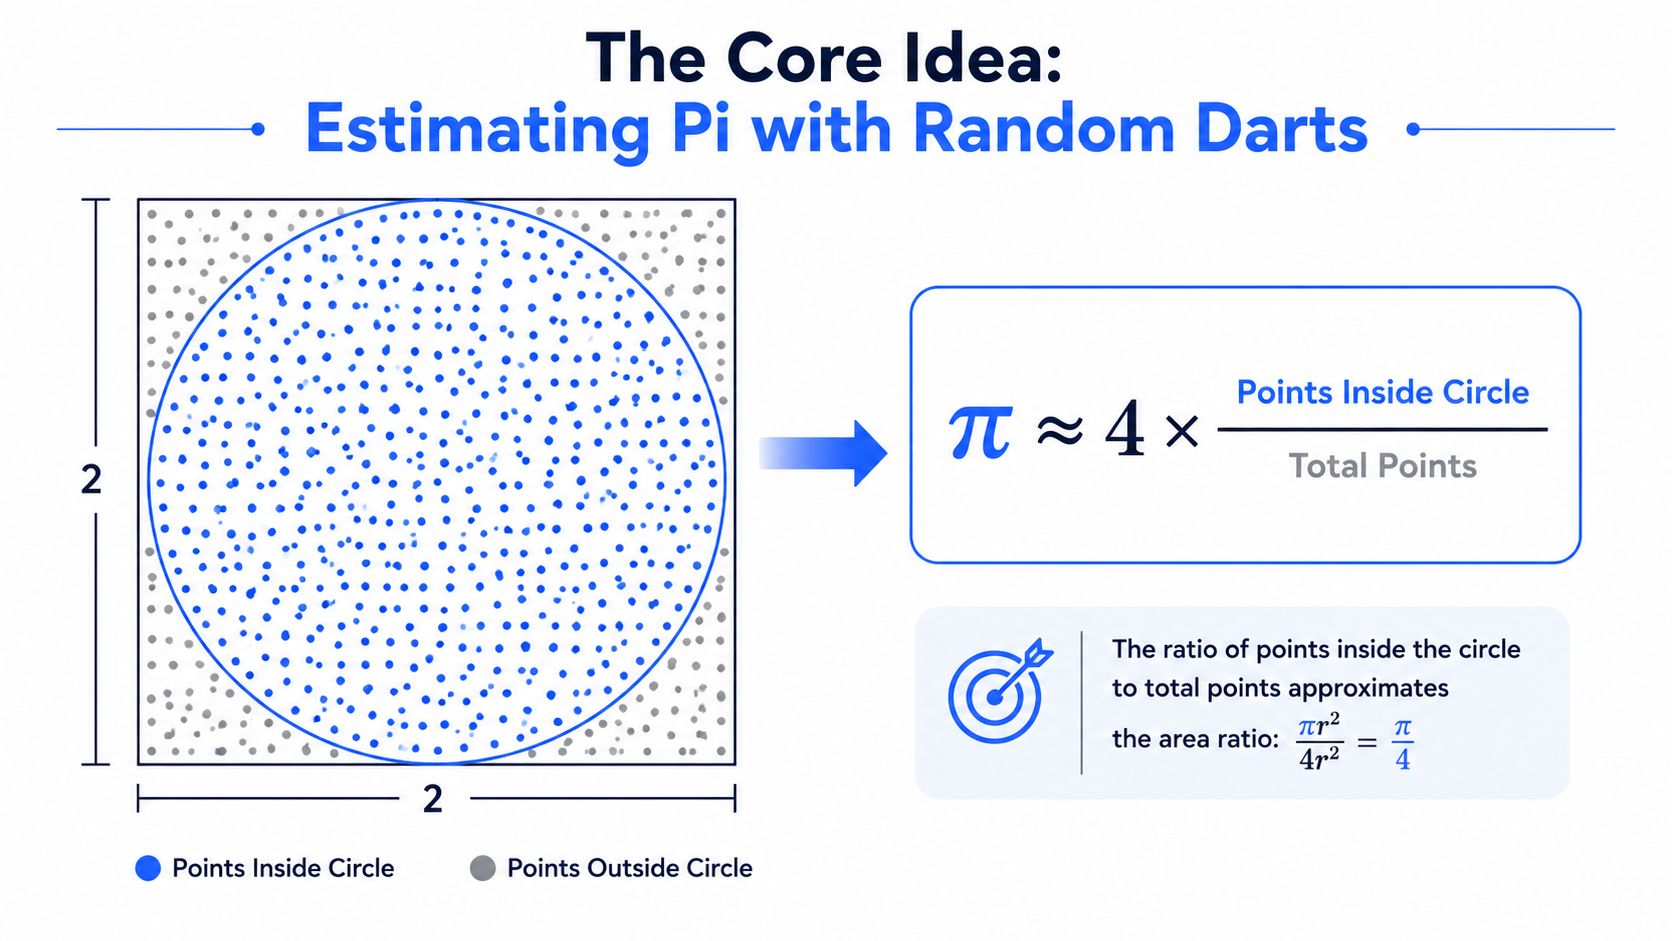
Au niveau technique moderne, une simulation de Monte-Carlo consiste à estimer une espérance mathématique, écrite simplement sous la forme E[f(X)], en effectuant de nombreux prélèvements aléatoires des variables incertaines X, en évaluant la fonction f à chaque fois et en calculant la moyenne des résultats. C'est cette même idée centrale qui est utilisée en finance, en ingénierie, en analyse de fiabilité et dans les sciences physiques et sociales, où l'ordinateur lance des milliers ou des millions d'essais pour étudier la variabilité Revue PMC.
La formule mathématique sans le brouillard
Vous n'avez pas besoin d'une formule analytique pour l'ensemble du système. Vous n'avez besoin que de deux choses : un moyen d'échantillonner les variables d'entrée et un moyen de calculer le résultat pour chaque essai. C'est pourquoi la méthode de Monte-Carlo est si utile pour les modèles non linéaires et les systèmes réels complexes ; elle ne dépend pas d'une algèbre élégante pour fonctionner.
La loi des grands nombres indique que la moyenne des résultats simulés tend vers l'espérance réelle à mesure que la taille de l'échantillon augmente. Le théorème central limite donne la raison pratique de cette apparente stabilité : l'erreur standard diminue approximativement avec la racine carrée de la taille de l'échantillon. Les notes de cours de finance du MIT explicitent ce changement d'échelle : l'erreur d'estimation directe a tendance à chuter à environ σ/√n, c'est pourquoi la précision ne s'améliore que lentement à mesure que vous ajoutez des simulations MIT OCW.
Règle pratique : si votre problème peut être échantillonné et évalué, Monte-Carlo peut généralement l'estimer, même lorsque l'algèbre exacte devient complexe ou impossible.
Cette polyvalence est tout l'intérêt de la méthode. Elle existe parce que de nombreux systèmes réels refusent de se résumer à une formule simple.
Comment se déroule réellement une simulation de Monte-Carlo
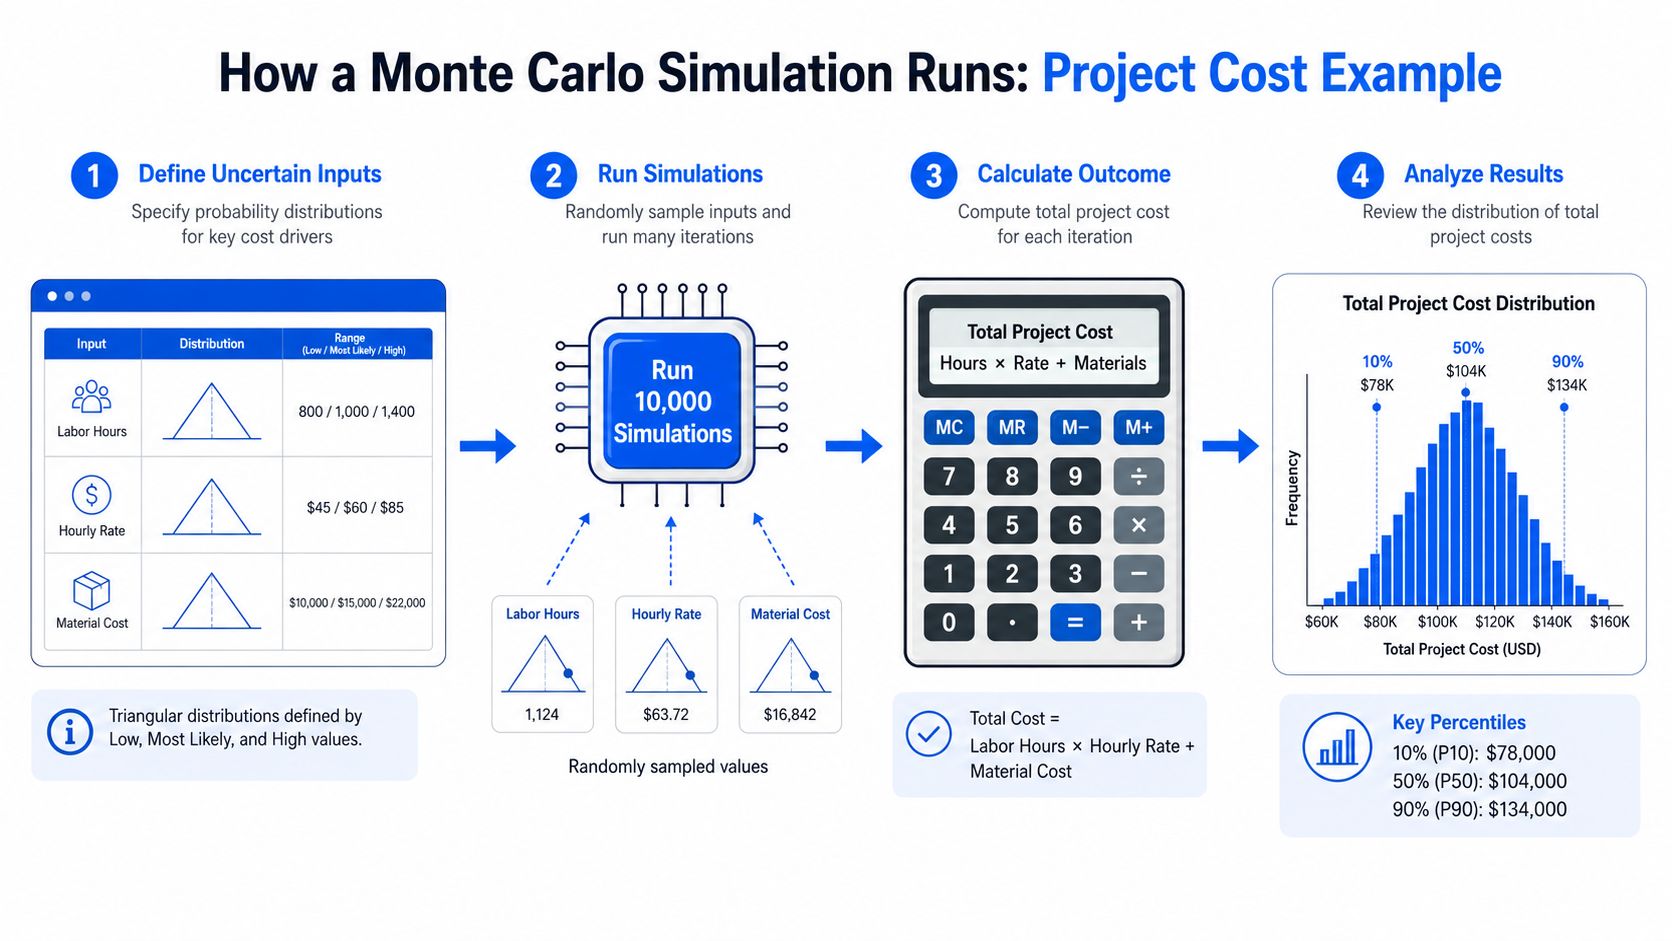
Un exemple pratique permet de mieux comprendre le processus. Supposons que vous estimiez le coût total d'un projet et que les éléments incertains soient les heures de travail, le taux horaire et le coût des matériaux. Vous ne connaissez pas précisément l'une de ces variables, vous décrivez donc chacune d'elles par une distribution de probabilité plutôt que par une valeur fixe, souvent en utilisant des données historiques, un jugement d'expert ou les deux.
Les quatre étapes en langage clair
Tout d'abord, définissez les variables d'entrée et choisissez les distributions qui leur correspondent. Une distribution triangulaire est courante dans la gestion de projet car les gens connaissent souvent une estimation basse, probable et haute, même s'ils ne disposent pas d'une courbe parfaitement mesurée.
Deuxièmement, prélevez une valeur dans chaque distribution d'entrée pour construire un scénario unique. Ce scénario unique devient un monde possible, et vous calculez le résultat, ici le coût total.
Troisièmement, répétez cette boucle de tirage et d'évaluation de nombreuses fois. Les sources d'enseignement et de recherche modernes décrivent cela comme une méthode expérimentale assistée par ordinateur capable de générer des milliers ou des millions d'essais aléatoires pour étudier les distributions et les risques Revue PMC.
Quatrièmement, résumez la liste des résultats sous la forme de sa propre distribution. Vous pouvez examiner la moyenne, la médiane, l'histogramme et les percentiles importants pour une prise de décision, car ils vous indiquent le comportement du coût sur l'ensemble des résultats plausibles.
Habitude opérationnelle : surveillez la moyenne courante pendant l'exécution de la simulation. Si elle continue de fluctuer, vous n'avez probablement pas lancé assez d'essais pour que l'estimation se stabilise.
Un simple aperçu en pseudocode ressemble à ceci :
Une version Python minimale est tout aussi directe :
Pour analyser de plus près la manière dont les hypothèses de données sont définies avant l'exécution d'un modèle, la page sur les méthodes statistiques pour l'analyse des données est un complément utile. La question clé de mise en œuvre est la convergence : lorsque l'ajout d'échantillons ne modifie plus la réponse de manière significative, vous avez généralement atteint un point d'arrêt exploitable.
Monte-Carlo par rapport aux formes analytiques et à l'analyse de sensibilité
Un modèle de coût de projet peut être abordé de trois manières différentes, et chacune répond à une question distincte. Les mathématiques analytiques fournissent une solution directe lorsque les formules sont résolubles. L'analyse de sensibilité perturbe une variable à la fois pour voir quelle hypothèse détermine le résultat. La simulation de Monte-Carlo exécute de nombreux scénarios complets et renvoie l'éventail des résultats, y compris la probabilité de dépassement budgétaire.
Dimension | Mathématiques analytiques | Analyse de sensibilité | Simulation de Monte-Carlo |
|---|---|---|---|
Question principale | Quelle est la réponse exacte ? | Quelle variable d'entrée importe le plus ? | Quels résultats sont plausibles, et à quelle fréquence ? |
Variables d'entrée | Formules fixes, souvent exactes | Une variable change à la fois | De nombreuses variables incertaines varient ensemble |
Résultat | Chiffre unique ou expression exacte | Influence classée ou direction du changement | Distribution complète des résultats |
Meilleure utilisation | Modèles linéaires simples et résolubles | Isoler les facteurs déterminants | Risque, comportement des queues de distribution, incertitudes interdépendantes |
Point faible | Échoue lorsque les mathématiques deviennent complexes | Ignore les interactions | Nécessite de l'échantillonnage, de la validation et de la puissance de calcul |
Les mathématiques analytiques sont efficaces lorsque le modèle est suffisamment simple. L'analyse de sensibilité est utile pour savoir quelle hypothèse corriger en premier. Monte-Carlo est l'outil idéal lorsque l'incertitude provient de nombreuses variables interdépendantes, que les corrélations sont importantes ou que le modèle est non linéaire.
Une façon claire de l'envisager est d'analyser le compromis entre biais et variance. Un raccourci déterministe peut être élégant mais trompeur, tandis qu'une simulation plus riche peut mieux capturer la réalité si les données d'entrée sont fiables.
Une règle de décision rapide
Si vous n'avez besoin que d'une orientation approximative, l'analyse de sensibilité peut suffire. Si le modèle possède une forme analytique et que les variables d'entrée sont stables, utilisez les mathématiques exactes. Si le résultat dépend de nombreux facteurs incertains et que la décision repose sur la queue de distribution, Monte-Carlo justifie sa puissance de calcul.
Pour les équipes qui conçoivent des flux de données, la même logique s'applique à l'analyse des anomalies. La page sur les méthodes d'identification des valeurs aberrantes est pertinente lorsqu'un seul point erroné peut fausser un modèle par ailleurs sain.
Où la simulation de Monte-Carlo apparaît dans le travail réel
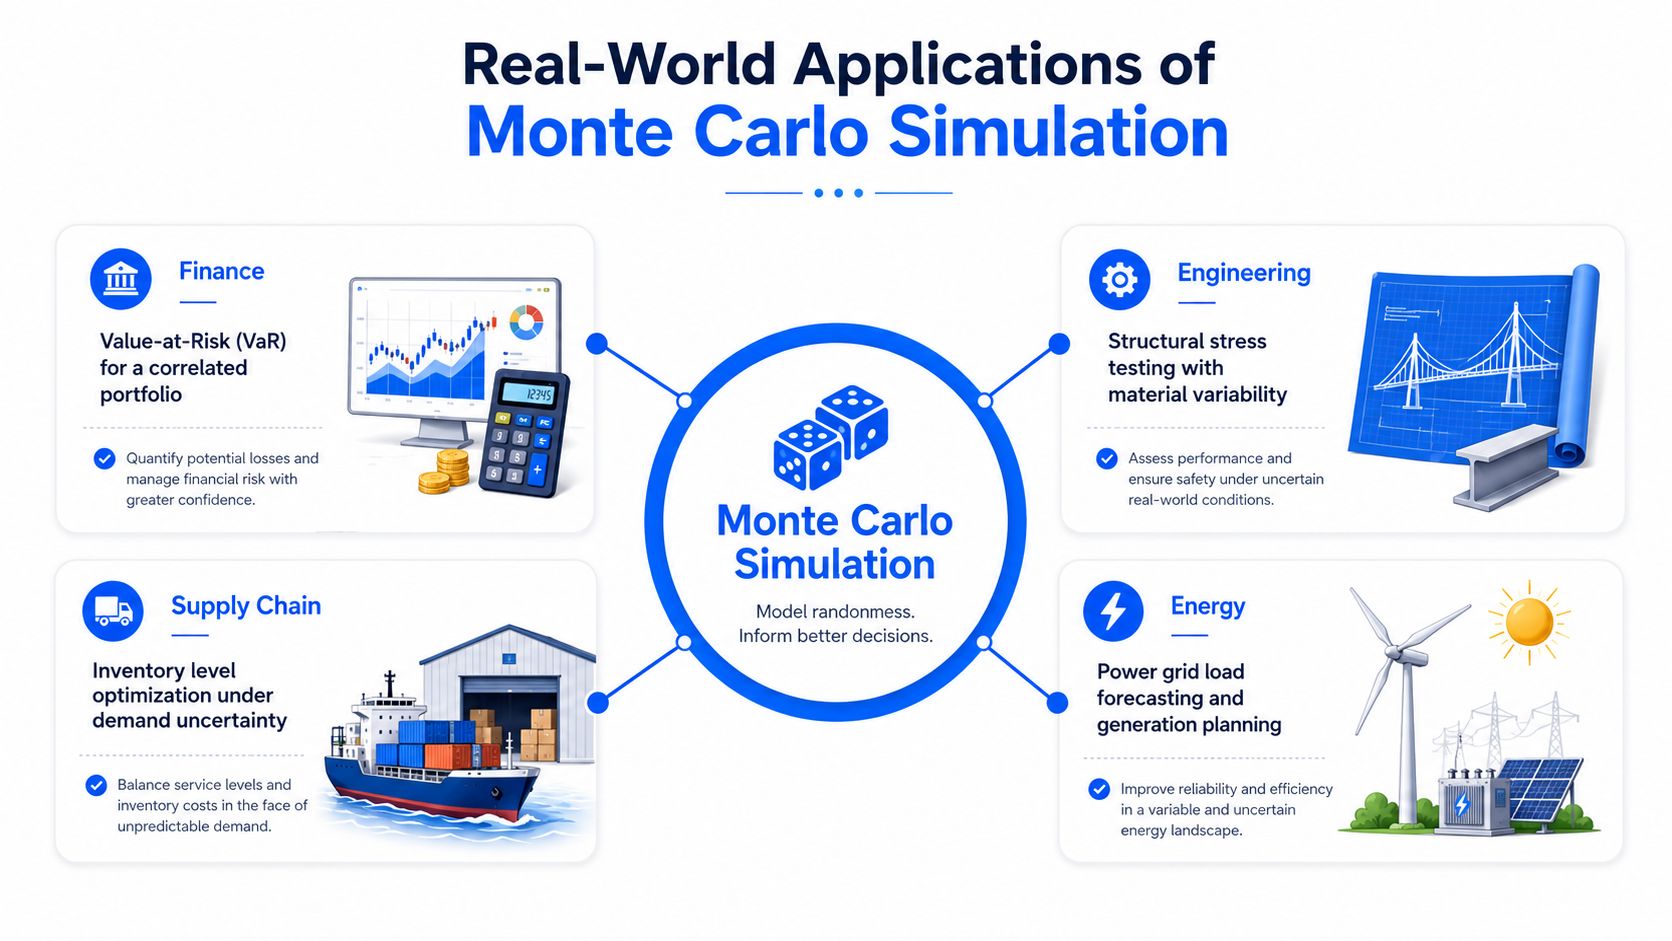
Les cas d'utilisation les plus solides partagent tous la même structure : la décision dépend de la queue de distribution, pas seulement de la moyenne. En finance, Monte-Carlo soutient la Value-at-Risk sur des portefeuilles d'actifs corrélés, car le comportement conjoint de ces actifs détermine le risque de perte. En ingénierie, elle aide à l'analyse de la fiabilité lorsque différents composants tombent en panne à des rythmes différents, de sorte que la vision globale du système importe plus que n'importe quelle pièce isolée.
Les quatre domaines où elle fait ses preuves
Dans la planification de la Timeliness, un modèle de Monte-Carlo peut estimer la probabilité de violation d'un SLA lorsque chaque étape du pipeline présente des variations. C'est bien plus utile qu'une heure d'arrivée estimée unique, car les opérateurs ont besoin de connaître la probabilité des scénarios défavorables.
Dans l'Data Observability, la même idée apparaît dans la détection des anomalies. Une plateforme peut traiter les signaux de fraîcheur, de volume et de schéma comme des données incertaines, échantillonner des états de métriques plausibles et estimer si une alerte reflète un incident réel ou juste du bruit. Cela correspond parfaitement au travail d'anomalie de style Monte-Carlo de digna, et la page sur la détection des Data Anomalies dans votre plateforme de données grâce aux simulations de Monte-Carlo correspond à ce cas d'utilisation.
Dans la planification de la chaîne d'approvisionnement et de l'énergie, le schéma se répète. L'incertitude de la demande, le risque de stock et la prévision de charge deviennent tous plus faciles à appréhender dès lors que le modèle renvoie une gamme de résultats probables au lieu d'une unique prévision optimiste.
Si la décision change lorsque la queue de distribution change, une estimation ponctuelle est généralement trop fragile pour qu'on s'y fie.
Il y a également une leçon importante sur les systèmes ici. Monte-Carlo n'est pas réservé aux analystes quantitatifs de la finance ou aux scientifiques. Toute équipe qui doit répondre à la question « Que se passe-t-il lorsque plusieurs éléments incertaines évoluent ensemble ? » se trouve déjà dans le domaine de Monte-Carlo.
Compromis honnêtes et pièges courants
Monte-Carlo est puissant, mais ce n'est pas de la magie. La limite la plus importante est la lenteur de la réduction de l'erreur ; l'erreur d'estimation directe diminue avec σ/√n, de sorte que diviser l'erreur par deux coûte beaucoup plus de puissance de calcul que ce que l'on imagine MIT OCW. C'est pourquoi les méthodes de réduction de la variance sont importantes : elles réduisent la variance de l'estimateur sans modifier son espérance, ce qui vous donne un intervalle plus serré pour le même budget CPU Frontiers in Physics.
Les pièges qui déforment discrètement les résultats
Le premier piège est la qualité des variables d'entrée. Si les distributions ne reflètent pas la réalité, la simulation produit simplement une réponse erronée plus sophistiquée. Une queue de distribution gaussienne peut sembler rassurante dans un modèle de risque alors que le monde réel présente des queues beaucoup plus épaisses.
Le second piège est l'aveuglement face aux corrélations. Les débutants échantillonnent souvent les variables d'entrée de manière indépendante parce que c'est plus simple, puis obtiennent des résultats trop lisses et trop favorables. Cette erreur est particulièrement coûteuse dans la gestion de portefeuille, les modèles de fiabilité et tout système où des facteurs communs évoluent ensemble.
Le troisième piège est une convergence qui ne semble correcte qu'à l'œil nu. Une moyenne courante qui se stabilise visuellement peut encore masquer une instabilité dans la queue de distribution, vous avez donc besoin d'une règle d'arrêt, pas seulement d'une intuition.
Le quatrième piège est la variance silencieuse des événements rares. Si l'événement qui vous intéresse se produit rarement, un nombre insuffisant de simulations peut l'omettre complètement, ce qui donne au résultat une apparence plus sûre qu'il ne l'est. Monte-Carlo peut sous-estimer les extrêmes lorsque les distributions choisies sont trop modérées, en particulier dans les contextes de finance et de risque systémique Analytica sur Monte-Carlo en finance.
Une check-list de notebook pour rester honnête
Validez chaque variable d'entrée par rapport aux données historiques ou au jugement d'expert avant de simuler.
Intégrez la corrélation là où des facteurs communs évoluent ensemble.
Choisissez une règle d'arrêt basée sur la stabilité du résultat, et non sur un nombre arbitraire de simulations.
Présentez une bande de confiance, et pas seulement une réponse unique.
Considérez le modèle comme un ensemble d'hypothèses parmi d'autres, et non comme une vérité absolue.
Le guide des stratégies de migration ETL rappelle utilement que les systèmes de données en aval dépendent également de la qualité des hypothèses. Si la structure en amont est incorrecte, la réponse en aval sera bruitée, quelle que soit l'élégance du calcul.
Des concepts de Monte-Carlo à l'Data Observability d'entreprise avec digna
Dans l'observabilité d'entreprise, l'approche de Monte-Carlo se traduit par l'apprentissage des profils de référence (baselines) et les alertes probabilistes. digna surveille les tables, les pipelines, les modèles de fraîcheur et les métriques métier au sein même de l'environnement du client, puis apprend à quoi ressemble un comportement normal sans obliger les équipes à coder en dur des règles rigides. C'est important car les données ne se contentent pas d'arriver, elles arrivent avec des variations, de la saisonnalité et des anomalies occasionnelles.
Pourquoi l'approche de Monte-Carlo convient à l'observabilité
La démarche utile consiste à traiter la fraîcheur attendue, le nombre de lignes et les taux de valeurs nulles comme des distributions, et non comme des seuils fixes. Une fois qu'une plateforme a appris cette référence, elle peut comparer les valeurs réelles à la plage apprise et estimer si l'état actuel est inhabituel. C'est la même logique que Monte-Carlo utilise dans d'autres domaines : un échantillonnage répété pour comprendre l'éventail des résultats plausibles.
La boucle pratique est facile à suivre. digna apprend un profil de référence de fraîcheur à partir du comportement historique des arrivées, échantillonne les états de retard attendus à partir de cette distribution apprise, puis évalue l'observation actuelle par rapport à ces états pour décider si la latence semble anormale. Le résultat est un signal basé sur la confiance, et pas seulement une alarme oui/non.
Cette approche s'intègre naturellement dans les travaux de migration et de modification des pipelines. Si une équipe déplace des flux de données ou retravaille des sources, le guide des stratégies de migration ETL fournit le contexte opérationnel global, tandis que l'observabilité de type Monte-Carlo aide à évaluer si le nouveau comportement dérive.
Ce qu'une équipe peut faire en premier
Activez l'apprentissage de référence pour les tableaux de bord et les pipelines critiques afin que le système connaisse le comportement normal avant de signaler des exceptions.
Comparez les distributions observées aux alertes à seuil statique, car les seuils seuls ignorent la variation.
Utilisez des bandes de confiance pour hiérarchiser les investigations d'astreinte, afin que les signaux les plus bruyants ne monopolisent pas la file d'attente.
Pour les équipes qui souhaitent un espace unique pour connecter ces idées, la page Alternative de données Monte-Carlo pour l'observabilité des données d'entreprise montre comment ce schéma s'applique à la surveillance opérationnelle.
Le point essentiel est simple. La réflexion de type Monte-Carlo vous aide à poser une meilleure question : « Quelle est la probabilité que cet état soit réel ? » En observabilité, cette question importe souvent plus que de savoir si une métrique a franchi une ligne fixe.
Si vous essayez de prendre des décisions de fiabilité des données avec moins de suppositions, visitez digna et découvrez comment l'apprentissage des profils de référence, la surveillance de la Timeliness et la détection des Data Anomalies fonctionnent ensemble au sein de la même plateforme d'Observability. C'est un moyen pratique d'appliquer une réflexion sur l'incertitude de style Monte-Carlo aux pipelines, aux tableaux de bord et aux métriques métier qui ne peuvent pas se permettre des alertes bruyantes.
Questions fréquentes
Qu'est-ce qu'une simulation de Monte-Carlo ?
L'estimation d'une espérance, écrite simplement E[f(X)], en tirant de nombreux échantillons aléatoires des entrées incertaines X, en évaluant la fonction f à chaque fois et en moyennant les résultats. En pratique, elle remplace une estimation unique par des milliers de futurs plausibles issus de la même incertitude.
Pourquoi une distribution vaut-elle mieux qu'une valeur ponctuelle ?
Parce qu'elle change la question posée. Dès qu'on voit une distribution plutôt qu'un nombre, on cesse de demander « quelle est la réponse ? » pour demander « quelle est la largeur de la bande de risque, et qu'est-ce qui la détermine ? », meilleure question pour les budgets, les délais et les SLA opérationnels.
Pourquoi l'échantillonnage aléatoire répété fonctionne-t-il ?
Par la loi des grands nombres : la moyenne des résultats simulés tend vers l'espérance véritable à mesure que la taille de l'échantillon croît. C'est pourquoi une cible fléchée assez souvent révèle une aire qu'il serait malcommode de calculer directement.
Quand Monte-Carlo vaut-il mieux qu'une formule fermée ?
Quand le système résiste à l'algèbre élégante. Nul besoin d'une solution fermée pour l'ensemble, et c'est précisément pourquoi la méthode convient aux modèles non linéaires et au comportement désordonné du monde réel. Si un problème peut être échantillonné et évalué, Monte-Carlo peut généralement l'estimer.
Monte-Carlo apporte-t-il la certitude ?
Non, et le croire est le piège principal. Un modèle de Monte-Carlo ne promet pas la certitude : il quantifie l'incertitude sous les hypothèses que vous avez fournies. La sortie honnête est donc une bande de risque avec ses facteurs nommés, pas un chiffre unique et assuré.