Qu'est-ce que l'ETL dans le domaine du test logiciel ? Votre guide 2026
|
8
minute de lecture

Vous fixez du regard un tableau de bord qui devrait être ennuyeux, mais les chiffres ne correspondent pas. Le travail ETL s'est terminé, l'ordonnanceur affiche une couleur verte, et pourtant un cadre dirigeant demande pourquoi le chiffre d'affaires, le volume de patients ou le nombre de réclamations semblent différer de ce que les opérations attendaient. Cet écart est précisément l'endroit où le test ETL gagne ses galons, car le pipeline peut « fonctionner » tout en envoyant de mauvaises données en aval.
Dans ce qu'est l'ETL dans les tests logiciels, le but n'est pas de prouver que le travail s'est exécuté. C'est de prouver que les données sont dignes de confiance après avoir traversé l'étape Extract, Transform, Load. Cela est important car les mauvaises données coûtent cher, l'estimation largement citée de Gartner évaluant l'impact organisationnel moyen à 12,9 millions de dollars par an et l'estimation macroéconomique d'IBM pour les États-Unis concernant la mauvaise qualité des données s'élevant à 3,1 billions de dollars par an. Ces coûts expliquent pourquoi les équipes testent le nombre d'enregistrements, les transformations, les doublons, les valeurs manquantes et la réconciliation source-destination avant que les analyses, les tableaux de bord décisionnels et les modèles d'IA ne consomment les données.
Table des matières
Quand de bons pipelines produisent de mauvaises données
Un responsable financier ouvre le tableau de bord et voit un panneau d'état vert et propre. Chaque pipeline est indiqué comme réussi. Le problème est que les chiffres sous-jacents ne correspondent pas au grand livre, et l'écart est assez important pour déclencher une réunion dont personne ne veut. C'est la douloureuse réalité des échecs de test ETL : le système peut s'exécuter correctement et tout de même délivrer une vérité erronée.
La cause racine n'est souvent pas un travail interrompu. Il s'agit d'une règle de transformation qui a changé, d'un système source qui a introduit une modification subtile de structure, ou d'un lot qui a abandonné des lignes en cours de route. En pratique, l'ETL consiste à valider que les données sont extraites des systèmes sources, transformées par des règles métier et chargées dans un entrepôt ou une base de données cible sans perte ni altération, c'est pourquoi l'accent du test doit rester sur les données elles-mêmes, et non pas seulement sur le chemin du code. La vue d'ensemble des tests ETL de Datagaps lie directement cette définition au coût commercial des mauvaises données.
C'est pourquoi un pipeline « réussi » peut tout de même être un processus métier défaillant. Les analyses, la BI et l'IA ne se soucient pas de savoir si la couche d'orchestration est passée au vert, elles s'intéressent à la justesse du résultat. Dans les environnements réglementés comme la finance, la santé et le secteur public, cette distinction n'est pas académique, c'est la différence entre un rapport défendable et un problème de confiance qui se propage à travers les équipes.
Règle pratique : si le tableau de bord est faux, la première question n'est pas « le travail a-t-il tourné ? » mais « les données ont-elles survécu correctement à chaque étape ? »
L'évolution historique ici a son importance. L'ETL est devenu le modèle d'entreposage standard à mesure que les analyses se développaient, mais d'ici 2026, les orientations du secteur traiteront les tests ETL comme faisant partie d'une assurance qualité des données plus large englobant les entrepôts, les lacs et les pipelines. Cette vision plus large reflète la façon dont les organisations modernes utilisent les données : comme un actif partagé qui doit rester correct après chaque mouvement, et non comme un transfert de fichiers qui peut être vérifié une fois puis oublié.
Comprendre les trois étapes de l'ETL
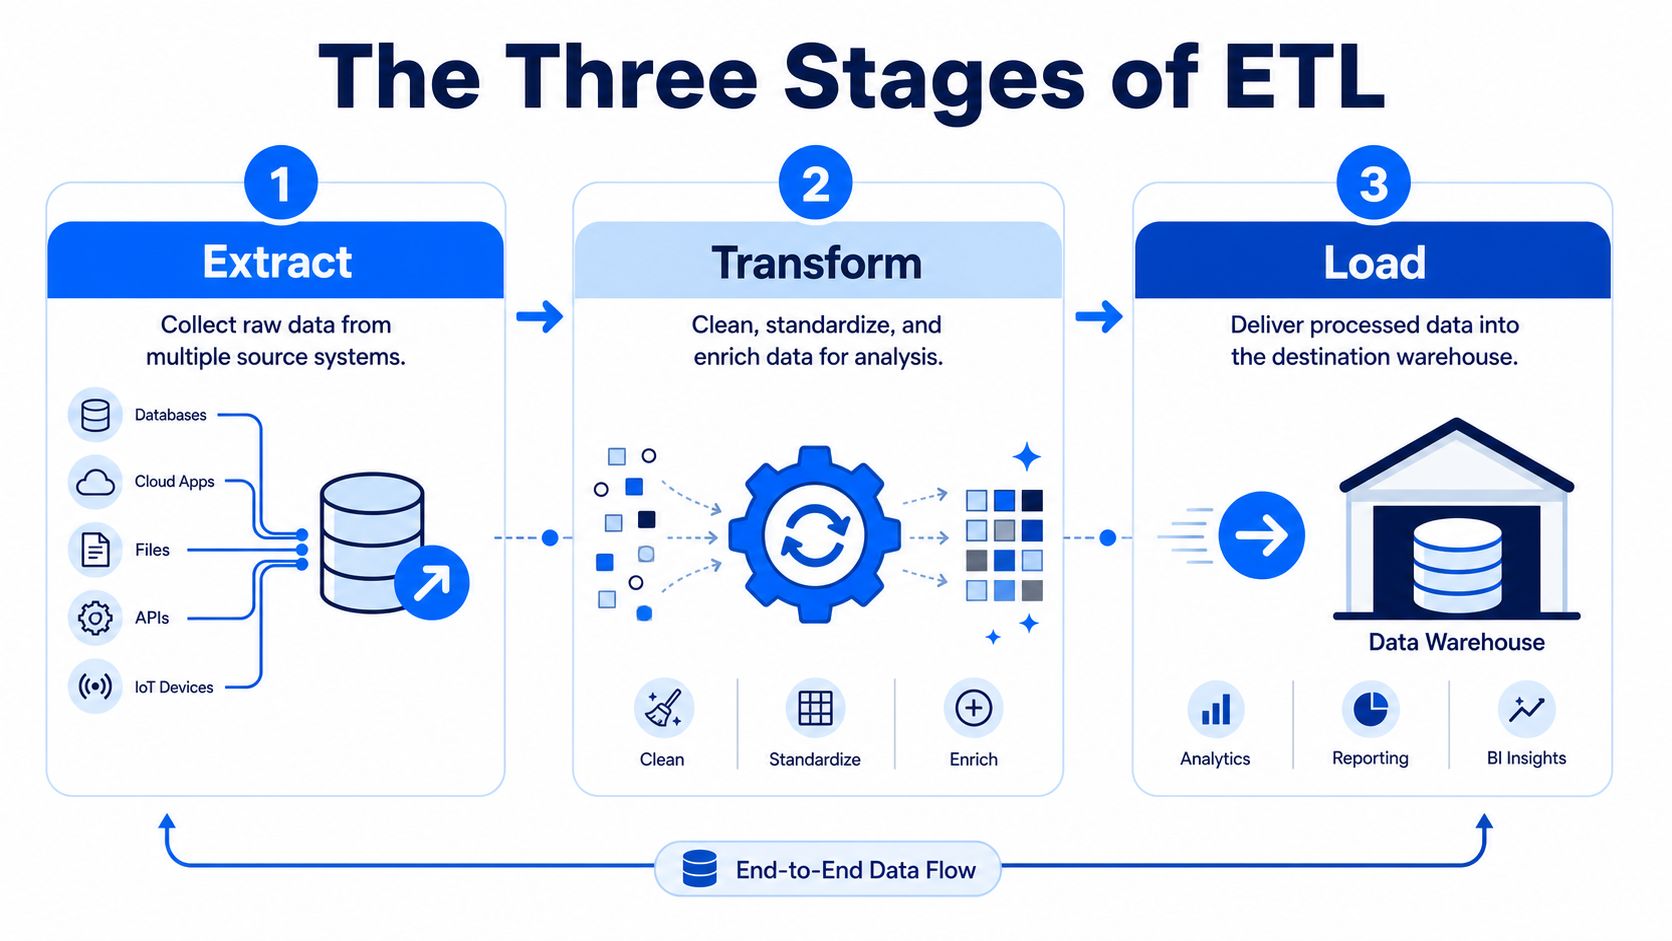
Une façon utile de concevoir l'ETL est de l'imaginer comme un centre de tri postal. Le courrier arrive de nombreux expéditeurs, est trié et étiqueté, puis est acheminé vers les bons bacs de destination. Si une lettre est mal lue ou égarée pendant le tri, le centre peut toujours « traiter » le courrier, mais le destinataire reçoit la mauvaise enveloppe, et c'est exactement ainsi que les pipelines de données échouent dans la réalité.
L'étape Extract extrait les données des systèmes sources tels que les bases de données, les API, les fichiers ou les flux d'événements. Le travail ici est simple en théorie : collecter les bons enregistrements de manière complète et sans altération, mais c'est là que les lignes manquantes, les extractions partielles et les problèmes de connectivité source peuvent commencer. L'étape Transform est celle où interviennent les règles métier, le nettoyage, la standardisation, l'enrichissement et les calculs. L'étape Load écrit les données finalisées dans l'entrepôt, le lakehouse ou la base de données sur lesquels reposent les rapports et les applications en aval.
Les tests s'alignent sur ces étapes pour une bonne raison. Vous ne validez pas un processus monolithique unique, vous vérifiez trois surfaces de défaillance différentes. Un système source peut être correct alors que le mappage est faux. Une transformation peut être correcte alors que le chargement rejette des lignes. Un chargement peut réussir alors que les totaux finaux ne correspondent toujours pas à ce qui a été extrait.
Pour les lecteurs comparant les structures d'équipe, les descriptions de rôles dans les rôles de développeur ETL en science des données sont utiles car elles montrent comment la responsabilité de l'ETL se situe souvent entre l'ingénierie, l'analyse et le travail sur la plateforme de données. C'est là que les responsabilités de test deviennent réelles : une personne peut construire le pipeline tandis qu'une autre prouve que les données sont arrivées intactes.
Un modèle mental clair aide ici, mais l'état d'esprit de test compte davantage. Extract vérifie l'accès à la source et l'exhaustivité, Transform vérifie la signification métier, et Load vérifie que la destination stocke fidèlement le résultat. Si votre équipe gère également l'ingestion, la référence interne sur le pipeline d'ingestion de données de digna est un endroit pratique pour connecter le mouvement des données avec les contrôles qui garantissent leur fiabilité.
Pourquoi le test ETL est critique pour la confiance dans les données
L'incident de données le plus dangereux est celui que personne ne remarque au début. Un tableau de bord dérive, une prévision est établie sur des valeurs obsolètes, ou un rapport de Compliance part avec un décalage structurel, et les journaux du pipeline semblent toujours corrects. C'est pourquoi la validation ETL moderne doit intercepter les pannes silencieuses, et pas seulement les plantages évidents.
Les pannes silencieuses sont le vrai problème
Une analyse citée par AccelQ sur plus de 11 millions de tables de production actives montre que les défauts d'exécution ne représentent que 26,2 % des incidents, tandis que 73,8 % sont des problèmes structurels ou de comportement des données, tels que la dérive de schéma (27,6 %) et les écarts opérationnels dans les données sources (25,1 %) qui n'arrêtent pas le travail mais corrompent tout de même les analyses en aval. Cette répartition d'AccelQ explique pourquoi les simples contrôles de réussite/échec sont si limités.
C'est le changement fondamental d'état d'esprit. La validation à l'ancienne demandait si le lot s'était terminé. La validation moderne demande si les données ont toujours la signification que l'entreprise leur prête. Cela inclut les changements de schéma, les modifications des sources, les enregistrements tardifs ou manquants, et la dérive de transformation qui ne déclenche jamais d'exception.
La confiance est le véritable livrable
Le test ETL consiste réellement à prouver que les consommateurs en aval peuvent faire confiance au résultat. Si la finance voit un chiffre, les opérations un autre, et que l'entrepôt contient une troisième version, le pipeline est peut-être encore « sain » du point de vue de l'ordonnanceur, mais l'organisation a déjà perdu confiance. C'est pourquoi le test ETL est si important dans la finance, la santé, les télécoms et le secteur public, où l'auditabilité et la cohérence comptent autant que le temps de fonctionnement.
Règle pratique : si un test confirme uniquement que le travail a tourné, c'est un détecteur de fumée, pas une stratégie de qualité des données.
La raison pour laquelle cela continue d'apparaître dans les systèmes réels est simple : le comportement des sources change plus vite que de nombreux scripts de validation. Un événement de dérive de schéma peut modifier le nom des colonnes ou les types de données sans provoquer l'échec du travail. Un flux source peut arriver avec des valeurs inattendues ou des partitions manquantes tout en étant chargé. Le test ETL protège l'entreprise en interceptant ces changements avant que les équipes BI, les analystes et les modèles de machine learning ne les transforment en décisions.
Une plongée au cœur des principaux types de tests ETL
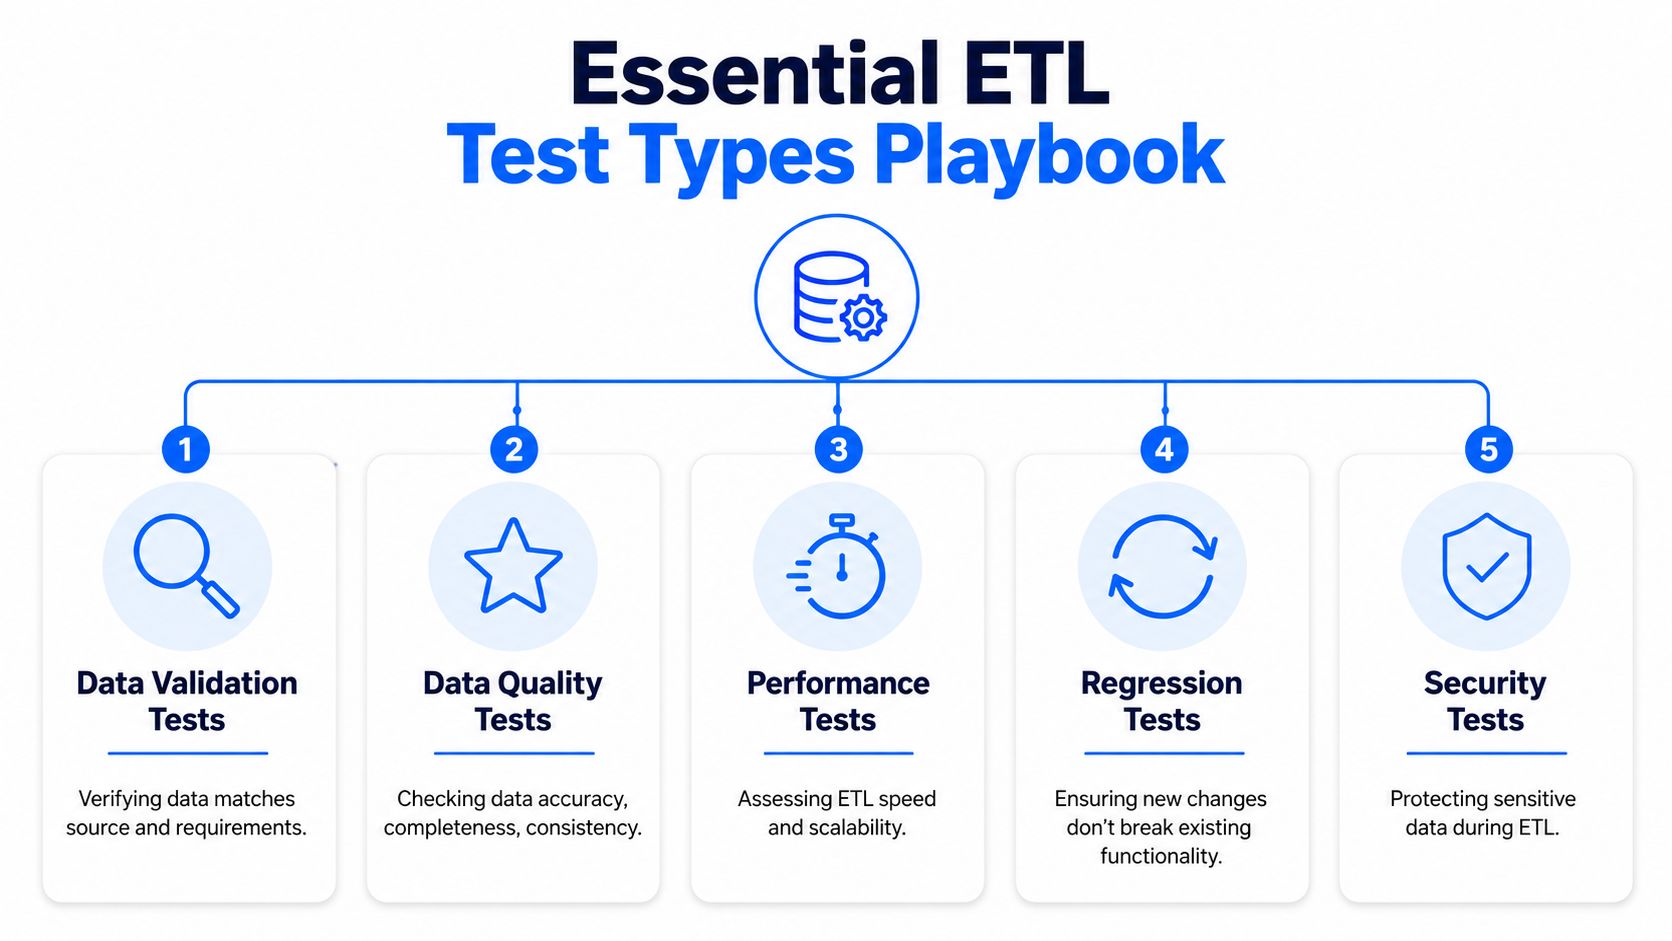
Le moyen le plus rapide de rendre les tests ETL utiles est de les traiter comme un guide de jeu, pas comme une liste de contrôle. Chaque type de test répond à un risque différent, et chacun intercepte des défaillances que les autres manquent. Si vous réconciliez uniquement le nombre de lignes, vous manquerez une mauvaise transformation. Si vous validez uniquement la logique métier, vous risquez de manquer des chargements en doublon ou des lignes rejetées.
Réconciliation des données
La réconciliation répond à la question : « Les données prévues sont-elles arrivées ? » Le point de départ pratique est la réconciliation du nombre d'enregistrements, où les totaux de la source et de la cible sont comparés après l'extraction et le chargement pour confirmer que toutes les lignes prévues ont été déplacées. Les bases des tests ETL de Matillion décrivent cela comme un mécanisme central, et c'est la première ligne de défense contre les pertes accidentelles.
Un modèle SQL simple ressemble à ceci en concept : nombre source, nombre cible, nombre rejeté, et une comparaison sur les champs clés si nécessaire. Si les nombres divergent, l'étape suivante consiste à inspecter les rejets, les doublons ou la logique de filtrage plutôt que de supposer que la source était erronée. Le risque commercial est évident : une perte non comptabilisée peut fausser les rapports sur le chiffre d'affaires, les stocks, les patients ou les réclamations sans aucun plantage visible.
Validation de la logique métier
Ce test vérifie si la transformation a fait ce que l'entreprise a demandé. Si les taxes, le mappage d'état, la conversion de devise ou la standardisation des noms font partie du pipeline, le test doit prouver que la règle a été appliquée de manière cohérente. Une assertion SQL pratique compare les valeurs sources au résultat transformé pour un échantillon connu ou vérifie que les champs calculés suivent le document de mappage.
Validation de schéma
La validation de schéma intercepte les changements de structure avant qu'ils ne perturbent les consommateurs en aval. Cela signifie vérifier les types de données, les longueurs, les champs acceptant les valeurs nulles et la présence de colonnes par rapport au contrat ou au fichier de mappage. C'est important car un travail peut toujours réussir après un changement de schéma, tout en déformant la structure des données, sans pour autant déclencher d'alerte.
Contrôles de ponctualité et de latence
Les données peuvent être correctes tout en étant inutiles si elles arrivent en retard. Les contrôles de ponctualité翌comparent les fenêtres de livraison prévues avec les arrivées réelles afin que les équipes puissent repérer les chargements obsolètes avant que les tableaux de bord et les alertes ne deviennent aveugles. Ceci est particulièrement important dans les systèmes en quasi-temps réel où la valeur de la donnée dépend de sa fraîcheur, pas seulement de son exactitude.
Tests de performance et de régression
Les tests de performance garantissent que le pipeline peut gérer des volumes réels sans provoquer de goulots d'étranglement ou de problèmes de dépassement de délai. Les tests de régression vérifient ensuite qu'une nouvelle source, règle ou optimisation n'a pas cassé ce qui fonctionnait auparavant. Dans les équipes matures, ces tests font partie de chaque livraison car les modifications de pipeline sont la norme, pas l'exception.
Règle pratique : si une transformation change, retestez les lignes qu'elle touche, les lignes qu'elle filtre et les lignes qu'elle peut accidentellement dupliquer.
Pour les équipes qui maintiennent l'intégrité à travers les tables, le guide interne sur les tests d'intégrité de base de données est un compagnon utile car le résultat de l'ETL devient souvent l'entrée des contraintes relationnelles, pas seulement des tableaux de bord.
Des scripts manuels à l'Observability automatisée
Les scripts SQL manuels ont toujours leur place, mais ils vieillissent rapidement lorsque les schémas changent, que les sources se multiplient et que les cycles de livraison s'accélèrent. Un script qui code en dur un mappage unique peut intercepter un défaut connu, puis manquer le suivant parce que personne n'a mis à jour le contrôle à temps. L'automatisation au sein de la CI/CD est devenue la référence, mais elle ne couvre toujours que les cas que vous aviez déjà prévus.
Le secteur passe du test ETL par lots à une Observability continue des pipelines. Des orientations récentes d'Informatica sur les tests ETL soulignent une utilisation accrue de la surveillance pour la ponctualité, la dérive de schéma et la détection d'anomalies sur les données de production. Cela reflète un abandon de la validation purement manuelle après chargement au profit d'une assurance proactive. En pratique, les équipes ont besoin de savoir quand les données commencent à se comporter de manière étrange, et non pas seulement lorsqu'un script de test sait déjà quoi chercher.
Le test et l'Observability résolvent des problèmes différents. Le test est le plus efficace lorsque l'équipe connaît la règle, comme un champ qui ne devrait jamais être nul ou un mappage qui doit convertir A en B. L'Observability continue des pipelines intercepte les cas qui n'apparaissent pas dans une liste de contrôle, comme une source qui change de forme, un lot qui arrive en retard ou une distribution qui varie sans note de mise à jour. La Data Observability aide à combler cet écart car elle surveille le comportement en production de manière continue, et pas seulement lors d'une exécution de validation planifiée.
L'une des plateformes de cet espace est digna, qui surveille le comportement des données, valide les enregistrements, suit la ponctualité, détecte les changements de schéma et fait remonter les métriques métier et de plateforme au sein du propre environnement du client. Cela est important pour les équipes qui ont besoin de contrôles en base de données et d'une governance plus stricte, en particulier lorsque les données ne peuvent pas sortir d'une infrastructure contrôlée.
Le compromis est pratique. Les scripts manuels sont transparents, mais fragiles. L'automatisation passe mieux à l'échelle, mais elle dépend toujours de règles attendues claires. L'Observability réduit les zones d'ombre en surveillant en continu le comportement en production, ce dont les équipes de données modernes ont besoin lorsqu'un pipeline peut être « réussi » tout en étant erroné.
Bâtir votre stratégie de test ETL et d'Observability
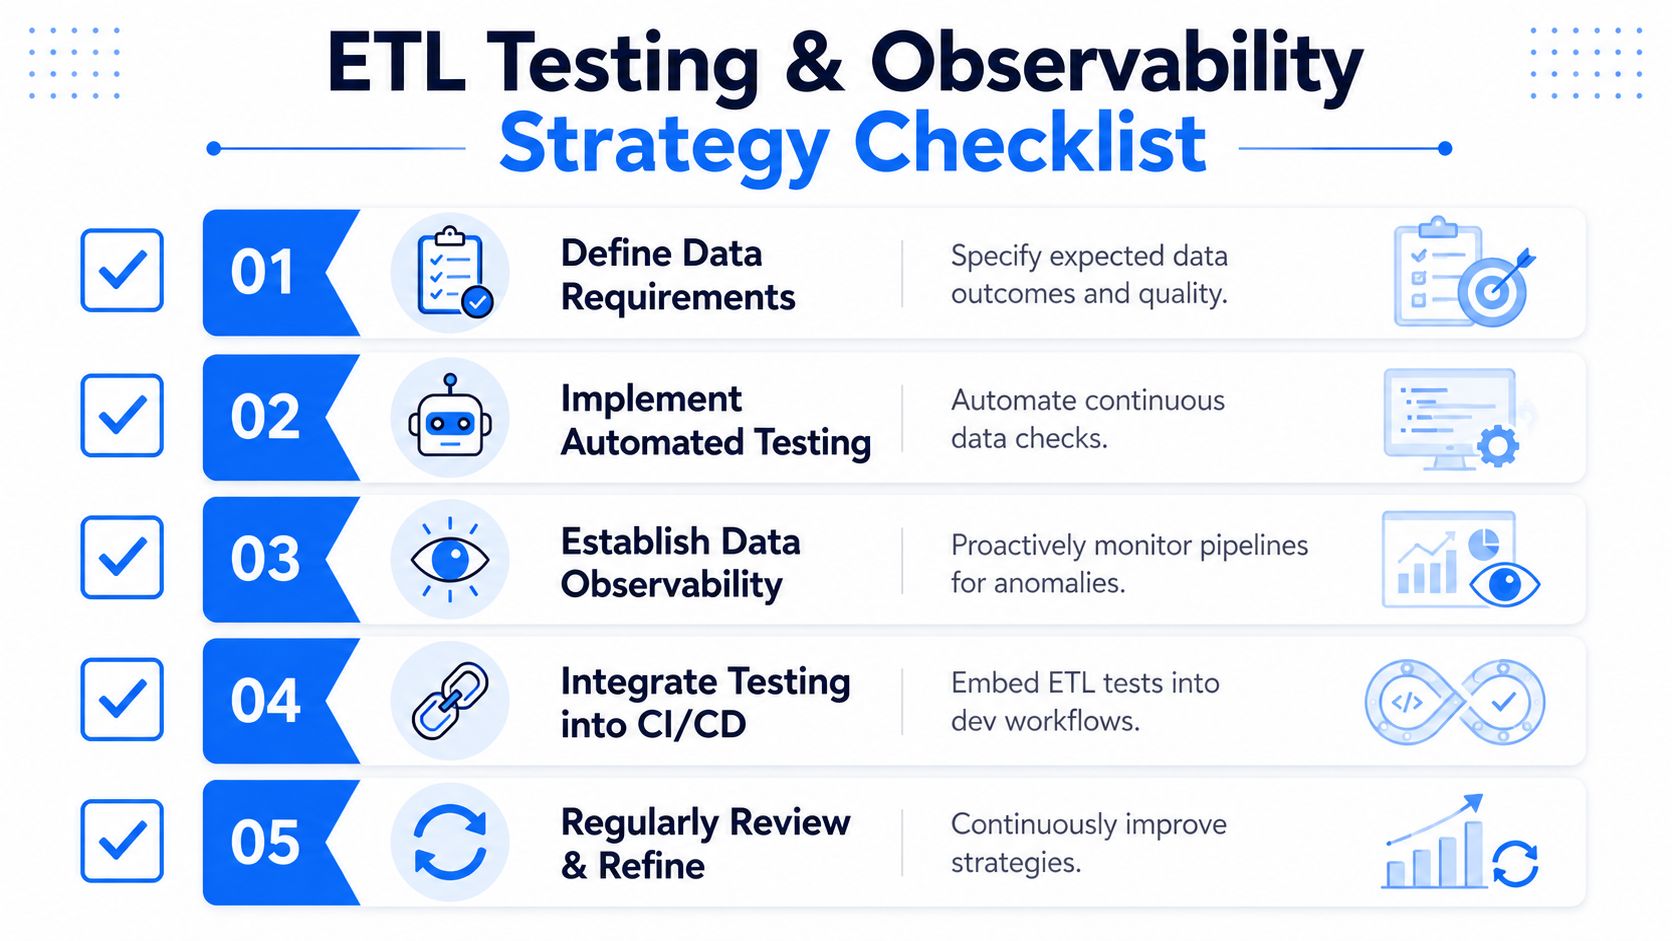
Une bonne stratégie commence modestement et devient plus stricte là où les données comptent le plus. Les équipes n'ont pas besoin de tout tester de la même manière dès le premier jour, mais elles ont besoin d'un moyen reproductible de prouver que les pipelines critiques sont fiables. L'approche idéale est structurée par couches, en commençant par la réconciliation et la validation, puis en ajoutant l'automatisation, puis en ajoutant l'Observability pour les zones d'ombre.
Définir les exigences de données. Commencez par la signification métier des données, les totaux attendus, les valeurs nulles autorisées, les règles de transformation et les objectifs de fraîcheur. Si l'équipe ne peut pas décrire le résultat correct, aucun test ne sera stable bien longtemps.
Automatiser les contrôles de base. Les nombres d'enregistrements, les comparaisons de la source à la cible, la détection de doublons et les assertions de transformation doivent faire partie de tâches reproductibles. Ce sont ces tests qui détectent tôt les régressions et empêchent les dommages évidents d'atteindre les couches de reporting.
Intégrer les tests dans la CI/CD. Chaque modification de pipeline devrait déclencher une validation avant son déploiement. Cela permet de lier la qualité ETL à la livraison, et non à un examen manuel séparé qui est ignoré lorsque les délais se resserrent.
Ajouter de l'Observability pour le comportement en production. Surveillez la ponctualité, les changements de schéma et les anomalies afin que l'équipe puisse détecter des problèmes pour lesquels personne n'a écrit de test spécifique. C'est la différence entre réagir à une plainte et intercepter le problème avant que les utilisateurs ne s'en aperçoivent.
Réviser et affiner. La couverture de test doit évoluer avec les systèmes sources, les règles métier et les consommateurs de données. Si une règle de validation continue d'échouer pour des raisons sans importance, c'est le signe que la règle ou le pipeline a changé, et dans les deux cas, la suite de tests a besoin d'une maintenance.
Les indicateurs doivent correspondre à cette stratégie. Suivez le temps de fonctionnement des données, le délai de détection et la vitesse de résolution pour les actifs critiques. Choisissez ensuite vos outils en fonction du fonctionnement de votre équipe : un framework pour la validation pilotée par SQL, une couche de test native CI, ou une plateforme qui combine le test avec l'Observability et l'auditabilité.
Pour les équipes qui souhaitent un endroit unique pour surveiller la dérive de schéma, la ponctualité, les anomalies et le comportement de validation dans des environnements contrôlés, digna offre une option pratique à évaluer aux côtés de vos contrôles ETL existants. Si vos tableaux de bord doivent rester dignes de confiance à mesure que les pipelines changent, commencez par les tests qui protègent les données les plus importantes et étendez-les à partir de là.


