Qu'est-ce qu'une plateforme de données ?
|
8
minute de lecture

Une plateforme de données est l'ensemble intégré d'outils et d'infrastructures qu'une organisation utilise pour ingérer, stocker, traiter, gouverner et distribuer des données pour l'analytique et l'IA. Le marché mondial des plateformes de données a été estimé à 82,4 milliards de USD en 2024 et devrait dépasser 210 milliards de USD d'ici 2031, avec un taux de croissance annuel composé de 14,5 % sur cette période de prévision, selon l'aperçu du marché des plateformes de données de 6Wresearch.
Votre équipe produit vit peut-être déjà avec ce problème. Un export CRM arrive sous forme de feuille de calcul, une réplique Postgres contient des données d'application, des plateformes publicitaires fournissent des fichiers CSV, et un tableau de bord Looker tombe soudainement en panne parce que quelqu'un a renommé un champ. Chaque source fonctionne de manière indépendante, mais personne ne peut facilement expliquer quelle version est à jour, qui peut l'utiliser, si elle est arrivée à temps ou pourquoi une métrique a changé.
Le problème ne vient généralement pas des données elles-mêmes. C'est l'absence d'un système d'exploitation connecté unique pour les données.
Table des matières
Une définition simple d'une plateforme de données
Les couches fondamentales de chaque plateforme de données
L'ingestion est le quai de déchargement
Le stockage est le garde-manger et la chambre froide
Le calcul est la cuisine
La gouvernance est l'inspecteur et le livre de recettes
L'Observability est le panneau de contrôle de la cuisine
Comment les plateformes de données ont évolué pour devenir ce qu'elles sont aujourd'hui
Comparaison entre Warehouses, Lakes et Lakehouses
Pourquoi l'Observability a sa place au sein de la plateforme
Les défaillances que les équipes ne voient pas à temps
La qualité et l'observabilité répondent à des questions différentes
Les plateformes de données en pratique à travers les industries
Une liste de contrôle pratique pour évaluer votre plateforme
Ingestion et stockage
Calcul et modélisation
Gouvernance et accès
Observability et fiabilité
Une définition simple d'une plateforme de données
Pensez à une plateforme de données comme à la chaîne d'approvisionnement en données partagée de l'organisation. Elle reçoit des informations des systèmes opérationnels, les stocke sous des formes appropriées, les prépare pour l'utilisation, applique des règles d'accès et de signification, et expose des résultats fiables aux analystes, aux applications et aux systèmes d'IA.
Cette définition a une implication importante : une plateforme de données n'est pas nécessairement un produit unique. C'est un ensemble intégré d'infrastructures, de services, de politiques et d'interfaces. Un entrepôt de données peut fournir le stockage et le traitement SQL, tandis que des services distincts gèrent l'ingestion, la transformation, le catalogage, le contrôle d'accès et la surveillance. Ces pièces deviennent une plateforme lorsqu'elles fonctionnent ensemble comme un système fiable plutôt que comme des outils déconnectés.
Au niveau pratique, posez-vous cinq questions :
Les données arrivent-elles de manière fiable ? Il s'agit de la couche d'ingestion, qui couvre les fichiers, les API, les événements d'application et la capture de données modifiées (CDC).
Où résident-elles ? Le stockage peut inclure des tables d'entrepôt, du stockage d'objets, des tables de lakehouse ou des magasins en temps réel spécialisés.
Comment sont-elles préparées ? Le calcul exécute des requêtes, des transformations, des agrégations et des charges de travail de machine learning.
Que signifient les données et qui peut les utiliser ? La gouvernance gère les définitions, le lignage, le catalogage, les autorisations et les journaux d'audit.
Comment les équipes savent-elles si le système est sain ? L'Observability suit la fraîcheur, les changements de schéma, les anomalies, le comportement des pipelines et l'impact en aval.
Les guides d'architecture d'entreprise décrivent généralement ce type de plateforme comme un logiciel qui aide les utilisateurs à stocker, accéder, gérer et gouverner les données de l'entreprise à la fois sur le plan des données et sur le plan de contrôle des données, comme décrit dans l'analyse du marché des plateformes de données d'IDC.
Une plateforme de données n'est donc pas simplement une base de données, car une base de données peut stocker des données sans gérer l'intégralité de leur cycle de vie. Ce n'est pas non plus un simple outil de BI, car les tableaux de bord consomment des données préparées plutôt que de gérer l'ingestion et la gouvernance. Ce n'est pas non plus automatiquement une suite d'un seul fournisseur. La caractéristique déterminante est l'intégration.
Pour un cadre d'entreprise plus large, cet aperçu des plateformes de données d'entreprise est utile. La question centrale reste simple : votre organisation peut-elle passer du système source à une décision de confiance sans assembler manuellement chaque étape ?
Les couches fondamentales de chaque plateforme de données
Un restaurant permet de comprendre plus facilement l'architecture. Les fournisseurs livrent les ingrédients, le personnel les stocke, les cuisiniers préparent les plats, les inspecteurs font respecter les normes et les gérants surveillent l'opération pour détecter les signes de problème. Une plateforme de données suit le même modèle.
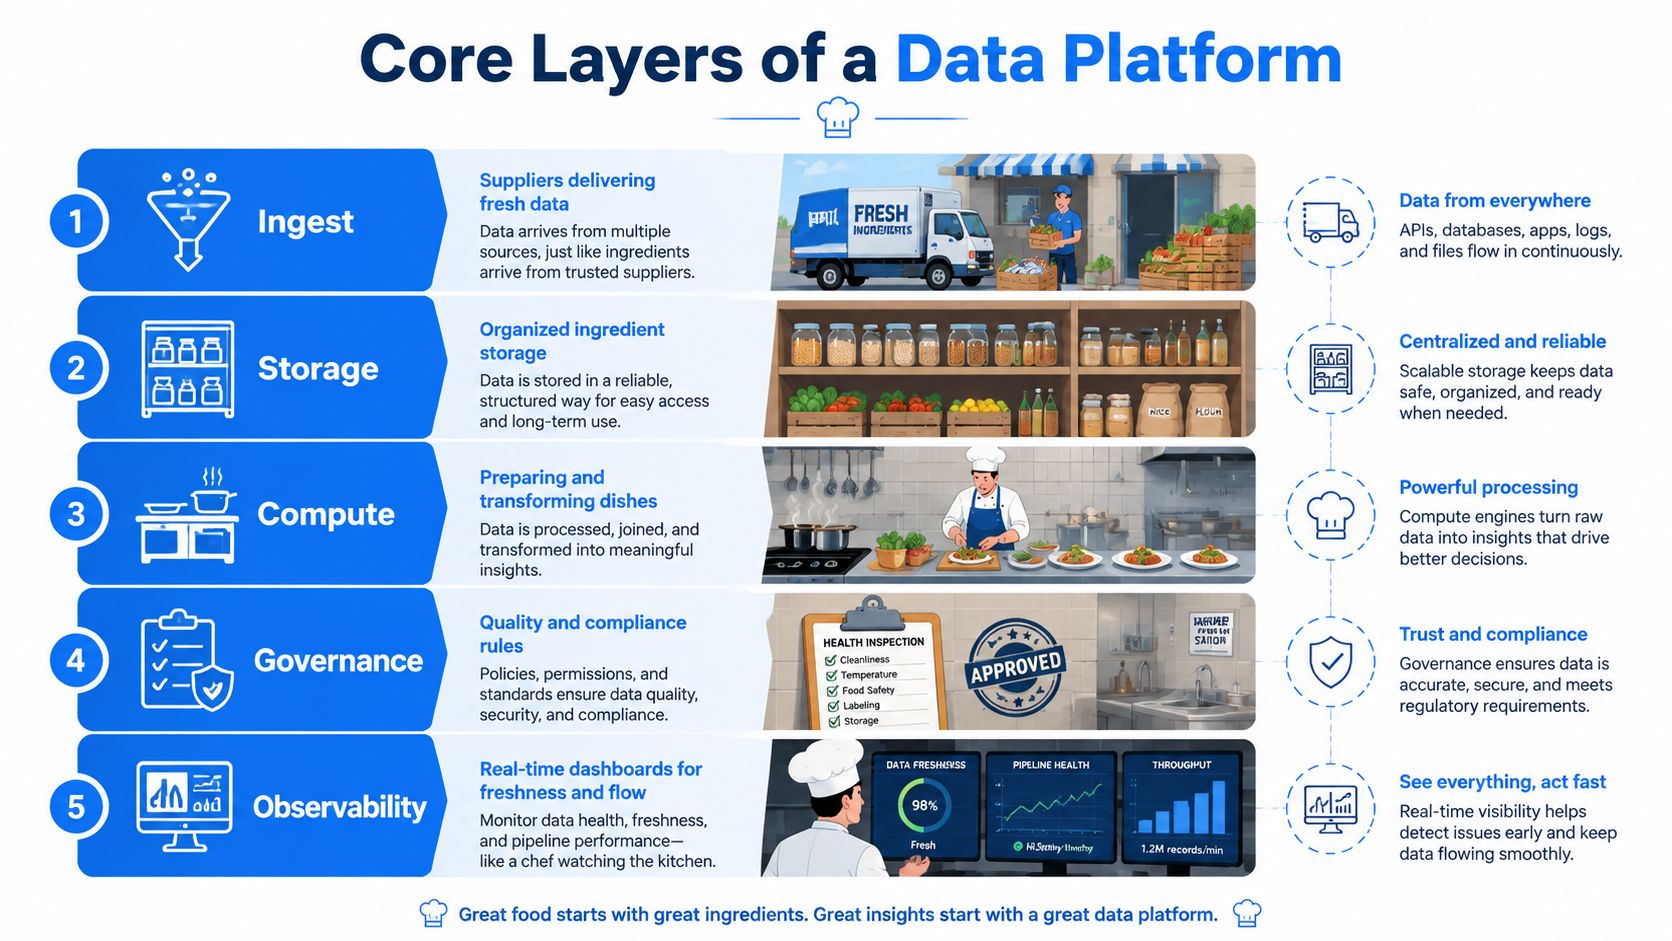
L'ingestion est le quai de déchargement
L'ingestion apporte la matière première dans la plateforme. Les sources peuvent inclure des événements d'application, des API, des fichiers, des répliques de bases de données ou des flux de capture de données modifiées. Kafka peut acheminer les flux d'événements, tandis que des connecteurs et des tâches planifiées peuvent charger des fichiers et des enregistrements opérationnels.
Le quai de déchargement a besoin de plus qu'une simple porte. Il a besoin d'heures de réception, d'identification de la source, de gestion des pannes et d'un enregistrement de ce qui est arrivé. Sans ces contrôles, une plateforme peut accepter des données tout en laissant l'équipe incapable de dire si une livraison était complète.
Les organisations qui ont besoin de connecter des systèmes externes évaluent souvent les services d'API de données aux côtés des connecteurs natifs et des outils d'événements. Le bon choix dépend de la variété des sources, des besoins de latence et de la part de logique de pipeline que l'équipe interne souhaite posséder.
Le stockage est le garde-manger et la chambre froide
Le stockage préserve les ingrédients sous des formes adaptées à différents travaux. Amazon S3 peut contenir des objets structurés et non structurés, tandis que Snowflake peut organiser des tables analytiques préparées. Un lakehouse peut superposer des formats de table transactionnels au stockage d'objets afin que les équipes puissent travailler avec des ensembles de données volumineux et diversifiés tout en conservant une gestion de table plus solide.
Les décisions de stockage affectent le coût, la vitesse d'accès, la conservation et la gouvernance. Les données brutes peuvent devoir rester proches de leur forme d'origine pour l'exploration, tandis que les données préparées doivent être organisées pour une utilisation commerciale répétable.
Le calcul est la cuisine
Le calcul transforme les données stockées en quelque chose d'utile. Les moteurs SQL répondent aux questions, les frameworks de transformation tels que dbt construisent des ensembles de données modélisés, et les moteurs de traitement distribué préparent les données pour des charges de travail complexes ou le machine learning.
La distinction importante est que le stockage contient les ingrédients, tandis que le calcul fait le travail. Les séparer peut permettre aux équipes de faire évoluer le traitement et le stockage de manière indépendante, mais cela crée également des limites opérationnelles qui nécessitent une appropriation claire.
La gouvernance est l'inspecteur et le livre de recettes
La gouvernance définit qui peut accéder aux données, ce qu'une métrique signifie, d'où provient un ensemble de données et quels contrôles s'y appliquent. Unity Catalog, le contrôle d'accès basé sur les rôles, le contrôle d'accès basé sur les attributs, la journalisation d'audit, les catalogues et les outils de lignage peuvent soutenir ces responsabilités.
La gouvernance protège également la cohérence. Si une équipe définit « client actif » différemment d'une autre, les deux tableaux de bord peuvent être techniquement corrects tout en produisant des décisions contradictoires.
L'Observability is the kitchen control panel
L'Observability montre si les livraisons sont arrivées, si le stockage est disponible, si les transformations se sont terminées correctement et si les résultats restent fiables. Des outils tels que Monte Carlo peuvent surveiller le comportement des données, tandis que les métriques et alertes natives de la plateforme fournissent un contexte opérationnel.
Les guides d'architecture orientés IBM traitent l'Observability comme une couche fondamentale de la plateforme de données car les équipes ont besoin de visibilité sur la confiance, la fraîcheur et le comportement des pipelines, et pas seulement sur la réussite des tâches. Un pipeline peut se terminer avec succès et pourtant publier des données obsolètes, incomplètes ou structurellement modifiées.
Une vue architecturale utile est présentée dans ce guide d'architecture des systèmes de données. La leçon est simple : déplacer des données n'est qu'une partie du travail. Une plateforme fonctionnelle doit également expliquer, protéger et inspecter en continu ce qu'elle déplace.
Comment les plateformes de données ont évolué pour devenir ce qu'elles sont aujourd'hui
Les plateformes de données ont évolué à travers des compromis récurrents plutôt qu'une succession propre de technologies se remplaçant les unes les autres. Les équipes ont à plusieurs reprises équilibré la discipline des schémas, la flexibilité, la vitesse analytique, le coût des infrastructures et la gouvernance.
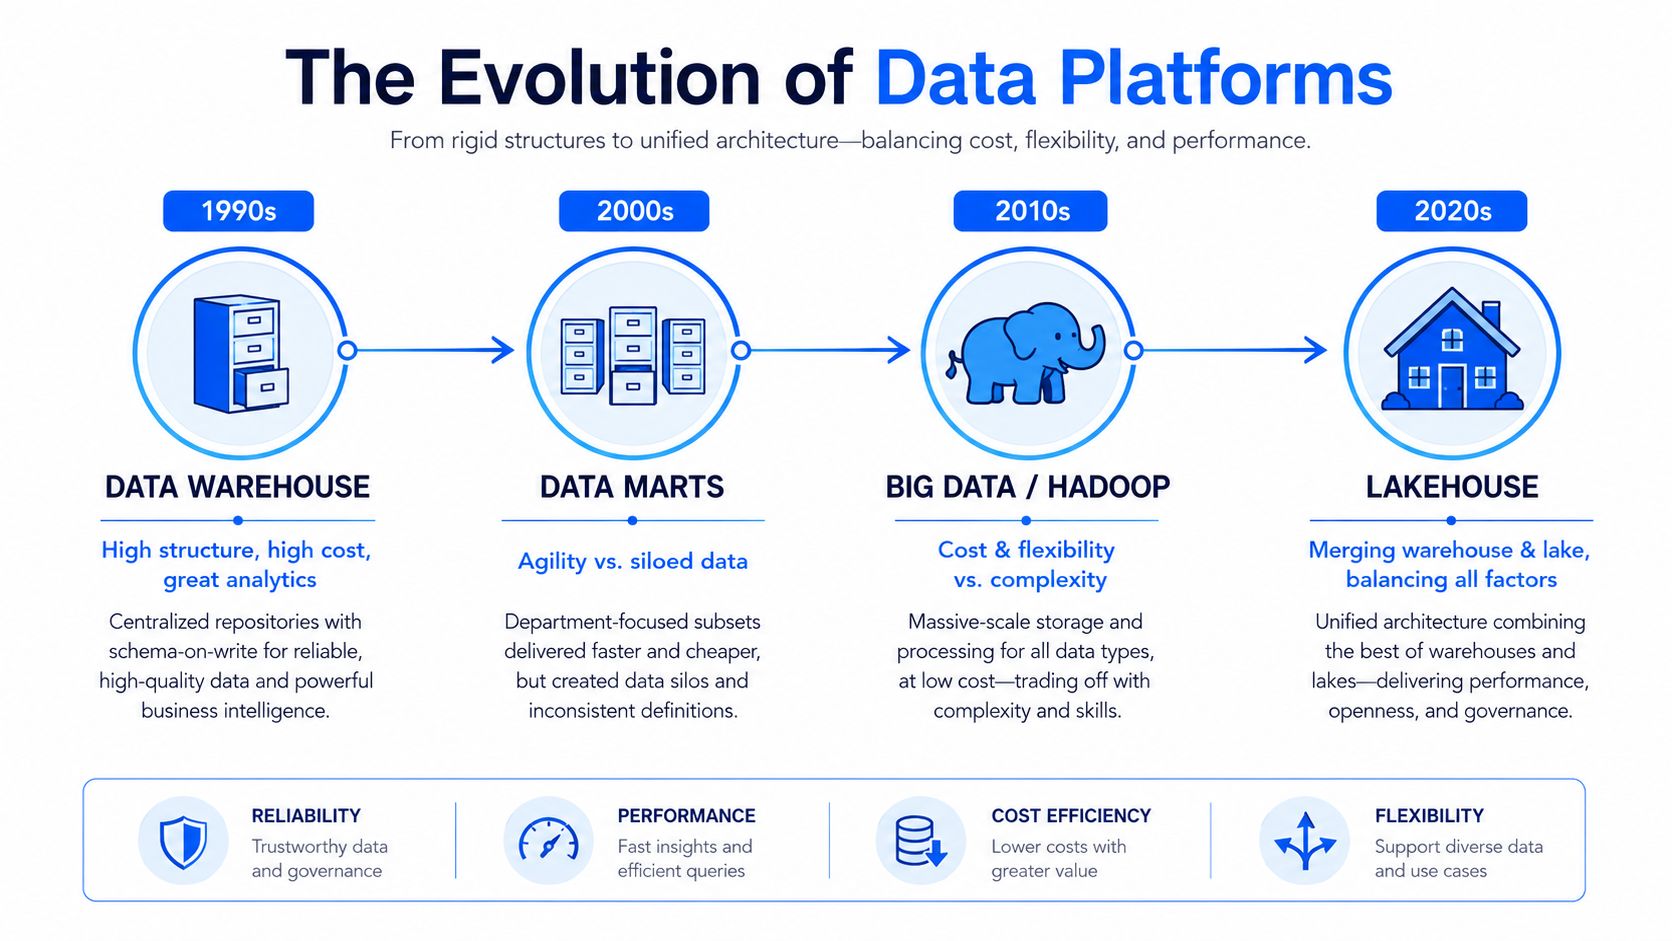
L'entrepôt de données a établi un modèle centralisé pour le reporting. Les organisations ont consolidé les informations de plusieurs systèmes dans des schémas structurés, offrant aux analystes une vue unifiée de l'entreprise. Cette approche permettait des analyses SQL fiables, mais des schémas rigides et des équipements sur site coûteux rendaient les modifications difficiles et lentes.
Les data marts ont introduit plus de flexibilité locale. Les départements individuels pouvaient façonner les données pour leurs propres besoins de reporting, mais cette même flexibilité pouvait créer une logique dupliquée et des définitions concurrentes. Un data mart financier et un data mart marketing pouvaient chacun calculer une mesure commerciale différemment, même s'ils s'appuyaient tous deux sur des sources similaires.
Le data lake a répondu au besoin d'un stockage moins cher et plus vaste. Le stockage d'objets et Hadoop ont permis de conserver de manière pratique des fichiers bruts, des journaux, des événements et d'autres formats sans avoir à tout modéliser avant l'arrivée. Le compromis était la complexité. Sans propriété, catalogage, contrôles de qualité et règles de cycle de vie, un lac pouvait devenir une collection de fichiers auxquels personne ne faisait confiance.
Le lakehouse est apparu comme une réponse pragmatique. Des formats de table tels que Delta Lake, Apache Iceberg et Apache Hudi ajoutent une gestion de schéma et un comportement transactionnel sur un stockage ouvert, aidant un seul environnement à prendre en charge à la fois les charges de travail analytiques et de machine learning.
L'architecture continue de converger. Les entrepôts gérés prennent de plus en plus en charge les données semi-structurées et les formats de fichiers ouverts, tandis que les lacs modernes adoptent des transactions, une gouvernance et une gestion de table de style entrepôt. Cette histoire est résumée dans un aperçu du développement historique des plateformes de données.
La conclusion utile n'est pas qu'une architecture l'a emporté sur une autre. C'est que chaque plateforme hérite de compromis. Une équipe qui choisit une architecture doit se demander quelles contraintes importent le plus : un SQL gouverné rapide, une conservation brute peu coûteuse, un accès flexible pour le machine learning, des formats ouverts ou la simplicité opérationnelle.
Warehouses Lakes et Lakehouses Comparés
Un entrepôt, un lac et un lakehouse peuvent tous prendre en charge l'analytique, mais ils organisent le travail différemment. Le meilleur choix dépend de vos formats de données, de vos charges de travail, de vos attentes en matière de gouvernance et des compétences de vos équipes.
Dimension | Data Warehouse | Data Lake | Lakehouse |
|---|---|---|---|
Formats typiques | Tables structurées préparées, avec une prise en charge croissante des données semi-structurées | Fichiers bruts, journaux, événements, objets structurés et non structurés | Tables structurées et semi-structured sur stockage d'objets ouvert |
Charges de travail principales | BI, reporting SQL, analyse commerciale gouvernée | Conservation des données brutes, exploration, science des données, traitements divers | BI, analytique, machine learning et ingénierie des données partagée |
Approche du schéma | Le schéma est généralement défini avant ou pendant le chargement | Le schéma peut être appliqué ultérieurement, ce qui augmente la flexibilité | Les contrôles de schéma et de table sont ajoutés sur un stockage flexible |
Modèle de gouvernance | Souvent centralisé et mature pour les ensembles de données préparés | Peut varier considérablement et nécessite un catalogage et une conception de politiques délibérés | Vise à combiner stockage ouvert et gouvernance de table renforcée |
Profil de coût | Optimisé pour des performances analytiques managées, avec des coûts façonnés par l'utilisation du calcul et du stockage | Souvent attractif pour un stockage large, avec de l'ingénierie supplémentaire requise pour l'utilisabilité | Équilibre l'économie du stockage partagé avec les besoins de traitement et de gestion |
Équipes qui s'y fient | Analystes, développeurs BI, ingénieurs analytiques, finance et opérations | Ingénieurs de données, data scientists, chercheurs et utilisateurs exploratoires | Plateforme transverse, équipes d'analytique, d'ingénierie et d'IA |
Un entrepôt est souvent le choix le plus évident lorsque la plupart des charges de travail impliquent des tables préparées et du SQL rapide. Il offre aux analystes un environnement contrôlé, mais les équipes peuvent avoir besoin de systèmes supplémentaires pour les fichiers bruts, les traitements spécialisés ou l'expérimentation de machine learning.
Un lac est utile lorsque l'organisation doit conserver des données variées avant d'en connaître chaque utilisation future. Cette flexibilité s'accompagne de responsabilités. Le catalogage, la propriété, le suivi des schémas et les politiques d'accès doivent empêcher l'environnement de devenir une archive non gérée.
Un lakehouse tente de combiner les deux modèles. Il peut fournir un stockage ouvert et un large accès aux données tout en ajoutant une sémantique de table plus forte, la gestion des transactions et la gouvernance. Cela ne supprime pas pour autant la complexité. Les équipes doivent toujours comprendre les dispositions des fichiers, les choix de calcul, la maintenance des tables, les autorisations et l'isolation des charges de travail.
La distinction entre un lac et un data mart plus ciblé est explorée dans cette comparaison des data lakes et des data marts. La décision doit suivre la réalité des charges de travail plutôt que la mode. Une plateforme hybride peut être judicieuse lorsque la finance a besoin d'un reporting d'entrepôt gouverné, que la science des données a besoin d'un accès aux événements bruts et que les opérations ont besoin de données à faible latence provenant d'un magasin spécialisé.
Why Observability Belongs Inside the Platform
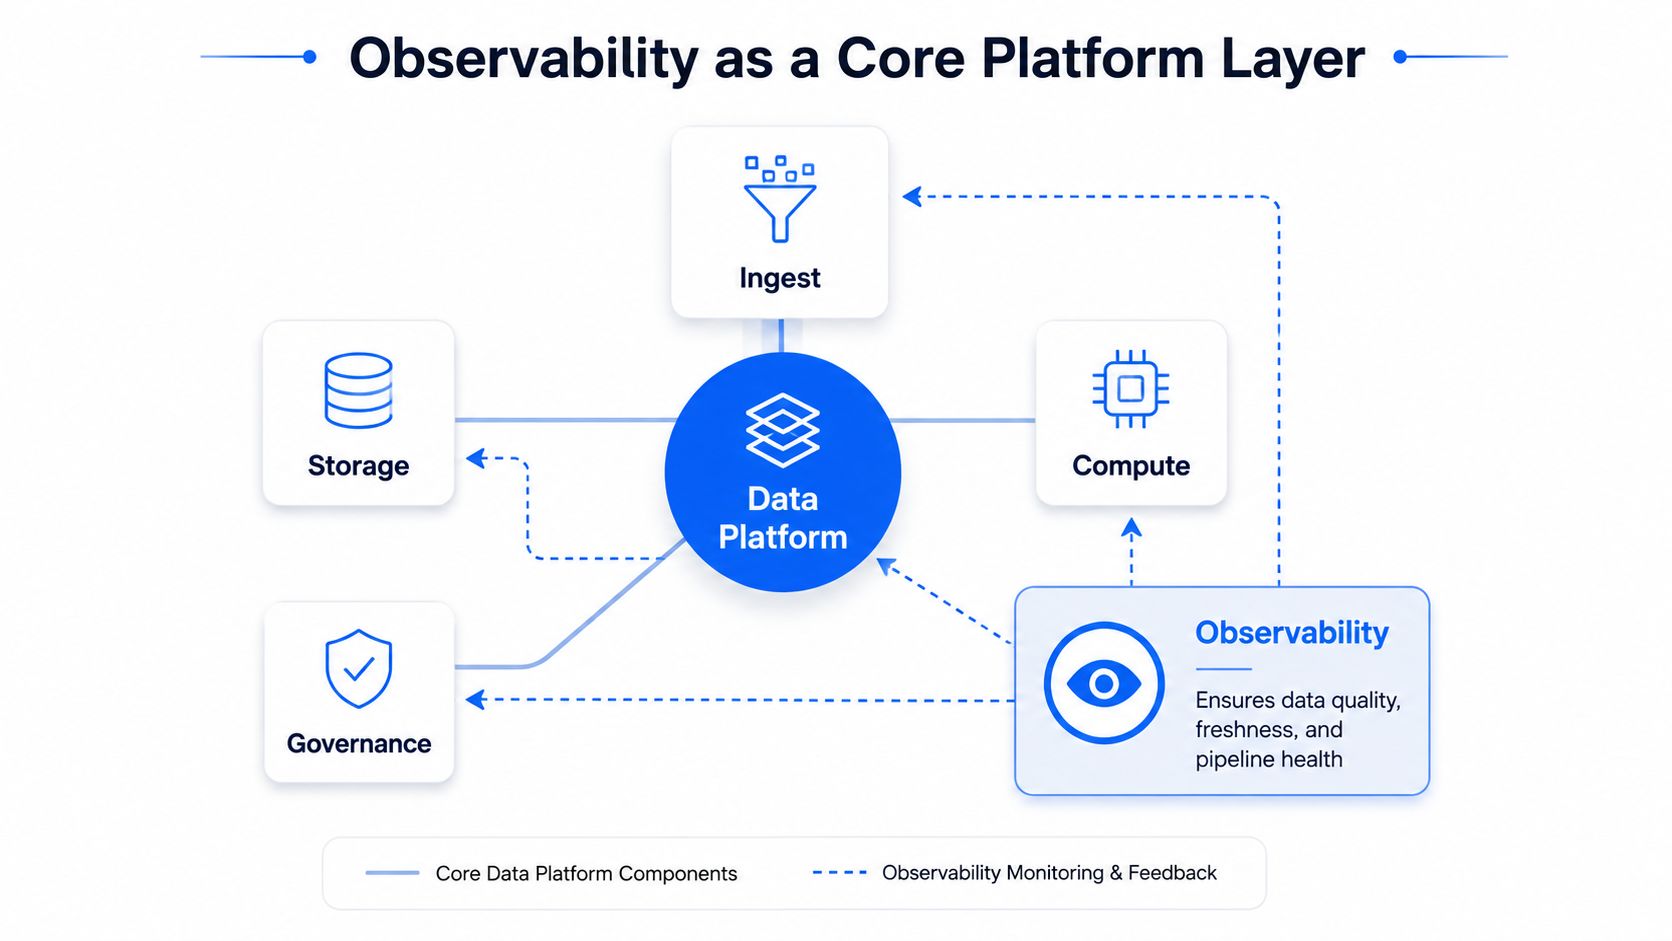
L'Observability a sa place aux côtés de l'ingestion, du stockage, du calcul et de la gouvernance car chaque couche peut introduire une défaillance qui semble correcte de l'extérieur. Un statut de pipeline vert ne prouve pas que les données sont fraîches, complètes, structurellement compatibles ou significatives pour leurs consommateurs.
La Data Observability est la surveillance continue des pipelines, des tables, des tâches et des modes de consommation. Elle recherche les changements de fraîcheur, les dérives de schéma, les anomalies de volume, les transformations échouées et les décalages d'exécution plutôt que de s'appuyer uniquement sur la réussite d'une tâche planifiée. Les conseils d'entreprise sur la Data Observability décrivent cette portée opérationnelle plus large.
The failures teams don't see in time
La dérive de schéma est une défaillance silencieuse courante. Un système source peut ajouter une colonne, supprimer un champ ou modifier un type de données sans avertissement. Un modèle en aval peut échouer immédiatement, ou il peut continuer tout en produisant des résultats incomplets ou trompeurs. La recherche sur la surveillance des schémas identifie ces changements structurels comme des signaux que les systèmes d'Observability devraient suivre au fil du temps.
La fraîcheur crée un autre risque. Un ensemble de données peut être valide dans sa structure et pourtant être inutilisable parce que sa dernière livraison est arrivée en retard. Les équipes comparent l'arrivée réelle avec les calendriers prévus ou les accords de niveau de service pour détecter les retards avant que les données obsolètes n'atteignent les tableaux de bord et les rapports opérationnels, une distinction soulignée par les conseils de digna sur la Timeliness.
Les doublons, les variations de volume inattendues et les changements de distribution peuvent créer une autre classe d'incidents. Une table de revenus peut se charger avec succès tout en contenant des enregistrements répétés, et une variable de ML peut techniquement exister tout en reflétant une population obsolète.
Quality and observability answer different questions
Les contrôles de qualité valident des règles connues. Par exemple, un test au niveau de l'enregistrement peut exiger qu'un identifiant existe ou qu'une valeur se situe dans une plage acceptée. L'Observability détecte les comportements inattendus, retrace l'impact à travers le lignage et aide à diagnostiquer les changements que les règles prédéfinies n'avaient pas anticipés.
Règle pratique : Utilisez la validation déterministe pour les règles que vous comprenez déjà, et l'Observability pour les changements que vous ne saviez pas attendre.
Les deux approches fonctionnent ensemble. Une stratégie unifiée de qualité et d'Observability des données explique pourquoi les entreprises combinent la validation avec la détection d'anomalies, le lignage et le suivi des schémas.
Faire de l'Observability une partie intégrante de la plateforme modifie la responsabilité. Les ingénieurs de données reçoivent des alertes avec le contexte source et aval, les ingénieurs analytiques peuvent voir si un modèle est affecté, et les équipes de gouvernance obtiennent des preuves sur le comportement des données. Au lieu de découvrir un problème via un tableau de bord cassé, les équipes peuvent enquêter sur la limite d'ingestion ou de schéma où le changement a commencé. Les pratiques de Data Observability fournissent un cadre utile pour évaluer cette capacité.
Les plateformes de données en pratique à travers les industries
L'architecture devient plus claire lorsque les mêmes couches résolvent des problèmes opérationnels différents.
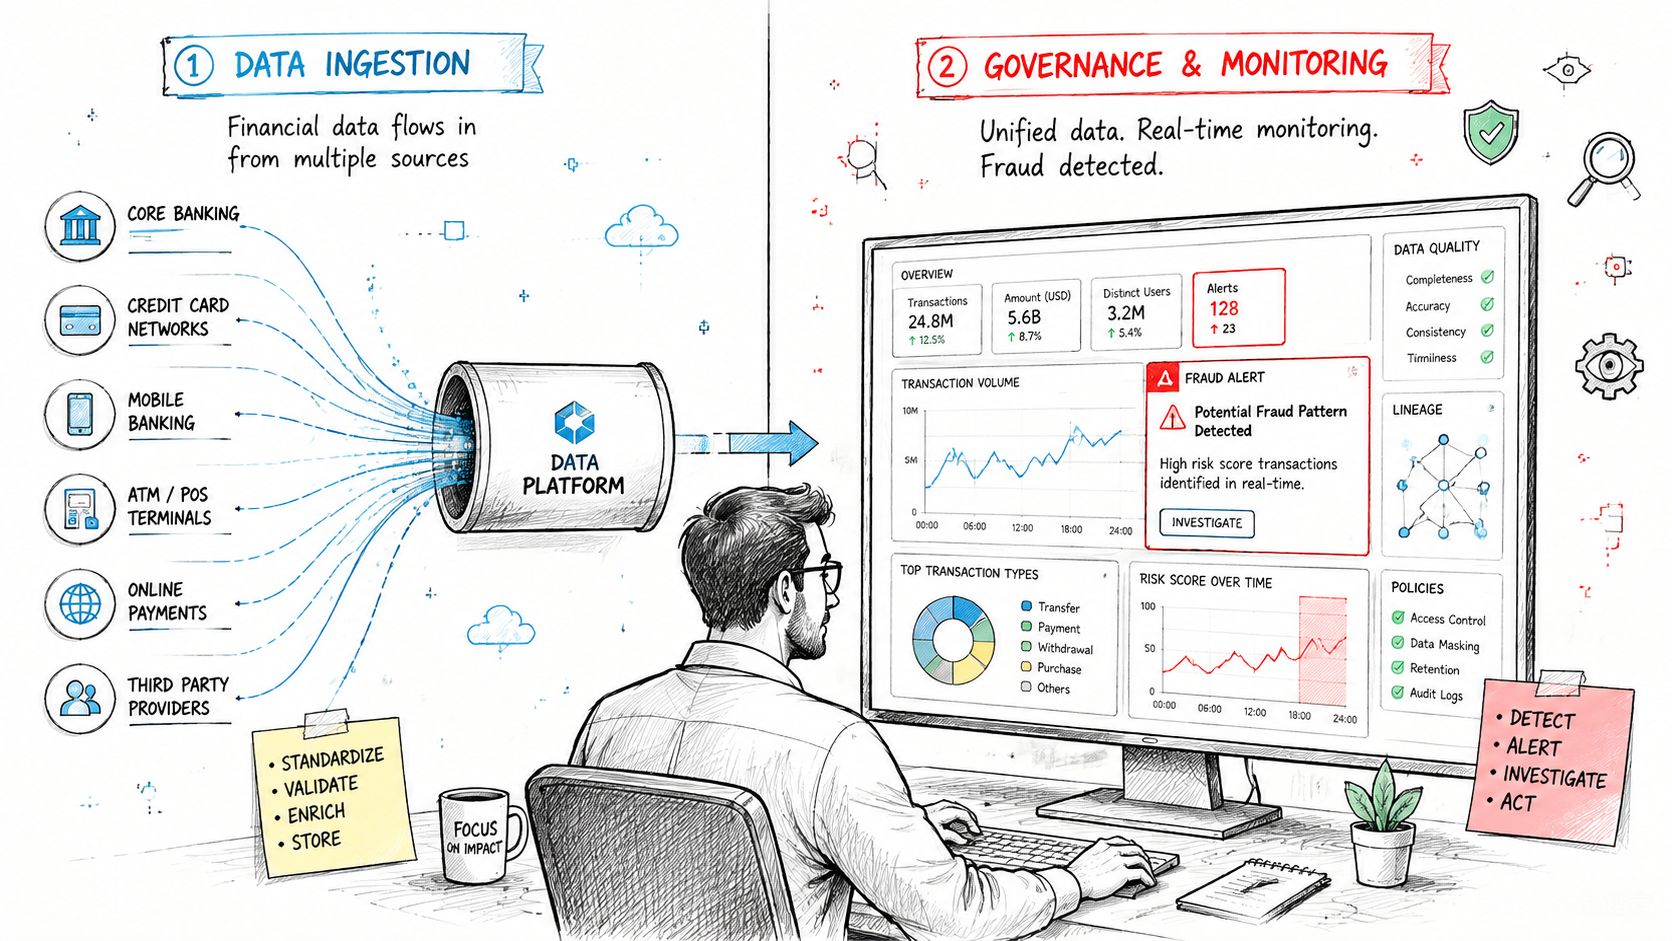
Une banque de détail peut ingérer des événements de transaction, des dossiers clients et des signaux d'appareils dans une plateforme qui prend en charge l'analyse de la fraude en quasi-temps réel. La couche d'ingestion doit gérer les événements en temps opportun, le calcul doit comparer le comportement actuel avec les modèles pertinents, la gouvernance doit restreindre les données financières sensibles, et l'Observability doit identifier les livraisons manquantes ou les changements structurels avant que les processus de fraude ne consomment des entrées défectueuses. Le compromis est la complexité opérationnelle en échange d'une détection plus rapide et d'une utilisation plus contrôlée des informations sensibles.
Un réseau hospitalier fait face à une combinaison différente de contraintes. Les dossiers cliniques, les données de réclamations, les systèmes opérationnels et les données d'appareils peuvent devoir être rassemblés, mais l'accès ne peut pas être uniforme. La gouvernance détermine quels rôles peuvent voir quels ensembles de données, le lignage aide les utilisateurs à comprendre comment un rapport a été produit, et la validation aide à appliquer des règles sur les enregistrements critiques. L'organisation accepte une charge de contrôle plus importante car la traçabilité et l'accès restreint importent autant que la commodité analytique.
Les équipes de télécommunications ont souvent besoin à la fois d'une perspective client et réseau. Un lakehouse peut fournir une base commune pour les tableaux de bord d'attrition (churn) et les modèles d'anomalies réseau, tandis que des modèles de calcul distincts servent les utilisateurs SQL et les équipes de machine learning. L'Observability aide les ingénieurs de la plateforme à distinguer un véritable changement de comportement client d'un pipeline défectueux ou d'un flux incomplet.
Les organisations du secteur public peuvent partager des données entre agences tout en respectant les exigences de résidence, d'accès et d'audit. Une plateforme modulaire peut centraliser le catalogage et les définitions de politiques tout en permettant aux différents départements de conserver la propriété de leurs ensembles de données. Le compromis accepté est que l'accès inter-agences nécessite des contrôles plus formels qu'un échange de fichiers informel, mais le résultat est une analyse plus reproductible et une responsabilité plus claire.
Ces exemples ne pointent pas vers une architecture universelle unique. Ils montrent pourquoi la conception de la plateforme doit commencer par les conséquences d'une défaillance. Un flux de télécommunications retardé, un champ clinique exposé, une métrique bancaire inexpliquée et un ensemble de données du secteur public incomplet nécessitent tous des contrôles différents, même si les couches sous-jacentes semblent similaires.
Une liste de contrôle pratique pour évaluer votre plateforme
Utilisez les questions suivantes pour évaluer votre pile actuelle. Un « non » ne signifie pas automatiquement que l'architecture est mauvaise. Il identifie une frontière où l'intégration, l'appropriation ou la visibilité peuvent être faibles.
Ingestion et stockage
Couverture des sources : La plateforme peut-elle accepter des entrées par lots (batch) et en streaming sans créer un modèle opérationnel sur mesure pour chaque source ?
Placement des données : Savez-vous quels ensembles de données ont leur place dans des tables d'entrepôt préparées, dans un stockage de lac flexible ou dans des tables de lakehouse ?
Contrôle du cycle de vie : Les propriétaires peuvent-ils identifier les attentes de conservation, d'accès et de fraîcheur pour les ensembles de données importants ?
Calcul et modélisation
Fondation partagée : L'analyse SQL, les flux de transformation et les charges de travail de machine learning peuvent-ils utiliser des données gouvernées sans copies inutiles ?
Reproductibilité : Les analystes peuvent-ils tracer une métrique depuis sa définition sémantique jusqu'aux données sources à travers les transformations ?
Adéquation de la charge de travail : La couche de calcul prend-elle en charge la latence, l'échelle et les modèles de traitement dont vos équipes ont besoin ?
Gouvernance et accès
Clarté des autorisations : La plateforme peut-elle appliquer un accès basé sur les rôles ou sur les attributs plutôt que de s'appuyer sur des accords informels ?
Lignage et catalogage : Un utilisateur peut-il découvrir ce qu'un ensemble de données signifie, qui en est le propriétaire et quels produits en aval en dépendent ?
Auditabilité : Votre équipe peut-elle reconstituer qui a accédé à des données sensibles et comment un chiffre rapporté a été produit ?
Observability et fiabilité
Visibilité de la fraîcheur : L'équipe saura-t-elle quand une livraison est en retard ou manquante avant qu'un utilisateur de tableau de bord ne signale le problème ?
Protection structurelle : La plateforme peut-elle détecter les colonnes ajoutées, les champs supprimés et les changements de types de données ?
Signaux comportementaux : Peut-elle faire remonter des anomalies de volume, de valeurs, de métriques commerciales, d'exécution de pipeline et de consommation de la plateforme ?
Une plateforme mature n'a pas besoin de provenir d'un seul fournisseur. Elle nécessite simplement une intégration suffisante pour qu'une équipe puisse répondre à la question « d'où vient ce chiffre ? » sans mener une enquête sur six outils différents. La liste de contrôle de fiabilité des données pour les équipes de données peut aider à transformer ces questions en une évaluation plus formelle.
digna fournit une plateforme d'Observability et de qualité des données d'entreprise qui s'exécute dans l'environnement propre du client, avec des contrôles en base de données pour les anomalies, la Timeliness, la validation et les changements de schéma à travers les entrepôts, les lacs et les pipelines. Visitez digna pour voir comment son approche de surveillance modulaire peut s'intégrer dans une plateforme de données gouvernée.
Questions fréquentes
Qu'est-ce qu'une plateforme de données ?
L'ensemble intégré d'outils et d'infrastructure qu'une organisation utilise pour ingérer, stocker, traiter, gouverner et servir la donnée à l'analytique et à l'IA. L'implication importante : une plateforme de données n'est pas nécessairement un produit, et ce n'est pas seulement une base de données.
Quelles sont les couches essentielles ?
Ingestion, stockage, calcul, gouvernance et observabilité, qui se calquent sur un restaurant : l'ingestion est le quai de chargement, le stockage le garde-manger et la chambre froide, le calcul la cuisine. Chaque couche emporte ses propres conséquences de coût, de vitesse d'accès, de rétention et de gouvernance.
Quelles cinq questions révèlent si vous en avez une ?
La donnée peut-elle arriver de façon fiable ? Où vit-elle ? Comment est-elle préparée ? Que signifie-t-elle et qui peut l'utiliser ? Comment les équipes savent-elles que le système est sain ? Un stack incapable de répondre aux deux dernières est une collection d'outils, pas une plateforme.
En quoi diffère-t-elle d'une base de données ?
Une base de données peut stocker sans gérer le cycle de vie complet. Les guides d'architecture décrivent une plateforme comme un logiciel aidant à stocker, accéder, gérer et gouverner les données d'entreprise à la fois sur le plan de données et sur le plan de contrôle, ce qu'une base seule n'apporte pas.
Quelle est la taille du marché des plateformes de données ?
Il était estimé à 82,4 milliards USD en 2024 et devrait dépasser 210 milliards USD d'ici 2031, soit une croissance annuelle composée de 14,5 % sur la période. Cette croissance traduit la consolidation d'outils séparés en plateformes gouvernées, et pas simplement davantage de stockage.


