Qu'est-ce qu'un fichier Parquet et pourquoi l'utiliser
|
9
minute de lecture
Parquet est un format de fichier en colonnes open source qui range ensemble les valeurs de même type et utilise des métadonnées de pied de page pour que les moteurs de requête ne lisent que les colonnes nécessaires et ignorent les données sans intérêt. Né d'un effort conjoint de Twitter et Cloudera, il paraît pour la première fois en juillet 2013 et devient projet de premier plan de l'Apache Software Foundation le 27 avril 2015.
Si vous êtes ici, vous avez sans doute l'un de trois problèmes. Vos requêtes d'entrepôt ont ralenti après la croissance d'un jeu de données. Votre lake déborde d'exports CSV, faciles à produire et pénibles à parcourir. Ou votre équipe utilise déjà Parquet, mais les performances oscillent encore entre « assez rapide » et « pourquoi ce tableau de bord expire-t-il ? ».
Cette confusion est normale. La plupart des explications répondent à qu'est-ce qu'un fichier Parquet en une ligne : « un format en colonnes compressé ». C'est vrai mais incomplet. En pratique, Parquet relève autant des métadonnées, de la discipline de schéma et des choix d'agencement des fichiers que de la compression.
Un jeu de données Parquet propre peut sembler couler de source. Un jeu désordonné peut produire des scans coûteux, des traitements en aval fragiles et des comportements étranges quand les schémas divergent d'un fichier à l'autre. C'est pourquoi les ingénieurs de données adorent Parquet et s'en plaignent en même temps.
Table des matières
À l'intérieur d'un fichier Parquet, de l'en-tête au pied de page
Bonnes pratiques de partitionnement, d'évolution de schéma et de rapidité
Introduction à Parquet pour l'analytique moderne
Une scène familière : une ingénieure analytique ouvre un modèle qui se terminait vite, ajoute deux mois de données de plus, et soudain chaque requête traîne. Les données brutes sont dans le stockage objet. Certains fichiers sont en CSV, d'autres des exports JSON, d'autres du Parquet. L'équipe BI veut des tableaux de bord plus rapides. L'équipe plateforme veut des coûts de scan plus bas. Personne ne veut réécrire tous les pipelines.
C'est là que Parquet entre habituellement dans la conversation.
Apache Parquet a été créé comme format de fichier open source orienté colonnes pour un stockage et une récupération efficaces, avec des idées de conception inspirées des travaux Dremel de Google. Il est né d'un effort conjoint de Twitter et Cloudera, a paru pour la première fois en juillet 2013 et est devenu projet de premier plan de l'Apache Software Foundation le 27 avril 2015, d'après l'historique du projet Apache Parquet.
Pour l'analytique moderne, l'attrait est simple. Parquet organise les données comme les analystes interrogent les grandes tables. La plupart des charges analytiques ne lisent pas chaque champ de chaque enregistrement. Elles lisent un sous-ensemble de colonnes, appliquent des filtres, puis agrègent.
Pourquoi les équipes passent des fichiers bruts à Parquet
Un export par lignes comme CSV est facile à inspecter, mais il force les moteurs à patauger dans des données souvent inutiles. Parquet est bâti pour un autre travail.
Lectures centrées colonnes : il fonctionne bien quand les requêtes touchent peu de colonnes sur beaucoup de lignes.
Efficacité de stockage : les valeurs de même type sont rangées ensemble, ce qui aide la compression.
Métadonnées favorables aux moteurs : les lecteurs peuvent utiliser les métadonnées du fichier pour éviter de scanner des portions inutiles d'un jeu de données.
Le hic, c'est que Parquet n'est pas un défaut universel. Il excelle pour les scans analytiques. Il n'est pas conçu comme un moteur de stockage OLTP pour des recherches et mises à jour fréquentes ligne par ligne.
Parquet aide surtout quand votre motif d'accès est large et analytique, pas transactionnel et ligne à ligne.
Cette distinction compte encore plus dans les environnements lakehouse, où le choix du format de fichier interagit avec le partitionnement, l'évolution de schéma et la planification des requêtes. Si vous exploitez ce type de pile, il est utile de relier les décisions de format aux pratiques plus larges de maintien de la qualité des données en lakehouse.
La question derrière la question
Quand on demande ce qu'est un fichier Parquet, on veut souvent dire quelque chose de plus concret :
Est-ce que cela accélérera mes requêtes ?
Est-ce que cela réduira le stockage ?
Est-ce que cela cassera quand les schémas évolueront ?
Dois-je l'utiliser pour tous les jeux de données ?
Ce sont les questions utiles. À la fin, vous devriez pouvoir y répondre plus précisément que par « Parquet est compressé et en colonnes ».
Le stockage en colonnes expliqué simplement
Pensez à un tableur avec des colonnes comme customer_id, country, signup_date et revenue. Un format orienté lignes range chaque enregistrement ensemble. Un format orienté colonnes range toutes les valeurs de customer_id ensemble, toutes celles de country ensemble, et ainsi de suite.
Cela paraît abstrait jusqu'à ce qu'on le rapporte à une requête.
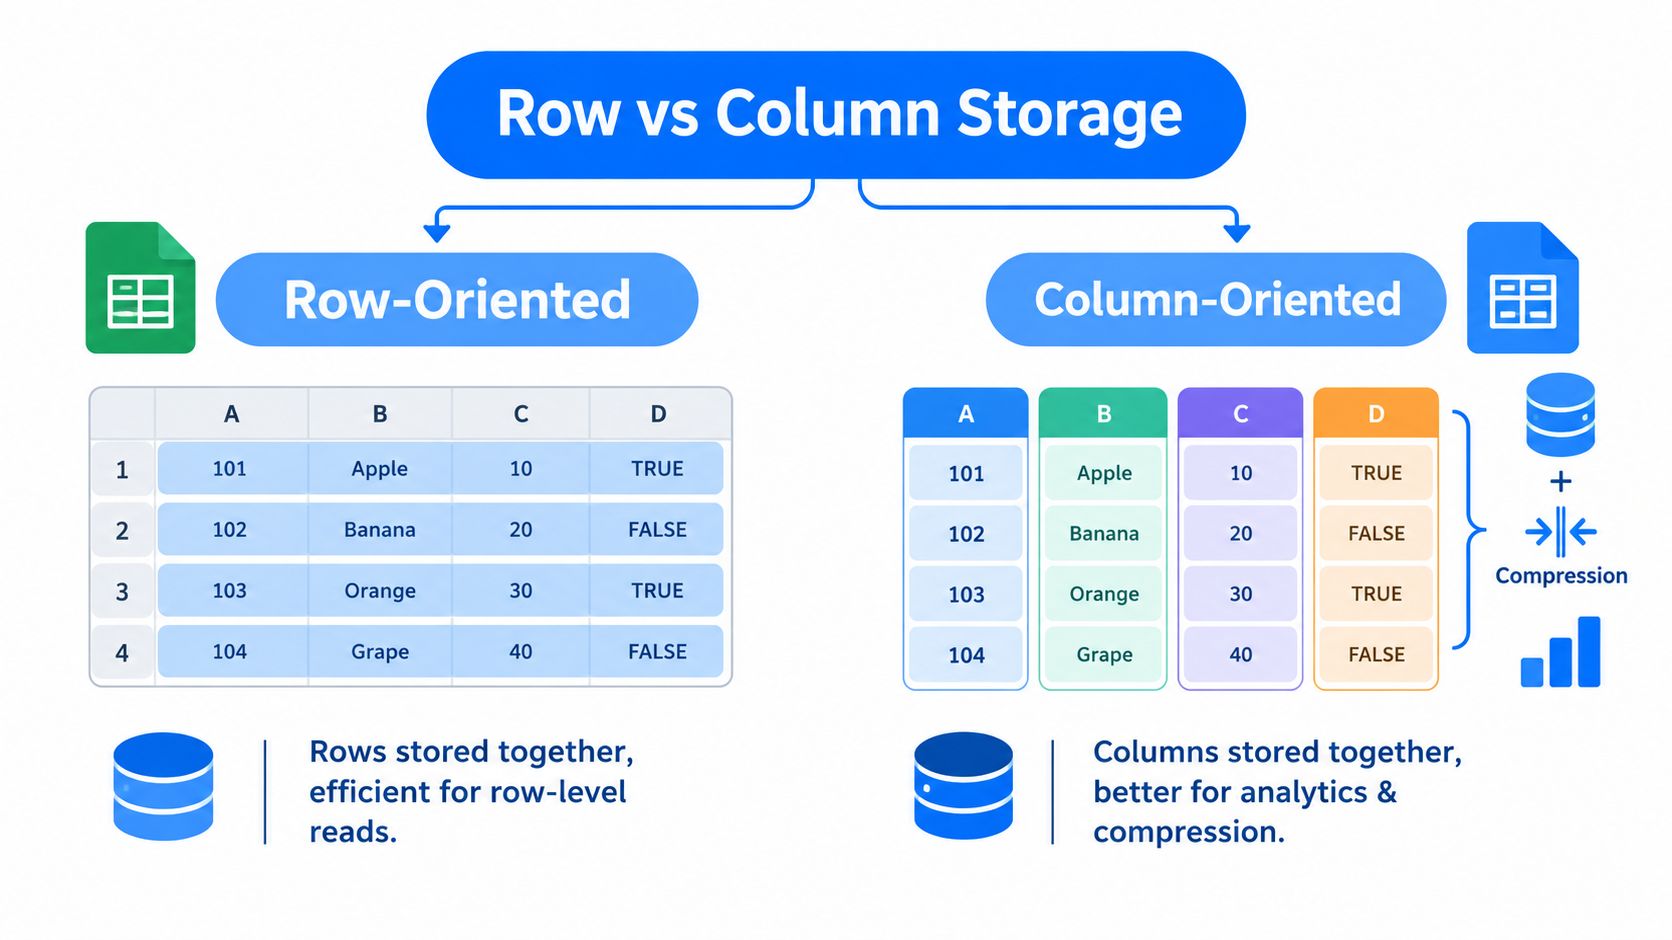
Stockage par lignes contre stockage par colonnes
Supposons que vous exécutiez :
select country, sum(revenue) from sales where signup_date >= ... group by country
Un fichier orienté lignes oblige le moteur à lire chaque enregistrement complet, y compris les colonnes que votre requête n'utilise pas. Un fichier orienté colonnes lui permet de se concentrer sur country, revenue et signup_date.
C'est la première grande idée : l'élagage de colonnes. Le lecteur saute entièrement les colonnes non sollicitées.
La deuxième grande idée est la compression. Quand des valeurs semblables se côtoient, la compression fonctionne généralement mieux. Une colonne pleine de dates se comporte autrement qu'une colonne de texte, et une colonne de catégories répétées autrement qu'un champ de notes libres.
Pourquoi les valeurs de même type aident
Parquet prend en charge des encodages de colonne et des codecs de compression intégrés, et le format documente des codecs comme Snappy, Gzip, LZO et Zstandard. Parce que les valeurs de même type sont rangées ensemble, cet agencement améliore l'efficacité du stockage et offre aux équipes un arbitrage entre coût CPU et taille de fichier pour les charges analytiques, comme le décrit la documentation des encodages Parquet.
Voici la version pratique :
Les valeurs répétées compressent bien : codes pays, champs de statut, booléens.
Les suites numériques s'encodent efficacement : identifiants et horodatages profitent souvent d'encodages spécialisés.
Les tables larges gagnent à la projection : si votre tableau de bord a besoin de 5 colonnes sur 80, le moteur n'a pas à payer pour les 80.
Règle pratique : si vos utilisateurs parcourent d'habitude beaucoup de lignes mais seulement une fraction des colonnes, le stockage en colonnes travaille avec votre charge et non contre elle.
Là où l'on se trompe
Beaucoup entendent « en colonnes » et en déduisent que Parquet est automatiquement plus rapide dans tous les cas. Ce n'est pas vrai.
Parquet est optimisé pour les scans analytiques, surtout quand vous avez besoin de quelques colonnes sur beaucoup d'enregistrements. Il est moins naturel pour les accès ligne à ligne, les mises à jour à haute fréquence ou les charges qui vont sans cesse chercher des enregistrements individuels par clé.
Un modèle mental utile est celui-ci :
CSV : facile à produire, difficile à parcourir efficacement à grande échelle
Formats binaires par lignes : meilleurs pour lire des enregistrements entiers
Parquet : idéal quand la requête est sélective par colonne et vaste par nombre de lignes
Si vous ne retenez qu'une chose de cette section, retenez celle-ci : Parquet accélère l'analytique parce qu'il change ce que le moteur doit lire, pas seulement parce qu'il réduit la taille des fichiers.
À l'intérieur d'un fichier Parquet, de l'en-tête au pied de page
Une fois l'idée des colonnes comprise, l'étape suivante est l'anatomie du fichier. Parquet devient alors plus que « du CSV mais compressé ».
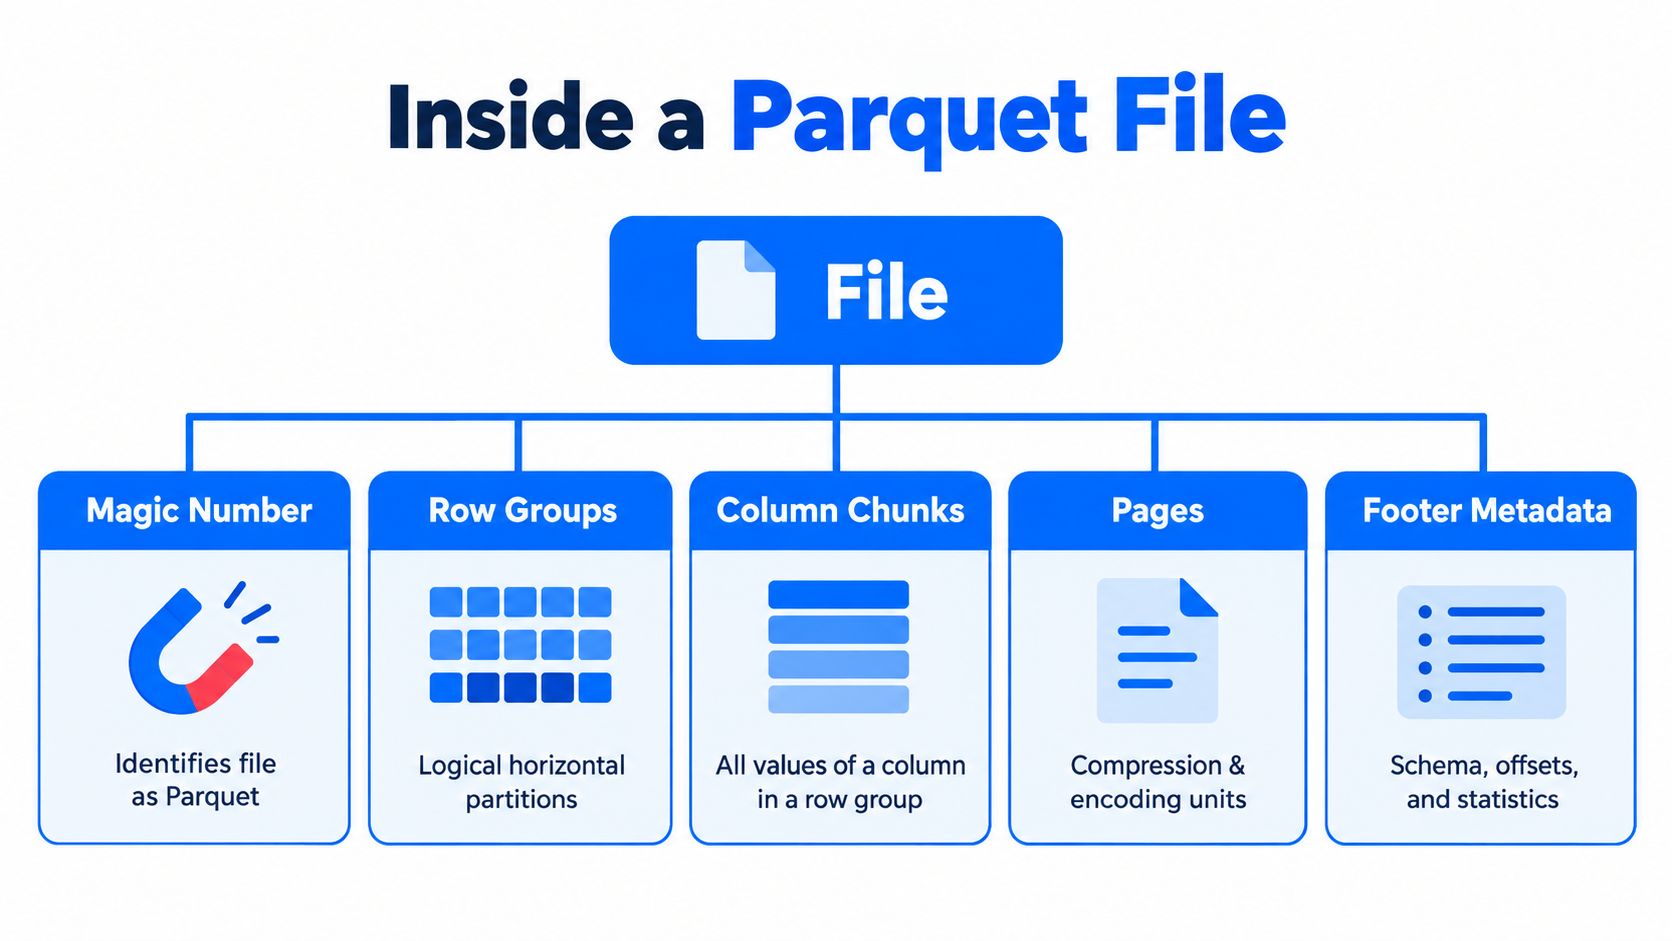
Un fichier Parquet commence par un nombre magique de 4 octets, PAR1, et contient des métadonnées de pied de page qui consignent le schéma, l'emplacement des blocs de colonnes, les encodages et les statistiques. Cette conception permet aux moteurs de ne lire que les colonnes utiles et d'ignorer les groupes de lignes sans intérêt pendant les scans, selon la documentation du format de fichier Parquet.
Le fichier a des couches
Il est utile de se représenter un fichier Parquet comme un conteneur à parties imbriquées.
En-tête
Commence par le nombre magique
PAR1.Signale que le fichier suit le format Parquet.
Groupes de lignes
Partitions horizontales à l'intérieur du fichier.
Chaque groupe de lignes contient les données d'une tranche de lignes.
Blocs de colonnes
Dans chaque groupe de lignes, chaque colonne est rangée séparément.
Une requête lisant trois colonnes n'a besoin que des blocs de ces colonnes.
Pages
Unités plus petites au sein des blocs de colonnes.
Les encodages et la compression s'appliquent à ce niveau.
Pied de page
Stocke le schéma et la carte structurelle du fichier.
Contient des métadonnées sur l'emplacement des blocs et leur encodage.
Pourquoi le pied de page compte tant
Le pied de page est la partie que beaucoup d'introductions sous-estiment. C'est là que Parquet devient intelligent.
La vraie puissance de Parquet vit dans les métadonnées. Le fichier ne stocke pas que des valeurs. Il stocke assez de structure pour aider les moteurs à éviter du travail inutile.
Ces métadonnées peuvent indiquer à un lecteur où commence un bloc de colonne, comment les valeurs ont été encodées et quelles statistiques sont disponibles pour l'élagage. Autrement dit, le moteur n'ouvre pas le fichier à l'aveugle pour lire jusqu'à trouver. Il part d'une carte.
Pour les équipes qui manipulent beaucoup de fichiers dans un lake, c'est la raison pour laquelle les pratiques de gestion des métadonnées comptent autant. L'analytique rapide dépend d'une structure de fichiers organisée, de schémas cohérents et de métadonnées lisibles, pas du seul choix initial de Parquet.
Ce que font les groupes de lignes en pratique
Les groupes de lignes sont un compromis utile. Ils rendent un fichier assez grand pour des scans efficaces tout en restant divisible pour le travail parallèle.
Supposons que votre requête filtre sur une colonne de date. Si les métadonnées indiquent qu'un groupe de lignes tombe entièrement hors de la plage du filtre, le moteur peut l'ignorer. Si la requête ne sélectionne qu'un sous-ensemble de colonnes, il peut aussi ignorer les blocs de colonnes inutiles dans les groupes retenus.
C'est cette combinaison qui fait souvent gagner Parquet :
Ignorer les colonnes dont vous n'avez pas besoin
Ignorer les groupes de lignes qui ne peuvent pas correspondre
Décoder les pages seulement là où c'est nécessaire
Pourquoi l'anatomie du fichier pèse sur l'exploitation
Quand Parquet se comporte mal, le problème n'est presque jamais « Parquet est lent ». C'est plutôt l'un de ceux-ci :
trop de fichiers minuscules
tailles de groupes de lignes mal choisies
schémas incohérents entre fichiers partiels
statistiques faibles ou absentes
découverte de métadonnées coûteuse sur de grandes tables
C'est pourquoi les ingénieurs expérimentés traitent Parquet à la fois comme un format de stockage et comme un système d'exploitation. Les entrailles du fichier sont élégantes. C'est au niveau du jeu de données que commencent les parties difficiles.
Compression, encodages et compromis de performance
Parquet tire une bonne part de son efficacité d'une chose simple : dès que des valeurs de même type se côtoient, le format peut les encoder et les compresser plus intelligemment qu'un fichier texte.
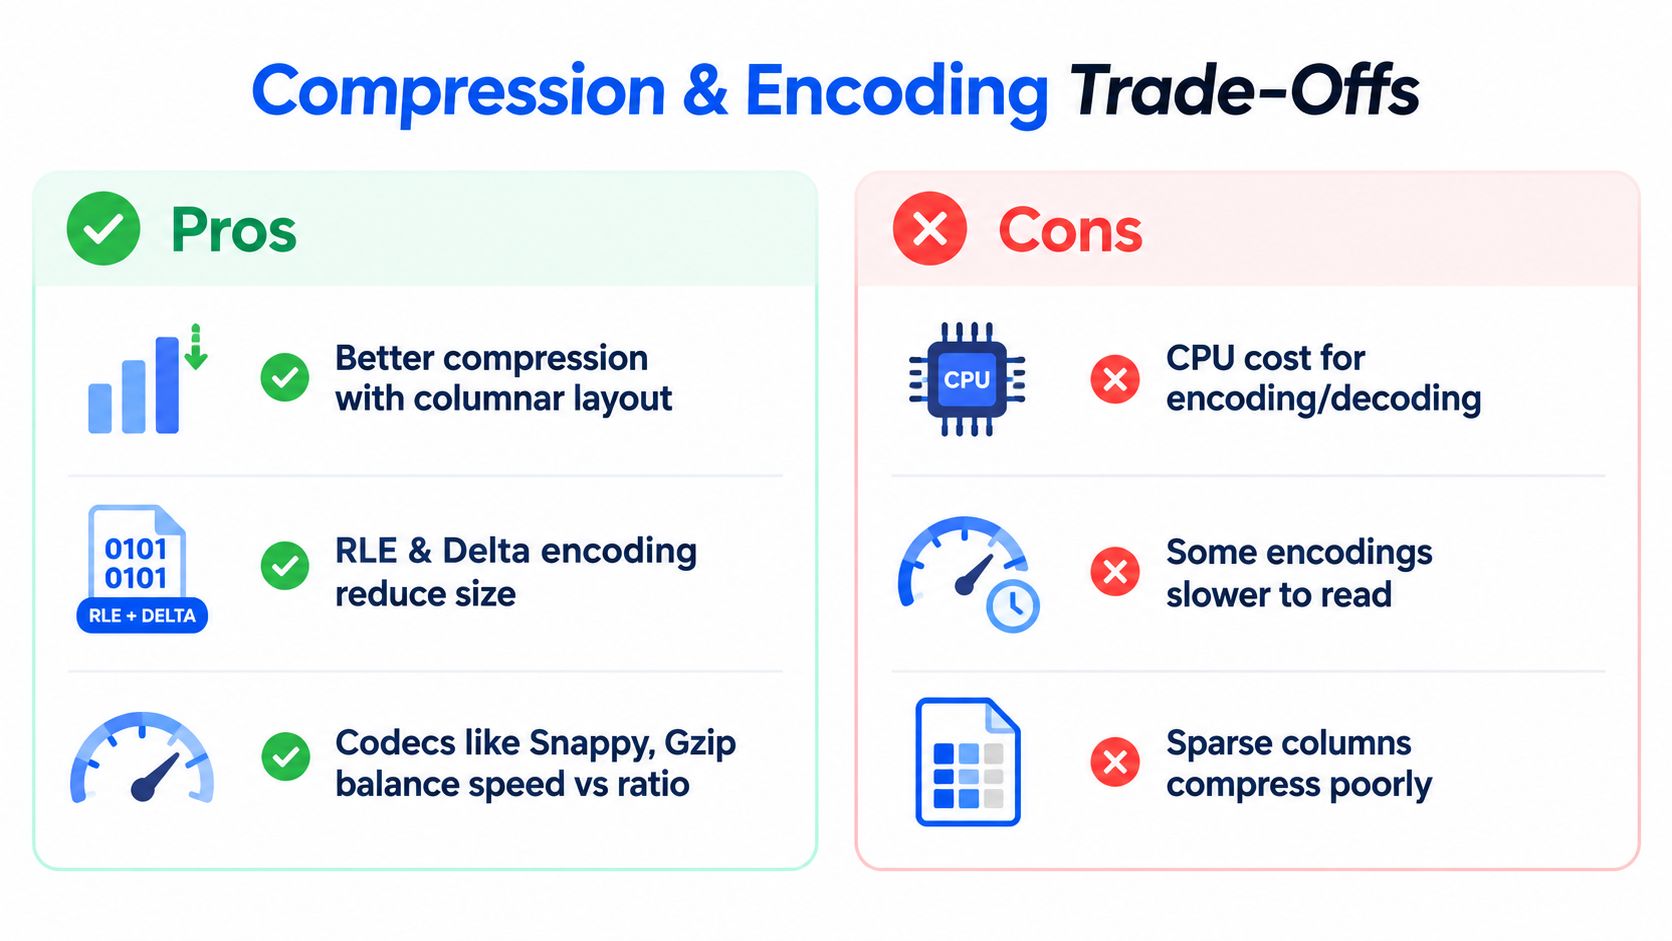
Le détail clé est l'endroit où cela se produit. Parquet prend en charge plusieurs mécanismes d'encodage et de compression au niveau des pages. Le format inclut des encodages tels que PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY et BYTE_STREAM_SPLIT, ainsi que des codecs de compression comme SNAPPY, GZIP, BROTLI, ZSTD et LZ4_RAW, comme le résume la référence du format Parquet.
L'encodage d'abord, la compression ensuite
Une façon simple d'y penser :
L'encodage change la manière dont les valeurs sont représentées.
La compression réduit les octets encodés.
Les deux sont liés, mais ce ne sont pas la même décision.
Une colonne de chaînes à faible cardinalité peut profiter d'un traitement par dictionnaire. Une série numérique peut convenir à un encodage par deltas. Ensuite, un codec comme Snappy ou ZSTD peut compresser davantage les pages.
Encodages et codecs Parquet en un coup d'œil
Mécanisme | Exemples | Idéal pour | Compromis |
|---|---|---|---|
Encodage | PLAIN | Données simples, compatibilité large | Moins compact pour les valeurs répétitives |
Encodage | RLE | Valeurs répétées ou à faible cardinalité | Moins utile quand les valeurs varient fortement |
Encodage | DELTA_BINARY_PACKED | Données numériques ordonnées ou à évolution progressive | Peut ajouter du travail de décodage |
Encodage | RLE_DICTIONARY | Valeurs catégorielles répétées | Le surcoût du dictionnaire n'aide pas toutes les colonnes |
Encodage | BYTE_STREAM_SPLIT | Certaines dispositions numériques | La prise en charge par le lecteur et l'adéquation à la charge comptent |
Codec | SNAPPY | Lectures analytiques rapides | Fichiers en général plus gros qu'avec des codecs plus lourds |
Codec | GZIP | Meilleure réduction de la taille des fichiers | Plus de CPU pour compresser et décompresser |
Codec | BROTLI | Cas d'usage à compression agressive | Peut augmenter le coût de calcul |
Codec | ZSTD | Équilibre entre taille et vitesse dans bien des charges | Les résultats dépendent du support moteur et des réglages |
Codec | LZ4_RAW | Scénarios de décompression rapide | Le taux de compression peut être moins agressif |
Plus petit n'est pas toujours plus rapide
Les équipes sur-optimisent souvent le mauvais paramètre. Le plus petit fichier sur disque ne produit pas automatiquement la requête la plus rapide.
Si un codec comprime agressivement mais coûte plus de CPU au décodage, le temps total peut augmenter. À l'inverse, si le stockage ou le transfert réseau est la contrainte dominante, une compression plus dense peut valoir le coup.
Pour l'analytique, le bon choix est généralement celui qui réduit le travail total entre stockage, E/S et CPU. Pas celui qui produit le fichier le plus petit.
Voilà pourquoi il faut tester. Des moteurs comme Spark, Trino, DuckDB et les runtimes d'entrepôt réagissent différemment aux tailles de fichiers, à la structure des pages et au coût de décompression. Le même arbitrage revient dans l'optimisation des requêtes en général, pas seulement dans les formats de fichiers, raison pour laquelle de bonnes habitudes d'optimisation SQL restent utiles après l'adoption de Parquet.
Comparaison avec les autres formats
La compression est aussi un bon endroit pour distinguer Parquet des formats voisins :
CSV n'offre guère d'appui structurel à une compression typée efficace.
Avro est orienté lignes, ce qui change ce qui compresse bien et ce qui se lit efficacement.
ORC est lui aussi en colonnes et tourné vers l'analytique.
Delta ajoute un comportement de table par-dessus Parquet plutôt que de remplacer son agencement de stockage.
Alors oui, Parquet est souvent plus petit et plus rapide que CSV pour l'analytique. Mais son avantage réel vient de la combinaison agencement, métadonnées, encodages et lecture sélective.
Parquet comparé à CSV, Avro, ORC et Delta
Les comparaisons de formats s'embrouillent quand on demande « lequel est le meilleur ? ». C'est généralement la mauvaise question. La bonne est : quel format correspond au motif d'accès et au modèle d'exploitation de ce jeu de données ?
Partez de la charge de travail, pas de la fidélité
CSV reste courant parce qu'il est universel. On l'ouvre presque partout. Mais l'universalité s'accompagne d'un typage faible, de métadonnées pauvres et de scans coûteux.
Avro convient mieux quand comptent l'échange orienté lignes, les pipelines événementiels ou la lecture d'enregistrements entiers. ORC concurrence plus directement Parquet dans les environnements analytiques, surtout dans les piles nées autour de l'optimisation façon Hive. Delta est encore autre chose : il désigne généralement une couche de transactions et de gestion de tables bâtie sur des fichiers Parquet.
Choisir entre Parquet, CSV, Avro, ORC et Delta
Format | Agencement | Charge idéale | Limite à surveiller |
|---|---|---|---|
Parquet | En colonnes | Scans analytiques sur de grandes données tabulaires | Peut devenir pénible à exploiter avec la dérive de schéma et un mauvais agencement de fichiers |
CSV | Texte brut proche des lignes | Échange simple, exports rapides, inspection manuelle | Typage faible, pas de métadonnées riches, grands scans inefficaces |
Avro | Binaire orienté lignes | Pipelines événementiels, sérialisation, traitement d'enregistrements entiers | Moins efficace que les formats en colonnes pour l'analytique sélective |
ORC | En colonnes | Analytique dans les écosystèmes qui privilégient l'outillage ORC | L'adéquation dépend du support moteur et des standards de l'équipe |
Delta | Couche de table au-dessus de Parquet | Charges lakehouse nécessitant sémantique de table et gestion des données | Ajoute des concepts d'exploitation au-delà du seul format de fichier |
La question subtile que l'on saute
Beaucoup d'équipes demandent ce qu'est un fichier Parquet, l'adoptent et s'arrêtent là. La meilleure relance est : cette charge devrait-elle encore utiliser Parquet par défaut ?
Cette question compte davantage aujourd'hui car le format continue d'évoluer. La documentation du projet Parquet de 2026 montre des changements actifs, dont la prise en charge de Variant en préversion et un type logique File proposé pour les charges non structurées, signe d'une extension au-delà des tables analytiques classiques. Mais ces capacités ne sont pas encore largement matures dans l'écosystème, si bien que l'adéquation à la charge compte plus que des défauts uniformes, comme le note la documentation des versions du format Parquet.
Cela a une implication concrète en 2025 et 2026. Les équipes choisissent de plus en plus le format selon le motif d'accès :
scans analytiques sur des données tabulaires stables
transport d'événements ligne à ligne
opérations de lakehouse gérées par table
charges semi-structurées ou à fort accès aléatoire
Pour les équipes plateforme sur des piles lakehouse façon Databricks, le choix du format interagit aussi avec des décisions de gouvernance et de fiabilité comme la gestion de la qualité des données pour les environnements Databricks.
Une règle de décision simple
Utilisez Parquet quand votre motif dominant est la lecture analytique sur de grands jeux de données et que votre outillage le prend bien en charge. Soyez plus prudent quand la charge penche vers des mises à jour fréquentes de lignes, des charges semi-structurées en forte évolution, ou des accès qui privilégient la récupération aléatoire aux scans larges.
Parquet est souvent un défaut solide. Il n'est simplement plus le seul défaut raisonnable.
Inspecter et créer des fichiers Parquet en pratique
La théorie aide, mais la plupart des ingénieurs finissent par vouloir répondre à trois questions concrètes :
Quel schéma contient ce fichier ?
Combien de groupes de lignes comporte-t-il ?
Quels choix de compression ou d'encodage ont été faits ?
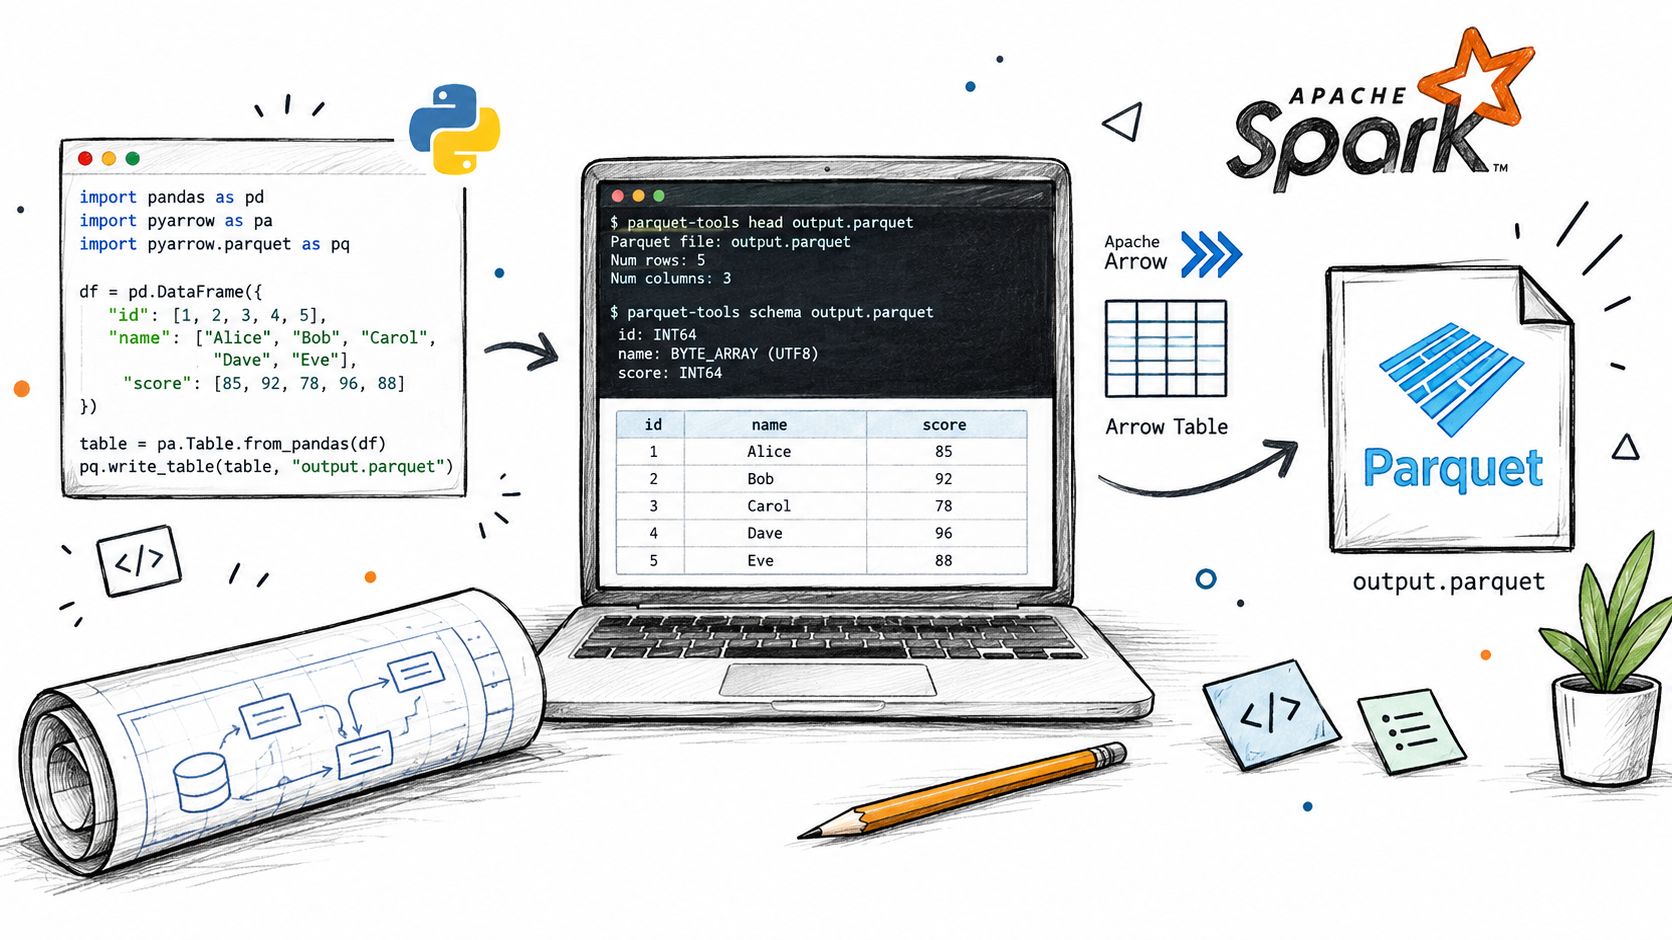
Inspecter un fichier
Une habitude légère consiste à inspecter le Parquet avant de déboguer le comportement des requêtes en aval.
Avec parquet-tools, les ingénieurs regardent couramment schéma et métadonnées :
Avec PyArrow en Python :
Avec Spark :
Que cherchez-vous ?
La forme du schéma : les noms et types de colonnes sont-ils ceux que vous attendez ?
Le nombre de groupes de lignes : trop élevé, il peut signaler une fragmentation excessive.
Les détails de compression : utiles quand stockage et temps d'exécution ne concordent pas.
La nullabilité et les changements de champs : souvent le premier indice d'une casse en aval.
Écrire du Parquet depuis Python et Spark
Créer du Parquet est généralement simple. Les détails d'exploitation comptent plus que la syntaxe.
Avec pandas et PyArrow :
Avec Spark :
Ces lignes sont la partie facile. Les questions plus importantes sont :
Écrivez-vous des tailles de fichiers sensées ?
Les partitions correspondent-elles aux filtres réels ?
Tous les écrivains produisent-ils le même schéma ?
Les traitements d'ajout introduisent-ils de la dérive ?
Les outils ne font que la moitié du travail
Un jeu de données peut contenir des fichiers Parquet valides et se comporter mal en tant que table. C'est pourquoi les équipes combinent souvent l'inspection de fichiers avec la surveillance des changements de schéma, de la fraîcheur et du comportement des données. Entrent dans cette catégorie l'inspection de métadonnées native au moteur, l'outillage de catalogue et des plateformes comme digna, qui surveille le comportement des données, valide les enregistrements, suit la ponctualité et détecte les changements de schéma dans l'environnement du client.
Si votre plan de requête paraît raisonnable mais que les performances oscillent encore, inspectez les fichiers et les métadonnées du jeu de données avant d'accuser le moteur.
En pratique, la meilleure boucle de débogage est courte : inspecter le fichier, inspecter l'agencement de la table, inspecter le plan de requête, puis inspecter l'évolution du schéma entre partitions ou lots d'ajout.
Bonnes pratiques de partitionnement, d'évolution de schéma et de rapidité
La plupart des problèmes de « performance Parquet » ne viennent pas de Parquet. Ils viennent de la façon dont les équipes écrivent, ajoutent, partitionnent et font évoluer les jeux de données dans le temps.
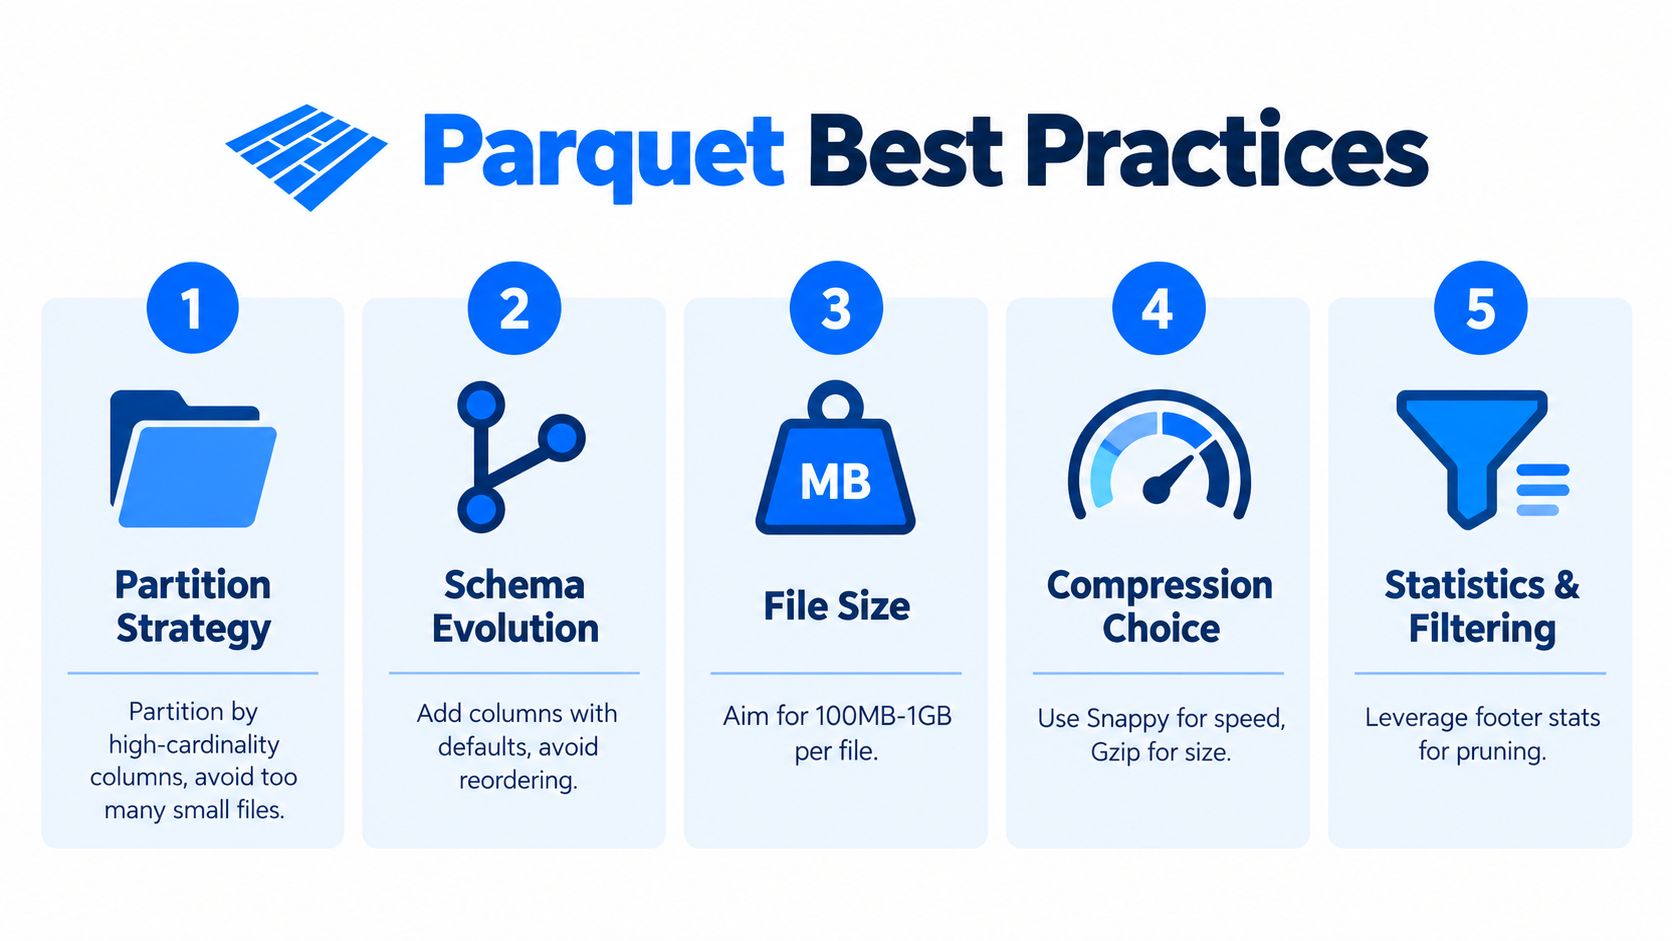
Traitez l'agencement comme une part du modèle de données
La spécification Parquet recommande de grands groupes de lignes de 512 Mo à 1 Go, ce qui aide à équilibrer efficacité de scan et traitement parallèle pour de grands jeux analytiques, selon les recommandations de configuration Parquet.
Cette recommandation surprend, car beaucoup de jeux réels finissent fragmentés en morceaux bien plus petits. Petits fichiers et groupes de lignes minuscules créent de la surcharge de planification, de gestion des métadonnées et d'ordonnancement des tâches.
Quelques habitudes pratiques aident :
Partitionnez avec retenue : partitionnez selon les champs sur lesquels on filtre. Trop de partitions créent une prolifération de fichiers et des soucis de métadonnées.
Visez des tailles de fichiers saines : assez grandes pour des scans efficaces, pas au point que la planification domine.
Gardez des écrivains cohérents : des réglages d'écriture mélangés entre traitements produisent souvent des performances irrégulières.
C'est dans l'évolution de schéma que se cachent les coûts
Un angle souvent oublié dans les discussions sur ce qu'est un fichier Parquet : le plus dur n'est pas le format de fichier. C'est de lire efficacement des jeux de données aux schémas mélangés.
Apache Spark note que Parquet prend en charge l'évolution de schéma, mais que la fusion de schémas entre fichiers partiels est relativement coûteuse et désactivée par défaut sauf activation explicite. Autrement dit, beaucoup de problèmes Parquet réels sont des problèmes de gestion de métadonnées dans les data lakes, surtout pour des jeux alimentés en continu où une dérive de schéma silencieuse peut déclencher des scans complets coûteux à la lecture, comme le décrit la documentation du projet Parquet.
Le format de fichier peut être irréprochable. Le jeu de données peut rester difficile à lire efficacement si chaque lot écrit une forme légèrement différente.
C'est pourquoi la gouvernance de schéma compte. Les équipes ont besoin d'un modèle clair des changements autorisés, d'une détection de la dérive et d'une visibilité sur l'impact en aval. Un point de départ concret est une compréhension partagée des types de schémas et motifs de changement avant que les pipelines n'évoluent chacun de leur côté.
À quoi ressemble une bonne exploitation
Les jeux de données Parquet les plus sains partagent quelques traits :
Discipline d'ajout : les nouvelles données arrivent dans une structure prévisible.
Revue de schéma : les colonnes ajoutées sont délibérées, pas accidentelles.
Conscience des métadonnées : les ingénieurs inspectent groupes de lignes, partitions et comportement de scan.
Contrôles de Timeliness : les chargements tardifs ou partiels ne corrompent pas les hypothèses en aval.
Si vous retenez une chose de cet article, que ce soit celle-ci : Parquet est puissant parce qu'il permet aux moteurs d'éviter du travail inutile. Mais si vos fichiers sont trop petits, vos partitions trop bruyantes ou vos schémas trop incohérents, le moteur perd vite cet avantage.
Si la performance de Parquet dans votre lake finit toujours par devenir un problème de dérive de schéma ou de visibilité des métadonnées, digna peut vous aider à surveiller les changements structurels, la ponctualité, la qualité au niveau des enregistrements et le comportement général des données sans sortir les données de votre environnement. Il devient plus facile de repérer les problèmes d'exploitation autour des jeux Parquet avant qu'ils ne deviennent des tableaux de bord cassés ou des scans coûteux. Pour en savoir plus : digna.
Un fichier valide n'est pas un jeu de données fiable — l'observabilité des données surveille les signaux de schéma, de fraîcheur et de volume sur lesquels les métadonnées Parquet seules n'agiront pas.
Questions fréquentes
Qu'est-ce qu'un fichier Parquet ?
Un format de fichier en colonnes open source qui range ensemble les valeurs de même type et utilise des métadonnées de pied de page pour que les moteurs de requête ne lisent que les colonnes nécessaires et ignorent les données sans intérêt. Né d'un effort conjoint de Twitter et Cloudera, il a paru pour la première fois en juillet 2013 et est devenu ensuite projet Apache de premier plan.
En quoi le stockage en colonnes diffère-t-il du stockage par lignes ?
Le stockage par lignes garde ensemble tous les champs d'un enregistrement ; le stockage en colonnes regroupe les valeurs de chaque champ à travers les enregistrements. Comme les valeurs de même type se côtoient, elles s'encodent et se compressent bien mieux, et une requête qui touche trois colonnes n'a jamais à lire le reste.
Pourquoi le pied de page compte-t-il tant ?
Il contient le schéma et la carte des emplacements des groupes de lignes et des blocs de colonnes, si bien qu'un lecteur le consulte avant de décider quoi ouvrir. Cela rend la planification bon marché pour les scans analytiques — et un pied de page endommagé démesurément coûteux, puisque les pages de données peuvent être intactes et pourtant inaccessibles.
Un fichier Parquet plus petit est-il toujours plus rapide ?
Non. Plus petit n'est pas toujours plus rapide : un codec agressif réduit les octets sur disque mais ajoute du CPU à chaque lecture, ce qui peut faire monter la latence des tableaux de bord au lieu de la baisser. Choisissez d'abord l'encodage selon le motif des valeurs de la colonne, puis le codec selon l'arbitrage stockage/CPU.
Quand choisir Parquet plutôt que CSV, Avro, ORC ou Delta ?
Partez de la charge de travail plutôt que de la fidélité à un format. Parquet convient aux scans analytiques répétés sur un sous-ensemble de colonnes ; Avro aux écritures ligne à ligne et à l'échange d'événements ; CSV reste utile pour l'inspection et les transferts simples ; Delta apporte des garanties transactionnelles que Parquet seul n'offre pas.



