Nettoyage des données en SQL : modèles pratiques
|
9
minute de lecture
Un tableau de bord grimpe en flèche du jour au lendemain, et la première explication est généralement l'activité commerciale. Puis quelqu'un vérifie l'entrepôt et trouve des commandes en double, des clés étrangères manquantes ou des dates analysées dans deux formats différents. Le rapport n'était pas « presque correct ». Ses entrées étaient incohérentes, et chaque calcul en aval a hérité du problème.
C'est la réalité opérationnelle du nettoyage des données en SQL. Le travail consiste moins à concevoir une syntaxe intelligente qu'à mesurer les défauts, isoler les enregistrements risqués, appliquer des réparations déterministes et empêcher le retour de ces mêmes défauts. À l'échelle de l'entrepôt, un UPDATE imprudent peut endommager plus de données qu'il n'en corrige, tandis qu'un flux de travail SQL bien structuré peut rendre la logique de qualité répétable, révisable et efficace.
Table des matières
Pourquoi SQL reste l'épine dorsale du nettoyage de données
Profiler vos données avant d'écrire la moindre correction
Établir une référence de défauts
Trouver les doublons sans toucher à la production
Gérer les valeurs nulles et supprimer les doublons à l'échelle
Dédupliquer avec une règle de survie explicite
Savoir comment l'unicité traite les valeurs nulles
Standardiser les formats de texte et corriger les types de données
Rendre les conversions explicites
Standardiser avant la déduplication
Verrouiller la qualité avec des contraintes et des règles de validation
Choisir le rejet strict ou la mise en quarantaine souple
Aller au-delà des scripts ponctuels vers une surveillance continue
Pourquoi SQL reste l'épine dorsale du nettoyage de données
Une charge de travail analytique importante peut consacrer plus de temps à préparer les données qu'à les analyser. Une statistique largement citée indique que les analystes et les scientifiques des données peuvent passer jusqu'à 80 % de leur temps à nettoyer et préparer les données, un constat abordé dans cet aperçu du nettoyage de données en SQL de Domo. Cette répartition explique pourquoi des opérations telles que le filtrage des valeurs nulles, la suppression des doublons, la standardisation des formats et la validation des plages sont devenues des compétences fondamentales pour les ingénieurs de données et les ingénieurs analytiques.
SQL se situe au plus près des données, ce qui est crucial dans les architectures ELT modernes. Les enregistrements bruts peuvent être chargés dans un entrepôt et transformés là où ils résident déjà, au lieu d'être extraits, déplacés et traités à plusieurs reprises dans un autre système. La base de données devient la couche d'exécution de la logique de qualité, tandis que les instructions SQL fournissent un historique déterministe de ce qui a changé et pourquoi.
Un incident typique commence par un petit défaut qui devient un problème de rapport majeur :
Événements commerciaux en double : Une tentative de réexécution dans un travail d'intégration crée deux lignes pour une même transaction, gonflant le chiffre d'affaires ou le volume.
Clés de relation manquantes : Une clé client ou produit nulle empêche une jointure de correspondre, de sorte que le tableau de bord sous-estime l'activité.
Dérive de format : Une source envoie une date sous forme de texte dans une convention différente, décalant les enregistrements dans la mauvaise période de rapport.
Valeurs sentinelles : Des chaînes vides, des dates fictives ou des zéros remplacent les informations manquantes et passent à travers les contrôles superficiels de valeurs nulles.
Règle de production : Traitez le nettoyage comme une opération de données contrôlée, et non comme une série de corrections improvisées au sein d'une requête de tableau de bord.
La distinction est importante car SQL peut à la fois réparer et dissimuler des défauts. Un COALESCE peut permettre l'affichage d'un rapport tout en masquant une valeur manquante qui devrait déclencher un incident en amont. Un DELETE trop large peut supprimer des doublons tout en effaçant l'enregistrement valide qui aurait dû être conservé. Une bonne logique de nettoyage classifie d'abord les erreurs, isole les lignes affectées et conserve suffisamment de preuves pour auditer la décision.
Pour les lecteurs qui souhaitent des exemples SQL plus larges et des perspectives pratiques, les ressources SQL de Wonderment Apps offrent un contexte utile sur le langage et ses applications. Pour les équipes qui évaluent l'exécution de la qualité native dans l'entrepôt, les conseils de digna sur la qualité des données en base de données sont pertinents, car maintenir les contrôles à proximité des données réduit les mouvements inutiles et sépare la logique de validation des scripts externes fragiles.
Profiler vos données avant d'écrire la moindre correction
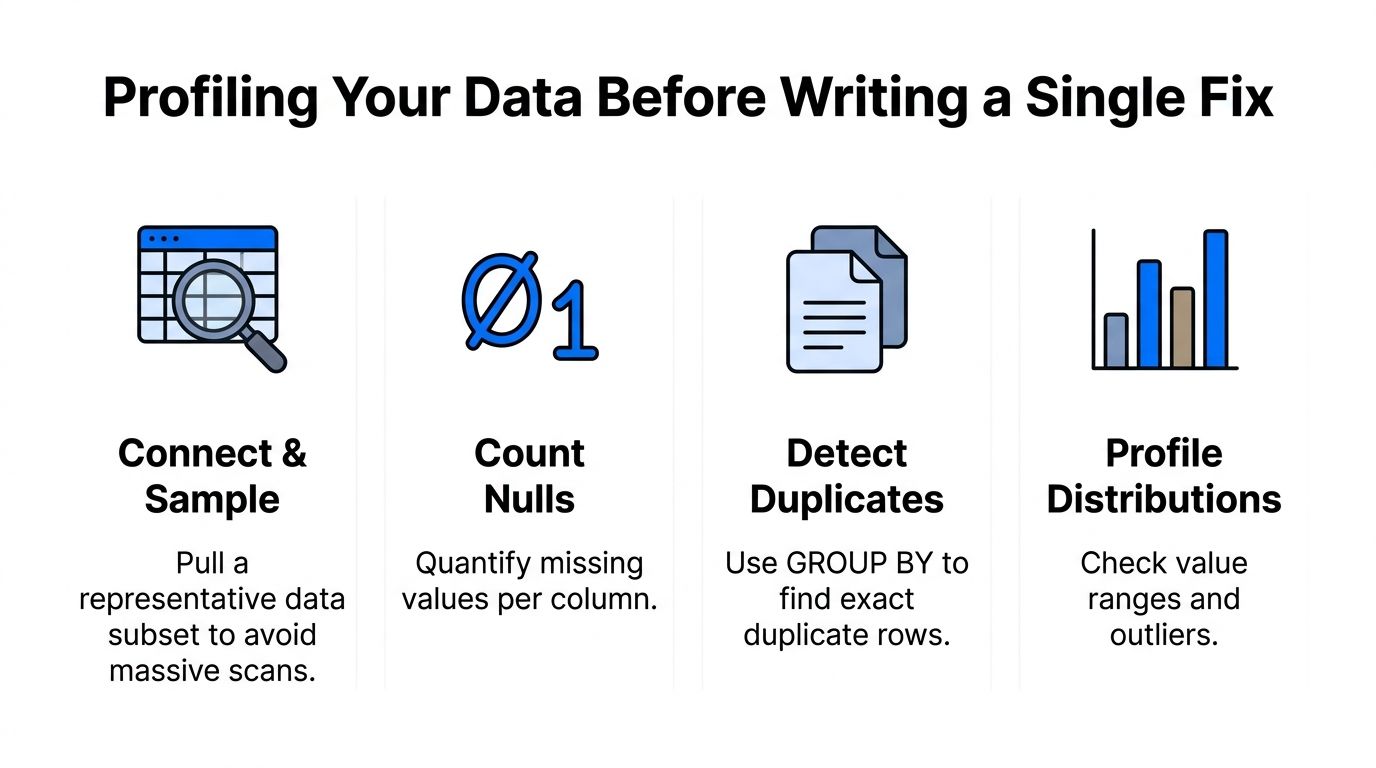
L'erreur de nettoyage la plus coûteuse est souvent la première : écrire un UPDATE avant de mesurer le problème. Un profil vous donne une référence, révèle si le problème est isolé ou systémique, et vous permet de comparer l'ensemble de données avant et après la correction.
Commencez par un échantillon représentatif lorsque la table est volumineuse. Un échantillon ne remplacera pas une validation complète, mais il vous aide à inspecter les formats et les valeurs commerciales sans imposer immédiatement un balayage massif. Exécutez des agrégations ciblées sur l'ensemble de la table lorsque le moteur de l'entrepôt et le partitionnement rendent ces vérifications pratiques.
Établir une référence de défauts
Pour les colonnes acceptant les valeurs nulles, comptez directement les valeurs manquantes plutôt que de vous fier à un échantillon visuel :
Le taux de valeurs nulles est utile car il rend le défaut mesurable et comparable entre les exécutions de pipeline. Vous pouvez également regrouper les absences par système source, partition ou date d'intégration pour distinguer une caractéristique de données de longue date d'une rupture récente.
Les vérifications de valeurs distinctes révèlent des catégories inattendues :
Recherchez les variantes d'orthographe, les casses incohérentes, les chaînes vides et les valeurs qui violent le vocabulaire métier. Une colonne qui semble contenir un petit ensemble de statuts peut contenir plusieurs représentations du même état.
Trouver les doublons sans toucher à la production
La détection exacte des doublons commence par le regroupement des colonnes qui définissent l'enregistrement :
Cette requête vous indique où se trouvent les doublons, mais elle ne vous dit pas quel enregistrement doit être conservé. Capturez les enregistrements suspects dans une table intermédiaire distincte et incluez les métadonnées d'intégration, la priorité de la source, l'horodatage de mise à jour et une clé de substitution stable lorsqu'elle est disponible.
La syntaxe exacte varie selon l'entrepôt, mais le principe de fonctionnement reste le même : ne faites jamais d'expérimentations directement sur la relation de production lorsque vous pouvez d'abord isoler les candidats. Les guides pratiques de nettoyage SQL recommandent également de valider les transformations sur de petits sous-ensembles avant de les appliquer à grande échelle, ce qui réduit la portée d'un prédicat incorrect. Les techniques de profilage des données utilisées dans le nettoyage d'entrepôt complètent cette approche en rendant la phase d'inspection explicite plutôt qu'en la traitant comme une préparation facultative.
Mesurez d'abord, réparez ensuite. Si vous ne pouvez pas indiquer combien de lignes sont affectées, vous ne pouvez pas examiner la modification en toute sécurité.
Gérer les valeurs nulles et supprimer les doublons à l'échelle
La gestion des valeurs nulles est une décision commerciale déguisée en expression SQL. Remplacer chaque valeur manquante par une valeur par défaut peut simplifier les requêtes en aval, mais cela peut également transformer une information « inconnue » en une fausse affirmation. Laissez la valeur d'origine disponible lorsque la distinction est importante.
COALESCE convient lorsqu'une valeur de repli a un sens clair :
Ce modèle est plus sûr pour la présentation que pour un stockage irréversible. Si l'absence d'une devise signifie que la source n'a pas fourni les informations requises, un indicateur de validation est plus honnête :
NULLIF aide à convertir les espaces réservés connus en véritables valeurs nulles avant le profilage :
Vous pouvez également utiliser une logique conditionnelle lorsque le remplacement correct dépend d'une règle documentée. Ne déduisez pas un attribut client à partir d'un champ non lié simplement parce que la requête nécessite une valeur non nulle.
Dédupliquer avec une règle de survie explicite
ROW_NUMBER() est le modèle durable pour identifier un seul survivant au sein de chaque groupe de doublons :
La clause ORDER BY est la partie importante. « Conserver le plus récent » ne fonctionne que si l'horodatage est fiable et que les égalités disposent d'un repli déterministe. Si les enregistrements diffèrent en termes de complétude, classez-les selon une règle de complétude documentée plutôt que de supposer que la dernière ligne arrivée est la meilleure.
Pour les tables à l'échelle de l'entrepôt, matérialisez le résultat classé dans une nouvelle relation ou une partition de remplacement lorsque cela est possible. Reconstruire une partition propre peut être plus sûr que d'effectuer une suppression massive ligne par ligne, en particulier lorsque la table est clusterisée ou partitionnée. Conservez les lignes rejetées dans une table d'audit si les doublons nécessitent une correction dans le système source.
Savoir comment l'unicité traite les valeurs nulles
SQL Server a un comportement particulièrement important : une contrainte UNIQUE autorise NULL, mais seulement une seule valeur NULL par colonne contrainte est autorisée, comme documenté dans la référence des contraintes uniques et de vérification de Microsoft. Ce comportement peut surprendre les équipes qui nettoient des champs facultatifs, car la gestion des valeurs nulles influe sur l'acceptation ou le rejet des enregistrements ultérieurs.
Utilisez des Data Validation de complétude pour séparer ce qui est « manquant mais autorisé » de ce qui est « manquant et invalide ». Ne supprimez les doublons que lorsque la règle d'identité est sans ambiguïté. Sinon, marquez le groupe pour examen et conservez les preuves nécessaires pour expliquer pourquoi un enregistrement spécifique a été sélectionné.
Standardiser les formats de texte et corriger les types de données
Les incohérences textuelles survivent souvent aux tests de base car elles semblent correctes pour un humain. Un espace de fin dans une clé de jointure, une casse différente dans un statut ou un caractère Unicode ressemblant à un caractère ASCII peuvent produire des jointures sans correspondance et des agrégations fragmentées.
Normalisez d'abord les valeurs dans une projection contrôlée :
TRIM supprime les espaces blancs environnants, tandis que UPPER et LOWER établissent une forme de comparaison cohérente. REPLACE peut supprimer des caractères de formatage connus, mais les remplacements larges sont risqués lorsque la ponctuation a une signification. Les expressions régulières sont utiles pour la validation de motifs et les corrections ciblées là où l'entrepôt les prend en charge, mais elles doivent être testées par rapport à des variantes réelles des sources plutôt qu'appliquées comme un nettoyeur universel.
Rendre les conversions explicites
Les conversions implicites sont pratiques lors de l'exploration et dangereuses en production. Une valeur textuelle peut se convertir différemment selon le moteur, les paramètres de session, la langue ou le type cible. Les instructions explicites CAST ou CONVERT rendent la représentation voulue visible :
Avant de convertir, profilez les valeurs qui ne respectent pas le format attendu. Une conversion ayant échoué doit être capturée comme une exception de qualité, et non rejetée. Vérifiez également la précision et l'échelle, car un type numérique cible peut perdre des détails significatifs s'il est plus étroit que la source.
Les données temporelles nécessitent encore plus d'attention. Un horodatage sans fuseau horaire peut se décaler lorsque les systèmes l'interprètent avec des paramètres de session différents. Standardisez la convention source, convertissez avec une politique de fuseau horaire explicite et conservez la valeur brute d'origine jusqu'à ce que le résultat passe la validation.
Standardiser avant la déduplication
L'ordre est important. Une séquence de nettoyage pratique consiste à inspecter les valeurs nulles, les doublons et les formats inhabituels, puis à standardiser le texte, corriger les types et dédupliquer une fois que les valeurs équivalentes ont été ramenées à une forme commune. Cet ordre est décrit dans les conseils de nettoyage de données SQL sur l'inspection et la standardisation.
Si vous dédupliquez avant de nettoyer et de normaliser, des enregistrements tels que ACME et ACME restent séparés bien que l'entreprise les traite comme une seule clé. Si vous ajoutez des contraintes avant la conversion de type, la base de données risque de rejeter des enregistrements entrants valides ou de conserver une représentation inadaptée. Séparez bien les colonnes brutes, normalisées et validées pendant le développement afin que les réviseurs puissent comparer chaque transformation.
Verrouiller la qualité avec des contraintes et des règles de validation
Un script de nettoyage corrige le lot actuel. Une contrainte protège le lot suivant. Utilisez des barrières de sécurité de base de données lorsque la règle est stable, locale à l'enregistrement et suffisamment importante pour rejeter les données invalides lors de l'intégration.
Contrainte | Portée | Meilleur cas d'utilisation |
|---|---|---|
| Présence de colonne | Identifiants, dates et clés requis |
| Colonne unique ou combinaison | Contrôle d'identité et prévention des doublons |
| Règle booléenne au niveau de la ligne | Plages autorisées, statuts et ordre des dates |
NOT NULL est simple, mais elle doit refléter une exigence réelle. L'appliquer à un attribut optionnel crée des frictions opérationnelles sans améliorer l'exactitude. UNIQUE fonctionne bien pour les identifiants naturels ou les clés commerciales composites, à condition d'avoir défini le comportement attendu pour les valeurs nulles et les mises à jour tardives.
Les contraintes CHECK expriment des règles telles que :
Les expressions ANSI SQL CHECK peuvent s'évaluer à TRUE, FALSE ou UNKNOWN, et elles sont limitées à l'intégrité du domaine. Elles peuvent valider les valeurs d'une ligne, mais elles ne peuvent pas inspecter d'autres lignes pour vérifier la cohérence entre elles, comme l'explique cette référence de migration des contraintes SQL. Un CHECK peut rejeter un montant négatif ou un ordre de date invalide. Il ne peut pas confirmer qu'un total de compte correspond à celui d'une table distincte.
Choisir le rejet strict ou la mise en quarantaine souple
Les contraintes strictes conviennent lorsque l'acceptation d'une mauvaise ligne corromprait une table critique et que la source peut corriger les erreurs rapidement. Elles sont moins adaptées lorsque les systèmes en amont envoient régulièrement des enregistrements partiels qui nécessitent une investigation avant d'être finalisés.
Un modèle souple stocke l'enregistrement tout en ajoutant des colonnes de validation telles que is_valid, failure_reason ou rule_name. Les modèles en aval peuvent exclure les lignes ayant échoué, tandis que les équipes opérationnelles conservent une visibilité sur le défaut de la source. Cette approche demande plus d'efforts de conception, mais elle évite de transformer un problème source temporaire en un échec de chargement sans aucun contexte de diagnostic.
Les règles de validation des données SQL et les conseils de qualité continue fournissent un cadre utile pour séparer les valeurs requises, les formats, la complétude, l'unicité et l'intégrité référentielle. En pratique, combinez les contraintes avec une validation intermédiaire. Les contraintes constituent le dernier filtre, et non un substitut au profilage, à la classification des erreurs ou à une piste d'audit.
Aller au-delà des scripts ponctuels vers une surveillance continue
Le nettoyage SQL est réactif. Il répare les enregistrements après qu'un défaut a pénétré dans le pipeline, tandis que la surveillance continue recherche les conditions qui indiquent une régression.
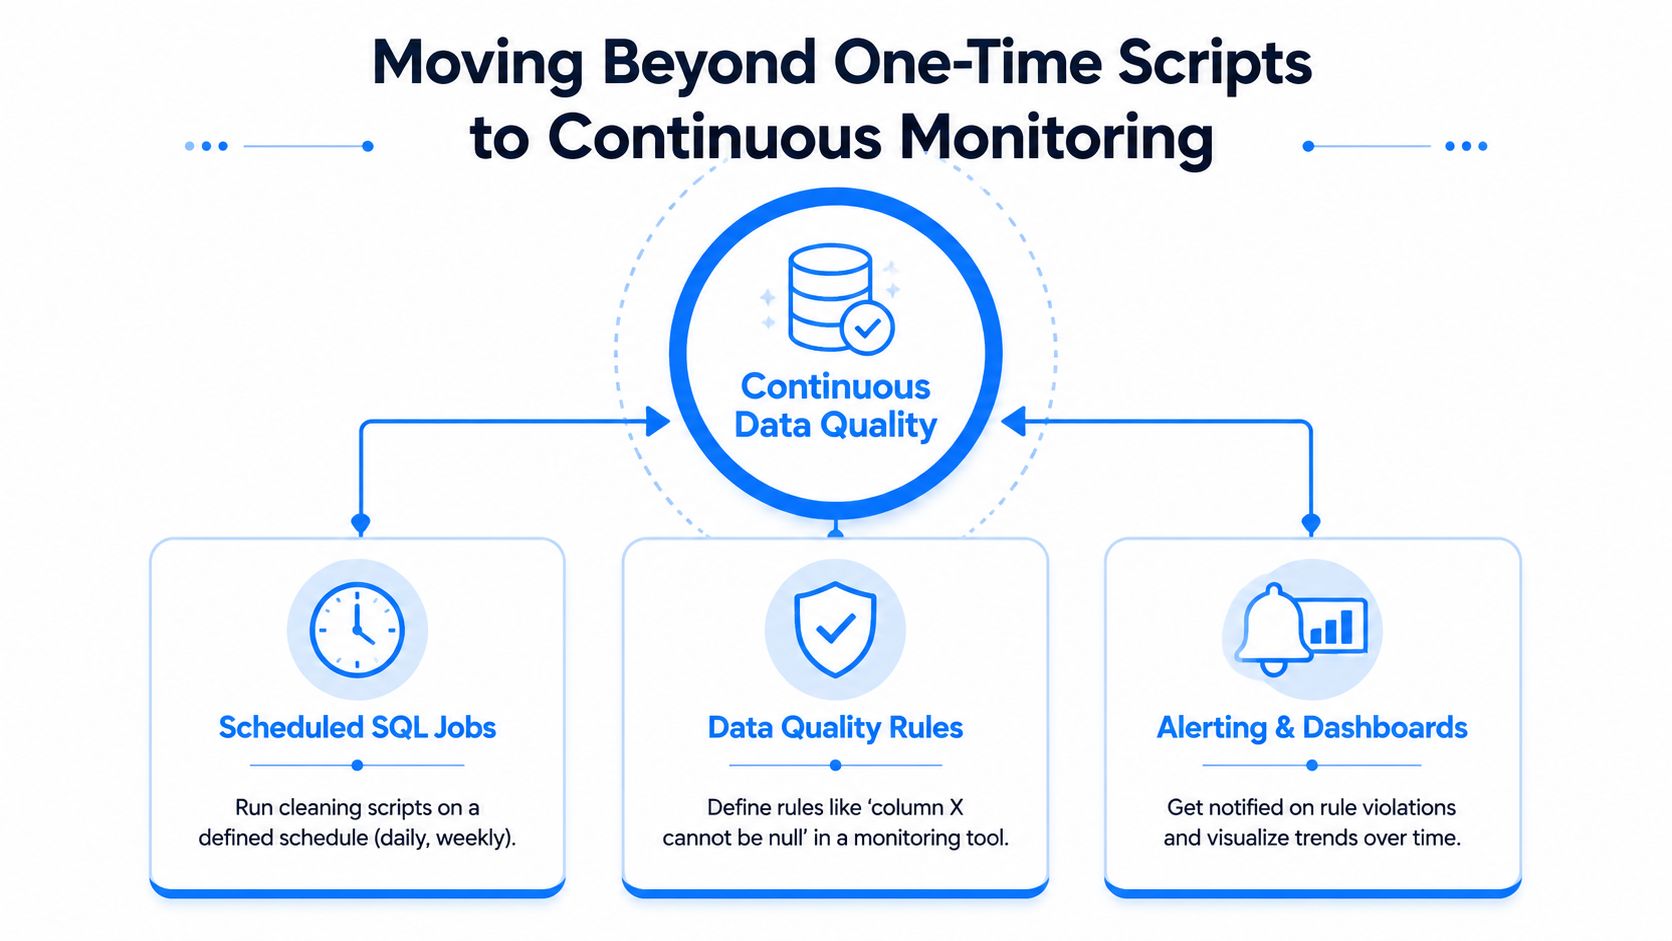
Un flux de travail mature superpose plusieurs signaux sur l'ensemble de données nettoyé :
Tâches SQL planifiées : Exécuter des transformations déterministes selon un calendrier défini et enregistrer le nombre de lignes affectées.
Règles de qualité : Vérifier les valeurs requises, les formats valides, l'unicité, l'intégrité référentielle et les conditions commerciales.
Détection d'anomalies : Comparer les distributions et volumes actuels avec les comportements établis pour faire émerger des changements inhabituels.
Contrôles de Timeliness : Détecter les livraisons manquantes, retardées ou étonnamment précoces.
Suivi des schémas : Identifier les colonnes ajoutées ou supprimées ainsi que les modifications de types de données avant que les requêtes en aval n'échouent.
Le bon investissement dépend du mode de défaillance. Écrivez un script SQL lorsque la règle est déterministe, que la transformation est répétable et que l'ensemble de données concerné est clairement délimité. Ajoutez de l'Observability automatisée lorsque les défauts se répètent, que le comportement de la source change, que le moment de la livraison est important ou qu'une défaillance de tableau de bord serait découverte trop tard par une révision manuelle.
Les plateformes comme digna exécutent des contrôles de qualité et d'anomalies directement dans l'environnement de base de données du client, permettant aux équipes de surveiller le comportement des données sans déplacer les enregistrements de production vers une couche de traitement externe. Ses capacités de surveillance de la qualité des données comblent le vide entre le nettoyage planifié et la détection continue en combinant validation, anomalies, Timeliness et surveillance structurelle.
Utilisez digna pour exécuter des validations en base de données, des détections d'anomalies, des contrôles de Timeliness et un suivi des schémas sur les ensembles de données dont dépendent vos pipelines SQL. Visitez digna pour voir comment la surveillance continue peut transformer une logique de nettoyage ponctuelle en un système opérationnel de qualité des données.


