Gestion des risques liés à la qualité des données : un guide pratique
|
8
minute de lecture
Un tableau de bord est obsolète, mais le pipeline est au vert. Un modèle produit des résultats inhabituels, pourtant aucun déploiement n'a été modifié. Un rapport réglementaire contient des totaux incohérents, et l'investigation commence par une recherche frénétique dans les journaux d'ingestion, le code de transformation et les feuilles de calcul. Dans chaque cas, la défaillance visible apparaît à la fin du processus, alors que le problème de qualité sous-jacent peut s'être introduit bien plus tôt.
Ce schéma est familier aux ingénieurs de données car le travail traditionnel sur la qualité des données commence souvent après que quelqu'un a constaté des dommages commerciaux. Les équipes corrigent les enregistrements, mettent à jour une règle, relancent une tâche et passent à autre chose. La même faiblesse réapparaît lorsqu'une source en amont modifie son schéma, qu'une livraison arrive en retard ou qu'une métrique s'écarte de son comportement normal.
La gestion des risques liés à la qualité des données traite ces événements comme des défaillances de contrôle, et non comme des tickets de nettoyage isolés. L'objectif pratique est de détecter les comportements anormaux, de valider les enregistrements critiques, de suivre les attentes en matière de livraison et d'orienter les incidents avant qu'ils n'affectent les décisions, la conformité ou les systèmes orientés client. Cela est crucial à l'échelle de l'entreprise, car l'estimation largement citée d'IBM évaluait le coût annuel d'une mauvaise qualité des données aux États-Unis à environ 3,1 billions de dollars en 2016 (Discussion de la communauté SAP sur l'estimation d'IBM).
Table des matières
Pourquoi la gestion des risques liés à la qualité des données est cruciale aujourd'hui
Le coût du nettoyage réactif
Comprendre les dimensions du risque lié à la qualité des données
Associer les dimensions aux modes de défaillance
Prioriser selon les conséquences
Construire un registre des risques liés à la qualité des données
Utiliser des champs opérationnels
Exemples d'entrées de registre des risques liés à la qualité des données
Stratégies de surveillance pour détecter les risques rapidement
Détection d'anomalies
Surveillance de la Timeliness
Surveillance des changements de schéma
Conception des contrôles et des flux d'escalade
Placer la validation au plus près des données
Acheminer les alertes selon l'impact
Valider les hypothèses statistiques
Mesurer l'efficacité du programme et itérer
Mesurer la qualité du signal, pas le volume d'alertes
Examiner le registre comme un artefact de contrôle
Démarrer avec votre programme de risques liés à la qualité des données
Se développer par incréments contrôlés
Pourquoi la gestion des risques liés à la qualité des données est cruciale aujourd'hui
Une équipe de données peut disposer d'une orchestration fiable, de statuts de tâches réussis et de tests unitaires approfondis tout en fournissant des données inutilisables. Une source peut envoyer un fichier valide avec une population d'affaires incomplète. Une table peut se charger avec succès avec une colonne renommée. Un rapport peut se rafraîchir à l'heure prévue en utilisant des enregistrements qui ne correspondent plus aux hypothèses qui sous-tendent ses calculs.
Le symptôme en production détermine généralement qui est alerté. Les analystes voient un tableau de bord obsolète. Les équipes de conformité constatent une incohérence. Les data scientists s'interrogent sur les résultats d'un modèle. Les ingénieurs retracent ensuite le problème à travers des systèmes qui ont tous signalé un succès. Cette investigation est coûteuse car la santé technique d'un pipeline et l'adéquation de ses données à l'usage sont deux questions de contrôle différentes.
Le coût du nettoyage réactif
La maintenance manuelle des règles fonctionne tant que le nombre de sources, de tables et de cas d'utilisation reste gérable. Elle échoue lorsque les équipes doivent coder manuellement chaque valeur attendue, modèle de livraison et variation structurelle. Les audits périodiques présentent une limite similaire. Ils permettent d'identifier les défauts historiques, mais ne détecteront pas de manière fiable une défaillance silencieuse entre deux cycles d'examen.
Un programme continu observe le comportement plutôt que d'attendre une plainte. Il compare le volume et les distributions actuels aux bases établies, évalue si les données sont arrivées au moment où les utilisateurs en avaient besoin, et identifie les changements structurels avant que la logique en aval ne défaille. La validation au niveau de l'enregistrement ajoute une couche distincte pour les règles d'affaires que la surveillance globale ne peut pas détecter.
Règle opérationnelle : Un statut de pipeline vert prouve seulement que le flux de travail s'est terminé. Il ne prouve pas que les données résultantes sont exactes, opportunes, cohérentes ou adaptées à une prise de décision.
Le changement est également organisationnel. La qualité des données devient une discipline de risque partagée, avec des propriétaires, des niveaux de gravité, des voies de réponse et des preuves. Un aperçu utile de la valeur commerciale de cette approche est disponible dans l'explication de digna sur les avantages de la qualité des données, mais la question de la mise en œuvre reste opérationnelle : quelles défaillances importent le plus, comment l'équipe va-t-elle les détecter, et que se passe-t-il après une alerte ?
Les équipes devraient commencer par les produits de données qui influencent les rapports réglementaires, les décisions financières, les opérations clients ou l'apprentissage automatique. Elles n'ont pas besoin de tout surveiller immédiatement. Elles ont besoin de contrôles aux points où un défaut non détecté modifierait un résultat.
Comprendre les dimensions du risque lié à la qualité des données
Un pipeline peut se terminer avec succès alors que sa sortie reste dangereuse. Une table numériquement exacte qui arrive après une date limite de rapport est opérationnellement inutilisable. Une table complète présentant des définitions contradictoires d'un système à l'autre peut produire une vision d'entreprise trompeuse. Un jeu de données récent présentant un changement de type inattendu peut perturber les utilisateurs en aval sans modifier aucune valeur.
Le risque lié à la qualité a donc besoin de dimensions qui correspondent à des modes de défaillance observables. La norme ISO 8000-61:2016 définit les processus de gestion de la qualité des données, tandis que le cadre d'évaluation de la qualité des données du FMI organise la qualité autour de l'intégrité, de la solidité méthodologique, de l'exactitude et de la fiabilité, de la commodité d'emploi et de l'accessibilité (référence ISO 8000-61, Cadre d'évaluation de la qualité des données du FMI). Ces références soutiennent une évaluation récurrente plutôt qu'un nettoyage ponctuel. Les équipes peuvent également consulter ce guide pratique sur les dimensions de la qualité des données lors de la définition de leur vocabulaire de contrôle.
Associer les dimensions aux modes de défaillance
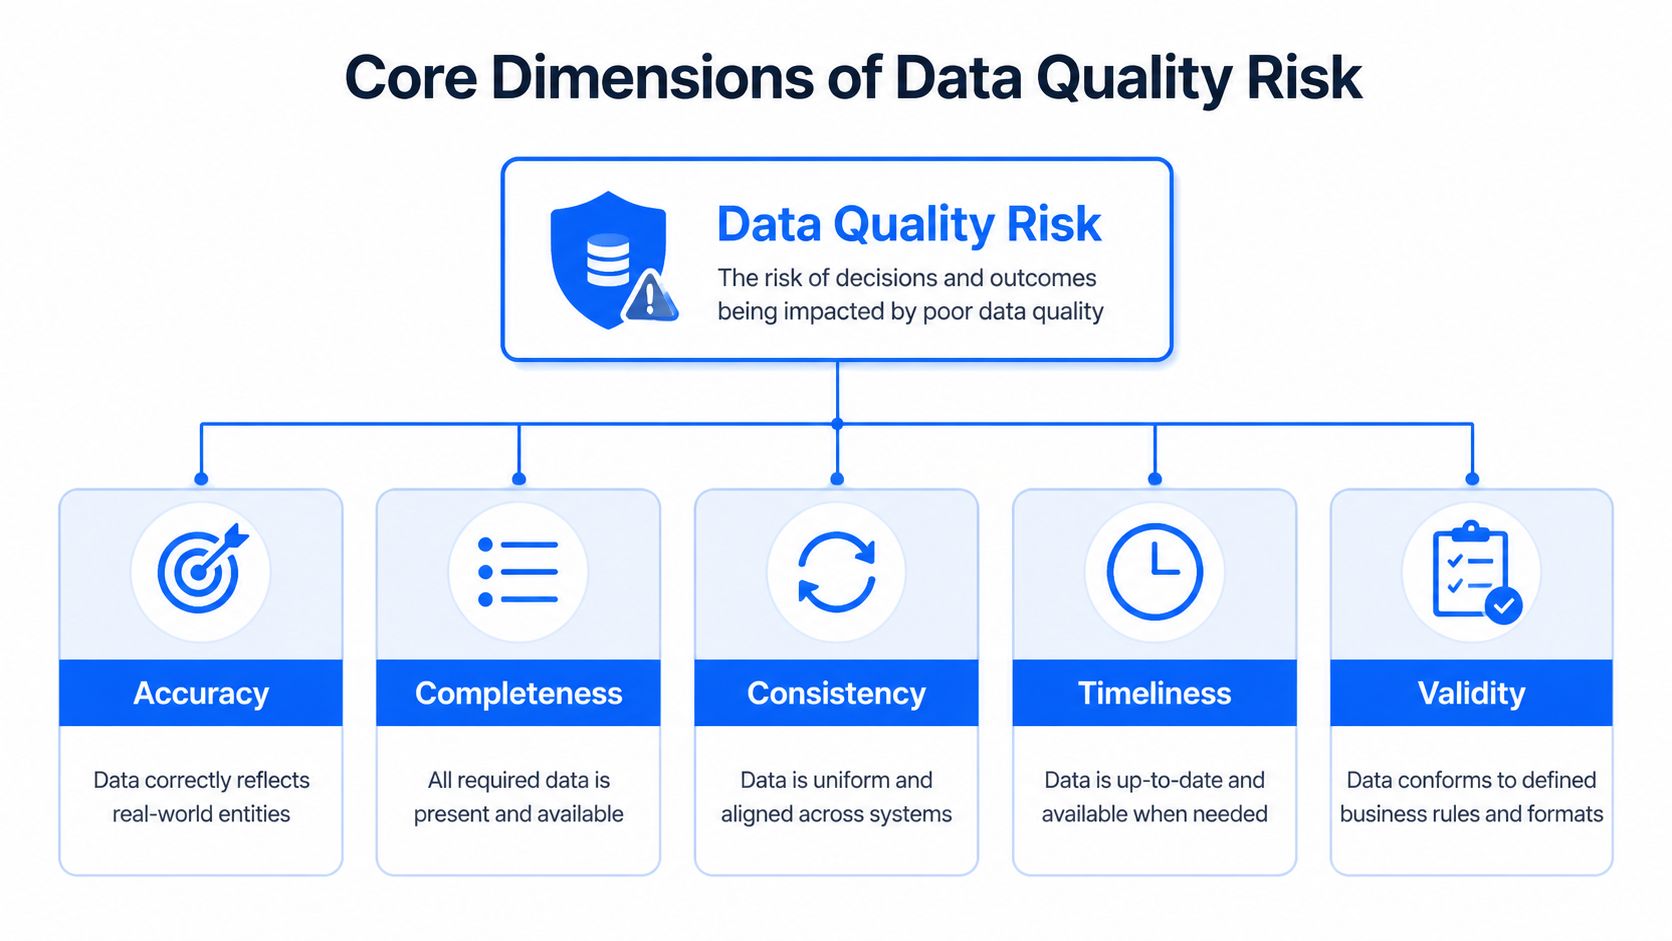
L'exactitude se demande si les enregistrements représentent fidèlement le monde ou les événements qu'ils décrivent. Un statut de compte, un montant ou un identifiant client incorrect peut fausser une décision même lorsque chaque ligne attendue est présente.
La complétude couvre les enregistrements et les champs requis. L'absence d'attributs facultatifs peut être tolérable, tandis que l'absence d'identifiants ou de champs réglementaires peut bloquer un processus.
La cohérence, appelée cohérence dans certains guides statistiques, vérifie si les définitions et les valeurs concordent d'un système à l'autre. Des représentations différentes du même client, produit ou transaction créent un travail de réconciliation et peuvent nuire aux rapports.
La Timeliness mesure si les données sont disponibles lorsque l'utilisateur en a besoin. Un ensemble de données de planification quotidienne et un flux de risques opérationnels ont des attentes de livraison différentes, de sorte que la surveillance doit utiliser des seuils spécifiques au produit.
La validité vérifie les formats, les domaines, les relations et les règles d'affaires. Une valeur peut avoir le type de données correct et tout de même violer un statut ou une relation autorisée.
Prioriser selon les conséquences
Surveiller chaque colonne de la même manière gaspille les efforts d'ingénierie et produit du bruit d'alerte. Classez les produits de données par criticité, identifiez les dimensions qui pourraient modifier une décision et connectez chaque risque à un contrôle. Utilisez la détection d'anomalies pour les changements inattendus de volume ou de distribution, les vérifications de Timeliness pour les chargements tardifs ou manquants, et le suivi de schéma pour les changements structurels avant que les utilisateurs ne rencontrent des défaillances. Le guide du FMI reconnaît également la pertinence, l'exactitude, la Timeliness, la cohérence, l'interprétabilité et l'accessibilité, de sorte que l'exactitude ne doit pas devenir la seule dimension surveillée.
Une évaluation pratique pose trois questions :
Qu'est-ce qui pourrait changer ? Identifiez la décision, le rapport, le modèle ou le processus affecté.
Comment la défaillance apparaîtrait-elle ? Définissez le signal, tel qu'un chargement manquant, un décalage de distribution, un enregistrement invalide ou une modification de schéma.
Quelle réponse est proportionnée ? Choisissez un blocage, un avertissement, un ticket ou un examen des tendances en fonction de l'impact et de la confiance.
Cette cartographie évite aux équipes de surveiller ce qui est simplement facile à mesurer. Une dimension de qualité devient opérationnellement utile lorsqu'elle est connectée à un utilisateur désigné, à un signal observable et à une réponse définie.
Construire un registre des risques liés à la qualité des données
Un registre des risques devrait aider un ingénieur à décider quoi vérifier à deux heures du matin. Des entrées larges telles que « les données clients peuvent être inexactes » n'offrent aucune action claire, exigence de preuve ou chemin d'escalade.
Commencez par les actifs de données qui soutiennent les décisions, les rapports, les modèles ou les flux de travail opérationnels. Pour chaque actif, enregistrez son propriétaire, ses utilisateurs, ses attentes de livraison, ses champs sensibles, ses dépendances en amont et ses modes de défaillance connus. Décrivez ensuite chaque risque sous forme de cause, d'événement et de conséquence. « Une équipe en amont supprime un champ requis, ce qui conduit le pipeline d'éligibilité client à produire des décisions incomplètes » donne aux intervenants beaucoup plus de direction que simplement « dérive de schéma ».
Utiliser des champs opérationnels
Chaque entrée nécessite suffisamment de détails pour hiérarchiser le travail et soutenir une réponse :
Description du risque : Indiquez la défaillance et sa conséquence commerciale.
Gravité : Décrivez l'impact si l'événement atteint un utilisateur. Utilisez critique, élevé, moyen ou faible, avec des définitions convenues en interne.
Probabilité : Fondez-la sur l'historique observé, le comportement de la source, la fréquence des changements et la complexité du processus plutôt que sur l'intuition.
Propriétaire : Désignez la personne ou l'équipe capable d'enquêter et de coordonner la remédiation.
Atténuation : Nommez la vérification, la barrière, la solution de repli, la réconciliation ou l'action d'escalade.
Preuve : Stockez l'historique des alertes, les résultats de validation, le lignage et les notes de résolution.
Statut d'examen : Enregistrez si le contrôle est actif, bruyant, manquant ou en cours de réévaluation.
Le registre doit distinguer un problème de source d'un problème de détection. Si une livraison est tardive, l'équipe source peut être propriétaire de la remédiation tandis que l'équipe de la plateforme est propriétaire de la surveillance de la Timeliness. Cette division maintient une responsabilité précise et évite qu'une alerte ne devienne un substitut à un correctif.
Pour les champs de haute priorité, un catalogue d'éléments de données critiques peut aider les équipes à concentrer les contrôles sur les enregistrements et les attributs les plus susceptibles d'affecter les décisions.
Exemples d'entrées de registre des risques liés à la qualité des données
Description du risque | Gravité | Probabilité | Propriétaire | Stratégie d'atténuation |
|---|---|---|---|---|
Une colonne requise en amont est supprimée ou renommée, brisant les transformations en aval | Élevé | Moyen | Équipe plateforme de données | Suivre les modifications de schéma, tester la compatibilité et arrêter les tâches dépendantes lorsque la modification viole le contrat |
Un pipeline critique arrive après la fenêtre de rapport de son utilisateur | Élevé | Moyen | Propriétaire du système source | Surveiller les modèles d'arrivée, calculer l'heure de livraison estimée et escalader les chargements manqués |
Une règle d'affaires diffère entre les systèmes opérationnels et analytiques | Élevé | Moyen | Propriétaire du domaine de données | Exécuter des validations au niveau de l'enregistrement et réconcilier les résultats d'un système à l'autre |
La fraîcheur diminue sans défaillance de tâche | Moyen | Moyen | Équipe d'ingénierie analytique | Surveiller la livraison et mettre à jour les seuils lorsque le comportement de la source change |
Des champs optionnels deviennent inopinément nuls sur l'ensemble d'une population source | Moyen | Faible | Data steward | Suivre les distributions, enquêter sur le changement de source et documenter les exceptions acceptées |
Traitez le registre comme un dossier de contrôle vivant, et non comme un document de governance ponctuel. Examinez-le lorsqu'une source, une méthode d'intégration, un modèle ou un processus d'affaires change. Les produits de données intégrés peuvent introduire des risques par le biais de la liaison, de l'harmonisation ou de la modélisation, et pas seulement par la source d'origine. Un schéma modifié, un chargement tardif ou un décalage de distribution devrait mettre à jour l'entrée de risque correspondante, ses preuves ou son propriétaire.
Le registre gagne sa place lorsqu'il pilote la configuration de la surveillance, les discussions sur la propriété et les examens d'incidents. Il doit montrer quels risques disposent de contrôles actifs, quelles alertes créent du bruit et quelles lacunes nécessitent encore des travaux d'ingénierie. Cette connexion permet à l'équipe de passer de la gestion de crise réactive à un contrôle continu.
Stratégies de surveillance pour détecter les risques rapidement
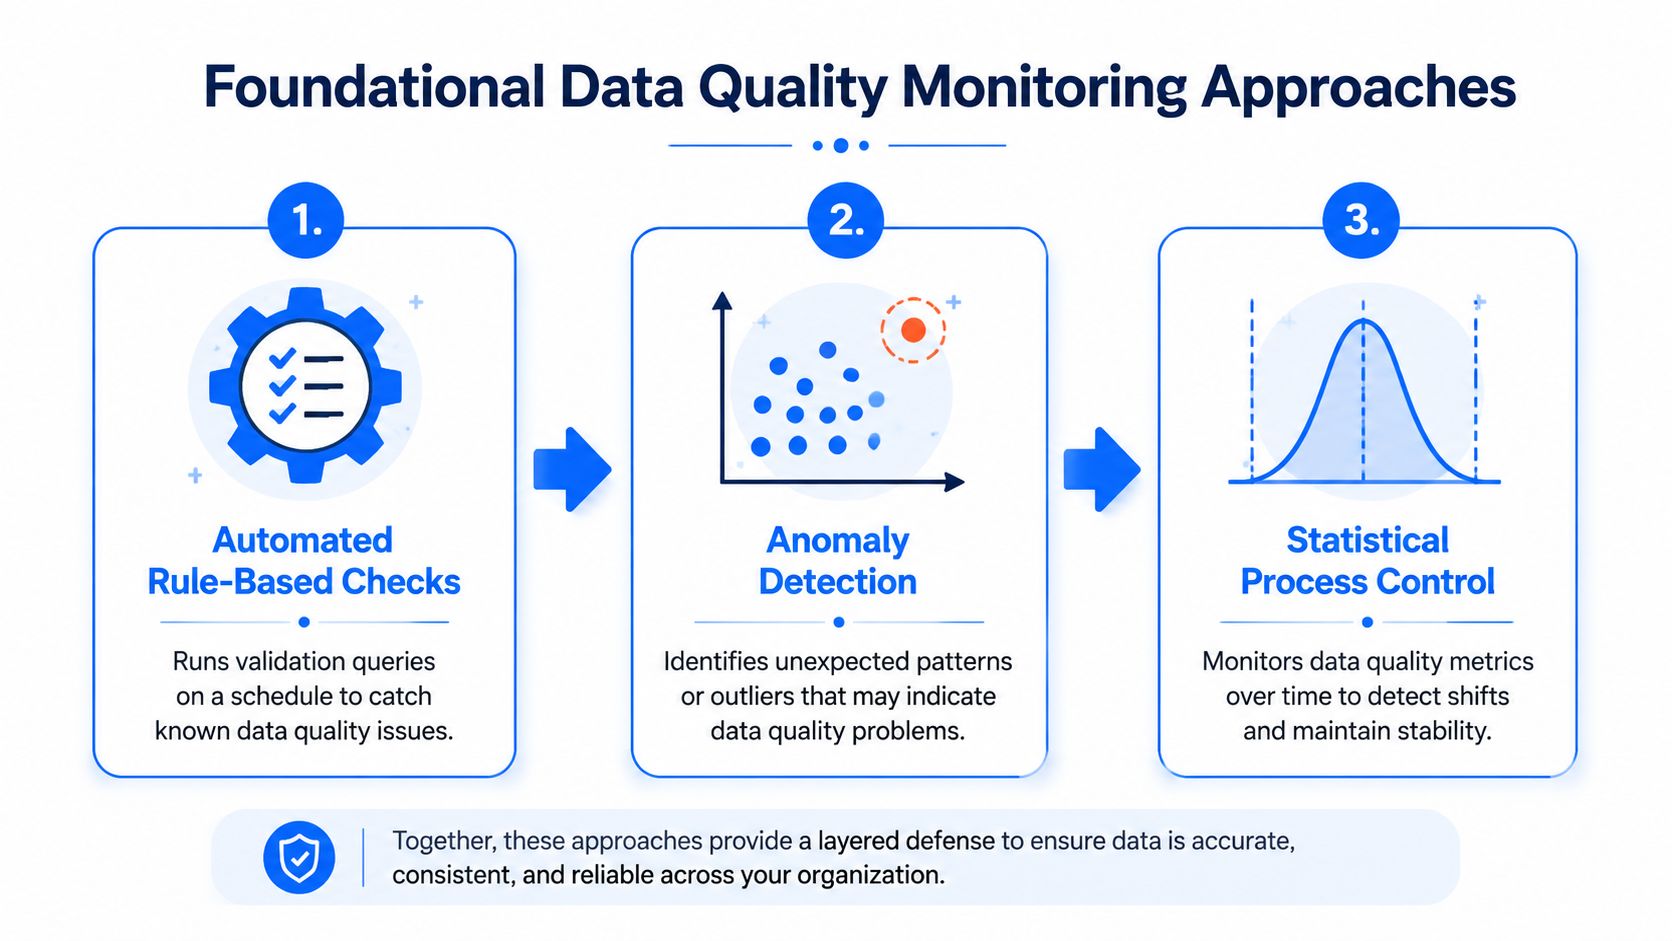
Un pipeline peut être vert alors que les utilisateurs reçoivent des données inutilisables. La surveillance de la production nécessite plusieurs couches : des règles déterministes pour les violations connues, la détection d'anomalies pour les comportements inhabituels, des vérifications de Timeliness pour le risque de livraison, et le suivi de schéma pour les contrats structurels.
Détection d'anomalies
L'apprentissage de référence est utile lorsque les ingénieurs ne peuvent pas écrire une règle pour chaque modèle valide. Les moniteurs peuvent examiner le volume, le comportement des valeurs nulles, les distributions et les métriques d'affaires, puis signaler les écarts importants par rapport au comportement établi du jeu de données.
Une valeur inhabituelle ne constitue pas automatiquement un incident. La saisonnalité, les releases planifiées, les acquisitions et des événements d'affaires légitimes peuvent modifier une référence. Séparez les métriques techniques des métriques d'affaires, associez un contexte opérationnel aux alertes et laissez les propriétaires qualifier les événements d'attendus ou d'inattendus. Ces décisions améliorent les investigations ultérieures sans transformer chaque exception en une règle manuelle permanente.
Surveillance de la Timeliness
Un chargement peut réussir tout en arrivant trop tard pour les utilisateurs. Suivez le modèle d'arrivée de chaque jeu de données critique, y compris les livraisons manquantes, tardives ou exceptionnellement précoces. Calculez une fenêtre de livraison estimée à partir du comportement observé, puis configurez la réponse en fonction de la date limite de l'utilisateur.
Un flux tardif peut justifier un avertissement lorsqu'un tableau de bord en aval dispose d'une solution de repli. Ce même retard peut nécessiter une escalade lorsqu'il affecte une soumission réglementaire ou un calcul de risque. Les messages d'alerte doivent inclure la dernière arrivée réussie, la fenêtre attendue, les produits affectés et le propriétaire qui peut confirmer le statut de la source.
Les équipes qui formalisent la conception des notifications peuvent utiliser ce guide d'alerte en temps réel pour structurer les alertes autour du bon intervenant et réduire le bruit évitable.
Surveillance des changements de schéma
La dérive de schéma crée des incidents déroutants car une source peut rester disponible alors que les utilisateurs interprètent mal ses données de sortie. Suivez les colonnes ajoutées et supprimées, les champs renommés, les modifications de type de données et les changements qui violent un contrat documenté.
Un ajout compatible peut nécessiter un examen sans imposer d'interruption. La suppression d'un champ requis ou la modification d'un type devrait généralement suspendre les traitements dépendants jusqu'à ce que le propriétaire confirme l'impact. Stockez le schéma avant et après avec l'alerte pour éviter aux ingénieurs d'avoir à reconstituer le changement à partir des journaux de déploiement.
Ces signaux sont particulièrement utiles dans une vue opérationnelle unique. Une approche de surveillance et de reporting des données doit présenter ensemble l'anomalie, l'historique des livraisons, l'événement de schéma, l'actif affecté et le statut actuel de l'incident. L'outil importe moins que la préservation du contexte, de la détection jusqu'à la résolution, afin que les équipes puissent remplacer la gestion réactive par un contrôle continu.
Conception des contrôles et des flux d'escalade
Une alerte ne devient un contrôle qu'une fois que l'équipe a défini la réponse, le traitement des données, le propriétaire responsable et les preuves requises pour la clôture. Sans ces décisions, la surveillance produit des notifications mais ne limite pas l'exposition en aval.
Utilisez des contrôles stricts lorsque des données non valides ne doivent pas se propager. Un pipeline peut rejeter un enregistrement présentant une relation impossible, suspendre une publication en aval lorsqu'un champ de schéma requis disparaît, ou mettre en quarantaine un lot qui viole un contrat critique. Utilisez des contrôles souples pour les activités inhabituelles mais potentiellement légitimes, telles qu'un changement inattendu du volume d'affaires qui nécessite un examen humain plutôt qu'un blocage automatique.

Placer la validation au plus près des données
Les vérifications au niveau de l'enregistrement appliquent des règles que les métriques globales ne peuvent pas prouver. Validez les champs requis, les valeurs autorisées, les relations entre entités, les dates d'effet, les conditions de doublons et les exigences réglementaires ou contractuelles. Exécutez ces vérifications dans la base de données lorsque cela est possible. Maintenir le calcul près des données réduit les transferts, respecte les limites de sécurité et évite de charger des tables volumineuses dans la mémoire de l'application.
Un modèle d'ingénierie pratique combine un framework standardisé pour les attentes de schéma avec du SQL direct pour les vérifications majeures des règles d'affaires. SecurityScorecard décrit l'utilisation de Great Expectations pour la validation de schéma, DataHub pour la visibilité centralisée et Apache Airflow pour l'orchestration. Son équipe a placé les vérifications de règles d'affaires dans du SQL côté base de données plutôt que de charger de très grandes tables dans Python (compte rendu de validation de pipeline).
Principe de conception des contrôles : Arrêtez le pipeline lorsque le préjudice commercial attendu de la propagation dépasse le coût opérationnel de son blocage.
Acheminer les alertes selon l'impact
Un chemin d'escalade efficace enregistre quatre décisions :
Problème détecté : Capturez la vérification exacte, la valeur observée, le comportement attendu, l'horodatage et l'actif affecté.
Alerte de l'équipe : Informez le propriétaire capable d'enquêter, plutôt qu'un canal large sans intervenant responsable.
Analyse d'impact : Identifiez les rapports, modèles, utilisateurs en aval et processus réglementaires concernés.
Ticket de résolution : Enregistrez le correctif, le traitement des données, la cause racine et les preuves appuyant la clôture.
Alertez l'ingénieur d'astreinte ou le propriétaire des données pour les événements susceptibles de corrompre des produits critiques. Envoyez les écarts à moindre impact vers une file d'attente d'examen. Une urgence égale sur tous les sujets apprend aux intervenants à ignorer le système.
Les équipes qui formalisent la propriété et les chemins de réponse peuvent utiliser ce guide d'aide à l'escalade pour définir les itinéraires et les responsabilités. Une vue partagée des incidents doit conserver les problèmes ouverts, les actifs concernés, l'historique des récurrences et le statut actuel, offrant ainsi aux ingénieurs, analystes et parties prenantes les mêmes preuves opérationnelles.
Valider les hypothèses statistiques
La détection d'anomalies requiert toujours du jugement. Un flux de travail de qualité statistique doit clarifier les objectifs du projet et la conception de l'échantillonnage, examiner les données, sélectionner une méthode appropriée, vérifier ses hypothèses, puis tirer des conclusions (flux de travail de qualité statistique).
Cette séquence limite les faux positifs et les faux négatifs causés par des données mal comprises. Les valeurs aberrantes, les absences non aléatoires, la saisonnalité ou un cadre d'échantillonnage inapproprié peuvent ressembler à des défauts de qualité alors qu'ils reflètent simplement le processus de mesure. Choisissez la méthode valide la plus simple, documentez ses hypothèses et exigez un examen lorsque ces hypothèses ne sont plus vérifiées.
Mesurer l'efficacité du programme et itérer
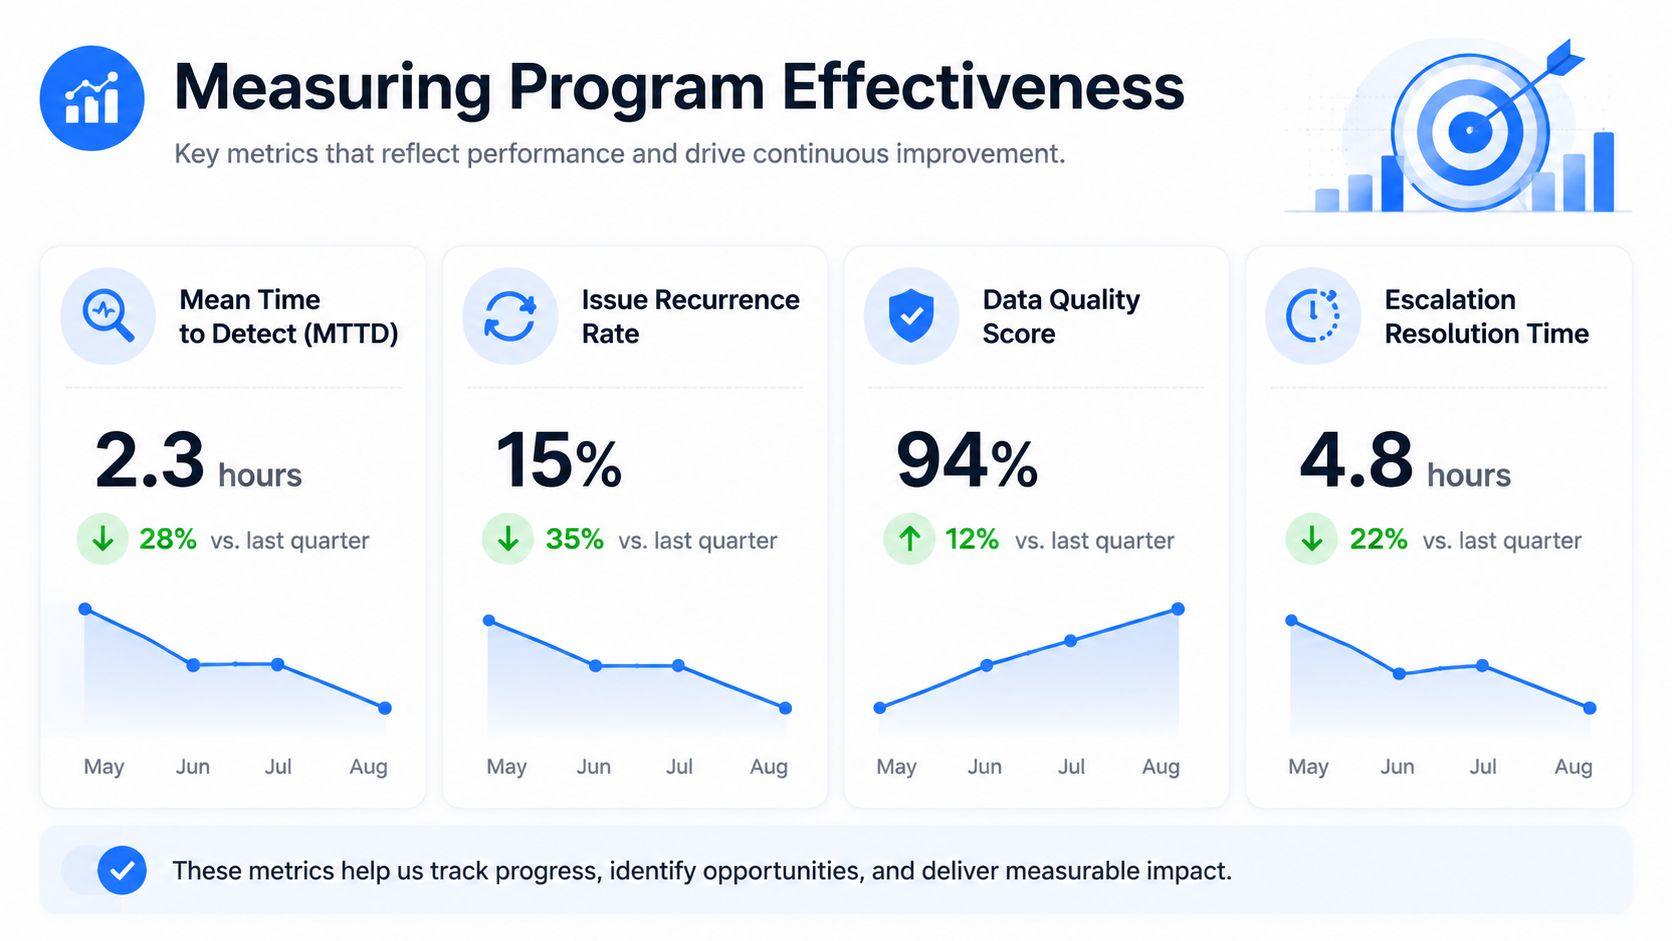
Un programme de qualité prouve sa valeur en production en réduisant l'exposition, en raccourcissant le temps de réponse ou en rendant l'incertitude visible. Un score élevé sur un tableau de bord ne prouve pas grand-chose en soi. Les mesures doivent relier la détection, l'investigation, le comportement de contrôle et l'impact commercial.
Suivez le temps moyen de détection, le temps moyen de résolution, la récurrence, le taux de faux positifs, la couverture des actifs critiques et la part des incidents ayant un propriétaire identifié. Segmentez les résultats par gravité et par produit de données. Sinon, de nombreuses vérifications à faible impact peuvent masquer un flux critique doté de contrôles faibles. Un cadre pratique de métriques de qualité des données peut aider à standardiser ces mesures sur l'ensemble des produits.
Mesurer la qualité du signal, pas le volume d'alertes
Une alerte rapide génère tout de même du travail d'investigation si elle manque de contexte. Vérifiez si chaque notification identifie la table concernée, le comportement modifié, la référence attendue, le propriétaire probable et le chemin de remédiation disponible. Des alertes répétées pour un modèle saisonnier accepté indiquent généralement un problème de seuil ou de référence.
Examinez l'historique des données d'observabilité pour détecter la volatilité, les défaillances récurrentes et les détériorations progressives. Utilisez ces schémas pour ajuster la portée de la surveillance et la force des contrôles. N'élargissez pas les seuils uniquement pour supprimer le bruit. Enregistrez le risque que le seuil plus large accepte, puis vérifiez que le compromis reste raisonnable.
Le problème de la confiance peut persister après le déploiement de l'observabilité. Un rapport BARC de 2025 a révélé que 42 % des organisations ne faisaient toujours pas confiance aux résultats de l'IA/ML, tandis que 58 % avaient mis en œuvre ou optimisé des programmes d'observabilité des données (discussion de l'enquête BARC). La surveillance est donc nécessaire mais insuffisante. Les équipes ont besoin de signaux d'anomalie aux côtés de la surveillance de la Timeliness, du suivi de schéma et de la validation au niveau de l'enregistrement pour expliquer pourquoi un modèle ou un tableau de bord mérite confiance.
Examiner le registre comme un artefact de contrôle
Les revues d'incidents doivent mettre à jour la probabilité, la gravité, la propriété et le statut d'atténuation. Ajoutez un risque lorsqu'une source introduit une nouvelle méthode d'intégration ou qu'un processus d'affaires change. Ne retirez un contrôle qu'une fois que le risque sous-jacent a été supprimé, et non simplement parce que les alertes ont cessé.
L'enquête 2026 Global Third-Party Risk Management Survey de KPMG a révélé que seulement 17 % des organisations décrivaient leur qualité des données au niveau le plus élevé. Elle a également indiqué que 52 % des répondants disposant de données de haute qualité étaient très confiants dans leurs décisions de gestion des risques, contre 40 % des répondants ayant une mauvaise qualité de données qui n'étaient pas confiants (enquête KPMG). L'implication opérationnelle est directe : une faible qualité des données réduit la confiance dans les décisions, y compris dans les flux de travail automatisés de gestion des risques.
Chaque incident est une preuve concernant le système de contrôle. L'objectif est une détection plus rapide et plus précise des défaillances lourdes de conséquences, avec un enregistrement clair de la manière dont l'organisation a réagi.
Démarrer avec votre programme de risques liés à la qualité des données
Commencez par un seul produit de données critique, et non par un inventaire à l'échelle de l'entreprise. Nommez ses utilisateurs, documentez les décisions qu'il soutient, listez ses dépendances en amont et enregistrez les modes de défaillance que les ingénieurs connaissent déjà. Sélectionnez ensuite un ensemble restreint de contrôles couvrant différents risques, tels que la détection d'anomalies pour le comportement, la surveillance de la Timeliness pour la livraison, le suivi de schéma pour la structure et la validation au niveau de l'enregistrement pour la logique d'affaires.
La première référence doit être observable et révisable. Capturez le comportement d'arrivée normal, le volume attendu, les distributions importantes, les champs requis et le schéma actuel. Définissez qui reçoit les alertes et à quel moment une défaillance bloque la publication. Si l'équipe ne peut pas expliquer la réponse, la vérification n'est pas prête pour la production.
Se développer par incréments contrôlés
Un déploiement modulaire permet aux équipes d'apprendre sans créer une surface d'alerte ingérable :
Commencer par l'actif ayant les plus lourdes conséquences : Choisissez le jeu de données où une défaillance affecterait les décisions, la conformité ou les opérations clients.
Ajouter une fonctionnalité de surveillance : Commencez par la Timeliness ou la détection d'anomalies si le principal problème est un changement de comportement silencieux. Ajoutez des contrôles de schéma et de validation à mesure que la cartographie des défaillances se précise.
Exécuter les vérifications près de la source : L'exécution en base de données limite les transferts inutiles et maintient les données sensibles dans l'environnement du client.
Passer en revue chaque alerte : Identifiez les changements attendus, ajustez les seuils et convertissez les constatations récurrentes en contrôles documentés.
Étendre la couverture délibérément : Ajoutez des actifs lorsqu'une nouvelle source, un modèle, un rapport ou un processus réglementaire crée un risque matériel.
Les exigences de déploiement sont importantes dans les environnements réglementés. Une plateforme qui s'exécute au sein d'un cloud privé, d'un VPC ou d'un centre de données peut prendre en charge le contrôle local des données de production. Les vérifications en base de données peuvent s'aligner sur les exigences de sécurité, tandis que les méthodes statistiques combinées au machine learning peuvent adapter la détection d'anomalies au comportement de référence de chaque jeu de données. Une tarification qui évite les frais liés aux appels d'API ou au volume d'alertes peut également faciliter la prévision de l'expansion, bien que les équipes doivent toujours définir la portée des tables actives et la propriété avant d'intégrer davantage de données.
La gestion des risques liés à la qualité des données réussit lorsqu'elle s'intègre dans les routines de Release, d'incident et de gestion du changement. Traitez la qualité comme un système de contrôle continu, et les équipes pourront détecter les flux obsolètes, les schémas instables, les comportements inhabituels et les enregistrements invalides avant que ces défaillances ne deviennent des incidents d'affaires.
digna fournit une plateforme d'entreprise pour la qualité et l'observabilité des données qui s'exécute au sein de votre environnement, combinant détection d'anomalies, surveillance de la Timeliness, suivi de schéma, validation au niveau de l'enregistrement et analyse historique. Visitez digna pour évaluer un point de départ modulaire afin de transformer les risques critiques de qualité des données en contrôles continus et exploitables.


