Explication des dimensions de la qualité des données pour les équipes de données modernes
|
8
minute de lecture

Vous pouvez avoir un tableau de bord rempli de voyants verts, un pipeline qui se termine à temps et un rapport hebdomadaire qui arrive dans chaque boîte de réception à l'heure, tout en regardant l'entreprise prendre la mauvaise décision. C'est la partie que les gens oublient lorsqu'ils traitent les dimensions de qualité des données comme une liste de contrôle de conformité au lieu d'un modèle opérationnel. En production, la défaillance n'est généralement pas une corruption évidente. Il s'agit d'un glissement lent dans une dimension, peut-être la timeliness, peut-être la cohérence, peut-être l'exactitude, qui échappe à une surveillance globale et empoisonne les décisions.
Table des matières
Quand de bonnes données mènent à de mauvaises décisions
Des cadres académiques à la réalité opérationnelle
Pourquoi la liste s'est raccourcie
Les dimensions clés et comment les mesurer
Ce qu'il faut mesurer en premier
Où les contrôles échouent dans les pipelines réels
Pourquoi le contexte détermine les dimensions qui importent le plus
Choisissez les dimensions par cas d'usage, pas par habitude
Opérationnaliser les dimensions avec une surveillance continue
Comment fonctionnent les contrôles continus en pratique
Pourquoi l'architecture est importante
Cadre de priorisation et liste de contrôle de mise en œuvre
Un déploiement progressif qui fonctionne
Le plaidoyer pour une surveillance continue plutôt que des contrôles périodiques
Quand de bonnes données mènent à de mauvaises décisions
Une équipe de services financiers peut faire confiance à ses tableaux de bord des risques pendant des mois et se faire tout de même piéger. Les chiffres semblent stables, les tâches ETL réussissent et personne ne voit de table corrompue. Puis, une révision de modèle expose le problème : les entrées dérivaient d'une manière que l'équipe n'a jamais isolée, de sorte que les sorties du modèle se dégradaient bien avant que quiconque ne s'en aperçoive.
C'est le danger pratique d'un score unique de qualité des données. Un ensemble de données peut être complet mais obsolète, valide mais incohérent, ou propre en interne mais désaligné avec l'événement métier qu'il est censé représenter. Lorsque la surveillance vous dit seulement que « la qualité est bonne », elle masque la question : quelle dimension a échoué, et comment.
De nombreuses équipes ne découvrent cela qu'après qu'une décision a mal tourné. Le problème est rarement que les données soient totalement inutilisables. Le plus souvent, une dimension a glissé juste assez pour rester invisible aux contrôles génériques tout en modifiant le comportement des modèles, rapports ou alertes en aval.
Règle pratique : si votre surveillance ne peut pas vous dire si le problème vient de la fraîcheur, d'une contradiction, d'un doublon ou d'une absence de données, elle ne surveille pas ce qui a réellement échoué.
C'est pourquoi les praticiens doivent traiter les dimensions séparément. L'entreprise ne perçoit pas la « qualité des données » comme un score abstrait, elle subit des flux en retard, des entités dupliquées, des champs manquants, des systèmes contradictoires et des valeurs qui ne correspondent plus à la réalité. Un modèle opérationnel utile commence par identifier la dimension exacte qui a changé, puis par retracer comment ce changement a impacté une décision.
Pour une perspective connexe sur la façon dont une mauvaise qualité des données se manifeste dans les résultats commerciaux, voir la discussion de digna sur l'impact d'une mauvaise qualité des données sur les décisions commerciales.
Des cadres académiques à la réalité opérationnelle
Un programme pratique de qualité des données commence généralement par une réalité désordonnée, et non par une taxonomie soignée. L'origine des cadres modernes remonte aux années 1990, lorsque des chercheurs ont regroupé 15 dimensions de qualité des données en catégories intrinsèques, contextuelles, de représentation et d'accessibilité. Cela a élargi la conversation au-delà de l'exactitude et a contribué à façonner des normes ultérieures telles que l'ISO 8000 comme décrit dans la littérature. L'histoire est importante car elle explique pourquoi les équipes héritent encore d'un ensemble fragmenté de définitions, de contrôles et de modèles de propriété.
Pourquoi la liste s'est raccourcie
La plupart des organisations ne peuvent pas opérationnaliser les 15 caractéristiques à la fois. Elles ont besoin de dimensions qu'elles peuvent mesurer, sur lesquelles elles peuvent alerter et qu'elles peuvent attribuer à un propriétaire. Les six dimensions clés d'IBM (exactitude, complétude, cohérence, timeliness, validité et unicité) reflètent ce virage vers des contrôles que les équipes peuvent exécuter. Pour une filiation de governance plus large, DAMA-DMBOK est souvent le point de référence que les praticiens utilisent lorsqu'ils ont besoin de relier les concepts à la pratique opérationnelle.
La même pression se manifeste dans d'autres cadres. Statistique Canada utilise un ensemble plus gérable, comprenant la pertinence, l'exactitude, la timeliness, l'accessibilité, l'interprétabilité et la cohérence, ce qui montre comment les organisations simplifient le modèle lorsque l'objectif est la governance quotidienne plutôt que la couverture académique.
L'ISO/IEC 25012 pousse le modèle vers l'implémentation en traitant la qualité comme un modèle multidimensionnel doté de 15 caractéristiques de haut niveau, divisées en groupes inhérents et dépendants du système comme indiqué dans le résumé de la norme. Cette distinction est cruciale en production, car les données peuvent être saines alors que le pipeline, le schéma ou l'interface les font paraître corrompues. L'ISO 8000-8 restreint ensuite le travail à la qualité syntaxique, sémantique et pragmatique comme décrit dans la littérature, ce qui correspond au type de répartition que les ingénieurs peuvent transformer en contrôles, exceptions et processus d'escalade.
La leçon pratique est directe. Les taxonomies académiques définissent l'espace. Les cadres opérationnels indiquent aux équipes quoi inspecter, où l'inspecter et comment distinguer un mode de défaillance d'un autre.
Les normes sont surtout utiles lorsqu'elles obligent à exposer les compromis au grand jour. Si vous ne pouvez pas dire si le problème est sémantique, syntaxique ou pragmatique, vous ne pouvez généralement pas non plus concevoir le bon contrôle.
Les dimensions clés et comment les mesurer
Le modèle à six dimensions est un point de départ pratique car il donne aux équipes un langage commun, et non parce qu'il couvre tous les cas particuliers. En production, chaque dimension a besoin d'une métrique, d'une méthode de détection et d'un schéma de défaillance qui fait surface avant que les utilisateurs ne s'en aperçoivent. L'objectif est de détecter le type de rupture qui modifie le comportement en aval. Pour un guide détaillé d'une dimension, le guide de digna sur comment mesurer l'exactitude des données est un complément utile.
Dimension | Métriques Clés | Méthodes de Détection | Modes de Défaillance Courants |
|---|---|---|---|
Exactitude | Écart par rapport à la source de vérité, dérive par rapport aux valeurs de référence | Contrôle croisé avec les systèmes faisant autorité, audits sur échantillon, comparaisons de dérive | Les valeurs ne correspondent plus à la réalité, les entrées du modèle deviennent obsolètes |
Complétude | Taux de valeurs nulles, enregistrements requis manquants, enregistrements partiels | Contrôles de présence au niveau des champs, réconciliation du nombre de lignes, validation des champs obligatoires | Identifiants manquants, attributs vides, enregistrements partiellement écrits |
Cohérence | Taux de contradiction entre les systèmes, nombre de discordances | Comparaisons entre systèmes, réconciliation d'entités, contrôles de contradiction basés sur des règles | La même entité a des valeurs différentes à différents endroits |
Timeliness | Délai entre la période de référence et la disponibilité, taux de livraison tardive | Surveillance de l'heure d'arrivée, contrôles SLA, estimations de livraison attendue | Les chargements arrivent en retard, les tableaux de bord reflètent la mauvaise période |
Validité | Taux d'échec des règles, valeurs hors limites, violations de format | Application des règles métier, contraintes de schéma, contrôles regex et de domaine | Codes invalides, valeurs impossibles, champs mal formés |
Unicité | Taux de doublons, nombre de clés répétées | Logique de déduplication, analyses de collision de clés, correspondance floue pour les quasi-doublons | Clients en double, transactions répétées, totaux gonflés |
Ce qu'il faut mesurer en premier
L'Exactitude commence par une référence de confiance. Comparez les valeurs à cette référence et surveillez la dérive au fil du temps. Un enregistrement peut passer les contrôles de schéma et rester incorrect, le contrôle doit donc comparer les données à un élément extérieur à l'ensemble de données. Pour les équipes qui cherchent à définir ce contrôle, le guide comment mesurer l'exactitude des données en expose clairement les mécanismes.
La Complétude est généralement la dimension la plus facile à mettre en production rapidement. Suivez les taux de valeurs nulles, les lignes requises manquantes et les enregistrements partiels par champ et par source. Le mode de défaillance est simple : un pipeline laisse passer des lignes, mais un attribut important n'est jamais renseigné, ce qui perturbe les analyses et les rapports par la suite.
La Cohérence nécessite une réflexion transversale aux systèmes. Deux systèmes peuvent sembler corrects individuellement et pourtant être en désaccord sur la même entité. Cette contradiction nuit à la réconciliation, en particulier lorsque les équipes en aval supposent qu'il existe une source unique de vérité.
Où les contrôles échouent dans les pipelines réels
La Timeliness est une question de latence, pas une vague étiquette de fraîcheur. La directive du gouvernement victorien la définit comme le délai entre la période de référence et la publication des informations, ce qui en fait une mesure opérationnelle concrète plutôt qu'un slogan pour la fraîcheur des données. Le cadre du gouvernement britannique traite également la timeliness comme des données qui reflètent la période qu'elles représentent et restent à jour au sein du modèle officiel.
La Validité est le lieu où vivent les règles métier. Vérifiez les plages autorisées, les listes de valeurs exactes, les formats et les seuils, car les enregistrements invalides semblent souvent inoffensifs jusqu'à ce qu'un processus en aval les rejette ou, pire, les accepte.
L'Unicité concerne le contrôle des doublons. Cela signifie l'absence de duplication dans les enregistrements pour une même entité, comme le définit le cadre du gouvernement britannique dans ce même modèle officiel. Sur le plan opérationnel, les enregistrements en doublon gonflent les volumes, comptabilisent deux fois les clients ou transforment une jointure en aval en non-sens.
L'intégrité et la provenance comptent également. L'intégrité protège les relations entre les enregistrements et les tables. La provenance montre d'où vient une valeur et comment elle a changé. Elles reçoivent rarement la priorité lors d'un examen de qualité, mais elles déterminent souvent si un correctif est appliqué rapidement ou s'il se transforme en une enquête approfondie.
Pourquoi le contexte détermine les dimensions qui importent le plus
Chaque charge de travail n'a pas besoin du même équilibre de dimensions. Une équipe financière, une équipe clinique et une équipe e-commerce peuvent toutes utiliser le même entrepôt de données et pourtant se soucier de modes de défaillance différents. L'erreur consiste à supposer que chaque dimension mérite le même poids partout.
Dans les services financiers, l'exactitude et la cohérence se hissent généralement au sommet car les rapports réglementaires, les calculs de risques et les réconciliations dépendent de l'alignement des valeurs entre les systèmes. Un enregistrement complet mais contradictoire reste un problème. Dans le domaine de la santé, la timeliness peut être plus cruciale sur le moment car un flux retardé peut être moins utile qu'un flux légèrement imparfait, en particulier lorsque les décisions opérationnelles dépendent du statut disponible le plus récent.
Le e-commerce donne souvent la priorité à la complétude et à la validité. Un catalogue de produits avec des attributs manquants ou des catégories invalides peut bloquer la recherche, les filtres et la logique d'exécution des commandes, même si la plupart des enregistrements semblent corrects. L'IoT et les systèmes pilotés par événements s'appuient généralement fortement sur la timeliness et l'exactitude, car des données de télémétrie obsolètes peuvent amener un système de décision en temps réel à réagir trop tard ou à réagir au mauvais état.
Choisissez les dimensions par cas d'usage, pas par habitude
Une étude récente soutient que les dimensions de qualité des données dépendent du contexte et devraient être intégrées dans les pratiques, plutôt que d'être traitées comme une liste de contrôle statique d'étiquettes. Cela correspond à ce que les équipes rencontrent en production. Un même ensemble de données peut être « assez bon » pour un rapport financier mensuel et insuffisant pour un tableau de bord opérationnel du jour même.
La question opérationnelle est toujours : qu'est-ce qui casse en premier si cette dimension se dégrade ? Si un champ manquant n'affecte qu'un enrichissement mineur, cela peut attendre. Si un flux obsolète modifie une décision clinique ou commerciale, il passe en tête de file.
Vision opérationnelle : donnez la priorité à la dimension qui change la décision, pas à celle qui est la plus facile à mesurer.
Cette formulation permet aux équipes d'éviter le piège courant de la sur-optimisation d'une zone à faible risque tout en manquant une zone à haut risque. Elle explique également pourquoi les tableaux de bord statiques échouent dans les environnements réglementés. Un tableau de bord peut sembler propre alors que le cas d'usage réel manque encore de la fraîcheur, des contrôles de contradiction ou des règles de validation dont il a besoin.
La démarche pratique consiste à cartographier chaque ensemble de données avec ses utilisateurs réels, puis à noter les dimensions dont ces utilisateurs dépendent. Une fois cela clarifié, la conception de la surveillance devient beaucoup plus simple.
Opérationnaliser les dimensions avec une surveillance continue
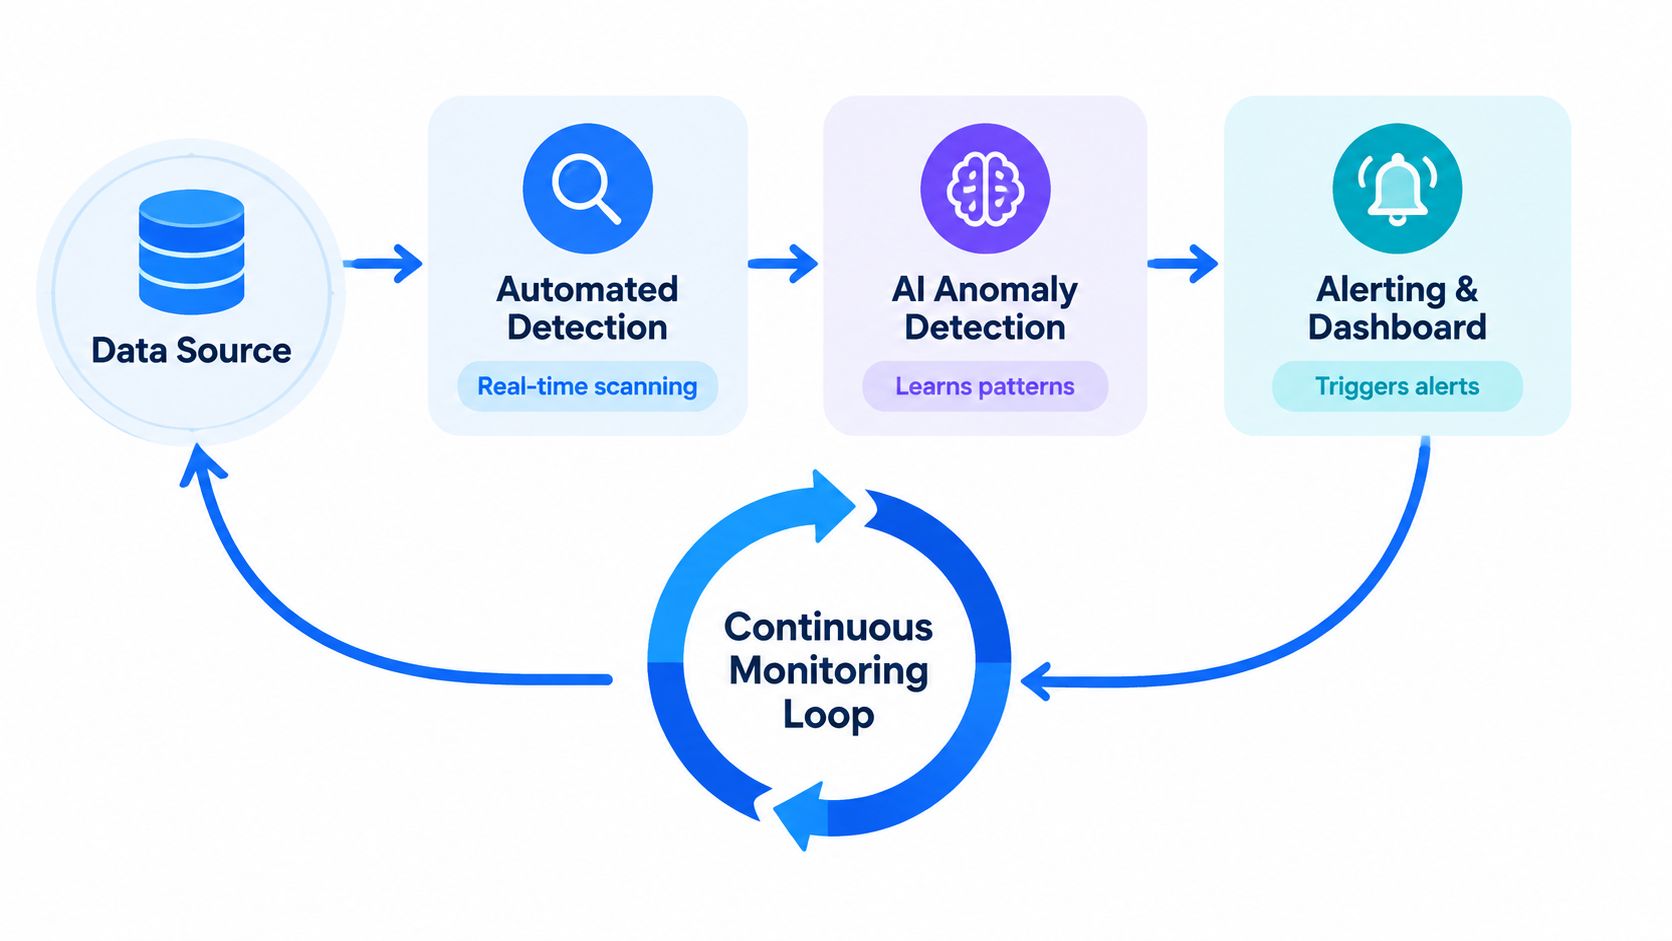
La surveillance continue est l'étape où la théorie devient applicable. Au lieu d'attendre un examen hebdomadaire, les plateformes modernes observent les données elles-mêmes, apprennent les modèles normaux et signalent les écarts dès qu'ils apparaissent. C'est important car la plupart des défauts de qualité n'arrivent pas sous forme de ruptures évidentes, ils se manifestent sous forme de dérive subtile.
La configuration modulaire de digna reflète cette réalité. Data Anomalies couvre l'apprentissage de base basé sur l'IA pour les changements d'exactitude et de cohérence, Timeliness suit les modèles d'arrivée attendus et les retards de livraison, Data Validation applique des contrôles basés sur des règles pour la validité et la complétude, et Schema Tracker surveille les changements structurels qui peuvent impacter les consommateurs en aval. Les contrôles s'exécutent dans la base de données, de sorte que les données restent en place pendant que la plateforme calcule les métriques et détecte les problèmes dans l'environnement client.
Comment fonctionnent les contrôles continus en pratique
L'apprentissage de référence est utile car toute anomalie n'est pas un simple dépassement de seuil. Une table peut toujours connaître un pic le premier jour ouvrable du mois, une règle fixe créerait donc du bruit. L'apprentissage de la référence permet au système de voir à quoi ressemble la normale pour cet ensemble de données, puis de signaler un écart lorsque le modèle change.
La surveillance de la timeliness devrait faire plus que simplement marquer les chargements tardifs après coup. Elle doit apprendre la cadence attendue, la comparer aux arrivées réelles et identifier les chargements manquants ou les livraisons précoces avant que les tâches en aval ne consomment des données obsolètes. C'est la différence entre découvrir le problème lors d'une autopsie et le détecter alors qu'il est encore temps de réorienter un pipeline.
Le suivi des schémas comble une autre lacune courante. Les modifications de structure, les colonnes ajoutées, les colonnes supprimées et les modifications de type peuvent perturber les consommateurs même lorsque le nombre de lignes semble correct. L'utilisateur final ne se soucie pas de savoir si la table source existe toujours si sa structure a changé en dessous.
Pourquoi l'architecture est importante
Les contrôles manuels ne passent pas à l'échelle dès lors que les équipes gèrent de nombreux ensembles de données et de nombreuses règles. L'automatisation continue réduit la charge d'inspecter tout à la main et aide à distinguer les véritables anomalies des variations de routine. Cela réduit la fatigue des alertes, qui est généralement ce qui tue les programmes de surveillance en premier lieu.
Une plateforme doit également prendre en charge la remédiation, et pas seulement la détection. Les ingénieurs ont besoin d'incidents, de tendances et de suffisamment de contexte pour décider s'il faut corriger en amont, modifier une règle ou accepter la nouvelle référence. Sans cette boucle de rétroaction, la surveillance devient un flux d'alarmes sans plan d'action.
Cadre de priorisation et liste de contrôle de mise en œuvre
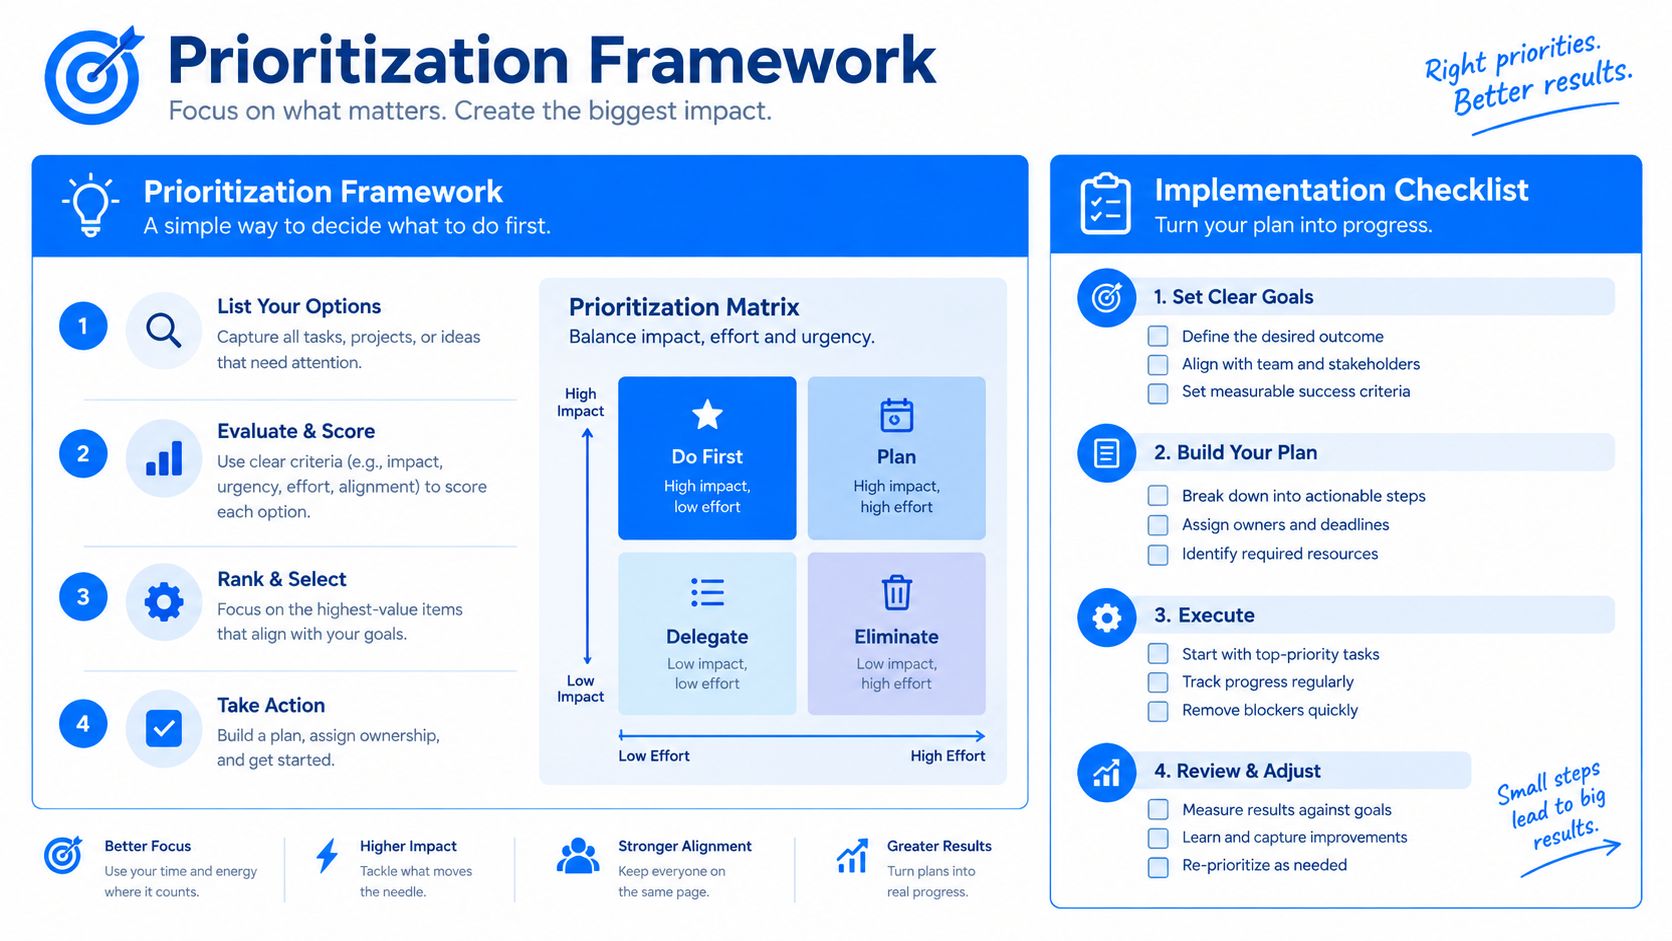
Commencez par les ensembles de données qui peuvent vous nuire le plus. Cela désigne généralement les flux financiers, les tables de faits opérationnels, les données de référence clients, les ensembles de rapports réglementés ou tout ce qui alimente les tableaux de bord de la direction. Un ensemble de données de faible valeur peut attendre. Un ensemble critique ne le peut pas.
Un déploiement progressif qui fonctionne
Phase 1 : choisir les lacunes évidentes. La timeliness et la complétude sont généralement les victoires les plus rapides car elles sont plus faciles à définir, plus faciles à inspecter et plus faciles à expliquer aux parties prenantes. Si un flux arrive en retard ou qu'un champ obligatoire est manquant, de nombreuses équipes peuvent rapidement en mesurer l'impact.
Phase 2 : ajouter des contrôles de contradiction et de règles. Une fois les bases maîtrisées, passez à la cohérence et à la validité. C'est là que les contradictions entre systèmes, les codes invalides et les mauvaises combinaisons de règles métier commencent à apparaître.
Phase 3 : renforcer l'exactitude et l'unicité. Celles-ci ont tendance à nécessiter de meilleures références, de meilleures données de référence et des flux de remédiation plus matures. Elles sont plus difficiles à cerner avec une seule règle, mais elles importent beaucoup dès que le volume et l'impact commercial sont élevés.
Une liste de contrôle utile pour chaque phase est simple :
Définir clairement la métrique. Si l'équipe ne peut pas expliquer ce qui a changé, la métrique n'est pas prête.
Établir une référence. Sans comportement normal, chaque alerte semble suspecte.
Définir des seuils d'alerte. Les seuils doivent refléter le risque commercial, et pas seulement la rigueur technique.
Documenter le processus de remédiation. Quelqu'un doit savoir qui corrige le problème, où et à quelle vitesse.
Une plateforme modulaire est utile car vous n'avez pas besoin d'installer toutes les fonctionnalités dès le premier jour. Vous pouvez commencer avec une table, un module et une catégorie de problèmes, puis étendre la couverture au fur et à mesure que l'organisation gagne en confiance et que le périmètre se précise. Cette approche est bien plus viable que d'essayer de surveiller chaque dimension partout dès le départ.
Le plaidoyer pour une surveillance continue plutôt que des contrôles périodiques
Les contrôles périodiques avaient du sens lorsque les pipelines étaient plus lents et que le nombre d'ensembles de données critiques était gérable. Ils s'effondrent dès lors que les données circulent en continu, que les consommateurs dépendent de flux récents et que le coût d'une découverte tardive est élevé. Au moment où un rapport planifié fait apparaître un problème, les dommages sont souvent déjà intégrés dans les décisions.
La surveillance continue modifie la cadence. Elle détecte la dérive pendant que les données sont encore en mouvement, et non après qu'elles ont déjà structuré une analyse ou déclenché une action. C'est particulièrement important car les problèmes de qualité commencent souvent modestement, puis se propagent à travers les jointures, les agrégations, les modèles et les tableaux de bord.
C'est également là que l'échelle compte. Les équipes qui gèrent de nombreuses règles, de nombreuses sources et de nombreux utilisateurs en aval ne peuvent pas suivre le rythme des inspections manuelles. L'automatisation gère la répétition, et l'apprentissage de base basé sur l'IA aide à réduire le bruit en comprenant à quoi ressemble la normale pour chaque ensemble de données au lieu de traiter chaque fluctuation comme une défaillance.
L'autre avantage est le temps de réponse. Lorsqu'un retard, une contradiction ou un changement de schéma est détecté tôt, l'équipe peut corriger la source, suspendre une tâche en aval ou rediriger le processus avant que les utilisateurs n'agissent sur des résultats erronés. C'est beaucoup plus difficile à faire lorsque la première alerte arrive lors d'un examen hebdomadaire.
La surveillance continue ne vise pas à remplacer le jugement. Elle consiste à donner aux ingénieurs suffisamment de signal, au bon moment, pour agir avant que l'entreprise ne subisse le défaut.
Si vous construisez ou renforcez un programme de qualité des données, commencez par les ensembles de données qui comportent le plus de risques commerciaux et surveillez les dimensions qui influencent les décisions. digna offre aux équipes une surveillance modulaire des anomalies, de la timeliness, de la validation et des changements de schémas au sein de leur propre environnement, afin que les contrôles restent proches des données et que le processus de remédiation reste pratique. Visitez digna pour voir comment cette approche s'intègre à votre architecture et par où vous commenceriez en premier.
Questions fréquentes
Quelles sont les dimensions centrales de la qualité des données ?
Exactitude, complétude, cohérence, Timeliness, validité et unicité. Chacune a ses métriques et méthodes de détection : l'exactitude se vérifie contre une référence fiable, la complétude via les taux de valeurs nulles et la réconciliation des comptages, la cohérence via les contradictions entre systèmes.
D'où viennent les cadres de dimensions ?
Des travaux des années 1990 ont regroupé 15 dimensions en catégories intrinsèque, contextuelle, représentationnelle et d'accessibilité. ISO/IEC 25012 conserve 15 caractéristiques de haut niveau réparties en groupes inhérents et dépendants du système, tandis qu'ISO 8000-8 resserre le travail sur la qualité syntaxique, sémantique et pragmatique.
Pourquoi un score de qualité unique pose-t-il problème ?
Parce qu'il masque la défaillance réellement survenue. Si votre surveillance ne peut pas dire s'il s'agit de fraîcheur, de contradiction, de duplication ou d'absence, elle ne surveille pas ce qui a cédé, et les équipes s'en aperçoivent en général après une mauvaise décision.
Quelles dimensions une équipe doit-elle prioriser ?
Cela dépend du consommateur, pas de l'habitude. Les services financiers placent d'ordinaire exactitude et cohérence en tête, car le reporting réglementaire et les rapprochements supposent des valeurs concordantes entre systèmes, tandis que l'e-commerce privilégie souvent complétude et validité. Demandez ce qui casse en premier si cette dimension se dégrade.
Comment déployer la surveillance par dimensions ?
En trois phases : commencez par les manques évidents, ajoutez les contrôles de contradiction et de règles, puis resserrez exactitude et unicité. Pour chaque phase, définissez clairement la métrique, établissez une ligne de base, fixez les seuils d'alerte et documentez le chemin de remédiation avant de poursuivre.



