Détection d'anomalies dans les données de capteurs : un guide pratique
|
8
minute de lecture

Un tableau de bord des vibrations vire au rouge pendant le quart de l'après-midi. L'opérateur vérifie la machine et ne trouve rien d'évident. L'alarme provenait d'un canal de température réagissant à une pièce plus chaude, tandis qu'un canal de vibration distinct a dérivé vers la panne sans franchir sa limite fixe. Le temps que quelqu'un relie les signaux, le détecteur a soit crié au loup trop souvent, soit est resté silencieux trop longtemps.
C'est la réalité du déploiement de la détection d'anomalies de données de capteurs. Les flux industriels sont bruyants, multimodaux, dépendants du temps et en constante évolution. Un détecteur performant sur un benchmark propre peut tout de même échouer lorsque les capteurs dérivent, les horodatages se désalignent, les canaux se déplacent ensemble ou l'usine change de régime de fonctionnement. La question pratique n'est pas seulement de savoir quel modèle a le score le plus élevé. Il s'agit de savoir si le système peut identifier des écarts significatifs assez rapidement pour qu'un opérateur ou un ingénieur puisse agir.
Table des matières
Pourquoi la détection d'anomalies de capteurs est plus difficile qu'il n'y paraît
Les contraintes de production qui comptent
Ingénierie des caractéristiques pour les flux de capteurs
Aligner le temps avant de calculer les caractéristiques
Faire correspondre les caractéristiques au modèle de défaillance
Un menu de caractéristiques pratiques
Choisir le bon modèle de détection
Bases de référence statistiques
Apprentissage automatique classique
Apprentissage profond
Gérer la saisonnalité, la dérive et les canaux corrélés
Réancrer la base de référence avec soin
Prendre en compte les canaux couplés
Évaluer honnêtement les performances de détection
Utiliser une évaluation sensible aux événements
Architectures de déploiement pour la surveillance en temps réel
Faire correspondre le modèle à la décision
Ne pas négliger l'évaluation en base de données
Passer au direct en toute confiance
Exécuter la liste de contrôle pré-lancement
Rendre l'escalade explicite
Pourquoi la détection d'anomalies de capteurs est plus difficile qu'il n'y paraît
Un capteur de vibration de turbine peut rester presque plat pendant des heures après le desserrage d'un support de montage. L'état mécanique a changé, pourtant le signal peut dériver lentement et rester en dessous d'un seuil statique. Une règle qui alerte au-dessus d'une certaine valeur voit un fonctionnement normal. Un ingénieur examinant la tendance, le contexte de rotation et les canaux associés peut y déceler un défaut émergent.
Cet écart définit le problème de production. Les systèmes industriels combinent vibrations, température, pression, courant, signaux de commande, images et d'autres modalités, chacune ayant un comportement d'échantillonnage et des modes de défaillance différents. Les échantillons manquants créent des vides, les lectures bruyantes créent des pics, et les canaux corrélés peuvent faire apparaître un changement de fonctionnement légitime comme anormal. Le détecteur doit apprendre le comportement normal pour un actif, un état de fonctionnement et une période donnés, plutôt que de mémoriser une seule plage globale.
Règle pratique : Traitez le « normal » comme un contexte de fonctionnement appris, et non comme un nombre permanent.
La recherche dans ce domaine reflète cette même progression. Les premières méthodes de détection d'anomalies reposaient largement sur les statistiques et le traitement du signal. Les travaux ultérieurs se sont étendus à l'apprentissage automatique et à l'apprentissage profond. Une enquête de 2020 sur la détection intelligente d'anomalies dans les systèmes de capteurs décrit la longue histoire des méthodes statistiques et de traitement du signal, et distingue les techniques conventionnelles des approches basées sur les données. Une revue distincte de la détection d'anomalies sur les machines industrielles a évalué 84 études s'étendant de 2016 à 2023, illustrant la croissance rapide de la recherche industrielle moderne.
Les contraintes de production qui comptent
Un pipeline de détection doit répondre à plusieurs contraintes avant de pouvoir produire un score utile :
Changements de régime de fonctionnement : La charge, la vitesse, la température ambiante, les recettes de production et les cycles d'équipe modifient le signal attendu.
Dérive des capteurs : Les changements d'étalonnage et le vieillissement peuvent déplacer la base de référence alors que la machine reste saine.
Canaux corrélés : La température, les vibrations et le courant peuvent répondre à la même condition mécanique ou électrique.
Échantillonnage inégal : Un canal peut arriver rapidement tandis qu'un autre rapporte de manière sporadique, de sorte que des jointures naïves ligne par ligne peuvent déformer les relations.
Étiquettes retardées : Les équipes de maintenance enregistrent rarement le moment exact où une anomalie a commencé, laissant les fenêtres d'entraînement et d'évaluation incertaines.
Latence et localité : Une décision de sécurité peut devoir être prise à proximité de la machine, tandis qu'une analyse plus approfondie peut s'exécuter sur une plateforme centrale.
Ces conditions expliquent pourquoi la précision des benchmarks sur des ensembles de données propres est souvent médiocre en production. Les benchmarks ont tendance à fournir des horodatages ordonnés, des distributions stables et des étiquettes explicites. Les usines fournissent des pertes de capteurs, des interventions de maintenance, des charges de travail changeantes et des anomalies qui se développent au fil du temps. Un modèle peut obtenir de bons résultats tout en produisant des alertes trop tard, trop souvent, ou sans assez de contexte pour qu'un opérateur puisse agir.
Pour les équipes responsables des pipelines environnants, la Data Observability pour la fiabilité opérationnelle fournit des contrôles pour séparer une anomalie de machine d'un flux tardif, manquant, malformé ou structurellement modifié. Le détecteur ne peut pas raisonner de manière fiable sur un signal qui n'est jamais arrivé ou qui est arrivé dans un format incorrect. La surveillance opérationnelle doit donc couvrir à la fois l'équipement et le chemin des données qui le représente.
Ingénierie des caractéristiques pour les flux de capteurs
Les valeurs brutes des capteurs sont des entrées de modèle faibles sans contexte opérationnel. Une température de 70 peut être normale à une certaine charge et suspecte à une autre. Une lecture de vibration qui semble inoffensive seule peut avoir de l'importance après une rampe prolongée. Les caractéristiques utiles capturent le contexte local, l'évolution dans le temps et les relations entre les canaux.
Aligner le temps avant de calculer les caractéristiques
Choisissez une cadence d'analyse qui correspond au budget de latence du détecteur, puis rééchantillonnez chaque canal délibérément. Ne propagez pas vers l'avant (forward-fill) un flux de vibrations à haute fréquence pendant une panne prolongée, et n'interpolez pas à travers une période où l'équipement était hors ligne. Conservez un indicateur d'imputation et de données manquantes afin que le détecteur puisse séparer une valeur mesurée d'une reconstruction.
L'alignement dépend également de la qualité de l'horloge. Un décalage d'horloge entre les appareils ou les passerelles peut créer de fausses relations de retard lorsqu'un canal en explique un autre. Vérifiez l'ordre des horodatages, les doublons, les écarts d'échantillonnage et la cohérence des unités avant de joindre les flux. Une caractéristique bien conçue construite à partir de signaux mal alignés reste erronée.
Pour les équipements multimodaux, conservez autant que possible les horodatages d'origine des canaux ou les indicateurs de qualité. Une cadence commune facilite le calcul des caractéristiques, mais elle peut masquer de courts écarts et faire paraître un canal lent plus précis qu'il ne l'est. Le bon choix dépend du mode de défaillance et de la fenêtre d'action, et non d'un tableau simplement bien ordonné.
Faire correspondre les caractéristiques au modèle de défaillance
Un score z glissant mesure la distance entre la lecture actuelle et une moyenne récente par rapport à la variation récente. Une fenêtre courte, de cinq minutes par exemple, peut révéler un saut d'amplitude soudain. Une fenêtre plus longue, comme 30 minutes, peut révéler une dérive plus lente qu'une fenêtre courte pourrait absorber comme normale. La méthode familière calcule la moyenne et l'écart-type sur une fenêtre glissante, puis signale les valeurs au-delà d'un seuil sélectionné. Une implémentation de référence utilise un seuil de 3, ce qui correspond à environ 3 points sur 1 000 dans une distribution normale, comme décrit dans l'exemple de détection d'anomalies par score z d'Ericsson.
La différenciation répond à une question distincte. Les différences de premier ordre exposent les sauts entre observations adjacentes. Les différences de second ordre exposent les changements dans la vitesse de mouvement, aidant à identifier une dérive qui s'accélère ou une instabilité émergente. Les deux opérations peuvent amplifier le bruit, il faut donc d'abord lisser ou agréger les signaux très volatils. Ce prétraitement ajoute un délai, qui doit s'intégrer dans le budget de surveillance.
Les caractéristiques de décalage (lag) de une à dix étapes offrent aux modèles classiques une vue compacte de l'histoire récente. Elles conviennent aux processus où la lecture suivante dépend des valeurs récentes, mais elles augmentent la dimensionnalité et deviennent redondantes lorsque l'échantillonnage est dense. Les centiles glissants décrivent la dispersion locale sans supposer de distribution symétrique, ce qui les rend utiles pour les valeurs aberrantes et les comportements opérationnels asymétriques.
Un menu de caractéristiques pratiques
Technique | Ce qu'elle capture | Meilleure utilisation |
|---|---|---|
Score z glissant | Écart local par rapport à la moyenne et à la variation récentes | Dérive d'amplitude et écarts de courte durée |
Différence de premier ordre | Changement entre lectures adjacentes | Sauts soudains et discontinuités |
Différence de second ordre | Changement dans la vitesse de mouvement | Rampes d'accélération et instabilité émergente |
Caractéristiques de décalage (lag) | Contexte autorégressif récent | Dépendances temporelles courtes dans les modèles classiques |
Centiles glissants | Limites de distribution locale | Signaux bruyants et variation non gaussienne |
Résidus inter-canaux | Écart après prise en compte d'un signal connexe | Comportements couplés de température, courant, vitesse et vibration |
Les résidus inter-canaux apportent souvent plus de valeur qu'une autre transformation du même signal. Estimez le comportement attendu d'un canal à partir d'un canal connexe, puis surveillez le résidu. Vérifiez à nouveau cette relation à mesure que les charges de travail et l'étalonnage changent, car la corrélation peut dériver même si les deux capteurs restent sains.
Pour un examen plus approfondi de la construction des caractéristiques, consultez les conseils de détection d'anomalies sur les séries temporelles de capteurs ainsi que les connaissances sur les actifs. Le choix des caractéristiques importe plus que leur volume. Chaque transformation doit répondre à une question de surveillance, rester traçable dans une alerte et éviter de consommer plus de latence ou de calcul que ne le permet la décision opérationnelle.
Choisir le bon modèle de détection
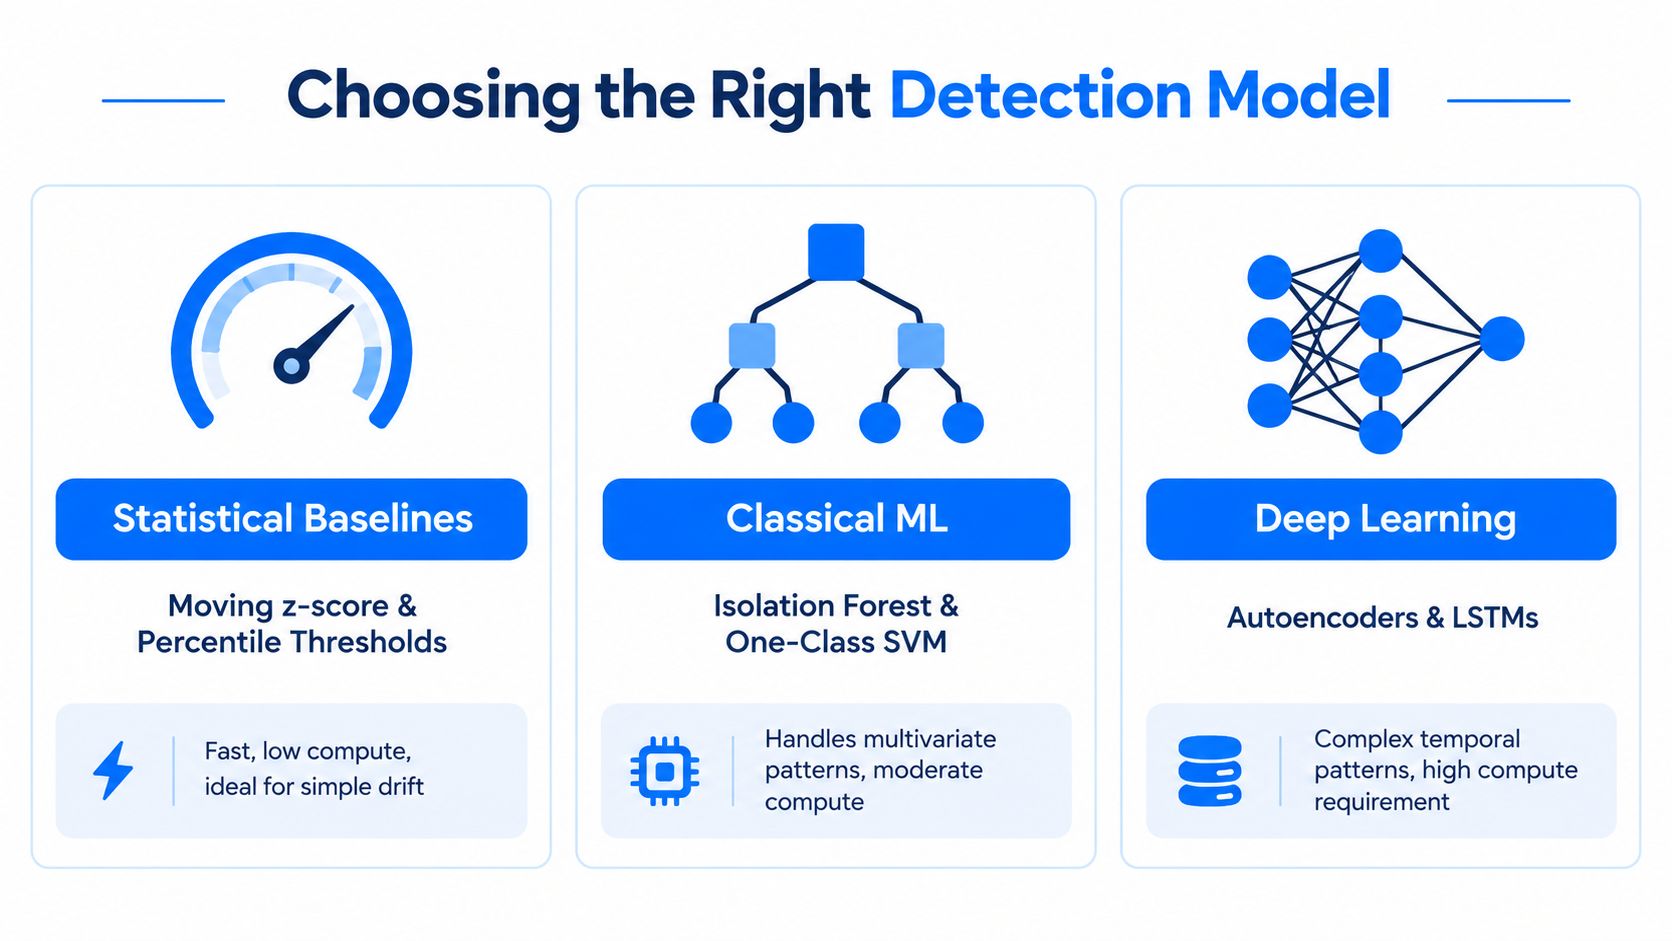
Aucun détecteur unique ne l'emporte sur tous les régimes de capteurs. Les méthodes statistiques sont peu coûteuses et explicables, l'apprentissage automatique classique gère des espaces multivariés compacts, et l'apprentissage profond peut modéliser des relations temporelles complexes. La bonne conception en production attribue généralement un rôle à chaque approche plutôt que de contraindre un seul modèle à traiter chaque alerte.
Bases de référence statistiques
Les scores z mobiles, les centiles glissants et les seuils de résidus constituent d'excellents détecteurs de première ligne. Ils sont rapides, faciles à inspecter et adaptés aux dérives simples ou aux changements abrupts. Leur faiblesse est le contexte. Un seuil fixe ne fonctionne plus lorsque le régime de fonctionnement change, et une fenêtre glissante courte peut traiter un défaut prolongé comme la nouvelle norme.
Des bases de référence adaptatives peuvent éliminer une partie de la configuration manuelle. Une implémentation documentée apprend une base de référence à partir des sept jours précédents de lectures, la met à jour une fois par heure et nécessite au moins 100 lectures avant d'établir la base de référence, comme décrit dans la documentation sur les bases de référence d'anomalies de capteurs. Ces mécanismes sont des modèles utiles, mais ils ont tout de même besoin de garanties contre l'apprentissage à partir d'une période contaminée.
Apprentissage automatique classique
La forêt d'isolement (Isolation Forest) et le SVM à une classe (one-class SVM) sont utiles lorsque les anomalies occupent des régions inhabituelles d'un espace de caractéristiques multivarié. Ils peuvent combiner des statistiques glissantes, des décalages, des résidus et le contexte de fonctionnement sans nécessiter une grande archive de défaillances étiquetées. Ils sont souvent plus faciles à déployer qu'un modèle séquentiel, mais leur performance peut se dégrader lorsque les distributions des caractéristiques dérivent ou lorsque les défauts rares sont mal représentés.
La prudence est de mise. Sur un benchmark d'anomalies industrielles, Isolation Forest avec ou sans mise à l'échelle n'a atteint qu'un score F1 moyen de 0,171, tandis que le LOF (Local Outlier Factor) a atteint un score F1 moyen de 0,100, selon les résultats de détection d'anomalies industrielles rapportés. Ces résultats ne rendent pas ces algorithmes inutiles. Ils montrent pourquoi une base de référence non supervisée doit gagner la confiance sur l'équipement cible plutôt que d'en hériter d'un exemple de manuel scolaire.
Apprentissage profond
Les auto-encodeurs LSTM et les détecteurs basés sur les Transformers peuvent représenter des dépendances temporelles longues et des relations entre les canaux. Ils conviennent mieux lorsque la signature de la défaillance dépend d'une séquence plutôt que d'un point isolé, mais ils exigent plus de calculs, une conception de fenêtre minutieuse et des données de fonctionnement sain fiables.
Les résultats appliqués montrent à la fois le potentiel et le piège. Un auto-encodeur LSTM combiné avec Isolation Forest a atteint une précision de 95,7 % et un score F1 de 0,93 dans une évaluation d'anomalies de capteurs, comme rapporté dans cette étude d'identification d'anomalies de capteurs. Un auto-encodeur de systèmes de contrôle industriel distinct a rapporté une précision de 0,993 et une exactitude de 96 %, mais le rappel n'était que de 0,673 et le score F1 de 0,771, documenté dans l'étude d'auto-encodeur de systèmes de contrôle industriels. Une précision élevée peut coexister avec un trop grand nombre de défauts manqués.
Une architecture à plusieurs niveaux est généralement plus efficace. Laissez les règles statistiques gérer les écarts évidents, utilisez des modèles classiques pour les résidus multivariés et envoyez les cas ambigus ou temporellement complexes à un modèle plus profond. Pour des détails d'implémentation concernant les flux de travail d'anomalies basés sur Python, les pratiques de détection d'anomalies de données Python peuvent accompagner votre documentation spécifique au modèle.
Gérer la saisonnalité, la dérive et les canaux corrélés
Une ligne de production peut fonctionner avec différentes équipes, se réchauffer au fil de la journée et développer une usure des roulements pendant que son profil de charge change. Un seuil fixe traite chaque changement comme un défaut. Le détecteur doit séparer le mouvement attendu des preuves que le processus ou la relation entre capteurs a changé.
Réancrer la base de référence avec soin
Un score z glissant peut absorber un cycle de fonctionnement quotidien tout en préservant les écarts par rapport au modèle récent. Cela crée également un angle mort : un défaut qui se développe progressivement sur toute la fenêtre peut finir par faire partie de la base de référence. Définissez la fenêtre à partir du cycle du processus et de la latence d'alerte, et non à partir d'une valeur par défaut arbitraire.
La décomposition STL sépare la tendance, le comportement saisonnier et la variation résiduelle, puis évalue le résidu au lieu de la valeur brute. Utilisez-la lorsqu'un canal présente un motif répétable. Les seuils de centiles font moins d'hypothèses en recalculant les limites locales à partir d'observations récentes, bien qu'ils nécessitent toujours une protection contre les périodes d'entraînement contaminées.
Une conception de seuil adaptatif recalcule sa base de référence quotidiennement à partir des sept jours précédents, utilise des données à la minute pour estimer le 99e centile, et ajoute un terme de fluctuation basé sur l'écart interquartile entre les 25e et 75e centiles, selon la méthode de seuil auto-adaptatif de Dynatrace. L'implémentation illustre une règle plus large : le comportement récent ne peut définir le comportement attendu que lorsque les périodes anormales sont exclues ou pondérées à la baisse.
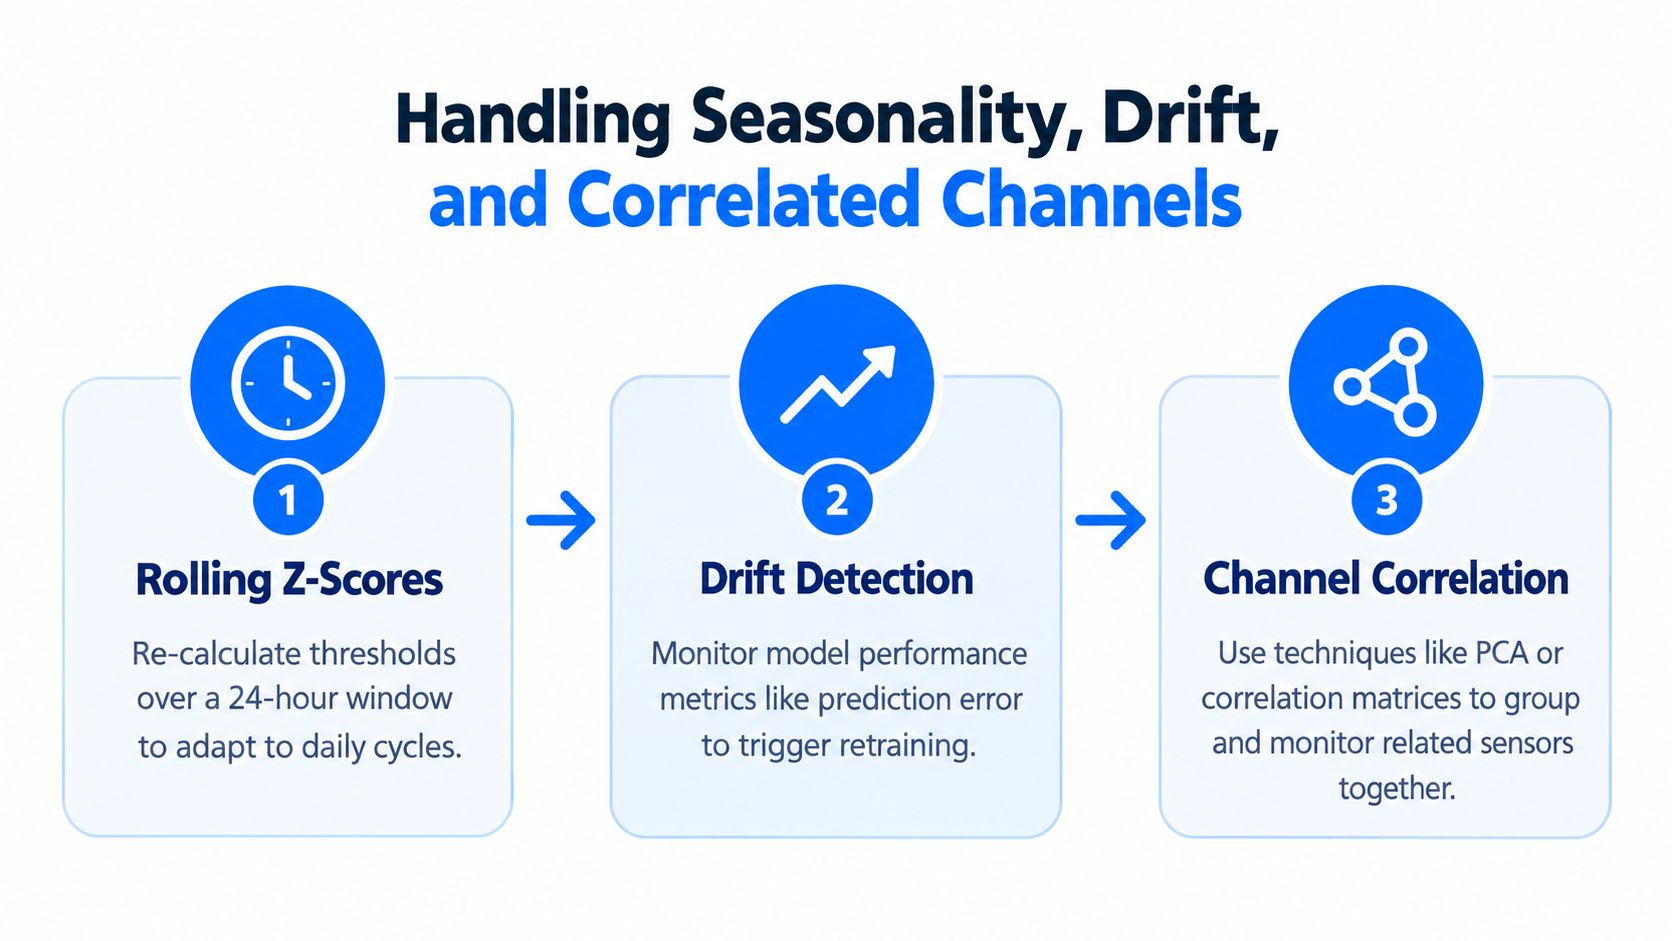
Suivez la détection de dérive de modèle pour les bases de référence de capteurs avec la détection de dérive de modèle pour les bases de référence de capteurs. Examinez séparément les distributions de caractéristiques, les résidus et les résultats d'alertes. Une base de référence peut sembler saine même après que la relation entre un capteur et ses conditions de fonctionnement a changé.
Prendre en compte les canaux couplés
La température, les vibrations et le courant évoluent souvent ensemble car la vitesse ou la charge affecte les trois. Une évaluation indépendante produit alors des alertes pour des changements de fonctionnement légitimes. Les canaux corrélés doivent être évalués par rapport au contexte de fonctionnement et les uns par rapport aux autres.
La résidusalisation est une première étape pratique. Si le régime (RPM) explique une grande partie de l'amplitude des vibrations, effectuez une régression des vibrations par rapport au régime et évaluez le résidu. L'ACP (Analyse en Composantes Principales) peut compresser les canaux corrélés en profils de fonctionnement latents, tandis que les matrices de corrélation peuvent identifier les groupes qui doivent figurer dans la même règle de surveillance. La recherche sur les flux industriels à fort bruit examine également des méthodes hybrides telles que l'ACP combinée avec des auto-encodeurs, comme décrit dans cette recherche sur la détection d'anomalies de capteurs à fort bruit.
Règle de décision : Utilisez une fenêtre adaptative lorsque le processus reste stable mais que sa base de référence se déplace. Réentraînez le modèle lorsque la relation entre les entrées et le comportement attendu a sensiblement changé, ou lorsque des incidents validés montrent des manques systématiques.
Gardez la latence à l'esprit dans la décision. Un modèle multicanal qui dépasse le budget de temps de réponse est moins utile qu'une règle de résidu plus simple qui s'exécute en continu. Combinez les relations entre canaux avec des vérifications de dérive, puis orientez les cas incertains vers un examen plutôt que de laisser la base de référence les absorber.
Évaluer honnêtement les performances de détection
L'exactitude (accuracy) est souvent le chiffre le moins utile dans un système d'anomalies. Si les défauts sont rares, un détecteur peut obtenir de bons résultats en prédisant « normal » pour presque chaque observation tout en ne capturant rien d'important. Même sans attribuer une prévalence artificielle, la leçon opérationnelle est claire : évaluez les événements dont se soucient les opérateurs, et pas seulement les lignes individuelles.
La précision vous indique combien d'alertes étaient significatives. Le rappel vous indique combien d'anomalies étiquetées le détecteur a trouvées. Aucun des deux ne mesure si le système a réagi assez tôt. Mesurez le délai de détection à partir du début de l'anomalie, et pas seulement à partir de la fin d'une fenêtre d'évaluation, car une alerte tardive peut être techniquement correcte tout en étant opérationnellement inutile.
Utiliser une évaluation sensible aux événements
Un ensemble d'évaluation pratique doit inclure :
Précision et rappel : Calculez les deux sur des fenêtres étiquetées, avec des étiquettes vérifiées par rapport aux registres de maintenance et au contexte opérationnel.
Délai de détection : Mesurez le temps écoulé entre le début justifiable le plus précoce de l'anomalie et la première alerte exploitable.
Volume d'alertes : Suivez les alertes par quart de travail et par actif, et pas seulement les métriques globales du modèle.
Charge des fausses alarmes : Enregistrez les fausses alarmes par heure d'opérateur afin que le résultat reflète la charge de travail humaine.
Examen des événements manqués : Examinez les anomalies que le détecteur n'a jamais signalées, en particulier les dérives progressives et les défaillances inter-canaux.
Une étude de référence sur la détection d'anomalies fonctionnelles a révélé que les performances dépendent fortement du type d'anomalie et qu'une évaluation basée sur la simulation est nécessaire car aucun détecteur unique n'est fiable pour tous les profils. Cette conclusion soutient l'utilisation d'une suite de tests contenant des pics soudains, des rampes progressives, des changements de niveau, des données manquantes, des changements corrélés et des intervalles bruyants, comme décrit dans le benchmark de détection d'anomalies fonctionnelles.
Métrique | Ce qu'elle mesure | Piège sur les données de capteurs |
|---|---|---|
Exactitude (Accuracy) | Classifications correctes globales | Peut masquer des défauts rares non détectés |
Précision | Part des alertes qui correspondent à des anomalies | Une précision élevée peut résulter d'alertes trop rares |
Rappel | Part des anomalies étiquetées détectées | Peut récompenser un excès d'alertes bruyant sans contexte temporel |
Score F1 | Équilibre entre précision et rappel | Traite chaque échantillon de la même manière, même lorsqu'un seul événement s'étend sur plusieurs échantillons |
Délai de détection | Temps écoulé entre le début de l'anomalie et la première alerte | Les étiquettes peuvent indiquer l'heure de la maintenance plutôt que le début physique de l'anomalie |
Volume d'alertes | Charge de travail opérationnelle générée par le modèle | Les totaux agrégés peuvent masquer un actif ou un quart de travail particulièrement bruyant |
La littérature fournit une mise en garde utile. Le contexte temporel a amélioré la détection sur un ensemble de données industrielles OPC UA de 2,27 % pour le F1, de 2,33 % pour la précision et de 3,02 % pour le rappel lorsqu'une mémoire séquentielle de second ordre a été ajoutée, selon l'étude sur la mémoire séquentielle de l'IoT industriel. Ce type d'amélioration n'a d'importance que s'il survit à une évaluation en mode miroir (shadow evaluation) propre à l'usine.
Exécutez le modèle candidat aux côtés des règles existantes en mode miroir. Ne montrez pas ses alertes aux opérateurs pendant l'évaluation initiale, comparez le moment de ses événements et sa charge de travail avec les incidents connus, et étudiez chaque divergence avant de le déployer.
Pour l'analyse d'incertitude dans les scénarios d'événements rares, la simulation de Monte Carlo pour les tests opérationnels peut aider les équipes à explorer le comportement des politiques d'alerte dans diverses conditions de signal sans traiter un résultat synthétique comme une preuve de performance en production.
Architectures de déploiement pour la surveillance en temps réel
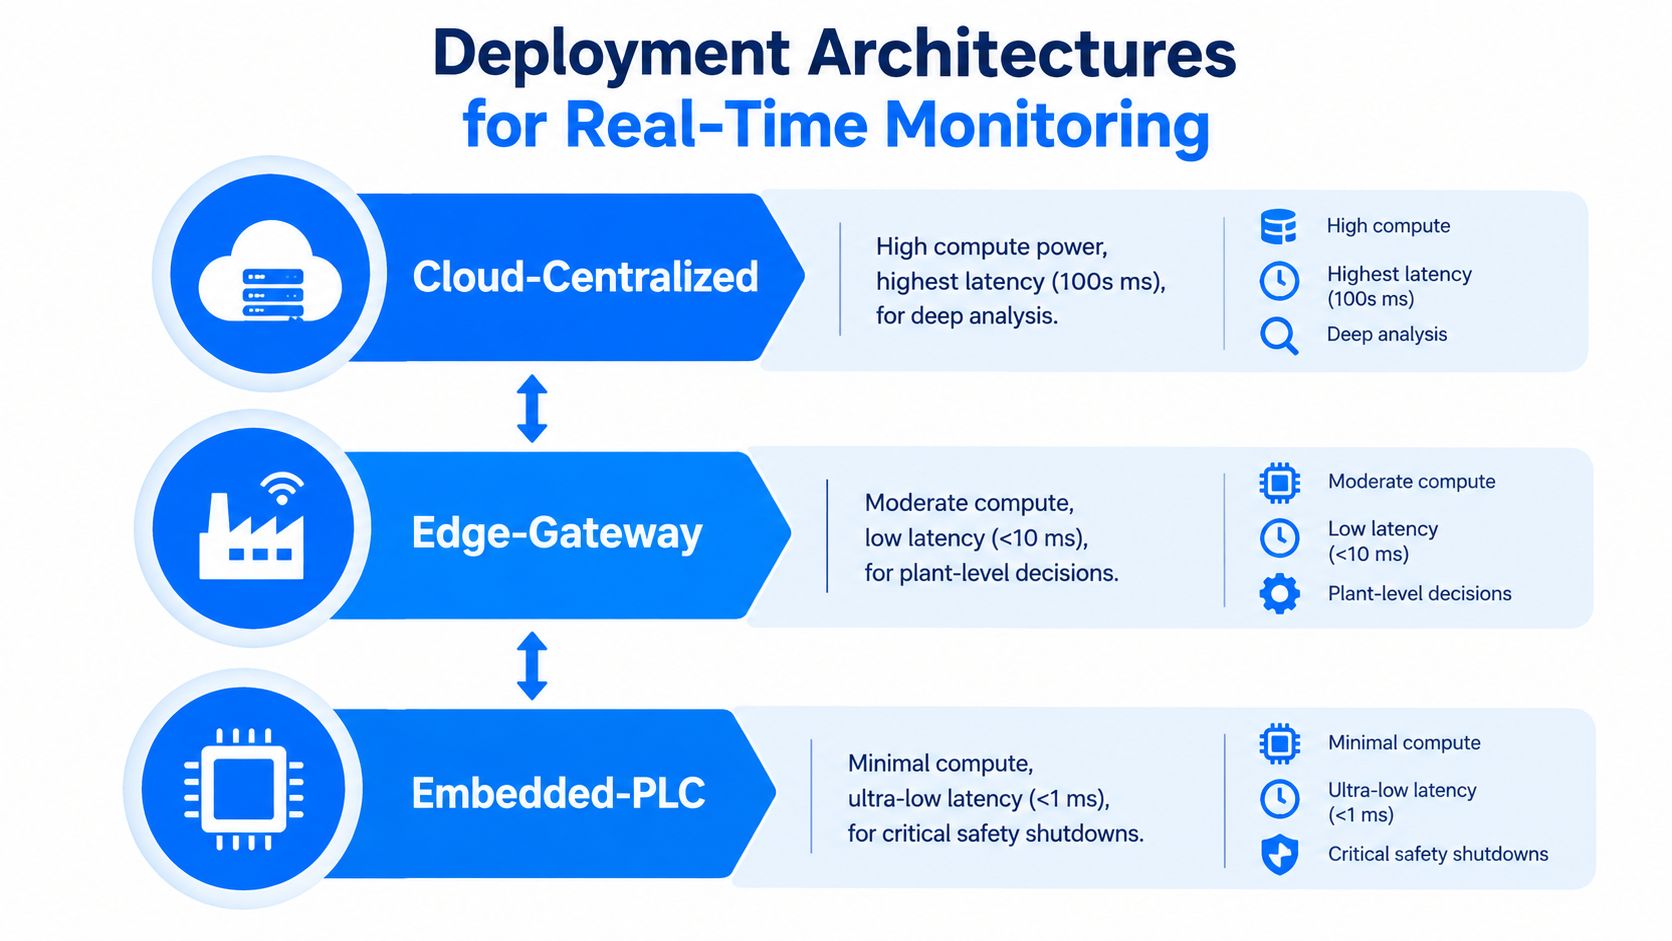
L'architecture découle des contraintes. Si une décision doit être prise à proximité de la machine, envoyer chaque échantillon brut vers un cloud lointain ajoute de la latence et crée une dépendance vis-à-vis de la connectivité réseau. S'il s'agit d'analyser des tendances à l'échelle d'un parc de machines, intégrer un modèle volumineux dans chaque contrôleur crée une charge opérationnelle inutile.
Faire correspondre le modèle à la décision
L'inférence intégrée dans un automate (PLC) ou dans un capteur convient aux actions locales critiques. Un détecteur compact peut s'exécuter là où le signal entre dans le système de contrôle, évitant ainsi un aller-retour réseau. Le compromis réside dans une limitation sévère des ressources, des mises à jour de modèles difficiles et des exigences de test strictes. Utilisez-le pour des décisions de sécurité simples, pas systématiquement pour chaque charge de travail analytique.
L'inférence sur passerelle locale (Edge) offre plus d'espace pour l'ingénierie des caractéristiques et les modèles multicanaux tout en conservant les données au sein de l'usine. Une passerelle peut consommer les messages des systèmes locaux, calculer les fenêtres temporelles et envoyer uniquement les scores ou certaines caractéristiques vers le haut. Ce modèle fonctionne bien lorsque la confidentialité et la résilience importent plus que la simplicité centralisée.
L'inférence centrale ou cloud offre une plus grande puissance de calcul et facilite le réentraînement à l'échelle du parc. Elle convient à l'analyse approfondie, aux comparaisons inter-sites et au développement de modèles à long terme, mais elle dépend d'une connectivité fiable et augmente le transfert de données brutes sensibles.
Ne pas négliger l'évaluation en base de données
Pour les synthèses de parc et le suivi historique, l'évaluation directement au sein d'une base de données de séries temporelles comme TimescaleDB ou Influx peut réduire le streaming inutile de chaque point vers le cloud. Cela permet également de garder les calculs de caractéristiques proches des données stockées et facilite les investigations pour les ingénieurs de données qui travaillent déjà en SQL. La limite est que l'exécution en base de données peut ne pas répondre aux exigences de contrôle en temps réel strict.
La collaboration cloud-edge est de plus en plus pratique pour les réseaux de capteurs industriels car elle sépare la détection locale de l'analyse centralisée. La recherche sur la détection collaborative d'anomalies cloud-edge décrit cette division comme une réponse aux contraintes de latence et d'évolutivité, tandis que les travaux plus récents axés sur le edge se concentrent sur une détection en temps réel et économe en ressources.
Conservez les versions des artefacts de modèle sur tous les sites. Enregistrez la configuration du capteur, les définitions des caractéristiques, l'état d'étalonnage et la version du modèle avec chaque alerte. Conservez suffisamment de contexte brut autour d'un incident pour le débogage post-hoc, mais définissez la rétention de manière délibérée car les fenêtres de données brutes à haute fréquence peuvent rapidement s'accumuler.
Choisissez en fonction de trois questions : à quelle vitesse la décision doit-elle être prise, les signaux bruts peuvent-ils quitter l'installation, et quelle puissance de calcul l'appareil local peut-il supporter. La réponse conduit souvent à un déploiement hybride : évaluation locale avec réentraînement et investigation centralisés.
Passer au direct en toute confiance
Un modèle ne compense pas un flux de travail d'alertes auquel on ne fait pas confiance. Les opérateurs jugent le système selon que les alertes arrivent à des moments utiles, contiennent suffisamment de contexte et distinguent un événement digne d'action d'une variation ordinaire du processus. Le réalisme opérationnel doit décider de la mise en service d'un détecteur, et non la nouveauté architecturale.
Exécuter la liste de contrôle pré-lancement
Commencez par une exécution en mode miroir aux côtés des règles existantes pendant deux à quatre semaines, en utilisant l'intervalle spécifié dans le plan de lancement plutôt que de le traiter comme une garantie universelle. N'agissez pas encore sur les nouvelles alertes. Comparez-les avec les registres de maintenance, les notes d'opérateur, les interventions connues et le flux d'alertes existant.

Ajustez ensuite la sensibilité en fonction des comportements observés :
Exécution en mode miroir (shadow run) : Identifiez les alertes qui auraient atteint les opérateurs et vérifiez si elles correspondent à des événements reconnaissables.
Réglage des seuils : Équilibrez les événements manqués par rapport à la charge d'alertes en utilisant de vraies périodes de fonctionnement, et non de simples relectures de fichiers de benchmark.
Plan de repli : Définissez le retour arrière (rollback), le contournement manuel et le comportement sécurisé lorsque le modèle, le pipeline de caractéristiques, la passerelle ou le flux de données amont échouent.
Surveillance continue : Suivez la dérive des données d'entrée, la disponibilité des caractéristiques, les distributions de scores, les résultats d'alertes et les performances du modèle après le Release.
La surveillance des modèles nécessite une boucle de rétroaction sur les incidents. Le réentraînement doit faire suite à des incidents étiquetés vérifiés et à des changements significatifs dans le comportement opérationnel, et non à une date de calendrier choisie par commodité. Si un capteur est remplacé, qu'un processus change ou qu'une action de maintenance réinitialise le comportement de la machine, enregistrez ce contexte afin que le modèle n'apprenne pas l'intervention comme une anomalie inexpliquée.
Rendre l'escalade explicite
Les anomalies critiques doivent être acheminées vers les ingénieurs d'astreinte dans le cadre d'un objectif de latence défini. Les événements de gravité moindre peuvent entrer dans une file d'attente d'examen hebdomadaire, où les ingénieurs examinent les profils, confirment les étiquettes et décident si la base de référence ou l'ensemble de caractéristiques a besoin d'un ajustement. Chaque alerte doit indiquer l'actif concerné, l'horodatage, les canaux contributeurs, les valeurs des caractéristiques, la version du modèle et un lien vers la fenêtre de données brutes correspondante.
La véritable métrique de succès est la confiance des opérateurs. Un détecteur gagne son statut de production lorsque les gens agissent sur ses alertes sans hésiter à chaque fois.
Un système qui minimise les faux positifs sur un benchmark mais submerge une équipe de quart a échoué. Un détecteur plus simple qui capture les bons événements, explique son score et se dégrade de manière sécurisée peut apporter plus de valeur qu'un modèle complexe que personne ne peut maintenir. Le but de la détection d'anomalies de données de capteurs n'est pas de produire des métriques impressionnantes de manière isolée. Il s'agit de donner aux personnes responsables des équipements des preuves opportunes et suffisantes pour prendre une meilleure décision.
digna aide les équipes à surveiller les comportements de données anormaux, la Timeliness, les règles de validation et les changements structurels au sein de leur propre environnement, ce qui complète les pipelines d'anomalies de capteurs qui dépendent d'entrées fiables. Visitez digna pour voir comment son approche de l'observabilité en base de données peut vous aider à détecter les lacunes de données et les mouvements inattendus avant qu'ils ne compromettent la surveillance industrielle.
Questions fréquentes
Pourquoi la détection d'anomalies sur capteurs est-elle plus difficile qu'il n'y paraît ?
Parce que le normal est un contexte de fonctionnement appris, pas un nombre figé. Un capteur de vibration de turbine peut rester presque plat pendant des heures après le desserrage d'un support : un seuil fixe annonce donc la bonne santé alors que l'état mécanique a déjà changé.
Quelles contraintes de production cassent un modèle capteur ?
Six reviennent : changements de régime liés à la charge, à la vitesse et aux équipes ; dérive du capteur due au calibrage et au vieillissement ; canaux corrélés réagissant à la même condition ; échantillonnage inégal rendant trompeuses les jointures ligne à ligne ; étiquettes tardives issues de la maintenance ; et contraintes de latence quand une décision de sécurité doit se prendre près de la machine.
Comment préparer les variables de capteurs ?
Alignez le temps avant tout calcul. Choisissez une cadence d'analyse compatible avec le budget de latence du détecteur, rééchantillonnez chaque canal délibérément, et conservez les horodatages d'origine ou les indicateurs de qualité pour les équipements multimodaux. Les valeurs brutes sont de faibles entrées sans contexte de fonctionnement.
Quelles variables attrapent quelles défaillances ?
Accordez la variable au motif. Un z-score glissant mesure l'écart à une moyenne récente relativement à la variation récente, une fenêtre plus longue comme 30 minutes révèle une dérive lente qu'une fenêtre courte absorbe comme normale, la différenciation répond à une autre question, et les variables de décalage donnent aux modèles classiques un historique récent compact.
Pourquoi la précision des benchmarks ne survit-elle pas à la production ?
Parce que les jeux de données propres omettent précisément les conditions qui provoquent la panne : changements de régime, dérive, canaux corrélés, échantillonnage inégal et étiquettes incertaines. Les contrôles du pipeline environnant comptent aussi, car ils distinguent une vraie anomalie machine d'un flux tardif, manquant, malformé ou structurellement modifié.



