Connecteur JDBC SQL Server : Guide d'installation et de configuration
|
8
minute de lecture
Une connexion SQL Server peut sembler saine pendant des mois, puis un correctif de routine, une mise à niveau de la JVM ou un rafraîchissement des dépendances la fragilise du jour au lendemain. Les pires cas sont ceux qui n'échouent pas de manière flagrante, mais qui se traînent avec des avertissements de certificat, des sessions de pool qui se bloquent ou des comportements de types de données qui changent juste assez pour casser la logique en aval. C'est pourquoi le connecteur JDBC SQL Server doit être traité comme une dépendance gérée, et non comme une installation ponctuelle.
Les équipes commencent généralement par une chaîne de connexion et passent à autre chose. La production a tendance à exposer le travail caché : l'alignement des versions de pilotes, la compatibilité de l'environnement d'exécution Java, la validation TLS, le choix du mode d'authentification, le réglage du pool et la planification du cycle de vie du support. L'histoire même des pilotes de Microsoft montre un long parcours de maintenance, avec le connecteur introduit en 2000 et passé en open source en 2016, puis livré via des versions telles que la 1.0 en janvier 2006, la 2.0 en mars 2009, la 3.0 en avril 2010, la 4.0 le 6 mars 2017, et des versions ultérieures incluant la 4.1, la 6.0, la 7.0 et la 8.4 atteignant leurs propres jalons de support au fil du temps Notes de version du pilote JDBC Microsoft. Cette chronologie en dit long : le connecteur évolue avec la plateforme, et votre posture de production doit évoluer avec lui.
Table des matières
Pourquoi la configuration du connecteur JDBC exige de l'attention
Choisir la bonne version de pilote et l'environnement d'exécution Java
Sélectionner les modes d'authentification pour les environnements d'entreprise
Configuration du chiffrement TLS et de la validation des certificats
Optimisation du regroupement de connexions et du comportement de tentative
Prise en charge des fonctionnalités et types de données SQL Server modernes
Exemples de configurations pour l'ingestion de données et l'exécution en base de données
Pourquoi la configuration du connecteur JDBC exige de l'attention
Une défaillance familière commence par un déploiement qui semblait correct hier. Le pipeline se connecte, insère quelques lignes, puis un correctif SQL Server est appliqué. Le lendemain matin, le travail commence à générer des erreurs de handshake sur certains hôtes seulement, ou pire, il continue de s'exécuter alors que le serveur refuse le style de connexion vers lequel le client s'est rabattu.
Ce genre de panne est courant car une mauvaise configuration JDBC se situe souvent en dessous du niveau où les ingénieurs la remarquent immédiatement. Une API REST échoue généralement à la frontière. Un connecteur de base de données peut à l'inverse créer des dommages opérationnels subtils : sessions de pool obsolètes, tentatives en double, contournements de certificats ou comportements de données qui ne changent que sous charge. Le cycle de vie des pilotes de Microsoft rend cela plus important, et non moins, car les anciennes versions majeures sortent du support standard tandis que les nouvelles versions continuent d'ajouter des comportements prenant en compte la plateforme notes de version et matrice de support.
Le coût caché du « ça se connecte »
Une connexion qui fonctionne ne signifie pas qu'elle est sécurisée. Le pilote JDBC Microsoft est un pilote JDBC de type 4, il communique donc directement avec le protocole TDS de SQL Server en Java pur, sans bibliothèques natives, et Microsoft indique qu'il prend en charge Azure SQL Database, SQL database dans Fabric, Azure SQL Managed Instance, ainsi que toutes les versions et éditions prises en charge de SQL Server, y compris les éditions Express présentation du pilote. Cette large compatibilité est utile, mais elle permet également de passer facilement à côté d'une mauvaise configuration jusqu'à ce qu'un runtime, une chaîne de certificats ou une fonctionnalité de serveur spécifique soit sollicité.
Règle pratique : si un connecteur JDBC n'a jamais été testé par rapport à la JVM exacte, à la build du pilote et au niveau de correctif SQL Server en production, il n'est pas réellement testé.
Le changement est mental. Arrêtez de penser au connecteur comme à de la plomberie et commencez à le considérer comme une dépendance d'exécution versionnée avec des limites de sécurité et de cycle de vie. Ce cadrage vous évite de supposer qu'une propriété par défaut, une mise à niveau Java ou un correctif SQL Server peut être ignoré simplement parce que l'application démarre toujours.
Choisir la bonne version de pilote et l'environnement d'exécution Java
Le choix du pilote détermine la stabilité de l'exécution et la continuité du support. Microsoft publie plusieurs gammes de connecteurs en même temps, le bon choix dépend donc de votre runtime Java, des fonctionnalités SQL Server que vous utilisez et de la pression de mise à niveau que vous pouvez absorber sans créer d'interruptions de service. Le dernier pilote GA est le 13.4, sorti le 13 mars 2026, et Microsoft indique qu'il prend en charge Java 8, 11, 17, 21 et 25 tout en suivant un cycle de vie fixe qui nécessite l'installation de la dernière version mineure dans les 12 mois suivant sa sortie pour conserver un support complet notes de version et matrice de support. Cette règle de support transforme les mises à niveau différées en un véritable risque opérationnel.
Épingler l'artefact à l'environnement d'exécution
Microsoft livre des variantes de fichiers JAR distinctes, et jre8 et jre11 doivent correspondre à la version de la JVM utilisée. Alignez l'artefact avec votre version de JVM pour éviter le débogage du classpath et de l'environnement d'exécution sous pression. La version 13.4 maintient l'histoire de la compatibilité à jour et indique clairement sa prise en charge de Java, ce qui importe dans les parcs d'entreprise où la pile applicative et la plateforme d'exécution n'évoluent pas ensemble notes GA 13.4.
Figez la version exacte du pilote dans Maven ou Gradle au lieu de laisser dériver les dépendances transitives. Dans les environnements isolés (air-gapped), copiez le JAR dans le package de déploiement et traitez-le comme une dépendance gérée, et non comme un fichier qui se trouve là par hasard sur le disque. Vérifiez également attentivement les classpaths des serveurs d'applications, car les anciens pilotes intégrés peuvent masquer la version que vous aviez l'intention d'exécuter.
Version du pilote | Environnement d'exécution Java | Versions SQL Server | Fonctionnalités clés | Statut du support |
|---|---|---|---|---|
13.4 | 8, 11, 17, 21, 25 | Cibles SQL Server modernes et Azure SQL | Gestion des métadonnées VECTOR et JSON, mises à jour de sécurité, compatibilité Java 21 | Dernière GA, le support dépend de la fraîcheur de la version mineure |
12.x | 8, 11, 17 | Large compatibilité SQL Server | Base de référence d'entreprise stable | À utiliser uniquement si votre runtime ou votre plateforme bloque les gammes plus récentes |
11.x | 8, 11 | Anciens parcs d'entreprise | Ensemble de fonctionnalités plus ancien | Souvent acceptable pour les systèmes existants, mais pas idéal pour les nouvelles constructions |
10.x | 8, 11 | Compatibilité héritée | Comportement pré-changement par défaut pour le chiffrement | Attention aux différences de valeurs par défaut TLS |
9.x | 8 | Parcs plus anciens | Connectivité de base | À conserver uniquement lorsque les contraintes de la plateforme l'imposent |
Savoir quand jTDS ne suffit plus
jTDS apparaît encore dans les parcs plus anciens, généralement parce que quelqu'un a copié une configuration fonctionnelle il y a des années et que personne ne l'a réexaminée. Le problème est la dérive des fonctionnalités. Si votre environnement a besoin de chemins d'authentification modernes, d'une gestion TLS actuelle ou d'une sémantique SQL Server plus récente, jTDS devient un handicap pour la migration.
Utilisez le pilote Microsoft lorsque la charge de travail touche aux fonctionnalités actuelles de SQL Server, aux exigences de sécurité récentes ou à l'authentification alignée sur Azure. Si vous maintenez un connecteur plus ancien en place, documentez-en la raison et définissez un plan de sortie. Une dette technique non gérée se transforme en incident de production au pire moment possible.
Construire correctement l'URL de connexion
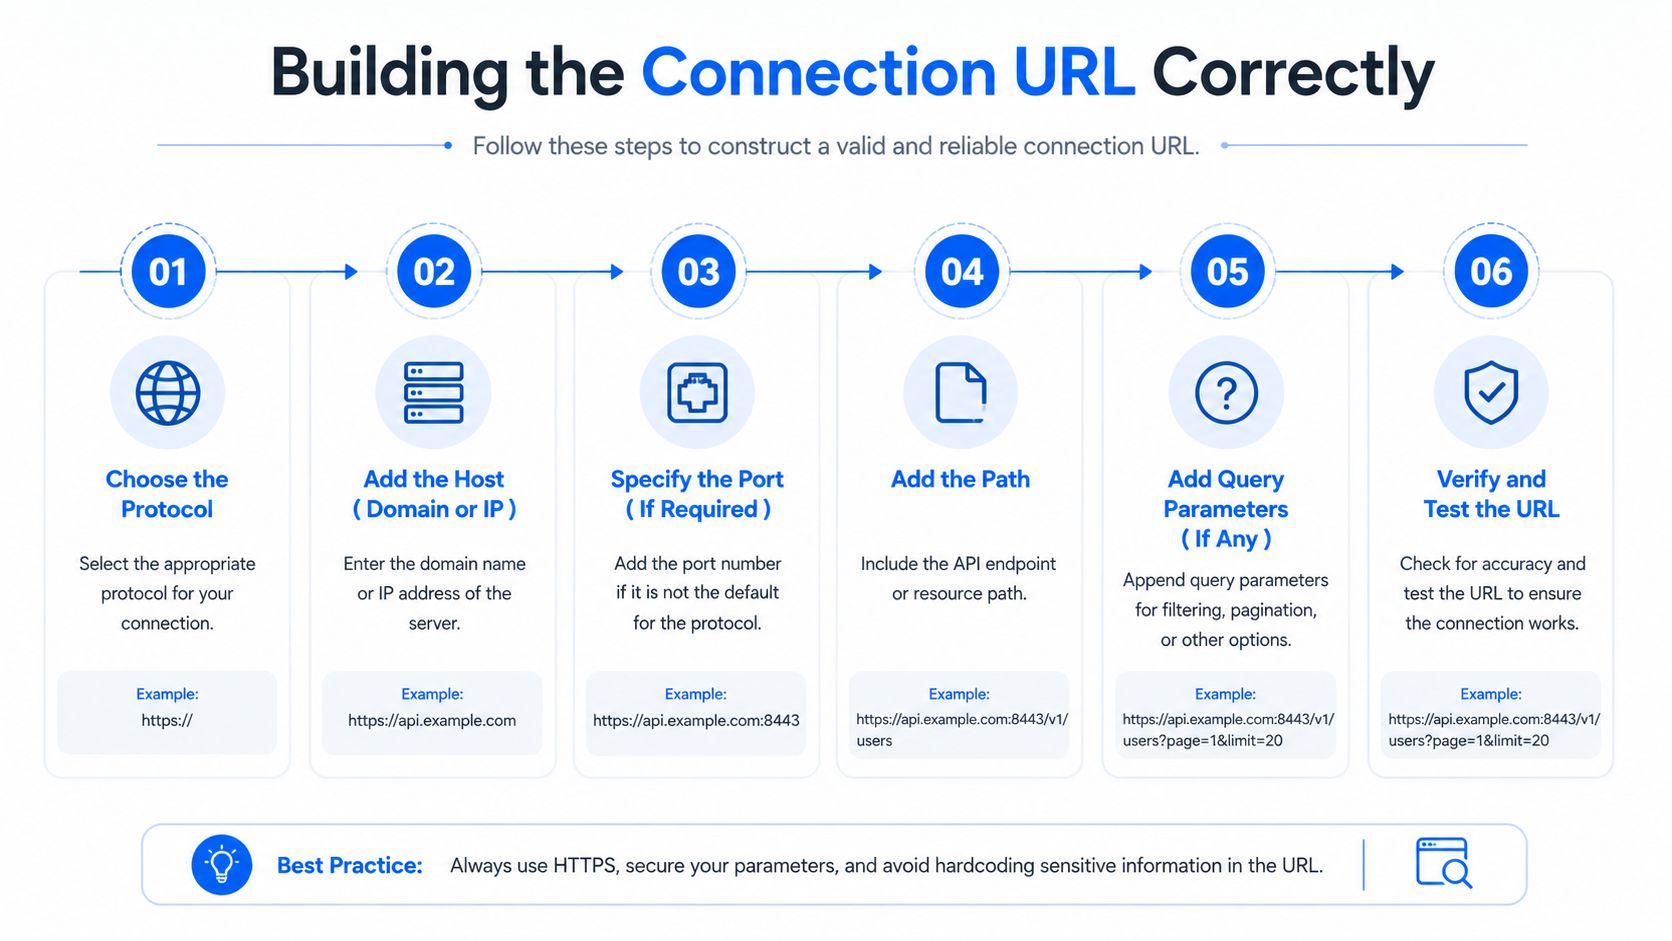
Une URL de connexion JDBC SQL Server ne reste gérable que si vous la construisez dans le bon ordre. Commencez par l'hôte, l'instance et le port, puis ajoutez la base de données et les propriétés qui affectent le comportement. La forme standard est jdbc:sqlserver://[nomServeur[\nomInstance][:numéroPort]][;propriété=valeur[;propriété=valeur]], et Microsoft autorise ces propriétés dans l'URL, dans un objet Properties transmis à DriverManager.getConnection, ou via les setters de SQLServerDataSource documentation sur l'URL de connexion. La syntaxe est stricte, délimitée par des points-virgules, et les propriétés en double sont rejetées.
Pour les pipelines d'ingestion, la chaîne de connexion n'est qu'une partie d'un parcours opérationnel plus large. Le guide du pipeline d'ingestion de données de digna est un rappel utile que les paramètres du connecteur doivent survivre au transfert entre les environnements, les tâches et les outils de déploiement.
Construire à partir de la cible réseau vers l'extérieur
Commencez par le point de terminaison, puis l'instance ou le port, puis la base de données, puis les propriétés. Cet enchaînement évite qu'une simple erreur d'hôte ou de port ne se retrouve noyée dans une longue suite d'options.
Concernant le comportement des propriétés, les détails pratiques importent :
applicationNameest défini par défaut surMicrosoft JDBC Driver for SQL Serveret est limité à 128 caractères, configurez-le donc explicitement si vous souhaitez que les traces côté serveur soient utiles propriétés de connexion.databaseNamea également une limite de 128 caractères et, à défaut, se rabat sur la base de données par défaut du serveur propriétés de connexion.connectRetryCountest défini par défaut sur 1 et peut aller de 0 à 255 propriétés de connexion.connectRetryIntervalest défini par défaut sur 10 secondes et peut aller de 1 à 60 secondes propriétés de connexion.
Placez les paramètres durables dans le code ou l'infrastructure-as-code, pas dans des modifications ponctuelles de chaînes de caractères qui dérivent entre les environnements.
Préférer les propriétés DataSource pour des déploiements répétables
Utilisez les propriétés de DataSource pour les déploiements mutualisés (pooled). La configuration basée sur les setters est vérifiable et résiste aux surcharges de valeurs. Elle est également plus facile à comparer (diff) lorsque la même définition d'application est réutilisée sur plusieurs chemins d'exécution, ce qui est courant dans des frameworks comme HikariCP.
Sélectionner les modes d'authentification pour les environnements d'entreprise
La connectivité d'entreprise à SQL Server repose rarement sur un seul modèle d'authentification. Les équipes utilisent l'authentification SQL pour la simplicité, l'authentification intégrée Windows pour la confiance de domaine, les flux Entra ID pour l'alignement cloud et l'identité gérée là où la plateforme la prend en charge. Le bon choix dépend moins des préférences que de la politique de rotation, des limites de fédération et du niveau de friction que votre équipe de sécurité est prête à tolérer.
Faire correspondre le mode au réseau et au modèle d'identité
L'authentification SQL est simple, mais elle rejette la gestion des identifiants sur l'application. C'est acceptable pour les charges de travail isolées et les validations de principe de courte durée, mais c'est rarement la solution la plus propre pour la governance d'entreprise. L'authentification intégrée a tendance à mieux convenir aux environnements de domaine Windows, tandis qu'Entra ID est le choix naturel lorsque l'organisation utilise déjà les contrôles d'identité Microsoft et les modèles d'accès basés sur les jetons.
Kerberos peut être performant dans les réseaux d'entreprise gérés, mais il dépend du comportement correct des SPN et des tickets. Si les SPN sont incorrects, les équipes constatent souvent un repli vers NTLM ou des problèmes de connexion intermittents qui n'apparaissent que lorsque le pool rafraîchit les sessions. Les approches basées sur les jetons résolvent une autre catégorie de problèmes, mais elles introduisent des dépendances de rafraîchissement et de bibliothèques qui doivent être planifiées dans les tâches de longue durée.
Mode d'authentification | Propriétés requises | Idéal pour | Pièges courants | Rotation des identifiants |
|---|---|---|---|---|
Authentification SQL | username, password | Comptes d'application simples, systèmes existants | Dispersion des mots de passe, charge de rotation manuelle | Manuelle, gérée par l'application |
Authentification intégrée Windows | paramètres d'authentification intégrée, configuration liée à Kerberos | Environnements d'entreprise joints à un domaine | Problèmes de SPN, expiration de ticket, surprises de repli | Gérée par l'infrastructure d'identité |
Entra ID intégré |
| Parcs d'identités centrés sur Microsoft | Changements de dépendance de bibliothèque, lacunes dans la gestion des jetons | Rotation centralisée des identités |
Identité gérée | liaison d'identité cloud | Charges de travail hébergées sur Azure avec identité de plateforme | Incompatibilité de portée et d'environnement | Gérée par la plateforme |
Traiter le rafraîchissement des jetons comme faisant partie de la conception
Les tâches d'ingestion de longue durée échouent de manière brutale lorsque les jetons d'authentification expirent en plein milieu du pool. Il ne s'agit pas tant d'un bug du connecteur que d'un décalage de cycle de vie entre la méthode d'identité et la durée de la tâche. La conception la plus sûre est celle où le cycle de vie des identifiants est visible pour l'opérateur, et non masqué dans un pool de connexions qui réutilise des sessions obsolètes.
La question d'aide à la décision est simple. Votre équipe opérationnelle peut-elle expliquer comment les identifiants tournent, comment les sessions se renouvellent et ce qui se passe lorsqu'un jeton expire pendant qu'un autre thread emprunte une connexion ? Si ce n'est pas le cas, le mode n'est pas prêt pour la production.
Configuration du chiffrement TLS et de la validation des certificats
La mauvaise configuration de TLS est la source la plus courante d'échecs JDBC silencieux en production. Microsoft documente les paramètres de sécurité de la connexion autour de encrypt, trustServerCertificate, trustStore, trustStorePassword et hostNameInCertificate, et recommande explicitement hostNameInCertificate pour la validation des certificats Prise en charge de TLS. Microsoft indique également que lorsque encrypt=true et trustServerCertificate=true, le pilote ne valide pas le certificat TLS de SQL Server, tandis que encrypt=true et trustServerCertificate=false le valide Comportement du chiffrement SSL.
Don't confuse encryption with validation
Le chiffrement et la validation répondent à des risques différents. Une connexion chiffrée qui fait confiance à n'importe quel certificat protège le canal mais pas l'identité du serveur. C'est acceptable dans un laboratoire, mais c'est une mauvaise posture de production pour un accès de base de données.
Microsoft documente un changement de comportement dans les versions de pilotes 10.1+, où encrypt est défini par défaut sur true. Les équipes qui mettent à niveau sans revérifier leurs paramètres de magasin de confiance et de nom d'hôte sont surprises lorsqu'une connexion auparavant permissive commence à échouer. Si le serveur n'est pas configuré pour le chiffrement, Microsoft indique que encrypt=true avec trustServerCertificate=false échouera, la gestion des certificats et des noms d'hôtes fait donc partie de la préparation à la production Prise en charge de TLS.
Les modèles de production sont simples :
Développement avec des certificats auto-signés, utilisez le chiffrement uniquement si vous acceptez l'échec de la validation pendant les tests.
Production avec des certificats d'autorité de certification interne, définissez
encrypt=true,trustServerCertificate=false, et configurez correctement le magasin de confiance.Azure SQL, utilisez des connexions chiffrées et validez le chemin du certificat attendu par la plateforme.
Les noms d'hôtes importent plus que ce que les équipes imaginent
hostNameInCertificate corrige les cas où le nom du certificat du serveur ne correspond pas à la cible de connexion du client. Microsoft recommande cette propriété précisément pour ce décalage, transformant une erreur TLS opaque en un changement de configuration clair Prise en charge de TLS.
Les JVM compatibles FIPS ajoutent un autre niveau de risque. L'ordre des fournisseurs peut casser le handshake si la JVM résout les primitives TLS dans une séquence inattendue. Des modifications de durcissement comme celle-ci nécessitent des tests de type production, avec la même posture de sécurité que celle que vous exécuterez en production.

Optimisation du regroupement de connexions et du comportement de tentative
Les paramètres de pool par défaut sont généralement trop indulgents pour les charges de travail de l'ingénierie des données. Ils supposent des requêtes courtes, une simultanéité modeste et une base de données toujours prête à répondre immédiatement. Cela ne correspond pas aux pics d'ETL, aux événements de basculement ou aux requêtes analytiques qui conservent les sessions plus longtemps qu'un cycle de requête web.
Séparer l'échec de connexion de l'échec de requête
loginTimeout et socketTimeout résolvent des problèmes différents, ils ne doivent donc pas être traités comme un seul et même bouton. Une connexion peut ne pas s'ouvrir rapidement, ou s'ouvrir puis se bloquer pendant l'activité réseau ou de requête. Si les deux délais d'expiration restent flous, le pool continue d'attendre tandis que les threads s'accumulent derrière des connexions mortes.
Les paramètres de tentative intégrés de Microsoft sont suffisamment spécifiques pour être utilisés délibérément. connectRetryCount est défini par défaut sur 1, et connectRetryInterval sur 10 secondes propriétés de connexion. Ces valeurs par défaut conviennent comme point de départ, mais elles ne remplacent pas une validation au niveau du pool et une politique de gestion des pannes.
Propriété | Requêtes OLTP | Ingestion de masse | Requêtes analytiques | Valeur par défaut |
|---|---|---|---|---|
loginTimeout | Court | Modéré | Modéré | Non spécifié dans les données vérifiées |
socketTimeout | Court | Plus long | Plus long | Non spécifié dans les données vérifiées |
queryTimeout | Court | Modéré | Plus long | Non spécifié dans les données vérifiées |
connectRetryCount | Faible à modéré | Modéré | Modéré | 1 |
connectRetryInterval | Court | Modéré | Modéré | 10 secondes |
Optimiser pour la charge de travail, pas pour le modèle
Les charges de travail OLTP ont besoin d'une défaillance rapide et d'une rotation rapide des emprunteurs de connexions. L'ingestion en masse nécessite de la patience pendant les périodes de tension sur le réseau et le serveur. Les requêtes analytiques se situent quelque part au milieu, elles ont besoin de suffisamment de temps pour se terminer sans épuiser le pool, mais pas au point qu'une mauvaise requête bloque indéfiniment les ressources.
Pour les travaux de résilience, Le guide de l'ingénierie de la fiabilité des bases de données de digna est une référence complémentaire pertinente car le comportement du connecteur et la résilience de la base de données sont indissociables en production. Un pool qui effectue des tentatives de manière trop agressive peut amplifier le bruit d'une panne, tandis qu'un pool qui échoue trop vite peut transformer des micro-coupures passagères en incidents visibles pour l'utilisateur.
Règle pratique : dimensionnez le pool pour la simultanéité réelle, et non pour le nombre maximal de threads que le serveur d'applications peut générer.
La stratégie de validation est également importante. testOnBorrow détecte les mauvaises sessions plus tôt, tandis que testWhileIdle répartit le coût de la validation dans le temps. Choisissez l'approche qui correspond à votre tolérance au basculement et à votre tolérance à l'emprunt d'une connexion obsolète lors d'une brève panne de SQL Server.
Prise en charge des fonctionnalités et types de données SQL Server modernes
Les fonctionnalités modernes de SQL Server évoluent plus vite que la plupart des documentations JDBC. Le connecteur n'est plus seulement une couche de transport, il détermine si votre application peut conserver sans surprise les nouvelles sémantiques du serveur, le comportement de sécurité et la forme des métadonnées.
La version 13.4 de Microsoft ajoute la compatibilité avec Java 21 et des améliorations de support pour les nouvelles capacités de SQL Server telles que la gestion des métadonnées VECTOR et JSON, ainsi que des correctifs de sécurité pour plusieurs CVE et aucun changement d'API perturbateur notes GA 13.4. Cela compte en production car un pilote peut sembler stable tout en manquant des éléments nécessaires pour interpréter correctement les nouveaux comportements du serveur.
Vérifier la prise en charge des fonctionnalités avant de mettre à niveau le serveur
Les équipes mettent souvent à niveau SQL Server en premier et découvrent ensuite que le pilote ne peut pas exprimer clairement le nouveau comportement. Il en résulte généralement des valeurs tronquées, des erreurs de conversion ou des appels de métadonnées qui ne correspondent pas à la forme des types plus récents. Les notes des versions 13.2 et 13.4 de Microsoft montrent une expansion constante du support natif pour les types de données JSON et VECTOR, en plus d'améliorations concernant la copie en masse (bulk copy) et la gestion des métadonnées version 13.2, notes GA 13.4.
Traitez la version du pilote comme une étape clé de la validation des fonctionnalités. Si l'application dépend du chiffrement des colonnes, de l'identité basée sur des jetons ou du routage en lecture seule, vérifiez ces paramètres par rapport à la build exacte du connecteur avant de déployer le changement sur le serveur. L'alignement de l'environnement d'exécution Java importe également, puisque la version 13.4 est celle qui mentionne la compatibilité avec Java 21. Pour les charges de travail où la forme de la requête et l'accès aux métadonnées interagissent étroitement, Le guide d'optimisation des requêtes T-SQL de digna est un compagnon utile.
Fonctionnalité SQL Server | Version minimale du pilote JDBC | Propriété de connexion requise | Symptôme de défaillance si non pris en charge |
|---|---|---|---|
Prise en charge du type de données JSON | 13.2 | Configuration compatible avec la fonctionnalité | Incohérences de conversion ou de métadonnées |
Prise en charge du type de données VECTOR | 13.2 | Configuration compatible avec la fonctionnalité | Gestion native manquante ou incorrecte |
Compatibilité Java 21 | 13.4 | Alignement de l'environnement d'exécution Java | Incompatibilité d'exécution |
Validation IP SAN du certificat TLS | 13.4 | Configuration TLS | Échec de la validation lors de la connexion par IP via TLS |
Modernisation de l'authentification intégrée Entra | 13.4 |
| Le flux d'identité dépend de composants d'authentification plus récents |
Supposer que la sémantique peut changer même si les API ne changent pas
Un pilote peut toujours se charger et votre code peut toujours compiler alors que le comportement change sous la surface. Cela se produit le plus souvent lorsqu'une charge de travail mélange des appels de métadonnées, l'application de la sécurité et des types de données en évolution.
Un audit du pilote avant un déploiement de serveur coûte moins cher qu'un incident après le déploiement. C'est là qu'il faut consacrer du temps.
Exemples de configurations pour l'ingestion de données et l'exécution en base de données
L'ingestion par lots et l'exécution analytique nécessitent des stratégies de délai d'expiration et de tentative opposées. L'utilisation d'un profil pour l'autre produit une dégradation silencieuse des performances. Les tâches d'ingestion ont besoin de marge pour les tensions passagères et d'une configuration de pilote qui maintient le mouvement des lots. L'exécution analytique a besoin d'une défaillance plus rapide sur les sessions bloquées, d'une validation plus stricte et d'une identité de tâche claire pour que les traces du serveur restent lisibles.
Profil d'ingestion de données
Un travail axé sur le volume a besoin d'une fenêtre de socket suffisamment longue pour survivre à une pression temporaire, ainsi que de paramètres permettant au pilote de déplacer efficacement les lots. Traitez la version du pilote comme un élément de la conception de l'ingestion, et non comme un bruit de fond, car le comportement de la copie en masse change avec la build du connecteur et peut modifier la stabilité perçue d'une exécution d'ETL.
Une configuration d'ingestion pratique ressemble souvent à ceci, avec des valeurs non par défaut choisies pour maintenir la stabilité de l'ETL :
URL :
jdbc:sqlserver://warehouse-host;databaseName=staging;encrypt=true;trustServerCertificate=false;applicationName=ETL LoaderPropriétés :
connectRetryCount=2,connectRetryInterval=10,socketTimeoutdéfini pour des fenêtres de traitement par lots plus longues, et options de copie en masse activées là où la charge de travail en bénéficieJustification : éviter que le pool n'échoue lors de brèves turbulences tout en validant correctement le certificat du serveur
Pour les équipes qui construisent une couche de mouvement de bout en bout, une référence sur la construction de pipelines de données ETL est un compagnon utile pour le profil du connecteur lui-même. Elle aide à maintenir l'alignement de la conception du pipeline, du comportement des tentatives et des points de transfert au lieu de traiter les paramètres JDBC de manière isolée.
Profil d'exécution en base de données
L'exécution analytique nécessite le parti pris inverse. Le pilote doit échouer rapidement sur les sessions mortes ou bloquées, et l'application doit s'identifier clairement afin que le traçage côté serveur puisse l'associer à la tâche correspondante. Pour une charge de travail de reporting ou de transformation, cela signifie généralement resserrer les délais d'expiration, maintenir un chiffrement strict et éviter les choix de gestion des paramètres qui altèrent les plans de requête.
digna est une option pour la qualité des données en base de données et le travail de Observability lorsque les équipes souhaitent que les vérifications s'exécutent au sein de leur propre environnement plutôt que de déplacer les données pour inspection. Cela compte dans les parcs SQL Server où le chemin du connecteur, les transformations et la couche de surveillance doivent rester proches de la source de données.
Propriété de connexion | Valeur d'ingestion de données | Valeur d'exécution en base de données | Justification |
|---|---|---|---|
applicationName | ETL Loader | Analytics Runner | Rend les journaux du serveur lisibles |
connectRetryCount | Modéré | Faible | L'ingestion tolère mieux les tentatives temporaires |
socketTimeout | Plus long | Plus court | L'ingestion a besoin de plus de temps de traitement |
trustServerCertificate | false | false | La validation en production reste intacte |
encrypt | true | true | Maintenir le transport protégé |
sendStringParametersAsUnicode | Spécifique à la charge de travail | Spécifique à la charge de travail | Éviter les surprises de conversion implicite |
Les deux paramètres qui sont souvent mal copiés sont sendStringParametersAsUnicode et selectMethod. Si vous transposez le profil d'une charge de travail dans une autre sans les réexaminer, vous risquez de détériorer la qualité des plans d'exécution ou de ralentir le comportement par lots de manières difficiles à lier au connecteur.
Erreurs de production courantes et comment les corriger
Les mêmes erreurs apparaissent encore et toujours dans les incidents SQL Server JDBC. Elles sont banales, ce qui explique précisément pourquoi elles échappent aux revues de code. La plupart proviennent de l'hypothèse selon laquelle si la connexion s'ouvre, la configuration doit être correcte.
Les déclencheurs d'incidents habituels
Laisser encrypt=false dans un environnement qui attend un protocole TLS moderne est un chemin direct vers l'échec dès que la politique du serveur se durcit. Ne pas définir loginTimeout et socketTimeout de manière indépendante permet à une session bloquée de consommer un emplacement du pool pendant bien trop longtemps. Utiliser jTDS pour des comportements SQL Server plus récents crée une longue traîne d'incohérences de fonctionnalités. Ne pas figer la version du pilote permet à un rafraîchissement des dépendances de modifier le comportement sans déploiement délibéré.
Les valeurs par défaut de Microsoft pour certaines propriétés rendent également le débogage plus difficile si vous ne les surchargez jamais. applicationName est défini par défaut sur Microsoft JDBC Driver for SQL Server, ce qui n'est pas assez spécifique lorsque vous tracez un pipeline parmi d'autres propriétés de connexion. Un nom clair fait toute la différence entre deviner et savoir.
Le piège des paramètres Unicode mérite d'être signalé séparément. Lorsque sendStringParametersAsUnicode=true force une conversion implicite par rapport à des colonnes varchar, les performances de recherche d'index peuvent en souffrir car le serveur doit concilier les types de paramètres et de colonnes. Ce n'est pas un plantage du connecteur, mais c'est absolument un problème de production.
Des correctifs qui durent vraiment
Utilisez une liste de contrôle de déploiement, pas la mémoire collective. Confirmez la version du pilote, l'environnement d'exécution Java, la politique TLS, le mode d'authentification et les paramètres du pool avant le déploiement. Ensuite, vérifiez le chemin d'erreur exact auquel vous vous attendez lorsque le serveur est indisponible, que le certificat est invalide ou que la requête s'exécute plus longtemps que ce que le pool devrait autoriser.
Pour le contrôle opérationnel, Le guide des techniques de surveillance et d'audit des bases de données de digna s'intègre bien à l'examen des incidents JDBC car le connecteur échoue rarement de manière isolée. Il échoue dans le cadre d'un pipeline plus large, et vous avez besoin de journaux, de mesures de temps et de preuves de validation pour identifier quelle couche a cassé en premier.
Référence rapide des propriétés de connexion essentielles
Voici la fiche de synthèse à garder à portée de main lors des revues de code et des réponses aux incidents. Les bonnes valeurs par défaut dépendent de votre environnement, mais l'essentiel est de savoir quels boutons comptent le plus et lesquels ont changé de comportement d'une génération de pilote à l'autre.
Propriété | Par défaut | Plage recommandée | Quand surcharger |
|---|---|---|---|
encrypt | true dans les pilotes 10.1+ | Toujours actif pour la production | Surcharger uniquement lors de tests non-production contrôlés |
trustServerCertificate | false lorsque la validation est appliquée, mais le comportement dépend des associations | Conserver à false en production | À utiliser uniquement lorsque vous acceptez intentionnellement l'absence de validation de certificat |
hostNameInCertificate | Non spécifié | Définir explicitement lorsque les noms de certificats doivent être alignés | Surcharger chaque fois que la validation du nom d'hôte échouerait autrement |
applicationName | Microsoft JDBC Driver for SQL Server | Définir un nom descriptif spécifique à l'application | Surcharger pour chaque charge de travail de production |
databaseName | Base de données par défaut du serveur | Définir explicitement par charge de travail | Surcharger dès que la base de données cible est importante |
connectRetryCount | 1 | Petit entier positif basé sur la tolérance | Surcharger pour les charges de travail sensibles aux micro-coupures réseau |
connectRetryInterval | 10 secondes | Conserver dans une plage modérée | Surcharger lorsque le délai d'attente des tentatives doit correspondre aux SLO |
loginTimeout | Non spécifié dans les données vérifiées | Définir explicitement | Surcharger chaque fois que l'acquisition du pool ne peut pas rester bloquée indéfiniment |
socketTimeout | Non spécifié dans les données vérifiées | Définir explicitement | Surcharger pour toutes les charges de travail de production |
responseBuffering | Non spécifié dans les données vérifiées | Ajuster par charge de travail | Surcharger lorsque la mémoire et le comportement de récupération ont besoin d'être contrôlés |
selectMethod | Non spécifié dans les données vérifiées | Définir uniquement si vous en connaissez la raison | Surcharger lorsque le comportement de récupération hérité est requis |
packetSize | Non spécifié dans les données vérifiées | Ajuster prudemment | Surcharger pour les chemins d'accès volumineux ou sensibles à la latence |
L'essentiel à retenir est simple. Traitez le connecteur JDBC SQL Server comme une dépendance d'exécution gouvernée, et non comme une chaîne de caractères passe-partout. Si vous avez besoin d'aide pour durcir les versions de pilotes, la posture TLS et le comportement du connecteur au sein d'une véritable plateforme de données, visitez digna et évaluez comment une couche d'observabilité intégrée à votre environnement peut s'associer à vos charges de travail SQL Server.
Questions fréquentes
Quel type de pilote est le connecteur JDBC SQL Server ?
Un pilote JDBC de type 4 : il parle directement au protocole TDS de SQL Server en Java pur, sans bibliothèques natives. Microsoft indique qu'il prend en charge Azure SQL Database, SQL database dans Fabric, Azure SQL Managed Instance et toutes les versions et éditions supportées de SQL Server, y compris Express.
Quelle version de pilote et quel runtime Java utiliser ?
Le pilote GA le plus récent est 13.4, publié le 13 mars 2026, prenant en charge Java 8, 11, 17, 21 et 25. Le cycle de vie impose d'installer la dernière version mineure dans les 12 mois suivant sa sortie pour conserver le support complet : figez donc l'artefact délibérément.
Pourquoi les JAR jre8 et jre11 comptent-ils ?
Parce que Microsoft livre des variantes distinctes qui doivent correspondre à la ligne de JVM utilisée. Cela pèse surtout dans les parcs d'entreprise où la pile applicative et la plateforme d'exécution n'évoluent pas ensemble, précisément là où un artefact mal apparié survit sans être remarqué.
Pourquoi une connexion stable depuis des mois casse-t-elle soudain ?
Parce qu'une mauvaise configuration JDBC se situe généralement sous le seuil où les ingénieurs la remarquent. Un correctif de routine, une montée de JVM ou un rafraîchissement de dépendances modifie une couche, et une connexion qui fonctionne n'est pas une connexion sûre.
Quand un connecteur JDBC est-il réellement testé ?
Seulement après avoir été testé face à la JVM, au build du pilote et au niveau de correctif SQL Server exacts utilisés en production. Tout le reste valide un autre système que celui qui tombera en panne, et c'est pourquoi « ça se connecte » est un critère d'acceptation faible.


