Comment mesurer la complétude des données : 8 méthodes pratiques
|
8
minute de lecture
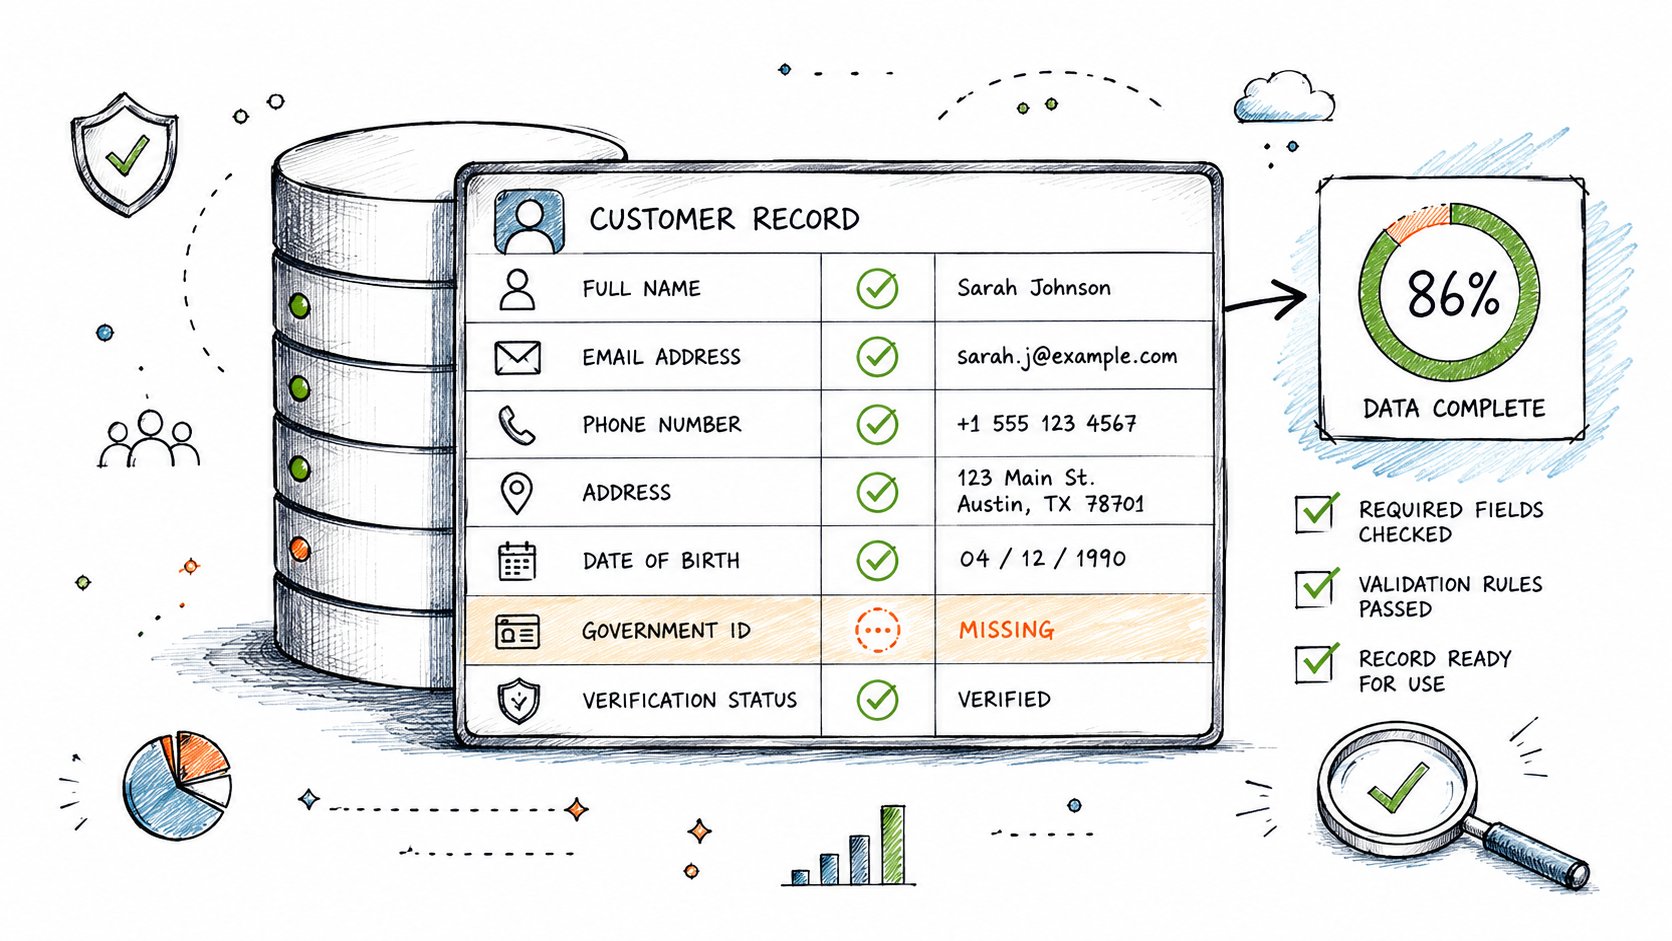
La complétude des données est mesurée en comparant les données requises présentes avec les données attendues. La formule de base est Taux de complétude = (Enregistrements avec données / Total des enregistrements) × 100. Ainsi, 9 800 numéros de téléphone renseignés sur 10 000 valeurs attendues produisent un taux de complétude de 98 % (Data Quality Sense explique le calcul standard).
Un pipeline de transactions peut signaler un chargement réussi tout en laissant l'entreprise avec des données incomplètes. Le nombre d'enregistrements peut chuter brusquement, les champs clients requis peuvent contenir plus de valeurs NULL que d'habitude, ou un fichier de rapport complet peut ne jamais arriver. Le pipeline a fonctionné, mais l'ensemble de données peut ne pas être assez complet pour la décision en attente en aval.
La complétude des données est le degré auquel toutes les données requises pour une utilisation prévue sont présentes. Cela inclut les valeurs de champ manquantes, les enregistrements manquants, les transactions manquantes, les ensembles de données manquants, les périodes historiques manquantes et les attributs requis manquants. Un enregistrement client avec un nom et une adresse valides mais sans identifiant client est incomplet pour tout processus qui dépend de cet identifiant.
Une surveillance fiable doit donc aller au-delà d'un simple pourcentage. Elle doit examiner les champs renseignés, les enregistrements complets, les volumes d'enregistrements, les ensembles de données attendus, les délais de livraison et les changements historiques inhabituels. Les huit méthodes pratiques ci-dessous construisent cette vue étape par étape, puis connectent chaque mesure à la validation, à la détection d'anomalies, à la ponctualité et à l'analyse historique dans digna.
Table des matières
5. Vérification de la complétude des ensembles de données et des périodes
6. Détection d'anomalies et analyse des tendances historiques pour la complétude
7. Complétude des données par rapport à l'évaluation de l'exactitude et de la validité
Comparaison en 8 points : comment mesurer la complétude des données
Du pourcentage de complétude à la confiance dans les données
1. Taux de complétude des champs
Un profil client peut contenir un nom et une adresse tout en restant inutilisable si son identifiant client requis est vide. Le taux de complétude des champs mesure ce premier niveau de complétude : combien de valeurs attendues dans une colonne sont renseignées. Les NULL, les chaînes vides et les autres marqueurs de valeur manquante définis font partie de la vérification.
Utilisez le calcul suivant :
Taux de complétude = valeurs renseignées / valeurs attendues × 100
Par exemple, si une table de comptes contient 4 500 adresses e-mail attendues et que 4 365 sont renseignées, le taux de complétude des champs est de 97 %. Cette méthode basée sur le pourcentage suit les conseils de complétude de Data Quality Sense.
Le dénominateur doit correspondre à la règle métier. Un identifiant client peut être requis pour chaque transaction, de sorte que toutes les lignes de transaction appartiennent au dénominateur. Un champ qui s'applique uniquement aux clients éligibles doit être mesuré par rapport à cette population éligible. Compter les lignes inapplicables comme manquantes rendrait le score moins bon que le processus ne l'est réellement.
Définir des seuils par utilisation métier
100 % est le point de référence idéal pour de nombreux champs régis. Les niveaux de service des champs requis peuvent être fixés au-dessus de 95 %, en fonction du risque métier et des conséquences des valeurs manquantes, comme SailPoint décrit ces pratiques de définition d'objectifs. Un identifiant de transaction peut nécessiter une couverture complète, tandis qu'un attribut descriptif à moindre risque peut autoriser une absence de données limitée si les utilisateurs en aval connaissent la contrainte.
Définissez un seuil pour chaque champ important au lieu de vous fier à une seule moyenne d'ensemble de données. Une moyenne peut masquer un écart important dans une colonne d'identifiant. Data Quality Sense recommande de traiter le taux de nullité comme un signal de complétude central, associez donc ce taux à des vérifications explicites de valeurs NULL et vides.
Dans digna, la digna Data Validation peut exécuter ces vérifications pour les identifiants clients, les montants des transactions, les horodatages, les numéros de compte et d'autres attributs obligatoires. Enregistrez les résultats par champ et par système source. Cet historique prend en charge la validation lors de l'ingestion, la détection d'anomalies après un changement et la comparaison ultérieure de la complétude entre les périodes.
Règle pratique : Documentez les champs requis par chaque processus métier avant de définir les seuils. Un pourcentage n'a de sens que lorsque sa population attendue et son utilisation prévue sont claires.
2. Surveillance du nombre d'enregistrements
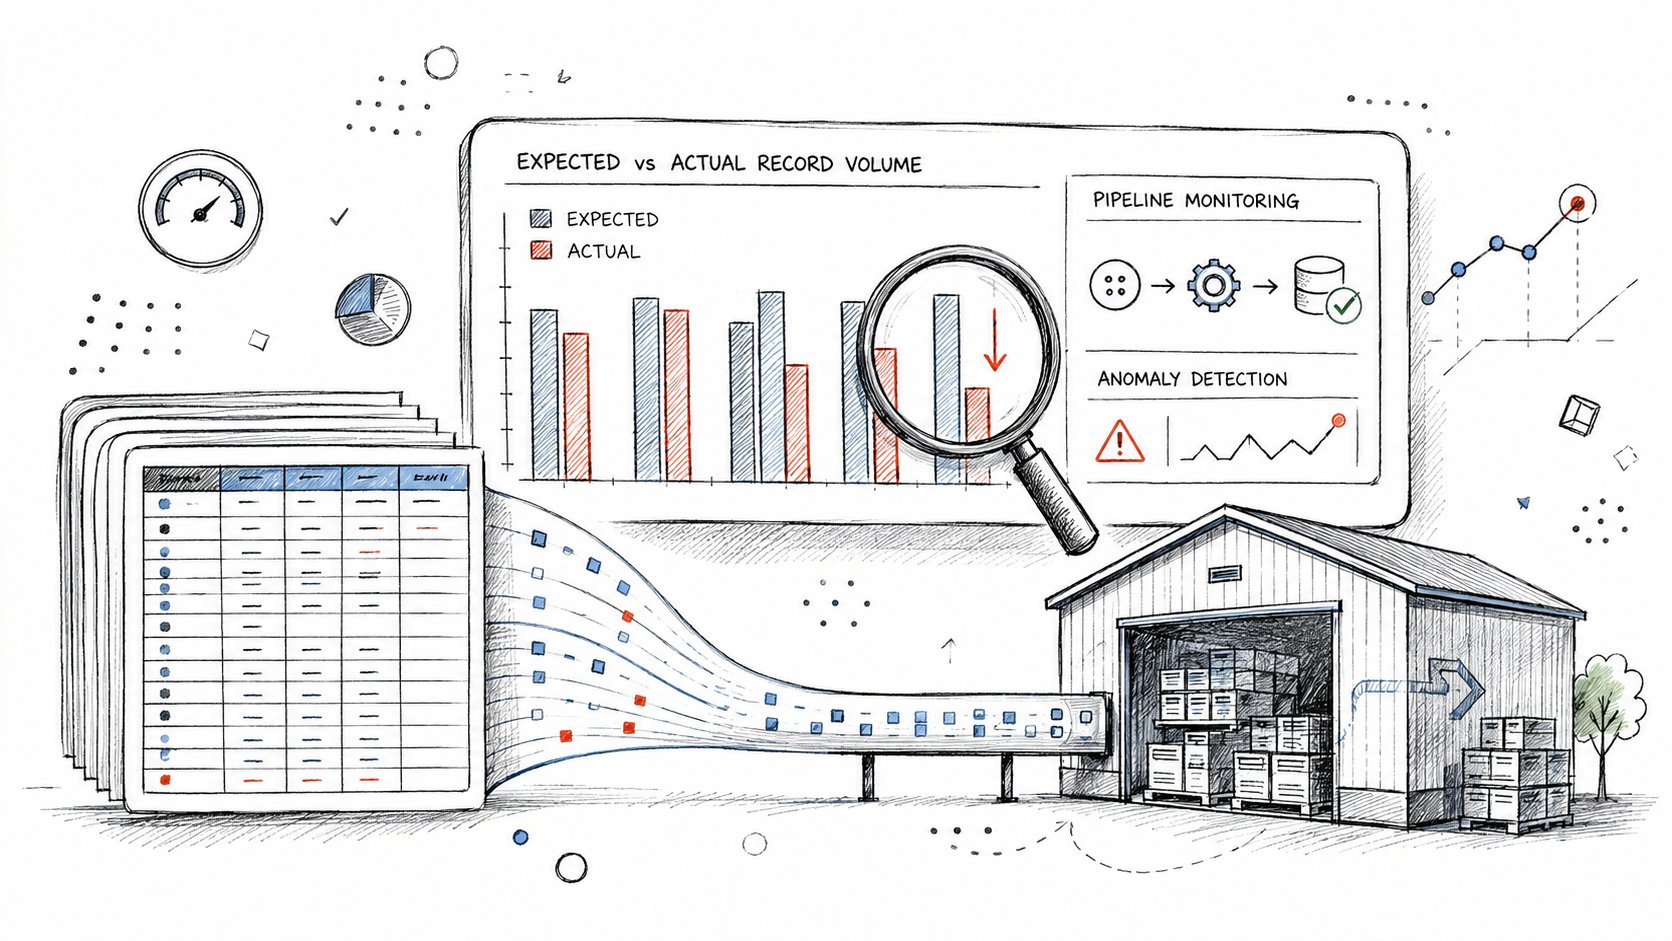
Un ensemble de données peut contenir des champs bien renseignés tout en étant incomplet parce que des enregistrements entiers ne sont jamais arrivés. La surveillance du nombre d'enregistrements compare le nombre de lignes chargées avec un volume attendu, un minimum défini ou le comportement historique du même ensemble de données.
Considérons une table de transactions quotidiennes qui reçoit normalement 10 millions d'enregistrements mais n'en contient soudainement que 7 millions. Ce changement peut indiquer un chargement de données incomplet ou des enregistrements sources manquants. L'exemple fait partie du scénario opérationnel fourni et illustre pourquoi un statut de pipeline réussi ne prouve pas que tous les événements métier attendus ont été livrés.
Les vérifications du nombre d'enregistrements fonctionnent à deux niveaux. Une règle absolue peut signaler un décompte inférieur à un minimum défini par l'entreprise. Une vérification comparative peut signaler un changement inhabituel par rapport à l'historique propre de l'ensemble de données. La deuxième approche est précieuse lorsque le volume légitime varie selon le jour de la semaine, la saison, la région ou le cycle comptable.
Enquêter sur les baisses et les augmentations
Une baisse soudaine est un avertissement évident, mais une augmentation inattendue peut également indiquer une duplication, des fichiers rejoués, une explosion de jointures ou un changement du système source. Les équipes doivent conserver le décompte ainsi que l'heure de chargement, la partition, la source et la date commerciale afin que les enquêteurs puissent rapidement restreindre la portée affectée.
Évitez de copier une plage générique depuis un autre ensemble de données. Établissez le comportement attendu à partir de l'historique de la table, puis tenez compte des cycles métier connus tels que le traitement de fin de mois ou la demande saisonnière. Les données sources peuvent également arriver par lots, de sorte que la vérification doit s'exécuter à un moment où le chargement est censé être complet.
digna Data Anomalies peut identifier des comportements de volume d'enregistrements inhabituels sans obliger les ingénieurs à maintenir un seuil distinct pour chaque table. Corrélez le signal de volume avec la complétude des champs. Un nombre de lignes inférieur combiné à une augmentation des identifiants clients manquants pointe vers un problème d'ingestion plus large, tandis qu'un nombre inférieur avec une couverture de champs stable peut suggérer une partition ou un segment d'activité manquant.
La surveillance du nombre d'enregistrements s'applique également aux lignes manquantes au cours d'une période. Si un système source doit fournir des transactions pour chaque région ou unité commerciale, comparez les décomptes par ces dimensions plutôt qu'uniquement au niveau global de la table. Un total à l'apparence complète peut masquer un extrait régional manquant compensé par une activité plus élevée ailleurs.
3. Surveillance du taux de NULL
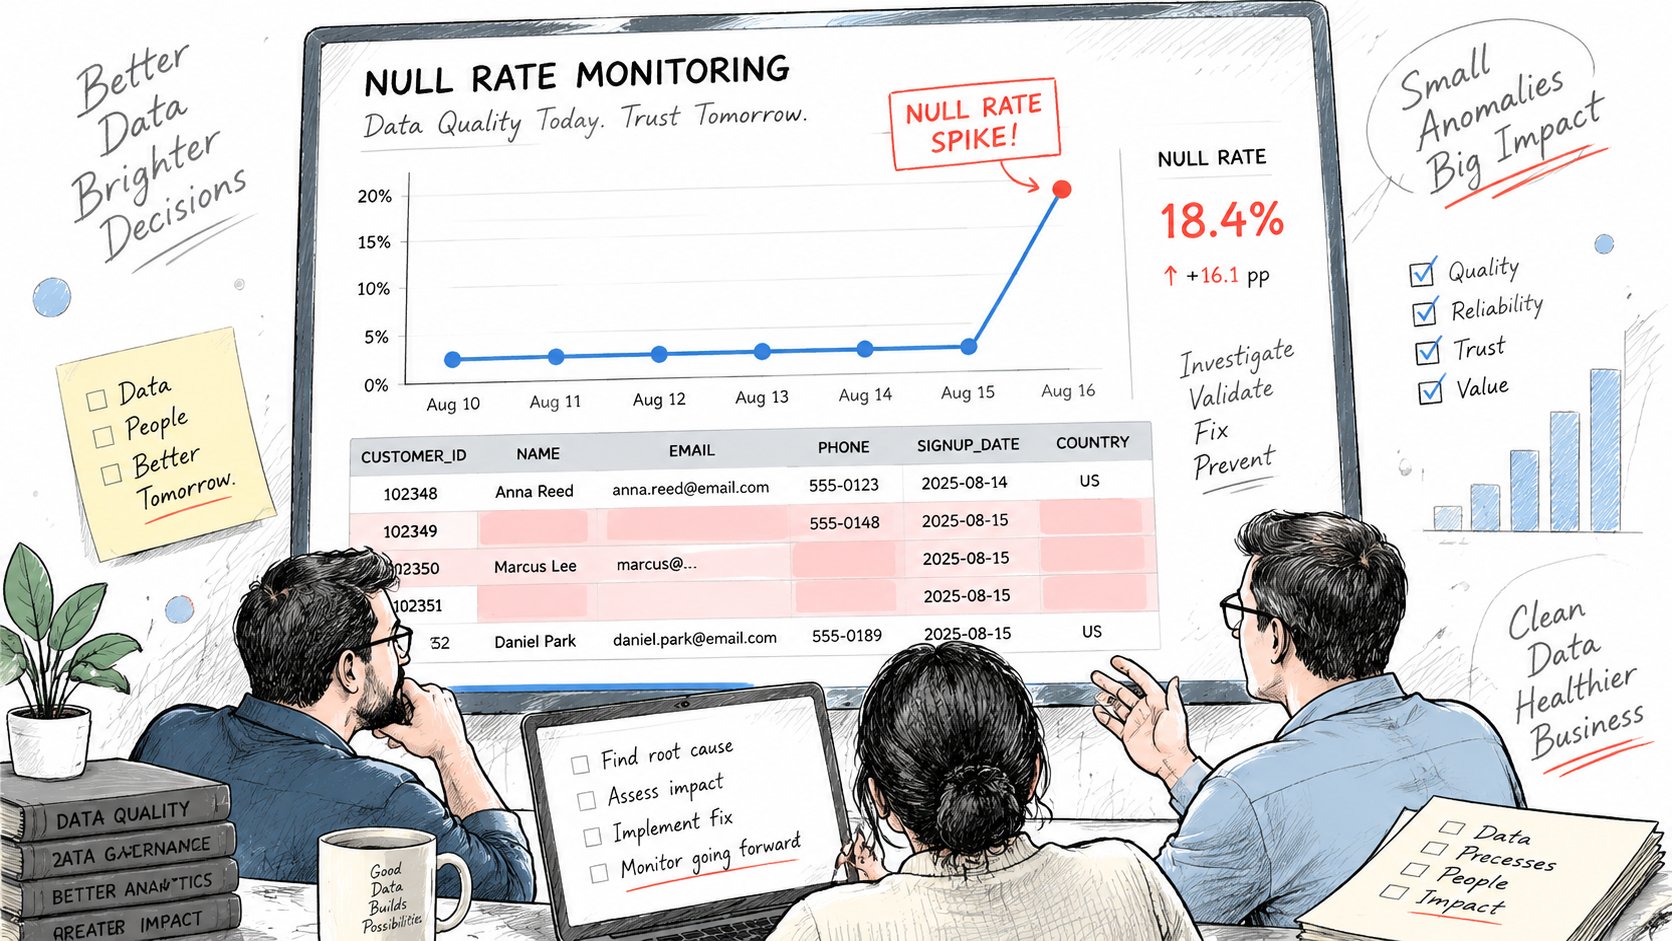
La surveillance du taux de NULL mesure la part des valeurs attendues qui sont manquantes et suit cette part au fil du temps. Au niveau du champ, calculez-la comme suit :
Taux de NULL = valeurs nulles ou vides / total des valeurs attendues × 100
La complétude et le taux de NULL décrivent deux aspects opposés de la même condition. La complétude montre ce qui est renseigné ; le taux de NULL montre ce qui est absent. Data Quality Sense identifie le taux de NULL comme une mesure de complétude centrale.
Le taux actuel n'est qu'une partie de l'évaluation. Un champ dont l'absence de données est stable et acceptée peut soutenir son processus prévu, tandis qu'une augmentation soudaine peut indiquer une interface en panne, un mappage modifié, une transformation échouée ou un comportement source altéré. Comparez le résultat actuel avec la référence propre au champ et connectez-le aux résultats de validation, aux délais de chargement et aux modifications de la source.
Traiter l'absence de données comme un contexte, pas seulement comme un décompte
Un NULL ne signifie pas toujours la même chose. Il peut représenter une valeur qui n'a pas été saisie, un champ qui ne s'applique pas, une omission intentionnelle ou un état spécial codé différemment selon les systèmes. Avant de calculer une mesure de complétude qualifiée, classifiez les NULL, les chaînes de caractères vides, les textes de remplacement et les codes spéciaux. La documentation indépendante sur la qualité des données avertit qu'une absence brute de données peut induire en erreur lorsque les valeurs manquantes sont mal codées.
Les règles d'éligibilité empêchent une non-applicabilité autorisée d'apparaître comme un échec. Par exemple, comparez un champ de contact de facturation uniquement parmi les enregistrements pour lesquels un contact de facturation est requis. Séparez également les sources et les chemins d'ingestion, car un référentiel client et un système de service saisi manuellement peuvent avoir des profils normaux différents.
Un modèle de surveillance pratique combine quatre vérifications :
Exigence statique : Alerte lorsqu'un champ obligatoire dépasse son taux de NULL accepté.
Évolution historique : Alerte lorsque le taux actuel diffère de manière inhabituelle de la référence du champ.
Comparaison des sources : Examinez le comportement par système source, région ou chemin d'ingestion.
Corrélation des changements : Examinez les déploiements, les changements d'interface et les mises à jour de mappage aux côtés des variations du taux de NULL.
La référence de complétude de Data Quality Sense décrit les décomptes de valeurs renseignées, nulles et incomplètes comme des vues de surveillance utiles. Ces décomptes connectent une alerte à l'enquête. Les analystes peuvent identifier les enregistrements, les sources, les périodes et les conditions commerciales affectés, puis comparer le modèle d'absence de données avec les échecs de validation ou les retards de chargement.
4. Évaluation de la complétude des enregistrements
La complétude des champs demande si les colonnes individuelles sont renseignées. La complétude des enregistrements demande si chaque enregistrement contient l'ensemble complet d'attributs requis pour un processus particulier. Cette distinction est importante car plusieurs champs peuvent sembler acceptables individuellement alors que les mêmes enregistrements clients restent partiellement renseignés.
Supposons qu'un enregistrement client nécessite un identifiant client, un nom, un e-mail et une adresse. La complétude des enregistrements compte combien d'enregistrements clients contiennent les quatre attributs requis. Un résultat tel que 97 % des enregistrements clients contiennent tous les attributs requis donne aux propriétaires de processus un aperçu différent de quatre pourcentages de champs séparés. La définition et le calcul au niveau de l'enregistrement sont décrits par les conseils de complétude de The Pedowitz Group.
Les exigences correctes dépendent de l'utilisation en aval. Un processus de souscription peut nécessiter une demande de prêt complète avant examen. Un processus de facturation peut nécessiter un numéro de compte, une adresse de service et un contact de facturation. Un ensemble de données de reporting peut nécessiter un horodatage et une clé métier même lorsqu'un champ descriptif est facultatif.
Trouver le modèle derrière les enregistrements incomplets
Commencez par une règle au niveau de l'enregistrement qui évalue tous les champs obligatoires ensemble. Conservez ensuite les motifs d'échec individuels. Le résultat combiné vous indique combien d'enregistrements sont utilisables, tandis que les motifs au niveau du champ montrent ce qui empêche les enregistrements restants d'être utilisés.
Par exemple, un enregistrement d'achat e-commerce peut nécessiter un identifiant de commande, un identifiant de client, un identifiant de produit, une quantité, un prix et un horodatage. Un enregistrement auquel il manque l'une de ces valeurs doit échouer à la règle de l'enregistrement complet si l'analyse des revenus dépend de la combinaison complète.
Utilisez la digna Data Validation pour les vérifications au niveau de l'enregistrement par rapport aux exigences métier explicites. Séparez les types d'enregistrements lorsque leurs exigences diffèrent. Un client, une transaction, un sinistre et un ordre de service ne doivent pas automatiquement partager la même définition de complétude.
Un enregistrement complet n'est pas la même chose qu'un ensemble de données complet. Vous avez besoin des deux vues pour comprendre si les lignes individuelles sont utilisables et si la population attendue est bien arrivée.
Suivez deux indicateurs :
Couverture des enregistrements complets : La part des enregistrements répondant à toutes les exigences du processus prévu.
Composition des échecs : Les champs les plus souvent manquants dans les enregistrements incomplets.
Cette combinaison soutient la remédiation. Si un petit nombre de champs échoue sur de nombreux enregistrements, corrigez la source ou le mappage. Si de nombreux champs échouent dans un petit groupe d'enregistrements, enquêtez sur une source, un type d'enregistrement ou une partition d'ingestion particulière.
5. Vérification de la complétude des ensembles de données et des périodes
Certains échecs de complétude se produisent au-dessus du niveau des lignes et des colonnes. L'ensemble de données attendu peut être totalement absent, une période de rapport peut manquer ou une source peut cesser de fournir des données pour une région particulière. La vérification de la complétude des ensembles de données et des périodes demande si les fichiers, tables, partitions et dates commerciales attendus existent réellement.
Les vérifications types incluent :
Arrivée des fichiers attendus : Confirmer que le fichier quotidien des ventes ou de règlement est bien arrivé.
Couverture des périodes : Vérifier que tous les jours, mois ou trimestres attendus sont représentés.
Couverture des sources : Vérifier que chaque région commerciale ou système en amont a fourni des données.
Présence des partitions : Confirmer que l'entrepôt contient les partitions de date et d'entité attendues.
Un ensemble de données peut passer la validation au niveau du champ parce que les lignes qui sont arrivées sont parfaitement renseignées. Ce résultat ne justifie pas pour autant la publication d'un rapport si une période entière de reporting est absente. La complétude doit être évaluée par rapport au calendrier de reporting et à la portée de l'activité.
Ajouter le délai de livraison à la définition de la complétude
Le délai de livraison fournit un signal opérationnel. Si un fichier quotidien est attendu dans un créneau défini et n'est pas arrivé, l'ensemble de données n'est pas disponible pour le processus, même s'il finit par apparaître. digna Timeliness peut surveiller les modèles d'arrivée, signaler les chargements manquants ou retardés, et calculer les délais de livraison attendus à partir du comportement observé.
Pour un framework de contrôle de complétude des données pratique, définissez une attente pour chaque ensemble de données :
Nommez la source et la destination.
Spécifiez la date commerciale ou la partition attendue.
Définissez le créneau de livraison et le fuseau horaire.
Enregistrez les dépendances vis-à-vis des fichiers ou tâches en amont.
Définissez une action de récupération en cas de livraison manquante ou tardive.
Cette approche aide les équipes à détecter un fichier de ventes quotidiennes manquant avant qu'un tableau de bord ne s'exécute avec une lacune invisible. Elle soutient également la collecte de données pour les équipes IEP, où les périodes attendues et les enregistrements requis doivent être suivis explicitement plutôt que déduits de toutes les données disponibles.
Documentez les sources de repli et les procédures de réexécution. Un ensemble de données manquant peut résulter d'une panne de source, d'un échec de l'ordonnanceur, d'un fichier rejeté ou d'une dépendance qui s'est terminée tardivement. L'alerte doit orienter les enquêteurs vers ces possibilités plutôt que de traiter chaque absence comme le même défaut.
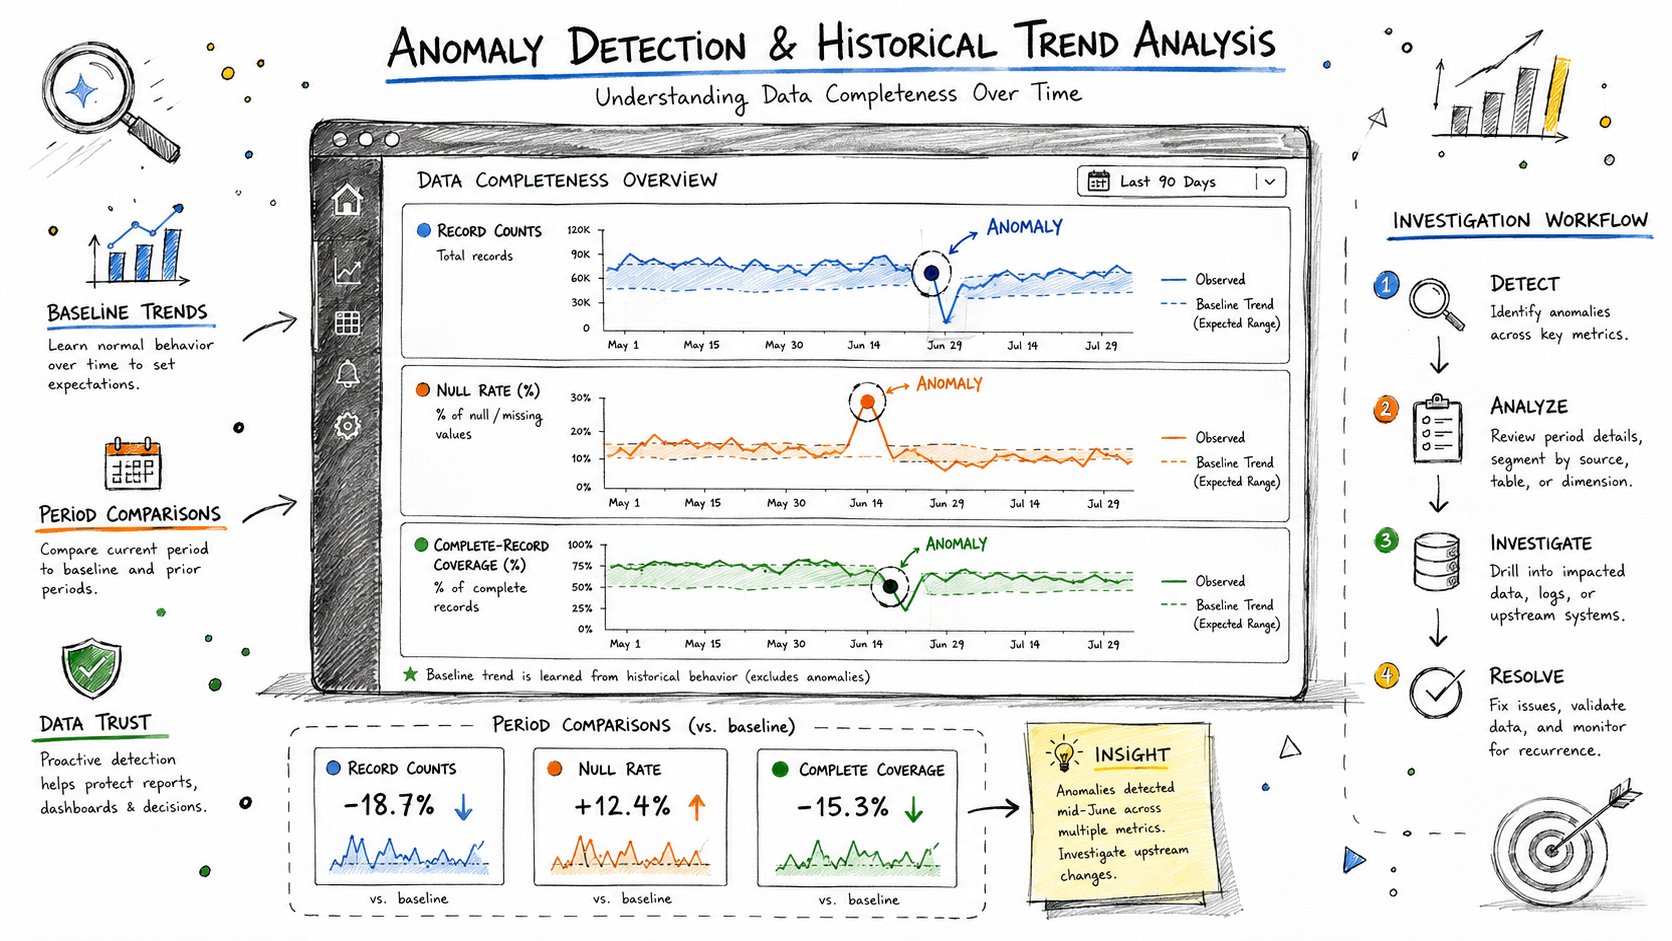
6. Détection d'anomalies et analyse des tendances historiques pour la complétude
Les règles fixes identifient les exigences connues. La détection d'anomalies et l'analyse des tendances historiques identifient les modèles de complétude qui changent sans condition d'échec prédéfinie. Les signaux utiles incluent les taux de NULL, les valeurs renseignées, le nombre d'enregistrements, la couverture des enregistrements complets, les délais de livraison et la présence des périodes attendues.
Un ensemble de données peut se détériorer progressivement. Le nombre d'enregistrements peut diminuer sur plusieurs chargements, ou un champ obligatoire peut devenir moins renseigné après un changement de système. Chaque métrique peut rester au-dessus de son seuil d'alerte alors que le risque global augmente. La comparaison historique rend cette direction visible, tout comme la comparaison de la mesure du jour avec la référence établie d'un patient plutôt que de la juger isolément.
Utilisez l'approche de détection d'anomalies sur les séries temporelles de digna pour comparer le comportement actuel de la complétude avec les modèles appris. L'objectif est de signaler les changements significatifs pour examen, et non de classer chaque écart comme un défaut.
Combiner les références avec le jugement du domaine
Une anomalie ne devient utile qu'une fois son contexte vérifié. Un processus de rapprochement de fin de mois peut produire un modèle récurrent. Un nouveau flux d'inscription peut modifier intentionnellement les champs renseignés. Une migration de source peut créer une transition temporaire qui nécessite un traitement distinct.
Examinez les signaux à un rythme régulier et conservez les observations. digna Data Analytics fournit un contexte historique pour les tendances, la volatilité, les échecs récurrents et les différences entre les périodes. Les analystes peuvent se demander quand le changement a commencé, s'il affecte toutes les sources et s'il suit un calendrier.
Utilisez cette séquence :
Détecter : Trouver un changement inhabituel dans le volume, le taux de NULL ou la couverture des enregistrements complets.
Localiser : Décomposer le signal par source, région, partition, type d'enregistrement ou processus.
Corréler : Le comparer avec les déploiements, les changements de schéma, les événements opérationnels et les retards de livraison.
Valider : Demander au propriétaire du domaine si le changement est attendu.
Remédier : Corriger la source ou le pipeline, puis confirmer que la métrique revient à un état acceptable.
Stockez les observations de complétude de manière cohérente. Une collecte quotidienne convient à de nombreux ensembles de données opérationnels, tandis que les pipelines à haut volume peuvent nécessiter des vérifications plus fréquentes. L'analyse des tendances n'est fiable que lorsque la définition de la métrique, la portée et le comportement attendu restent stables. Conservez ces détails avec chaque observation afin que les comparaisons ultérieures ne confondent pas un changement de mesure avec un changement de qualité des données.
7. Complétude des données par rapport à l'évaluation de l'exactitude et de la validité
La complétude est nécessaire, mais elle ne répond pas à toutes les questions de qualité des données. La complétude demande si les données requises sont présentes. L'exactitude demande si elles représentent correctement la réalité. La validité demande si elles sont conformes aux règles définies.
Un numéro de téléphone illustre clairement la différence :
Valeur manquante : Un problème de complétude.
Présent mais mal formaté : Un problème de validité.
Correctement formaté mais appartenant à une autre personne : Un problème d'exactitude.
La même distinction s'applique à un identifiant client. Un identifiant renseigné peut satisfaire une vérification de complétude de champ tout en échouant à la validité s'il viole le format ou la relation attendue. Il peut également échouer à l'exactitude s'il identifie le mauvais client.
Surveiller les dimensions ensemble
Utilisez la digna Data Validation pour appliquer des vérifications explicites pour les valeurs requises, les formats, les plages, les relations et la logique métier. Ce guide des outils de vérification de validité fournit un contexte utile pour traiter la validation au-delà de la simple détection de NULL.
Une vue partagée de la qualité doit montrer les dimensions séparément et ensemble. Le chemin de remédiation diffère :
Échec de complétude : Trouver pourquoi la valeur, l'enregistrement ou la période est absent.
Échec de validité : Corriger le format, le domaine, le type ou la règle de relation.
Échec d'exactitude : Comparer la valeur avec une source de confiance ou un événement réel.
Les exigences conditionnelles comptent également. Un attribut peut être obligatoire uniquement lorsqu'un autre champ indique que l'enregistrement est éligible. Un score global de complétude brut peut pénaliser des omissions de conception valides à moins que la règle n'inclue cette condition.
Éviter le faux réconfort d'un score élevé
Un ensemble de données dont tous les champs requis sont renseignés peut tout de même contenir des adresses incorrectes, des numéros de compte invalides ou des montants de transaction erronés. Inversement, un ensemble de données peut contenir des valeurs exactes pour les lignes qu'il a reçues tout en manquant d'une période source entière.
La complétude est la preuve que les informations requises sont présentes. Elle n'est pas la preuve que les informations sont correctes, valides, opportunes ou suffisantes pour chaque analyse.
Priorisez les problèmes en fonction de leur impact métier. Un champ systématiquement renseigné avec des valeurs incorrectes peut créer un risque plus important qu'un attribut facultatif avec des absences occasionnelles. Les utilisateurs métier doivent aider à définir cette priorité car ils comprennent comment chaque défaut affecte le reporting, les opérations, la Compliance et les décisions.
8. Stratégie de surveillance continue
Un programme de complétude fiable combine la validation déterministe, la détection d'anomalies, la surveillance de la ponctualité et l'analyse historique. Chaque couche répond à une question différente. La validation demande si les exigences connues sont respectées. La détection d'anomalies demande si le comportement actuel diffère de la référence normale. La surveillance de la ponctualité vérifie si les données attendues arrivent au moment requis, tandis que l'analyse historique montre si un écart est isolé, récurrent, saisonnier ou s'aggrave.
Commencez par définir ce qui rend un enregistrement utilisable et ce qui rend un ensemble de données utilisable. Connectez ensuite chaque définition à la bonne mesure :
Validation des champs requis : Détecter les valeurs obligatoires manquantes, comme un identifiant client ou un montant de transaction.
Validation au niveau de l'enregistrement : Confirmer qu'un enregistrement éligible contient tous les attributs nécessaires à l'utilisation prévue.
Surveillance du nombre d'enregistrements : Identifier les populations manquantes ou dupliquées de manière inattendue.
Surveillance de la ponctualité : Détecter les livraisons tardives, précoces ou absentes.
Détection d'anomalies : Signaler les changements inhabituels de volume, de taux de NULL, de comportement de livraison ou de couverture des enregistrements complets.
Analyse historique : Comparer la complétude entre les périodes pour identifier la récurrence et les changements à long terme.
Surveillance de schéma : Intercepter les changements structurels qui peuvent introduire de nouvelles absences de données.
Ces couches fonctionnent comme plusieurs instruments sur un même tableau de bord. Une vérification de champ peut montrer que des valeurs sont présentes, tandis qu'une vérification du nombre d'enregistrements révèle qu'une population source entière n'est jamais arrivée. Une alerte de ponctualité peut alors expliquer pourquoi les deux signaux ont changé.
digna soutient ce modèle opérationnel via Data Validation, Data Anomalies, Data Analytics, digna Timeliness et Schema Tracker. Le calcul et l'analyse des métriques s'exécutent dans les bases de données du client. Les options de déploiement en cloud privé et sur site répondent aux exigences de contrôle des entreprises.
Correler les signaux avant d'attribuer la responsabilité
Supposons que les échecs de validation augmentent tandis que le nombre d'enregistrements diminue et qu'une source arrive en retard. Ensemble, ces signaux peuvent indiquer un seul extrait incomplet en amont. Traitez l'événement comme une seule enquête plutôt que d'ouvrir des tickets séparés qui masquent la connexion.
Une routine pratique consiste à :
Définir les champs requis et les enregistrements éligibles avec les propriétaires métier.
Définir des attentes en matière de volume, de couverture des périodes et de délais d'arrivée.
Appliquer des vérifications déterministes aux exigences connues.
Établir des références pour les métriques de complétude importantes.
Corréler les alertes entre la validation, les anomalies, la ponctualité et les changements de schéma.
Passer en revue les problèmes récurrents et les tendances avec les propriétaires de données.
Réévaluer les règles lorsque les processus métier ou les systèmes sources changent.
Interprétez l'absence de données en fonction de l'éligibilité, du codage, du contexte de la source et de l'utilisation en aval. Une valeur manquante peut être attendue pour un enregistrement inéligible, tandis qu'une période manquante ou un ensemble de données absent peut indiquer un échec de livraison. La recherche sur les mécanismes de données manquantes note que les indicateurs de présence seuls peuvent ne pas montrer si l'absence est structurellement informative ou biaisée.
Comparaison en 8 points : comment mesurer la complétude des données
Méthode | 🔄 Complexité de mise en œuvre | ⚡ Ressources requises | 📊 Résultats attendus | 💡 Cas d'usage idéaux | ⭐ Avantages clés |
|---|---|---|---|---|---|
Taux de complétude des champs | Faible, vérifications SQL/NULL simples | Faible, calcul/stockage minimal | % de complétude au niveau du champ ; identification des champs manquants | Conformité des champs requis, audits, validations de base | Transparent, facile à mettre en œuvre, exploitable |
Surveillance du nombre d'enregistrements | Faible, décomptes périodiques et références | Faible, agrégations légères, décomptes historiques | Détecte les chargements manquants et les anomalies de volume | Surveillance des chargements par lots/flux, détection des défaillances de pipeline | Détection rapide des ensembles de données manquants ; faible coût |
Surveillance du taux de NULL | Moyenne, suivi des tendances et établissement de références | Moyenne, métriques historiques et surveillance | Tendances/pics dans les proportions de NULL au fil du temps | Champs où l'absence de données signale un changement dans les sources | Sensible aux problèmes émergents ; alertes précoces |
Évaluation de la complétude des enregistrements | Moyenne à élevée, règles multi-champs par enregistrement | Moyenne, calcul de validation par enregistrement | % d'enregistrements répondant à tous les attributs requis | Processus en aval nécessitant des enregistrements complets (souscription, facturation) | Métrique pertinente pour le métier ; donne la priorité à la remédiation |
Vérification de la complétude des ensembles de données et des périodes | Faible, vérifications de présence/calendrier | Faible, vérifications minimales + métadonnées de planification | Confirme l'arrivée des ensembles de données/fichiers et la couverture des périodes | Lots planifiés, reporting réglementaire/périodique | Prévient les rapports sur des périodes manquantes ; simple à appliquer |
Détection d'anomalies et analyse des tendances historiques | Élevée, références ML et analyse de séries temporelles | Élevée, stockage historique, calcul ML | Détecte les écarts inhabituels et les dégradations lentes | Pipelines complexes, modèles saisonniers, surveillance d'entreprise | Capture les problèmes subtils/progressifs ; moins de faux positifs |
Complétude par rapport à l'évaluation de l'exactitude et de la validité | Élevée, intègre plusieurs dimensions de qualité | Élevée, vérifications multi-dimensions et outils | Profil de qualité global (complétude + exactitude + validité) | Data Governance, priorisation des remédiations, audits | Prévient les corrections trop ciblées ; se concentre sur l'impact métier |
Stratégie de surveillance continue (intégrée) | Élevée, combine règles, anomalies, analyses | Élevée, modules multiples, corrélation des alertes | Couverture complète avec alertes corrélées et contexte | Entreprises disposant de pipelines critiques et de sources hétérogènes | Combine les forces de toutes les méthodes ; réduit les problèmes manqués |
Du pourcentage de complétude à la confiance dans les données
Aucune métrique unique ne prouve qu'un ensemble de données est complet pour chaque usage. Un taux de complétude des champs peut montrer que les valeurs requises sont renseignées, mais il ne révélera pas un fichier manquant, une région commerciale absente, une livraison tardive ou une baisse lente du volume d'enregistrements. Un pourcentage d'enregistrements complets peut montrer que les lignes sont utilisables, mais il ne prouvera pas que la population attendue est arrivée.
Le modèle de mesure le plus solide progresse à travers plusieurs niveaux :
Niveau du champ : Les valeurs requises sont-elles renseignées ?
Niveau de l'enregistrement : Chaque enregistrement utilisable contient-il tous les attributs requis ?
Niveau du volume : Le nombre attendu d'enregistrements est-il arrivé ?
Niveau de l'ensemble de données : Les fichiers, tables et partitions attendus sont-ils présents ?
Niveau de la période : Les données couvrent-elles chaque date commerciale ou période de reporting requise ?
Niveau de la ponctualité : Les données sont-elles arrivées dans leur créneau attendu ?
Niveau comportemental : Les taux de NULL, les décomptes et les valeurs renseignées se comportent-ils normalement ?
Niveau de la dimension de qualité : Les données présentes sont-elles également exactes et valides ?
Cette vue structurée empêche qu'un statut de pipeline réussi ne devienne un faux signal d'assurance. Elle aide également les équipes à attribuer la responsabilité au bon interlocuteur. Une valeur requise manquante peut relever d'une équipe d'application source. Une partition manquante peut relever de l'ingestion. Un fichier en retard peut nécessiter une enquête sur le pipeline ou l'ordonnanceur. Un changement de schéma peut nécessiter une coordination avec les consommateurs en aval.
Définir “complet” pour la décision
Le niveau acceptable de complétude dépend de l'utilisation prévue. Les conseils sur la qualité des données de l'université de Greifswald indiquent qu'il n'y a pas de seuil universel pour l'absence acceptable de données. La question pertinente est de savoir si les enregistrements complets restants soutiennent la décision, le rapport, le modèle ou le processus opérationnel.
Cela signifie qu'une équipe de governance doit documenter :
Quels attributs sont obligatoires.
Quels enregistrements sont éligibles pour chaque exigence.
Quelles sources et périodes sont attendues.
Quel créneau de livraison s'applique.
Quels écarts de complétude bloquent la publication ou le traitement.
Quels modèles d'absence de données nécessitent une enquête même lorsqu'un seuil est franchi.
Mesurez ensuite à la fois le score et la raison sous-jacente. Une moyenne unique peut masquer une colonne, une source, une région ou une période critique. Décomposez les métriques selon les dimensions importantes pour le processus et conservez suffisamment d'historique pour identifier les échecs récurrents.
Transformer la surveillance en une pratique opérationnelle
Une mise en œuvre pratique commence par des règles déterministes pour les exigences connues. Ajoutez des vérifications du volume attendu et de la livraison. Établissez des références historiques pour les taux de NULL et les populations d'enregistrements. Lorsqu'une alerte se déclenche, étudiez les signaux corrélés plutôt que de traiter chaque métrique indépendamment. Examinez les tendances avec les propriétaires métier afin que les changements légitimes de processus ne soient pas confondus avec des défauts.
digna offre une approche modulaire pour ce travail. Data Validation peut appliquer les valeurs requises et les règles métier au niveau de l'enregistrement. Data Anomalies peut identifier les changements inhabituels dans le comportement lié à la complétude. Data Analytics peut fournir un contexte historique. digna Timeliness peut surveiller les modèles d'arrivée et les chargements manquants. Schema Tracker peut détecter les changements structurels susceptibles d'introduire de nouveaux problèmes de complétude.
La plateforme exécute les vérifications et le calcul des métriques au sein des bases de données du client, avec des options de déploiement en cloud privé et sur site pour les organisations qui nécessitent que les données restent dans leur propre environnement. Cette architecture prend en charge une approche contrôlée à travers les entrepôts, les lacs de données et les pipelines, tandis qu'un tableau de bord partagé offre aux ingénieurs, aux analystes et aux parties prenantes une vue commune des incidents et des tendances.
La complétude des données n'est pas qu'un simple pourcentage. C'est l'assurance que les informations requises pour un but métier réel sont présentes, disponibles au bon moment et suffisamment stables pour qu'on puisse s'y fier. Mesurez les valeurs individuelles, les enregistrements complets, les volumes d'enregistrements, les périodes attendues, le comportement de livraison et les changements historiques. Connectez ensuite ces signaux à l'exactitude et à la validité afin que les équipes sachent non seulement ce qui manque, mais aussi si les données reçues peuvent soutenir la décision.
digna combine Data Validation, Data Anomalies, Data Analytics, digna Timeliness et Schema Tracker pour aider les équipes à surveiller la complétude sur l'ensemble des données de l'entreprise. Visitez digna pour explorer une plateforme d'Observability modulaire qui s'exécute dans votre environnement et vous aide à enquêter sur les valeurs manquantes, les chargements manquants, les changements inhabituels et les problèmes de qualité des données associés.


