Apache Iceberg : le guide du praticien
|
8
minute de lecture

Vous avez adopté Apache Iceberg, enregistré quelques tables et pointé Spark vers le stockage objet. Le premier incident de production arrive en général avant que l'architecture semble achevée : une requête en aval lit un schéma inattendu, un changement de partition se comporte différemment dans Trino, ou personne ne sait quels snapshots peuvent être supprimés sans risque. Les fichiers Parquet sont rarement la partie difficile. La propriété, la coordination des catalogues, l'entretien des métadonnées et la preuve qu'une table est digne de confiance constituent la vraie charge de travail.
La valeur d'Apache Iceberg vient de la séparation entre l'état de la table et l'agencement physique des fichiers. Cette séparation soutient une analytique fiable entre moteurs, mais elle implique aussi que les équipes adoptent des pratiques d'exploitation qui dépassent la spécification du format. Ce guide traite le format de table ouvert Apache Iceberg comme une discipline de plateforme, avec des frontières claires entre stockage, catalogues, moteurs, maintenance et observabilité.
Table des matières
Pourquoi Iceberg est une discipline d'exploitation et pas un simple format de fichier
Snapshots, manifestes, partitionnement masqué et voyage dans le temps
Bonnes pratiques de partitionnement, de tri et de taille de fichiers
Exploiter des tables Iceberg en pensant schéma, qualité et Timeliness
Pourquoi Iceberg est une discipline d'exploitation et pas un simple format de fichier
Une équipe peut adopter Iceberg rapidement et rester sans réponse aux questions qui comptent en production. Qui est responsable de l'expiration des snapshots ? Quelle équipe approuve un changement de schéma ? Comment détectez-vous qu'un producteur ajoute un champ au sens incompatible ? Que se passe-t-il quand Spark et Trino interprètent différemment une transformation de partition parce que leur configuration de catalogue ou de connecteur a dérivé ?
Iceberg a démarré chez Netflix en 2017 pour traiter les limites de passage à l'échelle et de cohérence des tables Apache Hive. Netflix l'a donné à l'Apache Software Foundation en novembre 2018, et il est devenu projet Apache de premier plan en mai 2020, d'après l'historique des versions du projet. Ces jalons expliquent l'orientation technique du format, mais ils ne suppriment pas les responsabilités d'exploitation qui apparaissent après l'adoption.
La couche physique de données est relativement simple. Les moteurs écrivent des fichiers, souvent Parquet, dans le stockage objet. Le travail difficile commence autour de ces fichiers :
Gouvernance du catalogue : décidez qui peut créer, modifier, supprimer ou promouvoir des tables, et comment les identifiants se résolvent d'un environnement à l'autre.
Hygiène des métadonnées : maîtrisez la rétention des snapshots, supprimez les fichiers orphelins et surveillez la croissance des manifestes.
Coordination des moteurs : testez la façon dont Spark, Flink, Trino et d'autres lecteurs traitent le même schéma, les mêmes spécifications de partition, suppressions et règles d'isolation.
Preuves : reliez la qualité des données, la fraîcheur, le lignage et l'historique de déploiement à un état de table précis.
Règle pratique : traitez chaque table Iceberg comme un produit géré, avec une personne responsable, une politique d'exploitation et un cycle de vie observable.
C'est là que s'inscrit l'observabilité des données. L'observabilité ne remplace ni le catalogue ni le moteur de requête. Elle fournit les preuves nécessaires pour dire si une table est saine à l'instant présent, si un changement a provoqué une régression et si l'ingénieur d'astreinte peut se fier au snapshot courant.
La performance et la justesse se jouent à cette couche d'exploitation. Iceberg donne aux équipes de solides primitives, mais une plateforme qui ne planifie pas la maintenance, ne coordonne pas les accès et ne surveille pas les comportements produira encore des données peu fiables.
Les briques essentielles d'une table Iceberg
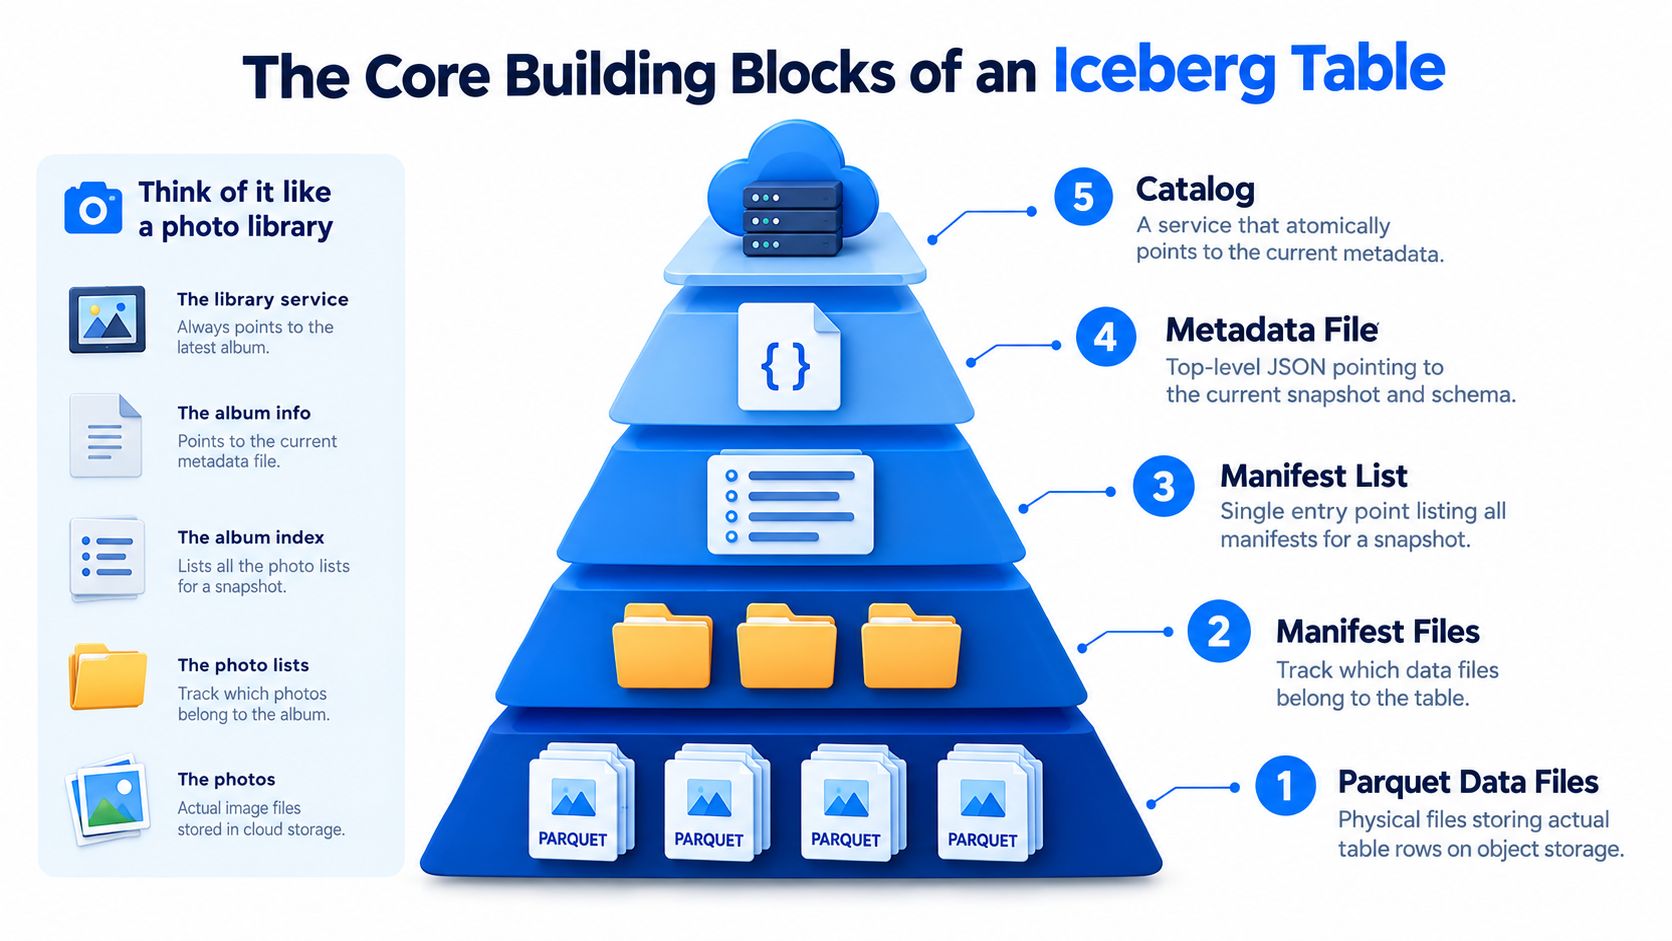
Un bon modèle mental part d'une photothèque. Les photographies sont les lignes, les dossiers décrivent des groupes de photographies, l'index de l'album vous dit où regarder, et le catalogue de la bibliothèque vous dit quelle collection fait foi.
Tout en bas, les fichiers de données Parquet stockent les lignes réelles dans le stockage objet. Parquet est un format de fichier en colonnes, et Iceberg gère les références vers ces fichiers au lieu d'obliger les lecteurs à les découvrir en parcourant des noms de répertoires. Pour une explication ciblée de la couche fichier, voir ce qu'est Parquet et comment il fonctionne.
Les fichiers de manifeste font office de dossiers organisés contenant des pointeurs vers les fichiers de données, ainsi que des informations aidant les moteurs à décider quels fichiers sont pertinents. Une liste de manifestes est l'index d'un snapshot donné. Elle identifie les manifestes qui composent cet état de table, si bien qu'un planificateur peut partir d'un point d'entrée structuré plutôt que de fouiller tout le stockage objet.
Les couches de métadonnées et de catalogue
Le fichier de métadonnées de table est la fiche du catalogue de la bibliothèque. Iceberg stocke l'état de la table dans des métadonnées JSON : schémas, spécifications de partition, historique des snapshots et lignage parent-enfant. Les snapshots sont intégrés aux métadonnées de table plutôt que sérialisés comme un système d'état distinct, ce qui permet aux lecteurs de reconstruire une table à un instant donné à partir du journal de snapshots et des informations de lignage, comme le décrit la spécification des tables Iceberg.
Le catalogue détient le pointeur atomique vers le fichier de métadonnées courant. Un écrivain crée de nouvelles données et métadonnées, puis met à jour ce pointeur via le mécanisme de commit du catalogue. Les lecteurs résolvent l'identifiant de table auprès du catalogue, obtiennent l'emplacement des métadonnées courantes et planifient à partir des manifestes référencés par le snapshot retenu.
Le modèle réutilisable est simple :
Les fichiers de données stockent les lignes.
Les fichiers de manifeste suivent les entrées de fichiers de données.
Les listes de manifestes identifient les manifestes d'un snapshot.
Les métadonnées consignent schémas, spécifications de partition, snapshots et lignage.
Le catalogue pointe de façon atomique vers les métadonnées courantes.
Cette indirection est le fondement des commits atomiques et des lectures indépendantes du moteur. Elle explique aussi pourquoi supprimer des fichiers à la main ou modifier des chemins du stockage objet en dehors des procédures Iceberg peut rompre l'intégrité de la table.
Snapshots, manifestes, partitionnement masqué et voyage dans le temps
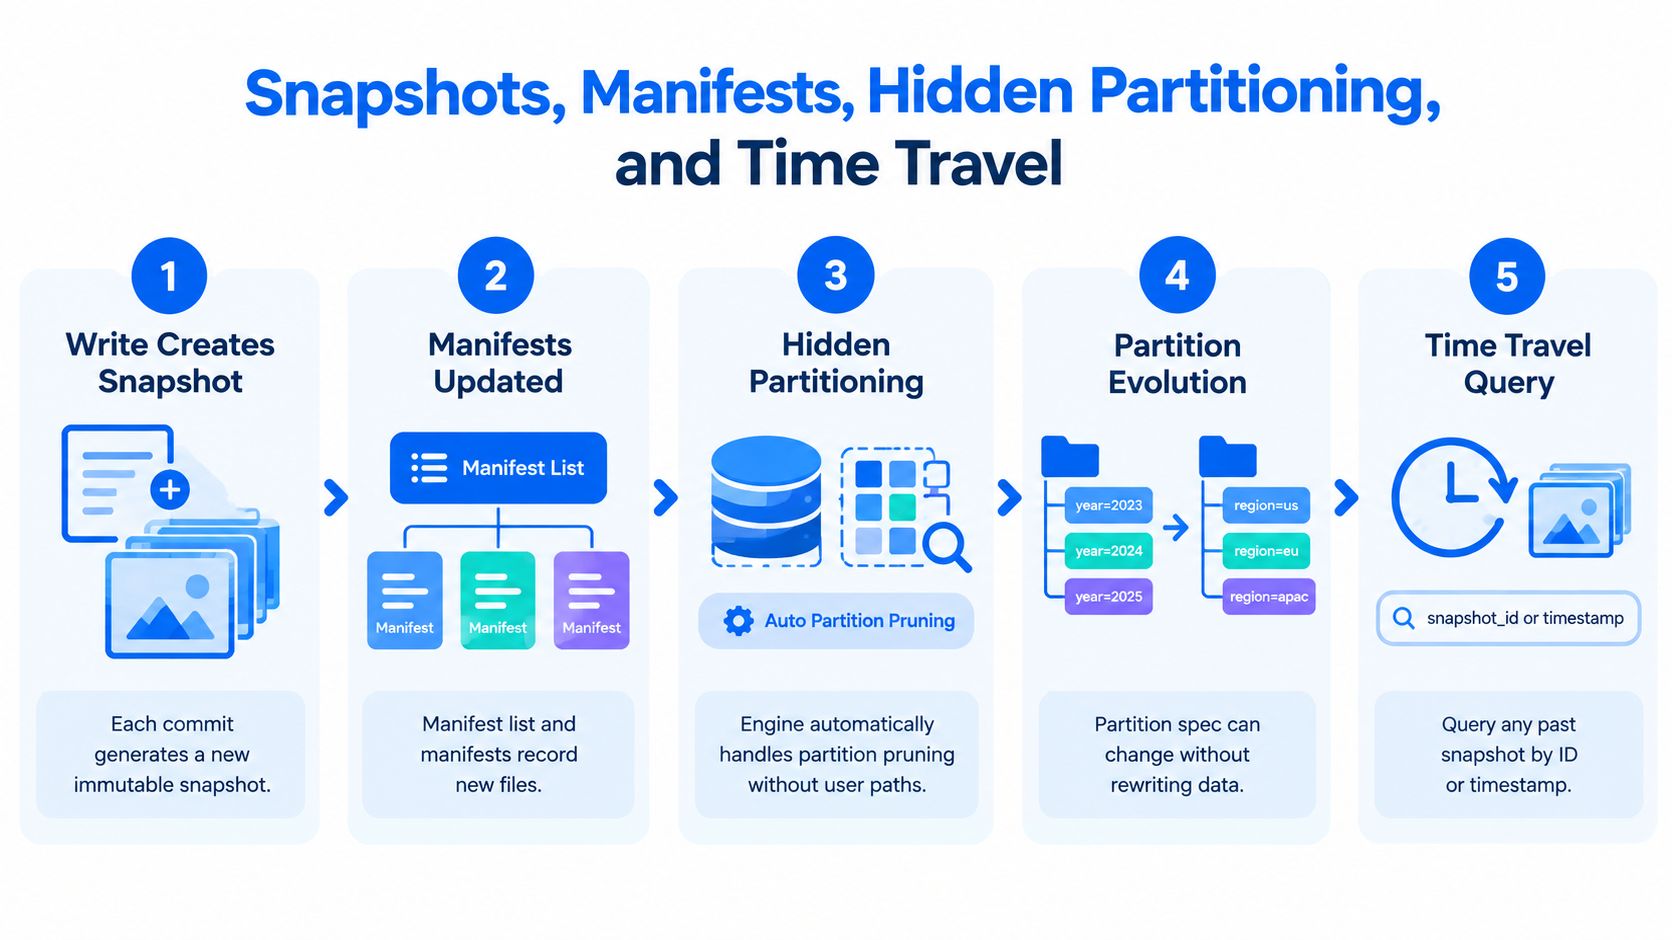
Une écriture Iceberg change l'état de la table en validant un nouveau snapshot. Le snapshot inscrit un nouveau point dans l'historique de la table et référence la liste de manifestes décrivant les fichiers visibles à ce point. Comme Iceberg conserve l'historique des snapshots et le lignage parent-enfant dans les métadonnées, un lecteur peut reconstruire non seulement l'état le plus récent, mais aussi des états validés antérieurs.
La séquence compte :
Un écrivain crée ou prépare de nouveaux fichiers de données.
Le commit crée un nouveau snapshot.
La liste de manifestes identifie les manifestes de ce snapshot.
Les lecteurs utilisent les métadonnées de manifeste et les statistiques de fichiers pour élaguer le travail.
Une requête historique peut cibler un snapshot antérieur plutôt que le courant.
Le partitionnement masqué retire la logique de chemins aux requêtes
Iceberg consigne les transformations de partition dans les métadonnées. Une transformation telle que l'extraction de date, le bucketing ou la troncature peut guider l'élagage sans obliger les utilisateurs à écrire des filtres sur des colonnes physiques de partition ou des chemins du stockage objet. Le moteur interprète les informations de partition de la table pendant la planification, ce qui garde le SQL centré sur les colonnes métier.
Cela ne veut pas dire que le partitionnement devient un réglage automatique des performances. Le moteur a toujours besoin de statistiques exploitables, d'un agencement de fichiers sensé et d'une spécification de partition adaptée à la charge de requêtes. Le partitionnement masqué supprime une catégorie d'erreurs de chemin visibles par l'utilisateur, mais il ne sauve pas une conception inadaptée.
Évoluer sans réécrire l'historique
L'évolution des partitions ne touche que les métadonnées. Une équipe peut changer une spécification de partition, laisser les anciennes données dans leur agencement physique d'origine et écrire les nouvelles sous la nouvelle spécification, comme le documente l'évolution des partitions Iceberg. La table suit chaque version de partition séparément.
Cette souplesse est précieuse quand les motifs d'accès changent. Elle crée aussi une obligation de planification, car les moteurs de requête doivent interpréter plusieurs spécifications de partition dans une même table. L'avantage est d'éviter un gros travail de réécriture ; le coût, des métadonnées et une planification plus complexes.
Le voyage dans le temps devient alors un outil de diagnostic concret. Interrogez un snapshot plus ancien, comparez ses résultats à l'état courant, examinez le changement, puis revenez au dernier snapshot. Le modèle de snapshots validés d'Iceberg offre l'isolation par snapshot, de sorte que les lecteurs voient un état validé cohérent pendant que les écrivains créent de nouveaux snapshots de façon atomique. Pour les traitements de données historiques, le même schéma sert au-delà d'Iceberg, comme l'illustre ce guide d'analyse de données historiques.
Apache Iceberg face à Delta Lake et Apache Hudi
Choisir un format de table au nombre de fonctionnalités est une mauvaise méthode de production. La comparaison utile porte sur le comportement des métadonnées, la couverture des moteurs et la sémantique des lectures historiques, puis sur la charge de travail et les contraintes de gouvernance que votre plateforme peut assumer.
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Modèle de métadonnées | Métadonnées fondées sur les snapshots, avec listes de manifestes et manifestes décrivant les fichiers de la table et soutenant la planification | Une chaîne de JSON | Une chronologie de commits conçue autour des changements au niveau des enregistrements et d'opérations orientées streaming |
Meilleur profil moteur | Usage multi-moteurs étendu : Spark, Flink, Trino, Presto, Impala, Dremio et Snowflake | Le plus fort dans les environnements centrés sur Spark | Le plus fort pour les upserts en streaming et le traitement incrémental |
Modèle de voyage dans le temps | Les lectures ciblent des snapshots validés, la rétention étant pilotée par des opérations de table | Les lectures dépendent de l'historique conservé du journal de transactions et des checkpoints | Les lectures dépendent de la chronologie de commits configurée et de la fenêtre de rétention |
Principal compromis en production | La coordination entre catalogues et moteurs exige une gouvernance délibérée | La portabilité peut devenir difficile hors de son écosystème de prédilection | Les choix merge-on-read et copy-on-write ajoutent de la complexité d'exploitation |
Le modèle de métadonnées d'Iceberg sépare l'état de la table des fichiers de données. Les moteurs peuvent utiliser listes de manifestes et statistiques de fichiers pour réduire le travail de planification sans obliger chaque lecteur à interpréter une convention de répertoires. La chaîne de journal de Delta est efficace pour consigner les changements, mais une inspection historique large peut devenir un sujet de gestion de journaux. La chronologie de Hudi convient naturellement aux mises à jour en streaming, surtout là où la consommation incrémentale et les upserts dominent la charge.
La couverture des moteurs change le comportement réel d'une même table. Spark et Flink peuvent écrire des tables Iceberg et participer aux protocoles de commit, produisant de nouveaux snapshots de façon atomique. Trino et Presto servent couramment de planificateurs orientés lecture qui récupèrent les métadonnées de manifeste, appliquent le pushdown de filtres et utilisent les transformations de partition à la planification. Impala accède à Iceberg via son abstraction de catalogue et peut profiter de l'élagage par métadonnées. Dremio et Snowflake ajoutent d'autres voies de consommation, mais chaque combinaison connecteur-catalogue exige encore des tests de compatibilité.
Le catalogue est le point de coordination
Les catalogues REST, Hive, Glue, Nessie et Polaris résolvent les identifiants de table jusqu'au pointeur de métadonnées courant. Ce pointeur est la décision du plan de contrôle qui indique à un moteur quel état de table lire ou mettre à jour. La seule compatibilité de stockage ne garantit pas une gouvernance cohérente.
Les écrivains concurrents ont besoin d'une gestion des conflits. Un écrivain peut découvrir que le pointeur du catalogue a changé après le début de son commit, ce qui impose une reprise ou une réponse de conflit. Les moteurs exposent ces échecs différemment ; les équipes plateforme devraient donc tester les reprises, la gestion des erreurs et la responsabilité opérationnelle plutôt que de supposer que tous les connecteurs se comportent pareil.
Une liste de sélection concrète ressemble à ceci :
Choisissez Iceberg quand plusieurs moteurs, des catalogues ouverts et une gouvernance de table portable comptent davantage qu'une intégration étroite à la plateforme.
Choisissez Delta Lake quand Spark et sa plateforme environnante constituent la voie dominante d'écriture, de gouvernance et de restitution.
Choisissez Hudi quand les upserts en streaming, les lectures incrémentales et l'ingestion au niveau des enregistrements sont les exigences centrales.
Testez d'abord le catalogue quand les mêmes tables doivent être gouvernées entre plusieurs moteurs.
Validez les lectures historiques avec de véritables procédures de rétention et de rollback, pas seulement une requête de démonstration réussie.
Les opérations de qualité des données doivent aussi correspondre à l'environnement d'exécution retenu. Pour les équipes sous Databricks, la gestion de la qualité des données sur Databricks est une voie opérationnelle pertinente à évaluer aux côtés du comportement du catalogue et du moteur.
Un exemple concret : créer et interroger une table Iceberg
Un petit enchaînement PySpark rend le modèle de métadonnées tangible. L'implémentation exacte du catalogue varie, aussi l'exemple utilise-t-il un catalogue Iceberg nommé et un emplacement d'entrepôt que vous remplaceriez par les réglages de votre environnement.
La définition de la table stocke la transformation de partition dans les métadonnées. Les utilisateurs peuvent filtrer sur event_time ; ils n'ont pas besoin de référencer une colonne de partition générée ni un répertoire du stockage objet.
L'ajout crée un nouveau snapshot validé. Pour inspecter l'historique, interrogez les tables de métadonnées, choisissez l'identifiant de snapshot voulu et utilisez-le pour une lecture historique.
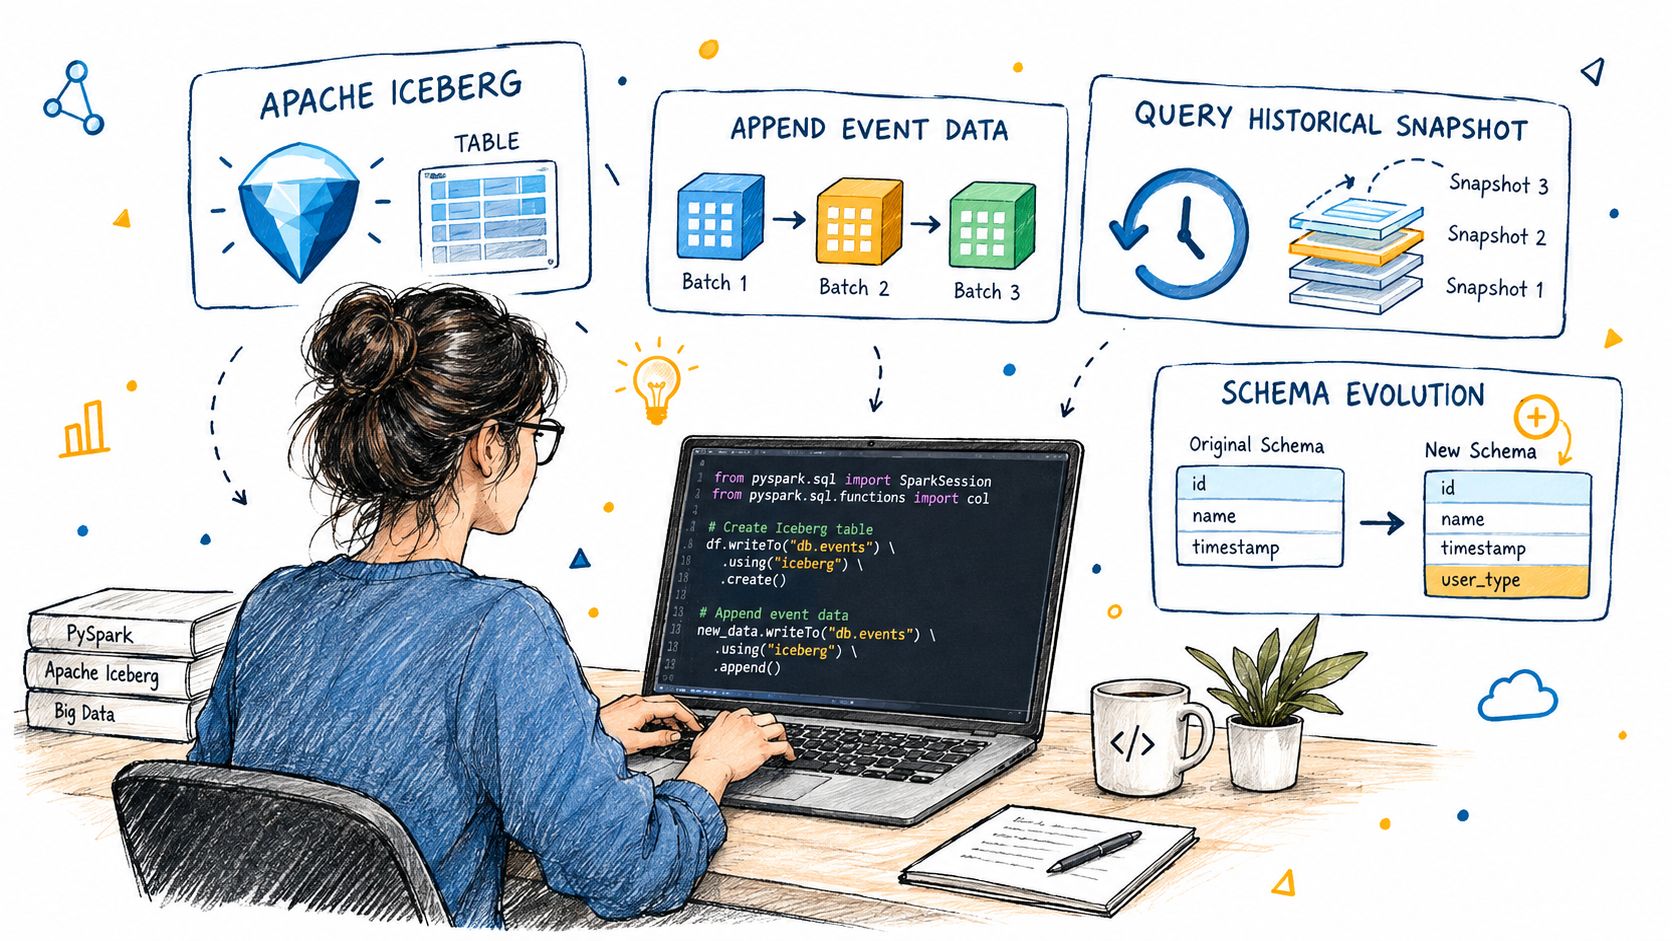
L'évolution de schéma ne touche que les métadonnées pour les changements pris en charge. Ajoutez une colonne, puis ajoutez des enregistrements qui la renseignent :
Les lecteurs visant l'ancien snapshot utilisent toujours l'ancienne projection de schéma. En coulisses, le catalogue pointe vers des métadonnées de table mises à jour, les métadonnées référencent un nouveau snapshot, la liste de manifestes identifie les manifestes pertinents, et les manifestes pointent vers les fichiers de données. Cet agencement du système de fichiers devrait être visible et explicable pour l'équipe qui exploite la table.
Bonnes pratiques de partitionnement, de tri et de taille de fichiers
Iceberg ne rend pas automatiquement rapide une requête lente. La performance dépend généralement du rapport entre taille de fichiers, ordre de tri, transformations de partition et mélange réel de filtres. Le format vous donne des mécanismes pour faire évoluer l'agencement, mais les ingénieurs doivent encore le tester et l'entretenir.
Commencez par la taille des fichiers. Une plage de départ courante est de 128 à 512 Mo, mais la bonne cible dépend des motifs de lecture, des réglages du format de fichier, de la compression et du comportement du moteur. Les petits fichiers alourdissent la planification et rendent les scans inefficaces. Des fichiers très volumineux peuvent réduire le parallélisme ou rendre les lectures sélectives moins économiques.
Le tri est le deuxième levier. Triez sur l'heure d'événement quand les scans par fenêtre temporelle dominent. Utilisez une colonne de filtre à forte cardinalité lorsqu'elle produit un regroupement utile, et n'envisagez une organisation de type Z-order que là où le moteur et l'outillage de maintenance la prennent en charge de façon cohérente. Une clé de tri séduisante sur le papier peut être fausse pour le mélange réel de requêtes.
Le partitionnement masqué est un outil d'affinage, pas un substitut à l'analyse de la charge. L'évolution des partitions permet d'ajuster la spécification sans réécrire aussitôt les fichiers historiques, mais chaque spécification supplémentaire augmente le nombre d'agencements que les planificateurs doivent interpréter.
Levier | Point de départ | Quand ajuster | Erreur fréquente |
|---|---|---|---|
Taille de fichier | Commencez autour de 128 à 512 Mo et validez avec des scans représentatifs | Ajustez selon les lectures sélectives, la concurrence et le parallélisme du moteur | Laisser s'accumuler quantité de fichiers minuscules |
Ordre de tri | Commencez par les filtres temporels courants ou des colonnes sélectives stables | Changez quand l'historique des requêtes montre d'autres prédicats dominants | Choisir une clé à l'intuition plutôt que d'après les requêtes observées |
Transformation de partition | Utilisez une transformation grossière et pertinente pour le métier | Faites-la évoluer quand les motifs d'accès changent sensiblement | Créer trop de partitions |
Maintenance | Planifiez le compactage et le nettoyage des métadonnées | Augmentez la fréquence à mesure que l'ingestion et le nombre de tables croissent | Traiter le nettoyage comme une tâche d'urgence |
Évitez le sur-partitionnement qui produit des fichiers de moins de 64 Mo. Préférez une granularité quotidienne ou mensuelle à une granularité horaire quand le volume résultant est faible. Ce sont des heuristiques d'exploitation, pas des garanties : validez-les sur des charges représentatives avant d'en faire une norme.
Le compactage n'est pas optionnel à grande échelle. Les procédures de réécriture Spark, la maintenance sous Flink ou des outils externes peuvent regrouper les fichiers et améliorer l'agencement, mais ils doivent être coordonnés avec la rétention des snapshots et le nettoyage des fichiers orphelins. L'évolution des partitions réduit la pression de réécriture, sans supprimer la nécessité de surveiller la croissance des métadonnées.
Exploiter des tables Iceberg en pensant schéma, qualité et Timeliness
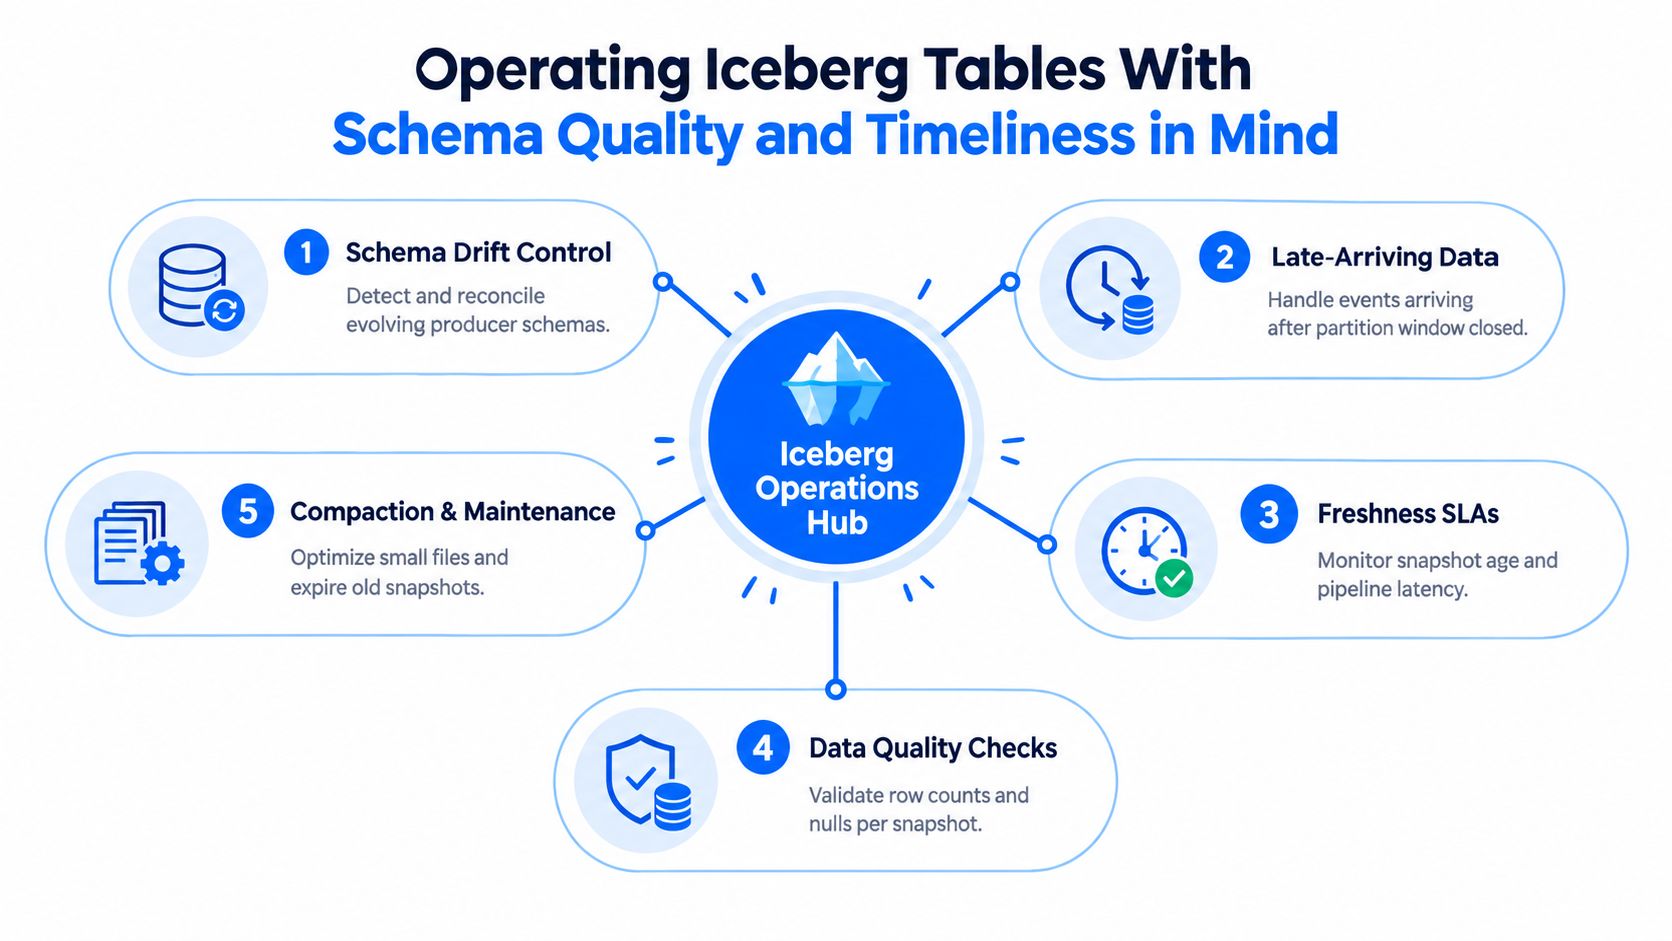
Dès qu'une équipe exploite de nombreuses tables Iceberg, la plupart des incidents commencent par un défaut de détection. Un producteur modifie un champ sans prévenir les consommateurs, des événements tardifs arrivent après la fenêtre de partition attendue, un pipeline crée des snapshots sans livrer de données utiles, ou la maintenance laisse une table techniquement lisible mais coûteuse à exploiter.
Traitez chaque risque comme un signal qui demande un responsable et une réponse :
Dérive de schéma : détectez les champs ajoutés, supprimés, renommés ou dont le type a changé avant que les traitements en aval ne les interprètent de travers.
Données tardives : comparez l'heure d'événement et l'heure d'arrivée pour qu'une partition temporelle close ne masque pas un problème de livraison.
Fraîcheur : suivez l'âge du dernier snapshot utile, et pas seulement le fait qu'un écrivain se soit exécuté.
Qualité : rattachez les résultats de validation à un snapshot précis pour qu'un incident soit reproductible.
Santé des métadonnées : surveillez le nombre de snapshots, la croissance des manifestes, les fichiers orphelins et la distribution des tailles de fichiers.
Rendre le snapshot courant explicable
Une vue d'exploitation fiable relie l'état de la table au comportement du pipeline. Un contrôle de nombre de lignes sans identité de snapshot ne dit pas à un ingénieur quelle version a échoué. Une alerte de fraîcheur fondée sur la seule horloge peut mal classer une table qui a reçu un lot vide ou malformé. Une alerte de schéma sans responsable en aval crée du bruit au lieu d'une action.
digna peut se placer à côté du catalogue et de la couche de calcul à cette fin. Son Schema Tracker surveille les changements structurels, Data Validation applique des contrôles métier au niveau des enregistrements, Timeliness suit les arrivées attendues et les retards, et les vues d'observabilité aident les équipes à examiner tendances et comportement de la plateforme. Son modèle d'exécution dans la base garde le calcul des métriques dans l'environnement du client plutôt que de déplacer des données de production vers un service externe.
La question d'exploitation à deux heures du matin n'est pas de savoir si Iceberg a validé correctement. C'est de savoir si la table est digne de confiance à cet instant, quel snapshot est touché et ce qui a changé depuis le dernier état sain. Cette réponse exige des signaux de qualité, de ponctualité, de schéma et de métadonnées dans un seul contexte d'incident.
Migrer depuis Hive, Delta ou Hudi sans incendier le lake
Les chemins de migration diffèrent nettement selon le format source. Les tables Hive externes sont souvent les plus abordables car les fichiers existants peuvent déjà convenir, mais des identifiants discordants, des hypothèses de SerDe et l'enregistrement au catalogue peuvent tout de même casser les lecteurs en aval. Une conversion de métadonnées ou une voie CTAS peut fonctionner pour une table et échouer pour une autre quand les hypothèses d'agencement physique diffèrent.
Delta demande un examen plus attentif. Les utilitaires de conversion ou de réécriture doivent prendre en compte les vecteurs de suppression, les réglages du change data feed et les colonnes d'identité qui ne se transposent pas proprement dans le modèle cible. Un enregistrement de table réussi ne prouve pas que le comportement historique, les suppressions ou les consommateurs incrémentaux se comporteront de la même façon.
Hudi est généralement la migration la plus ardue quand la source dépend du comportement merge-on-read, copy-on-write ou de la sémantique de la chronologie. Les snapshots Iceberg n'offrent pas de remplacement direct pour chaque opération de chronologie Hudi ; les équipes peuvent donc avoir besoin d'une réécriture complète et d'une frontière de bascule définie avec soin.
Une séquence de bascule plus sûre
Le choix du catalogue vient en premier. Décidez si le patrimoine cible utilisera REST, Glue, Nessie ou le Hive Metastore, puis testez permissions, identifiants, gestion des identifiants d'accès et comportement de rollback. Les outils de BI mettent souvent en cache des noms pleinement qualifiés ; changer de catalogue ou d'espace de noms peut donc casser des rapports même quand les données sont correctes.
La migration des partitions mérite son propre test. Le partitionnement masqué change la façon dont les utilisateurs expriment les filtres et dont les moteurs interprètent les transformations, tandis que anciens et nouveaux agencements peuvent coexister pendant la transition. La double écriture peut préserver des options de rollback, mais elle crée aussi un travail de réconciliation à surveiller.
Utilisez cette séquence :
Inventaire : recensez schémas, partitions, consommateurs, écritures, règles de rétention et besoins de lecture historique.
Pilote : convertissez des tables non critiques et testez chaque moteur important.
Double lecture : comparez résultats, comptages, schémas, fraîcheur et comportement d'accès.
Bascule : déplacez les consommateurs de façon délibérée, préservez une voie de rollback et gardez l'ancienne route disponible jusqu'à la fin de la validation.
Pour une planification plus large, utilisez les bonnes pratiques de migration d'un entrepôt de données vers un data lake comme liste de contrôle, puis adaptez-les aux contraintes de catalogue et de moteur de votre patrimoine.
digna fournit qualité des données et observabilité au sein de votre environnement pour les opérations autour d'Iceberg : suivi de schéma, validation d'enregistrements, surveillance de la ponctualité, détection d'anomalies et métriques de plateforme. Rendez-vous sur digna pour évaluer comment ces signaux peuvent aider votre équipe à exploiter de vastes patrimoines de tables avec des preuves plus claires et une réponse aux incidents plus rapide.
L'historique des snapshots vous dit ce qui a changé, mais pas si le changement était mauvais — pour cela, associez les métadonnées Iceberg à l'observabilité de la plateforme de données.
Questions fréquentes
D'où vient Apache Iceberg ?
Il a démarré chez Netflix en 2017 pour traiter les limites de passage à l'échelle et de cohérence des tables Apache Hive. Netflix l'a donné à l'Apache Software Foundation en novembre 2018, et il est devenu projet Apache de premier plan en mai 2020.
Pourquoi Iceberg est-il une discipline d'exploitation plutôt qu'un format de fichier ?
Parce qu'une équipe peut l'adopter vite et rester sans réponse aux questions qui comptent en production. La couche physique de données est relativement simple ; la performance et la justesse se jouent à la couche d'exploitation au-dessus.
Qu'exige réellement l'exploitation d'Iceberg ?
Quatre choses : une gouvernance de catalogue décidant qui peut créer, modifier, supprimer ou promouvoir des tables et comment les identifiants se résolvent ; une hygiène des métadonnées maîtrisant la rétention des snapshots, la suppression des fichiers orphelins et la croissance des manifestes ; une coordination des moteurs testant la façon dont Spark, Flink et Trino traitent les mêmes spécifications ; et des preuves reliant qualité, fraîcheur et lignage à un état de table.
Quelle est l'idée de conception centrale d'Iceberg ?
Séparer l'état de la table de l'agencement physique des fichiers. C'est de cette séparation que vient sa valeur, et c'est aussi pourquoi les questions d'exploitation montent d'un cran au lieu de disparaître.
Comment faut-il traiter une table Iceberg ?
Comme un produit géré doté d'une personne responsable, d'une politique d'exploitation et d'un cycle de vie observable. Une table privée de ces trois éléments a une spécification, mais personne pour répondre de son comportement dans la durée.



