Guide d'amélioration de la qualité des données pour les équipes d'entreprise
|
6
minute de lecture

Un tableau de bord trimestriel des revenus peut sembler parfaitement sain tout en surestimant les réservations EMEA pendant des semaines. Une mise à niveau de fournisseur modifie une colonne de devise du système source, des valeurs nulles commencent à affluer dans l'entrepôt, et une transformation en aval interprète incorrectement les valeurs manquantes. La finance découvre le problème lors de la préparation du conseil d'administration, après que les analystes ont déjà diffusé des rapports et que les dirigeants ont pris des décisions sur cette base.
Cet incident n'est pas principalement un problème de tableau de bord. C'est un échec d'amélioration de la qualité des données impliquant le contrôle des schémas, la promptitude, la propriété et la réponse aux incidents. Le correctif n'est pas un énième achat isolé de surveillance. C'est un modèle opérationnel qui définit ce que signifient des données fiables, attribue la responsabilité aux équipes qui les créent, détecte les défauts à proximité de leur origine et mesure la rapidité avec laquelle l'organisation rétablit la confiance.
Table des matières
Pourquoi la plupart des programmes de qualité des données s'enlisent avant de commencer
L'outil est rarement le modèle opérationnel
La couverture doit s'étendre au-delà de l'exhaustivité
Évaluer l'état actuel de votre qualité des données
Construire la base de référence à partir de quatre flux de preuves
Créer un aperçu mesurable de la maturité
Définir des SLA et des KPI qui tiennent réellement la route
Hiérarchiser les ensembles de données par conséquence
Séparer les signaux précoces des mesures de résultats
Validation, détection d'anomalies, promptitude et contrôles de schéma
Associer le contrôle au défaut
Exécution en base de données, intégration des flux de travail et guides opérationnels
Acheminer les signaux vers le travail existant
Rendre le guide opérationnel exécutable
Organisation des équipes, propriété et cadence opérationnelle
Séparer les rôles
Transformer les réunions en livrables
Mesurer le ROI et vos 90 premiers jours
Convertir les pertes opérationnelles en analyse de rentabilité
Utiliser une séquence ciblée de 90 jours
Pourquoi la plupart des programmes de qualité des données s'enlisent avant de commencer
La première réaction à un incident comme l'exemple de l'EMEA est souvent prévisible. Quelqu'un propose une plateforme de qualité des données, une autre équipe construit un tableau de bord des taux de valeurs nulles, et un centre d'excellence publie des normes que les producteurs ne voient jamais. L'organisation crée une activité visible sans modifier les conditions qui ont permis au défaut de passer.
L'outil est rarement le modèle opérationnel
Un outil de qualité peut calculer des indicateurs, exécuter des règles et acheminer des alertes. Il ne peut pas décider si c'est l'équipe financière ou l'équipe des systèmes commerciaux qui possède le champ de devise. Il ne peut pas non plus déterminer si une valeur manquante doit bloquer un chargement, mettre en quarantaine les enregistrements affectés ou déclencher un avertissement pendant que le traitement se poursuit.
Cette décision nécessite un contrat documenté entre producteurs et consommateurs. Sans cela, les équipes débattent des alertes après l'incident au lieu de s'accorder au préalable sur un comportement acceptable. Une analyse utile des causes structurelles apparaît dans cette analyse des raisons pour lesquelles les projets de qualité des données échouent, en particulier la distinction entre les symptômes techniques et les causes organisationnelles.
La couverture doit s'étendre au-delà de l'exhaustivité
Les taux de valeurs nulles sont utiles, mais une table peut être complète et tout de même erronée. Un flux peut arriver en retard, contenir un schéma modifié, utiliser un code de devise invalide ou introduire des clés d'activité en double. Les équipes qui ne mesurent que l'exhaustivité créent un faux sentiment de contrôle parce qu'elles vérifient une seule dimension tout en ignorant la fenêtre de décision et la signification des données.
Un programme fonctionnel attribue des contrôles aux risques qui comptent :
Normes : Définitions, valeurs acceptées, propriété et procédures de modification.
Responsabilité : Producteurs et coordinateurs désignés ayant l'autorité nécessaire pour résoudre les défauts.
Retours d'expérience : Alertes, tickets, rétrospectives et modifications de flux qui empêchent la récurrence.
La qualité nécessite également une approche économique. Le résumé de l'IBM Institute for Business Value indique que 43 % des directeurs des opérations ont identifié les problèmes de qualité des données comme leur priorité la plus importante en matière de données. Plus d'un quart des organisations ont signalé des pertes annuelles supérieures à 5 millions USD, tandis que 7 % ont signalé des pertes de 25 millions USD ou plus. Ces chiffres expliquent pourquoi la qualité a sa place dans les revues opérationnelles, et pas seulement dans les carnets de commandes d'ingénierie.
L'unité pratique de progrès est le cycle incident-résolution. Un programme fonctionne lorsqu'il détecte les défaillances plus tôt, les achemine vers le bon propriétaire, limite l'exposition en aval et transforme chaque constatation post-incident en un contrôle de flux plus solide.
Évaluer l'état actuel de votre qualité des données
Commencez par des preuves, pas par la frustration des parties prenantes. Les gens disent souvent qu'ils ne font pas confiance à un ensemble de données, mais cette perception peut refléter une poignée d'incidents visibles, des définitions peu claires ou des défauts mesurables. Votre base de référence doit capturer les trois.
Construire la base de référence à partir de quatre flux de preuves
Premièrement, effectuez une archéologie des incidents. Exportez les six derniers mois de tickets liés aux données depuis Jira ou ServiceNow. Regroupez chaque ticket par domaine, ensemble de données affecté, type de défaut, cause d'origine, temps de détection, temps de résolution, et si le même problème était déjà apparu auparavant. Ne jetez pas les "petits" tickets. Des corrections manuelles répétées révèlent souvent une faiblesse de processus qu'une panne majeure exposera plus tard.
Deuxièmement, profilez automatiquement les tables critiques. Examinez les taux de valeurs nulles, la cardinalité distincte, les valeurs minimales et maximales, les clés dupliquées, l'intégrité référentielle et les changements de distribution. Comparez les comptages source et cible le cas échéant, mais ne traitez pas des comptages de lignes correspondants comme une preuve d'exactitude. Une transformation peut préserver le volume tout en corrompant les valeurs.
Troisièmement, interrogez séparément les producteurs et les consommateurs. Demandez aux producteurs quels champs ils estiment posséder et aux consommateurs si les données sont adaptées à leurs décisions. Capturez des scores de confiance qualitatifs parallèlement aux modèles d'utilisation, rapports critiques, modèles et flux de travail opérationnels. Un ensemble de données très utilisé mais peu fiable mérite la priorité, même si son historique d'incidents est calme.
Quatrièmement, classez les défauts selon les six dimensions. Utilisez l'exactitude, l'exhaustivité, la cohérence, la promptitude, la validité et l'unicité comme vocabulaire partagé. Le modèle de maturité de la qualité des données peut aider les équipes à transformer des observations dispersées en une base de référence reproductible plutôt qu'en un atelier ponctuel.
Créer un aperçu mesurable de la maturité
Attribuez une note à chaque dimension sur une échelle de 1 à 5, en utilisant des preuves explicites. Un score faible peut signifier que l'organisation n'a pas de définition partagée ni de mesure reproductible. Un score moyen peut indiquer des vérifications automatisées mais une propriété incohérente. Un score élevé doit nécessiter des seuils documentés, des contrôles surveillés, des propriétaires responsables, un historique des incidents et des améliorations régulières.
Dimension | Métrique principale | Approche d'échantillonnage | Source de détection typique |
|---|---|---|---|
Exactitude | Accord avec une source faisant autorité ou un résultat vérifié | Comparer les champs critiques avec les enregistrements sources ou les données de référence approuvées | Rapprochement, examen par le consommateur |
Exhaustivité | Taux de valeurs nulles, d'enregistrements manquants et de champs obligatoires | Vérifications de table complète pour les champs critiques, vérifications échantillonnées pour les attributs à faible risque | Profilage, tests de validation |
Cohérence | Accord entre les systèmes, les tables et les définitions | Comparer les clés partagées, les unités, les étiquettes et les valeurs calculées | Rapprochement inter-systèmes |
Timeliness | Arrivée et disponibilité par rapport à la fenêtre de décision | Surveiller chaque partition ou événement de livraison attendu | Moniteur de planification, journaux de pipeline |
Validité | Conformité aux types, plages, formats et règles de gestion | Vérifications complètes pour les champs contraints, échantillonnage ciblé pour les enregistrements complexes | Vérifications de schéma, moteur de règles |
Unicité | Taux de doublons pour les clés d'activité définies | Analyses de clés complètes ou détection incrémentielle des doublons | Contraintes de base de données, profilage |
Conservez l'historique des versions de la base de référence. Un score sans les tests, échantillons et définitions sous-jacents ne peut pas soutenir une comparaison d'un trimestre à l'autre.
Définir des SLA et des KPI qui tiennent réellement la route
Un SLA de qualité des données nécessite quatre éléments : un propriétaire, un seuil, une fenêtre de mesure et un chemin d'escalade. Retirez l'un d'entre eux et le SLA devient un vœu pieux. « Garder les données fraîches » n'est pas applicable. « Le flux de données sur les risques doit arriver dans sa fenêtre de décision convenue, le propriétaire des données sur les risques étant alerté lorsque le seuil est franchi » est opérationnel.
Hiérarchiser les ensembles de données par conséquence
N'appliquez pas la même intensité de contrôle à chaque table. Classez les ensembles de données en tant que critiques, opérationnels ou exploratoires en fonction de l'impact sur l'activité, de l'exposition réglementaire, de la dépendance en aval et des attentes de rétablissement.
Les ensembles de données critiques soutiennent les rapports financiers, les décisions de gestion des risques, les soumissions réglementaires ou les opérations clients essentielles. Les ensembles de données opérationnels alimentent les flux de travail récurrents et les rapports de gestion. Les ensembles de données exploratoires soutiennent les analyses pour lesquelles des données retardées ou imparfaites sont incommodes mais pas immédiatement dommageables.
Les seuils doivent refléter l'utilisation, et non une carte de score universelle. Une table de faits sur les revenus peut nécessiter une exhaustivité de 95 %, tandis qu'un flux de risques intrajournalier peut nécessiter une fraîcheur de 98 %, mais ces chiffres n'ont d'importance que si chacun est lié à un propriétaire, une fenêtre de mesure définie et une réponse explicite. L'objectif est de rendre visible le compromis commercial.
Séparer les signaux précoces des mesures de résultats
Les comptages de lignes et les taux de valeurs nulles décrivent l'état des données après traitement. Ce sont des indicateurs de retard utiles, mais ils ne vous diront pas si le modèle opérationnel s'améliore. Ajoutez des indicateurs avancés tels que le taux de non-respect des SLA, le temps de prise en compte, le taux de défauts signalés par les consommateurs, le taux d'incidents récurrents et le pourcentage d'ensembles de données critiques dotés de guides opérationnels à jour.
Niveau | SLA de fraîcheur | KPI d'exhaustivité | KPI de validité | Responsabilité du propriétaire |
|---|---|---|---|---|
Critique | Défini par la fenêtre de décision et surveillé à chaque livraison | Champs obligatoires mesurés à chaque chargement | Les règles de gestion bloquent ou mettent en quarantaine les défaillances matérielles | Coordinateur désigné, producteur propriétaire et escalade d'astreinte |
Opérationnel | Fenêtre de livraison convenue avec états d'avertissement et de dépassement | Tendance surveillée par rapport à un seuil approuvé | Enregistrements invalides acheminés pour correction avant consommation | Le producteur résout, le coordinateur confirme la conformité |
Exploratoire | Disponibilité au mieux avec statut visible | Profilé périodiquement plutôt que de bloquer le travail | Avertissements documentés pour les limites connues | Le consommateur accepte ou escalade le risque |
Publiez le SLA là où travaillent les producteurs. Intégrez-le dans le référentiel de l'entrepôt, la configuration du pipeline, le modèle de demande de modification (pull request) et le guide opérationnel d'incident. Un portail de gouvernance peut détenir la définition canonique, mais il ne doit pas être le seul endroit où les ingénieurs peuvent trouver le contrat.
Validation, détection d'anomalies, promptitude et contrôles de schéma
Aucun contrôle unique ne capture tous les défauts. La validation basée sur des règles offre de la précision lorsque le contrat est connu. La détection basée sur l'IA offre une couverture plus large lorsque le comportement normal est difficile à coder. Les contrôles de promptitude et de schéma traitent des modes de défaillance que les vérifications au niveau des valeurs manquent souvent.
Associer le contrôle au défaut
La validation déterministe est le bon choix pour les champs obligatoires, l'unicité, l'intégrité référentielle, les ensembles de valeurs acceptées, les types de données et les règles de gestion connues au niveau de la ligne. Elle est interprétable et facile à connecter à une piste d'audit. Sa faiblesse réside dans la maintenance. Chaque nouvelle règle nécessite une rédaction, des tests et une appropriation, et une règle ne peut pas détecter une défaillance que personne n'avait anticipée.
La détection d'anomalies apprend les distributions normales, les volumes, la cardinalité et le comportement au fil du temps. Elle peut révéler des dérives silencieuses, des décalages inattendus et des modifications de structure des données des fournisseurs sans nécessiter une règle pour chaque possibilité. Le compromis réside dans l'interprétabilité. Une alerte statistique nécessite du contexte, et les équipes doivent l'ajuster pour que des événements inhabituels mais légitimes ne créent pas une fatigue des alertes.
La surveillance de la promptitude vérifie si les données arrivent et deviennent utilisables dans leur fenêtre de décision. Une table qui existe mais reflète l'état de la veille n'est pas saine pour un processus intrajournalier. Les conseils sur la surveillance de la promptitude et de la validation des données recommandent des seuils d'obsolescence automatisés afin que les enregistrements obsolètes soient signalés avant que les flux de travail en aval ne s'appuient sur eux.
Le suivi des schémas gère les versions des types de colonnes, de la possibilité de valeurs nulles, des structures imbriquées et de la présence des champs. Il doit distinguer les modifications additives des modifications de rupture et de la dérive sémantique. L'ajout d'une colonne acceptant les valeurs nulles peut être sûr pour un consommateur et perturbateur pour un autre, d'où l'importance de l'analyse de lignage et d'impact.
Contrôle | Ce qu'il capture | Ce qu'il manque | Profil de coût | Couche la plus adaptée |
|---|---|---|---|---|
Validation déterministe | Violations de règles connues et échecs de contrat | Nouveaux schémas en dehors des règles définies | Effort de rédaction et de maintenance prévisible | Intégration, normalisation, mise à disposition |
Détection d'anomalies par l'IA | Décalages de distribution, volumes inhabituels, dérive comportementale silencieuse | Contexte nécessitant une explication métier | Création de règles manuelles moindre, besoin d'ajustement plus élevé | Surveillance globale à travers les pipelines |
Vérifications de promptitude | Chargements manqués, partitions retardées, données obsolètes mais présentes | Valeurs qui arrivent à temps mais sont erronées | Faible une fois les planifications et fenêtres définies | Limites d'intégration et de livraison |
Suivi des schémas | Champs et structures ajoutés, supprimés ou dont le type a changé | Changements de signification sans modification structurelle | Effort modéré de métadonnées et de propriété | Contrats sources et limites de pipelines |
Les équipes évaluant les modèles d'automatisation peuvent également consulter les perspectives d'automatisation de Truespeak pour un contexte de flux de travail plus large. Le programme de qualité doit toujours décider quelles défaillances bloquent le traitement, lesquelles mettent les enregistrements en quarantaine, et lesquelles informent simplement les consommateurs. Plus d'automatisation n'est pas automatiquement préférable si elle déplace l'incertitude vers une file d'attente opaque.
Une approche par couches est plus forte que de choisir entre les règles et l'IA. Utilisez des règles de validation des données et des contrôles de qualité continus pour les obligations connues, puis ajoutez la détection d'anomalies pour les cas marginaux.
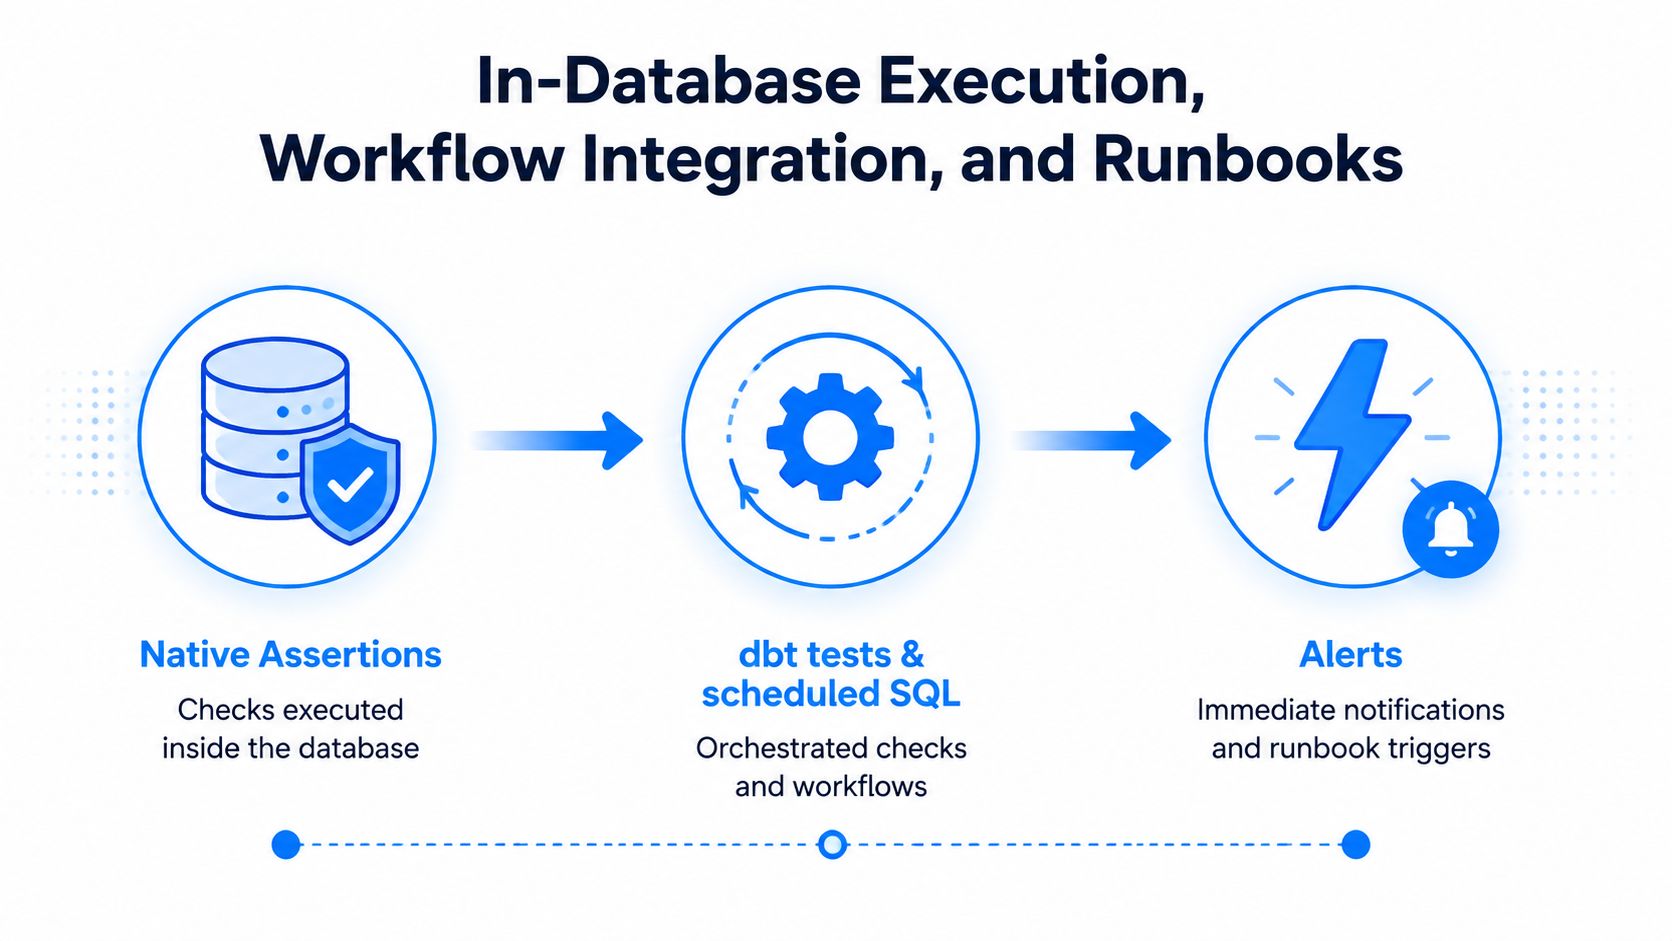
In-Database Execution, Workflow Integration, and Runbooks
Exécutez des vérifications à la limite où les données sont produites ou transformées. Les assertions natives, les tests dbt et le SQL planifié maintiennent la validation à proximité de la table et facilitent l'association des défaillances à un chargement, une partition ou une transformation spécifique. Une couche de surveillance distincte peut apporter de la valeur, mais elle ne doit pas introduire un long délai entre la création du défaut et sa détection.
Acheminer les signaux vers le travail existant
Utilisez un routage basé sur la gravité plutôt que d'envoyer chaque résultat à chaque canal.
Gravité un : Alertez l'ingénieur d'astreinte via PagerDuty lorsqu'un ensemble de données critique est indisponible, matériellement invalide ou en dehors de sa fenêtre de décision.
Gravité deux : Ouvrez un fil de discussion Slack avec le producteur et le coordinateur lorsque les consommateurs sont affectés mais qu'une solution de contournement contrôlée existe.
Suivi : Créez un ticket Jira pour les défauts récurrents, la maintenance des règles, la documentation ou la remédiation du pipeline.
Les conseils sur l'automatisation des flux de données sont utiles lors de la conception de ces transferts, mais le principe est simple : les alertes doivent atteindre la personne capable de modifier le processus de production.
Rendre le guide opérationnel exécutable
Un guide opérationnel (runbook) doit permettre à un ingénieur de commencer le diagnostic sans avoir à retrouver l'auteur d'origine. Incluez :
Signature de la défaillance : La métrique, la règle ou la planification qui a été enfreinte.
Zone d'impact : Les tables, tableaux de bord, modèles, rapports et processus métiers affectés.
Propriétaire probable : Producteur, coordinateur, équipe de plateforme ou fournisseur externe.
Trois premières requêtes : Vérifications des valeurs sources, des résultats de transformation et de l'impact en aval.
Étape de confinement : Restauration, mise en quarantaine, pause de chargement ou notification des consommateurs.
Modèle de communication : Ce qui s'est passé, ce qui est affecté, ce que les utilisateurs doivent faire et quand la prochaine mise à jour arrivera.
Dédoublonnez les alertes dans une fenêtre définie, masquez les alertes enfants lorsqu'une défaillance du pipeline parent les explique, et regroupez les constatations de faible gravité dans un résumé. Avant de déclarer le processus prêt, effectuez une simulation d'incident. Confirmez que l'alerte se déclenche, que le propriétaire est joignable, que les requêtes fonctionnent, que la restauration est sûre et que le ticket capture suffisamment de preuves pour une rétrospective ultérieure.
Organisation des équipes, propriété et cadence opérationnelle
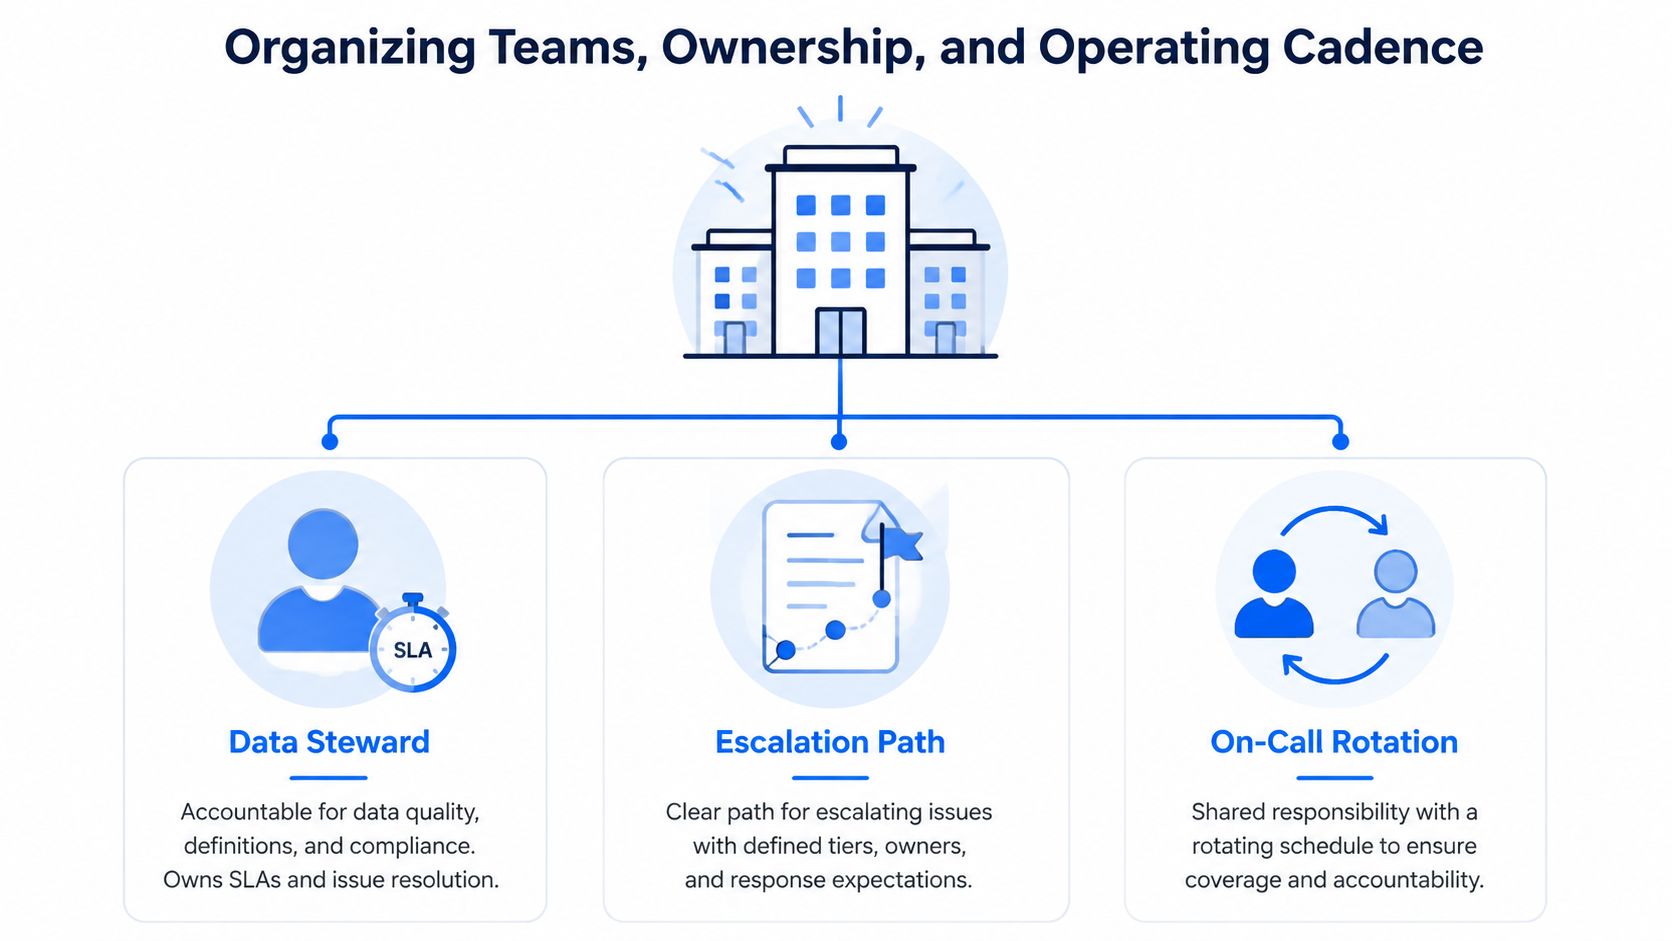
La propriété devient claire lorsque chaque ensemble de données a un coordinateur désigné, un producteur, un consommateur et un chemin d'escalade. Un centre d'excellence peut fournir des modèles et de l'accompagnement, mais il ne doit pas être responsable d'un défaut qu'il ne peut pas corriger.
Séparer les rôles
Le producteur de données possède l'intégration, les contrats sources, les modifications de schéma et le comportement du pipeline. Le coordinateur de données possède les définitions, les attentes de qualité, l'interprétation métier et la coordination des résolutions. Le consommateur de données valide si l'ensemble de données est adapté à un rapport, un modèle ou une décision opérationnelle et signale les défauts exploitables.
Les incidents transversaux nécessitent un responsable d'incident désigné. Si un fournisseur possède la source, qu'une équipe de systèmes commerciaux possède l'application et qu'une équipe de plateforme possède l'entrepôt, le responsable coordonne le confinement tandis que chaque groupe prend en charge sa part de l'investigation.
Transformer les réunions en livrables
Une cadence utile produit des décisions, pas des discussions :
Triage hebdomadaire : Examine les nouvelles anomalies, attribue des propriétaires, et clôture ou escalade les incidents.
Revue mensuelle des KPI : Compare les performances des SLA, les défauts récurrents, les rapports des consommateurs et les remédiations en retard.
Actualisation trimestrielle du contrat : Examine les définitions, les seuils, le lignage, les changements réglementaires et les nouveaux consommateurs.
Utilisez une matrice RACI légère pour chaque ensemble de données critique. Le producteur est responsable (R) de la mise en œuvre, le coordinateur est comptable (A) de la conformité et des définitions, les consommateurs sont consultés (C) sur l'impact, et le groupe de plateforme ou de gouvernance est informé (I) des changements systémiques. Adaptez les rôles si votre organisation utilise un modèle différent, mais ne laissez pas la responsabilité partagée par un comité anonyme.
Le modèle opérationnel nécessite également une rotation d'astreinte pour les pipelines les plus importants. Sans cela, les alertes arrivent en dehors des heures de bureau et l'organisation mesure la détection tout en acceptant une récupération lente. La propriété doit apparaître dans le catalogue, le référentiel, le contenu de l'alerte et le guide opérationnel, et pas seulement dans un document de réunion.
Mesurer le ROI et vos 90 premiers jours
La direction n'a pas besoin d'un autre score de qualité sans interprétation financière. Commencez par l'indisponibilité des données, la période pendant laquelle un ensemble de données est indisponible, obsolète ou non fiable pour l'usage auquel il est destiné. Une formule pratique est DDT = N × (TDD + TTR), où les incidents sont multipliés par le temps moyen de détection plus le temps moyen de résolution, comme décrit dans ces conseils de mesure de l'indisponibilité des données.
Convertir les pertes opérationnelles en analyse de rentabilité
Rassemblez les heures passées par les analystes, ingénieurs, équipes financières et opérationnelles à traquer des données erronées au cours du trimestre précédent. Multipliez ces heures par le coût horaire chargé concerné, puis ajoutez les conséquences documentées telles que les prévisions révisées, les décisions retardées, les actions clients manquées ou les remédiations de conformité.
Suivez les mêmes catégories après le déploiement. La comparaison doit montrer moins d'incidents, un temps de détection plus court, un temps de résolution réduit, moins de retouches et une exposition moindre aux décisions prises à partir de données non fiables. Ne prétendez pas que chaque incident évité est un revenu garanti. Séparez les économies concrètes des risques évités et rendez les hypothèses visibles.
Le dossier est d'importance pour de nombreuses entreprises. IBM rapporte que plus d'un quart des organisations estiment les pertes annuelles à plus de 5 millions USD en raison d'une mauvaise qualité des données, tandis que 7 % estiment les pertes à plus de 25 millions USD. Utilisez ces chiffres comme contexte, et non comme substitut à votre propre base de référence.
Utiliser une séquence ciblée de 90 jours
Phase | Jours | Livrables clés | Critères de réussite |
|---|---|---|---|
Base de référence | 1 à 15 | Profiler les cinq tables critiques prioritaires, définir les SLA, attribuer les propriétaires, enregistrer l'indisponibilité actuelle | Chaque ensemble de données prioritaire a un contrat, un propriétaire et une mesure de départ |
Instrumentation | 16 to 45 | Déployer des vérifications de schéma et de fraîcheur en base de données, acheminer les alertes vers les canaux d'astreinte, publier les guides opérationnels | Les infractions atteignent l'équipe responsable avec un contexte de diagnostic exploitable |
Ajustement | 46 to 75 | Ajouter la détection d'anomalies, examiner les faux positifs, ajuster les seuils et documenter les exceptions | Le volume d'alertes est gérable et les changements significatifs font l'objet d'une enquête |
Revue | 76 to 90 | Animer la revue trimestrielle, signaler les changements d'indisponibilité et de réponse, et sélectionner la prochaine zone de couverture | La direction constate l'impact opérationnel et approuve la prochaine extension |
Le cadre d'analyse de rentabilité de la qualité des données peut aider à structurer le récit financier autour des coûts, des risques et des résultats mesurables.
Évitez quatre pièges. Les indicateurs de vanité récompensent le nombre de vérifications plutôt qu'une détection utile. La fatigue des alertes masque les défaillances graves sous le bruit. L'outillage sans responsabilité crée des tableaux de bord au lieu de remédiations. L'omission de la première rétrospective d'incident garantit le retour de la même classe de défaut.
Commencez avec cinq tables critiques, un propriétaire désigné pour chacune, et une définition écrite de ce que signifie « disponible et digne de confiance ». Mesurez ensuite le premier incident, de sa détection à sa résolution, car ce cycle vous en dira plus sur la maturité du programme qu'un score de qualité poli.
digna fournit une validation en base de données, une détection d'anomalies, une surveillance de la promptitude et un suivi des schémas au sein de votre propre environnement, afin que les équipes puissent connecter les contrôles de qualité aux pipelines et aux ensembles de données qu'elles exploitent déjà. Visitez digna pour évaluer une approche modulaire de l'amélioration de la qualité des données à travers les entrepôts, les lacs et les pipelines d'entreprise.
Questions fréquentes
Pourquoi les programmes qualité calent-ils avant de démarrer ?
Parce que la première réaction à un incident consiste souvent à acheter ou configurer un outil. Un outil qualité calcule des métriques, exécute des règles et achemine des alertes, mais il ne peut pas décider de ce que « correct » signifie, ce qui suppose un contrat documenté entre producteurs et consommateurs.
Mesurer les taux de valeurs nulles suffit-il ?
Non. Les taux de valeurs nulles sont utiles, mais une table peut être complète et fausse. La couverture doit dépasser la complétude pour atteindre les définitions, les valeurs acceptées et les relations qui déterminent si un enregistrement complet est aussi juste.
Qu'attribue un programme qui fonctionne ?
Des contrôles aux risques qui comptent, sur trois terrains : des standards couvrant définitions, valeurs acceptées, propriété et procédures de changement ; une responsabilité portée par des producteurs et stewards nommés ayant autorité pour résoudre les défauts ; et un retour via alertes, tickets, rétrospectives et modifications de pipeline qui préviennent la récidive.
Pourquoi la qualité a-t-elle besoin d'un regard économique ?
Parce que sans lui, chaque jeu de données semble mériter la même attention. Relier les contrôles au coût d'une défaillance permet de justifier où porter l'effort et ce qui reste surveillé sans être corrigé pour l'instant.
À quoi ressemble la défaillance classique ?
Un tableau de bord de revenus d'apparence parfaitement saine qui surestime pendant des semaines les réservations d'une région. L'incident n'est pas d'abord un problème de tableau de bord, et c'est pourquoi le remplacer ou ajouter un contrôle de plus empêche rarement le suivant.


