Razonabilidad de los datos: cómo detectar datos que parecen incorrectos pero superan sus reglas
|
8
minuto de lectura

Los datos pueden superar todas las reglas de validación y, aun así, no ser razonables.
Esa es la brecha operativa detrás de muchos cuadros de mando fallidos, informes engañosos e inputs de IA poco fiables. La Data Validation tradicional comprueba condiciones definidas explícitamente, como los tipos de datos, los campos obligatorios, los valores permitidos y los límites máximos. La razonabilidad de los datos plantea una pregunta diferente: ¿se comportan los datos como se espera en su contexto empresarial?
Una transacción puede contener una moneda válida, una marca de tiempo válida y un importe inferior al límite configurado, y aun así representar un problema grave de datos. Un archivo retrasado puede estar completo cuando finalmente llega, pero ser inservible para una decisión que dependía de él previamente. Un esquema puede seguir siendo técnicamente legible mientras un cambio estructural sutil altera el significado de las métricas descendentes.
La exposición financiera es sustancial. El punto de referencia ampliamente citado es que la mala calidad de los datos cuesta a las organizaciones una media de unos 12,9 millones de dólares al año, mientras que IBM informó en 2026 de que más de una cuarta parte de las organizaciones pierden más de 5 millones de dólares anuales, y un 7% pierde 25 millones de dólares o más debido a la mala calidad de los datos. IBM también informó de que el 43% de los directores de operaciones identificaron la calidad de los datos como su prioridad de datos más importante, lo que demuestra que se trata de un riesgo operativo y no de un mero inconveniente de análisis. Consulte el análisis de IBM sobre el coste de la mala calidad de los datos para obtener un contexto empresarial más amplio.
Índice de contenidos
Cuando los datos válidos parecen incorrectos
Qué hace que los datos no sean razonables
La razonabilidad es multidimensional
Por qué la validación basada en reglas se queda corta
Dónde funcionan las reglas explícitas
Dónde las reglas resultan costosas
Cómo detectan las organizaciones los datos no razonables
Rangos esperados
Líneas de base históricas
Distribuciones estadísticas
Tendencias y comparaciones con pares
Validación frente a razonabilidad frente a detección de anomalías
Cómo apoya digna la razonabilidad de los datos
Monitoreo continuo de datos no razonables
Cuando los datos válidos parecen incorrectos
Las reglas son útiles porque convierten las expectativas conocidas en comprobaciones repetibles. Detectan valores nulos, identificadores mal formados, fechas inválidas, claves duplicadas y valores fuera de un dominio aprobado. Pero solo detectan lo que alguien ya ha descrito.
El monitoreo de razonabilidad cubre la brecha entre la validez técnica y la adecuación contextual. Un valor puede satisfacer una regla y, al mismo tiempo, contradecir el comportamiento histórico, la distribución, los tiempos o las relaciones que hacen que el conjunto de datos sea útil. Por eso, un informe de validación limpio no significa necesariamente que los datos sean seguros para las finanzas, las operaciones, los informes regulatorios o el aprendizaje automático.
Una distinción práctica resulta de ayuda:
Validez: El registro se ajusta a una regla estructural o de negocio explícita.
Calidad: El registro es preciso, completo, consistente, oportuno, único y apto para el uso previsto.
Razonabilidad: El valor o comportamiento tiene sentido en su contexto.
Detección de anomalías: La observación actual difiere materialmente del comportamiento aprendido o esperado.
La diferencia entre la validez de los datos y la calidad general de los datos es importante porque los equipos suelen tratar una regla superada como prueba de que no es necesaria ninguna investigación adicional. En producción, esa suposición falla cuando el problema es una desviación gradual, una llegada retrasada, un cambio en la distribución o un patrón multivariante que ninguna regla a nivel de campo puede expresar por sí sola.
Regla práctica: Una regla de validación superada significa "esta condición conocida no se ha infringido". No significa "no ha ocurrido nada inusual".
Por lo tanto, la razonabilidad no sustituye a la validación. Es una segunda capa que pone a prueba el comportamiento, el contexto y el cambio. La validación tradicional comprueba lo que ya se sabe que hay que buscar. El monitoreo de razonabilidad puede revelar comportamientos que no se esperaba encontrar.
Qué hace que los datos no sean razonables
Los datos no razonables son datos que parecen técnicamente aceptables pero entran en conflicto con los patrones, las relaciones, los tiempos o el contexto empresarial esperado para su uso. La palabra "no razonable" no significa "falso". Significa que la observación merece atención porque su comportamiento es difícil de explicar utilizando el contexto disponible.
Considere el importe de una transacción dentro de un rango permitido pero drásticamente superior a la actividad normal del cliente. Una regla puede aceptar cualquier valor de entre 0 y 1 millón de euros, mientras que el patrón establecido del cliente hace que merezca la pena investigar una transacción inusualmente grande. El mismo problema aparece en el monitoreo de volúmenes. Un aumento del 500% en los pedidos diarios podría reflejar una campaña exitosa, un evento estacional genuino, una ingesta duplicada o una unión rota. El número es una señal, no un veredicto.
Otros ejemplos incluyen:
La edad de un cliente que se encuentra dentro de un rango humano técnicamente válido pero que es muy inusual para el segmento.
Un cambio repentino en la distribución de precios de los productos, a pesar de que cada precio individual se mantiene dentro de los límites permitidos.
Un valor de ventas regional que difiere completamente de los patrones históricos a pesar de superar las comprobaciones de tipo, nulos y rango.
Una entrega tardía recurrente que deja la tabla completa pero hace que los usuarios descendentes tomen decisiones con datos obsoletos.
Una relación entre campos que cambia, como que las cantidades y los totales ya no se muevan juntos como lo hacían históricamente.

La razonabilidad es multidimensional
Los equipos de calidad de datos suelen trabajar en dimensiones que incluyen la precisión, la integridad, la consistencia, la Timeliness, la validez y la unicidad. Un registro puede ser válido pero no oportuno, completo pero inconsistente, o estructuralmente correcto pero inexacto. El monitoreo de razonabilidad ayuda a exponer esas combinaciones examinando cómo se comporta el conjunto de datos en lugar de inspeccionar los campos de forma aislada.
La detección de anomalías es especialmente útil para la identificación de valores atípicos, pero un valor atípico no debe eliminarse ni rechazarse automáticamente. Una promoción, una adquisición, una interrupción del servicio o un evento de mercado pueden crear una anomalía legítima. La respuesta correcta es añadir contexto, evaluar el impacto y decidir si la observación representa un cambio real o un defecto de los datos. La guía práctica sobre métodos de identificación de valores atípicos refuerza esta distinción.
Por qué la validación basada en reglas se queda corta
Tomemos una regla común:
El importe de la transacción debe estar entre 0 y 1 millón de euros.
Bajo esa regla, 500 €, 50.000 € y 900.000 € son todos válidos. La regla hace exactamente aquello para lo que fue diseñada, y eso es valioso. Evita que valores fuera del dominio aceptado entren en los procesos descendentes.
Pero supongamos que las transacciones históricas de un cliente se sitúan normalmente entre 50 € y 500 €. Una transacción de 900.000 € puede ser legítima, pero es lo suficientemente diferente del comportamiento establecido de ese cliente como para requerir una revisión. La regla estática no puede hacer ese juicio porque no tiene representación del historial específico del cliente.
Dónde funcionan las reglas explícitas
La validación basada en reglas sigue siendo la herramienta adecuada cuando la expectativa es conocida y estable:
Un identificador obligatorio no debe ser nulo.
Una fecha debe utilizar un formato aceptado.
Un estado debe pertenecer a un conjunto aprobado.
El importe de una transacción no debe superar un límite contractual.
Un registro debe satisfacer una relación documentada entre campos.
Estas comprobaciones son transparentes, fáciles de auditar y útiles para aplicar controles deterministas. También producen fallos procesables cuando la condición de negocio es explícita.
Dónde las reglas resultan costosas
Los problemas empiezan cuando los equipos intentan codificar manualmente cada posible expectativa de negocio. Añaden reglas para cada región, producto, tipo de cliente, patrón estacional, excepción y estado operativo. El resultado es una carga de mantenimiento creciente, cambios frecuentes de umbrales y un sistema de monitoreo que sigue perdiendo patrones que nadie pensó en definir.
Los enfoques estadísticos resuelven un problema diferente. ML.TFDV_VALIDATE de BigQuery, por ejemplo, compara las estadísticas de entrenamiento y de servicio para identificar diferencias anómalas entre los conjuntos de datos, lo que ilustra que la validación y la detección de anomalías son capas de control distintas. La perspectiva de las reglas de validación de datos y la calidad de datos continua es útil aquí: las comprobaciones deterministas aplican las condiciones conocidas, mientras que el monitoreo estadístico busca cambios inesperados.
Un diseño de producción sólido no elige un único enfoque. Utiliza la validación explícita para las restricciones conocidas y la detección de anomalías para el comportamiento que debe aprenderse a partir de las pruebas.
Cómo detectan las organizaciones los datos no razonables
Las organizaciones suelen evaluar la razonabilidad combinando varias formas de comportamiento esperado. Ningún umbral único funciona para todos los conjuntos de datos, por lo que el diseño del monitoreo debe reflejar la granularidad, la estacionalidad, la latencia y la importancia empresarial de cada métrica.
Rangos esperados
Comience con rangos donde la expectativa de negocio sea clara. Un precio, una edad, una cantidad o un saldo pueden tener un límite inferior y superior defendible. Estas comprobaciones son sencillas y explicables, pero no detectarán un valor inusual que se mantenga dentro del rango.
Líneas de base históricas
Una línea de base describe el comportamiento normal utilizando observaciones históricas. Un flujo de trabajo práctico recopila datos de referencia representativos, deriva una descripción estadística y evalúa continuamente los nuevos datos con respecto a ella. Un cambio detectado por las estadísticas de la prueba puede tratarse entonces como una anomalía, tal como se describe en esta guía de detección de anomalías basada en líneas de base.
Las líneas de base deben segmentarse cuando el contexto cambia el patrón esperado. El volumen diario de pedidos puede necesitar un comportamiento separado para los días laborables y los fines de semana. El gasto de los clientes puede requerir una comparación dentro de los segmentos de clientes en lugar de en toda la población.
Distribuciones estadísticas
Los promedios por sí solos pueden ocultar cambios importantes. Monitoree la distribución de precios, cantidades, saldos o valores categóricos. Una media estable puede coexistir con un cambio brusco en la dispersión, una nueva concentración en torno a un valor o la desaparición repentina de una categoría.
Los detectores prácticos definen un rango aceptable a partir del comportamiento normal. Un punto de partida común para la detección de anomalías con puntuación z es 3, lo que representa aproximadamente tres desviaciones estándar de la media bajo el supuesto de una distribución normal, tal como se documenta en la guía de detección de líneas de base de Nokia. Ese umbral es un punto de partida, no una configuración de producción universal.
Tendencias y comparaciones con pares
Las comprobaciones de tendencias identifican aumentos, disminuciones, inversiones repentinas o desviaciones sostenidas. Las comparaciones con pares añaden contexto al comparar regiones, productos, entidades o unidades de negocio similares. Una región puede parecer inusual a nivel global pero normal en comparación con sus propios pares estacionales.
Por último, añada una razonabilidad basada en reglas allí donde la expectativa de negocio sea conocida pero más contextual que una comprobación de validez básica. Los programas sólidos de calidad de datos combinan rangos esperados, líneas de base históricas, distribuciones, tendencias, comparaciones con pares y reglas deterministas.
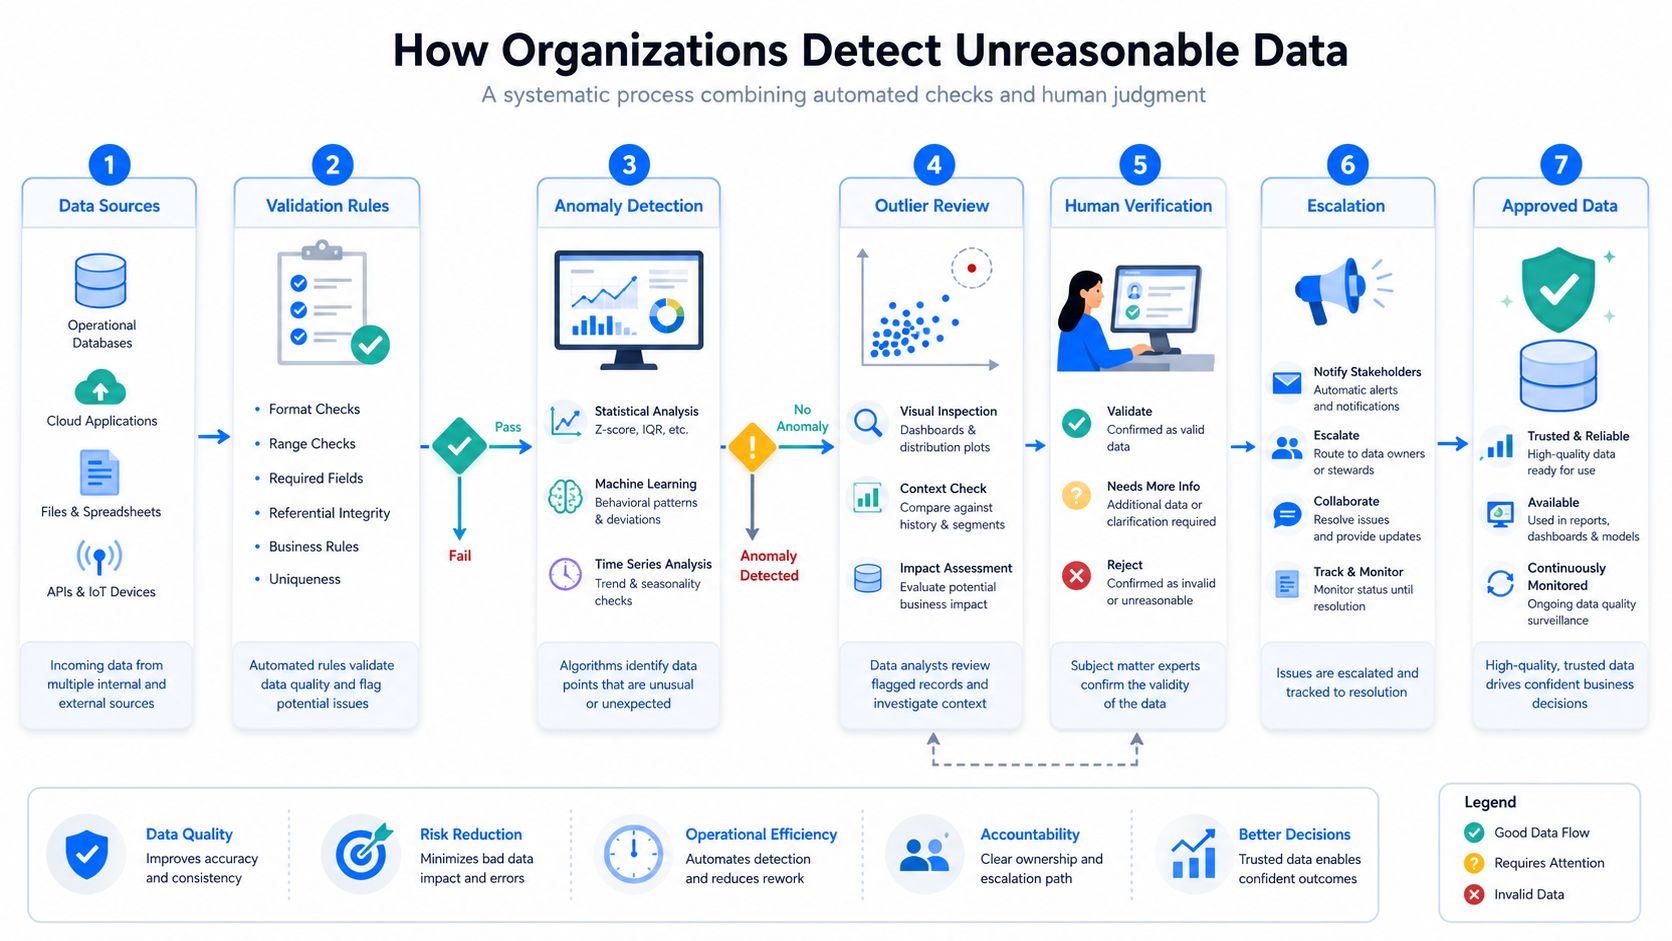
Para obtener una guía de implementación más amplia, la detección de anomalías para problemas tempranos de datos proporciona un marco operativo útil. La elección de diseño importante es ajustar las alertas en función de las consecuencias. Un pequeño cambio en una tabla de bajo impacto puede ser meramente informativo, mientras que un cambio modesto en un conjunto de datos regulatorios o financieros puede requerir una escalada inmediata.
Validación frente a razonabilidad frente a detección de anomalías
Un negocio minorista ofrece un ejemplo claro de cómo difieren los tres mecanismos. Su tabla de ventas diarias contiene normalmente alrededor de 2 millones de transacciones. Un día, la tabla contiene 2,1 millones, lo que puede superar una regla de volumen porque la tabla está presente, poblada y dentro de un límite operativo amplio. Sin embargo, el valor promedio del pedido aumenta en un 350%, creando un cambio de comportamiento que la validación estática tal vez nunca inspeccione.
La respuesta debe ser estructurada por capas:
La validación comprueba las restricciones conocidas. Confirma que los importes, las fechas, los identificadores y los campos obligatorios cumplen las reglas definidas.
La razonabilidad comprueba el contexto empresarial. Pregunta si el importe es plausible para el cliente, el producto, la región o el canal de ventas.
La detección de anomalías compara el comportamiento actual con el histórico. Señala el cambio repentino en el valor promedio de los pedidos y, posiblemente, los cambios de distribución relacionados.
El análisis histórico proporciona contexto. El equipo comprueba las campañas, los cambios de precios, las promociones, el comportamiento de ingesta y los eventos del sistema de origen.
La investigación determina el resultado. La anomalía puede representar una actividad de ventas real, registros duplicados, un problema de divisas o un defecto de transformación.
Enfoque | Pregunta | Ejemplo |
|---|---|---|
Validación | ¿Satisface el valor la regla? | Importe ≤ 1M € |
Regla de razonabilidad | ¿Satisface una condición comercial esperada? | Importe dentro del rango esperado del cliente |
Detección de anomalías | ¿Es el comportamiento inusual en comparación con el historial? | Aumento del 350% en el valor promedio del pedido |
La distinción se asemeja a otras disciplinas de monitoreo operativo. Los equipos que exploran el mantenimiento predictivo con Forge Reliability reconocerán el mismo principio: un sistema puede mantenerse dentro de un rango operativo permitido mientras su comportamiento cambia lo suficiente como para justificar una inspección. In data platforms, esto significa monitorear la trayectoria y las relaciones, no solo el estado de aprobado o fallido.
Esta es también la razón por la que Data Observability versus calidad de datos no debe tratarse como una elección binaria. La validación proporciona control sobre los requisitos conocidos. La razonabilidad proporciona un juicio contextual. La detección de anomalías proporciona una comparación adaptativa con el comportamiento observado.
Cómo apoya digna la razonabilidad de los datos
digna Data Anomalies aborda la brecha operativa entre las reglas creadas manualmente y el monitoreo basado en el comportamiento. Utiliza el aprendizaje de líneas de base impulsado por IA y la detección continua de anomalías para identificar desviaciones del comportamiento histórico sin requerir que los equipos definan cada condición posible de antemano.
El módulo puede sacar a la luz cambios inesperados de volumen, desviaciones en la distribución, valores métricos inusuales, cambios abruptos en los patrones históricos y anomalías recurrentes. Esto lo hace relevante cuando los datos siguen siendo sintácticamente válidos pero cambian de una manera que podría afectar a los informes, a las decisiones operativas o a los inputs de IA.
digna Data Analytics ayuda a los investigadores a examinar el contexto histórico detrás de una alerta. Los equipos pueden utilizar métricas de Observability histórica para revisar tendencias, volatilidad y patrones estadísticos en lugar de tratar una anomalía como un evento aislado. digna Data Validation sigue siendo útil cuando la condición esperada puede establecerse explícitamente como una regla de negocio, un requisito de auditoría o un control a nivel de registro.
El modelo de implementación es importante para los equipos empresariales. digna se ejecuta dentro de la propia infraestructura del cliente, con el cálculo y análisis de métricas realizados en la base de datos, por lo que los datos de producción permanecen en su lugar. El despliegue puede utilizar una nube privada o un entorno local dentro de la nube, VPC o centro de datos del cliente.
El valor práctico proviene de la combinación y no de un solo módulo. Las anomalías identifican comportamientos inesperados, las analíticas proporcionan contexto, la validación aplica condiciones conocidas y el monitoreo relacionado puede rastrear la Timeliness o los cambios de esquema que hacen que datos que de otro modo serían válidos no sean seguros de usar.
Monitoreo continuo de datos no razonables
El monitoreo continuo comienza con la priorización, no con un intento de monitorear cada columna por igual. Identifique los conjuntos de datos cuyo comportamiento no razonable podría afectar a la información financiera, a las decisiones de los clientes, al control operativo, al trabajo regulatorio o a los sistemas de IA. A continuación, defina el comportamiento que vale la pena observar, como el volumen, la hora de llegada, las distribuciones, las relaciones y las métricas comerciales.
Un modelo operativo útil consta de cuatro partes:
Línea de base: Aprender el comportamiento normal a partir de datos históricos representativos.
Detección: Comparar las nuevas observaciones con los patrones esperados y señalar las desviaciones significativas.
Contexto: Mostrar la tendencia histórica, las dimensiones afectadas y las métricas relacionadas.
Acción: Dirigir la alerta a un responsable que pueda investigar, clasificar y documentar el resultado.
La automatización es esencial porque la revisión manual no es escalable. Una presentación de supervisión sobre Data Governance informó de que el 42% de los encuestados globales identificaron la escasez de habilidades y de personal como la mayor barrera para obtener datos de alta calidad. Esa limitación hace que el monitoreo sensible al contexto sea más práctico que pedir a equipos que ya están sobrecargados que escriban y mantengan reglas para cada escenario posible. El mismo principio se aplica a los flujos operativos donde la Timeliness importa, incluidos los métodos de entrega de datos de esports fiables, porque un paquete de datos completo que llega tarde puede seguir fallando en su propósito comercial.
Una anomalía no significa que los datos sean incorrectos. Significa que la observación actual difiere del comportamiento esperado y necesita clasificación. Los equipos deben registrar si la causa fue un evento comercial legítimo, un cambio en el sistema de origen, un defecto en la tubería de datos, una carga duplicada, una entrega retrasada o un umbral demasiado sensible.
Los mejores programas de alerta también miden la calidad de las mismas. Suprima los eventos conocidos cuando sea apropiado, segmente las líneas de base por contextos significativos y priorice los incidentes por el daño descendente en lugar de por la frecuencia con la que falla una regla. Esto reduce el ruido al tiempo que preserva la atención para los cambios que pueden inducir a error en las decisiones.
Para las organizaciones que preparan datos para la IA, la brecha de preparación es significativa. Precisely informó de que solo el 12% de las organizaciones consideraba que sus datos tenían la calidad suficiente y eran lo suficientemente accesibles para la IA, mientras que el 64% nombró la calidad de los datos como su principal desafío de integridad de datos y el 49% citó las herramientas de automatización inadecuadas como el principal bloqueador. Estos hallazgos respaldan un principio operativo claro: el monitoreo de la calidad de los datos debe evaluar no solo si los datos son válidos, sino si siguen siendo confiables para la decisión que los consume.
digna combina Data Anomalies, Data Analytics, Data Validation, el monitoreo de Timeliness y el seguimiento de esquemas para detectar datos que superan las reglas estáticas pero se comportan de manera inesperada. Visite digna para ver cómo su plataforma en la base de datos puede ayudar a su equipo a monitorear datos no razonables de forma continua e investigar anomalías antes de que afecten a sus análisis o a la IA.


