Qué es un formato de tabla abierto
|
9
minuto de lectura

Es martes por la mañana. Un trabajo de Spark ha tomado un archivo Parquet mientras otro proceso aún lo estaba escribiendo. Un modelo dbt posterior lee un lote incompleto, lo vuelve a unir durante un reintento y duplica parte del total de ingresos. El equipo no encuentra el problema en los registros de la pipeline. Lo encuentra el área financiera, en un informe.
Este es el tipo de fallo que hace que un data lake en bruto se parezca menos a una base de datos y más a una carpeta compartida con un rendimiento excelente. Los archivos pueden ser duraderos, baratos y abiertos, pero el lake sigue necesitando una forma fiable de definir qué archivos pertenecen a una tabla, qué versión deben ver los lectores y cómo publican los escritores los cambios de forma segura. Ese es el papel de un formato de tabla abierto.
Tabla de contenidos
Cómo encajan los formatos de tabla abiertos en las plataformas de datos modernas
Límites y contrapartidas que la mayoría de los artículos omite
El problema que resuelve un formato de tabla abierto
Un data lake en bruto suele almacenar archivos en almacenamiento de objetos, a menudo con formatos como Parquet, ORC o Avro. El sistema de almacenamiento sabe que los archivos existen, pero no sabe automáticamente que un conjunto concreto de archivos representa una tabla lógica, que un lote nuevo está completo o que un lector debe ver el estado antiguo o el nuevo, nunca una mezcla de ambos.
Las convenciones de directorios intentan cubrir ese hueco. Los equipos crean carpetas para fechas, regiones, inquilinos o ejecuciones de ingesta, y luego piden a los motores de procesamiento que infieran la estructura de la tabla a partir de rutas y contenidos. Ese enfoque funciona hasta que llegan a la vez varios escritores, reintentos, actualizaciones, borrados, cambios de esquema y lectores concurrentes.
Regla práctica: una carpeta con archivos es almacenamiento. Una tabla necesita un contrato de identidad, estado y cambio.
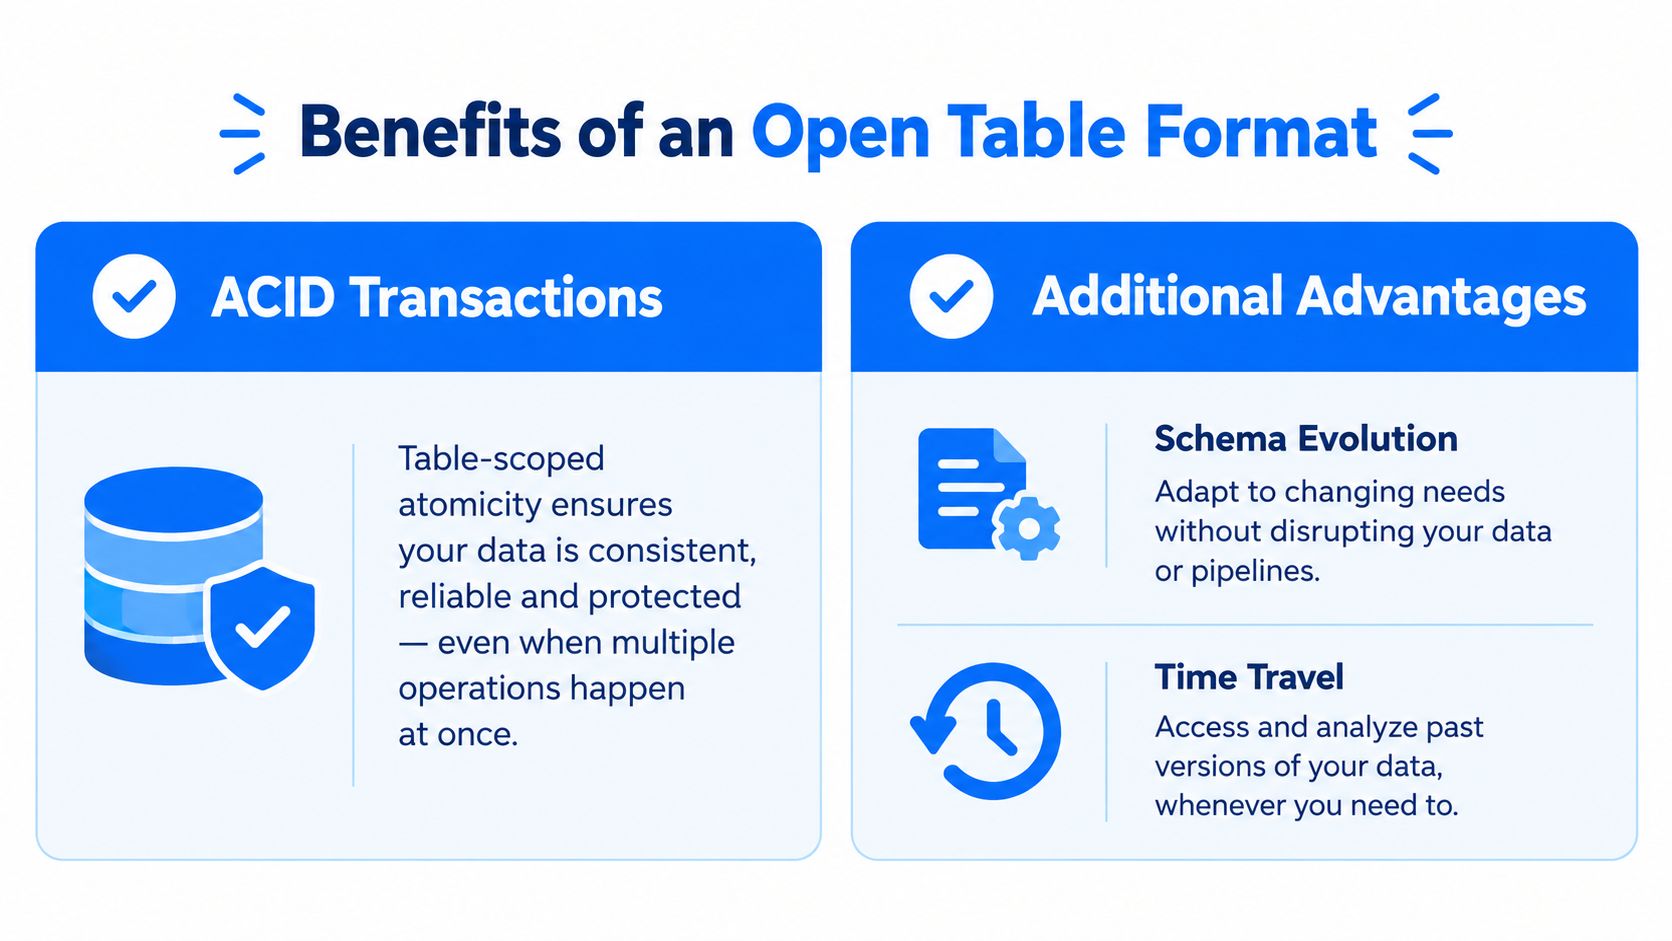
Un formato de tabla abierto es una capa de especificación y metadatos situada por encima de los archivos de datos en bruto y por debajo de los motores de consulta o procesamiento. Describe esos archivos como una tabla versionada y transaccional, incluidos el esquema, las reglas de particionado, los archivos activos y los snapshots confirmados. Los datos permanecen en almacenamiento abierto, mientras los metadatos de la tabla aportan la coordinación que a los directorios en bruto les falta. La visión general de Databricks sobre formatos de tabla abiertos describe esta capa como el mecanismo que añade capacidades como transacciones ACID, evolución de esquema, viaje en el tiempo y actualizaciones o borrados a nivel de fila a los archivos del almacenamiento de objetos.
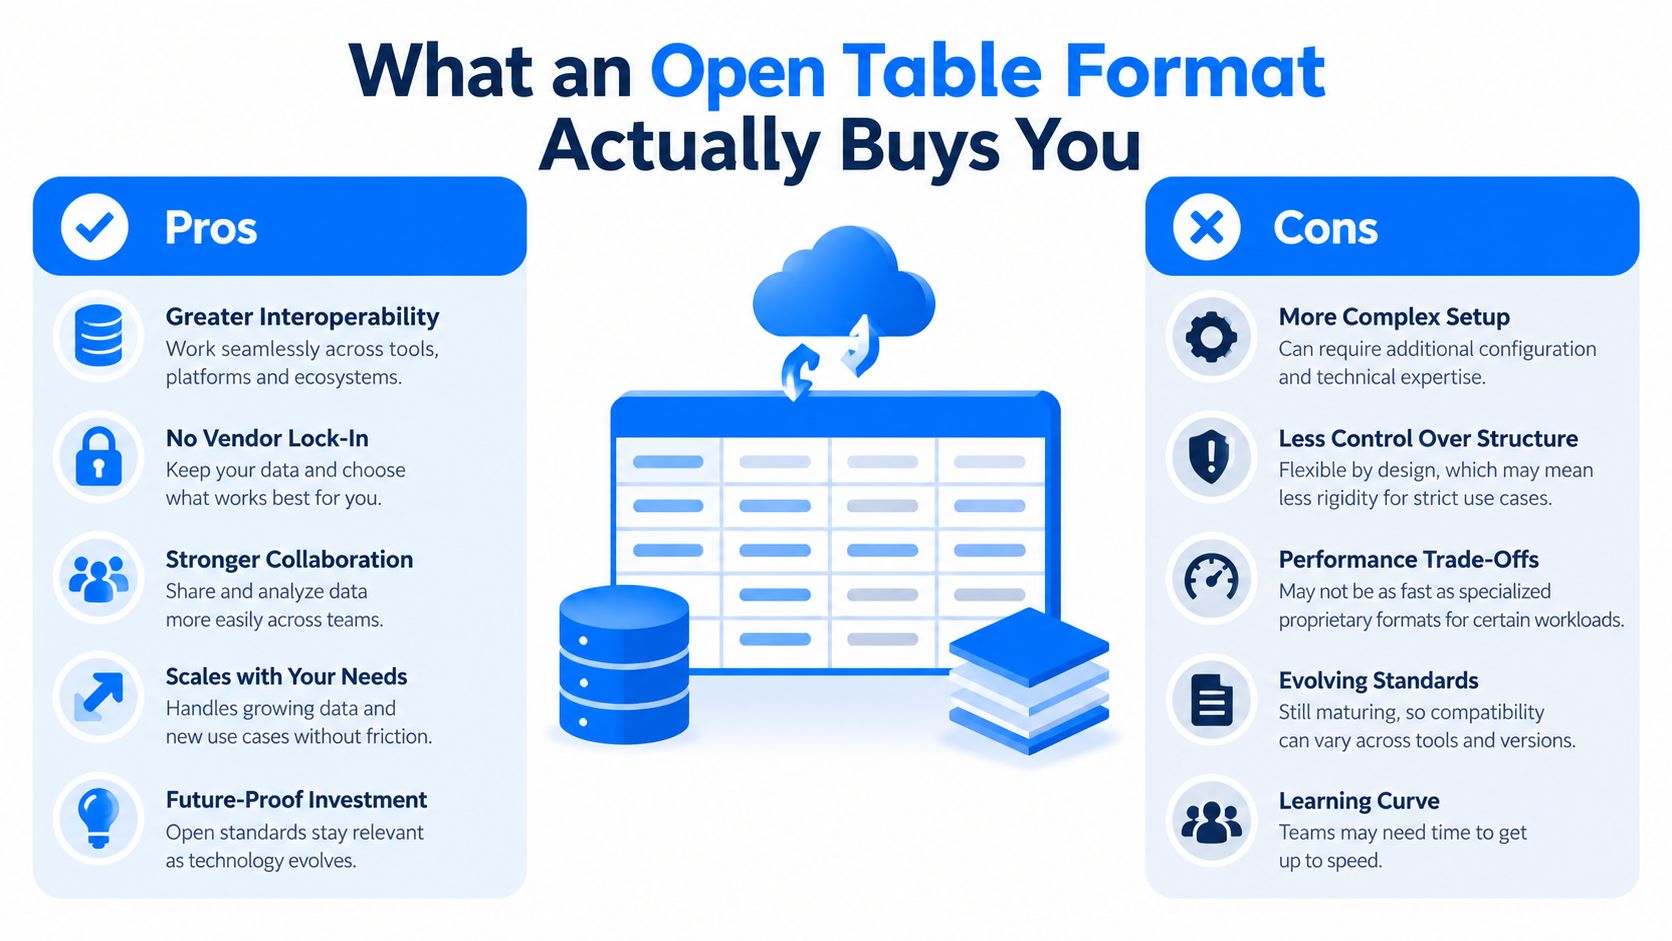
El formato también separa la tabla lógica de las suposiciones privadas de almacenamiento de un motor concreto. Los clientes compatibles pueden permitir que Spark, Trino, Flink, Snowflake, BigQuery y DuckDB trabajen con la misma tabla subyacente, aunque el soporte exacto de funciones depende del motor, el conector, el catálogo y la versión del formato. Esa neutralidad de motor es lo importante. Un equipo de plataforma puede usar Spark para transformar, Trino para SQL interactivo, Flink para streaming y otro motor para BI sin crear una copia física separada para cada carga de trabajo.
Por eso un formato de tabla abierto pertenece a una arquitectura de plataforma de datos más amplia. No sustituye a la plataforma. Aporta un estado de tabla fiable que el resto de la plataforma puede localizar, consultar, monitorizar y gobernar.
Históricamente, los formatos de tabla abiertos surgieron de las limitaciones del manejo de tablas al estilo Hive, basado en directorios. Apache Hudi comenzó en Uber en 2016, Apache Iceberg se originó en Netflix hacia 2017, y Delta Lake fue introducido por Databricks en 2017 y liberado como código abierto en 2019. Esos hitos marcaron el paso hacia la gestión de metadatos a nivel de archivo, el comportamiento ACID, la evolución de esquema y actualizaciones más seguras sobre almacenamiento de objetos en la nube. Una historia de los formatos de tabla abiertos sitúa esos proyectos en el centro de la evolución del lakehouse.
Cómo funciona por dentro un formato de tabla abierto
Un formato de tabla abierto se entiende mejor si separas la tabla en capas. Piensa en un congelador lleno de cubitos de hielo.
Los archivos de datos son los cubitos. Contienen los registros reales, normalmente en un formato columnar como Parquet. Una tabla puede contener muchos archivos, y esos archivos pueden estar repartidos por el almacenamiento de objetos.
El particionado es la cubitera. Agrupa archivos según una disposición que puede ayudar a planificar consultas, como una fecha u otra transformación de una columna. La distinción importante es que un formato de tabla moderno puede gestionar esa disposición como metadatos de la tabla, en vez de obligar a cada usuario a entender la estructura física de directorios.
Los archivos de manifiesto son listas de inventario. Cada manifiesto registra qué archivos de datos pertenecen a una parte concreta de la tabla e incluye información que ayuda al motor a decidir qué archivos puede omitir. Una consulta sobre un rango de fechas estrecho no necesita inspeccionar cada cubito del congelador si el inventario identifica la cubitera relevante.
La capa de metadatos es la carpeta de fichas. Sigue el esquema de la tabla, la especificación de particiones, el snapshot actual y las referencias a las listas de manifiestos. Un snapshot es una vista coherente de toda la carpeta, no simplemente una marca de tiempo pegada a un directorio cualquiera.
El modelo de Apache Iceberg ilustra este enfoque por capas. Organiza las tablas mediante snapshots inmutables y archivos de manifiesto. Cada commit crea una nueva vista en un instante concreto y preserva las versiones anteriores para el viaje en el tiempo y el rollback, con el JSON de metadatos, las listas de manifiestos y los archivos de manifiesto formando la jerarquía que suele describirse. Esta chuleta de metadatos de Apache Iceberg detalla esos componentes.
Publicar un nuevo estado de tabla
Un escritor normalmente no sobrescribe en el sitio el snapshot publicado. Prepara archivos nuevos o de reemplazo, crea metadatos y manifiestos actualizados y luego confirma un nuevo estado de tabla a través del catálogo o del protocolo de tabla. El paso final de publicación cambia de forma atómica la referencia de metadatos actual de la tabla.
Los lectores que empiezan antes del commit siguen usando el snapshot anterior. Los que empiezan después usan el nuevo. Esa separación impide que una consulta vea la mitad de un lote porque los archivos aparecieron en el almacenamiento de objetos en momentos distintos.
Un catálogo coordina la identidad y la localización de las tablas. Puede usar una interfaz REST, un servicio al estilo Hive u otra implementación de catálogo. El catálogo responde preguntas como dónde residen los metadatos de la tabla y qué versión de metadatos es la actual. Es el punto de control que impide que cada motor invente su propia interpretación de la tabla.
Las listas de manifiestos sostienen el descarte en tiempo de planificación, mientras que los metadatos guardan el esquema y la especificación de particiones. El particionado oculto va un paso más allá y permite a los usuarios consultar columnas lógicas sin escribir filtros contra nombres físicos de carpetas. Eso significa que una tabla puede hacer evolucionar su estrategia de particionado sin obligar a cada analista a reescribir SQL en torno a rutas de almacenamiento.
Elegir una disposición de escritura
Copy-on-write y merge-on-read representan contrapartidas distintas.
Con copy-on-write, una actualización reescribe los archivos de datos afectados. Las lecturas se mantienen más simples porque el último estado de la tabla ya está materializado en archivos columnares, pero las actualizaciones frecuentes pueden generar más trabajo de escritura.
Con merge-on-read, los cambios nuevos pueden guardarse aparte y fusionarse con los archivos base durante las lecturas o en una compactación posterior. Las escrituras pueden mantenerse más ágiles en cargas con muchas actualizaciones o en streaming, pero los lectores y los procesos de mantenimiento asumen más responsabilidad.
Si todavía te estás familiarizando con los archivos subyacentes, esta explicación de Parquet aporta el contexto de más bajo nivel. Parquet almacena registros. El formato de tabla abierto explica cómo esos registros participan en una tabla gobernada y versionada.
Lo que realmente te aporta un formato de tabla abierto
Los beneficios se evalúan mejor como una matriz. Cada capacidad resuelve un modo de fallo concreto, pero ninguna garantiza que el significado de negocio de los datos sea correcto.
Capacidad | Qué permite | Dónde se detiene |
|---|---|---|
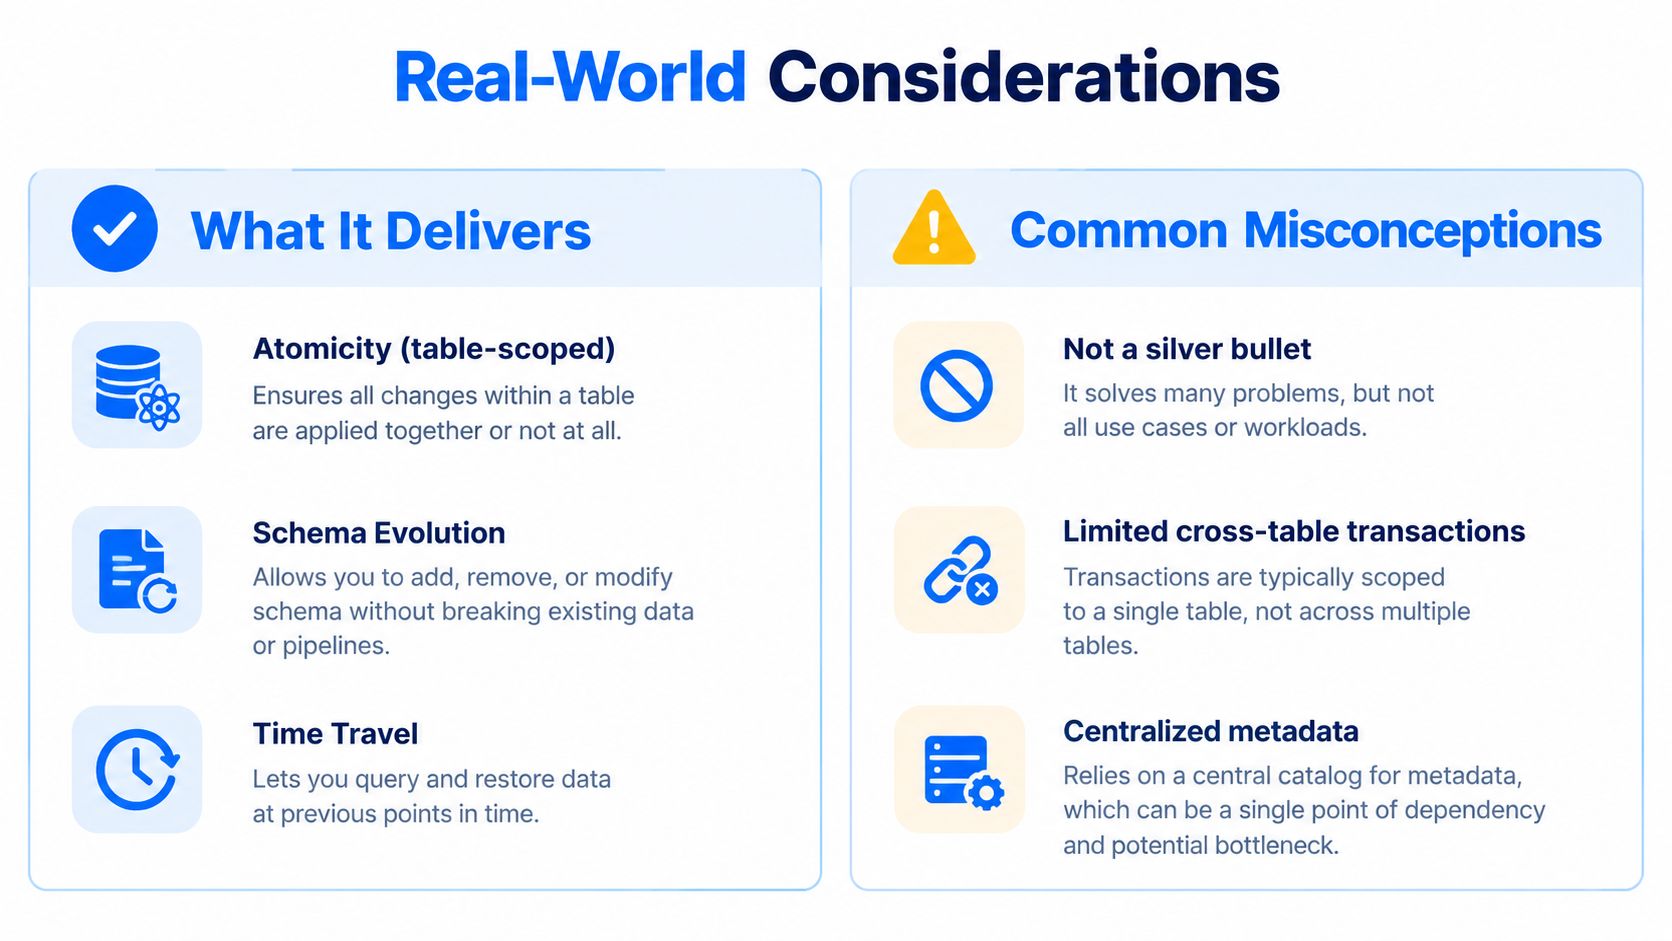
Transacciones ACID | Los lectores ven un estado de tabla confirmado, mientras los escritores publican cambios de forma atómica en el ámbito de la tabla. | No hace atómica una transacción que abarque varias tablas. |
Viaje en el tiempo | Los equipos pueden consultar o restaurar un snapshot anterior cuando el estado actual resulta sospechoso. | La retención, la limpieza y el soporte del catálogo determinan cuánto tiempo siguen disponibles esos snapshots. |
Evolución de esquema | Los equipos pueden añadir, renombrar, reordenar o eliminar columnas según las reglas de compatibilidad del formato y del motor. | No decide si un cambio de negocio es seguro para los modelos posteriores. |
Rendimiento guiado por metadatos | Los motores pueden descartar particiones y omitir archivos usando metadatos, estadísticas e información de disposición. | Un particionado deficiente, archivos pequeños y un orden de clasificación inadecuado pueden seguir produciendo consultas caras. |
Las transacciones ACID son el cimiento. Sin ellas, los equipos suelen depender de un patrón de renombrar y rezar. Un trabajo escribe en un directorio temporal y espera que un renombrado final evite que los lectores vean un resultado incompleto. Ese enfoque se vuelve frágil cuando interactúan reintentos, varios escritores, el comportamiento del almacenamiento de objetos y motores de consulta independientes.
El viaje en el tiempo cambia la respuesta a incidentes. Si una pipeline introduce valores erróneos, una analista puede comparar la tabla actual con un snapshot anterior, reejecutar una consulta contra el estado previo o restaurar una versión conocida como buena, siempre que los metadatos y archivos correspondientes no hayan sido eliminados por los procedimientos de retención. El historial de la tabla se convierte en un artefacto operativo en lugar de una secuencia invisible de mutaciones de archivos.
La evolución de esquema aborda otro problema. Los sistemas de origen cambian. Un productor añade un campo, renombra una columna o cambia el orden de los campos. Un formato de tabla puede registrar cambios estructurales compatibles sin exigir que cada archivo histórico se reescriba de inmediato. Eso reduce la fricción de la migración, pero el equipo sigue necesitando un contrato sobre cómo interpretan el cambio los consumidores posteriores.
Las mejoras de rendimiento vienen de mover trabajo del momento del escaneo al momento de la planificación. El motor puede usar metadatos de partición, estadísticas de columna a nivel de archivo y el orden de clasificación para evitar leer archivos irrelevantes. El resultado depende de cómo se escribe y mantiene la tabla. Los metadatos pueden estrechar la búsqueda, pero no pueden rescatar una disposición que genera una rotación excesiva de archivos o mala localidad de datos.
El límite importa:
Una tabla puede ser transaccionalmente correcta y semánticamente errónea.
Un commit atómico puede preservar un lote completo que contiene ingresos incorrectos, clientes duplicados o un código de estado inválido. Los formatos de tabla abiertos aportan coherencia estructural y estado histórico. La validación de datos, el linaje, la propiedad y la monitorización de negocio siguen necesitando un diseño aparte.
Iceberg, Delta Lake y Hudi comparados
Apache Iceberg, Delta Lake y Apache Hudi son las tres opciones dominantes de formato de tabla abierto. Comparten el objetivo general de llevar un comportamiento de tabla fiable al almacenamiento de objetos, pero sus modelos de metadatos y prioridades de carga de trabajo difieren.
Característica | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Modelo de metadatos | Snapshots inmutables que referencian listas de manifiestos y archivos de manifiesto, los cuales enumeran los archivos de datos de la tabla. | Un registro de transacciones secuencial en | Una línea temporal y un sistema de metadatos sostienen los commits, la indexación a nivel de registro y el procesamiento incremental. |
Modos de escritura | Suele usar reemplazo de archivos para las actualizaciones, con funciones de versión de tabla definidas por las capacidades de su formato. | Suele usar reemplazo de archivos coordinado por el registro de transacciones y patrones de concurrencia optimista. | Admite Copy On Write y Merge On Read. |
Garantías transaccionales | El comportamiento ACID se organiza en torno a los snapshots de tabla confirmados. | Los commits atómicos, el aislamiento por snapshot y el historial reproducible provienen del registro de transacciones. | Los commits transaccionales sostienen upserts y borrados, con un comportamiento marcado por el modo de escritura elegido. |
Estrategia de particionado | El particionado oculto y la evolución de particiones ayudan a separar las consultas lógicas de la disposición física. | Las disposiciones de tabla particionadas se coordinan mediante el protocolo de transacciones Delta y las integraciones de motor. | El particionado funciona junto a la indexación a nivel de registro y servicios de tabla diseñados para datos mutables. |
Cargas de trabajo idóneas | Analítica con varios motores, tablas por lotes y entornos donde importa la portabilidad de los metadatos. | Cargas muy integradas con las herramientas nativas de Delta y operaciones de lakehouse centradas en Spark. | Procesamiento incremental, CDC, upserts, borrados y pipelines orientadas a streaming. |
La fortaleza de Iceberg es su arquitectura de snapshots y manifiestos. Un motor puede planificar contra los metadatos sin listar cada archivo del almacenamiento de objetos, y el particionado oculto permite a quienes administran la tabla cambiar la organización física sin exponer cada detalle de disposición a los usuarios de SQL.
Delta Lake usa un registro de transacciones almacenado en el directorio _delta_log/. Las operaciones aparecen como archivos JSON o Parquet numerados secuencialmente, y ese registro sostiene commits atómicos, aislamiento por snapshot e historial de tabla reproducible. Esta comparación de Delta Lake, Iceberg y Hudi explica el papel del registro en el diseño de Delta.
Hudi está construido en torno a la indexación a nivel de registro y admite Copy On Write y Merge On Read, una combinación que encaja con pipelines que manejan upserts y borrados frecuentes. La guía de AWS sobre formatos de tabla abiertos describe esos modos de escritura y el enfoque de Hudi en el procesamiento incremental y el CDC en streaming.
Para una carga de ETL por lotes, los tres pueden ser viables. Para BI, la pregunta práctica es qué motores de consulta pueden leer la tabla con las funciones que tus consultas necesitan, incluidos el descarte, las lecturas por snapshot y el comportamiento del esquema. Para CDC en streaming, la amplificación de escritura, la indexación, la semántica de fusión y la compactación pueden importar más que una simple lista de funciones.
El soporte del ecosistema cambia constantemente entre Spark, Trino, Flink, Snowflake, BigQuery y otros motores. Eso hace que las pruebas de compatibilidad valgan más que suponer que un logotipo en una página de soporte garantiza un comportamiento idéntico en todas partes. Los equipos deberían validar escrituras, commits concurrentes, cambios de esquema, borrados, viaje en el tiempo y recuperación ante fallos con sus motores y catálogos reales. Un enfoque de calidad de datos en Databricks también debe evaluarse junto con la elección de formato, porque el protocolo de escritura de una tabla no sustituye las comprobaciones sobre los datos que contiene.
La elección práctica no es «¿qué formato gana?». Es qué semántica de escritura, modelo de catálogo, proceso de mantenimiento e integraciones de motor encajan con la pipeline que operas.
Cómo encajan los formatos de tabla abiertos en las plataformas de datos modernas
Un lakehouse suele tener cuatro capas funcionales. El almacenamiento de objetos guarda los archivos. El formato de tabla abierto gestiona los metadatos y el estado confirmado. Los motores de procesamiento y consulta leen o escriben mediante clientes compatibles. Los sistemas de gobernanza y observabilidad examinan qué ocurrió y si los datos resultantes son utilizables.
Un flujo típico empieza cuando los registros aterrizan en S3 o ADLS. Un escritor crea o actualiza una tabla, publica metadatos y registra la tabla en un catálogo. Spark puede transformar los datos, Flink puede procesar un flujo, Trino puede servir consultas interactivas, y Snowflake, BigQuery o Athena pueden ofrecer vías adicionales de consumo cuando sus integraciones admiten el protocolo y las funciones de la tabla.
Esa separación pone un único conjunto de datos lógico a disposición de varias cargas de trabajo. La analítica puede consultar la tabla, una pipeline de aprendizaje automático puede derivar características y un consumidor en streaming puede procesar cambios recientes sin obligar a cada equipo a mantener una copia aparte. La contrapartida es que cada cliente debe coincidir en la semántica de la tabla, el acceso al catálogo, las funciones admitidas y el comportamiento de autorización.
Por eso conviene entender el formato como parte del plano de control del lakehouse, y no solo como una elección de formato de archivo. El plano de control expone señales que importan en un día cualquiera de incidentes:
Patrones de commit: detecta escritores estancados, frecuencia de commit inusual o fallos repetidos.
Frescura de metadatos: identifica tablas cuyo estado de catálogo o actualizaciones de metadatos van por detrás de la entrega esperada.
Deriva de particiones: encuentra cambios en la organización física que alteran el comportamiento de las consultas.
Eventos de esquema: sigue las columnas añadidas, eliminadas o modificadas antes de que fallen los consumidores posteriores.
Comportamiento de snapshots: relaciona los incidentes de calidad de datos con el estado de tabla exacto que consumieron los lectores.
Una plataforma como digna puede situarse junto a esta capa monitorizando la frescura de los metadatos, los eventos de cambio de esquema, la puntualidad, los resultados de validación, las anomalías y las señales de plataforma dentro del propio entorno del cliente. Ese enfoque usa el historial de la tabla como fuente de señales operativas y mantiene la responsabilidad sobre la calidad de datos separada del protocolo de tabla.
La distinción es útil. El formato te dice qué estado de tabla se confirmó. La observabilidad te dice si ese estado llegó a tiempo, sigue los patrones esperados, cumple las reglas de negocio y sigue siendo seguro para el uso posterior. Hay más contexto sobre esa relación en cómo mantener la calidad de datos en un lakehouse.
Límites y contrapartidas que la mayoría de los artículos omite
Un formato de tabla abierto resuelve la brecha de atomicidad de una tabla. No convierte un lake sobre almacenamiento de objetos en una base de datos relacional plenamente coordinada.
El primer límite es el alcance transaccional. Las garantías ACID siguen siendo, en el modelo general, de ámbito de tabla. Si una pipeline actualiza una tabla de ventas y una tabla de inventario, cada tabla puede confirmar con seguridad mientras la operación de negocio en conjunto se vuelve incoherente entre ambas. Una transacción multitabla necesita un coordinador o una función de plataforma diseñada para ello.
El segundo límite es la calidad semántica. Una tabla puede contener todos los archivos esperados, un esquema válido y un snapshot limpio y aun así guardar valores incorrectos. Un formato de tabla abierto no sabrá que un reembolso supera su pedido, que un identificador de cliente infringe una regla de negocio o que los ingresos reflejan de pronto la divisa equivocada.
El trabajo operativo no desaparece
El mantenimiento de tablas sigue exigiendo atención de ingeniería.
Compactación: las disposiciones merge-on-read y las cargas con muchas actualizaciones pueden requerir compactación para que los lectores no reconcilien repetidamente muchos archivos de cambios.
Tamaño de archivos: un exceso de archivos pequeños aumenta el coste de planificación y escaneo, incluso cuando los metadatos permiten descartar.
Ajuste de particiones: un esquema de particiones que servía para los patrones de acceso de ayer puede rendir mal tras cambios en la carga de trabajo o en la distribución de datos.
Retención: el viaje en el tiempo depende de conservar los metadatos y archivos de datos que necesitan los snapshots antiguos. Las políticas de limpieza deben equilibrar las necesidades de recuperación con la gestión del almacenamiento.
Concurrencia: varios escritores pueden entrar en conflicto. La pipeline debe manejar reintentos, commits fallidos e idempotencia en lugar de suponer que toda escritura tendrá éxito.
La gobernanza también vive más allá del formato de tabla básico. Catálogos como Unity Catalog, Glue, Polaris y Nessie pueden gestionar la localización, los permisos, las integraciones de linaje y la coordinación, pero cada uno introduce responsabilidades de configuración, disponibilidad, compatibilidad y actualización. Las diferencias entre proveedores en torno a especificaciones de catálogo, interfaces REST y particionado oculto pueden complicar la portabilidad aunque dos sistemas afirmen soportar el mismo formato subyacente.
Frontera operativa: el formato protege el estado de la tabla. Tu plataforma sigue siendo dueña de la calidad, el linaje, la política de acceso, la respuesta a incidentes y el diseño de las cargas de trabajo.
Estas restricciones no son razones para rechazar los formatos de tabla abiertos. Son los límites que conviene documentar antes de producción. Un diseño que incluya operaciones de catálogo, trabajos de mantenimiento, comprobaciones de calidad, monitorización y procedimientos de rollback se comportará de forma muy distinta a uno que trate el formato como un reemplazo directo de un almacén de datos.
Elegir y adoptar un formato de tabla abierto
Elige el formato frente a la carga de trabajo, no frente al eslogan de un proveedor. Empieza por los motores que deben leer y escribir la tabla, y después prueba los patrones de escritura, la integración con el catálogo, el comportamiento ante fallos, la vía de mantenimiento y las señales de calidad que importan en producción.
Criterio | Qué evaluar | Por qué importa |
|---|---|---|
Compatibilidad de motores | Prueba Spark, Trino, Flink, herramientas de BI y cualquier integración con almacenes en la nube que uses de verdad. | Una integración nominal puede no admitir todas las funciones de tabla ni todas las operaciones de escritura. |
Concurrencia de escritura | Simula anexados, actualizaciones, borrados, reintentos y commits fallidos concurrentes. | La gestión de conflictos determina si las pipelines se recuperan con limpieza o exigen intervención manual. |
Necesidades de CDC y mutación | Compara upserts, borrados, lecturas incrementales y el comportamiento de Copy On Write y Merge On Read. | Las cargas en streaming y mutables imponen exigencias distintas al almacenamiento y a las lecturas. |
Integración con el catálogo | Evalúa el acceso REST o al estilo Hive, la localización, los permisos, el linaje y la disponibilidad del catálogo. | El plano de control determina cómo identifican y coordinan los motores el estado de la tabla. |
Herramientas de mantenimiento | Prueba la compactación, la limpieza de archivos, la evolución de particiones, las estadísticas y la retención de snapshots. | Un formato fácil de escribir pero difícil de mantener se convierte en una carga operativa. |
Observabilidad y calidad | Conecta los eventos de commit, los cambios de esquema, la puntualidad, la validación y las métricas de negocio con los flujos de incidentes. | La coherencia estructural por sí sola no demuestra que los datos sean aptos para su uso. |
Una migración práctica puede caber en un plan de 90 días sin fingir que un cambio de formato es un único despliegue.
Piloto
Selecciona tablas representativas, incluida una tabla con muchos anexados, una tabla con cambios de esquema y una carga con actualizaciones o borrados. Mide el comportamiento de las consultas, los conflictos de commit, el crecimiento de los metadatos, los pasos de recuperación y el esfuerzo necesario para validar registros.
Validación con doble escritura
Escribe las mismas entradas lógicas por la vía heredada y por la nueva vía de tabla. Compara recuentos de filas, claves, comportamiento de nulos, agregados, eventos de esquema, momento de entrega y contenido de los snapshots. Mantén la comparación centrada en criterios de aceptación de negocio, no solo en si ambos sistemas produjeron archivos.
Cambio definitivo
Mueve una carga posterior cada vez. Define la propiedad del catálogo, los trabajos de mantenimiento, los commits fallidos, las decisiones de rollback y las alertas. Mantén disponible la vía heredada hasta que la nueva haya demostrado lecturas, escrituras, recuperación y monitorización estables en condiciones normales de operación.
Retirada
Elimina escritores y rutas de almacenamiento redundantes solo después de documentar los requisitos de retención, auditoría, linaje y rollback. Archiva la evidencia necesaria para explicar cuándo ocurrió el cambio y qué snapshot de tabla pasó a ser el autorizado.
Los errores comunes de adopción son predecibles: subestimar las operaciones de catálogo, saltarse las pruebas de evolución de particiones, tratar el formato como un sustituto de almacén, ignorar los conflictos entre escritores concurrentes y descuidar la planificación del rollback. El proceso de selección más sólido incluye observabilidad desde el piloto, para que los equipos vean no solo si un commit tuvo éxito, sino si los datos resultantes llegaron a tiempo y siguieron siendo correctos para sus consumidores.
Para decisiones de arquitectura más amplias, una guía de plataforma de datos empresarial puede ayudar a situar los formatos de tabla junto a la gobernanza, la calidad y la responsabilidad operativa.
digna ayuda a las empresas a monitorizar la calidad de los datos, la puntualidad, los cambios de esquema, las anomalías y el comportamiento de la plataforma dentro de su propia infraestructura, lo que la convierte en una compañera práctica del plano de control de metadatos y snapshots de un formato de tabla abierto. Visita digna para evaluar cómo esas señales pueden apoyar operaciones de lakehouse más seguras.
Un commit atómico garantiza que un lector nunca vea medio lote; no garantiza que el lote fuera correcto, lo que sigue siendo un problema de gestión de la calidad de datos.
Preguntas frecuentes
¿Qué es un formato de tabla abierto?
Una capa de especificación y metadatos situada por encima de los archivos de datos en bruto y por debajo de los motores de consulta o procesamiento. Aporta lo que una carpeta no puede: un contrato de identidad, estado y cambio.
¿Por qué una carpeta con archivos no es una tabla?
Porque una carpeta es almacenamiento. Un data lake en bruto guarda archivos en almacenamiento de objetos con formatos como Parquet, ORC o Avro, y las convenciones de directorios intentan cubrir el hueco, que es lo que hace que un lake se parezca menos a una base de datos y más a una carpeta compartida con un rendimiento excelente.
¿Cuándo aparecieron estos formatos?
Surgieron de los límites del manejo de tablas al estilo Hive, basado en directorios. Apache Hudi comenzó en Uber en 2016, Apache Iceberg se originó en Netflix hacia 2017, y Delta Lake fue introducido por Databricks en 2017 y liberado como código abierto en 2019.
¿Qué separa el formato?
La tabla lógica de las suposiciones privadas de almacenamiento de un motor concreto. Esa separación es lo que permite que varios motores lean la misma tabla sin que cada uno imponga su interpretación de qué archivos cuentan.
¿Qué contrapartidas omite la mayoría de los artículos?
Las operativas. Adoptar un formato añade metadatos que gestionar, decisiones de retención que tomar y comportamientos de motor que reconciliar, así que el coste no es cero aunque la especificación sea abierta y la migración parezca mecánica.



