Pruebas de integridad de bases de datos: Una guía práctica para 2026
|
7
minuto de lectura

Se puede tener un pipeline que técnicamente esté en verde y aun así producir un panel de finanzas en el que nadie confía. Los trabajos finalizan, las pruebas pasan y las filas están ahí, pero el libro mayor no concilia con la cifra de ingresos en la pantalla. Esa brecha es donde las pruebas de integridad de bases de datos se ganan su sustento, porque verifican si los datos siguen siendo correctos después del almacenamiento, las uniones, las migraciones, las transformaciones y el paso del tiempo.
Tabla de contenidos
Qué significan realmente las pruebas de integridad de bases de datos
Las cinco dimensiones que toda prueba de integridad debería cubrir
De pruebas en un punto en el tiempo a una Observability de integridad continua
Cuando las pruebas en verde aún entregan datos rotos
La alerta provino de finanzas, no de ingeniería. Un panel mostraba una cifra de ingresos que no coincidía con el libro mayor, pero todas las comprobaciones del pipeline habían pasado y el almacén de datos parecía saludable en el papel. Un ingeniero de analítica rastreó el flujo de vuelta a través de las capas de staging, transformaciones y reportes, y luego descubrió la incómoda verdad: la base de datos no tenía ninguna violación obvia de integridad, pero la respuesta comercial seguía siendo incorrecta.
Esa es la trampa de los controles habituales. Los recuentos de filas pueden verse bien, un DAG puede ponerse en verde y una prueba básica de frescura puede pasar mientras una relación de clave externa está rota, se introdujo una clave duplicada durante una carga histórica (backfill) o una transformación modificó los totales históricos. En la práctica, la integridad depende de la estrategia de validación que rodea a la base de datos, no de la presencia de la base de datos en sí, y las pruebas de mutación han demostrado cuán amplia puede ser esa brecha, donde los criterios de cobertura más débiles eliminaron solo el 12% de los mutantes mientras que los más fuertes eliminaron hasta el 96% en un análisis de 2015 (McMinn 2015).
Una forma más clara de enmarcar el problema es la distinción entre calidad de datos y integridad de datos, que el equipo de digna trata como preocupaciones relacionadas pero no idénticas.
Por qué merece su propia disciplina
Las pruebas de integridad de bases de datos se sitúan junto al trabajo general de calidad de datos. Verifican si los registros siguen siendo precisos, consistentes, válidos y no corruptos a medida que se mueven a través del almacenamiento y cambian, y necesitan pruebas negativas que intenten violar las reglas en lugar de solo confirmar el camino feliz. Eso importa porque un sistema aún puede estar poblado, ser consultable y estar equivocado.
La orientación de la industria ahora enmarca la integridad en torno a cinco dimensiones principales: exactitud, completitud, consistencia, oportunidad y validez (Matillion). El mismo punto aparece en la guía de IBM sobre pruebas de integridad de datos, que enfatiza verificar si la base de datos impone las reglas que usted espera a lo largo del almacenamiento y la recuperación. Ese modelo es útil porque aleja a los equipos de una mentalidad de aprobación o falla única y los orienta hacia controles en capas que coinciden con la forma en que fallan los almacenes, lagos y pipelines modernos.
Qué significan realmente las pruebas de integridad de bases de datos

Una base de datos puede verse saludable en la superficie y aun así contener registros incorrectos. Las pruebas de integridad de bases de datos verifican si los datos se mantienen correctos y sin corrupción mientras se almacenan, recuperan, replican y transforman, y si la base de datos está aplicando las reglas de las que depende el sistema. Se ubican en el límite entre la aplicación del esquema y el comportamiento en tiempo de ejecución, por lo que la superficie de prueba debe cubrir ambos.
Un sistema simple de clientes y pedidos ilustra el punto rápidamente. Cada pedido debe apuntar a un cliente real, cada identificador de cliente debe permanecer único y campos como el estado o la cantidad del pedido deben permanecer dentro del conjunto permitido. Si una de esas promesas se rompe, la base de datos aún puede aceptar la fila a menos que la regla haya sido codificada y probada.
Los tipos clásicos de integridad
La integridad de entidad significa que cada fila tiene un identificador único y ese identificador no es nulo. Una clave primaria tiene que hacer su trabajo, o los registros comienzan a desdibujarse y las uniones (joins) posteriores se vuelven poco confiables.
La integridad referencial significa que las filas hijas apuntan a filas de padres reales. Si un pedido hace referencia a un cliente que no existe, el sistema crea un huérfano, y los informes pueden comenzar a contar mal o clasificar incorrectamente los registros.
La integridad de dominio mantiene los valores dentro del rango, tipo o lista permitidos. Eso podría ser una restricción CHECK, un tipo de datos o una regla que bloquee códigos de estado no válidos antes de que se propaguen.
La integridad semántica es la capa de negocio que el esquema por sí solo no puede expresar. Un valor de updated_at no debería ser anterior a created_at, y un pedido no debería marcarse como pagado si la tabla de pagos no muestra ninguna transacción.
Regla práctica: si una restricción de esquema puede expresar la regla, pruebe la restricción directamente. Si la lógica de negocio es dueña de la regla, pruebe el comportamiento que la demuestra.
Esa división entre verificaciones estructurales y controles de calidad más amplios es donde resulta útil la comparación entre calidad de datos vs integridad de datos, porque aclara qué fallas pertenecen a la base de datos en sí y cuáles pertenecen al pipeline circundante o a la lógica de la aplicación.
Las cinco dimensiones que toda prueba de integridad debería cubrir

Una tabla puede superar sus restricciones básicas y aun así producir malas decisiones. La fila existe, el tipo es correcto y la unión funciona, pero el número puede estar desactualizado, incompleto o ser contradicho por otro sistema. Es por eso que las pruebas de integridad deben cubrir más que las claves primarias y las claves externas. Deben verificar las formas específicas en que los datos pueden parecer válidos y, al mismo tiempo, no ser confiables.
El modelo de cinco dimensiones ayuda a los equipos a evitar el sobreajuste a un solo modo de falla. Cada tabla crítica debe asignarse a la dimensión con mayor probabilidad de romperse allí, porque la prueba adecuada para una clave de cliente no es la prueba adecuada para una instantánea de ingresos. Las restricciones clásicas detectan violaciones estructurales, mientras que las comprobaciones continuas detectan cambios en el comportamiento, la frescura y la coherencia entre sistemas. Para cambios de esquema que alteran esas reglas, consulte la deriva del esquema y por qué los cambios estructurales rompen los pipelines.
Qué detecta cada dimensión
La exactitud pregunta si el valor es correcto. Un total de ingresos aún puede estar equivocado incluso cuando la fila está presente y el tipo es correcto, por lo que la prueba debe comparar el resultado con el cálculo esperado o la fuente de verdad.
La completitud pregunta si los registros o campos esperados están presentes. La falta de un mes de transacciones es una falla diferente a un valor incorrecto, y generalmente requiere comprobaciones de recuento, comprobaciones de presencia o comprobaciones a nivel de partición. Si un trabajo de ingesta descarta una porción de datos, la completitud es el primer lugar donde debería aparecer esa brecha.
La consistencia busca contradicciones entre sistemas o capas. Un cliente marcado como activo en una tabla y cerrado en otra es una señal de que el modelo se ha desviado, y la discrepancia solo puede aparecer cuando se comparan dos tablas cara a cara.
La oportunidad verifica la frescura. Una carga que llega a las 11:55 PM pero se trata como actual a las 9 AM debería fallar una regla de oportunidad, incluso si cada fila es válida. La frescura importa porque los datos retrasados pueden ser precisos y aun así engañar a cualquiera que los lea como actuales.
La validez pregunta si los datos se ajustan al formato o conjunto de reglas permitido. Las cadenas de correo electrónico mal formadas, los valores de estado imposibles y las fechas incorrectas pertenecen aquí, junto con cualquier campo que viole las reglas comerciales asociadas a su tipo.
Un buen hábito de prueba es escribir para el modo de falla, no para la conveniencia de SQL. Si una tabla almacena fechas, recuentos, identificadores de clientes y estados comerciales, una sola consulta podría confirmar parte del panorama, pero rara vez demuestra las cinco dimensiones a la vez. El enfoque más limpio es decidir qué puede fallar y luego elegir la verificación que expondría esa falla de manera más directa.
Perspectiva operativa: un conjunto de pruebas en verde que solo verifica la completitud aún puede pasar por alto un cálculo de ingresos incorrecto, un lote desactualizado o un registro que es válido por sí solo pero inconsistente con el resto del modelo.
Es por eso que las cinco dimensiones se han convertido en una línea base para la governance empresarial en entornos regulados, especialmente donde la auditabilidad y la frescura importan tanto como la corrección.
Diseño de casos de prueba de integridad que rompen cosas
Las mejores pruebas de integridad no celebran el camino feliz, intentan hacer que el modelo falle. Si una regla es real, la prueba debería poder violarla a propósito y demostrar que la base de datos rechaza la entrada incorrecta o expone el comportamiento roto. Así es como se encuentran los casos en los que una migración eliminó una restricción o una refactorización de ETL dejó de aplicar la lógica.
Casos negativos que exponen controles débiles
Un inserto de clave primaria duplicada debería fallar inmediatamente si la integridad de la entidad es real. Una fila hija huérfana debería fallar si se aplica la integridad referencial. Un valor de enumeración no válido, un elemento hijo insertado antes que su padre o una cantidad negativa en una tabla que nunca debería aceptar una, le indican si la regla existe en la base de datos o solo en la documentación.
El mismo enfoque funciona para las comprobaciones semánticas. Un pedido pagado con cero transacciones de pago debería fallar en una consulta de validación. Lo mismo debería ocurrir con una fila donde updated_at sea anterior a created_at. Estos son los tipos de pruebas que detectan problemas silenciosos después de un lanzamiento, especialmente cuando la base de datos todavía "se ve bien".
Casos comunes de prueba de integridad y qué detectan
Caso de prueba | Tipo de integridad | Qué detecta | Ejemplo de aserción |
|---|---|---|---|
Inserción de clave primaria duplicada | Entidad | Falta de aplicación de unicidad | Falla si se acepta una clave duplicada |
Fila hija huérfana | Referencial | Relación padre-hijo rota | Falla si el hijo no tiene padre |
Enum o estado no válido | Dominio | Restricciones de valor débiles | Falla si se almacena un valor no permitido |
Inserción de hijo antes que el padre | Referencial | Falta de control de secuenciación | Falla si se pasa por alto la regla FK |
Pedido pagado sin fila de pago | Semántica | Proceso de negocio roto | Falla si el estado de pago es inconsistente |
Cantidad negativa | Dominio | Valores comerciales imposibles | Falla si se almacena un valor negativo |
| Semántica | Lógica de ciclo de vida incorrecta | Falla si las marcas de tiempo violan el orden |
Para obtener una vista a nivel de esquema de cómo suelen comenzar estas fallas, la nota interna sobre explicación de la deriva del esquema es un compañero útil. La deriva estructural puede debilitar las restricciones y es posible que el síntoma no aparezca hasta que una verificación posterior finalmente compare el comportamiento esperado con lo que está haciendo la base de datos.
El lenguaje de aserción debe ser directo. "Se aceptó un ID de cliente duplicado", "se encontró una línea de pedido huérfana" y "el estado del pago no coincide con los registros de transacciones" son mejores que los mensajes vagos de aprobación o falla porque le dicen exactamente al siguiente ingeniero qué se rompió.
Un patrón útil es emparejar estas fallas puntuales con las mismas reglas observadas dentro de la base de datos a lo largo del tiempo. La prueba estática demuestra que la restricción existe. La observabilidad continua muestra si los datos reales continúan cruzando los casos límite que importan, como la creación repetida de huérfanos después de un despliegue o un campo de estado que se desvía del conjunto permitido. Esa combinación le brinda tanto la barandilla como la luz de advertencia.
Si desea una plataforma para expresar estas comprobaciones dentro de la base de datos en lugar de enviar datos fuera para su validación, digna es una opción entre otras. Su validación basada en reglas y su modelo de ejecución en la base de datos se adaptan a este estilo de prueba, donde el objetivo es detectar relaciones rotas donde ya viven los datos.
Embedding Integrity Tests in CI/CD and Migrations
Un cambio de esquema que se envía sin volver a ejecutar las comprobaciones de integridad crea un punto ciego, y ahí es donde habitualmente se filtran los datos rotos. Un proceso de lanzamiento confiable mantiene juntas las migraciones y las aserciones de integridad, de modo que las reglas que protegen las claves, las relaciones y los valores permitidos viajen con el código que los modifica.
Cómo debería ser el flujo de lanzamiento
Comience con el control de versiones. Un desarrollador cambia el esquema, la lógica de transformación o la regla comercial, y el pipeline de CI ejecuta pruebas unitarias más pruebas de integridad contra una base de datos clonada. La migración debe aplicarse en dos lugares: una base de datos nueva y otra poblada, porque un cambio que funciona en tablas vacías aún puede fallar una vez que estén presentes filas reales, claves externas y casos límite.
Después del despliegue, vuelva a ejecutar las mismas aserciones. Ese segundo paso importa porque una migración puede aplicarse limpiamente pero aun así cambiar el comportamiento de las restricciones, los planes de consulta o los resultados de la validación. Los equipos también deben decidir de antemano si la migración es reversible o si se acepta formalmente como irreversible, en lugar de dejar esa pregunta abierta después del lanzamiento (bug0).
Dónde encajan las herramientas
Marcos de trabajo como pgTAP para PostgreSQL y tSQLt para SQL Server permiten a los equipos expresar las comprobaciones de integridad como código, lo que hace que las comprobaciones sean revisables y repetibles. La validación a nivel de consulta pertenece al mismo flujo de trabajo, especialmente para rutas críticas, y EXPLAIN ANALYZE puede revelar regresiones de rendimiento antes de que un cambio llegue a los reportes o analíticas posteriores. La misma disciplina también se manifiesta en la validación de datos empresariales dentro de la base de datos, donde las comprobaciones permanecen cerca de las tablas que protegen.
Las instantáneas de producción son otro patrón sólido. Le permiten verificar que un cambio se comporte de la misma manera en datos con forma real sin tocar el sistema en producción. Eso importa cuando una tabla es grande, crítica para el negocio o está regulada, porque el comportamiento de la prueba vacía puede ocultar problemas que solo aparecen a escala o con registros históricos.
De la misma manera que la detección de anomalías para distribuidores vigila cambios inusuales en el comportamiento a lo largo del tiempo, las pruebas de integridad en la base de datos vigilan las reglas que aún pasan en el papel pero fallan frente al movimiento de datos reales. Las aserciones estáticas detectan la restricción rota. Las comprobaciones en el momento del lanzamiento y posteriores al lanzamiento muestran si la migración mantiene la honestidad de la base de datos una vez que el nuevo código está en su lugar.
De pruebas en un punto en el tiempo a una Observability de integridad continua
Un conjunto de pruebas puede pasar y el panel de control aún puede estar equivocado. Eso suele suceder cuando el problema no es una restricción rota, sino una deriva a lo largo del tiempo, una entrega retrasada, un cambio de esquema o una transformación que alteró el historial sin provocar una falla grave. La Observability de integridad continua llena el vacío que dejan las validaciones puntuales.
Por qué las pruebas estáticas no son suficientes
Las pruebas de integridad tradicionales son buenas para detectar violaciones explícitas, como filas huérfanas o valores no válidos. Son más débiles cuando el pipeline cambia lentamente, porque el resultado correcto de ayer puede convertirse en la respuesta incorrecta de hoy sin que ocurra un solo evento de falla. El reprocesamiento, las cargas históricas y las refactorizaciones son fuentes comunes de ese tipo de ruptura silenciosa, y la guía pública trata esto cada vez más como un problema operativo separado en lugar de un problema puro de base de datos (Soda).
Es por eso que los equipos están agregando detección de anomalías, seguimiento de cambios de esquema y monitoreo de patrones de entrega sobre las comprobaciones deterministas. Estas señales le permiten ver la forma de los datos, no solo si infringen una regla. Si una tabla suele llegar a una hora determinada y empieza a llegar más tarde, o si una métrica varía de una manera que no coincide con el comportamiento anterior, usted querrá recibir la alerta antes de que un usuario de negocio abra el panel.
Cómo la observabilidad extiende la integridad
Una configuración eficaz vigila tres cosas juntas. Primero, la validación a nivel de registro demuestra que las reglas estrictas siguen vigentes. Segundo, el monitoreo de oportunidad marca las cargas tardías o faltantes según los patrones de entrega esperados. Tercero, el seguimiento del esquema detecta cambios estructurales antes de que los trabajos posteriores fallen debido a un cambio inesperado de nombre de columna o tipo.
Una referencia complementaria útil es la detección de anomalías para distribuidores, porque muestra cómo la detección consciente de la línea base puede sacar a la luz comportamientos inusuales sin obligar a cada equipo a escribir a mano una regla para cada caso límite.
Regla práctica: si una comprobación solo le indica que llegaron datos incorrectos, agregue una señal de observabilidad que le indique cuándo comenzó el sistema a derivar hacia datos incorrectos.
La observabilidad continua no reemplaza las pruebas de integridad. Detecta las fallas para las cuales las pruebas no pueden programarse, especialmente en pipelines que reprocesan el historial o dependen de sistemas ascendentes que usted no controla.
Medición de cobertura, SLAs y ROI real
Más pruebas no significan automáticamente más protección. Una larga lista de comprobaciones puede parecer impresionante y, al mismo tiempo, pasar por alto las tablas más importantes. La mejor pregunta es si el conjunto de pruebas cubre los datos que pueden perjudicar al negocio si se rompen.
La cobertura debe seguir al riesgo
Las tablas críticas merecen una cobertura más profunda que los datos de referencia, y los pipelines sensibles a los cambios merecen más atención que los estables. Los modelos descendentes, los conjuntos de datos regulatorios y las tablas de KPI se sitúan cerca de la parte superior de la lista porque las filas faltantes, las cargas tardías o las uniones rotas pueden distorsionar los reportes y las pruebas de Compliance. Muchas guías públicas analizan la documentación y las auditorías, pero rara vez definen qué significa una "buena cobertura" en un entorno mixto de almacén, lago y pipeline (VirtuosoQA).
Establezca SLAs que coincidan con la función de los datos. Si un conjunto de datos impulsa los reportes matutinos, el equipo necesita una expectativa de frescura que sea más estricta que la de un archivo por lotes. Si un esquema cambia con frecuencia, el control que importa no es cuántas comprobaciones existen, sino si el cambio se detectó antes de que los usuarios sintieran el impacto.
Una mentalidad de reducción de riesgos
Las pruebas de integridad son un programa de reducción de riesgos, no un recuento de pruebas por vanidad.
Ese marco facilita la justificación de la inversión en entornos regulados, donde el costo de una fila omitida, una carga tardía o un KPI dañado puede manifestarse como fricción en la auditoría, malas decisiones o reelaboración en los análisis y las operaciones. El ROI proviene de prevenir esas fallas, no de buscar una validación exhaustiva en cada tabla.
Una forma práctica de comenzar es clasificar los conjuntos de datos por consecuencias comerciales y luego asignar la profundidad de monitoreo en consecuencia. Eso le brinda un mejor equilibrio que intentar probar todo por igual.
Poniendo todo junto en una pila de datos confiable
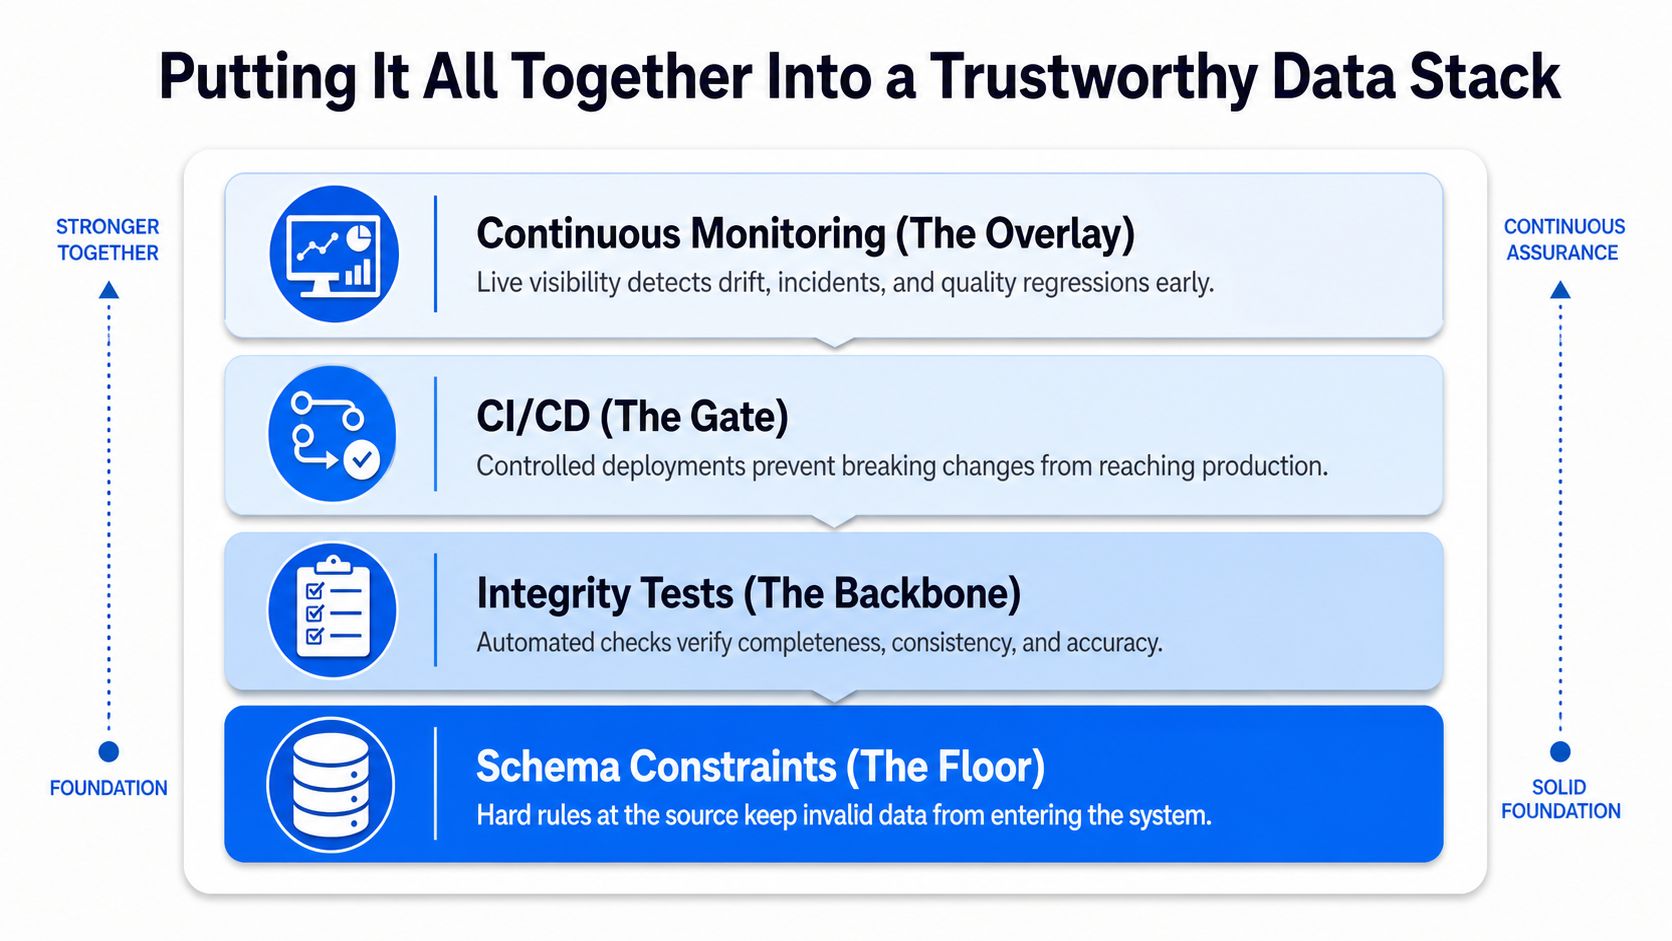
Una pila confiable tiene capas, y cada capa resuelve un tipo diferente de falla. Las restricciones de esquema son el piso, detienen violaciones obvias en el límite de la base de datos. Las pruebas de integridad son la columna vertebral, demuestran que las reglas siguen funcionando después de cambios de código, cargas y migraciones. El CI/CD es la puerta de lanzamiento, bloquea los cambios que romperían esas reglas. El monitoreo continuo es la superposición, vigila la deriva, el retraso y el cambio estructural después del despliegue.
Un modelo operativo sencillo
En el límite del almacén de datos o del lago, las restricciones mantienen fuera los registros no válidos. Dentro del pipeline, los casos de prueba verifican la integridad de entidad, referencial, de dominio y semántica antes de que los datos lleguen a los consumidores. En la gestión de lanzamientos, las migraciones y las aserciones se mueven juntas para que el equipo pueda demostrar que un cambio no alteró el comportamiento. Después del lanzamiento, la observabilidad vigila el sistema en vivo para detectar llegadas tardías, deriva de esquema y anomalías estadísticas.
Ese enfoque en capas también se adapta a la gobernanza. Ejecutar verificaciones dentro de la base de datos mantiene los datos en su lugar, lo que ayuda con la seguridad y reduce el movimiento innecesario. Combinar la validación determinista con el monitoreo del comportamiento es lo que permite a los equipos detectar tanto las violaciones graves como la deriva silenciosa.
Un equipo de datos senior puede resumir el modelo en una frase. Las pruebas de integridad de bases de datos no son una sola herramienta, es un programa en capas que combina la disciplina clásica de bases de datos con la observabilidad moderna para que los consumidores finales puedan confiar en los datos.
Si desea ayuda para crear ese modelo en capas dentro de su propio entorno, digna proporciona validación dentro de la base de datos, seguimiento de esquemas, monitoreo de oportunidad y detección de anomalías en almacenes, lagos y pipelines. Visite digna para ver cómo esos controles pueden encajar en su pila de datos y admitir las comprobaciones de integridad que su equipo necesita.



