8 KPIs de Data Governance a medir en 2026
|
8
minuto de lectura

La mayoría de los programas de gobernanza no fracasan porque nadie haya escrito políticas. Fracasan porque los equipos no pueden demostrar que esas políticas cambian lo que ocurre en producción. Un estudio de referencia de gobernanza empresarial de 2025 reveló que el 71% de las organizaciones cuenta con un programa formal de data governance, frente al 60% de dos años antes (estudio de referencia de gobernanza empresarial de 2025). La adopción formal está aumentando, pero el mismo estudio identificó la calidad de los datos como el principal punto de dolor empresarial con un 56%, seguido de cerca por la gobernanza con un 54%. La implicación es clara: documentar la propiedad y publicar normas no es suficiente. Los líderes necesitan pruebas de que los controles funcionan, los datos llegan de forma fiable, los incidentes se contienen y las decisiones se vuelven más seguras.
Los ocho KPI de data governance que se presentan a continuación forman un sistema de medición conectado. La cobertura muestra dónde existe gobernanza, la aplicación muestra si los controles funcionan, la calidad y la Timeliness muestran el estado de los datos, y las métricas de incidentes, esquemas y de negocio muestran si la gobernanza protege las decisiones. Cada KPI incluye lógica de cálculo, opciones de implementación y compensaciones.
Antes de calcular nada, defina la población de activos, el propietario, la ventana de medición, el nivel de criticidad, el umbral objetivo y la expectativa de respuesta ante alertas. Una puntuación sin un propietario asignado es un informe. Una puntuación vinculada a una vía de resolución es un control.
Tabla de contenidos
6. Efectividad de la detección de anomalías en KPI de negocio
7. Tasa de adopción y aplicación de políticas de data governance
8. Cobertura de Data Observability y profundidad de monitoreo
1. Puntuación de calidad de datos
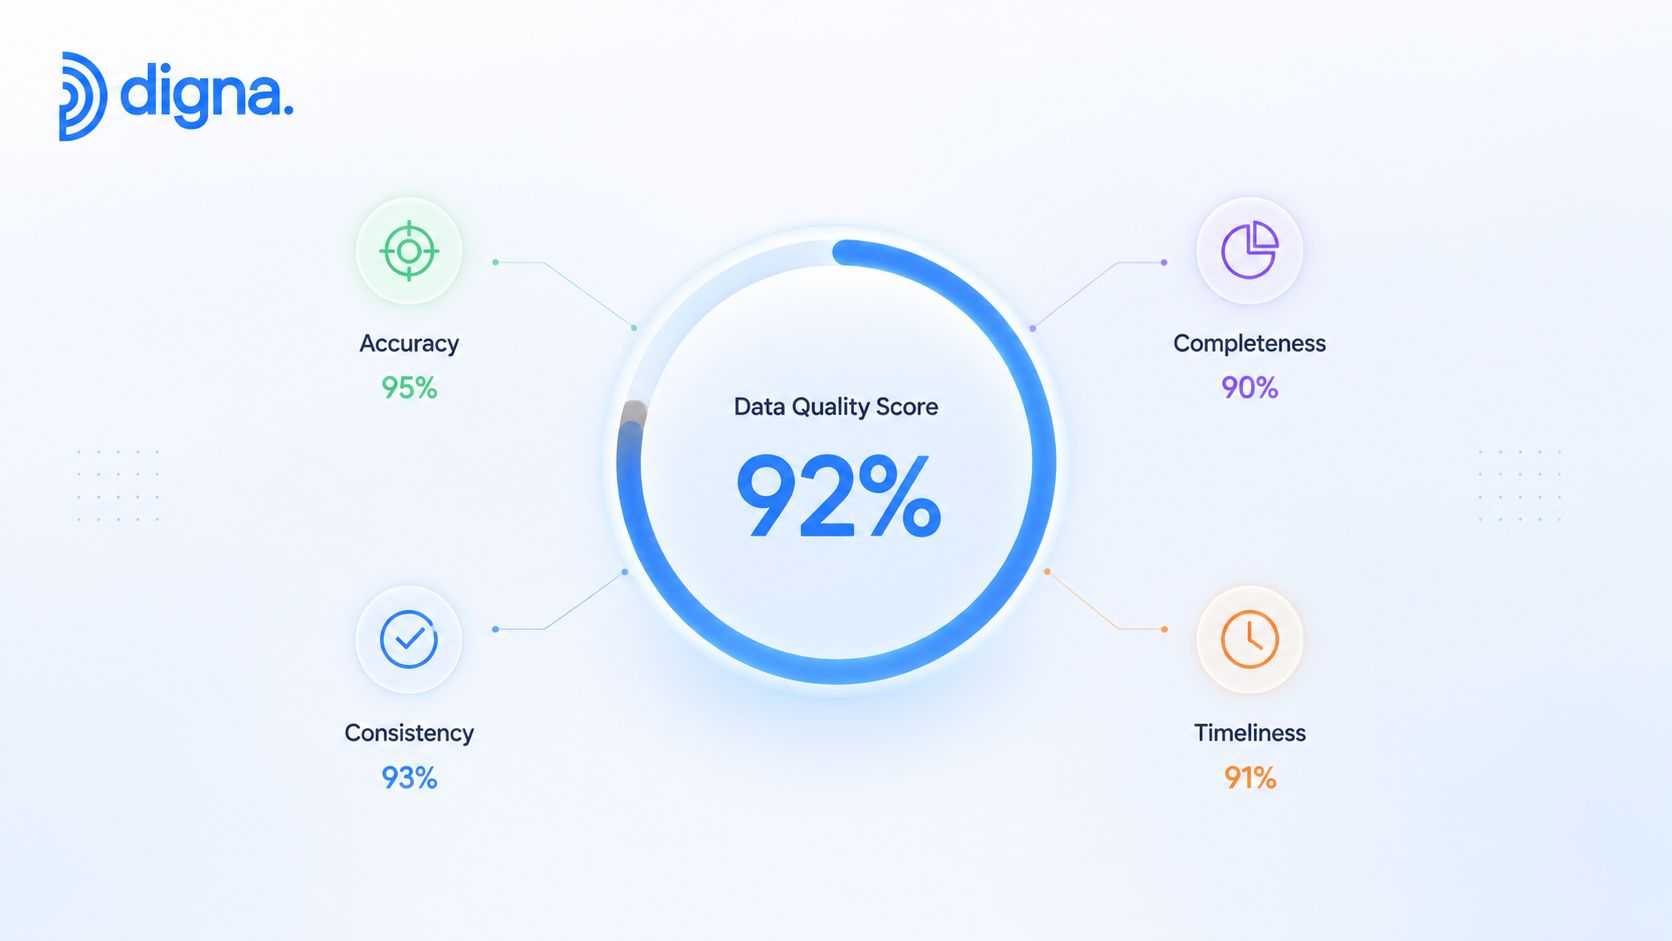
La Puntuación de calidad de datos es la señal de estado en el sistema de medición de ocho KPI. La cobertura muestra dónde existe gobernanza, la aplicación muestra si los controles funcionan, mientras que esta puntuación muestra si los datos críticos son aptos para informes, operaciones, cumplimiento normativo o flujos de trabajo de IA. Las dimensiones comunes incluyen precisión, integridad, consistencia, Timeliness y unicidad. Los equipos pueden utilizar la guía de métricas de calidad de datos para definir y combinar estas dimensiones sin tratar el resultado compuesto como un diagnóstico.
Un cálculo sencillo es:
Puntuación de calidad de datos = suma de las puntuaciones de las dimensiones multiplicada por sus pesos asignados
Los pesos deben coincidir con el uso de cada conjunto de datos. Un informe regulatorio puede dar mayor peso a la validez e integridad, mientras que un panel operativo casi en tiempo real puede priorizar la frescura. Una puntuación empresarial compartida mejora la comparación, pero las puntuaciones específicas de cada conjunto de datos conservan el contexto necesario para identificar a los propietarios y el trabajo de remediación.
Construya la puntuación en torno a los activos críticos
Comience con un grupo definido de conjuntos de datos críticos en lugar de calificar todo el patrimonio. Para cada activo, documente las dimensiones medidas, las reglas de validación, la línea base de anomalías, la expectativa de Timeliness, el propietario y la ruta de escalada. Priorice los datos vinculados a informes, cumplimiento normativo, operaciones con clientes o flujos de trabajo de IA, y luego amplíe la cobertura una vez que el proceso de medición sea estable.
La puntuación debe exponer el riesgo operativo, no ocultarlo. Un resultado de integridad más bajo puede reflejar un cambio planificado en el sistema de origen, un fallo en una tubería sin propietario o un defecto recurrente aguas arriba. Esas causas requieren respuestas diferentes, así que adjunte el contexto del incidente y los resultados a nivel de dimensión a la vista ejecutiva.
Regla práctica: Una puntuación compuesta debe activar una investigación, no reemplazarla.
La guía de digna resulta relevante cuando los equipos combinan resultados de validación, señales de anomalías y observaciones de Timeliness, manteniendo el cómputo dentro de su propio entorno. La ejecución dentro de la base de datos también puede reducir la necesidad de mover datos sensibles fuera de la infraestructura aprobada.
2. Tasa de aprobación de Data Validation
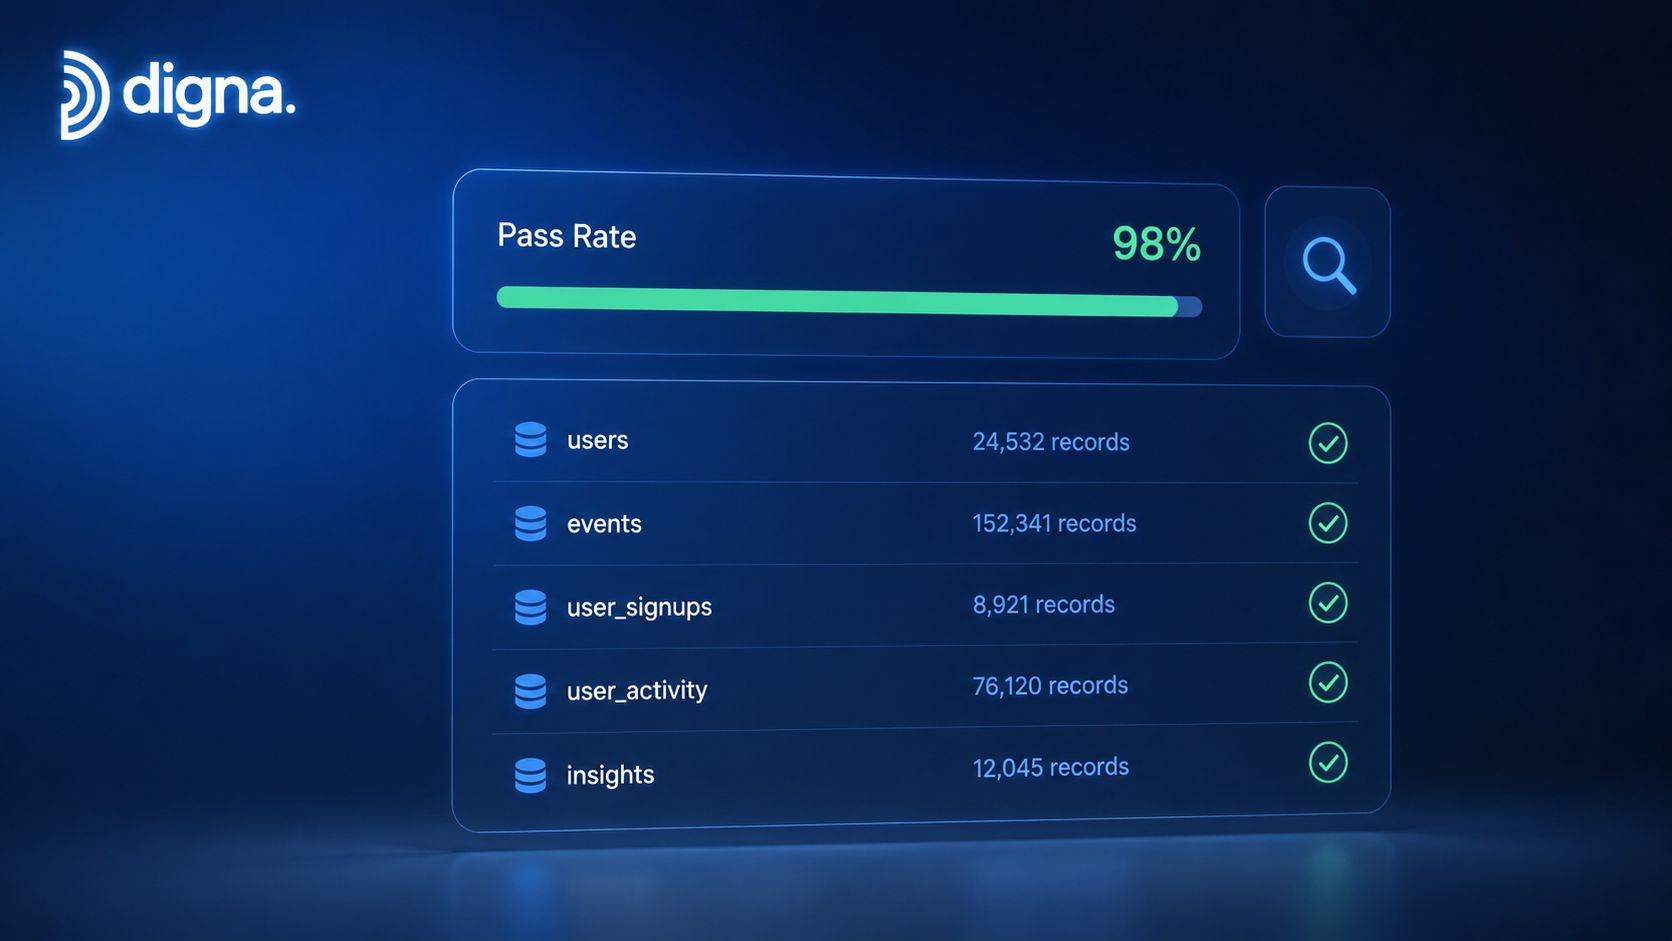
La Tasa de aprobación de Data Validation muestra si las reglas gobernadas funcionan sobre registros reales. Mide la proporción de registros que superan los controles comerciales y estructurales definidos durante un período determinado, conectando los requisitos de la política con el rendimiento del control.
Tasa de aprobación de validación = registros que superan todos los controles aplicables divididos por el total de registros evaluados, multiplicado por 100
Calcule el KPI a nivel de regla, conjunto de datos y dominio. La tasa agregada indica la aplicación general, mientras que los resultados a nivel de regla identifican fallos relacionados con direcciones, identificadores, fechas, relaciones financieras u otros campos. Dado que un solo registro puede fallar en varios controles, informe de los registros afectados de forma independiente al total de fallos de reglas. Esta distinción evita que los fallos repetidos en un grupo pequeño de registros distorsionen el panorama operativo.
Haga que los fallos sean explicables
Priorice las reglas vinculadas a informes, cumplimiento normativo, entradas de IA o prestación de servicios. Los controles deterministas permiten una comparación coherente, pero los recuentos agregados no son suficientes. Revise muestras de registros fallidos y clasifique la causa, como un error de configuración aguas arriba, una definición de origen modificada o un proceso que permite valores no válidos.
El riesgo del caso de uso debe establecer la tolerancia. Los controles de informes financieros generalmente requieren límites más estrictos que los análisis exploratorios. La validación de esquemas se puede calcular como registros que superan los controles de esquema divididos por el total de registros. Los benchmarks de KPI de data governance publicados describen objetivos superiores al 99.5% y tratan los resultados inferiores al 98% como una señal de alerta, pero esos umbrales requieren un ajuste en función de la criticidad de los datos y el alcance de las reglas.
Las reglas y controles de data validation de digna admiten pruebas a nivel de registro frente a la lógica empresarial y los requisitos de auditoría. Combine la tasa de aprobación con la propiedad de las reglas, el recuento de registros fallidos y el tiempo de resolución. Una tasa de aprobación alta sin revisión de fallos puede reflejar controles débiles en lugar de datos saludables.
3. Cumplimiento de SLA de Timeliness de datos
Los datos atrasados pueden invalidar una decisión que, de otro modo, sería correcta. El Cumplimiento de SLA de Timeliness de datos mide si las entregas esperadas llegan dentro del plazo acordado, conectando la fiabilidad de las tuberías con la frescura de los paneles, los flujos de trabajo operativos y la latencia de las decisiones. Forma la capa de condición del sistema de KPI: la cobertura muestra dónde existe gobernanza, la aplicación muestra si los controles funcionan y la Timeliness muestra si los datos gobernados son utilizables cuando las decisiones lo requieren.
Cumplimiento de SLA de Timeliness = entregas de datos disponibles a tiempo divididas por el total de entregas esperadas, multiplicado por 100
Calcule el numerador a partir de los registros de entrega con marca de tiempo. Incluya cada entrega esperada en el denominador, incluidas las cargas faltantes. Excluir los datos faltantes hace que el rendimiento parezca más sólido precisamente cuando la tubería está fallando.
Establezca el reloj en función de las necesidades del negocio
Establezca el SLA a partir de los requisitos de consumo, no del rendimiento actual de la tubería. Un resultado clínico necesario para un flujo de trabajo de alta médica tiene una urgencia diferente a la de una extracción de planificación mensual. Tenga en cuenta los cierres de mes, de trimestre, días festivos, ventanas de mantenimiento y otras variaciones del calendario antes de escalar un retraso.
Un benchmark publicado recomienda al menos un 98% de Timeliness para datos operativos críticos (fórmula y definición de KPI de Timeliness). Otra referencia de gobernanza sitúa el cumplimiento del SLA de frescura por encima del 99% y considera que un valor inferior al 95% es una señal de alerta. Estas cifras son puntos de referencia, no objetivos universales. El umbral adecuado depende de las consecuencias para el negocio, la frecuencia de entrega y el coste de los datos retrasados.
El enfoque de monitoreo de Timeliness de datos de digna utiliza patrones de entrega esperados para identificar retrasos, cargas faltantes y llegadas anticipadas. Correlacione los SLA incumplidos con el tiempo de ejecución del trabajo, la profundidad de la cola, la disponibilidad del origen y los eventos de infraestructura. Ese análisis distingue un defecto en la tubería de una limitación del entorno operativo, ofreciendo a los propietarios una ruta de remediación más clara.
4. Tasa de detección de incidentes de datos críticos
Un programa de gobernanza no puede reducir los incidentes que nunca detecta. La Tasa de detección de incidentes de datos críticos mide cuántas anomalías relevantes, fallos de calidad y cambios de esquema detecta el monitoreo dentro de una ventana de respuesta definida.
La fórmula básica es:
Tasa de detección = incidentes críticos detectados dentro de la ventana objetivo divididos por los incidentes críticos identificados a través de todas las pruebas disponibles, multiplicado por 100
La parte difícil es el denominador. Los equipos pueden descubrir incidentes a través del monitoreo, quejas de usuarios, informes fallidos, revisiones de auditoría o conciliaciones aguas abajo. Esos canales de descubrimiento deben conciliarse para que el KPI no recompense a un sistema de monitoreo por informar únicamente de sus propias alertas.
Mida la señal, no el volumen de alertas
Comience con conjuntos de datos de alto impacto y defina qué se califica como crítico. Un cambio repentino en la distribución de un conjunto de datos regulatorio puede requerir una escalada inmediata, mientras que una fluctuación estacional en una tabla exploratoria puede no requerirlo. Realice un seguimiento de la latencia de detección, los falsos positivos y la ruta desde la alerta hasta el ticket. La detección sin evidencia de respuesta es solo una protección parcial.
Las capacidades de detección de anomalías de digna combinan el aprendizaje de líneas base con la validación y el seguimiento de esquemas. Esa combinación es importante porque un incidente visible para el negocio puede originarse en una distribución de valores, una infracción de reglas o un cambio estructural.
Un equipo de monitoreo debería hacerse dos preguntas ante cada incidente: "¿Lo detectamos lo suficientemente pronto?" y "¿Actuó el propietario correcto?"
Revise los patrones de falsos positivos con regularidad. Los eventos estacionales conocidos, las migraciones planificadas y el comportamiento recurrente de los procesos por lotes deben servir para ajustar la línea base. El objetivo no es maximizar el número de alertas. Consiste en sacar a la luz los fallos importantes con la suficiente antelación para evitar informes rotos, modelos fallidos o resultados regulatorios poco fiables.
5. Tiempo de detección y resolución de cambios de esquema
Los cambios de esquema pueden generar fallos que las comprobaciones de calidad habituales pasan por alto. Una columna eliminada o un tipo incompatible pueden detener una tubería, mientras que un cambio en un campo opcional puede pasar y alterar la lógica aguas abajo sin previo aviso inmediato. El Tiempo de detección y resolución de cambios de esquema mide el tiempo transcurrido desde la detección de un cambio estructural hasta la confirmación de su adaptación por parte de los consumidores aguas abajo.
Tiempo de resolución = marca de tiempo de la adaptación confirmada aguas abajo menos la marca de tiempo de la detección del cambio
Realice un seguimiento independiente de los tiempos de resolución medio, mediano y en el peor de los casos. La media resume el rendimiento general, la mediana muestra la velocidad de funcionamiento típica y el máximo expone el riesgo de escalada. Detenga el reloj únicamente después de que se confirme la adaptación aguas abajo, no cuando alguien acuse recibo de una alerta o cree un ticket.
Clasifique los cambios antes de que ocurran
Un manual de procedimientos debe separar los cambios urgentes de aquellos aptos para una revisión planificada. La eliminación de columnas, los cambios de tipo incompatibles y la alteración de la semántica de las claves suelen requerir una escalada rápida. Las nuevas columnas opcionales pueden entrar en una cola de revisión cuando no afectan a los contratos aguas abajo.
La propiedad y el linaje acortan la investigación porque los ingenieros pueden identificar a los consumidores afectados sin tener que reconstruir las dependencias durante un incidente. Registre el significado de las columnas, la propiedad del origen, la lógica de transformación y el uso aguas abajo. Coordine los cambios planificados con el control de versiones para las transformaciones en SQL, dbt y Python.
La guía de monitoreo y explicación de la deriva de esquemas de digna cubre el seguimiento de columnas añadidas o eliminadas y las modificaciones de tipos de datos. Por lo tanto, el KPI debe evaluar algo más que la cobertura de detección. Debe mostrar si cada cambio material llegó al propietario correcto y se adaptó de forma segura, conectando la aplicación de la gobernanza con la fiabilidad de las tuberías y el riesgo en las decisiones.

6. Efectividad de la detección de anomalías en KPI de negocio
Las puntuaciones de calidad técnica protecen las decisiones solo cuando revelan si las métricas de negocio siguen siendo fiables. La Efectividad de la detección de anomalías en KPI de negocio mide la proporción de cambios significativos en métricas importantes que se detectan, explican y escalan dentro de una latencia aceptable.
Efectividad = cambios de negocio significativos detectados y correctamente escalados divididos por los cambios significativos confirmados mediante revisión, multiplicado por 100
El denominador requiere un proceso de revisión documentado. Clasifique cada alerta revisada como un movimiento comercial real, un problema de calidad de datos, un problema en la tubería o un falso positivo. Estas etiquetas conectan los resultados de negocio con las métricas de calidad de datos subyacentes, al tiempo que ofrecen pruebas a los analistas para ajustar los umbrales y reducir investigaciones evitables.
Defina lo que es "significativo" con los responsables de la toma de decisiones
Los ejecutivos pueden priorizar los ingresos, la actividad de los clientes, el volumen de transacciones o la eficiencia operativa. Los equipos de datos pueden monitorear las tablas de origen y las transformaciones que producen esas medidas. El control es efectivo únicamente cuando ambas vistas se conectan: una alerta debe identificar la métrica, el contexto histórico, los cambios de datos relacionados y el propietario de la investigación.
La capacidad de Monitoreo de Negocio de digna admite el análisis de métricas comerciales y operativas. Su módulo de Data Analytics puede ayudar a los equipos a examinar la volatilidad histórica y la estacionalidad antes de establecer los niveles de sensibilidad. Esto resulta importante para las métricas afectadas por patrones de calendario, ciclos promocionales o cierres de informes, donde un umbral fijo puede generar falsos positivos repetidos.
La alerta de anomalía de negocio más eficaz ayuda a quien toma las decisiones a determinar si cambió el negocio o cambiaron los datos.
Revise los resultados de forma periódica. Compare los resultados de detección y escalada por métrica, dominio de negocio y categoría de causa. Una puntuación a la baja puede indicar una cobertura de monitoreo débil, mientras que un alto volumen de alertas con pocas anomalías confirmadas puede indicar umbrales deficientes. Vincular las etiquetas a los incidentes de origen, eventos de esquema y fallos de validación convierte este KPI de un recuento de alertas en una prueba de que la gobernanza protege las decisiones operativas.
7. Tasa de adopción y aplicación de políticas de data governance
Una política documentada tiene un valor limitado hasta que un control la pone a prueba y alguien actúa ante las excepciones. Este KPI mide el grado de implementación de las políticas aprobadas a través de monitoreo, validación, controles de acceso, comprobaciones de Timeliness, controles de esquemas u otros mecanismos.
Tasa de aplicación = políticas con controles activos y probados divididas por el total de políticas definidas, multiplicado por 100
Defina el denominador antes de medir el progreso. Incluya normas formales y reglas operativas documentadas, separando al mismo tiempo las políticas aprobadas de las guías aspiracionales. De lo contrario, añadir políticas puede reducir la tasa incluso cuando mejora la cobertura de los controles.
Mida la madurez de la automatización
Un estudio de referencia reveló que el 61% de las organizaciones contaba con políticas vigentes, pero solo el 38% disponía de una aplicación automatizada (estudio de referencia de madurez de gobernanza). Esta brecha hace que los recuentos de políticas sean una prueba débil. Una política puede existir en un documento sin una verificación del sistema, un propietario responsable o una vía de excepción procesable.
Asocie cada política con su control, alcance del conjunto de datos, propietario, frecuencia de prueba, proceso de excepción y ubicación de la evidencia. Informe de los resultados por dominio y nivel de riesgo, no solo como un promedio de la empresa. Una organización de salud, por ejemplo, puede constatar que los controles de facturación funcionan automáticamente mientras que los controles clínicos siguen siendo manuales.
El monitoreo de la Timeliness también proporciona pruebas para la aplicación. El seguimiento de si los datos cumplen con los niveles de servicio acordados ayuda a verificar que una política opera en producción, en lugar de existir simplemente en la documentación. Consulte la guía sobre definiciones, métricas y monitoreo de Timeliness de datos.
La adopción incluye el comportamiento posterior a la detección. Realice un seguimiento del acuse de recibo de alertas, la resolución de excepciones y el cumplimiento del flujo de trabajo. Un control automatizado con hallazgos ignorados sistemáticamente solo se aplica de forma parcial, por lo que debe combinar este KPI con los resultados de los incidentes y las medidas de impacto en el negocio.
8. Cobertura de Data Observability y profundidad de monitoreo
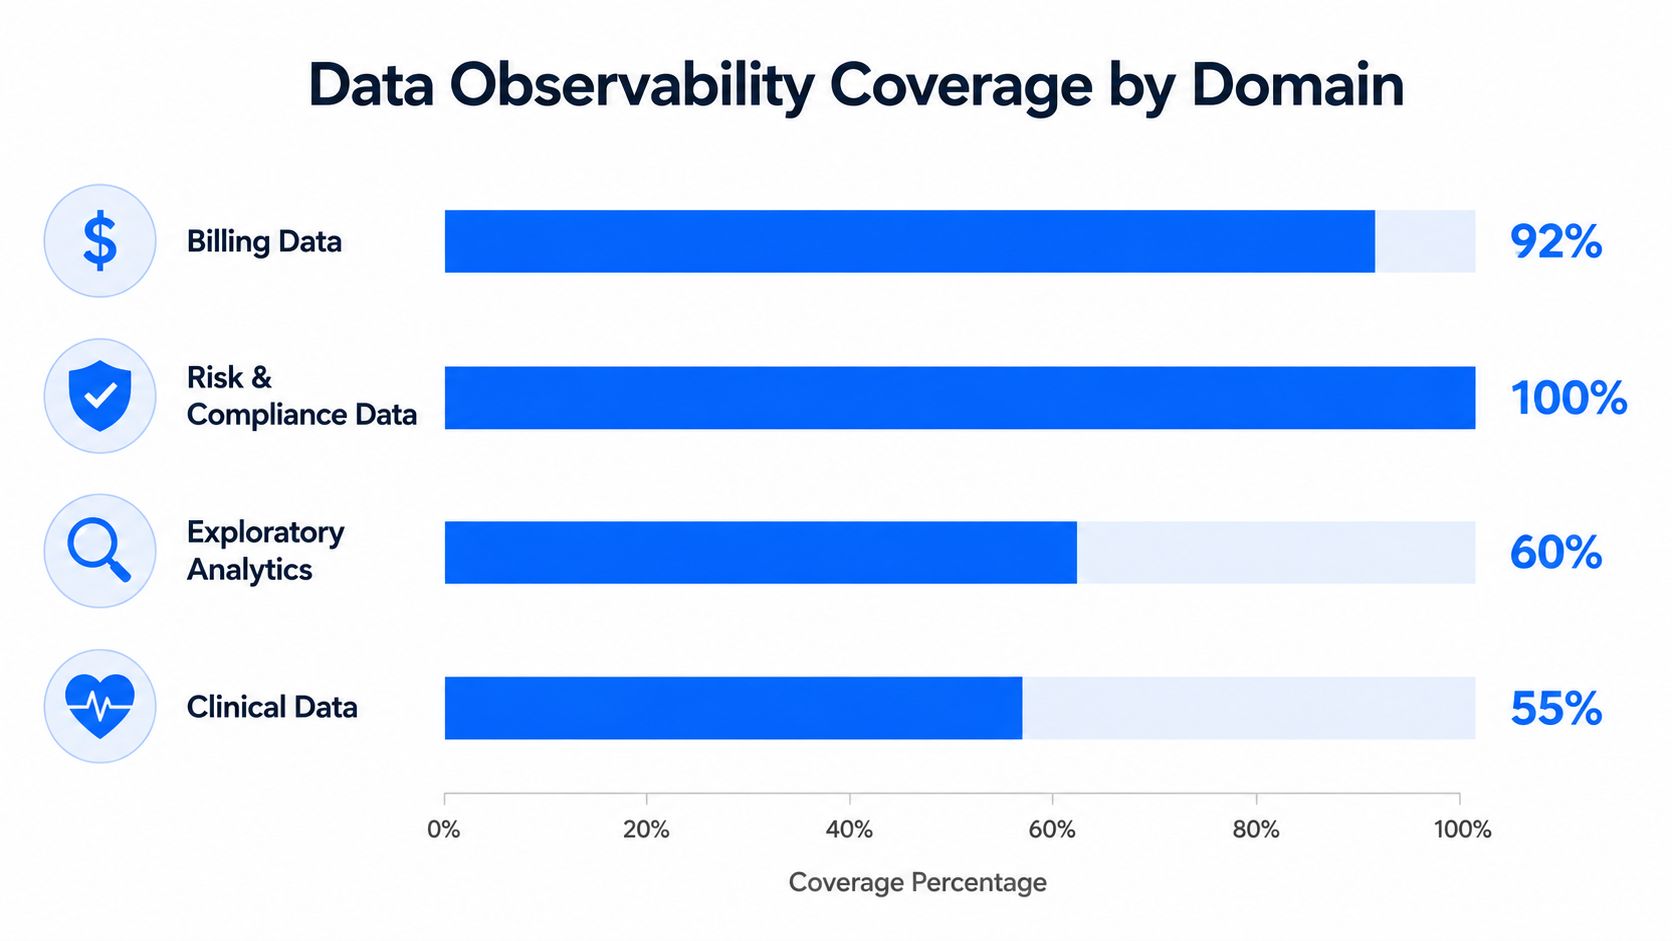
La cobertura muestra dónde existe gobernanza, mientras que la profundidad de monitoreo muestra si puede proteger las decisiones. Mida la proporción de tablas críticas, tuberías y métricas de negocio bajo monitoreo activo.
Cobertura de Observability = activos críticos monitoreados divididos por el total de activos críticos, multiplicado por 100
Un porcentaje de cobertura puede ocultar una protección débil. Monitorear una tabla para verificar su integridad ofrece menos control que monitorear otra para verificar integridad, Timeliness, anomalías y cambios de esquema. Informe tanto de la proporción de activos monitoreados como de la cantidad y el tipo de controles activos por activo.
Separe la amplitud de la protección
Inventaríe el almacén de datos, el lago, las tuberías y las métricas de negocio. Clasifique cada activo según su conexión con las decisiones, las obligaciones de cumplimiento, los acuerdos de nivel de servicio y el riesgo operativo. Priorice las brechas donde un fallo podría interrumpir los informes, el trabajo regulatorio o las operaciones.
Los objetivos de referencia pueden incluir aproximadamente un 90% de cobertura del catálogo y un 95% de cobertura de linaje o políticas, con un 100% de finalización de revisiones de acceso para un programa maduro. Estas cifras sirven de guía para la planificación en lugar de definir requisitos universales. Un conjunto de datos de riesgo regulado puede justificar un monitoreo completo, mientras que un activo exploratorio de bajo riesgo puede necesitar menos profundidad.
Utilice el historial de incidentes, las obligaciones de cumplimiento y las prioridades de negocio para establecer la profundidad de monitoreo. Una puntuación de cobertura alta con comprobaciones superficiales puede generar una falsa seguridad, mientras que controles más profundos en los activos de mayor repercusión pueden reducir el riesgo de las decisiones de manera más eficaz que un monitoreo uniforme.
La solución Data Platform Observability de digna monitorea las cargas de trabajo de datos, el consumo, la disponibilidad, las medidas relacionadas con el rendimiento y los cambios. Su modelo de ejecución dentro de la base de datos puede ayudar a los equipos a ampliar el monitoreo sin tener que mover datos de producción fuera de su entorno.
Comparación de los 8 KPI de data governance
Métrica | Complejidad de implementación 🔄 | Requisitos de recursos ⚡ | Resultados esperados 📊 | Casos de uso ideales 💡 | Ventajas clave ⭐ |
|---|---|---|---|---|---|
Puntuación de calidad de datos | 🔄 Media, necesita lógica de ponderación y agregación entre dimensiones | ⚡ Moderada, reglas de validación, detección de anomalías, almacenamiento histórico | 📊 Puntuación unificada de salud de datos para análisis comparativos y seguimiento de tendencias | 💡 Informes ejecutivos, seguimiento de SLA, comparaciones entre unidades | ⭐ Simplifica los informes; prioriza la remediación |
Tasa de aprobación de Data Validation | 🔄 Media, requiere un diseño y ajuste cuidadoso de las reglas | ⚡ Alta, comprobaciones a nivel de registro y mantenimiento continuo de reglas | 📊 Métrica de aplicación precisa con informes detallados de fallos | 💡 Auditorías de cumplimiento, validación aguas arriba, correcciones específicas | ⭐ Evidencia de fallos accionable y lista para auditorías |
Cumplimiento de SLA de Timeliness de datos | 🔄 Baja-Media, necesita aprendizaje de líneas base e integración de programaciones | ⚡ Moderada, monitoreo de tuberías y sistemas de alerta | 📊 % de entregas a tiempo; alerta temprana para cargas retrasadas o faltantes | 💡 Monitoreo de SLA de tuberías, frescura de paneles, SLA operativos | ⭐ Automatiza el seguimiento de SLA; cuantifica la fiabilidad de las tuberías |
Tasa de detección de incidentes de datos críticos | 🔄 Alta, definición de líneas base con IA + integración con sistemas de incidentes | ⚡ Alta, detección continua de anomalías y alertas | 📊 Detección más rápida (menor MTTD); expone problemas conocidos y desconocidos | 💡 Analítica de producción, monitoreo de modelos, dominios de datos de alto riesgo | ⭐ Detección temprana de anomalías; reduce el impacto de las interrupciones |
Tiempo de detección y resolución de cambios de esquema | 🔄 Baja-Media, seguimiento continuo + manuales de procedimientos para la respuesta | ⚡ Baja-Moderada, monitoreo de esquemas y herramientas de análisis de impacto | 📊 Métrica de tiempo de resolución; evita fallos silenciosos aguas abajo | 💡 Entornos con deriva de esquemas frecuente o muchas integraciones | ⭐ Detección inmediata; visibilidad de impacto y pista de auditoría |
Efectividad de la detección de anomalías en KPI de negocio | 🔄 Alta, requiere definiciones de KPI precisas y ajuste | ⚡ Alta, líneas base de IA, análisis multidimensional, pistas de causa raíz | 📊 % de cambios de negocio significativos detectados y contextualizados | 💡 Paneles ejecutivos, monitoreo de ingresos/volumen, alertas operativas | ⭐ Alertas enfocadas en el negocio con pistas contextuales sobre la causa raíz |
Tasa de adopción y aplicación de políticas | 🔄 Media, mapeo de políticas a monitores y flujos de trabajo de excepciones | ⚡ Moderada, gestión de políticas, registro de auditoría, aprobaciones | 📊 % de políticas operativizadas; indicador de madurez de la gobernanza | 💡 Programas de gobernanza, informes de cumplimiento, gestión de riesgos | ⭐ Muestra el control operativo; prioriza las brechas de aplicación |
Cobertura de Observability y profundidad de monitoreo | 🔄 Alta, descubrimiento automatizado y configuración de monitoreo multicapa | ⚡ Alta, inventariado, definición de líneas base, paneles en todas las capas | 📊 Ratio de cobertura y métricas de profundidad para identificar puntos ciegos | 💡 Grandes plataformas de datos, planificación de madurez de la observabilidad | ⭐ Cuantifica la madurez del monitoreo; guía la inversión en cobertura |
Convierta ocho métricas en un ritmo operativo de gobernanza
Estos ocho KPI funcionan mejor como sistema que como un inventario de números inconexos. La cobertura indica si los activos críticos son visibles. La aplicación de políticas indica si los estándares escritos funcionan en flujos de trabajo en vivo. La calidad y validación muestran si los registros son aptos para el uso. La Timeliness muestra si los datos llegan cuando las decisiones lo requieren. La detección de incidentes y resolución de esquemas revelan con qué rapidez responde la organización ante el cambio. La efectividad ante anomalías de negocio conecta el monitoreo técnico con los resultados que gestionan los líderes.
Comience estableciendo una línea base sobre los activos críticos. Registre las dimensiones de calidad actuales, los resultados de validación, el rendimiento de las entregas, la cobertura del monitoreo, los controles de políticas, las vías de incidentes y los resultados de las alertas de métricas de negocio. Evite cambiar el objetivo mientras cambia el método de medición. Una tendencia es útil solo cuando la población, la fórmula y la ventana de observación siguen siendo comprensibles.
Asigne un propietario a cada KPI y a cada activo crítico. El propietario debe tener autoridad para investigar, aprobar excepciones, coordinar la remediación y confirmar el cierre. Esto aborda un problema central de gobernanza identificado en una encuesta de 2025, donde el 47% de los encuestados señaló la falta de claridad en la propiedad y la responsabilidad como el principal obstáculo para escalar la gobernanza (encuesta de data governance de 2025). Un panel puede exponer un problema, pero solo las personas responsables pueden resolverlo.
Establezca umbrales según el impacto en el negocio. Utilice controles más estrictos para los datos que respaldan informes regulatorios, operaciones con pacientes, riesgo financiero o decisiones de clientes de gran trascendencia. Como referencia, los marcos publicados incluyen objetivos como al menos un 90% de cobertura de catálogo, al menos un 95% de cobertura de políticas, un MTTR inferior a cuatro horas y una finalización del 100% para las revisiones trimestrales de acceso (marco de métricas de data governance). Trate estos datos como parámetros de diseño y luego valídelos frente a las necesidades reales del servicio y la capacidad de respuesta.
Revise diferentes señales a ritmos distintos. Los ingenieros y administradores necesitan vistas frecuentes de validaciones fallidas, entregas fallidas, incidentes abiertos, falsos positivos y cambios de esquema. Los líderes de gobernanza necesitan ver las tendencias de cobertura, aplicación, calidad y remediación. Los ejecutivos necesitan una conexión concisa entre los controles de datos y los resultados del negocio. Esta distinción es importante porque el 39% de los líderes de datos reportó dificultades para demostrar el impacto de la gobernanza a la dirección, mientras que el 85% de los altos ejecutivos de datos y analítica priorizó las mejoras de gobernanza para prepararse para la IA (informe sobre el estado del data governance empresarial en 2025).
Ningún KPI por sí solo demuestra la salud de la gobernanza. Una puntuación de alta calidad puede coexistir con puntos ciegos. Una amplia cobertura puede coexistir con una aplicación débil. Una detección rápida puede coexistir con una remediación lenta. Construya el cuadro de mando de modo que cada medida responda a una pregunta operativa diferente, y conecte cada alerta con evidencia de propiedad, acción y resolución confirmada.
digna es una opción para los equipos que necesitan un monitoreo integral que abarque calidad, Timeliness, anomalías, validación, cambios de esquema, métricas de negocio y observabilidad de la plataforma. Su plataforma modular se ejecuta dentro del entorno del cliente y admite la ejecución en base de datos, lo que permite a los equipos mantener los datos en su sitio mientras expanden el sistema de medición de gobernanza.
Utilice digna para monitorear señales críticas de calidad de datos, Timeliness, validación, anomalías, esquemas y observabilidad dentro de su propio entorno. Visite digna para conectar estos controles con propietarios responsables, alertas operativas y pruebas de que la gobernanza está funcionando en producción.


