Formatos de archivo Parquet: estructura, ajuste y buenas prácticas
|
12
minuto de lectura

Tu panel de BI vuelve a ir lento. El trabajo nocturno dejó otro montón de archivos CSV en el almacenamiento de objetos, alguien añadió un par de columnas sin avisar y la única consulta que importa al negocio ahora mastica muchos más datos de los que justifica el resultado.
Ese suele ser el momento en que los formatos de archivo Parquet dejan de parecer una elección de extensión y empiezan a parecer una decisión de arquitectura. Si tu equipo usa Spark, DuckDB, Trino, BigQuery, modelos dbt o pipelines de lakehouse, Parquet está justo en el centro de tu historia de fiabilidad y coste. Lo complicado es que la mayoría de explicaciones se detienen en «Parquet es columnar», lo cual es cierto pero incompleto.
Lo que importa en la práctica es cómo Parquet dispone los datos en disco, qué codificaciones ayudan, qué cambios de esquema son seguros y qué sigue cambiando en el propio formato. En 2026 Parquet no está congelado. Siguen llegando nuevos tipos lógicos y codificaciones, y el soporte aterriza de forma desigual entre motores. Ahí es donde los equipos de producción quedan atrapados.
Índice de contenidos
Por qué existen los formatos de archivo Parquet para la analítica moderna
Codificaciones y códecs de compresión que de verdad marcan la diferencia
Por qué existen los formatos de archivo Parquet para la analítica moderna
CSV es sencillo de producir y doloroso de analizar a escala. Si una consulta de panel solo necesita price, region y event_date, un lector de CSV todavía tiene que parsear cada campo de cada fila solo para llegar a esas columnas. El formato no sabe dónde viven los valores de una columna como bloque contiguo y no lleva metadatos suficientes para saltarse fragmentos irrelevantes con limpieza.
Parquet lo corrige almacenando los datos por columna en lugar de por fila. También guarda metadatos que ayudan a los lectores a evitar trabajo innecesario. Las explicaciones modernas del formato señalan que estas decisiones de diseño suelen hacer los archivos Parquet entre 5 y 10 veces más pequeños que CSV y entre 10 y 100 veces más rápidos de consultar en cargas analíticas, con un ejemplo de benchmark que muestra un archivo Parquet-Zstd de 164 MB frente a 1,09 GB en CSV sobre un conjunto de 11,2 millones de filas, y algunas consultas de recuento unas 160 veces más rápidas cuando los metadatos por sí solos pueden responderlas (explicación del formato Parquet de MotherDuck).
Por qué la disposición columnar lo cambia todo
Cuando los valores de una misma columna están juntos, los motores pueden hacer tres cosas útiles:
Leer menos bytes: una consulta que necesita tres columnas no tiene que arrastrar las demás por la red y por el parser.
Comprimir mejor: los valores similares tienden a agruparse dentro de una columna, así que codificaciones como diccionario, run-length y delta se vuelven eficaces.
Saltarse bloques enteros: Parquet guarda metadatos de mínimo, máximo y recuento de nulos en el pie, de modo que los lectores pueden descartar row groups antes de decodificarlos.
Por eso Parquet se convirtió en el formato por defecto del almacenamiento analítico y no del procesamiento transaccional. Está optimizado para escaneos, agregaciones, filtrado y proyección.
Regla práctica: si la gente consulta sobre todo subconjuntos de columnas y escanea grandes conjuntos de datos, los formatos de texto orientados a filas están peleando contra la carga de trabajo.
Lo que los ingenieros todavía deben decidir
Parquet no elimina las decisiones de diseño. Las desplaza.
Un equipo de producción sigue teniendo que responder preguntas sobre el tamaño de los row groups, los códecs por defecto, la disposición de páginas, el soporte de versiones y la evolución del esquema. No son casos límite. Afectan directamente al coste de escaneo, a la interoperabilidad y a si los lectores posteriores sobreviven a un cambio en el pipeline.
Si estás diseñando almacenamiento de lakehouse o revisando los formatos de extracción del almacén, este es el punto en el que las decisiones de arquitectura de sistemas de datos dejan de ser abstractas. El comportamiento del formato de archivo moldea la latencia de consulta, la eficiencia de almacenamiento y los modos de fallo operativos.
La historia de origen y por qué sigue importando
Buena parte del dolor de producción alrededor de Parquet empieza con una suposición falsa: que es solo una extensión neutra que todos los motores tratan igual. No lo es. Parquet nació de un problema analítico concreto, y aquellas decisiones de diseño originales siguen explicando tanto sus fortalezas como sus modos de fallo.
Parquet comenzó en 2013 como un esfuerzo conjunto entre Twitter y Cloudera. El lanzamiento 1.0 se anunció el 30 de julio de 2013, cuando el proyecto ya acumulaba más de 90 pull requests fusionadas, lo que muestra la velocidad con la que el formato tomaba forma en sus primeros meses (anuncio de Parquet 1.0 por el equipo de ingeniería de Twitter).

En aquel momento, los equipos de la era Hadoop lidiaban con conjuntos de datos anchos, tiempos de escaneo largos y facturas de almacenamiento que crecían más rápido que los presupuestos. Parquet se construyó para ese entorno. Guardar valores por columna, comprimir juntos los valores similares y dar a los motores de consulta metadatos suficientes para ahorrarse trabajo. Hoy suena corriente porque todo equipo de lakehouse lo da por hecho. En 2013 resolvía un cuello de botella muy caro.
El proyecto pasó después a ser proyecto de primer nivel de la Apache Software Foundation el 27 de abril de 2015. Eso importa porque los formatos de archivo viven o mueren según el soporte de los lectores. En cuanto varios motores, almacenes y formatos de tabla apostaron por Parquet, la compatibilidad pasó a ser tan importante como la ratio de compresión bruta.
Las apuestas iniciales siguen apareciendo en 2026
Dos decisiones de diseño del principio siguen moldeando pipelines reales.
Primero, Parquet se optimizó para escaneos analíticos, no para búsquedas puntuales. Un archivo Parquet funciona como un almacén ordenado por tipo de producto en lugar de por pedido de cliente. Si necesitas todos los valores de una columna a lo largo de 500 millones de filas, esa disposición es eficiente. Si necesitas una fila concreta del medio, resulta torpe. Los equipos siguen metiéndose en problemas cuando usan Parquet para reproducir eventos, APIs operativas o cargas que requieren acceso rápido a registros individuales.
Segundo, Parquet hizo los archivos autodescriptivos. El esquema y los metadatos de row group viven en el pie, así que los lectores pueden descubrir la estructura sin depender de un servicio de esquema aparte. Esa portabilidad es una razón importante de que Parquet se extendiera por Spark, Hive, Trino, DuckDB, las tablas externas de Snowflake y las pilas de lakehouse.
También crea un filo peligroso. Si el pie se daña, el archivo puede resultar ilegible aunque las páginas de datos sigan intactas en el almacenamiento de objetos. El formato lo explicita. Los archivos terminan con el número mágico PAR1, y la longitud de los metadatos se guarda como un entero de 4 bytes little-endian en el pie, que indica a los lectores dónde empiezan el esquema y los metadatos de row group (documentación del formato de archivo Apache Parquet).
Ese detalle suena de bajo nivel, pero pesa en la operación. Una subida truncada, una escritura multiparte fallida o un trabajo de reescritura con errores pueden convertir un pie dañado en un archivo ilegible. En un conjunto particionado, eso suele aflorar como un día que falta, un backfill roto o una consulta que falla solo para un segmento de clientes. Para los equipos que trabajan en prácticas de calidad y fiabilidad de datos en el lakehouse, esta es una de las razones por las que la validación de archivos pertenece al pipeline y no al postmortem.
La historia de origen también ayuda a explicar lo que Parquet sigue sin resolver por defecto. La victoria original era evidente con valores repetidos, dimensiones de baja cardinalidad y analítica intensiva en escaneo. En 2026 reciben más atención los casos difíciles: columnas de texto de alta cardinalidad como URLs o identificadores de usuario, medidas en coma flotante que no comprimen bien y cambios de esquema que técnicamente validan y aun así rompen a los lectores posteriores. No son señales de que Parquet haya fallado. Son recordatorios de que el formato se diseñó como cimiento, no como garantía de que todo conjunto de datos obtenga buen tamaño, velocidad y compatibilidad solo con la configuración por defecto.
Dentro de un archivo Parquet: de los row groups a las pages
Una consulta de producción va lenta en una partición y rápida en los otros 364 días de la tabla. La razón habitual no es «Parquet es lento». Es que el archivo se dispuso de una forma que obligó al motor a leer muchos más bytes de los que la consulta necesitaba.
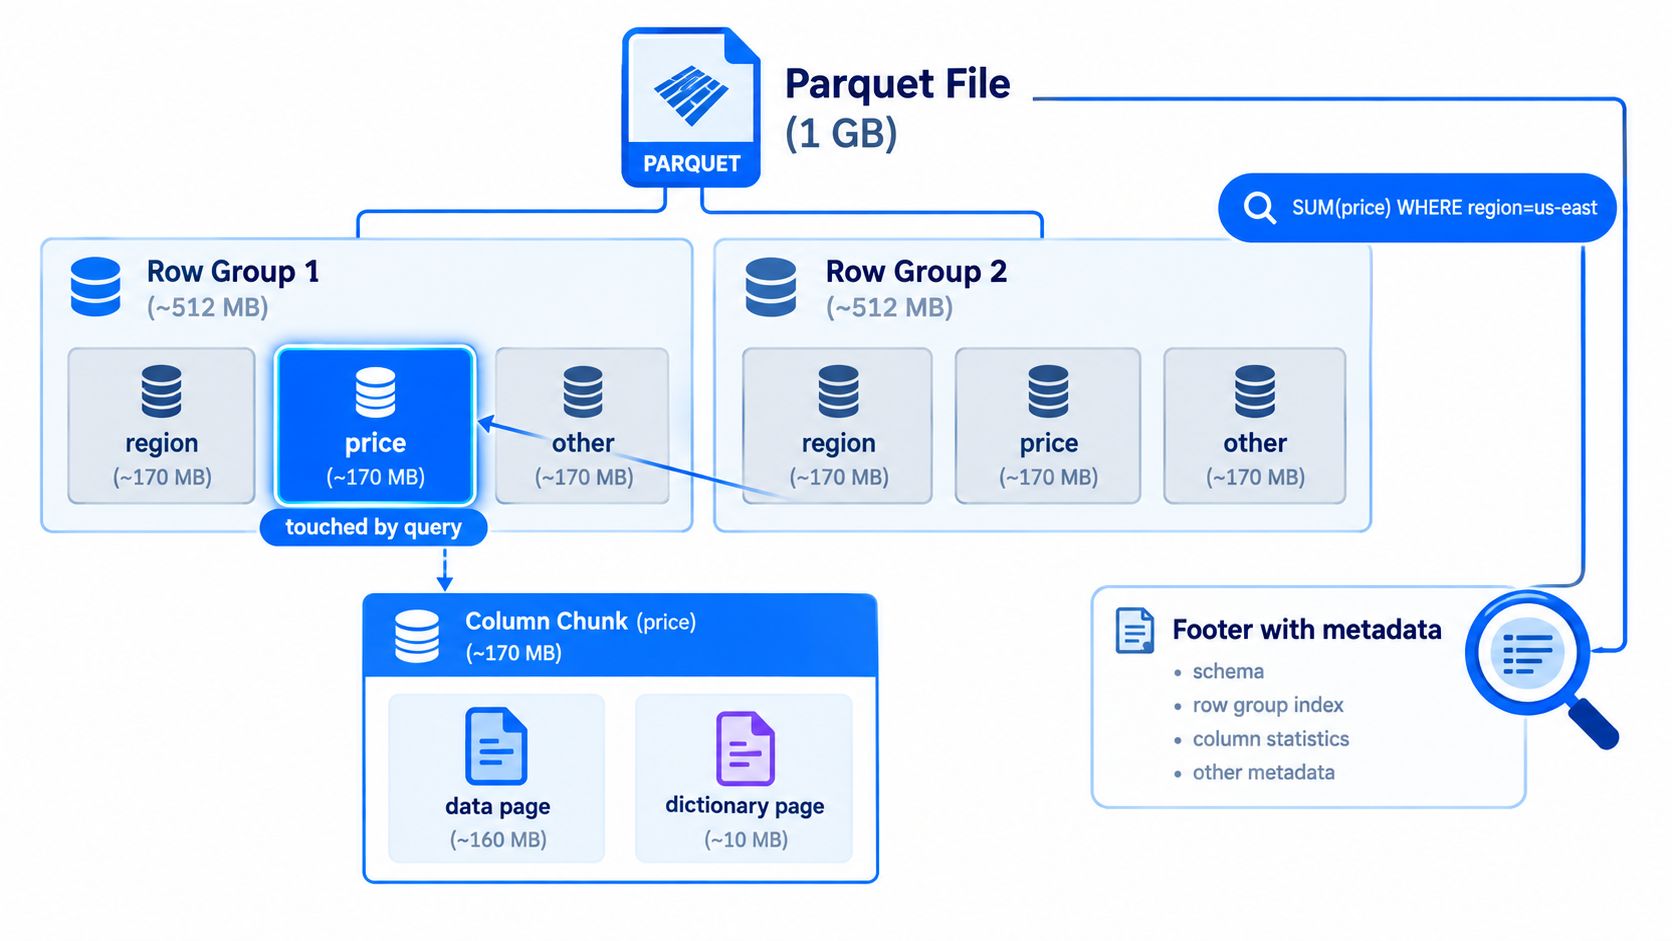
Parquet se entiende mejor cuando imaginas su disposición de almacenamiento como contenedores anidados. Un archivo contiene row groups. Cada row group contiene un column chunk por columna. Cada column chunk se divide en pages. Esa jerarquía es lo que permite a los motores leer price sin tocar comment_text, o saltarse bloques de datos que no pueden cumplir un filtro. La documentación del page index de Parquet describe la estructura y los metadatos opcionales de grano más fino usados para omitir páginas (documentación del page index de Parquet).
Empieza por el nivel de row group
Si vienes de una mentalidad de row store, el row group ayuda a replantear el modelo. Es una porción horizontal de la tabla, pero almacenada por columna dentro de esa porción.
Supongamos que un archivo contiene columnas como region, price y event_date. Un row group contendrá tres column chunks: uno para region, otro para price y otro para event_date. Los valores no se guardan fila a fila. Se guardan como tres tiras de datos separadas dentro de ese row group. Por eso una consulta que solo necesita price puede evitar leer los bytes de las otras dos columnas.
Para la analítica intensiva en escaneo, los row groups son la primera unidad útil de paralelismo y omisión. También es donde empiezan muchas concesiones operativas. Un row group demasiado pequeño genera metadatos de sobra y demasiadas lecturas diminutas. Uno demasiado grande puede hacer que las consultas selectivas lean más datos de los necesarios y encarece los reintentos y las reescrituras en el almacenamiento de objetos.
Luego acércate a las pages
Las pages son los bloques más pequeños dentro de cada column chunk. La codificación y la compresión ocurren a este nivel.
El detalle suena mecánico, pero afecta a cargas reales. Una columna con cadenas largas y de alta cardinalidad, como URLs, identificadores de dispositivo o tokens de sesión, a menudo se ve bien a nivel de archivo y aun así comprime mal página a página. El mismo patrón aparece con medidas en coma flotante que apenas se repiten y responden mal a las codificaciones por defecto. En 2026 esos dos casos siguen siendo donde los equipos descubren que «almacenado en Parquet» no significa automáticamente «pequeño y rápido».
Un modelo mental útil es un almacén. El archivo es el edificio. Los row groups son los pasillos. Los column chunks son las estanterías de un tipo de producto dentro de un pasillo. Las pages son las cajas de cada estantería. Una consulta debería abrir las menos cajas posibles.
Qué hace realmente un lector
Un lector empieza por los metadatos del pie y luego decide qué row groups y columnas merece la pena abrir. Si una consulta pide SUM(price) donde region = 'us-east', el motor suele poder inspeccionar las estadísticas de row group para region y saltarse aquellos cuyos valores no puedan coincidir. Si solo necesita price, también puede evitar leer los demás column chunks de esos row groups.
Ese es el camino feliz.
El matiz es que la omisión depende de la distribución de los datos y del comportamiento del escritor. Si las filas están mezcladas al azar y cada row group contiene todas las region, las estadísticas de mínimo y máximo ayudan menos. Si una columna de texto está desordenada y es muy única, los límites de página pueden contener suficiente variación como para que la omisión por página aporte poco. El formato proporciona la maquinaria, pero la disposición de tus datos determina si esa maquinaria ahorra trabajo.
Por qué los metadatos de página importan más ahora
Los metadatos de página son uno de los desarrollos más interesantes para sistemas de producción, porque pueden reducir lecturas desperdiciadas dentro de un row group y no solo entre row groups. Eso importa a medida que los archivos crecen y los filtros selectivos se vuelven más comunes.
También es desigual en la práctica. Algunos motores escriben los metadatos, otros los leen y otros los ignoran. El error operativo es dar por supuesto el soporte porque la especificación incluya la función. Los equipos que actualicen su pila en 2026 deberían verificar el comportamiento con sus motores reales y sus rutas de almacenamiento en la nube, sobre todo en entornos mixtos que usan Spark para escribir y DuckDB, Trino o lectores de almacén para consultar.
La guía de configuración frente a la realidad de campo
La guía de configuración de Parquet recomienda row groups grandes y páginas pequeñas, con ejemplos como row groups de 512 MB a 1 GB y páginas de 8 KB, además de supuestos de disposición alineados con HDFS (guía de configuración de Parquet).
Esas cifras son útiles como orientación del formato, no como ajustes universales.
En almacenamiento de objetos, la elección práctica depende a menudo de la concurrencia de lectores, el tamaño de las particiones, el coste de los reintentos y la forma de tus predicados. Una tabla de hechos por lotes escaneada de principio a fin puede beneficiarse de row groups mayores. Un conjunto golpeado por filtros selectivos de cliente o tiempo quizá funcione mejor con otro equilibrio. El error común es copiar valores por defecto de un motor o sistema de almacenamiento a otro y esperar el mismo comportamiento.
Ten presente esta jerarquía:
Archivo: el objeto guardado en S3, GCS, ADLS o HDFS
Row group: una porción horizontal de filas y la unidad principal de omisión gruesa
Column chunk: los datos de una columna dentro de un row group
Page: el bloque que se codifica, se comprime y a veces se omite con metadatos de grano más fino
Si entiendes esas cuatro capas, Parquet deja de resultar opaco. Se convierte en un conjunto de decisiones de almacenamiento que puedes inspeccionar, medir y ajustar.
Parquet versión 1 frente a versión 2 en la práctica
La especificación de Parquet ha evolucionado a lo largo de varias versiones, y la pregunta útil es qué capacidades soportan tus lectores y escritores.
Parquet v2 introdujo más que una etiqueta nueva. Amplió cómo el formato maneja los datos anidados, la representación de nulos y los metadatos para una omisión más fina. La estructura del archivo sigue resultando familiar, pero el soporte de las capacidades más nuevas aterriza de forma desigual entre motores, y por eso «escribir v2» puede ser un buen valor por defecto o una trampa de interoperabilidad según tu entorno.
La matriz de capacidades que importa
Capacidad | Parquet v1 | Parquet v2 | ¿Fiable en 2026? |
|---|---|---|---|
Disposición columnar básica | Sí | Sí | Sí |
Estadísticas de mínimo, máximo y nulos en el pie a nivel de row group | Sí | Sí | Sí |
Soporte de datos anidados con niveles de repetición y definición | Soportado en la familia del formato | Continuado y de uso extendido | Normalmente sí, pero verifica el comportamiento del lector con esquemas complejos |
Estadísticas de página mediante page index | No | Sí | Solo si tu motor las soporta y las usa explícitamente |
Mejor tratamiento de nulos en formatos de página más recientes | Limitado | Mejor soporte | A menudo sí, pero depende del motor |
Funciones opcionales más nuevas, como los filtros de Bloom | No | Disponible en el ecosistema | No, audita primero el soporte del lector |
De qué puedes depender con seguridad
Si escribes archivos para entornos mixtos con Spark, DuckDB, Trino y BigQuery, las suposiciones más seguras siguen siendo las básicas: proyección de columnas, estadísticas de row group, codificaciones estándar y códecs de compresión mayoritarios.
Lo que no es universalmente seguro es todo lo que dependa de metadatos opcionales recientes o de funciones nuevas de la especificación. Esa cautela importa aún más porque Parquet sigue evolucionando. En 2026 el proyecto publicó Parquet 2.14.0 y destacó el trabajo sobre el tipo lógico FILE, la codificación adaptativa sin pérdida para coma flotante (ALP) y una mejor ordenación de marcas de tiempo. El proyecto también señala que el despliegue es escalonado, con ALP marcado como «in preview» mientras las implementaciones se ponen al día (blog del formato Apache Parquet).
Regla de compatibilidad: escribe para el lector más antiguo que no puedas controlar.
Esa es la lente práctica. Para pipelines nuevos, v2 suele ser el mejor objetivo de escritura. Pero antes de apoyarte en metadatos de página recientes, semántica avanzada de marcas de tiempo o codificaciones en vista previa, audita todos los motores que vayan a leer los archivos. Si tu equipo usa Databricks o lectores de lakehouse mixtos, los controles de calidad de datos en Databricks pasan a formar parte de la conversación sobre el formato, porque los problemas de compatibilidad suelen aflorar como incidencias de calidad posteriores y no como fallos de lectura evidentes.
Codificaciones y códecs de compresión que de verdad marcan la diferencia
Un archivo Parquet se hace pequeño en dos pasos separados, y el ajuste en producción se vuelve más sencillo cuando mantienes esos pasos diferenciados.
Primero, Parquet codifica una columna en una forma que encaja con la forma del dato. Después ejecuta un códec de compresión sobre los bytes resultantes. Si te saltas esa distinción, es fácil culpar a Snappy o a ZSTD de un problema de tamaño que en realidad empezó con una mala elección de codificación. Una investigación que compara el comportamiento de codificación y compresión de Parquet en cargas analíticas concluyó que la combinación importa más que el códec por sí solo (resumen de investigación sobre compresión y codificaciones en Parquet).
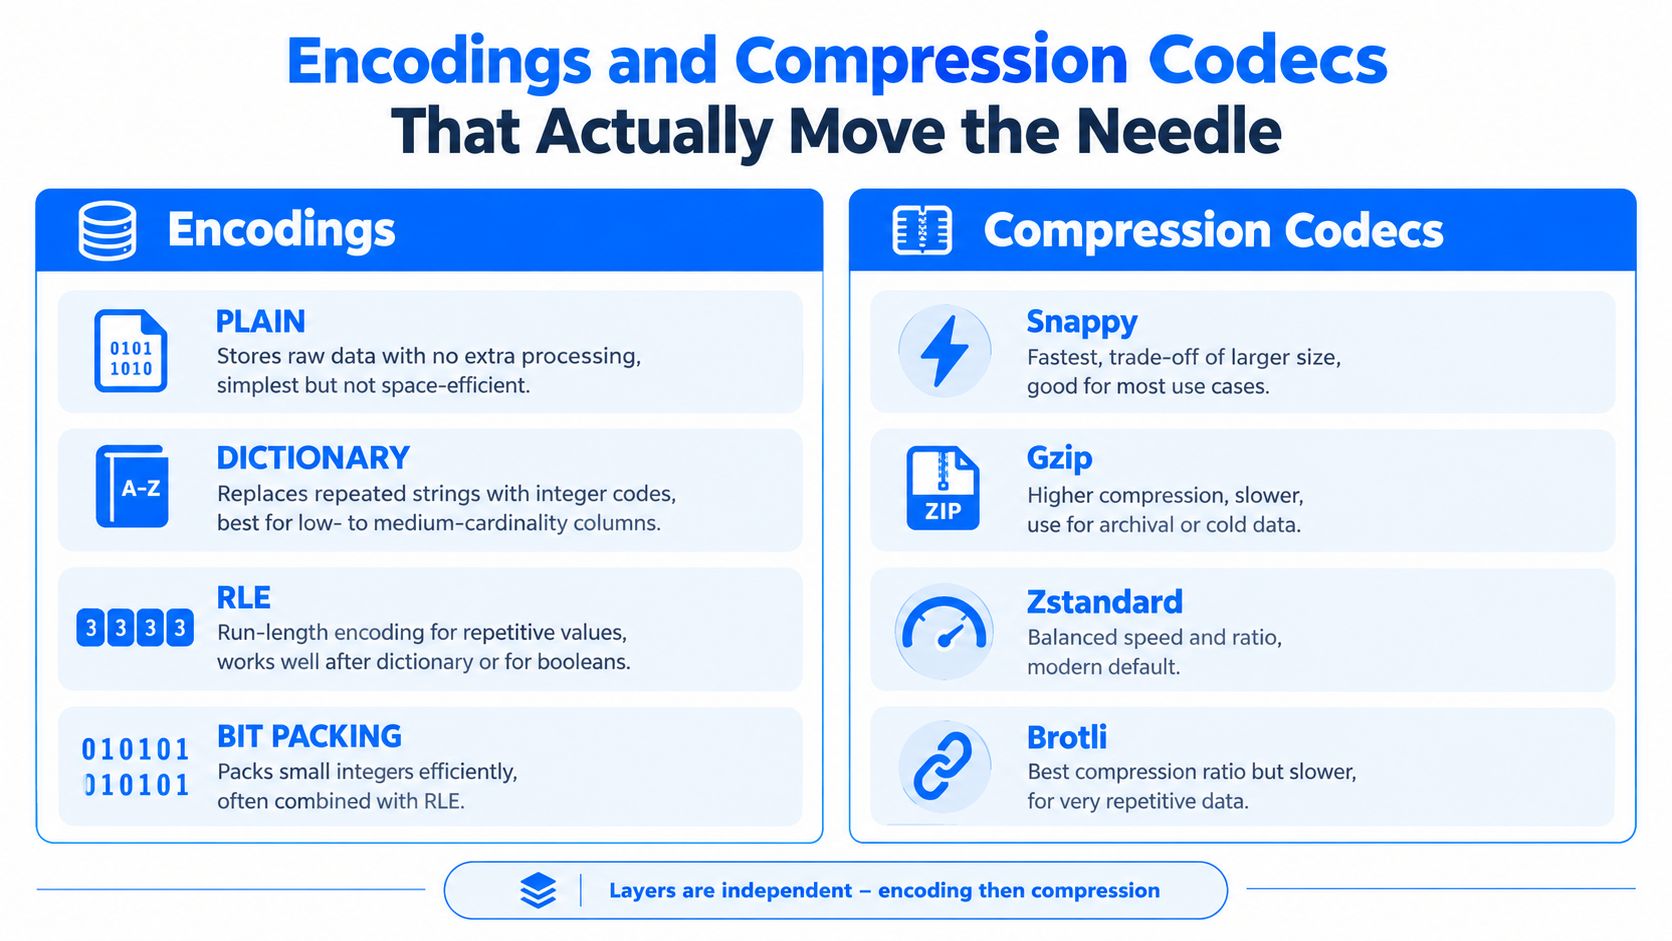
La codificación funciona como ordenar herramientas en cajas etiquetadas antes de cargar un camión. La compresión son las correas y el film que se aplican una vez cargado. Un buen embalaje empieza por las cajas.
Primero las codificaciones, después los códecs
Las codificaciones habituales resuelven problemas distintos:
PLAIN: guarda los valores directamente. Buen recurso de reserva, flojo en tamaño.
DICTIONARY: sustituye valores repetidos por códigos enteros pequeños. Potente con cadenas de cardinalidad baja y media, enumeraciones y muchas columnas tipo identificador.
RLE y bit-packing: compactan enteros repetidos o de poca anchura. Útiles para booleanos, índices de diccionario y datos con mucha repetición.
Codificaciones DELTA: guardan los cambios entre valores cercanos en lugar de cada valor completo. Encajan mejor con enteros ordenados, contadores y algunas columnas temporales.
Un ejemplo concreto ayuda. Supón que una columna status solo contiene pending, paid y failed a lo largo de 100 millones de filas. La codificación por diccionario convierte esas cadenas en códigos minúsculos como 0, 1 y 2. RLE y bit-packing pueden entonces guardar rachas largas o valores de poca anchura de bits con eficiencia. Después, ZSTD o Snappy tienen un flujo de bytes mucho más fácil de comprimir. Si ese mismo archivo guarda cadenas en crudo con codificación PLAIN, el códec tiene que trabajar mucho más y suele obtener peores resultados.
El mismo resumen de investigación indica que Parquet suele reducir drásticamente datos analíticos mixtos, y que ZSTD normalmente supera a Snappy en ratio de compresión mientras Snappy sigue siendo mejor que dejar los datos sin comprimir. También apunta que la codificación por diccionario combinada con bit-packing y RLE resulta especialmente eficaz en columnas de tipo entero y baja cardinalidad. Ese patrón coincide con lo que ven los ingenieros de datos en tablas de hechos y registros de eventos.
Combinaciones sensatas según la forma del dato
Deja que la forma de la columna guíe la elección.
Campos categóricos, códigos de país, valores de estado, tipos de producto: diccionario más ZSTD es un valor por defecto sólido.
Indicadores booleanos, columnas con muchos nulos, marcadores tipo partición dentro del archivo: las rutas afines a RLE suelen funcionar bien porque domina la repetición.
Marcas de tiempo ordenadas, números de secuencia, contadores monótonamente crecientes: las codificaciones delta pueden recortar la carga útil antes de que actúe ningún códec.
Rutas de consulta interactiva donde el tiempo de CPU cuenta: Snappy sigue siendo popular porque el coste de decodificación es predecible.
Conjuntos de archivo donde el coste de almacenamiento pesa más que la velocidad de escritura: ZSTD, GZIP o a veces Brotli pueden merecer la CPU extra.
El error habitual es aplicar una política global de códec y dar el trabajo por terminado. Una tabla con UUIDs, agentes de usuario, precios, booleanos y horas de evento contiene cinco problemas de compresión distintos.
Dónde los valores por defecto siguen quedándose cortos en 2026
Esta es la parte que muchas explicaciones de Parquet se saltan.
Los valores por defecto de Parquet siguen siendo desiguales en dos tipos de columna que aparecen constantemente en sistemas reales: cadenas de alta cardinalidad y valores en coma flotante. La codificación por diccionario pierde su ventaja cuando casi toda cadena es distinta, como ocurre con URLs, identificadores de petición, agentes de usuario y atributos de texto largo. Los flotantes tienen otro problema. Los códecs de propósito general pueden reducirlos, pero los patrones de bytes suelen ser lo bastante ruidosos como para que las ganancias sean menores de lo que los equipos esperan.
Esa brecha es una razón importante de que la conversación de 2026 alrededor de Parquet se haya desplazado hacia trabajos más recientes como FSST para cadenas y ALP para datos en coma flotante. La cuestión no es que el Parquet actual esté roto. La cuestión es que las codificaciones por defecto siguen dejando dinero sobre la mesa en telemetría, registros, métricas, salidas de modelos, precios y porcentajes. Un buen resumen de esa dirección aparece en la discusión sobre FSST y ALP para codificaciones de Parquet.
El soporte de los lectores sigue decidiendo qué puedes usar con seguridad. Las codificaciones en vista previa o recién añadidas pueden mejorar el tamaño de archivo en los benchmarks, pero un pipeline de producción se hace una pregunta más dura: ¿podrán Spark, Trino, DuckDB, tu trabajo de ingesta y tus herramientas de recuperación leer los archivos igual el mes que viene?
Qué marca de verdad la diferencia en producción
Tres decisiones suelen pesar más que los debates sobre códecs en redes sociales.
Ajusta la codificación a la cardinalidad. La codificación por diccionario es excelente hasta que el diccionario crece tanto que deja de compensar.
Ordena o agrupa los datos antes de escribir cuando puedas. Mejores patrones locales de valores dan más material a delta, RLE, las estadísticas y la compresión.
Mide rutas de lectura completas, no solo el tamaño del archivo. Un archivo un 20 por ciento más pequeño no es una victoria si el coste de CPU eleva la latencia de los paneles o estira los SLA por lotes.
Otra concesión merece honestidad. El archivo más pequeño no siempre es el más barato de operar. Los equipos suelen ahorrar más con un archivo algo mayor que todos los motores decodifican rápido y con fiabilidad que con una elección agresiva de codificación que introduce riesgo de compatibilidad o fallos de lectura difíciles de depurar.
Evolución del esquema sin romper a los lectores posteriores
La evolución del esquema es donde las buenas prácticas con formatos de archivo Parquet salvan o traicionan a tu equipo. El formato es lo bastante flexible para admitir cambios, pero eso no significa que todo cambio sea seguro.
La mentalidad más segura es simple: añadir suele ser más fácil que mutar.
Cambios que suelen ser seguros
Estos cambios son manejables en general cuando tus lectores se comportan bien:
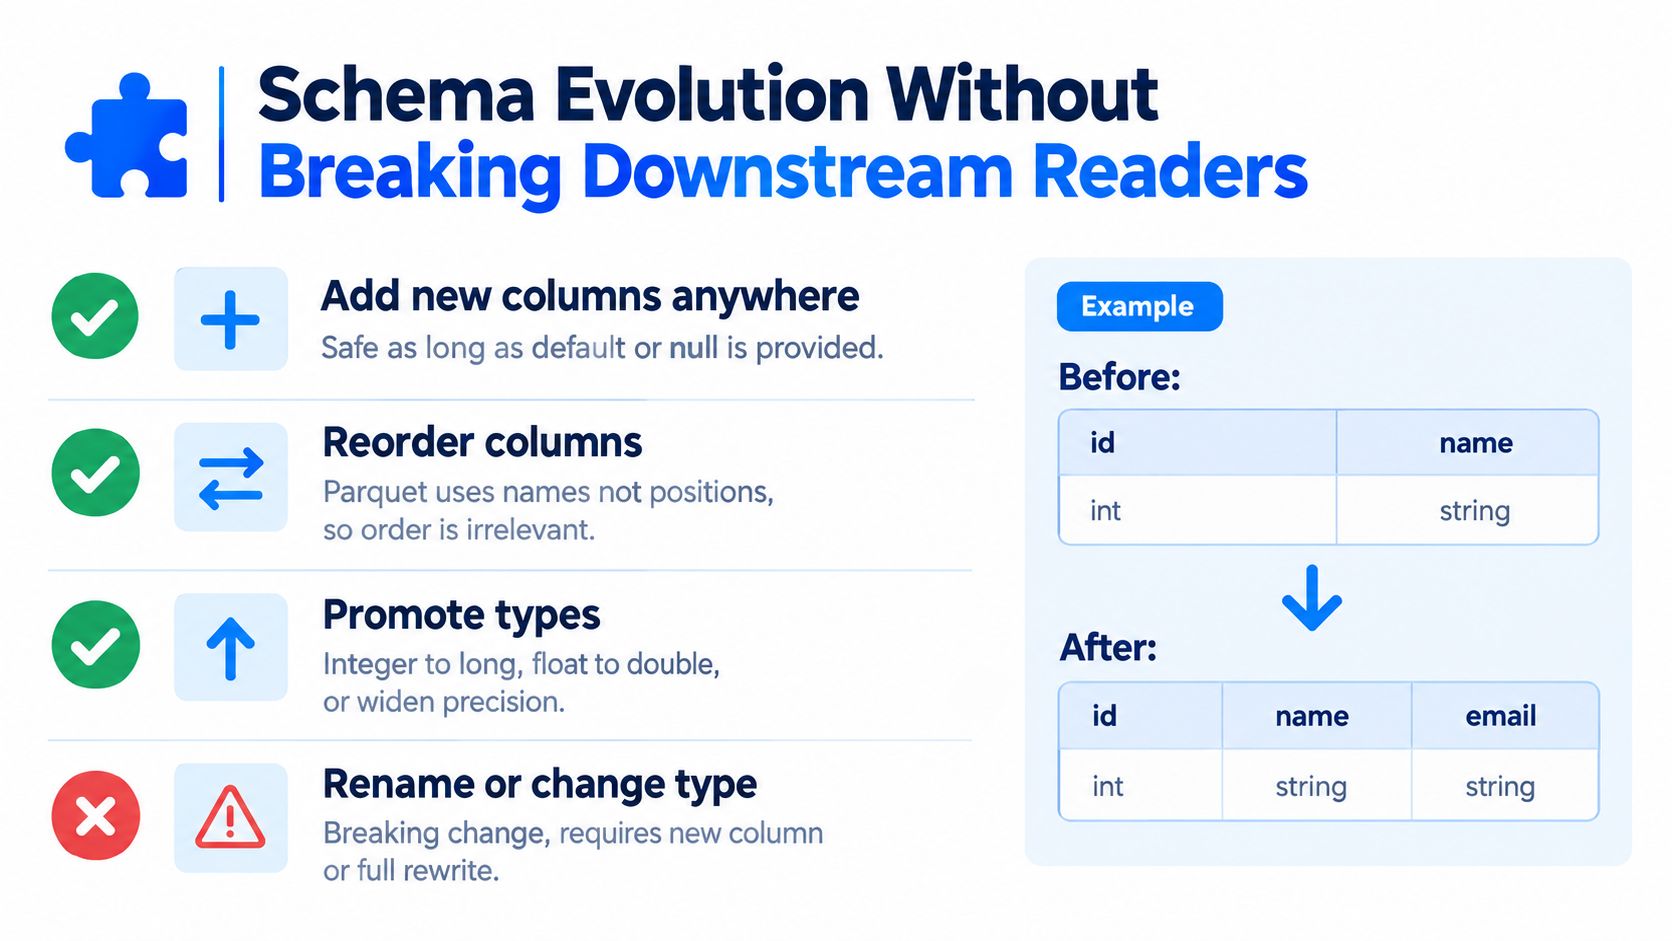
Añadir una columna nueva: los archivos antiguos no la tienen, así que los lectores suelen mostrar nulos o valores por defecto.
Reordenar columnas: los lectores usan por lo general los metadatos de esquema, no la posición visual en el archivo.
Ampliar un tipo: pasar de un tipo más estrecho a otro más amplio y compatible suele ser aceptable si el motor lo admite.
Esos patrones encajan con el modo en que Parquet guarda el esquema en metadatos en lugar de forzar una interpretación por posición. Aun así merecen pruebas, pero no son los cambios que suelen causar daño silencioso.
Cambios que provocan fallos silenciosos
Los renombrados son la trampa clásica. Para los lectores posteriores, un renombrado a menudo parece «quitar una columna y añadir otra». No se lanza ninguna excepción. Simplemente obtienes nulos donde antes había datos.
Los cambios de tipo pueden ser peores. Cambiar el significado lógico bajo el mismo nombre de campo puede producir valores que se parsean pero ya no significan lo mismo. Así es como los equipos acaban depurando filas «válidas» que ya no cuadran.
En los pipelines Parquet, los renombrados no son cosmética de metadatos. Son eventos de migración.
Hábitos que evitan la degradación de pipelines
Unos pocos hábitos operativos llegan muy lejos:
Congela los contratos de esquema fuera del código del escritor. Un registro, un contrato en repositorio o un proceso respaldado por catálogo es mejor que «lo que el trabajo emita esta noche».
Trata los renombrados como una migración en dos pasos. Añade el campo nuevo, rellena el histórico, actualiza los lectores y retira después el antiguo.
Valida la ampliación y la compatibilidad de tipos lógicos antes de publicar. Usa las mismas bibliotecas de lectura de las que dependen tus motores posteriores.
Monitoriza la deriva estructural de forma continua. Herramientas como Schema Tracker son útiles porque detectan columnas añadidas o eliminadas y modificaciones de tipo antes de que esos cambios se conviertan en incidencias de producción.
Si tu equipo maneja datos regulados o mucho consumo posterior compartido, la disciplina de esquema importa más que el ajuste fino de códecs. Los errores de compresión cuestan dinero. Los errores de esquema cuestan confianza.
Cómo se compara Parquet con ORC y Avro
Parquet, ORC y Avro resuelven partes distintas del ciclo de vida del dato. Los equipos se meten en problemas cuando piden a un formato que lo haga todo.
Avro está orientado a filas y encaja bien en las fronteras de ingesta. Parquet y ORC son columnares y encajan mucho mejor con las lecturas analíticas. En cuanto planteas la elección alrededor de la carga de trabajo en lugar de la lealtad a una marca, las concesiones se ven más claras.
Parquet, ORC y Avro de un vistazo
Criterio | Parquet | ORC | Avro |
|---|---|---|---|
Modelo de almacenamiento | Orientado a columnas | Orientado a columnas | Orientado a filas |
Mejor encaje | Analítica entre motores e intercambio en lakehouse | Entornos muy orientados al almacén, a menudo centrados en Hive | Streaming, búferes de mensajes, intercambio por filas |
Poda de columnas | Fuerte | Fuerte | Débil en comparación con los formatos columnares |
Predicate pushdown | Fuerte cuando hay estadísticas y están bien escritas | Fuerte | Limitado porque carece de estadísticas columnares al estilo de Parquet |
Gestión del esquema | Metadatos de archivo autodescriptivos | Metadatos de archivo autodescriptivos | Flujos sólidos centrados en el esquema |
Datos anidados | Soportado | Soportado | Soportado |
Amplia interoperabilidad de herramientas | Muy fuerte en los motores analíticos modernos | Fuerte, aunque a menudo más en pilas afines a ORC | Fuerte para flujos de ingesta y serialización |
Una regla práctica de decisión
Elige Avro cuando te importen las escrituras por filas, el intercambio de eventos y la ingesta gobernada por esquema. Es un buen formato de frontera.
Elige ORC cuando tu pila esté estrechamente alineada con motores y flujos que lo prefieren, sobre todo en entornos con convenciones de almacén asentadas.
Elige Parquet cuando la interoperabilidad amplia sea lo que más importa. Eso incluye motores mixtos, formatos de tabla abiertos, analítica ad hoc y conjuntos de lakehouse que muchas herramientas necesitan leer sin negociación.
La razón de que Parquet siga ganando ese terreno intermedio tiene menos que ver con una función estrella y más con la gravedad del ecosistema. Viaja bien entre lectores y, para la mayoría de equipos analíticos, eso importa tanto como la eficiencia bruta del archivo.
Buenas prácticas para pipelines Parquet fiables
Un pipeline Parquet suele fallar de formas corrientes. Una actualización del escritor cambia la codificación por defecto de una columna. Un trabajo de streaming emite miles de archivos de 5 MB durante la noche. Un campo nullable aparece como INT32 en un productor y como INT64 en otro. Nada parece dramático al escribir, pero a la mañana siguiente Trino escanea más datos de los esperados, Spark pierde el predicate pushdown en una partición y un modelo posterior empieza a leer nulos donde esperaba valores.
Esa es la realidad de producción para la que optimizar. La fiabilidad viene menos de un ajuste de archivo perfecto y más de hacer explícitos la disposición de archivos, las reglas de esquema y la compatibilidad de lectores.
La lista de comprobación operativa
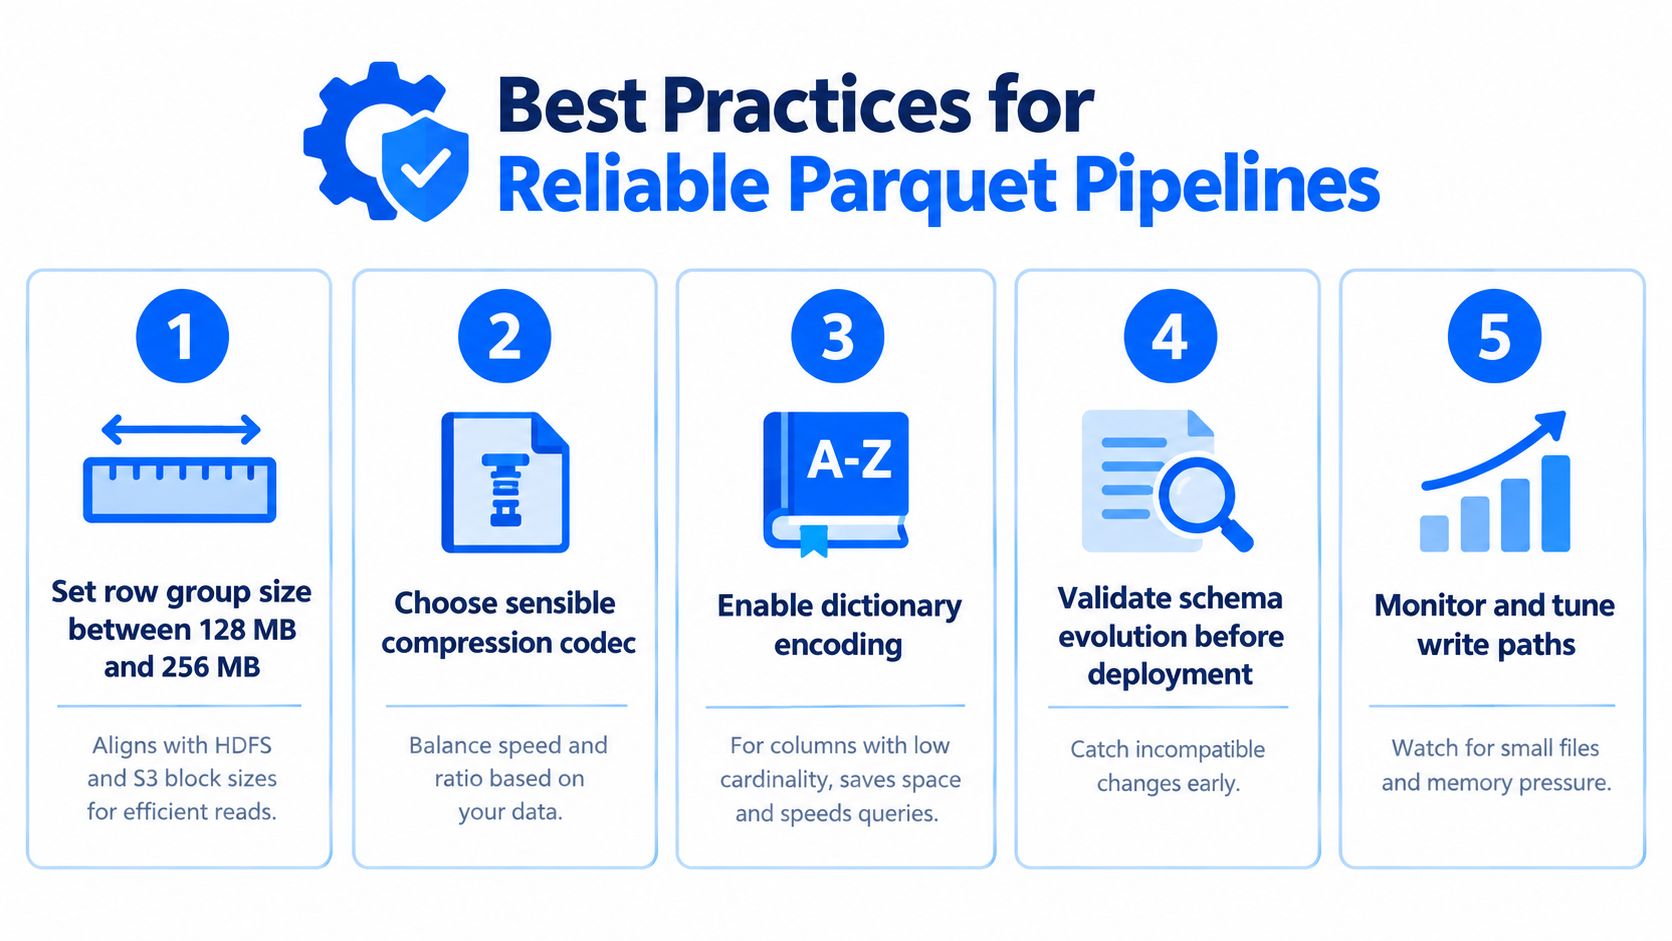
Elige los tamaños de row group a propósito. Muchos equipos empiezan en torno a 128 MB y ajustan según los patrones de escaneo, la presión de memoria y el comportamiento del almacén de objetos. Los row groups mayores pueden mejorar la eficiencia de escaneo, pero también amplían el radio del daño cuando las estadísticas son pobres. Los menores dan a los lectores más oportunidades de omitir datos, pero demasiados añaden sobrecarga de metadatos. Trata el tamaño de row group como la estantería de un almacén. Si cada caja es diminuta, pierdes tiempo manipulando cajas. Si cada caja es enorme, acabas abriendo contenedores llenos de datos que no necesitabas.
Frena pronto la proliferación de archivos diminutos. Es uno de los errores más comunes en pipelines Parquet. Los archivos pequeños desperdician tiempo de planificación, aumentan el trabajo de metadatos y reducen la eficiencia de lectura por igual en Spark, Trino, DuckDB y los almacenes en la nube. Si un sink de Kafka vuelca cada pocos segundos, convierte la compactación en un trabajo de primera clase y no en una ocurrencia tardía.
Ajusta las codificaciones a la forma real de la columna. Los valores por defecto suelen bastar para enteros y dimensiones comunes. Resultan mucho menos satisfactorios con cadenas de alta cardinalidad, identificadores largos y muchas columnas en coma flotante. Esta brecha importa más en 2026 porque los equipos guardan cada vez más embeddings, salidas de características e identificadores generados por máquina en Parquet, y la ruta de escritura por defecto sigue dejando dinero sobre la mesa para esas formas. La codificación por diccionario ayuda cuando la repetición es real. Ayuda mucho menos cuando casi todo valor es único.
Escribe datos que den una oportunidad a las estadísticas. El predicate pushdown depende de algo más que de «estadísticas activadas». Si una partición diaria contiene clientes, regiones y tipos de evento mezclados en cada row group, los valores mínimo y máximo se vuelven filtros débiles. Ordenar o agrupar antes de escribir suele aportar más a la eficiencia de omisión que cambiar el códec de compresión.
Trata la evolución del esquema como un cambio de API. Añadir una columna nullable suele ser de bajo riesgo. Renombrar un campo, cambiar la anchura numérica, alterar la semántica de marcas de tiempo o pasar de obligatorio a opcional puede romper lectores de formas sutiles. Valida los cambios de esquema antes del despliegue y pruébalos contra los motores que cuentan en producción, no solo contra la biblioteca de escritura. Una forma práctica de formalizar esas comprobaciones es integrarlas en tus buenas prácticas de pipelines de datos para validación, monitorización y control de cambios.
Prueba Parquet entre motores, no solo dentro de una pila. Un archivo que parece válido en Spark puede exponer casos límite en Trino, pandas, Arrow o un lector de almacén. Los tipos lógicos, los page indexes, el tratamiento de nulos y la interpretación de marcas de tiempo todavía varían lo suficiente como para que las pruebas entre lectores detecten errores reales de producción.
Las preguntas de producción que más importan en 2026
El ajuste de archivos sigue contando, pero dos asuntos merecen ahora más atención.
Primero, las codificaciones por defecto siguen siendo desiguales para las cargas modernas. Parquet sigue siendo excelente para muchas tablas analíticas, pero las cadenas de alta cardinalidad y los conjuntos con muchos flotantes suelen comprimirse y escanearse con menos eficiencia de la que los ingenieros esperan. Si tu lago guarda características de modelos, identificadores de telemetría o dimensiones semiestructuradas desplegadas en columnas, mide los ajustes del escritor sobre tus propios datos en lugar de confiar en los valores por defecto.
Segundo, el retraso de compatibilidad es real. Que una función entre en la especificación es solo la línea de salida. Se vuelve operativamente segura cuando tus lectores, validadores y herramientas de catálogo la interpretan igual. Por eso el trabajo fiable con Parquet incluye pruebas de versión, comprobaciones de diferencias de esquema y observabilidad. digna es una de las opciones que usan los equipos para esa capa operativa: monitoriza cambios de esquema, Timeliness, anomalías y señales de validación dentro del entorno del cliente.
Los problemas de fiabilidad de Parquet rara vez se quedan en el almacenamiento. Aparecen más tarde como escaneos más lentos, deriva silenciosa de tipos, paneles rotos y modelos entrenados con la forma equivocada de datos.
El tamaño de los row groups y la elección de códecs derivan a medida que cambian los escritores, así que acompaña estas prácticas con observabilidad de plataforma de datos que avise cuando la disposición de los archivos deje de coincidir con la guía.
Preguntas frecuentes
¿Qué tamaños de row group y de página recomienda Parquet?
La guía de configuración de Parquet recomienda row groups grandes y páginas pequeñas, con ejemplos como row groups de 512 MB a 1 GB y páginas de 8 KB, asumiendo una disposición alineada con HDFS. Muchos equipos en almacenamiento de objetos empiezan más cerca de 128 MB y ajustan según los patrones de escaneo, la presión de memoria y el comportamiento del almacén.
¿Cuál es la diferencia entre Parquet versión 1 y versión 2?
La especificación ha pasado por varias versiones, pero la pregunta práctica es qué capacidades implementan realmente tus lectores y escritores, no qué número de versión persigues. Para entornos mixtos con Spark, DuckDB, Trino y BigQuery, el terreno seguro sigue siendo la proyección de columnas, las estadísticas de row group, las codificaciones estándar y los códecs mayoritarios.
¿Qué cambios de esquema rompen a los lectores Parquet posteriores?
Los renombrados son la trampa clásica. Para los lectores posteriores, un renombrado parece una columna eliminada más una nueva, así que no se lanza ninguna excepción: simplemente obtienes nulos donde antes había datos. Añadir columnas nullable es bastante seguro; los fallos silenciosos empiezan con los cambios de tipo y el anidamiento reestructurado.
¿Cómo mejoran el rendimiento los metadatos de página?
Recortan lecturas desperdiciadas dentro de un row group, no solo entre row groups. El lector parte del pie, decide qué row groups y columnas merece la pena abrir y luego usa las estadísticas de página para no decodificar páginas que no pueden cumplir el filtro. Eso importa más a medida que los archivos crecen y los filtros se vuelven selectivos.
¿Debería usar Parquet, ORC o Avro?
Elige por etapa del ciclo de vida y no por benchmark. Avro encaja con escrituras por filas, intercambio de eventos e ingesta gobernada por esquema, lo que lo convierte en un buen formato de frontera. Parquet y ORC apuntan ambos a escaneos analíticos, con Parquet generalmente por delante en amplitud de ecosistema. Los problemas empiezan cuando se pide a un formato que cubra todas las etapas.



