Eventos de Data Analytics explicados: del seguimiento a la confianza
|
7
minuto de lectura

Tienes un panel que parece tranquilo, el equipo sigue enviando código y, sin embargo, una mañana los números no coinciden exactamente con lo que ven ventas, producto y soporte. Ese es el peligro silencioso de los data analytics events. El código puede seguir ejecutándose, pero si el significado del evento se desvía, el panel puede seguir contando una historia que ya no coincide con la realidad.
Por eso, los eventos confiables no son solo un problema de seguimiento. Son un problema de Data Contract, y el contrato tiene que mantenerse firme entre ingenieros, analistas y el negocio. Si el modelo de eventos es impreciso, cada embudo descendente, modelo de atribución y pipeline de funciones hereda esa ambigüedad. Si el modelo es claro, es más fácil confiar en el resto del stack. Consulta la idea relacionada de datos confiables como datos válidos para comprender la mentalidad de calidad más amplia que respalda esa confianza.
Idea clave: un evento solo es útil cuando su significado se mantiene lo suficientemente estable como para que las personas y los sistemas puedan confiar en él.
El camino práctico es sencillo, aunque los detalles requieran disciplina. Primero, comprende qué es realmente un evento. Luego, diseña el modelo de manera que escale con los cambios del producto. Después de eso, elimina los modos de falla comunes que corrompen los datos. Finalmente, sigue validando el flujo como un contrato vivo, no como una lista de verificación de una sola vez.
Tabla de contenidos
Introducción Por qué los eventos de análisis construyen o destruyen la confianza
Qué son realmente los data analytics events y cómo funcionan
Las tres partes que importan
De la interacción sin procesar al pipeline de análisis
Diseño de un modelo de eventos que escale con tu producto
Comienza con categorías y luego nombra el evento de forma limpia
Decide qué campos son obligatorios
Errores comunes que corrompen los datos de eventos y cómo evitarlos
Patrones saludables versus no saludables
Atención a los errores de sincronización y zona horaria
Validación de la calidad de los eventos con contratos y señales observables
Cinco señales que revelan diferentes tipos de problemas
Las líneas base superan a los umbrales fijos para el tráfico con picos
Puesta en práctica de la Event Observability con digna
Construcción de data analytics events confiables a largo plazo
Introducción Por qué los eventos de análisis construyen o destruyen la confianza
Un panel puede parecer saludable mientras que el flujo de eventos que hay debajo ya ha comenzado a desviarse. Un gerente de producto ve el gráfico de registro. Un analista ve el mismo gráfico. Un ingeniero de datos revisa el pipeline y no nota nada roto. La trampa es que el sistema puede estar técnicamente "activo" mientras que el significado del evento ha cambiado lo suficiente como para distorsionar las decisiones.
Por eso, los data analytics events se encuentran en la base de casi todas las métricas que interesan a las personas. Alimentan embudos, vistas de retención, lecturas de experimentación, atribución de marketing, alertas operativas y funciones de ML. Cuando la definición del evento es difusa, cada equipo llena los vacíos de manera diferente, y esas diferencias no siempre aparecen hasta que alguien pregunta por qué dos informes no coinciden.
El campo en sí tiene raíces profundas. La IEEE International Conference on Data Science and Advanced Analytics (IEEE DSAA) se describe a sí misma como el principal foro de ciencia de datos, con el apoyo conjunto de IEEE, ACM, ASA y CCF como se describe en la descripción general del ecosistema de eventos de análisis. Ese tipo de respaldo institucional es una fuerte señal de que los eventos de análisis no son un tema secundario, sino parte de la infraestructura profesional central del campo.
El otro cambio es práctico. Las tasas de asistencia a eventos en entornos profesionales también muestran con qué frecuencia la participación en el mundo real difiere del número en la lista de registro. En un punto de referencia de 2026, los eventos presenciales suelen convertir entre un 60% y un 70% de las confirmaciones de asistencia (RSVP) en asistentes reales, los eventos virtuales en vivo convierten entre un 40% y un 50% de los registros en asistencia, y las conferencias académicas y profesionales presenciales a menudo experimentan una tasa de inasistencia del 30% al 40% fuente. Ese mismo patrón importa en el trabajo de análisis, porque los equipos también deben planificar la pérdida entre la intención y el comportamiento real de los datos.
Qué son realmente los data analytics events y cómo funcionan
Una forma útil de pensar en un evento es como un recibo de una acción. Un recibo dice qué sucedió, cuándo sucedió y el contexto suficiente para comprenderlo más tarde. Sin ese contexto, un recibo es solo un trozo de papel. En el análisis, un clic sin procesar, una vista, un envío o un error se vuelven útiles solo después de convertirse en datos de eventos estructurados.
Las tres partes que importan
Cada evento sólido necesita tres ingredientes. La Acción te dice qué sucedió, como una vista de página, un clic en un botón o el envío de un formulario. El Contexto te dice dónde y cómo sucedió, como la página, el dispositivo, el ID de usuario o la versión de la aplicación. El Tiempo te dice cuándo sucedió, lo cual es importante porque la sincronización a menudo cambia el significado del evento.
Regla práctica: si no puedes explicar la acción, el contexto y el tiempo en un lenguaje sencillo, el evento aún es demasiado impreciso como para confiar en él.
Esa estructura es la razón por la que el análisis basado en eventos funciona en todas las áreas de producto, marketing y operaciones. Un especialista en marketing puede observar el tráfico de la campaña. Un analista de producto puede inspeccionar un embudo. Un ingeniero puede rastrear una ruta de error. No están haciendo la misma pregunta, pero todos están leyendo la misma señal subyacente.
De la interacción sin procesar al pipeline de análisis
El viaje generalmente comienza con una interacción sin procesar en una aplicación o servicio. Esa interacción se captura como un evento, se envía a través de una capa de flujo o colección y luego llega a un almacén o lago de datos (lakehouse) donde los analistas y los modelos pueden usarla. La parte importante no es solo el movimiento, sino la consistencia del significado en cada paso.
La gente a menudo confunde los eventos con las entidades o las sesiones. Una entidad es aquello que te interesa, como un usuario o una cuenta. Una sesión es un período de actividad delimitado. Un evento es un único hecho observado. Si estos se confunden, los equipos comienzan a sobrecargar los campos y el modelo se vuelve difícil de extender.
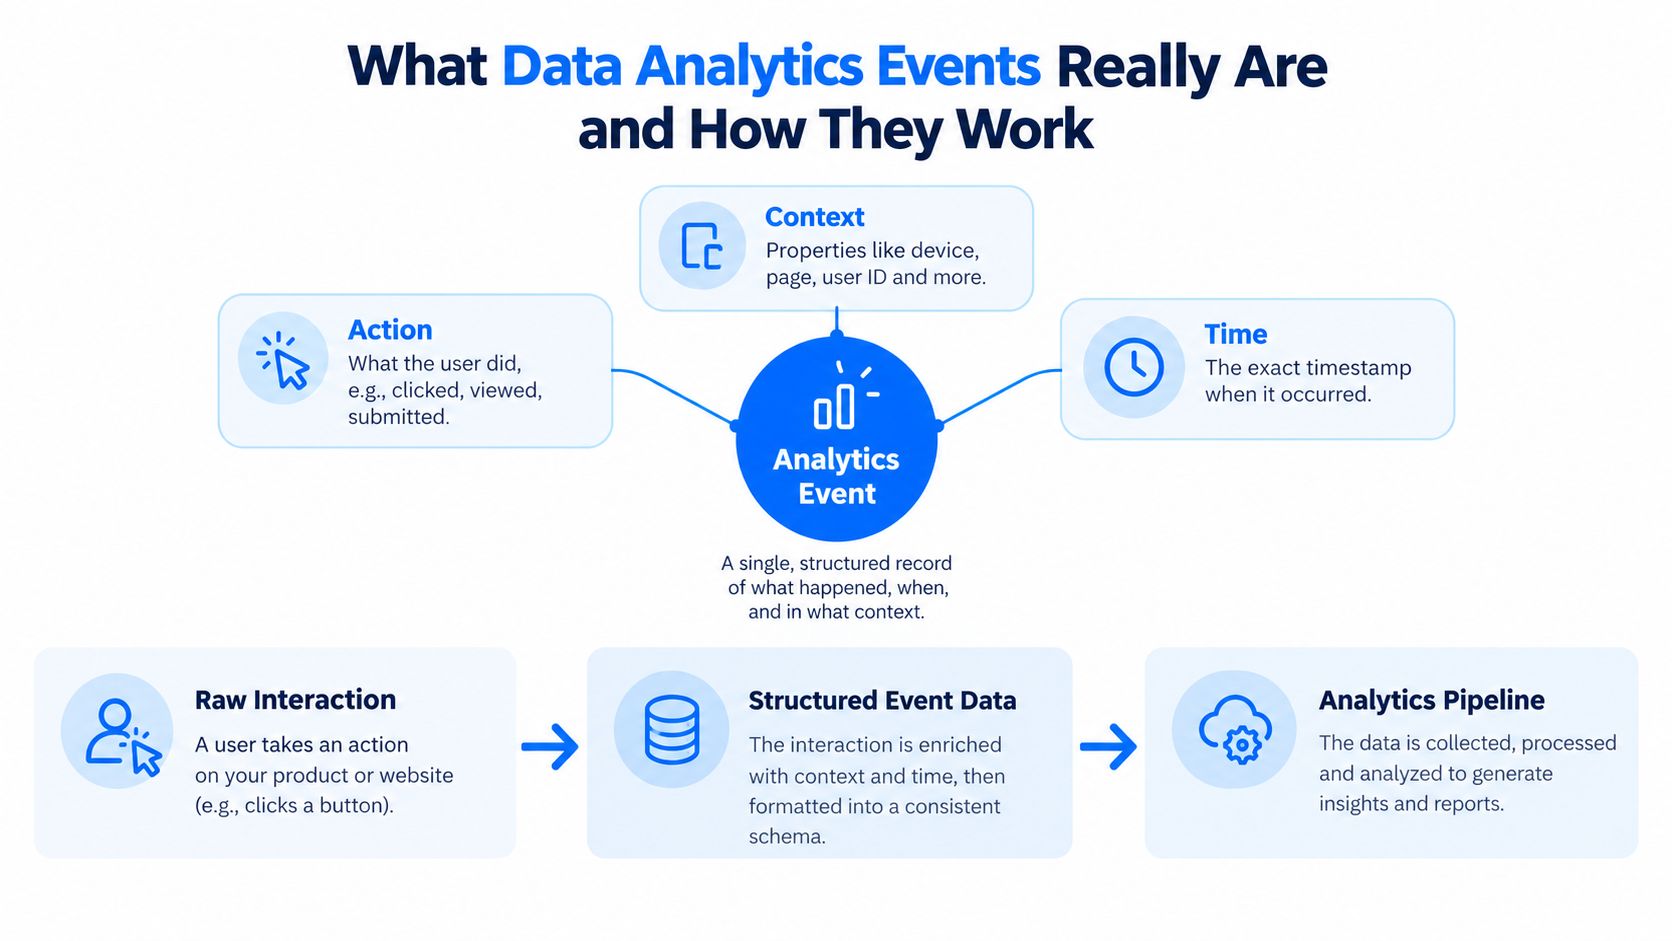
Cuando la semántica se mantiene estable, el trabajo descendente se vuelve más fácil. Los datos de eventos pueden respaldar paneles, experimentos, funciones de recomendación y monitoreo operativo sin que cada equipo invente su propia versión de la verdad.
Diseño de un modelo de eventos que escale con tu producto
Un modelo de eventos escalable comienza con la moderación. Los equipos a menudo quieren instrumentar todo a la vez y luego terminan con un catálogo repleto de eventos casi duplicados que nadie puede explicar seis meses después. Un mejor modelo mantiene la taxonomía pequeña, nombra las cosas con claridad y separa lo que sucedió de los detalles que lo rodean.
Comienza con categorías y luego nombra el evento de forma limpia
Una taxonomía duradera suele comenzar con categorías amplias como acciones del usuario y eventos del sistema. A partir de ahí, la convención de nomenclatura debe mantenerse consistente, a menudo en un estilo verbo_sustantivo como user_signed_up o invoice_failed. Ese patrón ayuda tanto a los humanos como a las máquinas a leer el evento sin tener que adivinar qué parte es la acción y qué parte es el sujeto.
La siguiente decisión es si un detalle pertenece a un nuevo evento o a una propiedad. Si la acción principal es la misma, pero un atributo cambia, mantenlo como una propiedad. Si la acción en sí cambia de significado, crea un nuevo evento. Esa separación evita que el modelo se convierta en una larga lista de casos especiales.
Decide qué campos son obligatorios
Cada evento debe tener una lista corta de campos obligatorios que hagan que el registro sea utilizable. La identidad, la marca de tiempo y el contexto principal suelen pertenecer aquí. Las propiedades opcionales pueden agregar detalles, pero no deberían ser obligatorias para la interpretación básica, porque eso hace que la instrumentación sea frágil.
La resolución de identidad también requiere una reflexión deliberada. Un usuario puede aparecer primero como anónimo y luego como autenticado. Si el modelo no puede conectar esos estados de forma limpia, el análisis del embudo y los informes del ciclo de vida se vuelven ruidosos. El mismo evento puede seguir siendo técnicamente válido aunque sea analíticamente incompleto.
Para los equipos que desean una estructura orientada primero al almacén de datos, la idea se conecta estrechamente con la disciplina de las tablas de hechos y dimensiones. Los eventos actúan como los hechos, mientras que los campos contextuales ayudan a los analistas a segmentarlos de manera estable.

Los buenos modelos de eventos hacen que las preguntas futuras sean más fáciles de responder, no más difíciles de plantear.
La documentación importa tanto como la nomenclatura. El equipo de ingeniería necesita los detalles de implementación y los analistas necesitan definiciones en un lenguaje sencillo. Si ambos grupos pueden leer el mismo contrato, los cambios en el producto dejarán de crear interpretaciones sorpresa.
Errores comunes que corrompen los datos de eventos y cómo evitarlos
La mayoría de los problemas de eventos no parecen dramáticos al principio. El pipeline sigue funcionando. El panel sigue actualizándose. El problema es que los datos se vuelven menos honestos con el tiempo, y la corrupción tiende a aparecer en el análisis antes de aparecer en las alertas.
Patrones saludables versus no saludables
Patrón no saludable | Por qué perjudica | Patrón más saludable |
|---|---|---|
Nomenclatura inconsistente | Métricas divididas, uniones rotas, lectores confundidos | Nomenclatura estandarizada entre equipos |
Propiedades faltantes | Los analistas pierden el contexto y recurren a suposiciones | Campos obligatorios para un contexto crítico |
Propiedades sobrecargadas | Un campo significa demasiadas cosas | Eventos de propósito único y propiedades claras |
Disparo duplicado | Los embudos cuentan de más, la atribución se vuelve ruidosa | Deduplicación en la captura o ingesta |
Valores predeterminados implícitos | La coerción silenciosa oculta el comportamiento real | Valores explícitos y reglas documentadas |
El problema más difícil no suele ser la mala intención, sino la desviación. Un productor cambia el nombre de un campo, elimina una propiedad o comienza a enviar una forma diferente sin avisar al equipo descendente. Es por eso que el desvío de esquema rompe los pipelines de datos con tanta frecuencia, y por lo que el catálogo de eventos necesita una propiedad activa.
Atención a los errores de sincronización y zona horaria
Los errores de sincronización son fáciles de pasar por alto porque el evento sigue llegando. Solo que llega al contenedor equivocado, en el día equivocado o con una suposición de zona horaria incorrecta. Para las métricas operativas y el análisis de cohortes, eso puede distorsionar la historia sin romper la consulta.
Los eventos duplicados causan un tipo diferente de daño. Un usuario hace clic una vez, pero la plataforma lo registra dos veces. Un paso del embudo parece más sólido de lo que es. Una función del modelo se infla. La solución no suele ser más paneles, sino reglas de captura y lógica de validación más claras.
Regla práctica: si un campo puede significar dos cosas diferentes, divídelo antes de que se propague la ambigüedad.
El hábito de revisión más seguro es rastrear cada evento desde el productor hasta el panel de control y hacer una pregunta en cada paso: "¿Sigue significando lo mismo?" Si la respuesta cambia, el contrato necesita trabajo antes de que más consumidores confíen en él.
Validación de la calidad de los eventos con contratos y señales observables
Un evento de análisis de datos debe comportarse como un contrato con pulso. El acuerdo se establece antes de que nadie realice el envío, y luego el pipeline sigue comprobando si los eventos reales coinciden con él en producción. Esa mentalidad de contrato es sobre la que se basa la guía de Data Contracts.
Cinco señales que revelan diferentes tipos de problemas
La Observability moderna suele realizar un seguimiento de la frescura, calidad, volumen, esquema y linaje como se describe en el modelo de Observability. La frescura pregunta si los datos llegaron cuando se esperaban. La calidad pregunta si los valores y los tipos siguen teniendo sentido. El volumen comprueba si el recuento parece normal. El esquema comprueba si la estructura cambió. El linaje muestra de dónde provienen los datos y cómo se movieron.
Cada señal apunta a un modo de falla diferente. La frescura detecta entregas tardías o faltantes antes de que los paneles se desvíen, por lo que las ventanas de entrega deben coincidir con la forma en que el negocio utiliza los datos como se describe en la guía de Timeliness. El monitoreo de esquemas detecta campos agregados, eliminados, renombrados y cambios de tipo, que es exactamente lo que el monitoreo de desviación de esquemas debe revelar como se describe en la descripción general del monitoreo de esquemas.
Las líneas base superan a los umbrales fijos para el tráfico con picos
El tráfico de eventos rara vez se mantiene plano. Los lanzamientos, las campañas y los ciclos comerciales cambian la forma del flujo. Las líneas base dinámicas y conscientes de la estacionalidad funcionan mejor que los umbrales fijos para muchos flujos de eventos porque comparan el comportamiento actual con un período similar en lugar de asumir que todos los días deberían verse idénticos como se recomienda en las prácticas de detección de desviación de eventos.
La validación del contrato debe ocurrir lo antes posible, idealmente en la ingesta. Los cambios aditivos pueden ser seguros cuando preservan la compatibilidad con versiones anteriores. Los cambios disruptivos deben ponerse en cuarentena. Los campos sin procesar deben seguir estando disponibles cuando la coerción borraría el significado. Esa disciplina reduce las roturas silenciosas y evita que el ruido de las alertas se propague por el equipo como se describe en la guía de contratos de flujos de eventos.
Señal | Qué responde | Qué falla puede revelar |
|---|---|---|
Timeliness | ¿Llegó a tiempo? | Cargas tardías, entregas perdidas |
Data Validation | ¿Son válidos los datos? | Tipos incorrectos, valores no válidos |
Volume | ¿Es el recuento esperado? | Lotes faltantes, inundaciones de duplicados |
Schema | ¿Cambió la estructura? | Campos agregados, eliminados, renombrados |
Lineage | ¿De dónde vino? | Origen poco claro, transformación oculta |
El objetivo no es tener más reglas. Es hacer que el comportamiento de los eventos sea lo suficientemente visible como para que los analistas e ingenieros puedan confiar en los datos sin tener que leer cada línea de registro.
Puesta en práctica de la Event Observability con digna
Hacer operativa la calidad de los eventos significa tratar al pipeline como un sistema en vivo, no como un activo estático. Los equipos necesitan una forma de observar los tiempos de entrega, detectar cambios estructurales y sacar a la luz comportamientos inusuales sin tener que configurar una regla separada para cada conjunto de datos.
digna hace esto ejecutándose dentro del propio entorno del cliente y calculando las comprobaciones en la base de datos, de modo que los datos permanezcan en su lugar. Su conjunto de módulos incluye Timeliness, seguimiento de esquemas, Data Validation y Data Anomalies, con un panel compartido para ingenieros, analistas y partes interesadas de governance. Esa configuración es importante porque el mismo flujo de eventos a menudo tiene que servir para informes, alertas y entradas de modelos a la vez.
Para los equipos que desean una referencia operativa más amplia, la descripción general de Data Observability muestra cómo encajan esas piezas en los entornos de producción. La idea central es simple. Las comprobaciones de Timeliness verifican las ventanas de entrega esperadas. El seguimiento de esquemas detecta campos agregados o eliminados y cambios de tipo. La detección de anomalías puede aprender el comportamiento normal y revelar desviaciones sin reglas creadas a mano.
Esa combinación es especialmente útil cuando los equipos de producto realizan envíos frecuentes. Un cambio que parece inofensivo en una solicitud de extracción (pull request) aún puede alterar la forma del evento, retrasar una fuente de datos o alterar los recuentos descendentes. El monitoreo detecta el efecto donde importa, en la ruta real de los datos.
Si estás comparando herramientas operativas para sistemas con una gran carga de eventos, las herramientas de mercado de predicción de polybacktest son una referencia adyacente útil de cómo se manifiesta el pensamiento de Observability en otros flujos de trabajo basados en eventos. La lección general se traslada de forma limpia, porque los datos de los eventos se vuelven confiables cuando la calidad se mide continuamente, no cuando se asume después de la implementación.
Construcción de data analytics events confiables a largo plazo
Los eventos confiables no ocurren por accidente. Provienen de una cadena de decisiones, desde la primera definición de una acción hasta las comprobaciones que mantienen esa definición honesta a lo largo del tiempo. Si un eslabón es débil, todo el stack de análisis lo resiente.
La forma más sencilla de priorizar es hacer tres preguntas. ¿Qué eventos impulsan las decisiones más importantes? ¿Cuáles tienen más probabilidades de desviarse a medida que cambia el producto? ¿Cuáles carecen de un propietario claro? Corrige esos primero, porque esos son los eventos con más probabilidades de causar un daño analítico silencioso.
La propiedad importa tanto como las herramientas. Los ingenieros necesitan saber quién aprueba los cambios de esquema. Los analistas necesitan saber qué definiciones son estables. Los equipos de governance necesitan visibilidad sobre qué cambió y cuándo. Cuando esos roles están claros, la calidad de los eventos deja de ser el problema de todos y se convierte en un proceso gestionado.
La ganancia a largo plazo no es solo tener paneles más limpios. Es un análisis más rápido, menos retrabajo y más confianza cuando los equipos utilizan el análisis para guiar los sistemas de producto e IA. Si tu catálogo de eventos aún se siente frágil, audita las definiciones, ajusta los contratos y coloca la Observability en la ruta crítica antes de que la próxima desviación silenciosa llegue a producción.
Si deseas una forma práctica de hacer que los datos de eventos sean más fáciles de confiar, visita digna y revisa cómo su validación en la base de datos, el seguimiento de esquemas, el monitoreo de Timeliness y la detección de anomalías encajan en un solo flujo de trabajo operativo. Está diseñado para equipos que necesitan que los eventos de análisis confiables sigan siendo confiables a medida que los productos, los pipelines y los consumidores continúan cambiando.
Preguntas frecuentes
¿Qué es un evento de analítica de datos?
Un recibo de una acción. Todo evento sólido necesita tres ingredientes: la acción, el contexto y el momento. Si no puede explicar esos tres en lenguaje claro, el evento sigue siendo demasiado laxo para confiar en él, diga lo que diga el plan de tracking.
¿En qué se diferencia un evento de una entidad o una sesión?
Un evento registra que algo ocurrió en un instante, una entidad describe algo que persiste y una sesión agrupa actividad en una ventana. Confundirlos es un error de modelado habitual y explica por qué las métricas posteriores dejan de coincidir entre sí.
¿Cómo se deben nombrar y estructurar los eventos?
Empiece con contención. Construya una taxonomía duradera desde categorías amplias como acciones de usuario y eventos de sistema, y decida después de forma deliberada si un detalle nuevo merece un evento propio o una propiedad. Cada evento necesita además una lista corta de campos obligatorios que hagan usable el registro.
¿Por qué derivan los datos de eventos?
Porque el significado cambia más rápido que el código de tracking. Un evento sigue técnicamente presente mientras su semántica se desplaza por debajo, de modo que los paneles parecen tranquilos mientras los números dejan de cuadrar con lo que ven ventas, producto y soporte. Un evento solo sirve mientras su significado se mantiene estable.
¿Por qué exige reflexión la resolución de identidad?
Porque determina si los eventos sobre la misma persona llegan realmente a unirse. Decida los campos de identidad necesarios al diseñar el modelo en lugar de parchearlos después, y documente la decisión, porque aquí la documentación importa tanto como los nombres.



