Detección del desvío del modelo: Una guía práctica para 2026
|
8
minuto de lectura

Por lo general, no se nota la desviación del modelo cuando comienza. Los paneles permanecen en verde, el modelo sigue puntuando y la primera señal proviene de un usuario comercial que dice que las aprobaciones, autorizaciones o recomendaciones se sienten "extrañas" en comparación con el mes pasado. Para cuando alguien abre un ticket, el modelo a menudo ha estado funcionando con suposiciones obsoletas durante días, a veces más, y el equipo ya está depurando la capa equivocada.
Es por eso que la detección de la desviación del modelo tiene que comenzar como un problema de data observability. El modelo es solo una parte del sistema. Las entradas cambian, los esquemas se rompen, las etiquetas llegan tarde, la confianza cambia de manera imperceptible y la distribución de salida comienza a tambalearse antes de que aparezca una caída obvia en la precisión.
Tabla de Contenidos
Los cuatro tipos de desviación que realmente necesita distinguir
Construcción de la canalización de detección de extremo a extremo
Por qué las métricas de rendimiento detectan la desviación demasiado tarde
Líneas base, umbrales y enrutamiento de alertas que realmente funcionan
Cuando un modelo deja de funcionar silenciosamente
Un modelo de fraude puede parecer saludable durante semanas mientras el negocio sangra. Los paneles muestran un tráfico normal, el modelo sigue devolviendo puntuaciones y nadie ve nada alarmante hasta que un líder de pagos pregunta por qué un segmento de clientes familiar está siendo rechazado con más frecuencia de lo esperado. Esa es la parte dolorosa de la desviación. No siempre llega como un colapso, a menudo llega como un cambio en el comportamiento que los humanos notan antes que el monitoreo.
Un buen programa de desviación detecta ese cambio antes de que la queja llegue a Slack. El trabajo práctico no es solo vigilar la precisión, es vigilar el sistema que alimenta al modelo, las predicciones que emite y el tiempo de las etiquetas que eventualmente confirman si fue correcto. Esa es la diferencia entre un monitor de modelo y una capa real de data observability para ML.
Regla práctica: si un interesado nota la desviación antes de que lo haga la plataforma, la plataforma está monitoreando lo incorrecto.
El modelo mental útil es simple. La desviación de entrada aparece cuando cambian las distribuciones de características. La desviación de salida aparece cuando las distribuciones de puntuación o la confianza se mueven. La desviación de esquema aparece cuando las columnas cambian de forma, desaparecen o llegan tarde. El retraso de etiquetas oculta la verdad hasta mucho después de que la predicción se puso en marcha. Necesita los cuatro a la vista porque cualquiera de ellos puede romper la utilidad del modelo sin una caída dramática en los KPI habituales.
Es por eso que los equipos empresariales terminan tratando la detección de la desviación del modelo como parte de la canalización más amplia, no como un complemento exclusivo del modelo. Una vez que lo enmarca de esa manera, la solución se vuelve más clara. No solo vuelve a entrenar más rápido, sino que detecta el cambio ascendente más rápido, lo localiza más rápido y lo enruta al propietario adecuado más rápido.
Los cuatro tipos de desviación que realmente necesita distinguir
La desviación de datos, la desviación de concepto, la desviación de etiquetas y la desviación de características están relacionadas, pero no requieren la misma respuesta. En producción, mezclarlas hace perder tiempo. Un equipo puede pasar medio día volviendo a entrenar un modelo que necesita una corrección de esquema, o puede seguir ajustando características cuando la relación subyacente ha cambiado.
Comience con la desviación de datos
La desviación de datos es la más fácil de detectar y ante la que es más fácil reaccionar de forma exagerada. Significa que la distribución de entrada cambió, mientras que la tarea comercial puede seguir siendo la misma. Un modelo de riesgo crediticio podría ver un cambio en los rangos de ingresos de los solicitantes después del lanzamiento de un nuevo producto, o un modelo de abandono podría ingerir más usuarios móviles después de un cambio en la combinación de canales. El modelo no está necesariamente equivocado todavía, pero su mundo ha cambiado lo suficiente como para que sus suposiciones ya no se sostengan.
Separe la desviación de concepto de la desviación de entrada
La desviación de concepto es la más difícil. La relación entre las entradas y el objetivo cambia, incluso si las entradas siguen pareciendo familiares. Un modelo de fraude puede seguir viendo los mismos patrones de transacciones, pero los delincuentes cambian de táctica, por lo que las señales antiguas dejan de predecir el fraude tan bien como solían hacerlo. Eso no es un problema de características. Es un problema con el mapeo aprendido en sí mismo.
Trate la desviación de etiquetas y la desviación de características de manera diferente
La desviación de etiquetas significa que el equilibrio de clases cambia. En un flujo de trabajo de crédito, la combinación de casos aprobados frente a rechazados puede moverse, y eso por sí solo puede distorsionar las métricas y los umbrales. La desviación de características es más estrecha, se trata de un cambio en una entrada específica, como un nuevo valor categórico, un rango numérico que se amplía o un campo faltante que antes no faltaba. La desviación de características a menudo proviene de problemas de datos ascendentes en lugar del comportamiento del modelo, razón por la cual la respuesta suele ser la reparación de la canalización, no el reentrenamiento.
Un punto de control útil es hacerse dos preguntas. ¿Cambiaron las entradas o cambió la relación? ¿Y el problema está en el modelo o en la ruta de datos que lo alimenta?
La distinción importa porque una ruptura de esquema, un pico nulo o una tabla retrasada pueden parecer una desviación en un panel de control incluso cuando la lógica del modelo está bien. Para una ruta de implementación concreta, la guía de detección de desviación de datos de digna es útil porque centra las señales operativas alrededor de la capa de datos en lugar de asumir que las etiquetas lo salvarán.
Elegir la Métrica Adecuada para Cada Señal
La mejor métrica depende de lo que esté observando y de qué tan rápido necesite actuar. En entornos regulados, los equipos suelen querer una estadística transparente vinculada a una línea base. En entornos de movimiento más rápido, a menudo necesitan una métrica que pueda ejecutarse continuamente en múltiples segmentos sin volverse ruidosa.
La base más antigua y aún más práctica es la prueba de hipótesis formal. Kolmogorov-Smirnov (KS) funciona bien para variables continuas porque compara la forma de las distribuciones en vivo y de referencia sin asumir normalidad. Chi-cuadrado es el ajuste natural para entradas categóricas, donde importa si la combinación de categorías cambió lo suficiente como para ser relevante. El Índice de Estabilidad de la Población (PSI) se usa ampliamente como una verificación de estabilidad basada en umbrales, y un PSI superior a 0.25 se trata comúnmente como una señal de advertencia fuerte Statsig sobre métodos de desviación y PSI.
Para distribuciones que son más complejas, la divergencia de Jensen-Shannon es una opción sensata, especialmente para salidas categóricas, incrustaciones (embeddings) o monitoreo del espacio de predicción. Es útil cuando le importa cómo difieren dos distribuciones de probabilidad, no solo si una sola característica cruzó una línea. La clave es no elegir una sola métrica y pretender que cubre cada señal.
Una sola métrica rara vez cubre todos los modos de falla. La pila correcta utiliza una estadística para la característica, otra para la salida y una tercera para el segmento donde más le importa al negocio.
Referencia rápida de métricas de desviación | Mejor para | Umbral de alerta común |
|---|---|---|
Índice de Estabilidad de la Población | Características continuas reguladas, comprobaciones de estabilidad de la línea base | 0.25 para una señal de advertencia fuerte |
Prueba de Kolmogorov–Smirnov | Distribuciones continuas, comparación no paramétrica | Use un umbral de valor p alineado con su política |
Prueba de Chi-cuadrado | Entradas categóricas, cambios en la combinación de categorías | Use un umbral de valor p alineado con su política |
Divergencia de Jensen-Shannon | Incrustaciones (embeddings), distribuciones de predicción, señales de mayor dimensión | Use un umbral de política basado en el comportamiento de referencia |
El valor predeterminado práctico es ejecutar múltiples estadísticas en paralelo en ventanas tanto cortas como largas. Las ventanas cortas detectan incidentes rápidamente. Las ventanas largas detectan el deterioro lento que no activa una verificación de un solo día. Si está decidiendo por dónde empezar, la guía de cómo describir la distribución de datos es un buen punto de referencia para pensar en qué forma de distribución está comparando.
Construcción de la Canalización de Detección de Extremo a Extremo
Una canalización de desviación en producción tiene cinco tareas, y cada tarea responde a una pregunta diferente. Primero, capturar las señales correctas. Luego computar perfiles. Luego comparar el comportamiento en vivo con una referencia. Luego alertar al equipo adecuado. Finalmente, forzar una respuesta, ya sea investigación, recalibración, reentrenamiento o una corrección de la canalización.
Capturar las señales que hacen visible la desviación
El conjunto mínimo de captura es sencillo, pero los equipos aún omiten partes de él. Necesita entradas del modelo, salidas, confianza de la predicción, marcas de tiempo y etiquetas de verdad fundamental cuando eventualmente lleguen. Si está monitoreando un flujo de trabajo de LLM, capture también prompts, respuestas, conteos de tokens, latencia y activaciones de barandillas (guardrails). Esas señales adicionales importan porque las fallas silenciosas en los sistemas generativos a menudo se muestran en el comportamiento, no en un solo número de precisión.
Calcular perfiles cerca de los datos
La capa de perfil debe comparar el comportamiento de producción con un perfil de referencia, no solo con una instantánea única. En la práctica, eso significa almacenar estadísticas de línea base y calcular métricas en vivo en las mismas familias de tablas a lo largo del tiempo. Desea este cálculo cerca de los datos, idealmente en el almacén de datos o lago, porque mover grandes conjuntos de datos a un almacén analítico separado crea demoras, sobrecarga de copia y más lugares donde la ruta de monitoreo puede fallar.
Ejecutar la detección de desviación en segmentos, no solo a nivel global
Los promedios globales ocultan fallas localizadas. Un modelo puede parecer estable en general mientras que una geografía, línea de productos o canal se está degradando. Es por eso que el monitoreo de producción necesita segmentación. Las ventanas cortas ayudan con los incidentes, las ventanas largas ayudan con el deterioro lento, y ambas deben desglosarse por los segmentos que importan para el negocio.
Alertar sobre la acción, no sobre el ruido
Las alertas deben estar vinculadas a una ruta de respuesta. Un cambio débil en las características puede pertenecer a un panel de control. Una ruptura repentina de la distribución puede merecer una llamada de alerta. Una falla de validación puede necesitar ir al propietario de ingeniería de datos, no al equipo de ML. La respuesta solo funciona cuando la señal llega a la persona que puede solucionar el problema subyacente.
Para los equipos que construyen esto en un entorno de plataforma, una herramienta como digna encaja naturalmente cuando el objetivo es calcular líneas base dentro del almacén de datos y combinarlas con verificaciones de anomalías, Timeliness, esquema y validación. Eso mantiene los datos residentes donde ya viven y brinda a los operadores un lugar para inspeccionar la tendencia, la frescura y el cambio estructural.
Por qué las Métricas de Rendimiento Detectan la Desviación Demasiado Tarde
A los equipos les encantan los gráficos de precisión porque les resultan familiares. El problema es que la precisión, la exhaustividad, la sensibilidad, F1, MAE, RMSE y AUC-ROC suelen ser señales descendentes, no advertencias tempranas. Si las etiquetas llegan tarde o de forma dispersa, la métrica le indica que el modelo está fallando solo después de que el impacto en el negocio ya ha comenzado.
Ese retraso es el problema operativo central. Un modelo puede continuar sirviendo predicciones mientras la verdad fundamental aún no está disponible. Para cuando es visible una caída significativa en el rendimiento, el modelo puede haber estado equivocado el tiempo suficiente como para afectar las aprobaciones, la detección de fraudes, las recomendaciones o el enrutamiento de servicios.
Verdad operativa: las métricas de rendimiento son herramientas de confirmación, no siempre herramientas de detección.
Es por eso que las señales proxy importan. Los cambios en la distribución de entrada pueden mostrarle que la población entrante cambió. Los cambios en la distribución de predicción pueden mostrarle que la confianza del modelo se movió incluso antes de que lleguen las etiquetas. Los despliegues en la sombra (shadow deployments) pueden exponer el comportamiento de forma comparativa. La calibración de la confianza puede mostrar que el modelo todavía parece seguro mientras se vuelve menos confiable. Esas aproximaciones no prueban que el modelo haya fallado, pero a menudo son la primera evidencia de que algo cambió.
La forma más útil de explicar esto internamente es tratar las banderas de desviación como pistas, no como pruebas de falla. Ese enfoque evita que el equipo reaccione de forma exagerada a cada pequeña fluctuación, al mismo tiempo que les da permiso para investigar antes de que el trabajo acumulado se convierta en un incidente comercial. En flujos de trabajo de alto riesgo, especialmente donde las etiquetas se retrasan o están incompletas, esa es la única postura que funciona de manera confiable.
Líneas Base, Umbrales y Enrutamiento de Alertas que Realmente Funcionan
Un programa de desviación genera confianza cuando sus líneas base coinciden con la realidad. Una línea base estática del período de entrenamiento es buena para el lanzamiento, pero a menudo envejece mal en sistemas en vivo. Una línea base de producción móvil es mejor para flujos de trabajo que evolucionan naturalmente. Las líneas base en modo sombra pueden ayudar cuando se está evaluando un modelo junto a uno existente, porque reflejan el tráfico actual sin contaminar la ruta de decisión principal.
El error que cometen muchos equipos es asumir que un único umbral estático puede cubrir todo. No puede. Los cambios repentinos merecen una escalada más rápida que el cambio lento. Una característica que cambia de forma gradualmente puede justificar una advertencia y una cola de investigación, mientras que un salto repentino de KS en un campo sensible puede necesitar un triaje inmediato. El umbral debe reflejar tanto la métrica como el contexto operativo.
Un modelo de enrutamiento por capas funciona mejor que una bandeja de entrada compartida. Enrute los problemas de esquema al propietario de ingeniería de datos. Enrute los cambios de confianza o de salida a la plataforma de ML o al equipo de modelado. Enrute la frescura y las cargas faltantes al propietario de la canalización. Esa división importa porque el primer nivel de respuesta no debería tener que adivinar dónde ocurrió la ruptura.
Si la alerta no designa a un propietario, no es una alerta. Es solo ruido con un mejor formato.
La forma más rápida de reducir la fatiga por alertas es hacer que la alerta sea lo suficientemente informativa como para acortar la primera investigación. Incluya el segmento afectado, la ventana de comparación, la métrica que se movió y la línea base de referencia. Luego, permita que el responsable decida si la solución es el reentrenamiento, la recalibración, la reparación de características o la transferencia a ingeniería de datos.
Análisis de Causa Raíz y Dónde Encaja la Observability
Una buena alerta de desviación debería conducir a una solución, no a un debate. Considere una característica de pago que de repente provoca un pico de KS. El equipo del modelo puede sospechar primero de la desviación de concepto, pero la causa real puede ser un cambio de esquema ascendente, como un campo cuyo tipo de datos se ha cambiado o una columna que admite valores nulos que de repente llega con valores inesperados. En ese caso, la solución correcta es la reparación de la canalización, no el reentrenamiento.
Un caso diferente parece más sutil. Una tendencia de PSI aumenta lentamente después del lanzamiento de un producto y el equipo ve un peor comportamiento del modelo en un subconjunto de tráfico. Eso a menudo apunta a un cambio en la combinación de clientes, no a un modelo roto. El modelo puede seguir siendo válido, pero su población de referencia ya no es representativa. Ahí es donde el contexto histórico importa, porque una tendencia sin historial es solo un punto en el tiempo.
El tercer patrón es la desviación de calibración. El modelo sigue devolviendo puntuaciones, pero las etiquetas retrasadas eventualmente muestran que la confianza ya no se ajusta a la realidad tan bien como solía hacerlo. Eso es un recordatorio de que el monitoreo debe manejar las etiquetas retrasadas con elegancia. Las señales proxy le brindan una advertencia temprana, mientras que las etiquetas eventuales confirman si la preocupación era real.
Una plataforma de data observability debería acelerar esta investigación exponiendo el seguimiento de esquemas para columnas agregadas o eliminadas, el monitoreo de Timeliness para llegadas faltantes o tardías, la detección de anomalías para cambios inesperados y vistas de tendencias históricas para el contexto. Ahí es donde digna encaja en la práctica, porque calcula líneas base y ejecuta comprobaciones de anomalías, Timeliness, esquema y validación dentro de la base de datos del cliente. El beneficio no es solo la privacidad, también es una ruta de triaje más limpia, ya que los ingenieros pueden inspeccionar la señal sin mover datos sensibles a otro sistema.
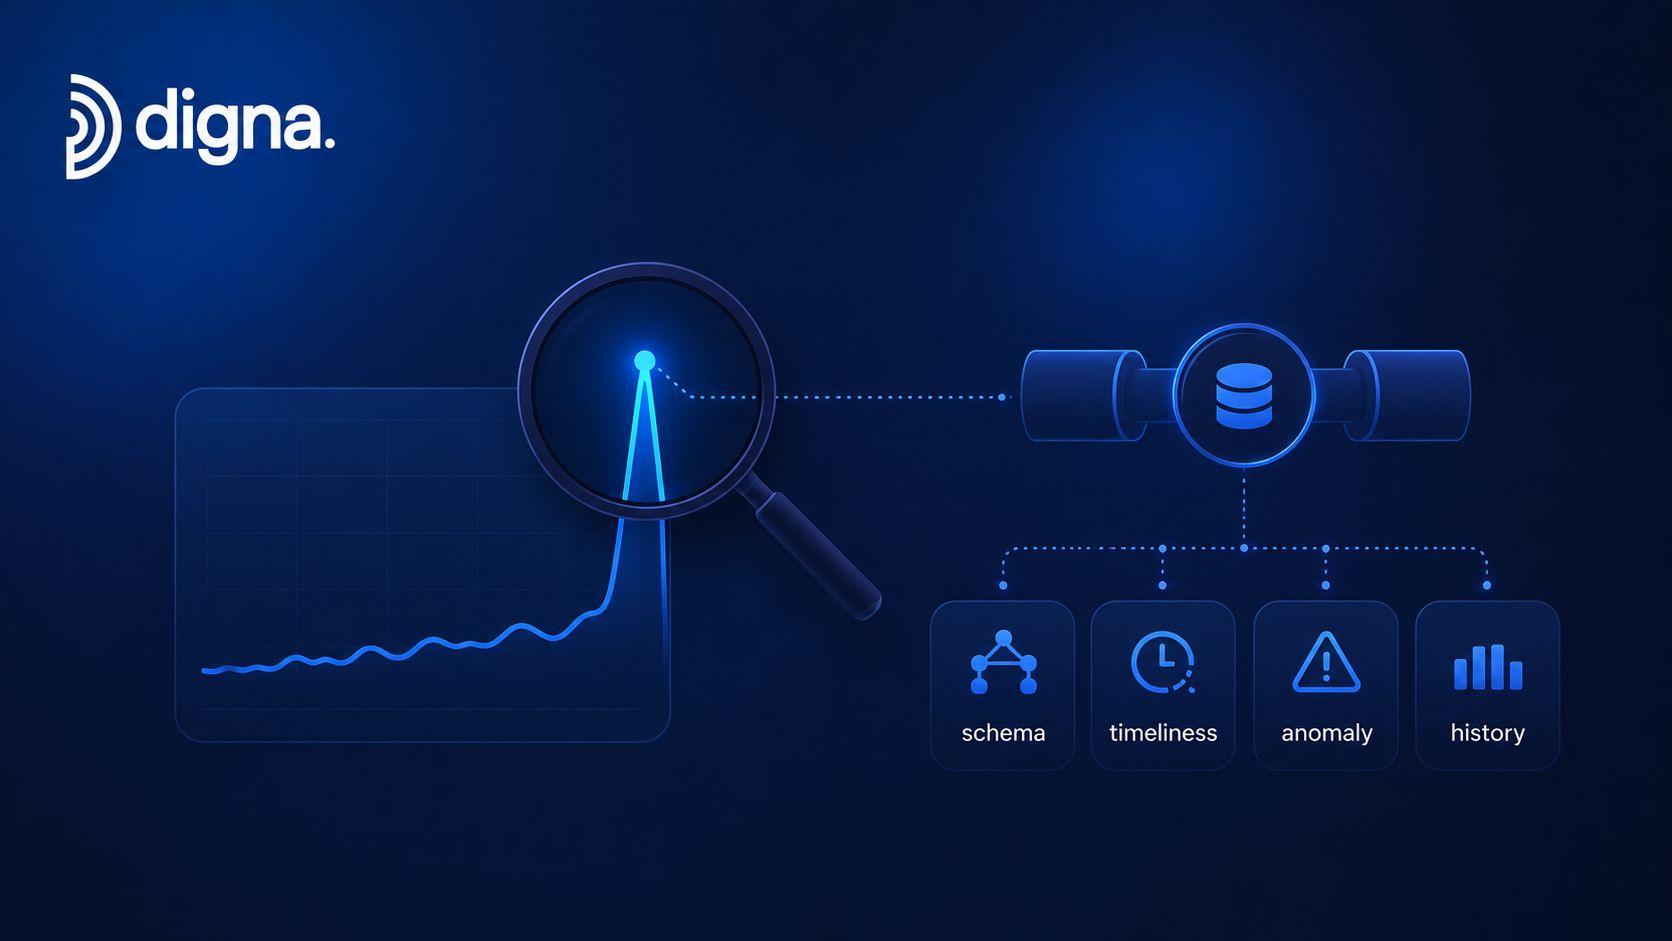
Si su equipo todavía está esperando etiquetas antes de investigar la desviación, el bucle de monitoreo ya es demasiado lento. Visite digna para ver cómo las líneas base nativas del almacén de datos, las comprobaciones de anomalías, el monitoreo de Timeliness, el seguimiento de esquemas y la validación pueden dar a sus sistemas de ML una señal de desviación más limpia y una ruta más rápida desde la alerta hasta la causa raíz.


