¿Qué es la deriva de datos y cómo detenerla?
|
5
minuto de lectura

Tienes un cuadro de mando que se veía bien el lunes, un modelo que pasó la validación el mes pasado y un interesado que pregunta por qué las cifras se sienten "raras" hoy. Así es como el data drift suele anunciarse, a través de un pronóstico roto, una recomendación extraña o un informe que ya no coincide con lo que los equipos sobre el terreno están observando.
La parte molesta es que nada tiene por qué "romperse" en el sentido evidente. Las canalizaciones pueden seguir ejecutándose, las tablas pueden seguir llenándose y el modelo aún puede devolver respuestas con confianza. El problema principal es que el mundo avanzó mientras tu pila de datos se quedó anclada en una versión anterior del mismo.
Cuando los buenos modelos salen mal: la amenaza silenciosa del Data Drift
Un modelo que se comportaba a la perfección en las pruebas puede empezar a tomar decisiones extrañas en producción, y el primer indicio no suele ser un mensaje de error en rojo. Es un equipo de ventas que cuestiona un cuadro de mando, un equipo de finanzas que concilia cifras que no cuadran o un responsable de operaciones que pregunta por qué la misma entrada produce ahora una decisión diferente. Esa brecha entre "ayer funcionaba" y "hoy no tiene sentido" es donde vive el data drift.
En la práctica, el data drift significa que las propiedades estadísticas de los datos de entrada cambian con el tiempo, por lo que la distribución de entrenamiento ya no coincide con las condiciones reales. Ese desajuste puede colarse en las capas de BI, los flujos de informes y las decisiones automatizadas, no solo en los resultados del aprendizaje automático. En España, esto se ha vuelto más difícil de ignorar porque el informe DESI 2022 de la Comisión Europea reveló que el 75% de las empresas ya contaban al menos con un nivel básico de intensidad digital, por encima de la media de la UE del 69% (Contexto del DESI 2022 para España).
Por eso el problema no es solo la calidad del modelo. Es la continuidad. Cuando la mayor parte de un negocio ya funciona con datos, un pequeño cambio en las transacciones, en el comportamiento de los clientes o en los patrones del esquema puede propagarse rápidamente por el resto de la pila. El riesgo aparece primero como confusión, luego como malas decisiones y, por último, como personas que pierden la confianza en las cifras.
Mantén la integridad del modelo con comprobaciones de calidad de datos
Regla práctica: si los interesados preguntan "¿por qué se ve mal esto?" antes de preguntar "¿qué tan preciso es el modelo?", ya te estás enfrentando a un problema de observability, no a un problema de modelado.
El problema del barco de Teseo para tus datos
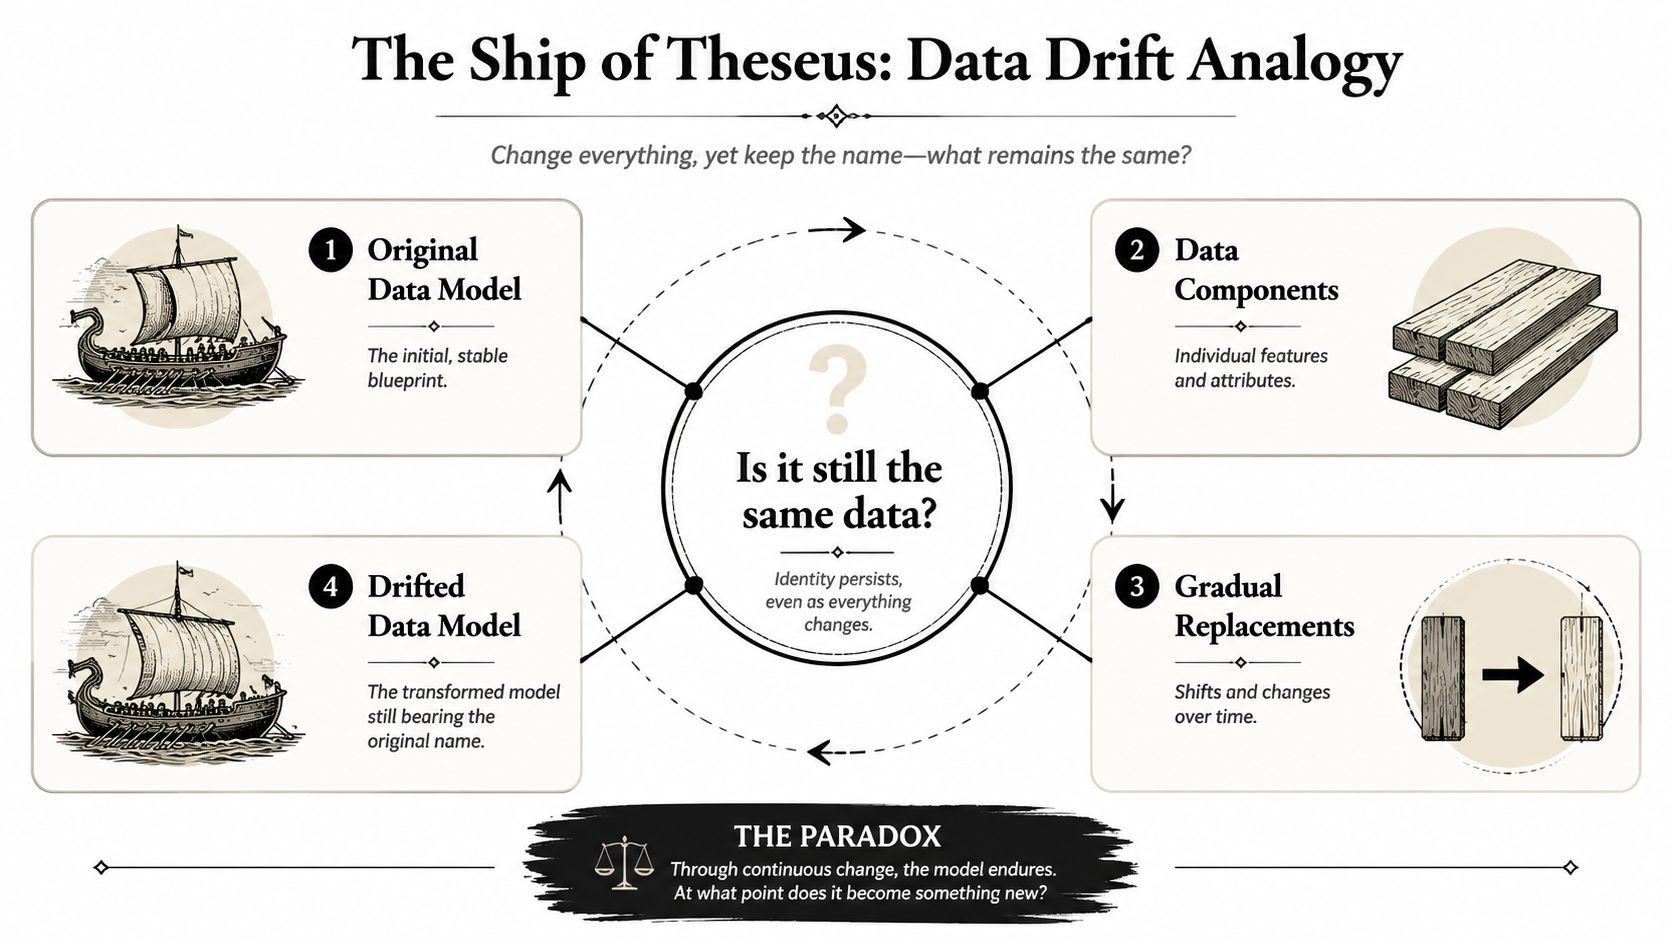
El data drift encaja bien con la paradoja del Barco de Teseo. Una canalización puede mantener el mismo nombre, las mismas tablas e incluso el mismo título de cuadro de mando mientras su contenido deja de coincidir poco a poco con los datos sobre los que se construyó. Una característica empieza a llegar con valores diferentes, otra llega tarde, una fuente reutiliza una etiqueta de categoría para algo ligeramente distinto y el conjunto de datos en tiempo real se convierte en un objeto diferente aunque nadie le haya cambiado el nombre.
Eso es lo que hace que el desfase sea difícil de detectar en producción. Por lo general, no se presenta como un único fallo evidente. Se introduce sigilosamente en forma de pequeñas sustituciones que parecen inofensivas por sí solas, pero que luego desplazan la distribución general lo suficiente como para cambiar el comportamiento de los informes, las alertas y los modelos. En la práctica, los equipos necesitan un monitoreo de desfases y comparación de distribuciones porque esperar a que se produzca un fallo empresarial visible significa que el desajuste ya se ha propagado por toda la pila.
El desfase lento y el cambio repentino no son lo mismo
El desfase lento se siente como ver moverse una línea de costa tras repetidas mareas. El cambio está ahí, pero solo se nota cuando se comparan los datos de hoy con el conjunto de referencia del mes pasado. Un cambio repentino se parece más al cierre de una carretera después de una tormenta. La ruta de ayer todavía existe en la memoria, pero ya no funciona en las operaciones reales.
El desfase lento suele aparecer en la combinación de clientes, los patrones de transacciones y el comportamiento estacional. Los cambios repentinos suelen proceder de un lanzamiento, un cambio normativo o una actualización del sistema de origen. El error consiste en tratar ambos casos como un único problema de precisión y esperar que un nuevo entrenamiento lo solucione todo a la vez.
En una infraestructura de informes europea, esa diferencia es importante más allá del propio modelo. Un cambio lento en un flujo de ingresos puede distorsionar los cuadros de mando financieros durante semanas antes de que alguien se dé cuenta. Un cambio repentino de esquema puede romper los informes de compliance, frustrar a los auditores y hacer que los equipos busquen un error falso en la capa de BI mientras el sistema de origen sigue avanzando. Una misma canalización puede parecer correcta sobre el papel y, sin embargo, ser errónea en los puntos donde se toman las decisiones empresariales.
Los cambios estructurales pueden romper tu canalización
Una etiqueta estable sobre datos inestables es una de las formas más sencillas de perder la confianza.
Los sospechosos habituales detrás de un desastre de Data Drift
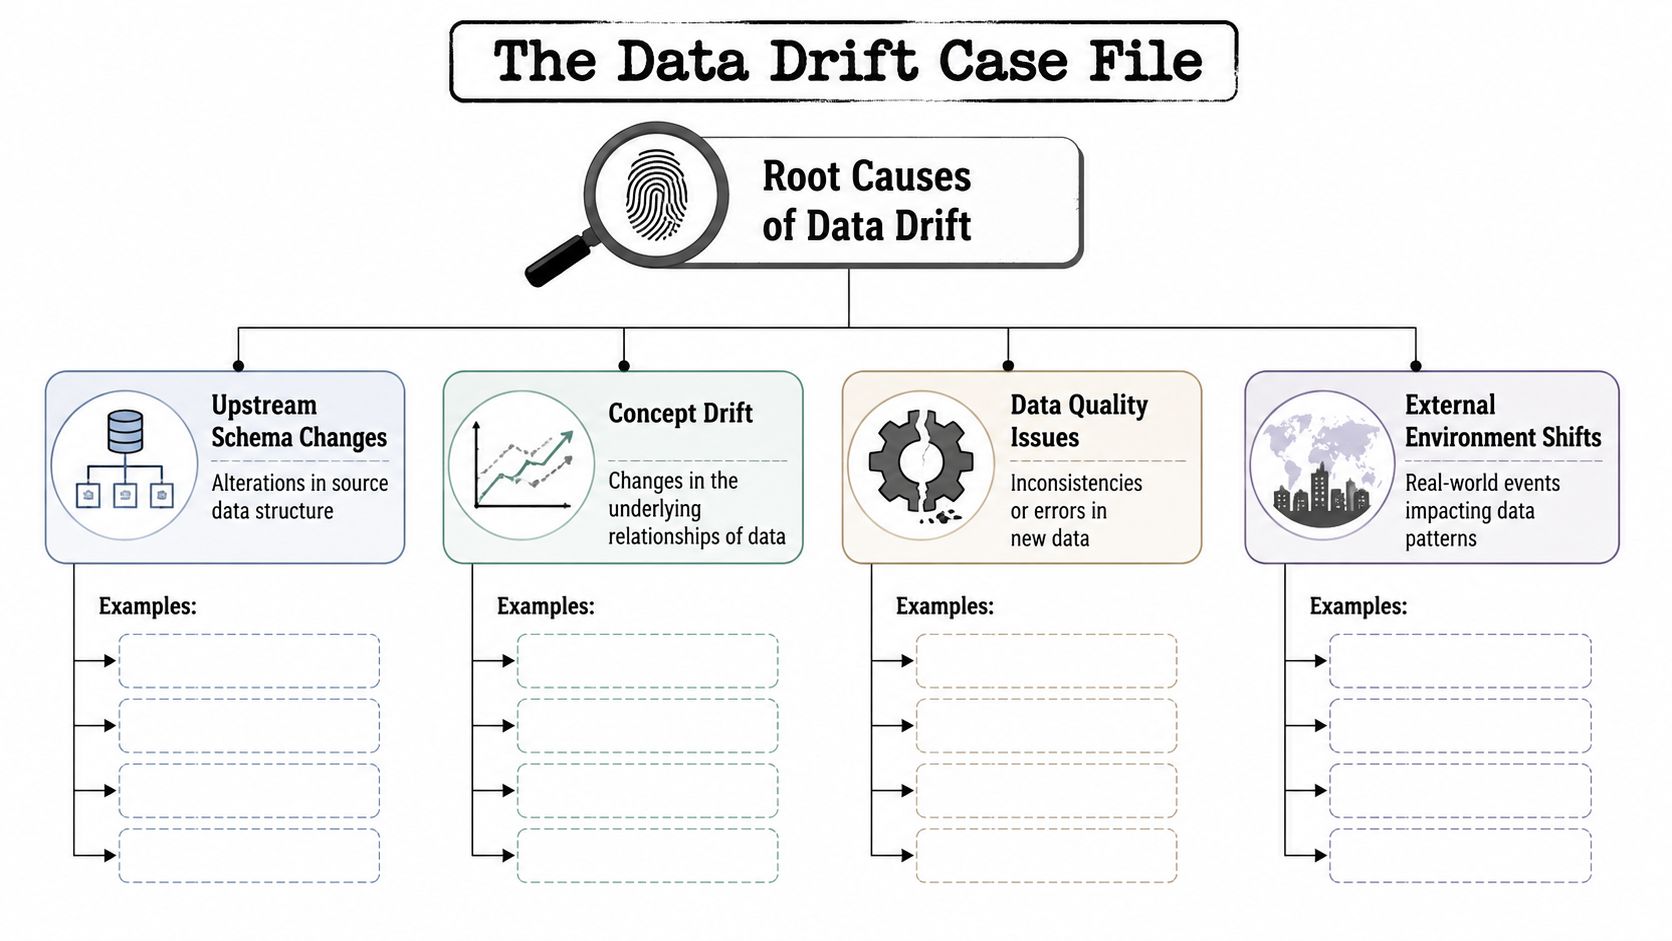
La forma más rápida de diagnosticar el desfase es observar por dónde suele entrar el cambio en el sistema. En las empresas españolas, esto importa más que en un entorno de demostración impecable, ya que la Oficina del Estado para la Estadística (INE) informó en 2024 que el 78,7% de las grandes empresas utilizan servicios de computación en la nube, lo que significa más piezas móviles, más dependencias y más lugares para que cambie el comportamiento (uso de la nube y riesgo de desfase en España). Una pila compleja no crea desfase por sí sola, pero le da más vías de entrada.
Cuatro lugares donde suele empezar el desfase
Cambios de esquema ascendentes: se cambia el nombre de una columna, cambia un tipo o desaparece un campo. Los cuadros de mando dejan de alinearse, las canalizaciones de características interpretan mal los valores y los informes se desvían de la verdad de origen.
Desfase de concepto (concept drift): la relación entre las entradas y los resultados cambia. Un patrón que solía señalar una cosa ya no significa lo mismo.
Problemas de calidad de datos: los valores faltantes, los registros duplicados, las cargas retrasadas y las entradas mal formadas distorsionan sutilmente tanto los análisis como las entradas del modelo.
Cambios en el entorno externo: el comportamiento del mercado, los cambios normativos y las interrupciones operativas alteran el ritmo de los datos sin previo aviso.
La razón por la que estas causas duelen tanto es que no solo afectan la precisión del modelo. Pueden romper los informes obligatorios, distorsionar la frescura del BI y hacer que los análisis orientados al cliente parezcan fiables cuando en realidad están obsoletos. En entornos con un uso intensivo de la nube, la fragilidad se reparte entre más servicios, programaciones y flujos de datos, por lo que los equipos deben pensar en términos de cadenas de dependencia, no solo de tablas.
Un hábito útil consiste en rastrear cada métrica rota hasta el primer sistema que cambió, no el último que falló. Ahí es donde suele residir la causa raíz.
Tu kit de herramientas de detective de Data Drift
Un detector de desfases hace bien un solo trabajo. Responde a si los datos en tiempo real aún coinciden con la línea de base, y lo hace antes de que un flujo obsoleto se convierta en un cuadro de mando roto, un informe engañoso o un problema de compliance. En una pila de informes europea, eso importa tanto para la frescura del BI como para la precisión del modelo.
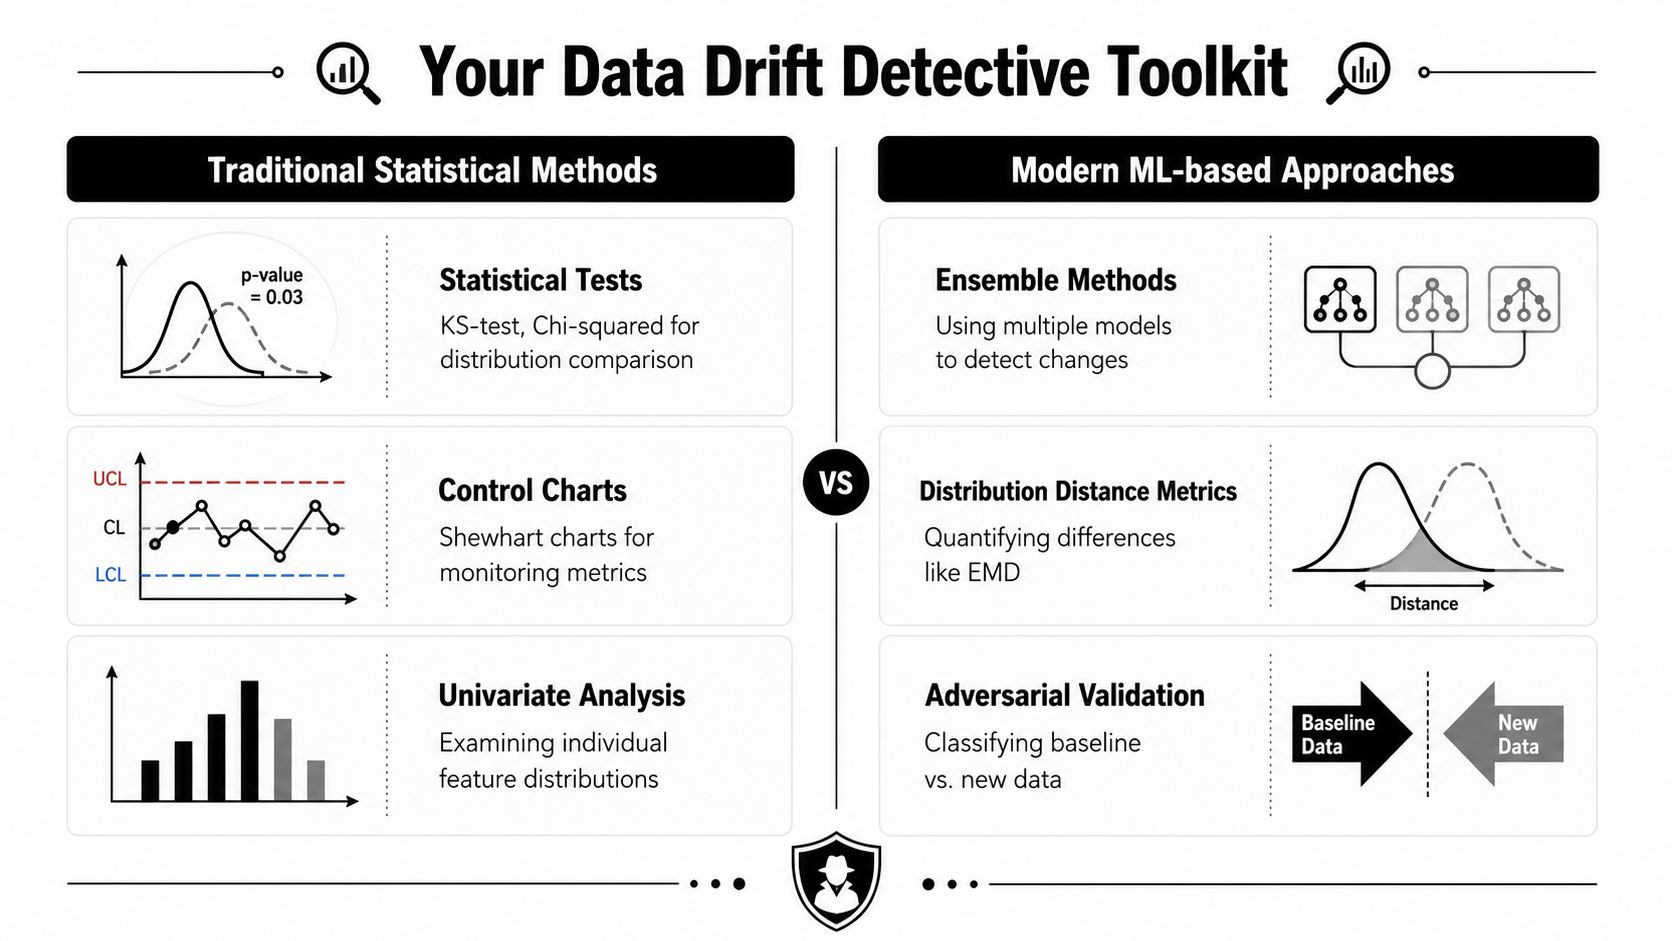
Los métodos estadísticos tradicionales siguen ganándose su lugar porque son claros y defendibles. Las herramientas modernas de observability añaden un monitoreo continuo, de modo que los equipos no tienen que esperar a que alguien note que un gráfico se ve extraño o a que se queje un consumidor descendente.
El aspecto estadístico
Las herramientas de la vieja escuela son directas, y por eso se mantienen en la caja de herramientas. La prueba de Kolmogorov-Smirnov compara dos distribuciones y muestra si difieren. La prueba de chi-cuadrado es adecuada para cambios categóricos. Las métricas de distancia, como la divergencia de Jensen-Shannon y el Índice de Estabilidad de la Población (PSI), ayudan a medir qué tan lejos se ha movido el lote actual respecto al conjunto de referencia (métodos comunes de comparación de desfases).
Estos métodos funcionan mejor cuando el equipo sabe qué campos importan y desea un umbral claro para actuar. Son menos útiles cuando el problema se encuentra dentro de un subgrupo, un archivo retrasado o una pequeña combinación de cambios repartidos en varias columnas. Una única puntuación de resumen puede pasar por alto ese tipo de desfase y, en la práctica, así es como un informe de aspecto limpio puede seguir siendo erróneo.
El aspecto de la Observability
Una plataforma como digna se adapta al lado operativo del problema. Puede aprender el comportamiento normal, realizar un seguimiento de las anomalías en la canalización y sacar a la luz los cambios estructurales sin pedirle a un analista que mantenga manualmente cada regla. Eso importa cuando la pila tiene demasiadas tablas, programaciones y consumidores descendentes como para inspeccionarlos uno por uno.
Regla práctica: utiliza pruebas estadísticas para la precisión, utiliza la observability para la cobertura. Si solo tienes una, algo se te escapará.
Los equipos más sólidos combinan ambos enfoques. Comparan los lotes con una línea de base, vigilan los cambios de distribución a nivel de características y controlan también la puntualidad y los cambios de esquema. De este modo, un archivo tardío, una mala unión y un cambio de distribución real no terminan en la misma alerta imprecisa. Para ver un ejemplo rápido de cómo el monitoreo de anomalías puede sacar a la luz los problemas antes de que se propaguen, consulta Detecta los problemas a tiempo antes de que se propaguen.
Cómo construir tu sistema de defensa contra el Data Drift
La defensa más sólida contra el desfase es aburrida, disciplinada y continua. Quieres Data Contracts claros, entradas versionadas, líneas de base monitoreadas y alertas que se activen ante cambios reales en lugar de ante cualquier fluctuación inofensiva. Si un equipo solo comprueba si hay problemas después de que un modelo empieza a fallar, ya es demasiado tarde para preservar la confianza en el resultado.
Diseña para toda la ruta de datos, no solo para el modelo
Comienza con contratos que definan cómo debe ser una buena entrada. A continuación, versiona los datos y el modelo juntos para poder saber si un cambio procede de la fuente o del algoritmo. Después de eso, añade un monitoreo que vigile tanto el contenido como los tiempos, porque un archivo retrasado puede perjudicar a un cuadro de mando tanto como uno mal formado.
La segmentación es importante en este caso. Un cambio puede existir en una línea de producto o en una cohorte de clientes concreta mientras que las métricas agregadas siguen pareciendo correctas, y así es exactamente como se cuela la falsa confianza. El monitoreo en la sección correcta de los datos reduce los falsos negativos y ayuda a dirigir la solución a donde corresponde (detección de desfases con segmentación).
Mantén las alertas útiles
La fatiga por alertas destruye la observability más rápido que el desfase. Si cada pequeña fluctuación activa la misma gravedad, la gente deja de prestar atención. Una buena configuración distingue entre cambios de esquema, problemas de sincronización y cambios de distribución reales, y luego dirige cada uno al propietario adecuado.
Los Data Contracts convierten la calidad en una expectativa compartida
Utiliza el monitoreo para reducir el radio de impacto. Es más barato ignorar una alerta ruidosa que descubrir tarde un fallo silencioso.
Convertirse en un equipo de datos vigilante
Para las organizaciones en España y en toda la UE, el desfase no es solo una molestia de ingeniería. Afecta al compliance, a los informes y a la resiliencia operativa, ya que el RGPD, aplicado por autoridades como la AEPD, exige que los datos sean exactos e íntegros (expectativas de exactitud e integridad del RGPD). Si los registros, los esquemas o los patrones de entrega sufren variaciones sin que nadie lo note, los datos inexactos pueden propagarse a la elaboración de perfiles, los informes y las decisiones automatizadas antes de que alguien tenga la oportunidad de detectarlo.
Por eso, la mentalidad adecuada no es "monitorear el modelo". Es "proteger el entorno de datos". El modelo es solo un consumidor de ese entorno. Finanzas, BI, compliance y operaciones dependen de las mismas señales, y un cambio silencioso en esas señales puede convertirse en un problema de negocio mucho antes de convertirse en un fallo de modelado.
Utiliza la lista de comprobación de fiabilidad para reforzar tus controles
Un equipo de datos vigilante trata el data drift como un problema de continuidad, no como una tarea secundaria para MLOps. Vigila los cambios en la distribución, realiza un seguimiento de las revisiones, comprueba la frescura y mantiene clara la propiedad cuando algo cambia. Esa es la diferencia entre los sistemas que simplemente funcionan y los sistemas en los que la gente puede seguir confiando en un mal día.
Reserva una Demostración Personalizada y descubre cómo digna Schema Tracker monitorea continuamente tus tablas configuradas en busca de adiciones, eliminaciones, cambios de nombre y cambios de tipo de datos en las columnas.
Preguntas frecuentes
¿Qué es el data drift?
El data drift es un cambio en las propiedades estadísticas de los datos de entrada a lo largo del tiempo, de modo que la distribución de entrenamiento ya no coincide con las condiciones reales. El artículo subraya que va más allá del machine learning: el desajuste puede llegar a capas de BI, flujos de reporting y decisiones automatizadas mientras los pipelines siguen funcionando con normalidad.
¿Qué causa el data drift?
La mayor parte del drift procede de cuatro fuentes: cambios de esquema aguas arriba, como una columna renombrada o un tipo modificado; concept drift, cuando las entradas se relacionan de otra forma con los resultados; problemas de calidad de datos, como valores ausentes o cargas retrasadas; y cambios externos en mercados, normativa u operaciones. Rastree una métrica rota hasta el primer sistema que cambió.
¿Cómo se detecta el data drift con pruebas estadísticas?
La prueba de Kolmogorov-Smirnov compara dos distribuciones, la prueba chi-cuadrado sirve para cambios categóricos y métricas de distancia como la divergencia de Jensen-Shannon y el Population Stability Index (PSI) miden cuánto se ha alejado un lote de su conjunto de referencia. Funcionan mejor cuando se sabe qué campos importan y se buscan umbrales claros.
¿Cuál es la diferencia entre un data drift lento y un cambio repentino?
El drift lento se acumula poco a poco, a menudo en el perfil de clientes, los patrones de transacciones o el comportamiento estacional, y solo se aprecia al comparar los datos de hoy con el conjunto de referencia del mes anterior. Un cambio repentino suele seguir a un release, un cambio regulatorio o una actualización del sistema de origen. El error habitual es tratar ambos como un único problema de precisión que se resuelve reentrenando.
¿Basta con reentrenar el modelo para frenar el data drift?
No. El artículo recomienda una defensa basada en contratos de datos, versionado conjunto de datos y modelo, monitorización del contenido y de los tiempos, y controles por segmento, ya que un cambio puede ocultarse en una línea de producto mientras los agregados parecen correctos. Combine pruebas estadísticas para la precisión con observabilidad para la cobertura y dirija cada alerta al responsable adecuado.



