Datos históricos de Snowflake: Time Travel y Fail-Safe
|
9
minuto de lectura

A las 3 de la mañana, un trabajo automatizado trunca una tabla de clientes en lugar de cargar su siguiente partición. Para cuando llega el equipo, los paneles están en blanco, los modelos de flujo descendente están fallando y nadie se pone de acuerdo sobre si el daño comenzó con la carga, la transformación o un script de limpieza. Los datos históricos de Snowflake pueden convertir ese incidente en una recuperación controlada, pero solo cuando el equipo sabe qué historial aún existe, qué objetos están protegidos y si la copia disponible se puede consultar o es solo para recuperación.
La suposición más peligrosa es que cada tabla de Snowflake tiene automáticamente la ventana de Time Travel anunciada de 90 días. Los objetos permanentes se pueden configurar para esa duración en la edición adecuada, pero los objetos temporales y transitorios tienen límites mucho más estrechos. Por lo tanto, los datos históricos son más que una función de SQL. Es una decisión de diseño que involucra recuperación, Observability, evidencia de auditoría, almacenamiento y el ciclo de vida del objeto.
Tabla de contenidos
Cuando los datos históricos salvan su entorno de producción
A las 2 de la mañana, una carga fallida reemplaza registros de clientes válidos con valores nulos. El ingeniero de guardia detiene el proceso de escritura, verifica si la tabla aún tiene un historial utilizable y captura el incidente antes de que otro reintento cambie la evidencia. Una consulta histórica puede mostrar el último estado conocido como bueno, mientras que un clon le brinda al equipo una superficie de recuperación separada. La producción permanece disponible mientras se investiga el fallo.
Ese resultado depende de la preparación. El Time Travel de Snowflake preserva los estados anteriores de las tablas y admite operaciones históricas de SELECT, clonación y UNDROP dentro de la ventana de retención configurada. El período estándar es de 1 día, mientras que las bases de datos, esquemas y tablas permanentes se pueden configurar de 0 a 90 días, de acuerdo con la documentación de Time Travel de Snowflake. El período anunciado de 90 días se aplica solo donde el tipo de objeto, la edición y la configuración lo permiten.
El patrón de incidentes que los equipos subestiman
Una tabla de producción permanente puede retener el estado necesario mientras que la tabla de almacenamiento transitorio que la alimentó ya ha perdido su historial utilizable. Esa brecha limita la investigación. El equipo podría recuperar el aspecto que tenía el destino sin poder probar qué cambio ascendente introdujo los valores incorrectos.
Capture la línea de tiempo del incidente con una consulta ejecutable antes de restaurar nada:
La vista de uso de la cuenta tiene latencia, así que combínela con los registros de orquestación y el historial de tareas cuando el incidente aún esté activo. Registre los objetos afectados, los síntomas observados y los ID de consulta que cambiaron la producción.
Regla operativa: Trate la retención como un control a nivel de objeto, no como una promesa para toda la plataforma.
Use una secuencia de recuperación conservadora:
Detener el proceso de escritura: Pausar la tarea, canalización o implementación que falla.
Inspeccionar antes de restaurar: Comparar filas históricas y actuales, claves, comportamiento de nulos y totales comerciales.
Recuperar en aislamiento: Crear un clon o una tabla separada mientras el mecanismo de falla siga siendo incierto.
Validar el reemplazo: Probar las dependencias y los permisos antes de la promoción.
Los equipos que crean una práctica de confiabilidad más amplia pueden conectar este flujo de trabajo con la ingeniería de confiabilidad de bases de datos. Los datos históricos respaldan entonces la Observability y la revisión de auditorías, no solo la recuperación de emergencia. La retención debe revisarse junto con la propiedad, el linaje, el monitoreo y los objetivos de recuperación.
El crecimiento de Snowflake también ha producido ciclos de vida de objetos más mixtos. A medida que las implementaciones se expanden, los equipos heredan conjuntos de datos permanentes, transitorios y temporales con diferentes comportamientos de recuperación. La pregunta práctica no es si Snowflake ofrece 90 días. Es qué objetos retienen la evidencia el tiempo suficiente para recuperar y explicar un fallo de producción.
Querying Past States with Time Travel
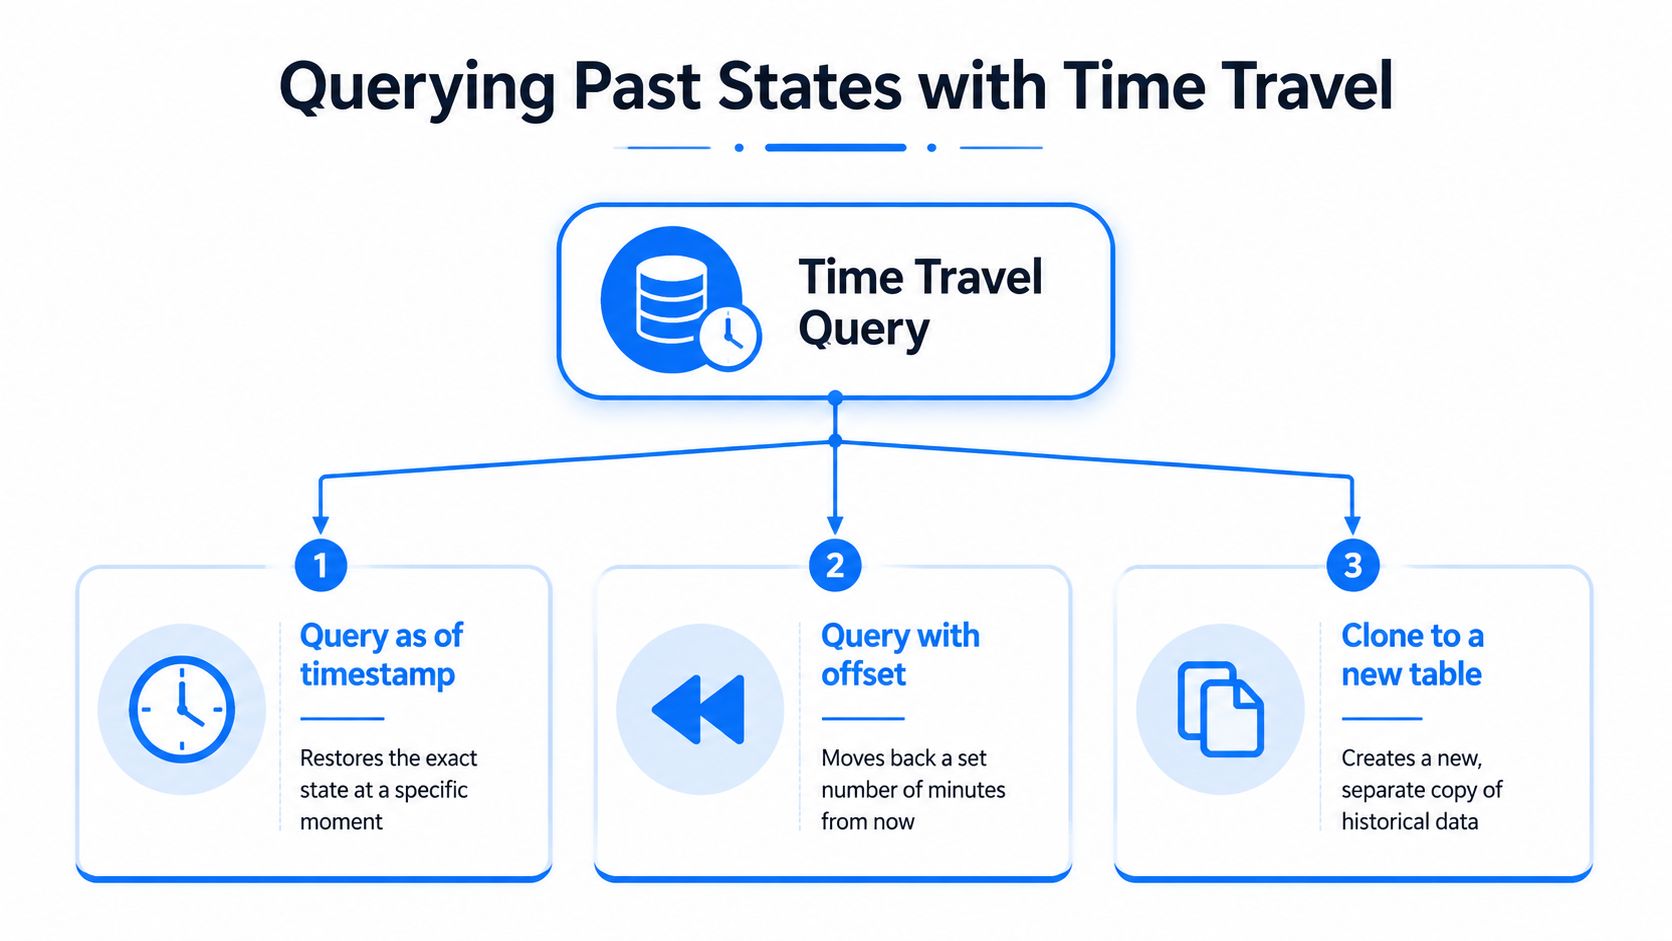
Time Travel funciona mejor cuando el ingeniero separa tres tareas: inspeccionar un estado anterior, identificar el límite de cambio exacto y crear una copia aislada. La sintaxis admite cada enfoque, pero la elección afecta la precisión con la que se puede reproducir el incidente.
Use timestamps for a known incident window
Si el monitoreo muestra que una carga destructiva comenzó a una hora conocida, consulte la tabla tal como existía antes de ese evento:
AT es útil cuando la línea de tiempo del incidente proviene de registros de orquestación, registros de implementación o historial de consultas. Le pide a Snowflake el estado del objeto en un punto específico, lo que lo hace adecuado para comparar una versión conocida como buena con la tabla actual.
También puede clonar ese estado histórico:
El clon le brinda al equipo una superficie de investigación de trabajo sin sobrescribir la fuente. Antes de confiar en el resultado, verifique que la marca de tiempo solicitada se encuentre dentro de la ventana de retención actual del objeto.
Use offsets for relative investigation
Cuando el incidente ocurrió recientemente pero la marca de tiempo exacta es menos importante, OFFSET retrocede un número de segundos:
Esto es conveniente durante un incidente activo porque expresa un punto relativo en el tiempo. Es menos adecuado para un registro de auditoría formal a menos que también capture el tiempo de ejecución y la marca de tiempo resuelta, ya que "hace una hora" puede volverse ambiguo después del hecho.
Use transaction boundaries when the change is identifiable
Si el historial de consultas o las herramientas de implementación le brindan un identificador de transacción, BEFORE le permite inspeccionar el estado de la tabla antes de esa transacción:
El identificador exacto debe estar disponible en sus registros operativos. No lo adivine. Una consulta de marca de tiempo suele ser más segura cuando el equipo solo tiene una hora aproximada del incidente.
La validación de la retención corresponde realizarse antes del SQL de recuperación, no después de una consulta fallida:
Inspeccione el retention_time devuelto, luego confirme la edición y el tipo de objeto de la tabla. Snowflake documenta un período de retención estándar de 1 día y una retención configurable de 0 a 90 días para bases de datos, esquemas y tablas permanentes en las ediciones correspondientes, como se describe en su guía de disponibilidad de datos.
Time Travel tampoco es un archivo de copia de seguridad convencional. Conserva estados históricos consultables durante un período definido, pero no cumple automáticamente con los requisitos de retención a largo plazo, copia inmutable o recuperación de cuentas independientes. Úselo para una investigación operativa rápida y recuperación en un punto en el tiempo, luego evalúe si se necesita otra capa de protección.
Understanding Retention Limits and Object Types
La cifra de 90 días se aplica a una capacidad, no a todos los objetos de una cuenta. Los objetos permanentes pueden tener un período de Time Travel configurable de 0 a 90 días, mientras que los objetos temporales y transitorios están limitados a 0 o 1 día, según la documentación de retención y costo de almacenamiento de Snowflake. Esa tabla de almacenamiento intermedio que su canalización recreó durante una implementación puede no tener la misma protección que la tabla de producción a la que alimenta.
Snowflake historical data retention by object type
Tipo de objeto | Time Travel (Estándar) | Time Travel (Enterprise+) | Fail-safe |
|---|---|---|---|
Base de datos, esquema o tabla permanente | 1 día por defecto | 0 a 90 días | 7 días después de Time Travel para objetos permanentes |
Tabla transitoria | 0 o 1 día | 0 o 1 día | No disponible |
Tabla temporal | 0 o 1 día | 0 o 1 día | No disponible |
La tabla refleja el modelo de retención documentado. Fail-safe no es una extensión de Time Travel que el usuario pueda consultar. Después de que expiren los datos históricos, los objetos permanentes pueden entrar en un período de Fail-safe de 7 días, pero esos datos están destinados al soporte de recuperación en lugar del análisis normal de SELECT. Tratar a Fail-safe como una capa de consulta de auditoría crea una falsa confianza durante un incidente.
Audit the settings before a failure
Comience con el propio objeto:
Revise el retention_time, el tipo de objeto y la edición que rige la cuenta. Luego clasifique las tablas por rol. Las tablas comerciales permanentes generalmente merecen una política diferente a la de las tablas de aterrizaje desechables, pero esa distinción debe ser explícita y estar documentada.
El almacenamiento es la compensación. Una retención más prolongada significa que Snowflake mantiene más datos históricos, por lo que los equipos deben estimar el impacto para las tablas con alta rotación en lugar de habilitar la retención máxima en todas partes. Las ventanas de mantenimiento de datos históricos documentadas de Snowflake abarcan de 7 a 97 días para objetos permanentes en Enterprise Edition, en comparación con 0 a 1 día para objetos transitorios, lo que hace que la clasificación de objetos sea fundamental para la planificación de costos y el diseño de recuperación.
Regla práctica: Una política de retención debe responder a tres preguntas: qué debe ser recuperable, qué debe ser auditable y qué se puede recrear a partir de una fuente autorizada.
Los requisitos reglamentarios añaden otra limitación. Una empresa puede necesitar conservar la evidencia durante un período que no se alinee con Time Travel, o puede necesitar un programa de eliminación documentado en lugar de una preservación indefinida. Para ese trabajo de políticas, los consejos sobre el calendario de retención de GDPR ofrecen un contexto útil sobre cómo alinear la retención con el propósito, los requisitos legales y la eliminación controlada.
Los equipos que diseñan conjuntos de datos de larga duración también deben separar el archivo de la recuperación de incidentes. La guía sobre cómo dominar el archivo de datos es relevante porque un archivo debe ser intencional, gobernado y reconocible. Time Travel protege un objeto cambiante durante una ventana limitada. No reemplaza un catálogo de archivos ni a un propietario de retención.
Recovering Dropped Objects with Cloning and UNDROP
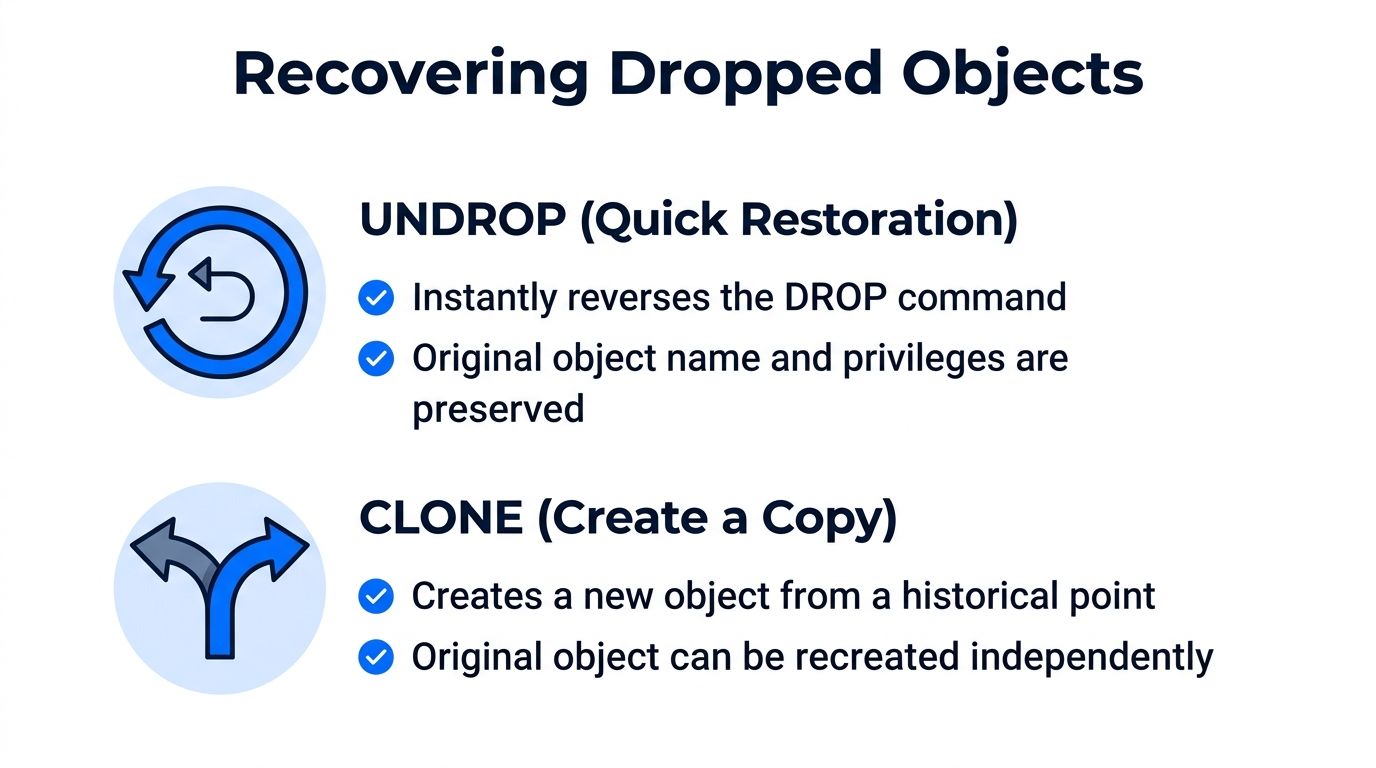
Una tabla eliminada crea un problema de recuperación diferente al de una actualización incorrecta. El objeto en sí puede desaparecer del espacio de nombres activo, por lo que el ingeniero debe decidir si restaura el objeto original o crea una copia independiente para la investigación.
UNDROP es la ruta directa cuando el objeto se eliminó dentro de su período de recuperación disponible:
Para un esquema o base de datos eliminados, use el comando correspondiente a nivel de objeto:
El comando es atractivo durante una interrupción porque revierte la eliminación en lugar de requerir un flujo de trabajo de movimiento de datos. Aun así, la restauración no debe tratarse como prueba de que el objeto es correcto. Verifique la existencia de objetos, otorgamientos, dependencias y el esquema esperado de la aplicación antes de volver a conectar a los consumidores.
Clone first when the failure is unclear
Un clon es más seguro cuando el equipo necesita inspeccionar una versión histórica sin cambiar la ruta de recuperación de producción:
Este enfoque preserva la fuente mientras los ingenieros comparan registros, prueban transformaciones e identifican la declaración que causó el daño. También admite un proceso de promoción controlado: validar el clon, documentar la evidencia y luego decidir si reemplazar o reparar el objeto de producción.
Los nombres de los objetos pueden complicar el UNDROP. Si un nuevo objeto ya ha tomado el nombre original, la operación de recuperación puede requerir cambiar el nombre o eliminar primero el objeto en conflicto. No improvise ese paso en producción. Registre los metadatos del objeto actual, preserve el objeto en conflicto si pudiera contener evidencia y use un esquema de recuperación designado cuando sea posible.
Validate before promotion
Una lista de verificación de recuperación debe incluir:
Confirmar el límite del fallo: Establecer si la eliminación, actualización o reemplazo afectó a una tabla, un esquema o una base de datos.
Verificar la elegibilidad de retención: Verificar que el estado histórico del objeto aún esté disponible y se pueda consultar.
Crear una copia aislada: Preferir un clon cuando aún se necesite investigación o comparación.
Comparar valores críticos: Verificar claves, excepciones a nivel de fila, agregados y expectativas de flujo descendente.
Revisar permisos: Confirmar que la propiedad y los otorgamientos coincidan con el modelo de acceso previsto.
Promocionar deliberadamente: Cambiar a los consumidores solo después de que el objeto recuperado pase la validación.
La arquitectura de microparticiones de Snowflake significa que un clon no es una copia de seguridad ensamblada manualmente. Los estados históricos permanecen vinculados al comportamiento de almacenamiento y retención de la plataforma, por lo que el plan de recuperación aún necesita una estrategia independiente para los datos que deben sobrevivir más allá de ese ciclo de vida.
Los equipos que formalizan estos procedimientos pueden usar las mejores prácticas de almacenamiento de datos como una referencia operativa más amplia. El objetivo práctico es la repetibilidad. A las 2 de la mañana, un ingeniero debe seguir una ruta de decisión conocida en lugar de buscar a través de suposiciones no documentadas sobre los nombres de los objetos y la retención.
Using Historical Data for Observability and Audits
El estado de una tabla histórica responde a: "¿Qué contenía este objeto en ese momento?". La Observability plantea una pregunta más amplia: "¿Cómo se comportaron los datos a lo largo del tiempo y cuándo ese comportamiento se volvió anormal?". Esas preguntas funcionan juntas, pero no son intercambiables.
Una investigación útil comienza con un síntoma observado. Una métrica cae, una carga llega tarde, una columna cambia de tipo o un total comercial se mueve fuera de su patrón normal. Time Travel puede inspeccionar la tabla subyacente en un punto relevante, mientras que un registro de Observability puede mostrar si el cambio fue aislado, recurrente o parte de un problema de canalización más amplio.
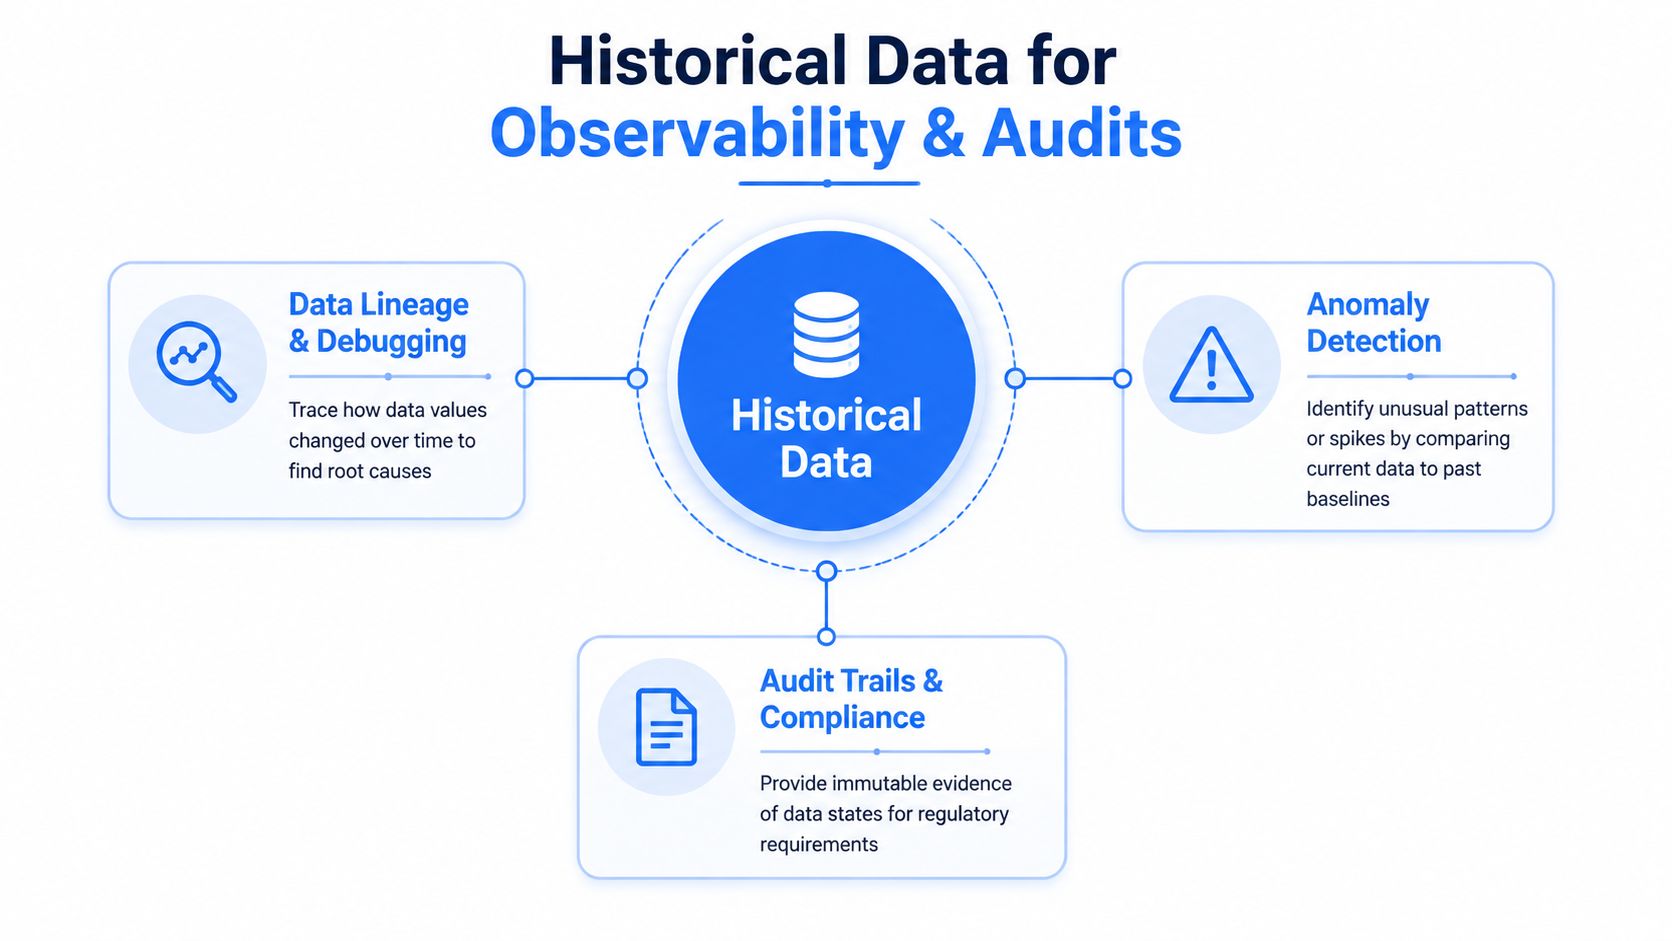
Combine point-in-time evidence with continuous signals
El flujo de trabajo es sencillo:
Detectar: Un monitor marca un volumen, Timeliness, esquema o comportamiento comercial anormal.
Localizar: Los ingenieros identifican la tabla, la tarea, la instrucción afectada y la ventana de cambio aproximada.
Comparar: Una consulta de Time Travel contrasta el estado actual con un estado histórico.
Explicar: El linaje y los registros de la canalización conectan el cambio de datos con una acción ascendente.
Preservar: El equipo almacena el contexto del incidente y los resultados de la validación en un registro apto para auditorías.
Snowflake expone la información de agrupamiento a través de CLUSTERING_INFORMATION, incluidos average_overlaps, average_depth y partition_depth_histogram. Esas métricas pueden ayudar a los ingenieros a determinar si una depuración deficiente contribuye a un análisis histórico lento, pero la reagrupación tiene un costo. Un flujo de trabajo sólido compara las particiones escaneadas con las particiones totales, establece un tiempo de ejecución de consulta representativo como referencia y revisa el consumo de créditos en AUTOMATIC_CLUSTERING_HISTORY antes de mantener una clave de agrupamiento.
La superficie del historial de consultas también tiene sus propios límites de retención. La vista QUERY_HISTORY de Account Usage conserva los registros durante 1 año, o 365 días, mientras que las vistas correspondientes de Information Schema y las funciones de tabla tienen períodos de retención más cortos que van desde 7 días a 6 meses, como se resume en esta descripción general de Time Travel e historial de consultas de Snowflake. Esa diferencia importa durante las auditorías. Una tabla puede conservar filas históricas mientras que la evidencia operativa que explica el cambio ya ha caducado.
Una plataforma como la de Data Observability puede complementar a Time Travel al preservar el historial de métricas, aprender el comportamiento esperado, realizar un seguimiento de la Timeliness, validar registros y detectar cambios en el esquema. La arquitectura debe mantener la evidencia en el entorno del cliente y distinguir los estados históricos sin procesar de las señales de monitoreo derivadas. Esa separación proporciona a los auditores tanto el contexto de los datos subyacentes como la historia operativa que los rodea.
When to Use Time Travel Versus External Backups
Time Travel es la herramienta adecuada para una recuperación rápida y local de errores recientes. Por lo general, es un sustituto deficiente para una política de copia de seguridad a largo plazo, especialmente cuando la empresa necesita un historial más allá de la ventana configurada, una recuperación independiente o pruebas que los usuarios no puedan alterar mediante las operaciones normales del almacén de datos.
Factor de decisión | Time Travel | Copia de seguridad externa |
|---|---|---|
Propósito principal | Recuperación y análisis operativo | Recuperación ante desastres y retención a largo plazo |
Objetivo de recuperación | El estado de una tabla, esquema o base de datos | Una copia mantenida por separado o un entorno más amplio |
Precisión histórica | Estado en un punto en el tiempo dentro de la retención | Depende del programa de instantáneas o exportación |
Velocidad operativa | Rápido para objetos elegibles | Puede requerir tareas de restauración, transferencia y validación |
Limitación principal | Retención, tipo de objeto y dependencia de la plataforma | Almacenamiento, orquestación, pruebas y gastos generales de gestión |
Use Time Travel cuando el incidente sea reciente, el objeto afectado sea elegible y el alcance de la recuperación sea estrecho. Un clon suele ser suficiente para la investigación, mientras que UNDROP se adapta a una eliminación accidental clara que necesita una restauración rápida.
Elija otra capa de protección cuando el requisito se extienda más allá del modelo de retención de Snowflake. Eso incluye la retención regulatoria a largo plazo, evidencia inmutable, recuperación entre entornos o protección contra errores operativos a nivel de cuenta. Los objetos permanentes pueden recibir 7 días de Fail-safe después de que expire el Time Travel, pero los objetos transitorios y temporales no reciben esa protección, y los usuarios no pueden realizar consultas en Fail-safe. El plan de recuperación debe tener en cuenta esos límites en lugar de tratarlos como equivalentes a una copia externa.
Make the decision against business requirements
Pregunte al propietario de cada conjunto de datos crítico:
¿Hasta dónde debe llegar la recuperación?
¿La copia debe controlarse de forma independiente?
¿Puede la empresa tolerar la reconstrucción a partir de los sistemas de origen?
¿Deben los auditores inspeccionar los registros históricos directamente?
¿Qué velocidad de recuperación se requiere para los flujos de trabajo de cara al cliente?
La replicación nativa, las exportaciones gestionadas y las herramientas de copia de seguridad de terceros pueden cubrir diferentes lagunas. El diseño correcto podría combinar el Time Travel de ventana corta para una reparación inmediata con un archivo gobernado por separado para una retención más prolongada. El costo no es solo el almacenamiento. Incluye pruebas operativas, controles de acceso, catalogación y el tiempo necesario para demostrar que una copia de recuperación funciona.
Los equipos que perfeccionan el plan de continuidad más amplio pueden consultar esta guía práctica de DR para equipos modernos. Para el aspecto de diseño de Snowflake, las mejores prácticas de disponibilidad de datos ayudan a enmarcar la disponibilidad como una disciplina operativa más que como un único comando de recuperación.
digna ayuda a los equipos de datos a monitorear el comportamiento de los datos de Snowflake mediante la detección de anomalías, el monitoreo de la Timeliness, la validación de registros, el seguimiento de esquemas y el análisis histórico, al mismo tiempo que mantiene la ejecución dentro del entorno del cliente. Visite digna para conectar la planificación de retención y recuperación con una Observability continua antes del próximo incidente de producción.
Preguntas frecuentes
¿Cuánto conserva Snowflake los datos históricos?
Menos de lo que asumen la mayoría de los equipos. El periodo estándar de Time Travel es 1 día, mientras que bases de datos, esquemas y tablas permanentes pueden configurarse de 0 a 90 días. La ventana de 90 días es un máximo configurable, no algo que toda tabla tenga automáticamente.
¿Por qué una tabla transitoria rompe una recuperación?
Porque la retención es un control a nivel de objeto y no una promesa de plataforma. Una tabla permanente de producción puede conservar aún el estado necesario mientras la tabla transitoria de staging que la alimentó ya ha perdido su historial utilizable.
¿Qué capturar antes de restaurar nada?
La línea temporal del incidente. Consulte SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY para la ventana en cuestión, filtrando por query_start_time y leyendo query_id, user_name, query_type, query_text y execution_status. Esa vista tiene latencia, así que combínela con registros de orquestación e historial de tareas.
¿Cuál es la secuencia segura de recuperación?
Detener primero al escritor: pause la tarea, canalización o despliegue que falla antes de intentar cualquier restauración. Recuperar mientras sigue corriendo el trabajo que causó el daño genera un segundo incidente encima del primero.
¿Qué añade Fail-safe a Time Travel?
Un último recurso, no un segundo nivel de retención consultable. Time Travel es la ventana que su equipo controla y usa directamente, así que un plan de recuperación que depende de Fail-safe ya ha salido de los controles que puede probar por adelantado.