Crear conjunto de datos
|
8
minuto de lectura

Se puede enviar un conjunto de datos que parezca limpio en staging, pase todas las pruebas unitarias y, aun así, descomponga el negocio dos semanas después. He visto cómo sucedía eso cuando una silenciosa normalización de zona horaria cambió los totales de ingresos en un panel y un proceso de marketing siguió ingiriendo ID de usuario nulos porque nada en el momento de la compilación trataba ese campo como crítico. Lo doloroso es que el equipo ya había calificado el conjunto de datos como "terminado".
Ese es el error que la mayoría de las guías dejan sin tocar. El trabajo de Create data set no es un hito de entrega, es el primer paso en un proceso de control continuo, de la misma manera que el Instituto Nacional de Estándares y Tecnología define la calidad de los datos como una capacidad determinada por la accesibilidad, relevancia, timeliness, metadatos, documentación, capacidades del usuario, contexto y costo, donde la generación, evaluación y mejora forman un ciclo en lugar de una línea de meta (artículo de perspectiva del NIST). En producción, el conjunto de datos no es real hasta que alguien lo posee, lo monitorea, lo versiona y sabe qué debería pasar cuando se desvía.
Tabla de contenidos
Cuando un conjunto de datos terminado es solo el comienzo
El equipo pensó que el conjunto de datos de eventos de clientes era sólido. Tenía columnas con tipos definidos, una compilación limpia y las comprobaciones habituales de nulos, así que lo publicaron y siguieron adelante. Dos semanas después, finanzas notó que los totales de ingresos se desviaban y marketing descubrió que un proceso de segmentación había aceptado registros con ID de usuario faltantes.
La causa raíz no fue dramática. Una regla de normalización de zona horaria cambió en origen, y nadie trató eso como un cambio disruptivo porque el esquema no había cambiado. Al mismo tiempo, el conjunto de datos permitía valores nulos en un campo que los consumidores intermedios asumían que era obligatorio, por lo que los registros incorrectos fluyeron hasta que un segmento de campaña pareció más grande de lo que debería. Esa es la trampa: un conjunto de datos puede ser sintácticamente correcto y, aun así, ser operativamente incorrecto.
El verdadero fracaso fue el control, no la construcción
Un conjunto de datos de producción necesita algo más que una compilación exitosa. Necesita umbrales de aceptación, detección de desviaciones, propiedad y una ruta de reversión, porque la definición de "bueno" cambia una vez que los consumidores reales dependen de él. Esa idea se alinea con la realidad empresarial de que la mala calidad de los datos es costosa y que solo una pequeña parte de los datos de la empresa se considera que cumple con los estándares básicos de calidad en investigaciones de la industria ampliamente citadas (Gráfico de Gartner y resumen relacionado).
Regla práctica: si un panel, modelo o flujo de trabajo descendente puede fallar silenciosamente, el conjunto de datos aún no está terminado.
El resto del trabajo consiste en evitar el tipo exacto de rotura que aparece después del lanzamiento. Una barrera de protección habría detectado el cambio de zona horaria. Otra habría marcado los ID de usuario nulos antes de que el equipo de marketing confiara en ellos. El resto de este artículo es el manual de prevención.
Diseñar el esquema antes de escribir una sola consulta
Los errores de esquema son costosos porque se consolidan rápidamente. Una vez que los equipos comienzan a cargar y modelar alrededor de una tabla, cambiar el grano o reinterpretar una columna se convierte en un proyecto de migración, no en una simple refactorización. Lo más seguro es decidir la forma antes de la primera extracción, y luego documentar las elecciones para que nadie tenga que descifrar la intención mediante ingeniería inversa más adelante.
Comenzar con el grano, las claves y la semántica del tiempo
Elija el grano de forma explícita. Si una fila representa un evento de usuario, dígalo en el documento de diseño y en la descripción de la tabla, porque esa decisión impulsa la deduplicación, la agregación y las uniones posteriores. Use claves sustitutas donde no se garanticen identificadores naturales estables, y fije las marcas de tiempo en UTC con un desplazamiento de origen documentado para que los consumidores posteriores puedan reconstruir la hora local sin adivinar.
Una tabla user_events descuidada suele mostrar sus problemas en los nombres de las columnas. Se ven mayúsculas y minúsculas mezcladas, booleanos ambiguos como is_active, valores de event_type de texto libre que derivan en casi duplicados, y marcas de tiempo cuyo significado cambia según quién las haya cargado. Una versión disciplinada se ve aburrida de la mejor manera, con enumeraciones o categorías controladas para los tipos de eventos, banderas de anulabilidad que tienen un significado explícito y ID estables que no dependen de lo que la aplicación ascendente haya decidido emitir esa semana.
Usar nombres que sobrevivan a las operaciones reales
La nomenclatura de almacenes y lagos de datos debería indicar a las personas en qué parte de la canalización se encuentra una tabla. Los prefijos como raw_, stg_ y dim_ hacen que eso sea visible, lo cual es importante cuando alguien intenta entender si una tabla está lista para la ingesta, para la transformación o para el consumo. Si desea una taxonomía más profunda de las opciones estructurales, la guía interna sobre tipos de esquemas es un punto de referencia útil.
Documente cada columna antes de que llegue la primera fila. Un archivo schema.yml, o comentarios en information_schema, obliga al equipo a definir el tipo, el significado, los valores permitidos y la propiedad mientras el diseño aún es fácil de cambiar.
Área de decisión | Antipatrón | Listo para producción |
|---|---|---|
Grano | Implícito, inferido más tarde | Declarado explícitamente antes de la compilación |
Identificador primario | Clave natural compuesta de fuentes inestables | Clave sustituta o ID duradero y estable |
Marcas de tiempo | Horas locales mezcladas, sin nota de desplazamiento | UTC con desplazamiento de origen documentado |
Booleanos |
| Bandera anulable con semántica escrita |
Tipos de eventos | Cadenas de texto libre | Categorías controladas o valores de tipo enumeración |
Documentación | Agregada después del lanzamiento | Escrita antes de la primera carga |
Abastecerse de datos sin perder la procedencia
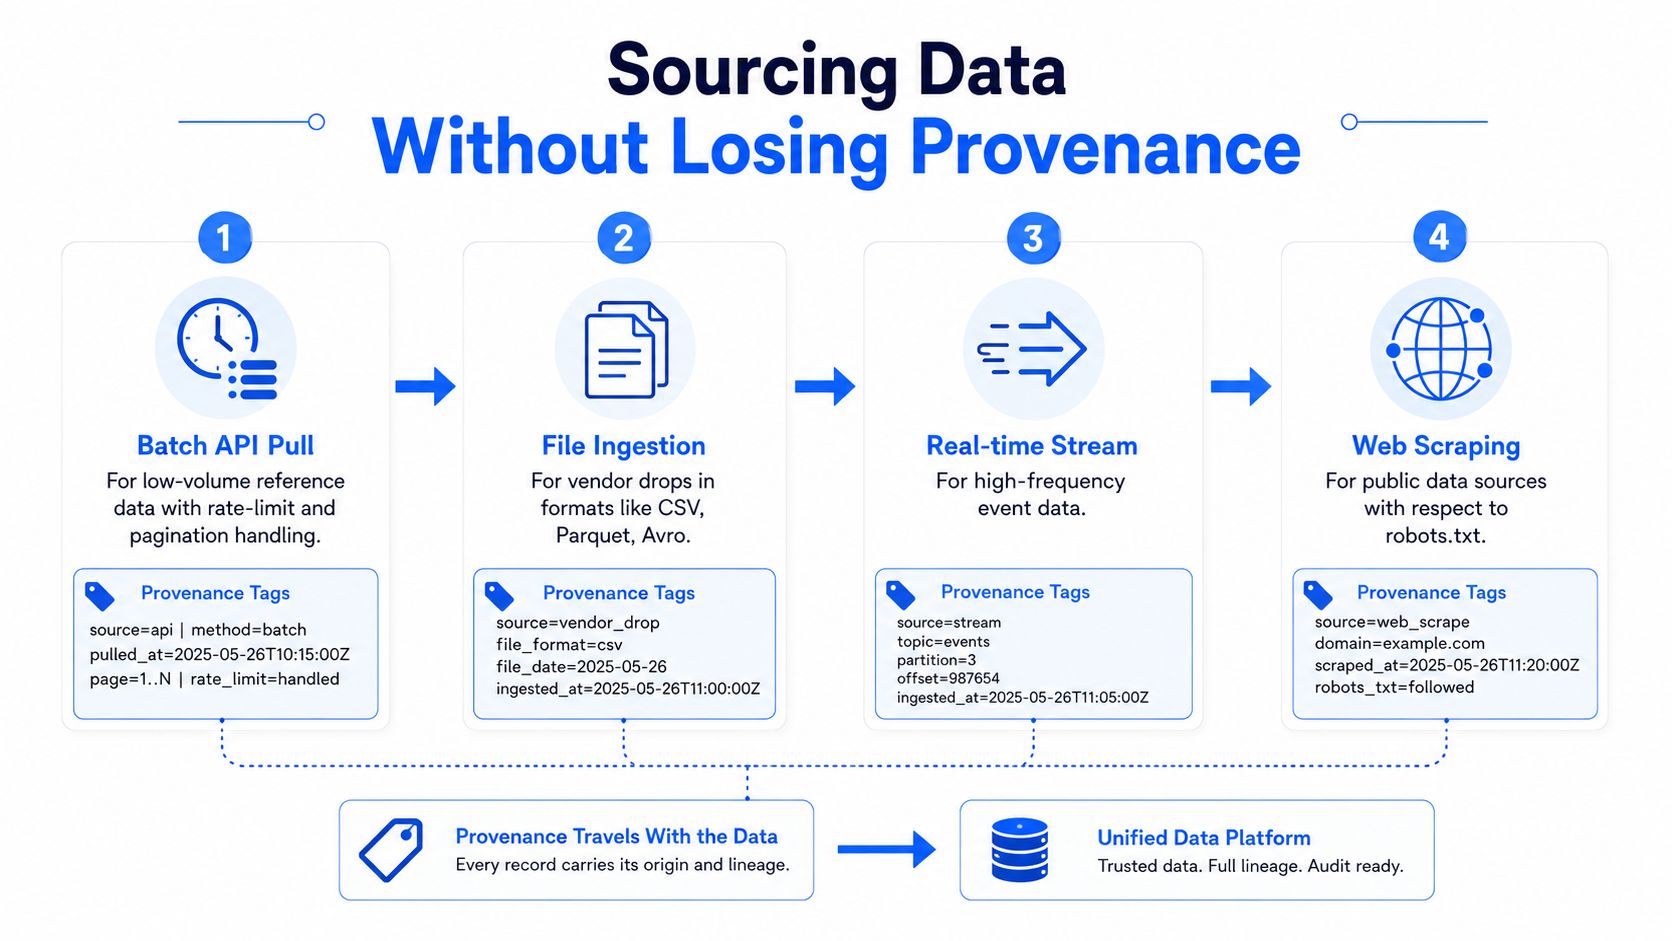
La fuente importa tanto como la forma. Una extracción por API por lotes, una entrega de archivos, CDC y los datos sintéticos resuelven cada uno un problema diferente y fallan de formas distintas. Si elige el patrón de origen incorrecto, pasará meses compensando la falta de linaje en lugar de mejorar el conjunto de datos.
Adaptar el método de ingesta al caso de uso
Use extracciones de API por lotes para datos de referencia de bajo volumen, donde la paginación y los límites de velocidad son las principales restricciones. Use ingesta de archivos para entregas de proveedores en CSV, Parquet o Avro cuando los contratos de esquema sean lo más importante, porque los archivos hacen que sea más fácil razonar sobre el versionado y la reproducción. Use captura de datos modificados (CDC) cuando necesite cargas en el almacén casi en tiempo real desde bases de datos operativas, y use datos sintéticos cuando necesite probar las canalizaciones antes de que existan los flujos de producción.
La parte esencial es la procedencia. Capture source_system, source_loaded_at, source_record_hash y ingestion_run_id en el momento de la lectura, no más tarde en la capa de transformación. El linaje agregado posteriormente es siempre una reconstrucción, y la reconstrucción es donde los equipos comienzan a inventar certezas que nunca tuvieron.
Escriba la procedencia en el punto de lectura. Cualquier otra cosa se convierte en una suposición bajo presión.
Para fuentes web públicas o flujos de trabajo de scraping, se aplica la misma regla, y el método de ingesta debe elegirse solo después de haber verificado las restricciones ascendentes y los modos de fallo. Un manual práctico sobre qué buscar en las API es un buen recordatorio de que la disponibilidad, la paginación y el comportamiento del contrato dan forma al conjunto de datos tanto como las filas. Si desea la distinción conceptual entre linaje y procedencia, vale la pena tener a mano el explicador interno sobre procedencia de datos frente a linaje de datos.
Versionar el contrato, no solo los datos
Las API externas y las fuentes de proveedores deben tratarse como dependencias. Fije la versión del contrato, documente qué campos son obligatorios y haga que un cambio de esquema aparezca como una solicitud de extracción visible en lugar de una rotura silenciosa. De esa manera, cuando un proveedor cambia el nombre o el tipo de un campo, el equipo ve la diferencia antes de que la canalización la absorba.
Comprobaciones de validación que detectan problemas reales
Un conjunto de datos puede parecer completo y, aun así, fallar en el momento en que alguien lo usa. Las comprobaciones de nulos detectan solo una clase de problema. Las referencias rotas, los valores fuera de rango, las filas que llegan tarde y las claves inconsistentes pueden dejar una tabla técnicamente poblada pero operativamente inútil.
Validar primero a nivel de registro
Comience con las comprobaciones que protegen las suposiciones posteriores. Use unicidad en identificadores naturales donde los duplicados duplicarían el recuento de registros, integridad referencial entre claves de dimensión y de hechos, listas de valores aprobados para campos categóricos y reglas de precisión para columnas monetarias. Si un campo de ingresos siempre debe tener dos decimales, escriba eso en la regla en lugar de confiar en que todos los sistemas de origen cumplan.
Los conjuntos de valores permitidos reutilizables ayudan aquí, especialmente para países, estados y códigos de estado. Si crea una biblioteca de reglas, el enfoque del módulo de Data Validation en digna sigue ese patrón, con comprobaciones limitadas a la tabla o a un subconjunto filtrado según sea necesario. El punto no es la herramienta. Es hacer explícitas las reglas comunes en lugar de enterrarlas en cuadernos únicos.
La parte que no puede omitir es la procedencia. Capture source_system, source_loaded_at, source_record_hash e ingestion_run_id en el momento de la lectura, no más tarde en la capa de transformación. Si esos campos se agregan después de la ingesta, dejan de ser hechos y se convierten en suposiciones bajo presión.
Agregar comprobaciones de distribución y timeliness
Una vez que las reglas a nivel de fila sean estables, observe la tabla en su conjunto. Los recuentos de filas que se desvían demasiado de la línea de base reciente, las tasas de nulos que aumentan en campos críticos y la deriva de la cardinalidad categórica apuntan a problemas que una regla de una sola fila pasará por alto. Para el timeliness, establezca un objetivo de nivel de servicio claro vinculado al propósito de la tabla, como una ventana de retraso corta para flujos casi en tiempo real y una más larga para lotes.
La parte difícil es la optimización. Las líneas de base de anomalías necesitan un período de preparación antes de significar algo, porque un conjunto de datos nuevo aún no tiene una forma estable. Separe las fallas graves de las advertencias leves, envíe las advertencias a triaje y asegúrese de que cada comprobación tenga un propietario, un manual de ejecución y una ruta de desvío. Las comprobaciones sin propietario se convierten en ruido con el tiempo, y las comprobaciones ruidosas se dejan de leer.
Trate los umbrales de aceptación como una decisión de governance, no como un detalle técnico. Si un flujo puede tolerar una pequeña cantidad de datos opcionales faltantes pero no puede tolerar claves rotas, dígalo claramente en las comprobaciones y en el proceso de aprobación. Eso evita que el equipo discuta por cada alerta como si todas las fallas tuvieran el mismo peso.
Capa de validación | Ejemplo de comprobación | Umbral sugerido | Propietario + Escalabilidad |
|---|---|---|---|
Integridad del registro | Unicidad de la clave natural | No se permiten duplicados | Ingeniería de datos, aviso en caso de infracción |
Integridad de la relación | Las claves de hechos coinciden con las claves de dimensión | Sin filas huérfanas | Propietario de la canalización, cuarentena de lote incorrecto |
Dominio de valor | País, estado o lista de enumeración | Solo valores aprobados | Propietario del dominio, cola de triaje |
Precisión numérica | Escala monetaria | Precisión decimal requerida | Ingeniero de analítica, bloquear publicación |
Tendencia de volumen | Desviación del recuento de filas | Dentro de la línea de base normal | Ingeniero de datos de guardia, investigar |
Estabilidad de nulos | Tasa de nulos en columnas críticas | Baja y estable para la tabla | Propietario del conjunto de datos, alerta leve primero |
Timeliness | Retraso entre evento y carga | Coincidir con el SLA del flujo | Propietario de la plataforma, aviso si se retrasa |
Para obtener una visión más detallada de cómo encajan las comprobaciones a lo largo del ciclo de vida de un conjunto de datos, consulte reglas de validación de datos, comprobaciones y calidad continua de los datos.
Particionamiento, versionado y deriva del esquema
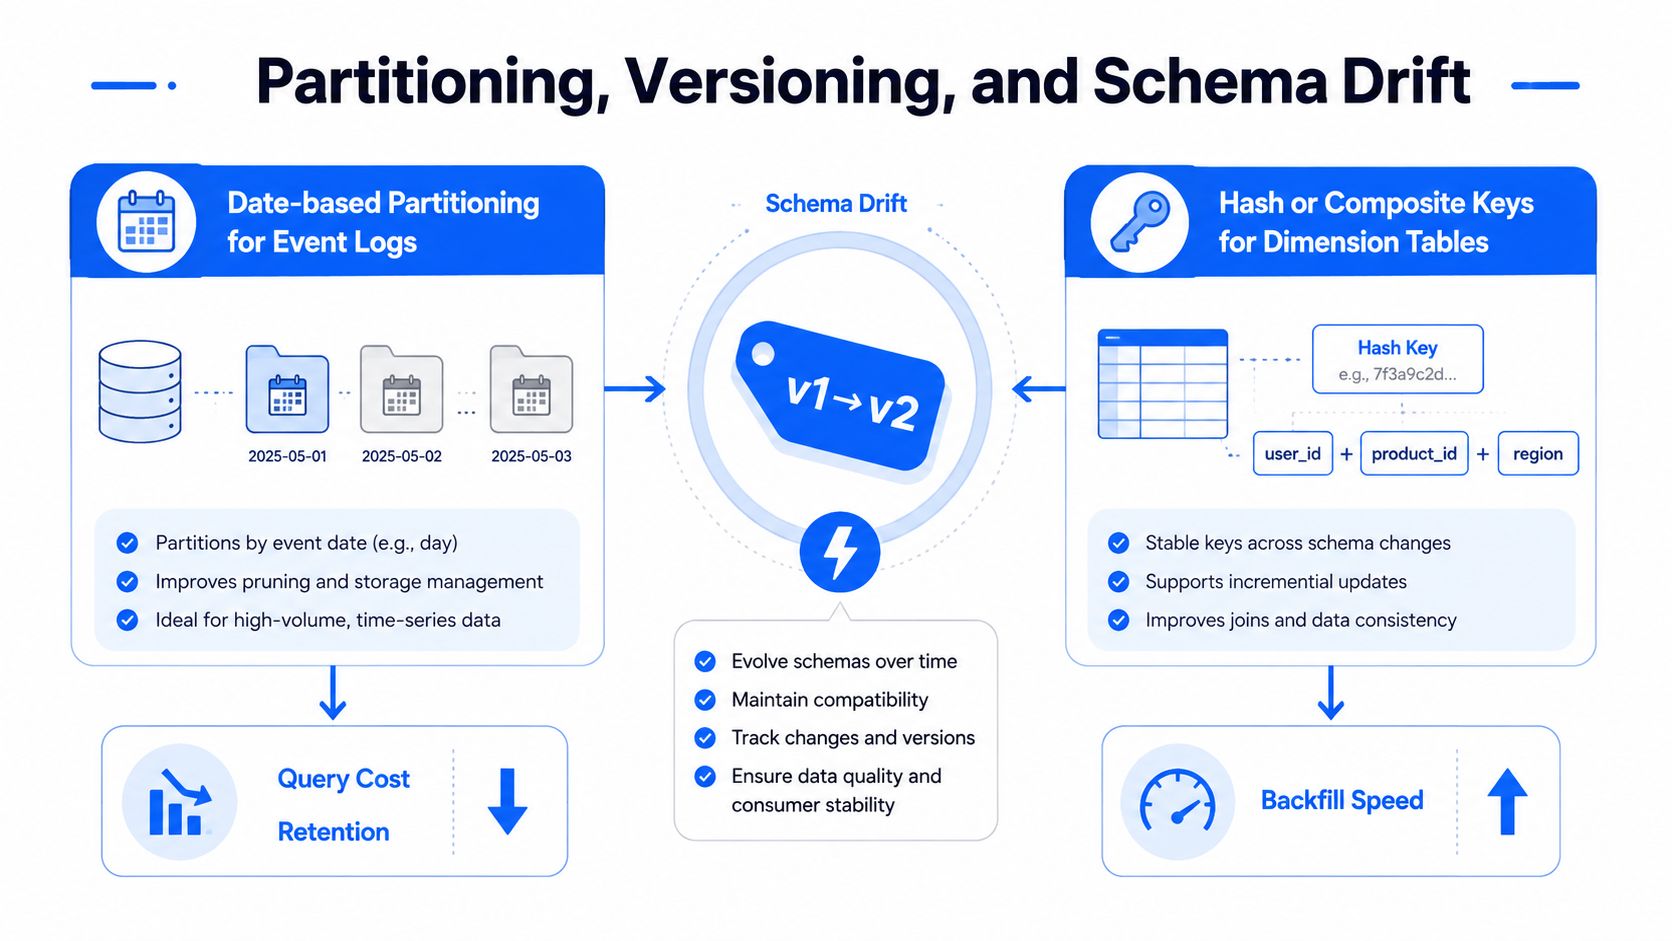
El particionamiento define más que el diseño del almacenamiento. Afecta al costo de las consultas, a la velocidad de llenado posterior (backfill) y a la facilidad con la que se pueden aplicar las reglas de retención. Los equipos a menudo eligen un esquema de particionamiento para acelerar un panel y luego descubren que complica el reprocesamiento o rearma datos históricos que aún necesitan.
Elegir el diseño en función de cómo se utiliza la tabla
Use particionamiento basado en fechas para registros de eventos y tablas de hechos con muchas inserciones (append-heavy). Eso le brinda una unidad limpia para la retención, rellenos posteriores incrementales y consultas limitadas en el tiempo. Para instantáneas de dimensiones o estructuras que cambian lentamente, las claves compuestas o hash pueden hacer que las búsquedas y reconstrucciones sean más predecibles, especialmente cuando la tabla no está organizada naturalmente por tiempo. En sistemas como BigQuery, Snowflake y Apache Iceberg, la sintaxis exacta difiere, pero el principio operativo es el mismo.
Trate el conjunto de datos como versionado desde el primer día. Las versiones semánticas en los metadatos, las etiquetas inmutables por Release y una ventana de obsolescencia para los consumidores antiguos evitan que el equipo finja que todos los lanzamientos son intercambiables. Cuando una versión cambia, la anterior debe seguir disponible hasta que los consumidores se hayan migrado, porque el peor momento para eliminar una tabla es cuando un informe todavía depende de ella.
Hacer que la deriva sea un fallo en la canalización, no una sorpresa
La deriva del esquema es el asesino silencioso. Aparecen nuevas columnas, desaparecen columnas obligatorias y los anchos de tipo se reducen lo justo para romper una unión o conversión posterior. El patrón más limpio es una ingesta permisiva en la zona de aterrizaje, seguida de perfiles, validación estricta en el siguiente límite y pruebas de staging que hagan fallar la canalización si el esquema ha cambiado de una manera incompatible.
Esa lógica pertenece al código, no a un comentario de revisión en un cuaderno. Si una capa de transformación puede ver la diferencia de esquema, puede detener el despliegue antes de que los consumidores se lleven una sorpresa. La documentación versionada y un registro de cambios cierran el ciclo indicando al siguiente analista por qué la tabla actual tiene ese aspecto.
Una guía práctica de control de versiones para equipos de cumplimiento de DPP Grid es útil aquí porque define el versionado como un problema de governance, no solo como un hábito de almacenamiento. Si ya está lidiando con la deriva del esquema en producción, el explicador interno sobre deriva del esquema y cambios estructurales que rompen las canalizaciones de datos ayuda a concretar los modos de fallo.
Governance y descubribilidad desde el primer día
El governance suele tratarse como un paso de revisión al final, pero en realidad es un problema de descubribilidad con cumplimiento asociado. Si las personas no pueden saber para qué sirve un conjunto de datos, quién es su propietario y qué datos contiene, lo usarán de forma incorrecta o lo evitarán. Ambos resultados son costosos.
Escribir los metadatos mínimos antes de publicar
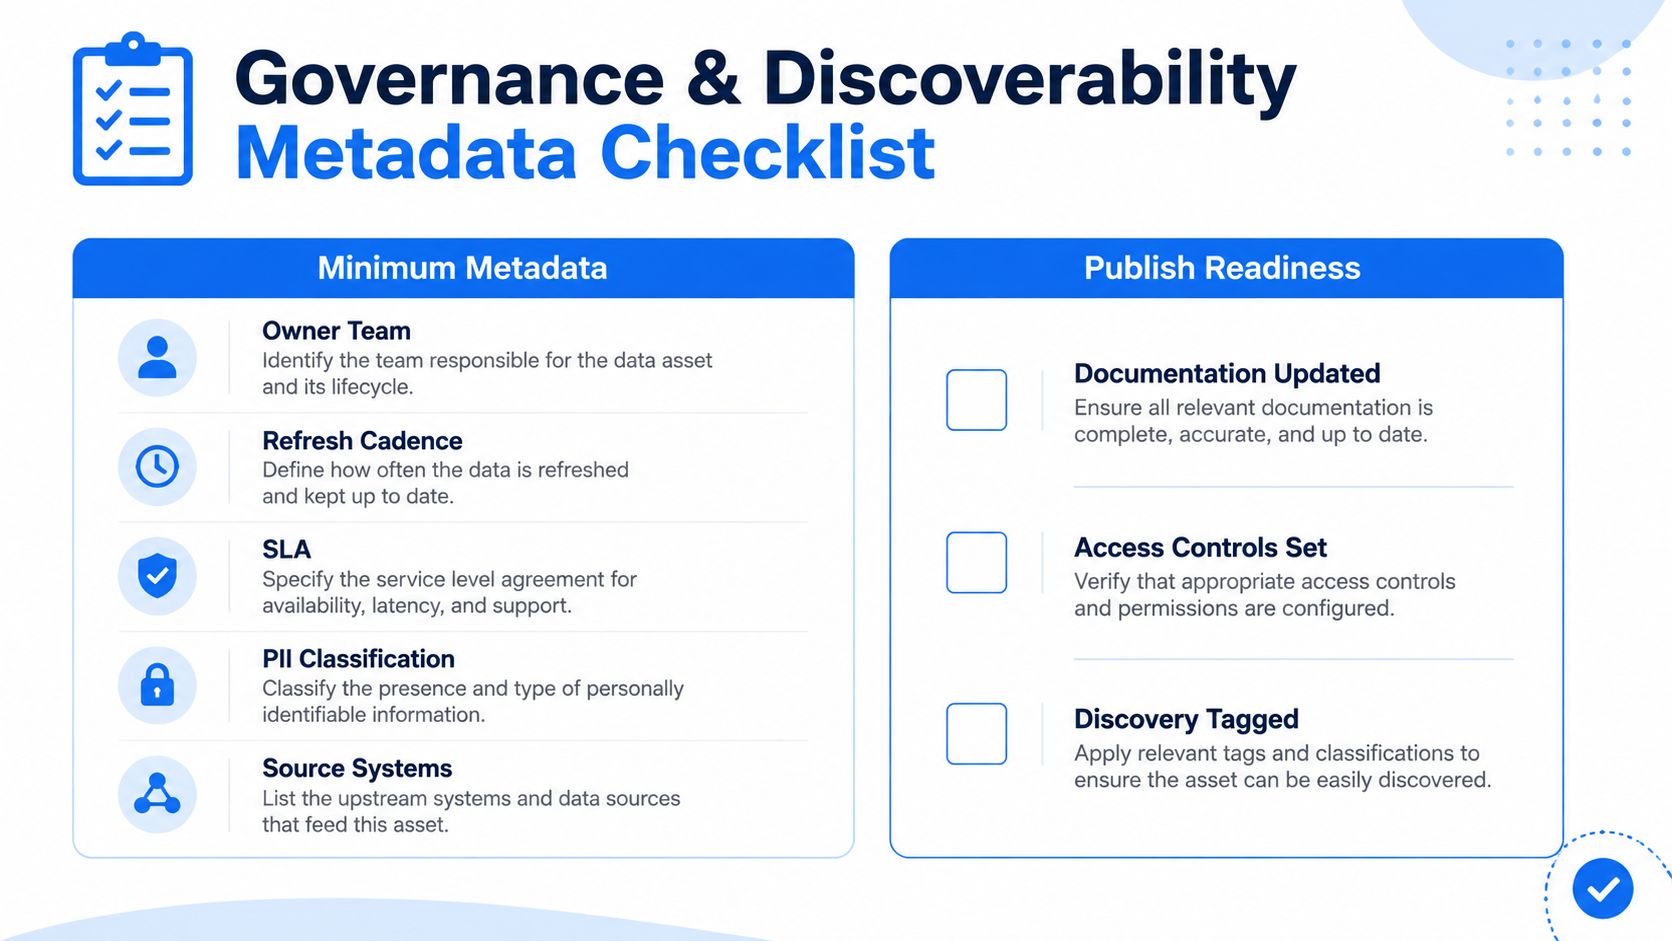
Cada conjunto de datos debe enviarse con un equipo propietario, cadencia de actualización, SLA, clasificación de PII, sistemas de origen y una breve declaración de uso previsto que también indique para qué no sirve el conjunto de datos. Estos seis campos suenan básicos porque lo son, y lo básico es exactamente lo que mantiene la tabla utilizable cuando aparecen auditorías, traspasos y nuevos consumidores.
Vincule los controles de acceso a la clasificación. Enmascare la PII restringida, aplique políticas a nivel de fila donde las reglas regionales importen y mantenga separados los roles de producción y de entorno de pruebas (sandbox) para que el acceso exploratorio no se filtre al uso operativo. Si el conjunto de datos incluye datos personales, preserve el linaje de consentimiento vinculándolo con la base legal y el programa de retención que lo rige.
El catálogo es donde todo esto se vuelve visible. La descripción general interna de qué es un catálogo de datos es un buen recordatorio de que el descubrimiento solo funciona cuando los metadatos y la política de acceso están alineados.
Hacer que la reutilización sea segura, no accidental
Un conjunto de datos que es fácil de encontrar pero difícil de confiar genera más trabajo, no menos. El objetivo es que el paso de publicación se sienta completo solo cuando el conjunto de datos esté etiquetado, documentado y mapeado con el motor de políticas que controla el acceso. De esa manera, la clasificación no se desvía de los permisos con el tiempo.
Si la entrada del catálogo es vaga, el conjunto de datos se reutilizará de mala manera.
Es por eso que la lista de verificación práctica es corta: propietario, clasificación, SLA, uso previsto, actualización y contacto. Complete estos datos al momento de la creación y se ahorrará semanas de idas y vueltas en auditorías más adelante.
Cómo saber cuándo su conjunto de datos es lo suficientemente bueno
"Suficientemente bueno" no es un sentimiento, es un contrato. El error es esperar a tener una cobertura perfecta antes de permitir que el conjunto de datos entre en producción, porque ese reflejo suele traducirse en un retraso indefinido. Es mejor definir la puerta de acceso y luego dejar que los datos se ganen su camino a través de ella.
Usar puertas de aceptación vinculadas a la decisión
Una primera puerta útil es la completitud. Si un campo obligatorio tiene una alta tasa de nulos, el conjunto de datos no es apto para la decisión que debe respaldar. Una segunda puerta es la recencia, porque los datos obsoletos pueden estar limpios y, aun así, ser incorrectos para el uso operativo. Una tercera puerta es la representación, que comprueba si los segmentos clave están lo suficientemente sesgados como para distorsionar un modelo o informe posterior.
Las comprobaciones de sesgo pertenecen a esa tercera puerta. Busque desequilibrios de clases, brechas geográficas, brechas demográficas y supervivencia en fuentes combinadas, y luego decida qué hacer con el resultado. Algunos conjuntos de datos deben aceptarse tal cual, algunos deben sobremurearse o complementarse, algunos deben excluir ciertos usos y otros deben documentarse como parciales por diseño.
Puerta de aceptación | Métrica | Ejemplo de umbral | Decisión si falla |
|---|---|---|---|
Completitud | Tasa de nulos en campos requeridos | Suficientemente baja para el caso de uso | Bloquear publicación o relleno posterior |
Recencia | Frescura frente a la latencia de la decisión | Dentro de la ventana permitida | Retener hasta que se actualice |
Representación | Cobertura de segmentos en grupos clave | Sin sesgo crítico | Sobremuestrear, excluir o documentar |
Estabilidad | Resultados de calidad repetidos a lo largo del tiempo | Pasa a través de múltiples ciclos | Mantener en modo oculto (shadow mode) |
Promocionar por etapas, no de un solo salto
El despliegue más limpio es el gradual. Instrumente primero las métricas de calidad, compárelas con un conjunto de datos de control después y solo convierta el nuevo conjunto de datos en el predeterminado una vez que se mantenga a lo largo de ciclos repetidos. Eso mantiene la honestidad del equipo sobre si los datos están listos o si simplemente se acaban de compilar.
Suficientemente bueno significa que el conjunto de datos respalda la decisión sin obligar a compensaciones ocultas en otros lugares.
La conversación sobre la creación de conjuntos de datos trata en realidad sobre el control, no sobre la recopilación. Si desea una plataforma que monitoree la validación, el timeliness, el cambio de esquema y el comportamiento de anomalías dentro de su entorno, digna lo hace a través de los datos del almacén y de la canalización sin tener que mover los datos de su lugar. Visite digna para ver cómo encaja esto en un ciclo de vida de un conjunto de datos que necesita propiedad, umbrales y comprobaciones continuas, no solo otra compilación única.
Preguntas frecuentes
¿Cuándo está realmente terminado un conjunto de datos?
No cuando se construye correctamente. Si un panel, modelo o flujo posterior puede fallar en silencio, el conjunto no está terminado. Un conjunto en producción necesita control después del lanzamiento, no solo construcción antes de él.
¿Qué hay que decidir antes de escribir la primera consulta?
Grano, claves y semántica temporal, porque los errores de esquema se endurecen rápido y salen caros. Elija el grano de forma explícita en lugar de dejar que emerja, y use nombres que sobrevivan a la operación real, porque una tabla de eventos descuidada suele mostrar sus problemas primero en los nombres de columna.
¿Por qué se rompen los conjuntos semanas después del lanzamiento?
Porque la causa raíz suele ser el control y no la construcción. La build pasó todas las pruebas y parecía limpia en staging, y después no ocurrió nada dramático; lo que faltaba era una forma de notar que los datos habían dejado de comportarse como el esquema sugería.
¿Qué controles deben acompañar a un conjunto nuevo desde el día uno?
Validación, disciplina de particionado y contexto de gobernanza, además de monitorización de los modos de fallo que permanecen callados. Añadirlos tras un incidente siempre sale más caro que diseñarlos desde el principio, porque para entonces ya hay consumidores decidiendo sobre esos datos.
¿Cuántos datos empresariales cumplen de verdad estándares de calidad?
Solo una pequeña parte, según investigación del sector ampliamente citada, junto a las estimaciones de Gartner sobre lo que cuesta la mala calidad. La lectura práctica no es que la mayoría de los datos sean inservibles, sino que la mayoría nunca se ha medido contra un estándar declarado.



