Control de calidad de los datos en la investigación: guía práctica
|
6
minuto de lectura
Los problemas de calidad de los datos no suelen aparecer cuando el conjunto de datos aún está recién recogido. Aparecen después de que una hoja de cálculo se haya copiado, un archivo se haya fusionado, el nombre de un campo haya cambiado y alguien pregunte por qué una fila muestra ahora una fecha imposible o un seguimiento ausente que nadie señaló a tiempo. Así es el control de calidad de los datos en la investigación: no es una lista de verificación ordenada al final, sino una cadena de controles que tiene que resistir cada traspaso.
Índice de contenidos
Por qué el control de calidad de los datos en la investigación falla en silencio
Su lista de verificación para el control de calidad de los datos
Por qué el control de calidad de los datos en la investigación falla en silencio
Un equipo de investigación puede pasar semanas recogiendo registros de aspecto impecable y, aun así, heredar un desastre. Los fallos suelen permanecer ocultos porque la transcripción, la transferencia, las actualizaciones y el guardado crean nuevas oportunidades de deriva silenciosa, y muchos equipos solo inspeccionan la calidad en el momento de la recogida. Cuando alguien detecta un valor atípico o una variable ausente, el formulario original puede estar enterrado, el esquema puede haber cambiado y la limpieza se convierte en una reconstrucción.
Por eso los sistemas más sólidos tratan la calidad como una obligación a lo largo de todo el ciclo de vida, no como una auditoría puntual. Un buen punto de partida es analizar las razones estructurales por las que fracasan los proyectos y corregir el proceso que las rodea, no solo los síntomas, tal y como se describe en esta nota práctica sobre por qué fracasan los proyectos de calidad de datos.
Regla práctica: si un registro puede cambiar de manos, puede perder su integridad.
El resto de esta guía se centra en cinco elementos que resisten bajo presión: validación en cada paso de manipulación, umbrales medibles, procedencia y documentación, reproducibilidad y pistas de auditoría. Esta combinación es importante porque los errores más graves no son espectaculares, sino corrientes, y los errores corrientes son precisamente los que se les escapan a los equipos que solo revisan en la línea de meta.
Las cinco dimensiones de la calidad de los datos
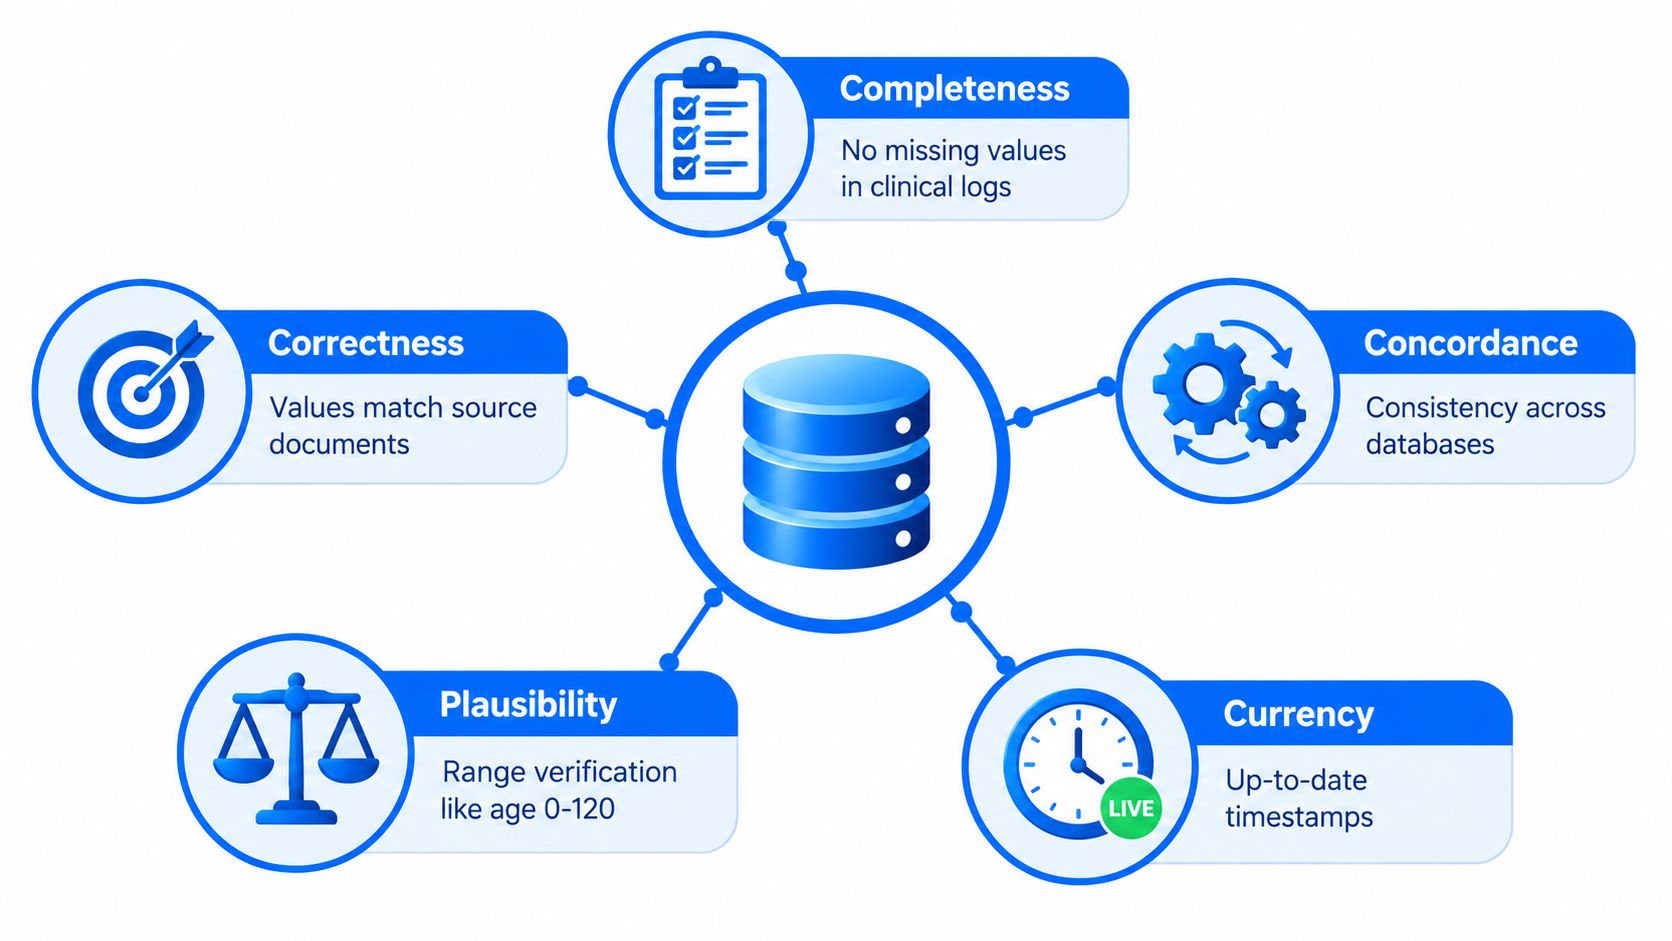
Un buen control de calidad empieza por un lenguaje compartido. Si un equipo dice “los datos parecen correctos” sin especificar qué ha comprobado, lo normal es que sus miembros no se estén entendiendo. Las cinco dimensiones, completitud, exactitud, concordancia, plausibilidad y actualidad, ofrecen al equipo una forma de distinguir la ausencia de datos de las contradicciones, y los datos obsoletos de los valores imposibles.
Qué detecta cada dimensión
La completitud tiene que ver con los huecos. Una visita de seguimiento ausente, un campo de laboratorio vacío o una fecha de consentimiento omitida pertenecen a esta categoría, y no son el mismo problema que los valores erróneos. Un sencillo informe semanal de completitud sobre los campos clave basta para mostrar dónde se concentran los huecos.
La exactitud pregunta si un valor coincide con la fuente. Si una fecha de nacimiento se ha tecleado mal o un resultado de laboratorio se ha copiado de la línea equivocada, el número puede tener un formato perfecto y aun así ser falso. Un control práctico consiste en una comparación selectiva con los documentos fuente sobre una pequeña muestra de los registros más importantes.
La concordancia es la coherencia entre sistemas. Dos bases de datos que discrepan sobre el estado de inscripción de un mismo participante generan trabajo de conciliación más adelante, así que conviene comparar pronto identificadores, fechas de visita e indicadores de estado entre sistemas. En este punto, muchos equipos confían demasiado en la tabla “maestra” y pasan por alto que la tabla maestra es simplemente el último lugar donde aterrizó el error.
La plausibilidad detecta valores técnicamente válidos pero poco creíbles. Una edad de 0 en una cohorte de adultos, una fecha de alta anterior a la de ingreso o una secuencia de marcas de tiempo inverosímil deberían activar una revisión aunque el campo supere las comprobaciones de formato. Aquí es donde los equipos suelen necesitar alertas basadas en reglas, no solo inspección humana.
La actualidad es la vigencia temporal de los datos. Un registro puede ser correcto y aun así ser demasiado antiguo para utilizarlo, sobre todo en estudios longitudinales donde importan los cambios de estado. Una marca de tiempo obsoleta o una actualización con retraso merecen su propio control, porque los datos obsoletos a menudo se hacen pasar por datos completos.
El artículo sobre las dimensiones de la calidad de los datos resulta útil si su equipo necesita un vocabulario común antes de escribir reglas. Los equipos suelen dar demasiado peso a la exactitud y comprobar poco la plausibilidad y la actualidad, que es justo donde se esconden los fallos silenciosos.
Prueba de utilidad: si un control no puede decirle qué tipo de problema ha encontrado, todavía no es lo bastante preciso.
Vincular la validación a cada paso de manipulación
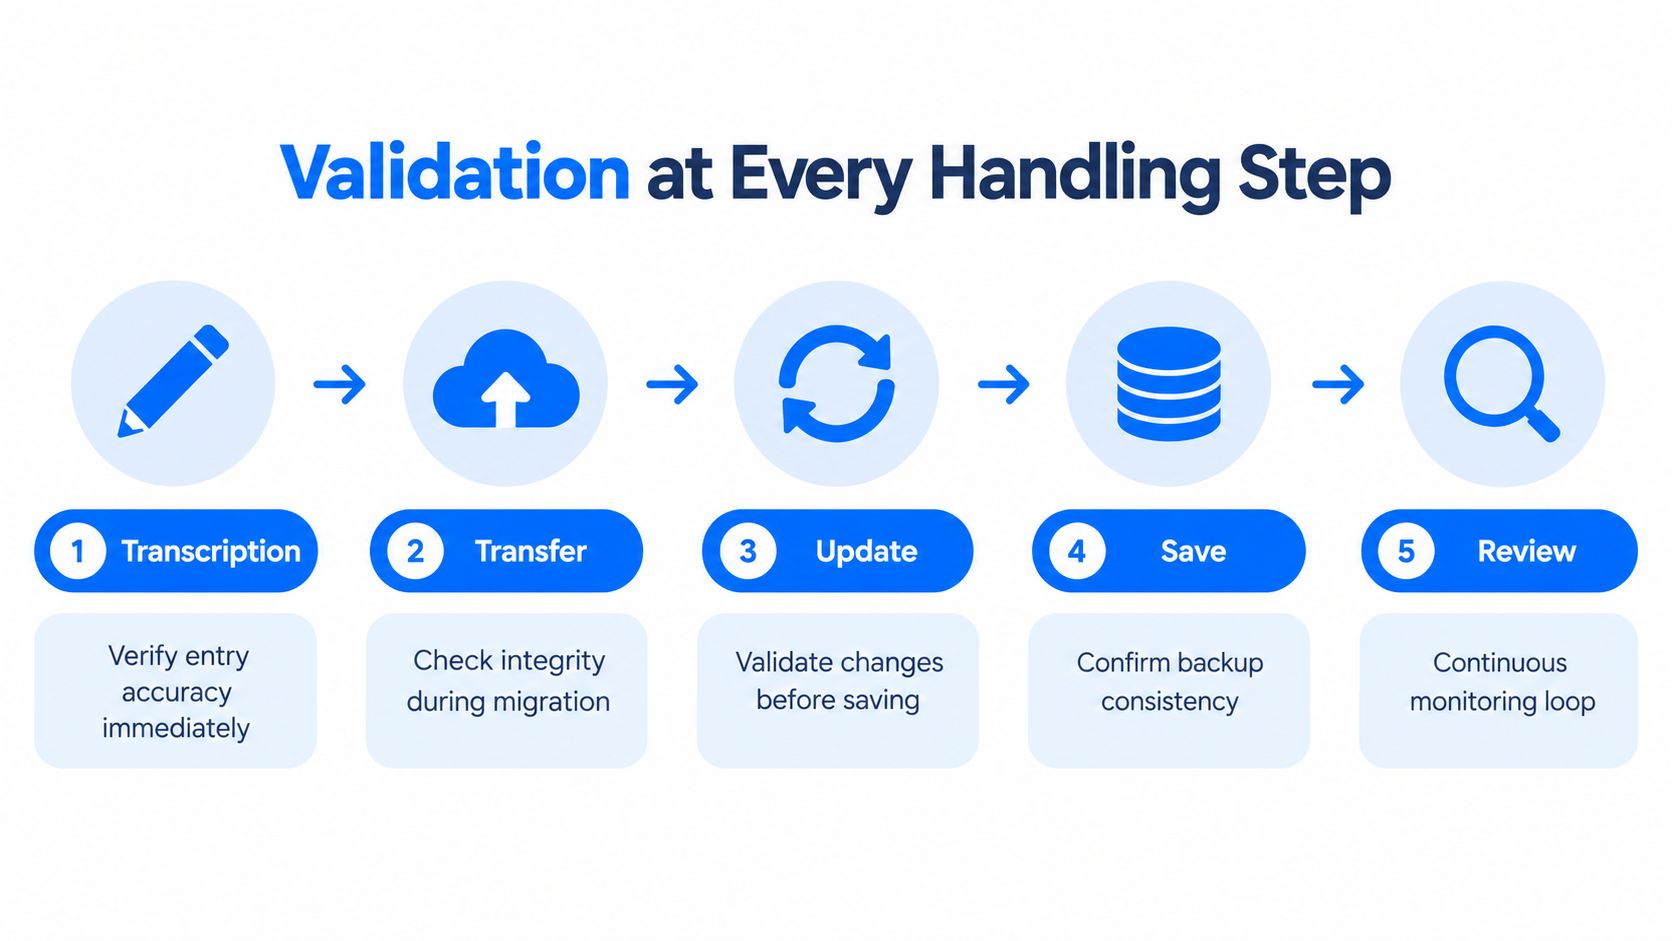
El control de calidad debe estar presente en cada punto en el que se manipulan los datos, no solo en una revisión final. Las directrices de investigación clínica son explícitas: la validación debe producirse cuando los datos se transcriben, se transfieren, se actualizan o se guardan en un nuevo soporte, y los procedimientos clásicos incluyen la doble entrada de datos, las comprobaciones programáticas de rango y coherencia, la revisión periódica de la tasa de errores y la revisión por parte de un responsable o compañero. El objetivo es la auditabilidad, porque cada paso de manipulación es un lugar donde se puede introducir u ocultar un error.
Un formulario en papel camino del análisis
Empiece por los formularios en papel. Durante la transcripción, una persona introduce el registro y otra verifica una muestra o realiza una doble entrada de los campos fáciles de teclear mal, como fechas o mediciones numéricas. Un sencillo registro de discrepancias se amortiza muy rápido en esta fase.
Cuando los datos pasan a una hoja de cálculo, aplique de inmediato comprobaciones de rango y reglas de coherencia. Una fecha de nacimiento en el futuro, un código de visita ausente o un valor de laboratorio fuera del dominio permitido deberían detener el archivo antes de que nadie empiece el análisis.
Cuando la hoja de cálculo se convierte en una base de datos de análisis, verifique la propia transferencia. Eso significa comparar el número de filas, los identificadores clave y cualquier campo vulnerable a truncamientos, recodificaciones o conversiones de tipo. Si la base de datos es el primer lugar donde aparece un problema, ya ha perdido la oportunidad de saber si el fallo se originó en la entrada o en la migración.
Tras las actualizaciones, someta los cambios a la revisión de un compañero o responsable. Esa revisión no tiene por qué ser ceremonial; tiene que responder a una sola pregunta: ¿ha preservado la actualización el significado del registro?
La página sobre reglas de validación y controles continuos es un buen ejemplo de cómo los equipos ponen en práctica estas salvaguardas en sistemas que funcionan a diario. La clave está en vincular el control al paso, porque un barrido periódico que se realiza después de tres traspasos ya llega tarde.
Un control que se realiza después de la transferencia es mejor que nada, pero no equivale a controlar la propia transferencia.
Umbrales medibles para el monitoreo de la calidad
El control de calidad se vuelve operativo cuando el equipo se pone de acuerdo en cifras, no en eslóganes. Umbrales defendibles, responsables designados y una cadencia de revisión fija convierten las métricas de calidad en controles. Un dashboard sin responsable de revisión no es más que papel pintado.
El muestreo sigue siendo importante. Las directrices de garantía de calidad respaldan límites estrictos sobre los que los equipos pueden actuar. A nivel de centro, no más del 5% de los participantes inscritos deberían incumplir los criterios de inclusión o exclusión, el reclutamiento debería mantenerse al menos en el 90% del objetivo a tiempo, la tasa de abandono debería ser igual o inferior al 5% y la tasa de errores de entrada de datos debería ser igual o inferior al 0,001%.
Métrica | Umbral | Cómo monitorizarla |
|---|---|---|
Verificación aleatoria frente a la fuente | 5% de los registros | Conciliar los registros seleccionados con los documentos fuente |
Incumplimientos de los criterios de inclusión o exclusión | No más del 5% en un centro | Revisar los registros de selección y las desviaciones del protocolo |
Avance del reclutamiento | Al menos el 90% del objetivo a tiempo | Seguir el reclutamiento frente a las fechas de los hitos previstos |
Tasa de abandono | No superior al 5% | Monitorizar los registros de retención y retirada |
Tasa de errores de entrada de datos | No superior al 0,001% | Comparar los valores introducidos con los campos fuente y registrar las discrepancias |
La cuestión no es recopilar estas medidas para admirarlas después. Se trata de revisarlas con un calendario fijo, asignar un responsable a cada umbral y dejar por escrito la vía de respuesta antes del primer incumplimiento. Ahí es donde ayuda una vista de monitoreo de la puntualidad, porque un control con retraso a menudo equivale a no tener ningún control.
Mantenga una respuesta proporcional al modo de fallo. Una pequeña serie de errores de entrada exige verificaciones selectivas, mientras que los incumplimientos repetidos en reclutamiento o retención suelen indicar que es el propio proceso el que tiene que cambiar. Si el umbral no desencadena una acción clara, es pura decoración.
Documentación de la procedencia y pistas de auditoría
La pregunta que hace un auditor nunca es abstracta. Suele ser: “¿De dónde sale este número?”. Si su respuesta depende de la memoria, de conversaciones paralelas y de una búsqueda entre exportaciones antiguas, el proceso todavía no es auditable. La documentación de la procedencia es el registro del origen, la manipulación y la transformación que le permite responder a esa pregunta sin tener que improvisar.
Un registro de procedencia defendible indica quién ha manipulado los datos, qué ha cambiado, cuándo ha cambiado y por qué. También conserva el valor original cuando se hace una corrección, porque el original suele ser la única forma de saber si una corrección era válida o simplemente conveniente. Esto es especialmente importante cuando varias personas han editado el mismo campo con distintas herramientas.
Qué debe contener la pista de auditoría
La estructura más limpia es sencilla. Mantenga archivos de datos bajo control de versiones, un registro de cambios vinculado a cada paso de manipulación, consultas por escrito sobre valores sospechosos o ausentes y una declaración explícita de los datos ausentes irrecuperables en el plan de análisis. Esas consultas por escrito son importantes porque convierten la incertidumbre en una decisión trazable en lugar de una excepción enterrada.
Las directrices de investigación sobre el control iterativo de la calidad de los datos son tajantes al respecto. Los equipos deberían realizar revisiones estadísticas sencillas durante la recogida, emitir consultas por escrito sobre valores sospechosos o ausentes e informar explícitamente de los datos ausentes irrecuperables en el plan de análisis (directrices sobre el flujo de trabajo iterativo). No se trata de una carga burocrática, sino de la forma de mantener la honestidad del análisis sobre lo que no se puede reparar.
Si no puede mostrar el camino desde la fuente hasta el análisis, no tiene una pista de auditoría, tiene una historia.
Un revisor que pregunte “¿de dónde sale este número?” debería poder ver el registro fuente, la transformación aplicada, la fecha del cambio y la persona que lo aprobó. Si la respuesta es un proyecto de reconstrucción, la pista es demasiado débil para un trabajo serio. La procedencia es lo que permite al equipo explicar el número en lugar de defender un recuerdo de él.
El papel de la IA en el control de calidad de los datos
La IA es útil en el control de calidad de los datos, pero solo dentro de un ámbito acotado. Puede sacar a la luz anomalías, agrupar registros sospechosos y detectar patrones difíciles de codificar como reglas, algo importante cuando el conjunto de datos es grande y la línea base es estable. También reduce el tiempo de triaje humano cuando funciona junto a la validación determinista en lugar de sustituirla. Para los equipos que construyen esa capa, cómo detecta la IA anomalías de datos en los pipelines de datos es el modelo adecuado que estudiar.
El riesgo es que la limpieza automatizada invente correcciones aparentemente plausibles que son erróneas. La literatura académica reciente señala una carencia real de benchmarks estandarizados para los sistemas de calidad de datos basados en LLM y advierte de que la limpieza automatizada puede introducir correcciones alucinadas. Trate la IA como un asistente del revisor, no como la autoridad que reescribe los registros por su cuenta.
Usos seguros y usos arriesgados
Entre los usos seguros se encuentran señalar anomalías para su revisión, priorizar registros para la inspección humana y sugerir posibles incidencias que una persona pueda confirmar. Entre los usos arriesgados se encuentran sobrescribir valores fuente sin informar de ello, resolver registros ambiguos sin la aprobación humana y actuar como único filtro para la publicación.
La salvaguarda es aburrida pero eficaz. Conserve los valores originales junto a cualquier corrección automatizada, revise por muestreo los registros señalados por la IA y documente el proceso de decisión de cada cambio aceptado. Guarde el valor original en una columna separada con la marca de tiempo de la transformación y el nombre de quien la aprobó, para que cada corrección siga siendo reversible y auditable. Si su equipo busca una visión más amplia de la gobernanza, el recurso sobre gobernanza y herramientas de datos con IA de MakeAutomation es un complemento útil, porque sitúa la IA dentro de los controles operativos y no del hype.
Para los equipos que quieren aplicar la IA sin renunciar al control, una plataforma como digna puede situarse en la capa de validación y anomalías, donde los controles siguen siendo inspeccionables y están vinculados a los datos subyacentes. Ese es el patrón correcto. La IA le ayuda a darse cuenta; las personas deciden.
Su lista de verificación para el control de calidad de los datos
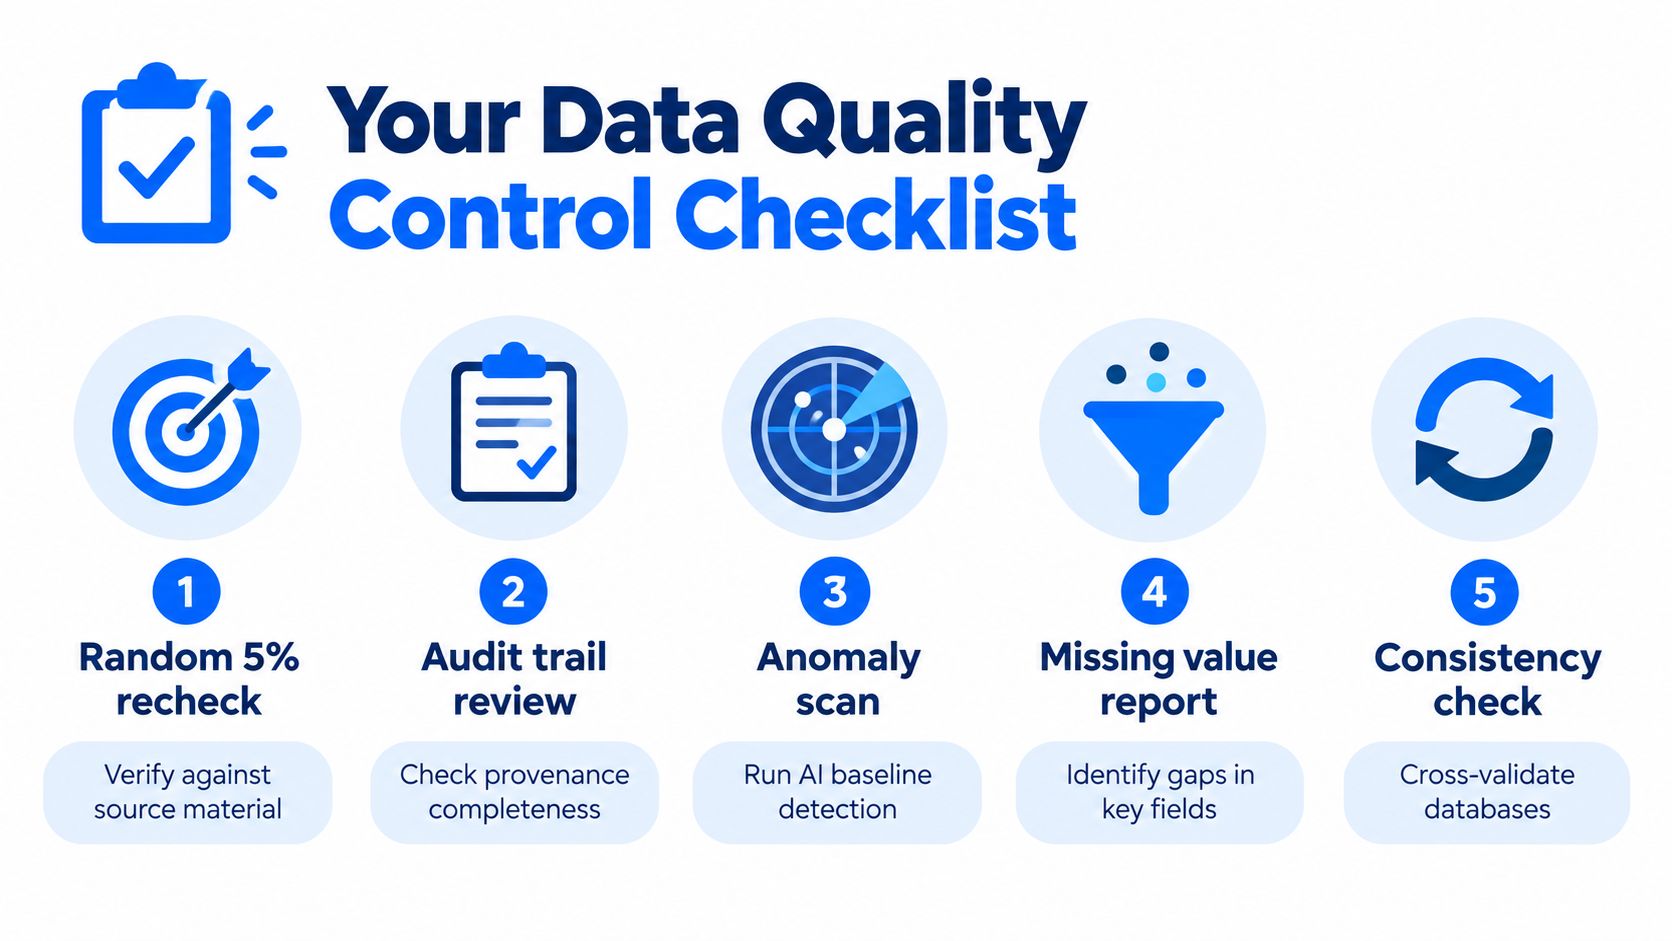
Una lista de verificación solo funciona si es lo bastante breve como para usarla durante el trabajo real y lo bastante estricta como para detectar la deriva antes de que empiece el análisis. Téngala en la mesa de trabajo, no en una presentación.
Verificación aleatoria frente a la fuente: verifique una muestra aleatoria del 5% frente al material fuente con un calendario semanal fijo, para detectar la deriva de transcripción mientras el archivo sigue abierto.
Validación en cada traspaso: vincule un control específico a la transcripción, la transferencia, la actualización, el guardado y la revisión. Una promesa genérica de “comprobarlo más tarde” no sobrevive a un pipeline con mucha actividad.
Responsable del umbral designado: asigne a una persona la revisión periódica de los umbrales de reclutamiento, abandono y errores de entrada. Las métricas solo cambian el comportamiento cuando alguien es claramente responsable de ellas.
Procedencia registrada: mantenga archivos bajo control de versiones, un registro de cambios y consultas por escrito sobre valores sospechosos o ausentes vinculadas a la transformación exacta. Así se pueden realizar auditorías posteriores sin reconstruir de memoria toda la cadena.
Correcciones de la IA revisadas: exija la revisión humana de los registros señalados por la IA, conserve el valor original y registre por qué se aceptó o rechazó una corrección.
Coherencia entre bases de datos: compare los campos clave entre sistemas para que los problemas de concordancia salgan a la luz antes de la publicación, no después.
Si busca un modelo operativo práctico, combine esta lista de verificación con una capa de control activa en lugar de con otra hoja de cálculo. Una configuración de gobernanza y herramientas de datos con IA puede mantener la validación a nivel de registro, la detección de anomalías, el monitoreo de la puntualidad y el seguimiento del esquema dentro del entorno donde ya residen los datos. digna encaja en ese tipo de ciclo de control cuando los equipos de investigación necesitan controles que sigan siendo inspeccionables y estén vinculados a los registros subyacentes.
Para los equipos que quieren que las comprobaciones de rango, coherencia y completitud descritas anteriormente se ejecuten automáticamente en cada traspaso en lugar de en un barrido periódico, digna Data Validation ejecuta reglas a nivel de registro dentro de la base de datos donde ya residen los datos de investigación.
Preguntas frecuentes
¿Cuáles son las cinco dimensiones de la calidad de los datos en la investigación?
Completitud, exactitud, concordancia, plausibilidad y actualidad. Juntas distinguen los valores ausentes de los valores erróneos, las discrepancias entre sistemas de las entradas imposibles y los registros obsoletos de los vigentes, lo que da al equipo de investigación un lenguaje común para describir qué ha encontrado realmente un control, en lugar de limitarse a decir que los datos parecen correctos.
¿Cuándo debe realizarse la validación de datos en un proyecto de investigación?
En cada punto en el que se manipulan los datos: cuando se transcriben, se transfieren, se actualizan o se guardan en un nuevo soporte. Los controles habituales incluyen la doble entrada de datos, las comprobaciones programáticas de rango y coherencia, la revisión periódica de la tasa de errores y la revisión de las actualizaciones por parte de un compañero o responsable, no solo un barrido final antes del análisis.
¿Qué umbrales de calidad se utilizan en la investigación clínica?
Las directrices del NINDS sugieren que no más del 5% de los participantes de un centro incumplan los criterios de inclusión o exclusión, que el reclutamiento alcance al menos el 90% del objetivo a tiempo, que la tasa de abandono sea igual o inferior al 5% y que la tasa de errores de entrada de datos sea igual o inferior al 0,001%, con una verificación aleatoria del 5% de los registros frente a los documentos fuente.
¿Qué debe contener la pista de auditoría de los datos de investigación?
Archivos de datos bajo control de versiones, un registro de cambios vinculado a cada paso de manipulación, consultas por escrito sobre valores sospechosos o ausentes y una declaración explícita de los datos ausentes irrecuperables en el plan de análisis. Debe mostrar quién cambió un valor, cuándo y por qué, y conservar el valor original junto a cualquier corrección.
¿Se puede confiar en la IA para limpiar datos de investigación?
Solo como asistente. La IA es útil para señalar anomalías y priorizar registros para su revisión humana, pero la limpieza automatizada puede inventar correcciones aparentemente plausibles que son erróneas. Conserve los valores originales junto a cualquier corrección, revise por muestreo los registros señalados por la IA y exija la aprobación humana antes de aceptar un cambio.



