Completo de los datos: Qué dice DAMA y cómo medirlo
|
6
minuto de lectura

El consejo más popular sobre la completitud de los datos es también el más engañoso: contar los valores NULL y dar el trabajo por terminado. ¿Qué es la completitud de los datos? Es el grado en que están presentes todos los datos requeridos para un propósito particular. Esa definición cambia la pregunta de “¿Hay celdas vacías?” a “¿Contiene este conjunto de datos lo que el proceso de negocio, informe, modelo o control necesita?”
Un campo completado aún puede contener el valor incorrecto, mientras que un NULL en un campo opcional puede no tener un impacto práctico. La completitud es, por lo tanto, una cuestión de idoneidad para el uso, no una exigencia de perfección abstracta. La guía de las Naciones Unidas sobre cobertura y completitud establece la misma distinción conceptual en las estadísticas oficiales, donde la completitud compara los eventos registrados con el total mundial que se pretende representar.
Índice de contenidos
Qué significa realmente la completitud de los datos
La completitud de los datos es el grado en que están presentes todos los datos requeridos para un propósito particular. En un conjunto de datos empresarial, eso puede significar atributos obligatorios completados, registros de negocio completos, volúmenes de registros esperados, períodos de informe requeridos o todos los conjuntos de datos de origen necesarios para un proceso posterior.
Por eso la completitud no es solo la ausencia de valores NULL. Supongamos que una tabla de clientes contiene un ID de cliente faltante. Eso es una falla de completitud cuando se requiere el identificador para uniones, conciliación o informes. Una preferencia de marketing secundaria faltante puede ser aceptable si el uso previsto no depende de ella.
La distinción también separa la completitud de otras dimensiones de calidad de datos. Si una dirección está presente pero es incorrecta, el problema es de precisión. Si un número de teléfono está presente pero infringe el formato requerido, el problema es de validez. La completitud solo pregunta si la información requerida existe dentro del alcance definido.
Comenzar con el propósito de negocio
Antes de elegir una métrica, identifique qué deben respaldar los datos:
Los informes regulatorios pueden requerir cada entidad reportable y atributo obligatorio.
El procesamiento operativo puede depender de identificadores, fechas y campos de estado.
La analítica puede tolerar la falta de atributos de enriquecimiento si la población principal sigue disponible.
El desarrollo de IA requiere suficientes campos, registros y períodos de tiempo para el análisis previsto, porque la falta de datos puede reducir el tamaño de la muestra analizable y producir estimaciones sesgadas o imprecisas, como se describe en esta revisión sobre datos faltantes alojada por el NIH.
Regla práctica: Defina qué significa “suficientemente completo” antes de medirlo. De lo contrario, un tablero reportará un número sin decirle a nadie si ese número respalda la decisión.
Una definición de trabajo útil es: los registros, campos, relaciones y períodos de entrega requeridos están presentes en el alcance y la cadencia esperados para un caso de uso definido. Esa definición les da a los propietarios de datos algo que pueden convertir en controles.
Los cinco tipos de completitud que vale la pena medir
Las organizaciones necesitan más de una perspectiva de completitud porque los valores faltantes y las poblaciones faltantes son fallas diferentes. Los cinco tipos a continuación cubren las necesidades comunes de monitoreo empresarial, aunque los equipos deben seleccionar la combinación que coincida con el requisito de negocio.
Completitud de atributos
La completitud de atributos pregunta si los campos requeridos están completados. Los ejemplos típicos incluyen:
ID de clientes faltantes
Fechas de transacciones faltantes
Números de cuenta faltantes
Atributos de negocio
NULLrequeridos por un informe o proceso
Puede existir un registro de cliente, pero si falta su identificador, el registro puede quedar inutilizable para deduplicación o uniones. La medida relevante es la proporción de registros esperados que contienen un valor en el atributo especificado.
Completitud de registros
La completitud de registros pregunta si cada registro disponible contiene todos los campos obligatorios a la vez. Una transacción puede tener un ID de transacción y un monto, pero carecer de su ID de cliente, moneda o fecha de transacción. Contar la fila como presente ocultaría el hecho de que el registro no está operativamente completo.
Completitud de recuento de registros
La completitud de recuento de registros compara la población entregada con la población esperada. Por ejemplo, una tabla de transacciones diarias que normalmente contiene 10 millones de registros pero que de repente contiene 7 millones de registros tiene un problema de completitud de población, incluso si cada fila entregada tiene campos perfectamente completados.
El artículo de investigación sobre calidad de datos de DAMA respalda esta visión más amplia al analizar la completitud en registros, archivos, atributos y metadatos.
Completitud temporal
La completitud temporal verifica si todas las fechas o períodos de informe esperados están presentes. Un pipeline financiero puede cargarse con éxito omitiendo un día, mes o partición de informe. La tabla puede contener filas válidas, pero la serie temporal está incompleta.
Completitud del conjunto de datos
La completitud del conjunto de datos pregunta si cada conjunto de datos requerido por un proceso posterior está disponible. Un flujo de trabajo de informes mensuales puede necesitar conjuntos de datos de clientes, transacciones, productos y tipos de cambio. Si una fuente no llega, las entradas del flujo de trabajo están incompletas, incluso cuando las otras tablas estén completadas.
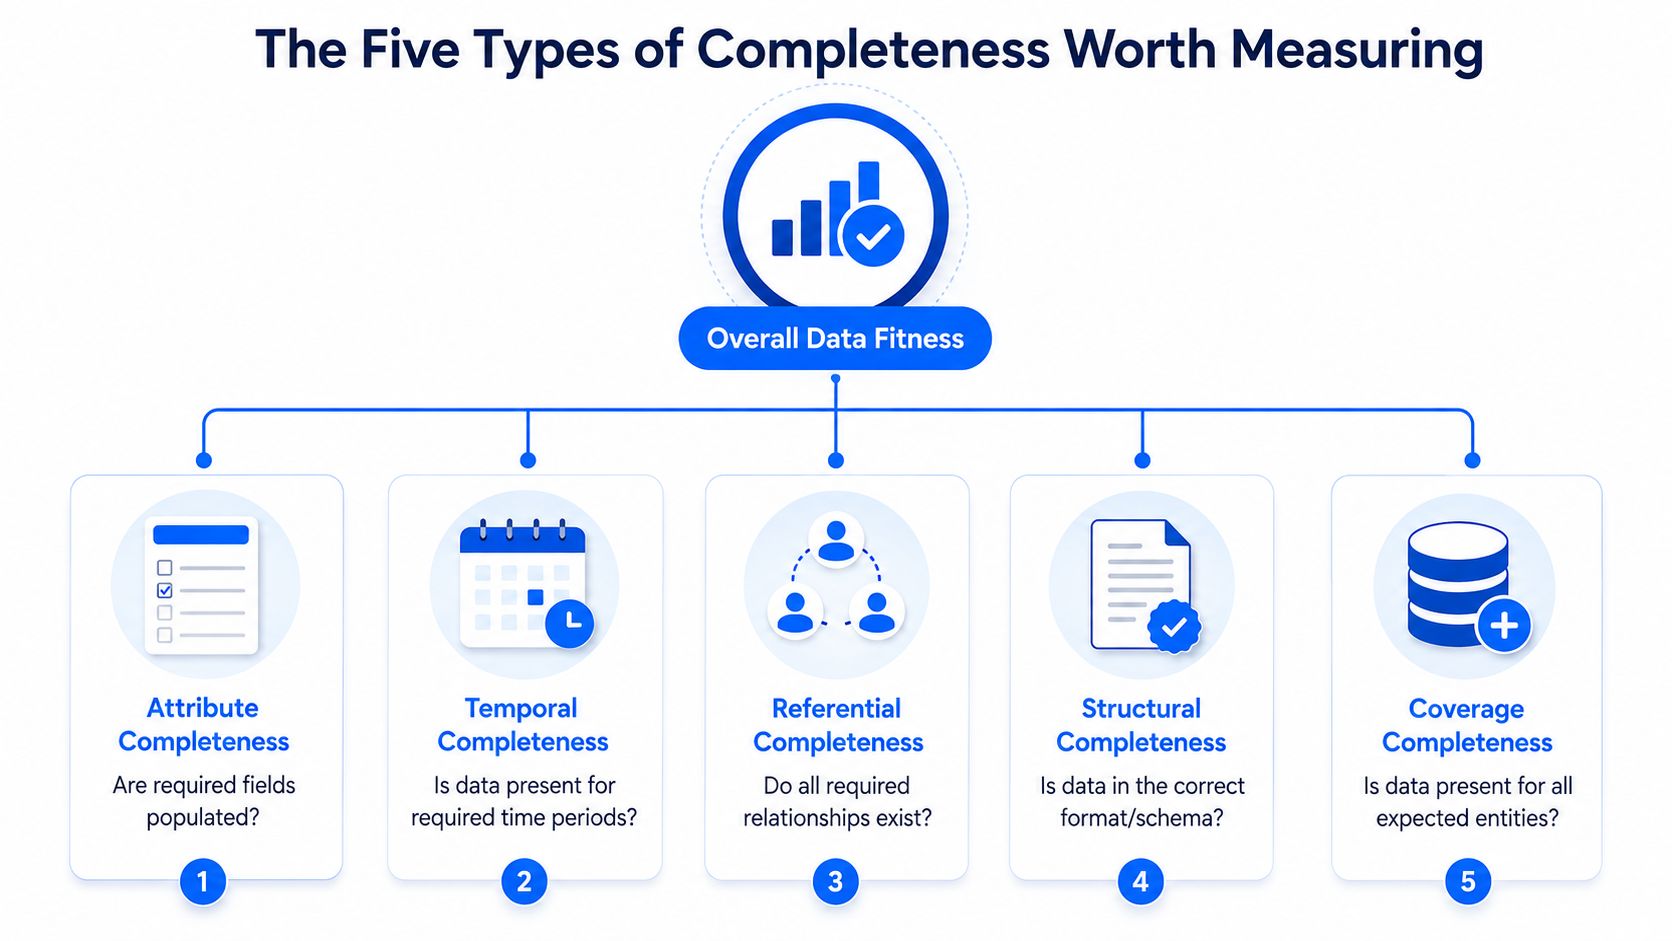
Estas comprobaciones no son intercambiables. Un equipo puede necesitar completitud de atributos y registros para un maestro de clientes, completitud de recuento de registros y temporal para transacciones, y completitud de conjuntos de datos para una dependencia de orquestación.
Cómo abordan DAMA y DMBOK la completitud
DAMA Internacional y la Edición Revisada DAMA-DMBOK® 2.0 tratan la completitud como una dimensión de la calidad de los datos. El marco es más útil cuando los equipos aplican la completitud en relación con los requisitos de negocio y la idoneidad para el uso, en lugar de tratarla como una puntuación técnica universal. El resumen de los marcos de gestión de datos y DAMA proporciona un contexto relacionado para posicionar la calidad de los datos dentro de prácticas de gestión más amplias.
El enfoque de DAMA se alinea con una pregunta práctica: ¿qué se debe saber para que estos datos cumplan su función prevista? La guía de calidad de datos del Gobierno del Reino Unido establece que los datos están completos cuando todos los datos requeridos para un uso particular están presentes, y aconseja medir la completitud para los datos críticos en lugar de para cada campo de cada conjunto de datos.
Eso significa que el 100% de completitud no es automáticamente el requisito correcto para cada conjunto de datos. Una tasa de completitud del 98% podría ser aceptable para un caso de uso analítico pero inaceptable para informes regulatorios. Esos valores ilustran una decisión de governance, no umbrales universales.
Establecer requisitos según el impacto
Una política útil conecta la completitud con las consecuencias:
Identificar el informe, modelo, proceso o control que consume los datos.
Definir los registros y atributos sin los cuales no puede operar.
Establecer un umbral de completitud aceptable con el propietario de los datos.
Documentar qué sucede cuando no se alcanza el umbral.
Revisar el requisito cuando cambie el caso de uso.
Una clave primaria, un atributo regulatorio o un identificador de transacción suelen merecer un tratamiento más estricto que un enriquecimiento descriptivo opcional. La contribución de DAMA es el vocabulario y la disciplina para hacer explícita esa distinción. No reemplaza las decisiones de propiedad locales.
Métricas y fórmulas para medir la completitud
Las métricas de completitud de datos deben medir la falta de información que puede afectar a un caso de uso definido. Un modelo de medición sólido combina indicadores a nivel de campo, registro, población, tiempo y conjunto de datos en lugar de depender de un único recuento de nulos.
La fórmula básica es:
Tasa de completitud = valores requeridos presentes / valores requeridos esperados × 100
Para la completitud de atributos, los “valores requeridos presentes” es el número de registros con un valor en el campo seleccionado. Para la completitud de registros, el numerador cuenta los registros que contienen cada atributo obligatorio. Para la completitud de población, compare los registros entregados con la población de registros esperada. El denominador debe reflejar la definición de negocio de los datos esperados, no simplemente el número de filas que llegaron.
Medidas principales
Tasa de NULL: La proporción de registros donde falta un campo seleccionado. Ayuda a localizar brechas a nivel de campo, pero no revela registros o conjuntos de datos faltantes.
Cobertura de campos obligatorios: La proporción de valores esperados que están presentes para los atributos obligatorios.
Recuentos de registros: El número de registros entregados para una carga, partición, entidad o período definido.
Varianza del recuento de registros: La diferencia entre el volumen observado y el esperado, utilizando una línea base documentada o una conciliación de origen.
Disponibilidad del conjunto de datos: Si cada origen, tabla, archivo o partición requerido está presente.
Cobertura temporal: Si están representadas todas las fechas y períodos de informe requeridos.
Tendencias de completitud: El movimiento de cada medida a lo largo del tiempo, lo que ayuda a distinguir un incidente aislado de un deterioro progresivo.
Métrica | Qué mide | Uso típico |
|---|---|---|
Tasa de NULL | Valores faltantes en un atributo seleccionado | ID de cliente o número de cuenta requerido |
Cobertura de campos obligatorios | Valores obligatorios presentes frente a valores esperados | Controles operativos y regulatorios |
Recuento de registros | Población de filas entregadas | Monitoreo de lotes y flujos de eventos |
Varianza del recuento de registros | Diferencia respecto al volumen esperado | Detección de pérdida de filas o cargas incompletas |
Cobertura temporal | Presencia de los períodos requeridos | Finanzas, operaciones y análisis de series temporales |
Disponibilidad del conjunto de datos | Presencia de las fuentes de datos requeridas | Comprobación de dependencias posteriores |
Tendencia de completitud | Cambio en la completitud a lo largo del tiempo | Análisis de problemas recurrentes y desviaciones del proceso |
La guía de métricas de calidad de datos de digna ofrece contexto adicional para seleccionar medidas. La decisión importante de governance es priorizar los atributos y poblaciones críticos. Medir cada campo por igual genera ruido y puede hacer que una brecha grave sea más difícil de detectar.
Cómo difiere la completitud de la precisión y la validez
La completitud pregunta si los datos requeridos están presentes. La precisión pregunta si son correctos. La validez pregunta si siguen las reglas o el formato requerido. Estas dimensiones pueden fallar de forma independiente, por lo que los equipos deben evitar asignar una etiqueta genérica de “problema de calidad” a las tres por igual.
Considere el número de teléfono de un cliente:
Completitud: ¿Hay un número de teléfono presente cuando el negocio lo requiere?
Validez: ¿El valor sigue el formato de número de teléfono aceptado?
Precisión: ¿El valor coincide con el número de teléfono real del cliente?

Completitud y precisión
Un número de teléfono faltante es un problema de completitud. Un número de teléfono correctamente formateado que pertenece a otro cliente es un problema de precisión. El campo está presente en ambos casos, pero solo un valor representa correctamente a la entidad del mundo real.
La explicación de Dataversity sobre las dimensiones de calidad de datos describe la completitud como la medición de qué información falta, no de si la información almacenada es precisa o válida. Esta separación es importante porque la remediación difiere. Los datos faltantes pueden requerir completarse en el sistema de origen o un reprocesamiento, mientras que los datos inexactos pueden requerir verificación, corrección o administración de datos maestros.
Completitud y validez
Un número de teléfono faltante está incompleto. Un número de teléfono que contiene letras cuando el esquema requiere un patrón numérico es inválido. Un número de teléfono correctamente formateado pero incorrecto es inexacto.
Pregunta | Dimensión | Ejemplo |
|---|---|---|
¿Está presente el valor requerido? | Completitud | Falta el número de teléfono |
¿Se ajusta a la regla? | Validez | El número de teléfono tiene un formato inválido |
¿Coincide con la realidad? | Precisión | El número pertenece a otra persona |
La distinción de IBM entre completitud, precisión y validez refuerza este modelo de tres preguntas. Utilícelo al asignar propietarios, diseñar pruebas y explicar incidentes a las partes interesadas del negocio.
Monitoreo de la completitud en pipelines modernos
Un pipeline técnicamente exitoso no necesariamente produce datos completos. Considere un almacén que recibe diariamente datos de clientes y transacciones: la tarea ETL finaliza, la orquestación reporta éxito y la tabla de destino está disponible, pero el volumen de transacciones es significativamente menor de lo normal y los ID de clientes requeridos muestran un aumento abrupto en los valores NULL.
El estado de un solo pipeline no puede detectar ambas condiciones. La primera es un problema de recuento de registros o de población. La segunda es de completitud de atributos. El diseño del monitoreo debe examinar los datos después de la entrega, no solo si el código se ejecutó sin errores.

Utilizar controles por capas
La validación determinista verifica requisitos conocidos, como que un ID de cliente obligatorio no sea
NULL.La detección de anomalías identifica cambios inesperados en el volumen de registros, tasas de nulos, distribuciones o comportamiento de entrega.
La analítica histórica muestra si la desviación es aislada, estacional, recurrente o parte de un deterioro más prolongado.
El monitoreo de puntualidad verifica si los datos esperados llegaron en el momento y la cadencia requeridos.
En este escenario, las comprobaciones de completitud de datos para pipelines empresariales se pueden organizar en torno a la pérdida de filas, pérdida de campos, registros faltantes y campos faltantes. El control también debe identificar la partición de origen o la entrega responsable de la brecha, de modo que los ingenieros puedan investigar en lugar de simplemente observar un estado en rojo.
Una ejecución exitosa de ETL demuestra que el proceso se realizó. No demuestra que los datos de negocio requeridos hayan llegado.
La continuidad es importante porque la completitud cambia con el tiempo. Un conjunto de datos limpio hoy puede volverse incompleto tras el lanzamiento de un sistema de origen, un cambio en el filtro de extracción, una partición retrasada o el traspaso de un flujo de trabajo. El monitoreo continuo hace que la condición sea visible cerca del momento en que cambia.
¿Cómo puede digna apoyar la completitud de los datos?
digna respalda la completitud de los datos a través de capacidades diferenciadas para reglas explícitas, comportamiento inusual y contexto histórico. Cada capacidad aborda una capa diferente, por lo que un equipo no debe tratar un módulo como un sustituto completo para todos los controles de completitud.
digna Data Validation
digna Data Validation admite requisitos conocidos basados en reglas, que incluyen:
Los campos requeridos no deben ser
NULL.Cada transacción debe tener un identificador requerido.
Los atributos de negocio obligatorios deben estar completados.
Se deben cumplir las reglas de completitud definidas.
Esta es la capacidad principal para los requisitos que se pueden declarar directamente y evaluar registro por registro.
digna Data Anomalies
digna Data Anomalies puede identificar cambios inesperados en el comportamiento relacionado con la completitud, como aumentos repentinos en las tasas de NULL, caídas inesperadas en los recuentos de registros, cambios significativos en la distribución y desviaciones inusuales de los volúmenes de datos históricos.
La detección de anomalías identifica comportamientos inusuales. No demuestra automáticamente que los datos estén incompletos. Un cambio estacional legítimo puede parecer inusual, mientras que una falla sutil de completitud puede mantenerse dentro de un patrón histórico amplio. Los equipos aún necesitan contexto de negocio y, cuando corresponda, reglas de validación explícitas.
digna Data Analytics
digna Data Analytics proporciona contexto histórico para las métricas de completitud. Los equipos pueden examinar tendencias de recuento de registros, tendencias de tasas de NULL, completitud histórica, patrones recurrentes de datos faltantes y cambios entre períodos de informe.
Requisito de completitud | Ejemplo | Capacidad de digna |
|---|---|---|
Valores requeridos | El campo requerido no debe ser | Data Validation |
Volumen de registros | Número esperado de registros | Data Anomalies |
Completitud histórica | Detectar deterioro a lo largo del tiempo | Data Analytics |
Disponibilidad del conjunto de datos | La fuente de datos esperada está presente | Data Validation / Data Anomalies |
El mapeo es deliberado. La validación impone condiciones conocidas, las anomalías revelan comportamientos inesperados y la analítica ayuda a determinar si un problema es aislado o recurrente.
Puntos clave y preguntas frecuentes
La completitud de los datos es una condición de negocio en constante cambio, no una comprobación estática de nulos. Defina los datos requeridos para cada caso de uso, mida la capa relevante y monitoree si los registros, atributos, períodos y conjuntos de datos continúan llegando según lo esperado.
¿Qué es la completitud de los datos?
Es el grado en que están presentes todos los datos requeridos para un propósito particular. El alcance depende de la idoneidad para el uso.
¿Cuáles son los tipos de completitud de los datos?
Los tipos comunes incluyen completitud de atributos, de registros, de recuento de registros, temporal y de conjuntos de datos. Cada uno aborda un riesgo diferente de datos faltantes.
¿Cómo se mide la completitud de los datos?
Utilice medidas como la tasa de NULL, la cobertura de campos obligatorios, los recuentos de registros, la varianza del recuento de registros, la disponibilidad del conjunto de datos, la cobertura temporal y las tendencias de completitud.
¿Qué dice DAMA sobre la completitud de los datos?
DAMA-DMBOK trata la completitud como una dimensión de la calidad de los datos y relaciona los requisitos con las necesidades del negocio y la idoneidad para el uso.
¿Se requiere siempre el 100% de completitud de los datos?
No. El 100% no es universalmente adecuado. El requisito debe reflejar las consecuencias de la falta de datos para el uso previsto.
¿Cuál es la diferencia entre completitud y precisión?
La completitud pregunta si el valor requerido está presente. La precisión pregunta si ese valor es correcto.
¿Cuál es la diferencia entre completitud y validez?
La completitud se refiere a la presencia. La validez se refiere a la conformidad con formatos, reglas o estándares definidos.
¿Cómo se puede monitorear continuamente la completitud de los datos?
Combine la validación basada en reglas, el monitoreo de registros y entregas, la detección de anomalías y el análisis histórico en pipelines por lotes, en tiempo real y cruzados entre sistemas.
¿Qué módulos de digna apoyan la completitud de los datos?
digna Data Validation, digna Data Anomalies y digna Data Analytics admiten diferentes necesidades de completitud. Deben asignarse al control específico en lugar de tratarse como intercambiables.
digna proporciona capacidades de Data Validation, Data Anomalies y Data Analytics para verificar los valores requeridos, identificar comportamientos inusuales de registros y tasas de nulos, y analizar la completitud a lo largo del tiempo. Visite digna para ver cómo estos controles pueden integrarse en su enfoque de monitoreo de la calidad de los datos.


