Cómo medir la precisión de los datos: 8 métodos prácticos
|
9
minuto de lectura

La exactitud se mide comparando los datos con una expectativa de confianza o realidad sobre el terreno, y luego reforzando esa comparación con la validación, la conciliación, el muestreo, la detección de anomalías y el análisis histórico. Para conjuntos de datos críticos, un punto de referencia práctico define la exactitud como registros correctos ÷ registros totales × 100, con un objetivo sugerido de al menos el 98% para datos críticos, aunque el umbral adecuado depende del riesgo comercial y del caso de uso (marco práctico de Acceldata).
El consejo popular es realizar unas pocas comprobaciones de nulos, confirmar que las fechas utilizan el formato correcto y calificar el conjunto de datos como exacto cuando la canalización se pone en verde. Ese enfoque mide la completitud y la validez, no necesariamente la verdad. La dirección de un cliente puede estar completa y correctamente formateada y, aun así, ser incorrecta. El importe de una transacción puede superar la validación técnica y diferir del importe cobrado. Una fecha como el 31 de diciembre de 2099 puede ser sintácticamente válida pero inexacta como fecha de nacimiento de un cliente.
La Exactitud de los Datos es el grado en que los datos representan correctamente el objeto, evento o valor del mundo real que describen. El nivel requerido depende del uso previsto. Una pequeña discrepancia puede ser tolerable en un análisis exploratorio, pero inaceptable en los informes financieros, los registros de atención médica, los datos regulatorios o una decisión automatizada.
Una evaluación rigurosa separa el sesgo, la precisión, la incertidumbre, la validez, la razonabilidad, la oportunidad y el cambio estructural. La ciencia de la medición describe la exactitud a través de la cercanía a un valor verdadero o de referencia, mientras que el sesgo refleja la desviación sistemática y la precisión refleja la dispersión de mediciones repetidas (guía del National Physical Laboratory). Los métodos siguientes tratan la exactitud como evidencia acumulada de que los datos reflejan la realidad, no como una puntuación única universal.
Índice de contenidos
8. Estrategia integrada de monitoreo de exactitud multimétodo
Comparación de 8 métodos: Medición de la exactitud de los datos
Convertir las comprobaciones de exactitud en evidencia continua
1. Comparación con fuentes de datos de confianza
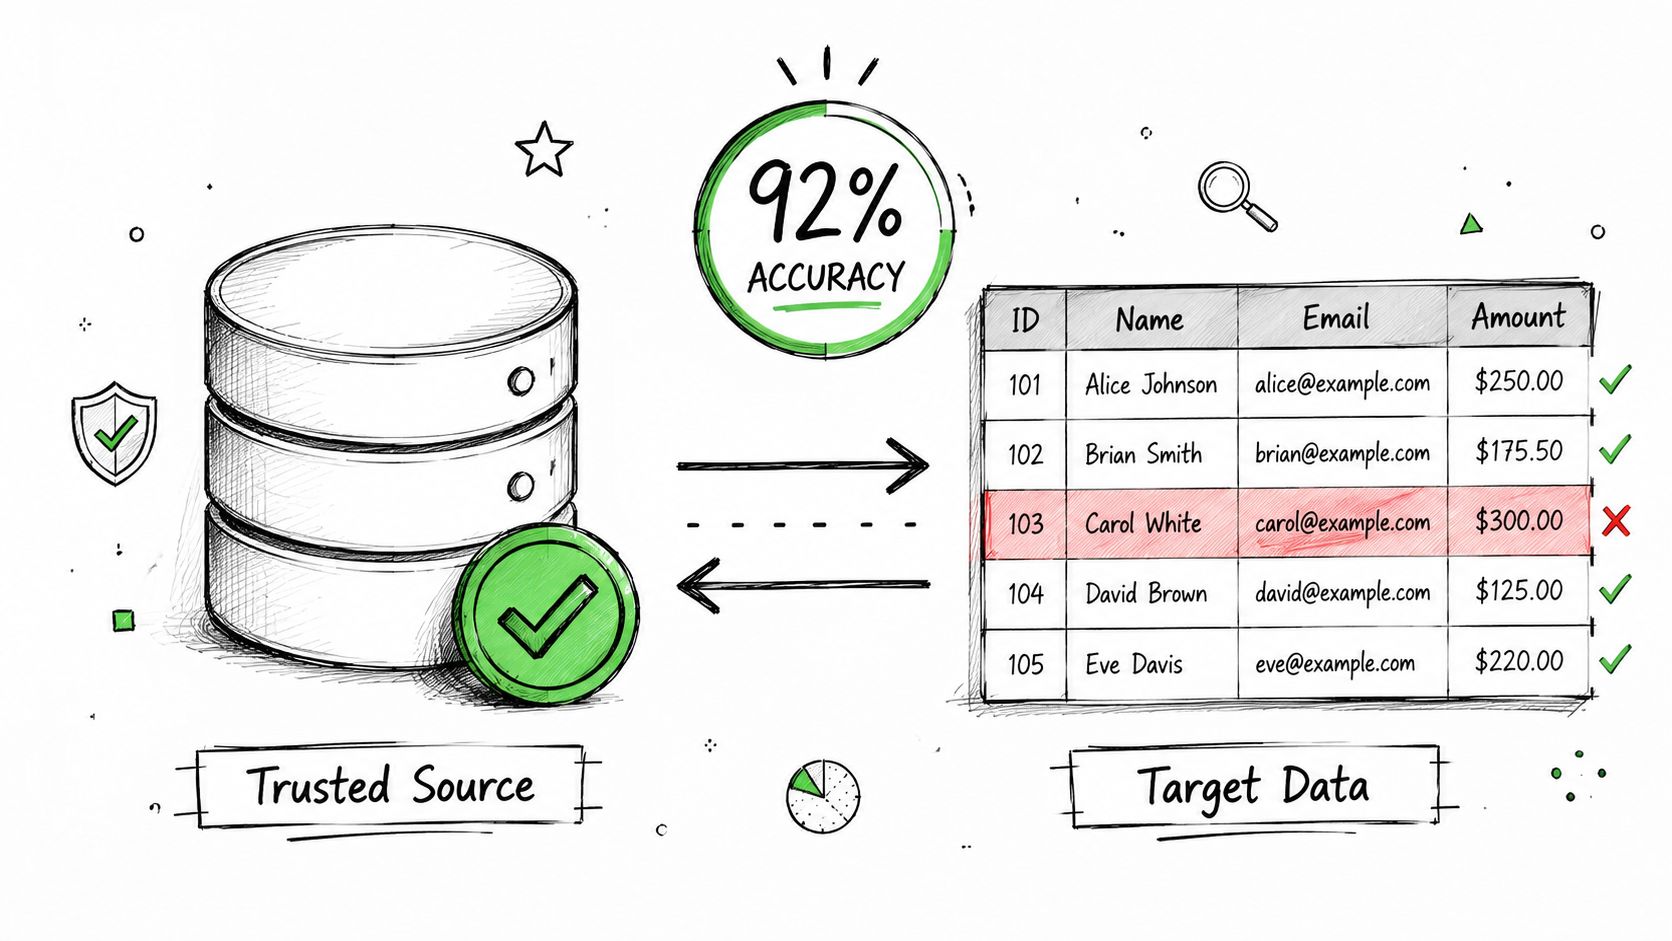
La comparación directa proporciona la evidencia inicial más sólida cuando una fuente tiene autoridad y controles definidos. Un conjunto de datos de un almacén se puede verificar con una base de datos maestra de clientes, un precio de análisis con un sistema de precios aprobado y un monto de informe con un registro de transacciones verificado. La pregunta es específica: ¿coincide el valor registrado con la referencia utilizada para representar el objeto, evento o valor esperado?
Una medida básica es:
Tasa de exactitud = registros que coinciden correctamente ÷ registros evaluados × 100
Esta tasa solo tiene sentido después de que el equipo define qué es una "coincidencia". La igualdad exacta puede ser adecuada para un identificador de transacción o un precio de producto aprobado. Una dirección puede requerir normalización, mientras que un campo de estado puede necesitar una regla de fecha de vigencia porque los sistemas se actualizan en momentos diferentes. Por lo tanto, el resultado mide la concordancia bajo un método de comparación establecido, no la exactitud en todos los sentidos posibles.
Definir la referencia antes de calcular
Registre la fuente de confianza, el propietario, la frecuencia de actualización, los campos dentro del alcance, la clave de coincidencia y la ventana de tiempo aceptable. Una carga de almacén que va brevemente por detrás de un sistema maestro puede reflejar una latencia de procesamiento normal en lugar de un valor incorrecto. Una referencia también puede contener registros obsoletos o sesgados, por lo que su autoridad debe estar respaldada por controles en lugar de asumirse.
Regla práctica: Una comparación demuestra la concordancia con la referencia seleccionada. No demuestra que la referencia en sí misma represente el objeto, evento o valor subyacente, a menos que esa fuente tenga sus propios controles de calidad.
Las aplicaciones incluyen:
Identidad del cliente: Compare las direcciones del almacén con el registro maestro del CRM y registre si la coincidencia es exacta, normalizada o basada en la fecha de vigencia.
Informes financieros: Compare los montos de las transacciones en una base de datos de informes con el sistema bancario de origen.
Gobernanza de productos: Verifique los precios de análisis con la referencia de precios aprobada.
Ciclo de vida del cliente: Verifique los campos de estado con los registros comerciales autorizados.
Los equipos pueden usar digna Data Reconciliation para automatizar las comparaciones periódicas de origen a destino, investigar las coincidencias fallidas y realizar un seguimiento de si las discrepancias son aisladas o persistentes. Establezca umbrales de aceptación de acuerdo con las consecuencias comerciales. No siempre se requiere una coincidencia perfecta, mientras que una pequeña discrepancia puede ser inaceptable para un campo de alto impacto.
2. Validación de reglas de negocio
Las reglas de negocio convierten una expectativa de exactitud en una prueba determinista. El total de una factura debe ser igual a sus partidas individuales más los impuestos. El descuento de un cliente debe mantenerse dentro del límite para ese nivel de cliente. El costo de un producto no debe exceder su precio de venta aprobado. Cada regla produce evidencia auditable de que se mantiene una relación definida.
El método es útil porque su alcance es explícito. Una comprobación fallida identifica la expectativa que se infringió y, a menudo, aísla el registro, campo o transformación afectados. La validación de reglas se adapta a campos críticos, controles de cumplimiento, métricas calculadas y relaciones que se pueden evaluar sin un juicio subjetivo.
Una regla aprobada demuestra la conformidad con la lógica codificada en esa regla. No establece que el valor subyacente refleje la realidad. Una factura internamente coherente aún puede mostrar un importe cobrado incorrecto, y una cantidad de inventario no negativa aún puede diferir del recuento físico. Como lo ilustra el consejo de detección de fraude en odómetros, superar las comprobaciones de formato no garantiza que un valor refleje la condición del mundo real.
Diseñe reglas con personas que comprendan el proceso que representan. Para cada regla, documente los campos protegidos, la justificación comercial, la respuesta ante fallas y las condiciones bajo las cuales una excepción es legítima. Pruebe las reglas con registros históricos para establecer el comportamiento esperado, luego revíselas cuando cambien los productos, las políticas, los estados o las transformaciones.
digna Data Validation admite comprobaciones a nivel de registro mediante valores, rangos, umbrales, datos de referencia y condiciones comerciales. Los equipos pueden usar esas comprobaciones para hacer cumplir expectativas explícitas a escala, al tiempo que conservan los detalles de las fallas para su investigación.
Un conjunto de controles prácticos debería dar prioridad a:
Métricas críticas: Comience con los ingresos, los saldos, los campos regulados y las medidas operativas.
Propiedad del negocio: Haga que las partes interesadas del dominio aprueben las reglas y las excepciones documentadas.
Resultados trazables: Almacene los registros fallidos, las razones exactas de las fallas, las versiones de las reglas y el estado de la investigación.
Cobertura en capas: Combine la validación determinista con la comparación de fuentes de confianza y señales de anomalías.
La cobertura de las reglas debe monitorearse como parte de la canalización, no tratarse como una configuración terminada. Una regla puede continuar ejecutándose con éxito mientras se vuelve incompleta porque el proceso comercial ha cambiado. Esa limitación es la razón por la cual la validación contribuye con una clase de evidencia dentro de una estrategia de monitoreo de exactitud más amplia.
3. Conciliación entre sistemas
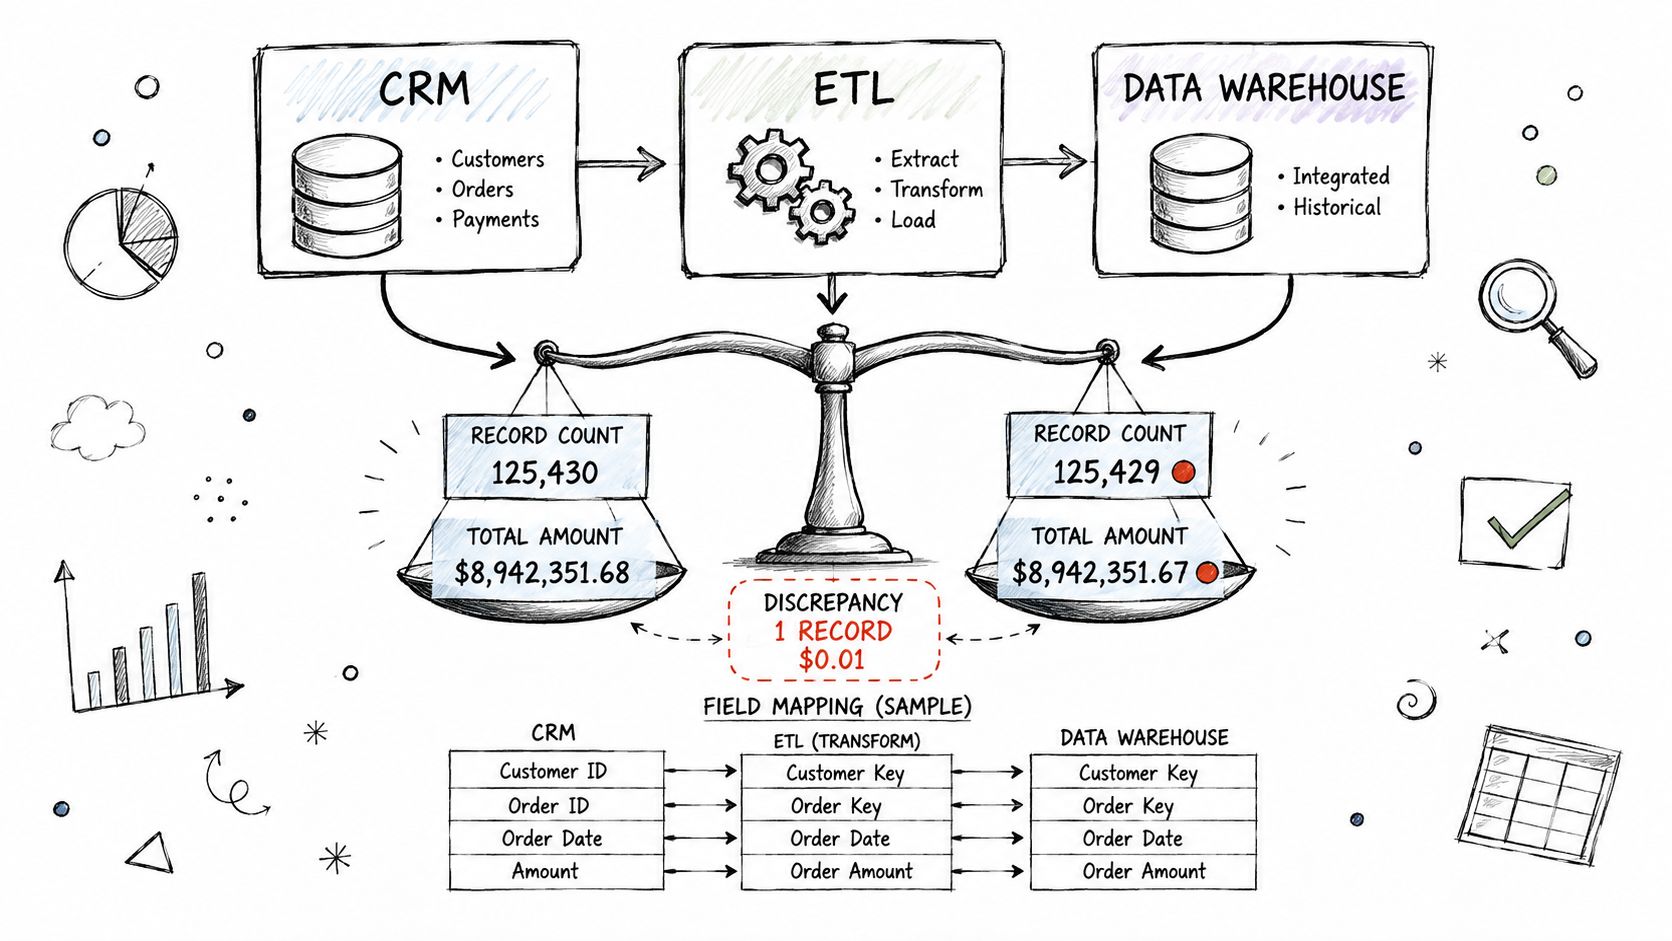
La conciliación entre sistemas comprueba si una transformación preservó la información requerida de manera descendente. Compara registros entre un sistema de origen y otro de destino, en lugar de verificar si los campos individuales utilizan formatos válidos. La comparación puede abarcar recuentos, agregados, métricas comerciales y perfiles estadísticos.
Una canalización financiera muestra por qué esto es importante. El origen puede contener registros de transacciones, mientras que un almacén almacena datos de informes transformados. Ambos sistemas pueden contener fechas válidas y montos no nulos, pero el total del almacén puede diferir porque los registros se filtraron, duplicaron, truncaron o transformaron incorrectamente.
La conciliación debe funcionar en varios niveles. Las comprobaciones a nivel de registro identifican entidades faltantes o inesperadas. Las comprobaciones agregadas comparan los totales de las transacciones, los ingresos, los saldos u otras medidas aprobadas. Las comprobaciones de perfil examinan las distribuciones y las frecuencias de los valores que un solo total podría ocultar.
Establezca una ventana de conciliación que tenga en cuenta la latencia conocida y los retrasos de procesamiento. Defina las tolerancias, las condiciones de alerta, la propiedad y los pasos de resolución antes de que ocurran discrepancias. Una diferencia que supere la tolerancia debería crear un registro de investigación con suficiente contexto para el diagnóstico.
Los controles útiles incluyen:
Recuentos: Compare los números de registro de origen y de destino después de aplicar los filtros documentados.
Agregados: Compare sumas, promedios y otras métricas comerciales aprobadas.
Cobertura: Confirme que los registros de facturas o de clientes esperados lleguen a los sistemas descendentes.
Comportamiento de las tendencias: Realice un seguimiento de las diferencias recurrentes para separar los incidentes aislados de los defectos de transformación sistémicos.
Utilice digna Data Reconciliation para admitir comparaciones periódicas entre conjuntos de datos de origen y de destino. El resultado es evidencia de consistencia, no una prueba de que cada valor sea exacto. Una fuente puede estar desactualizada o ser incorrecta, y los totales que coinciden pueden ocultar errores de compensación. Documente qué sistema proporciona la expectativa de confianza y cuándo debe estar actualizado cada sistema, luego combine los resultados de la conciliación con la validación, las señales de anomalías y la revisión humana.
4. Análisis estadístico, histórico y detección de anomalías
Un valor puede satisfacer cada regla predefinida y, aun así, comportarse de manera diferente al proceso que representa. El análisis estadístico e histórico agrega contexto al examinar las distribuciones, las tendencias, la volatilidad, los tiempos y las desviaciones recurrentes. La detección de anomalías amplía ese enfoque al identificar cambios inesperados que los equipos tal vez no hayan codificado como reglas.
Suponga que el valor promedio de las transacciones aumenta un 300% de la noche a la mañana. Eso no demuestra que los datos sean incorrectos. El cambio podría reflejar una decisión de precios legítima, una gran compra de un cliente o un evento comercial. No obstante, crea una señal de alta prioridad porque el comportamiento observado difiere notablemente del patrón establecido.
Investigar las desviaciones, no etiquetarlas automáticamente
Las señales útiles incluyen cambios repentinos en las distribuciones de edad de los clientes, variaciones inusuales en los precios de los productos, cambios inesperados en el recuento de transacciones y patrones de ingresos que se apartan del comportamiento histórico. Los equipos deben monitorear los recuentos, agregados, distribuciones y tiempos de manera conjunta porque una métrica aislada puede ocultar la forma de un problema.
digna's statistical methods for data analysis pueden respaldar el análisis de tendencias, volatilidad y comportamiento histórico. El aprendizaje de la línea base impulsado por IA puede ayudar a revelar desviaciones sin requerir que cada umbral se configure manualmente, pero la línea base aún necesita contexto operativo.
Una anomalía es evidencia de que el comportamiento cambió. No es evidencia, por sí misma, de que el valor modificado sea inexacto.
Comience con un período de preparación que le brinde al sistema suficiente comportamiento histórico para modelar la variación normal. Ajuste la sensibilidad durante campañas conocidas, migraciones, eventos estacionales o actualizaciones del sistema. Registre la explicación cuando una anomalía sea legítima. Esa decisión mejora el triaje futuro y evita que los equipos traten cada observación inusual como un defecto de datos.
El análisis estadístico también ayuda a distinguir la exactitud de la incertidumbre. La Organización para la Alimentación y la Agricultura explica que la exactitud analítica no se puede cuantificar directamente e implica errores aleatorios y sistemáticos, mientras que los errores estándar y los intervalos de confianza comunican la incertidumbre en torno a las mediciones (metodología de calidad de datos de la FAO). Un patrón estable aún puede estar sistemáticamente sesgado.
5. Comparación de datos de referencia
La comparación de datos de referencia comprueba si un campo coincide con una lista externa aprobada, una tabla maestra o un vocabulario controlado. Proporciona evidencia de validez, especialmente para campos categóricos y dimensionales, pero por sí misma no establece la exactitud. Un valor puede seguir el formato esperado y, aun así, ser inadecuado para el contexto comercial.
Por ejemplo, un campo de país puede contener un código de dos letras correctamente formateado que no es aceptado. Una categoría de producto puede estar poblada y ser única mientras apunta a una rama obsoleta de la jerarquía de productos. Un código de departamento puede existir en un registro incluso después de que el departamento haya sido eliminado de los datos maestros de la organización.
Preservar el estado de referencia aplicable
Los datos de referencia cambian. Las listas de monedas, las tasas de impuestos, las jerarquías de productos, las estructuras organizativas y las tablas de estado pueden agregar, eliminar o renombrar valores. Almacene la versión de referencia y la fecha de vigencia utilizadas para cada validación. De lo contrario, los registros históricos pueden juzgarse frente a un estado comercial posterior, lo que produce fallas falsas u oculta discrepancias legítimas.
Aplique la verificación a campos como:
Códigos de país: Compare los valores de los clientes con el estándar de códigos de país ISO 3166.
Taxonomía de productos: Haga coincidir los códigos de categoría con la jerarquía aprobada.
Monedas: Valide los códigos de moneda de las transacciones con una lista oficial de monedas.
Estructura organizativa: Compare los códigos de departamento de los empleados con los datos maestros actuales.
Estados: Verifique los valores de estado de las transacciones con la tabla de estados definida.
El resultado demuestra que un valor coincide con una referencia aceptada. No demuestra que la referencia sea adecuada para la fecha de la transacción, ni que el registro de origen refleje la realidad. Agregue fechas de vigencia, excepciones documentadas y pistas de auditoría cuando los datos de referencia respalden informes regulados.
La comparación de referencias también refuerza la validación de las reglas de negocio. Una regla puede requerir que exista un departamento, mientras que la verificación de referencia determina si su código está aprobado. Si la referencia cambia, actualice el control y registre el cambio. Esto mantiene la capa de validación alineada con el negocio en lugar de tratar una búsqueda obsoleta como evidencia de exactitud.
6. Muestreo y Verificación Manual
Las comprobaciones automatizadas son eficientes, pero la verificación manual expone tipos de errores que las reglas y las comparaciones pueden pasar por alto. Los equipos seleccionan registros representativos y los verifican con facturas, sistemas de origen, confirmaciones de clientes, investigaciones u otra evidencia del estado del mundo real.
Una muestra puede incluir registros de clientes cuyas direcciones se verifican con registros comerciales autorizados, registros de transacciones comparados con facturas de origen o precios de productos sospechosos revisados frente a documentos aprobados. El resultado no es solo una tasa de aprobación. También revela si los errores provienen de datos obsoletos, lógica de transformación, ingreso manual, defectos del sistema de origen o una definición poco clara de la verdad.
Diseñar la muestra deliberadamente
La selección aleatoria puede estimar condiciones generales, mientras que la estratificación garantiza que los registros de alto riesgo o de alto valor reciban atención. Documente la población, el método de selección, la evidencia de verificación, el revisor, la fecha, los criterios de decisión y la clasificación de errores. Los métodos de muestreo estadístico pueden ayudar a determinar el tamaño de muestra adecuado, pero el método debe coincidir con el riesgo y el uso previsto.
La verificación manual debe validar el control automatizado, no simplemente repetirlo.
Utilice el muestreo para desafiar las suposiciones detrás de las tasas de exactitud automatizadas. Si una comparación de fuentes informa una sólida concordancia, las comprobaciones manuales pueden probar si la supuesta fuente es actual y autorizada. Si la detección de anomalías marca registros inusuales, una revisión específica puede determinar si esos registros reflejan eventos comerciales legítimos.
La revisión humana también crea evidencia cualitativa. Los revisores pueden descubrir que lo "correcto" depende de las fechas de vigencia, el consentimiento del cliente, las convenciones geográficas o las excepciones comerciales que no estaban representadas en el modelo de datos. Esos hallazgos deben incorporarse nuevamente a las reglas, los datos de referencia, la lógica de conciliación y los umbrales de monitoreo.
El muestreo requiere mucha mano de obra, así que prográmelo en torno a conjuntos de datos críticos y áreas de riesgo conocidas. Realice un seguimiento de los patrones de error recurrentes en lugar de tratar cada registro revisado como un evento aislado. Con el tiempo, la organización aprende qué comprobaciones automatizadas merecen expandirse y qué señales generan demasiadas excepciones legítimas.
7. Completitud y Timeliness como Indicadores de Exactitud
La exactitud es la evidencia de que los datos entregados reflejan la realidad. La completitud y la Timeliness no demuestran que los valores individuales sean verdaderos, pero comprueban si el conjunto de datos representa a la población relevante en el momento requerido. Los registros faltantes, los campos críticos omitidos o las cargas retrasadas pueden hacer que los valores correctos no sean adecuados para el uso previsto.
Un conjunto de datos de transacciones diarias puede contener registros exactos y, sin embargo, llegar después de la fecha límite de presentación de informes. El informe describe únicamente los registros recibidos, no el estado comercial disponible cuando se requerían las decisiones. Una carga maestra de clientes que excluye a los clientes recién creados crea una vista parcial exacta y puede inducir a error en los análisis descendentes.
Realice un seguimiento de la cobertura y la entrega como señales operativas independientes:
Comportamiento de llegada: Compare las horas de entrega con el cronograma establecido para identificar cargas tardías, faltantes o inesperadamente tempranas.
Cobertura: Compare los registros entregados con la población esperada o el recuento de la fuente de confianza.
Campos críticos: Mida la población para los campos utilizados en uniones, cálculos, decisiones de elegibilidad o resultados regulatorios.
Puntos de cambio: Investigue los cambios bruscos de cobertura después de un cambio de origen, esquema o canalización.
Defina las brechas aceptables antes de que comience el monitoreo. Se puede esperar una carga incremental tardía durante el mantenimiento planificado, mientras que un retraso inexplicable puede indicar una falla en el origen o en la canalización. Las comprobaciones de cobertura también necesitan un denominador claro. Un recuento de registros por sí solo no puede mostrar si la población faltante se concentra en un segmento de alto impacto.
La capacidad de Timeliness de digna monitorea los patrones de llegada y los tiempos de entrega esperados. El Schema Tracker detecta cambios estructurales, incluidas las columnas agregadas o eliminadas y los tipos de datos modificados. Estas señales no establecen la verdad a nivel de valor. Sin embargo, pueden identificar cuándo un proceso de exactitud que antes era confiable ya no es seguro, lo que genera una comparación de fuentes, una validación de reglas o una revisión específica.
La guía de calidad de datos ubica la exactitud junto con la completitud, la consistencia, la confiabilidad y la oportunidad (guía de calidad de datos del gobierno canadiense). Tratar estas dimensiones de manera conjunta brinda a los equipos una evidencia más sólida de la idoneidad de los datos: los valores deben ser correctos, la cobertura debe coincidir con la población prevista y la información debe llegar a tiempo para respaldar su uso.
8. Estrategia integrada de monitoreo de exactitud multimétodo
El modelo operativo más sólido combina los métodos en lugar de pedirle a una sola puntuación que cargue con todo el peso. La comparación con la fuente de confianza comprueba la concordancia con un estado esperado. La validación empresarial comprueba la lógica explícita. La conciliación comprueba el movimiento a través de los sistemas. La detección de anomalías y el análisis histórico comprueban el comportamiento. El muestreo comprueba si las suposiciones automatizadas sobrevivieron al contacto con la evidencia real.
Una canalización de informes financieros muestra cómo funcionan juntas las capas. El sistema de origen contiene datos de transacciones y el almacén respalda los informes. Los campos obligatorios se completan y la canalización finaliza, pero el total del almacén difiere de la fuente de confianza.
La investigación puede proceder de la siguiente manera:
Conciliar las métricas de origen y destino para identificar la discrepancia y su alcance.
Validar las reglas de negocio para montos de transacciones, fechas, identificadores y campos calculados.
Inspeccionar anomalías para determinar si los valores o recuentos afectados cambiaron inesperadamente.
Usar análisis históricos para identificar cuándo comenzó la desviación y si se repite.
Muestrear registros seleccionados con la evidencia de origen para clasificar el error.
Comprobar la oportunidad y los cambios de esquema para cargas tardías, cambios estructurales o comportamiento alterado de la canalización.
Mapear los métodos al riesgo
Los datos de atención médica pueden necesitar monitoreo de completitud, validación de referencias, detección de anomalías y revisión manual periódica. La facturación de telecomunicaciones puede requerir conciliación de ingresos, reglas de cobro, análisis de patrones de uso y monitoreo de cambios estructurales. Los datos del sector público pueden requerir versiones de referencia trazables, validación repetible y registros de investigación listos para auditorías.
Utilice el impacto comercial para decidir por dónde empezar. Mapee cada elemento de datos crítico con su expectativa de confianza, reglas, comprobaciones de conciliación, señales de comportamiento, plan de muestreo y ruta de escalada. Correlacionar los hallazgos entre los métodos ayuda a los equipos a distinguir un registro local defectuoso de una falla en toda la canalización.
Una plataforma como digna puede integrar Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness y Schema Tracker en un flujo de trabajo de monitoreo compartido. La plataforma se ejecuta en el entorno del cliente y realiza análisis en la base de datos, lo que permite que los datos permanezcan en su lugar mientras los ingenieros, analistas y equipos de gobernanza revisan los incidentes y las tendencias.
Comparación de 8 métodos: Medición de la exactitud de los datos
Método | Complejidad de implementación 🔄 | Requisitos de recursos y mantenimiento ⚡ | Resultados esperados 📊⭐ | Casos de uso ideales 💡 | Ventajas clave ⭐ |
|---|---|---|---|---|---|
Comparación con fuentes de datos de confianza | Media, lógica de mapeo y coincidencia; mantener la fuente de confianza | Moderado, cómputo para grandes conjuntos; mantenimiento continuo de la fuente | Altas tasas de exactitud medibles; evidencia clara de discrepancias | Datos estructurados con maestros autorizados (CRM, precios, finanzas) | Identificación objetiva y escalable de discrepancias a nivel de campo |
Validación de reglas de negocio | Baja–Media, formalizar y versionar reglas | Baja–Media, redacción de reglas y mantenimiento por parte de las partes interesadas | Auditorías claras de aprobado/reprobado; sólida evidencia de cumplimiento | Procesos regulados y comprobaciones deterministas (facturas, descuentos) | Auditable, eficiente para encontrar violaciones sistemáticas de reglas |
Conciliación entre sistemas | Media–Alta, mapeo, ventanas de tiempo, conocimiento de la canalización | Media, integraciones, comparaciones programadas, cómputo | Detecta pérdida/corrupción de datos; valida la integridad de extremo a extremo | Canalizaciones ETL multisistema, sistemas financieros y de informes | Revela errores de transformación/transferencia con evidencia de remediación |
Análisis estadístico, histórico y detección de anomalías | Media, aprendizaje de línea base y ajuste de modelos | Baja–Media, datos históricos, experiencia en análisis | Revela valores atípicos, tendencias y señales de degradación gradual | Monitoreo de tendencias, alerta temprana sobre problemas novedosos, nuevos conjuntos de datos | Detección adaptativa de problemas que las reglas/comprobaciones de referencia pasan por alto |
Comparación de datos de referencia | Baja, comprobaciones basadas en búsquedas; gestionar versiones de referencia | Baja–Media, gestión y actualización de datos de referencia | Garantiza la consistencia y comparabilidad categórica/dimensional | Códigos estándar/maestros (códigos ISO, tasas de impuestos, jerarquías de productos) | Aplica estándares; evita errores de agregación/clasificación |
Muestreo y verificación manual | Baja complejidad pero alto esfuerzo operativo 🔄 | Alto, requiere mucha mano de obra, personal capacitado, escala limitada ⚡ | Evidencia cualitativa y de alta confianza para los registros muestreados 📊 | Auditorías, validación de comprobaciones automatizadas, prueba regulatoria | Encuentra tipos de errores que los métodos automatizados pasan por alto; contexto de causa raíz |
Completitud y Timeliness como indicadores de exactitud | Bajo–Medio, definir cronogramas y líneas base 🔄 | Bajo, herramientas de monitoreo; establecer umbrales; programación opcional con IA ⚡ | Alerta temprana de datos faltantes/retrasados; mejora la confianza en los datos 📊 | Canalizaciones con SLA, informes operativos, datos sensibles al tiempo | Detección proactiva de problemas de entrega de la canalización |
Estrategia integrada de monitoreo de exactitud multimétodo | Alta, coordinar múltiples técnicas y ajustes 🔄 | Alto, múltiples módulos, integración, mantenimiento continuo ⚡ | Cobertura integral, respuesta más rápida a incidentes, listo para auditorías 📊⭐ | Dominios críticos (finanzas, salud, telecomunicaciones, sector público) | Múltiples líneas de evidencia; detecta diversos escenarios de exactitud |
Convertir las comprobaciones de exactitud en evidencia continua
Ninguna puntuación de exactitud única demuestra que los datos reflejen la realidad en todos los contextos. Un porcentaje de registros coincidentes puede ocultar una fuente de referencia sesgada. Una puntuación de validación puede mostrar que los registros siguen las reglas comerciales mientras se pasa por alto un defecto de transformación. Una conciliación puede exponer una discrepancia sin explicar si el origen, el destino o la ventana de tiempo es responsable.
La respuesta práctica es construir una cadena de evidencia. Comience por definir el uso previsto y el nivel de error que la empresa puede aceptar. Establezca la expectativa de confianza, ya sea que eso signifique un sistema maestro, datos de referencia aprobados, un registro de transacciones verificado o una observación documentada del mundo real. Luego defina qué constituye una coincidencia y registre el tiempo, la versión, la propiedad y las excepciones detrás de esa decisión.
Codifique las expectativas más importantes como reglas deterministas. Las reglas deben proteger las métricas críticas, las obligaciones de cumplimiento, las relaciones y los cálculos. Pruebelas con datos históricos, conserve los registros fallidos y las razones exactas de las fallas, y revíselas a medida que cambien los productos, las políticas, los esquemas y los procesos comerciales.
Concilie las métricas de origen y destino en los puntos donde se mueven los datos. Compare recuentos, agregados, cobertura y perfiles, teniendo en cuenta la latencia de procesamiento conocida. Una discrepancia no es automáticamente una prueba de que el destino sea inexacto, sino que es evidencia de que la canalización requiere investigación.
Utilice la detección de anomalías y el análisis histórico para proporcionar un contexto que las comprobaciones explícitas no pueden proporcionar. Un cambio repentino puede revelar un error en el sistema de origen, una transformación rota, una deriva del esquema o un evento comercial legítimo. Los analistas deben documentar la explicación, no simplemente cerrar la alerta. Ese historial mejora el triaje futuro y ayuda a los equipos a ajustar las líneas base sin suprimir cambios significativos.
La verificación manual sigue siendo importante para los datos de alto riesgo y para probar si los controles automatizados miden lo correcto. El muestreo puede revelar sesgos sistemáticos, definiciones de referencia poco claras y categorías de error que ninguna regla existente captura. Trate los hallazgos como información para el diseño del monitoreo.
La oportunidad, la completitud y los cambios de esquema actúan como alertas tempranas. Un conjunto de datos tardío o parcial puede ser exacto para los registros que contiene, pero poco confiable para la decisión que respalda. Un cambio estructural puede invalidar la lógica descendente sin producir un error obvio a nivel de campo. El monitoreo de estos indicadores junto con las comprobaciones de exactitud brinda a los equipos una visión más realista de la idoneidad de los datos.
digna respalda este flujo de trabajo basado en evidencia a través de Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness y Schema Tracker. Los equipos pueden comenzar con conjuntos de datos de alto impacto, establecer umbrales basados en el negocio, documentar investigaciones y ampliar la cobertura a medida que evolucionan los requisitos y los riesgos observados.
La evidencia independiente de los usuarios también muestra por qué la medición técnica debe combinarse con la percepción de las partes interesadas. En una encuesta de usuarios de 2023, el 72% de los usuarios calificó la exactitud de los datos estadísticos como buena o muy buena, con una puntuación promedio de 4.03, mientras que otra encuesta informó solo un 29.39% de satisfacción con la calidad de los datos (Resultados de la Encuesta de satisfacción del usuario de 2023). El contraste demuestra que un conjunto de datos técnicamente aceptable y un conjunto de datos de confianza no siempre son lo mismo.
Mida la concordancia con la realidad, pruebe la lógica que la respalda, investigue el cambio de comportamiento y preserve la evidencia detrás de cada decisión. Así es como los equipos de datos pasan de un indicador de canalización verde a datos que pueden utilizar de manera responsable.
digna proporciona calidad de datos y observabilidad en el entorno a través de Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness y Schema Tracker. Visite digna para ver cómo su equipo puede convertir las comprobaciones de exactitud de los datos en evidencia continua en almacenes, lagos y canalizaciones.


