Guía de confiabilidad y arquitectura de canalizaciones de datos ETL
|
7
minuto de lectura

Un estudio comparativo de 2026 reveló que el 97 % de los líderes sénior de datos y tecnología afirma que los fallos en las canalizaciones han ralentizado las iniciativas de analítica o IA, con una exposición empresarial mensual media de unos 3 millones de dólares (cobertura de StorageNewsletter sobre el estudio comparativo). Eso cambia la forma en que evalúo una canalización de datos ETL. La pregunta no es si un trabajo se completó. Es si la canalización entregó datos confiables, a tiempo, con suficiente evidencia para explicar qué sucedió cuando algo cambió.
Una canalización ETL a menudo se trata como plomería. En una empresa, se comporta más como un servicio de producción. Tiene dependencias, expectativas de servicio, modos de fallo, procedimientos de recuperación y consumidores que pueden tomar decisiones financieras, operativas o regulatorias a partir de sus resultados. Por lo tanto, el trabajo de confiabilidad no es un mantenimiento en los márgenes. Es parte del producto de datos.
Tabla de contenidos
Por qué las canalizaciones ETL siguen siendo importantes en 2026
Comprensión de los componentes principales de la arquitectura ETL
Fallos comunes en las canalizaciones y cargas de mantenimiento
Por qué las canalizaciones ETL siguen siendo importantes en 2026
El costo empresarial de un incidente en la canalización rara vez aparece en el programador. Una tarea fallida puede parecer un solo estado en rojo, pero las consecuencias pueden incluir paneles desactualizados, conciliaciones demoradas, entrenamiento de modelos interrumpido, investigación manual y decisiones tomadas a partir de información incompleta. El estudio comparativo citado anteriormente reveló que los fallos en las canalizaciones ya están ralentizando los programas de analítica e IA en los equipos de liderazgo sénior, lo que convierte a la Observability en una prioridad comercial en lugar de una función de panel.
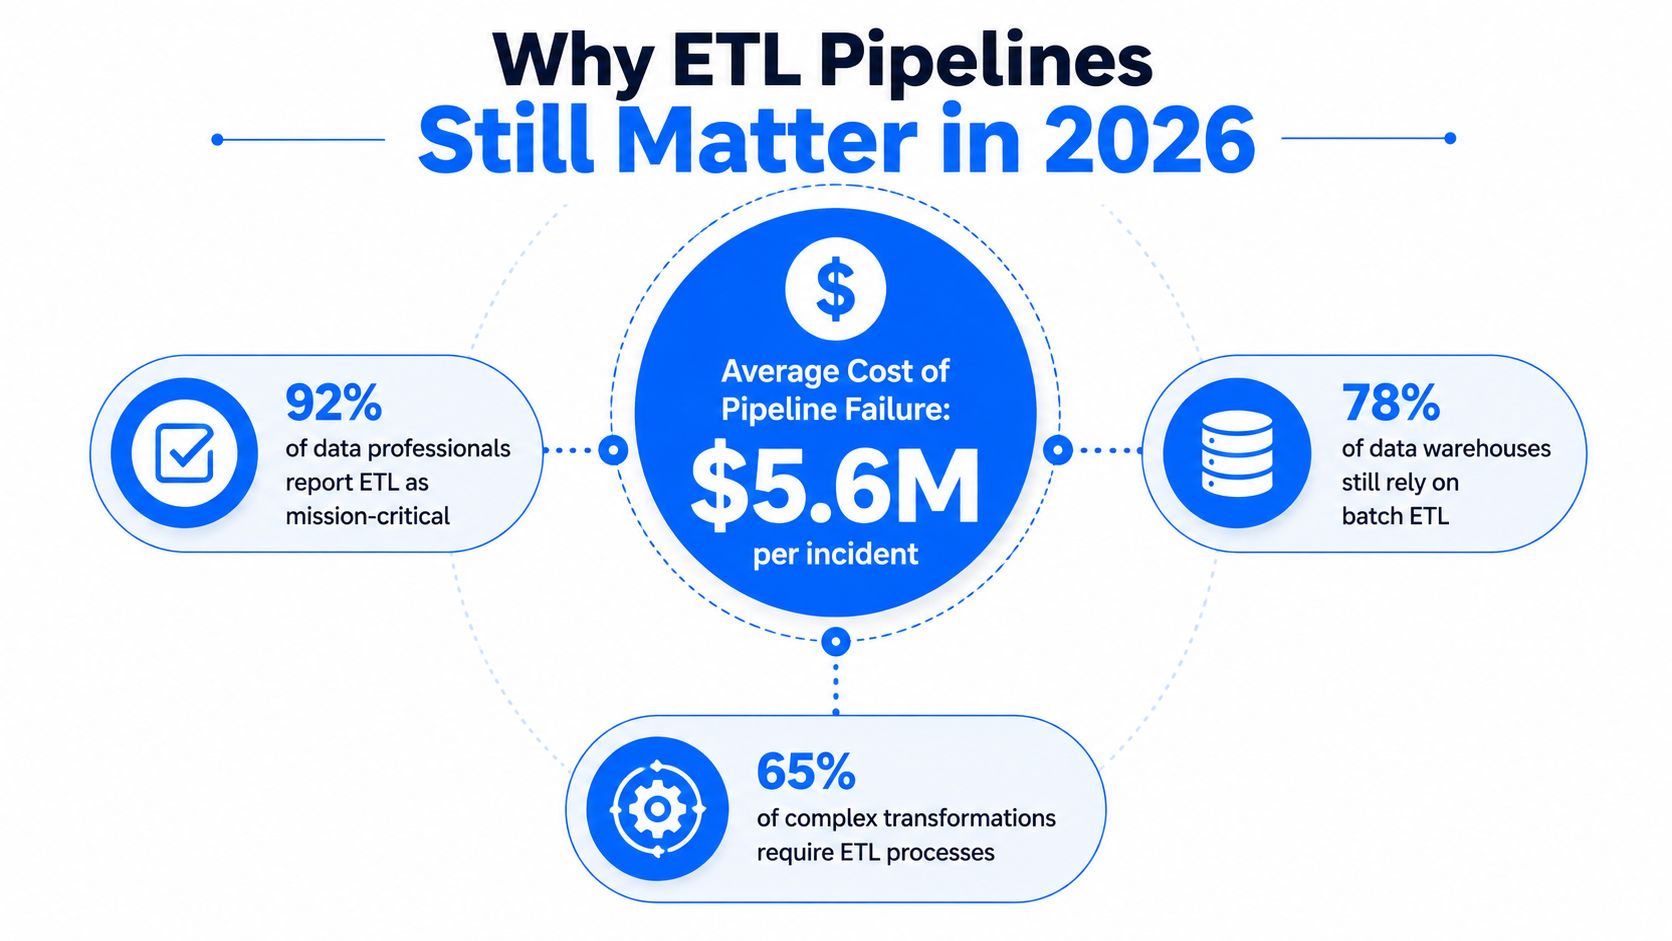
La imagen incluye afirmaciones que no forman parte de los datos verificados disponibles para este artículo, incluido el costo de fallo indicado y los porcentajes en las burbujas de estadísticas circundantes. Esas cifras no deben usarse como evidencia. El estudio comparativo verificado respalda una conclusión diferente, que sigue siendo urgente: los fallos en las canalizaciones generan alrededor de 3 millones de dólares en exposición empresarial mensual promedio para las organizaciones representadas en el informe (StorageNewsletter).
ETL sigue siendo fundamental
ETL se convirtió en un patrón de datos empresarial principal a principios de la década de 1990, a medida que los almacenes de datos se integraban en la analítica convencional. En esa época surgieron productos de integración dedicados, como Prism Solutions, fundada en 1988, Informatica, fundada en 1993, y DataStage en el mismo período. Para 1995, se había fundado el Data Warehousing Institute, lo que refleja la rapidez con la que el movimiento de datos impulsado por almacenes se convirtió en una categoría distinta de software empresarial (resumen histórico del almacén de datos).
El patrón persiste porque muchas organizaciones todavía necesitan que las transformaciones estén controladas, sean reproducibles y auditables antes de que los datos lleguen a los sistemas analíticos. Los entornos de finanzas, atención médica, telecomunicaciones y del sector público a menudo no pueden tratar los datos de origen estructurados como confiables de inmediato. Necesitan mapeos definidos, evidencia de validación, lógica de conciliación, controles de acceso y ejecuciones repetibles.
ELT y el streaming han ampliado el espacio de diseño, pero no han eliminado ETL. Una plataforma moderna puede usar la captura de datos modificados para una fuente, ETL por lotes para un libro de contabilidad regulado, ELT para modelos de almacén exploratorios y streaming para eventos urgentes. La arquitectura sensata es la que coincide con el riesgo de datos, los requisitos de latencia, la ubicación del cómputo, las obligaciones de governance y la capacidad de recuperación.
Para obtener detalles de implementación, los equipos pueden utilizar las mejores prácticas de canalización de datos de digna junto con sus estándares existentes de orquestación y governance. El objetivo práctico es simple: hacer que el comportamiento de la canalización sea visible en términos comerciales antes de que una carga fallida se convierta en un incidente de analítica.
Comprensión de los componentes principales de la arquitectura ETL
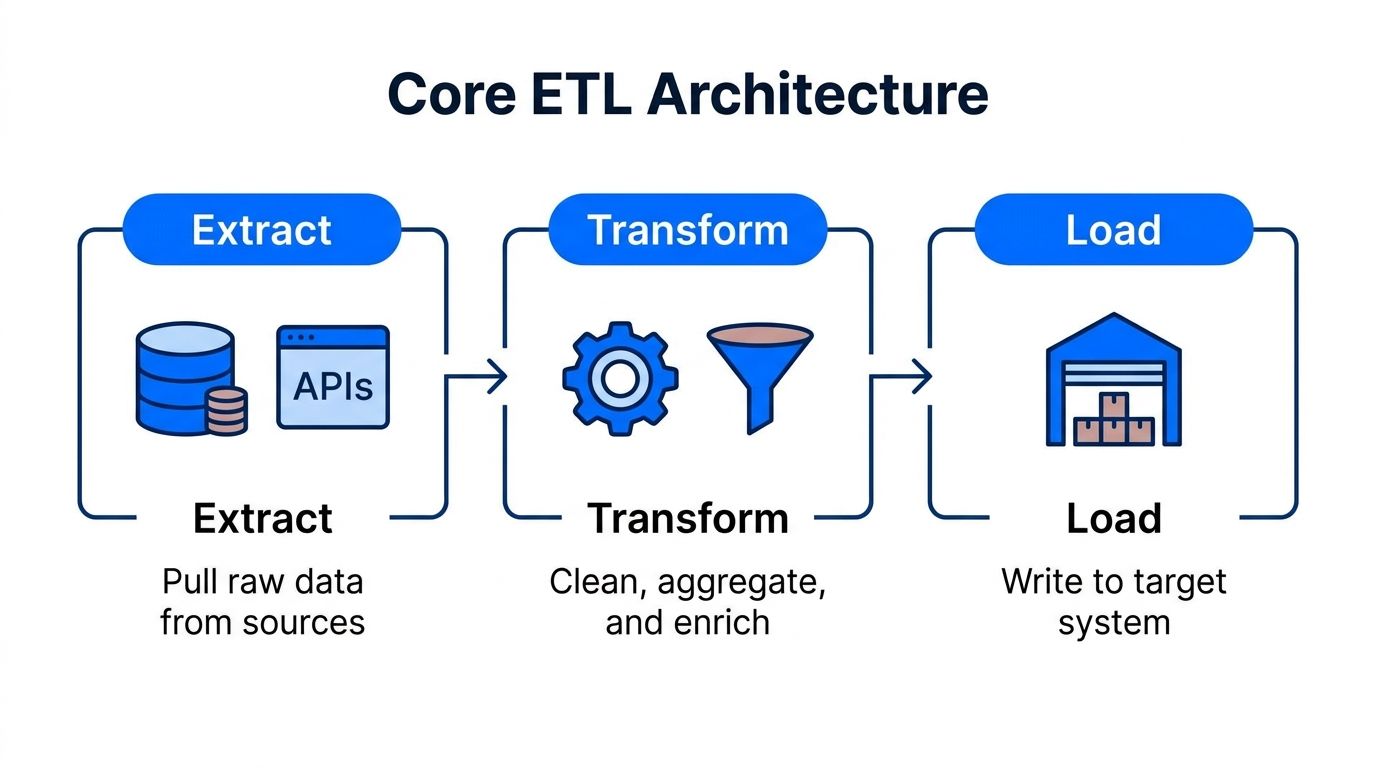
Una canalización de datos ETL tiene tres movimientos definitorios: extraer, transformar y cargar. En producción, esas etapas generalmente se encuentran dentro de una estructura de control más grande que maneja el almacenamiento temporal, los puntos de control, las dependencias, los reintentos, la validación y la evidencia operativa.
Extraer desde el extremo de origen
La extracción extrae datos de bases de datos operativas, API, archivos, aplicaciones SaaS u otros sistemas. La parte difícil no es simplemente conectarse a cada fuente. Es preservar el contexto suficiente para saber qué se extrajo, cuándo se extrajo, qué versión de origen se utilizó y si el origen devolvió una respuesta completa.
Un extractor resiliente maneja los límites incrementales con cuidado. Registra un punto de control, como el marcador de actualización aceptado más reciente, y evita avanzar ese punto de control hasta que la escritura posterior haya tenido éxito. Si la ejecución se detiene a la mitad, la canalización puede reanudarse o reproducirse desde una posición conocida en lugar de adivinar qué se procesó.
Un área de almacenamiento temporal proporciona otro límite útil. Las extracciones brutas se pueden retener antes de la transformación, lo que permite a los ingenieros inspeccionar el comportamiento de la fuente, reproducir transformaciones y separar los problemas de disponibilidad de la fuente de los defectos de transformación.
Transformar en una forma confiable
La transformación es donde la canalización estandariza los formatos, aplica reglas de negocio, elimina registros inutilizables, concilia entidades y crea estructuras analíticas. Un identificador de cliente podría necesitar normalización entre sistemas. Las marcas de tiempo pueden necesitar una interpretación común. Los registros de transacciones pueden requerir un manejo de duplicados y comprobaciones referenciales antes de que puedan respaldar los informes.
Mantenga la lógica de transformación modular. Un único script monolítico dificulta aislar un mapeo roto o identificar qué regla cambió el resultado. Los componentes controlados por versiones, las entradas y salidas explícitas y las funciones comprobables hacen que la revisión y la reversión sean más prácticas.
Cargar con control
La carga escribe los resultados validados en un almacén, lago, almacén operativo u otro destino. Un cargador confiable distingue entre una escritura completada y una escritura parcialmente completada. Utiliza un comportamiento idempotente siempre que es posible, registra las filas aceptadas y rechazadas, y hace que el paso final de publicación sea explícito.
La orquestación debe coordinar las dependencias en lugar de lanzar tareas según una programación. Para los equipos que diseñan el lado de origen de esta arquitectura, la guía de canalización de ingesta de datos de digna ofrece un punto de referencia útil. El principio de diseño clave es tratar cada etapa como un contrato observable, no como una entrega opaca.
Elección entre enfoques ETL y ELT
ETL y ELT difieren principalmente en dónde ocurre la transformación. ETL transforma los datos antes de cargarlos en el destino. ELT carga primero los datos brutos y luego utiliza el almacén o lago de datos de destino para transformarlos.
Ninguno de los dos enfoques gana de manera universal. ETL puede ser la mejor opción cuando se deben filtrar registros sensibles o no válidos antes de que ingresen a un almacén analítico compartido, cuando el destino tiene un cómputo limitado o cuando se requiere una representación de precarga controlada para fines de Compliance. ELT puede ser más flexible cuando los equipos necesitan retener el historial bruto, iterar en modelos y utilizar un cómputo de almacén escalable para las transformaciones.
La decisión también depende de la recuperación de fallos. ETL puede reducir la cantidad de datos inadecuados que llegan al destino, pero un defecto de transformación puede obligar a un reprocesamiento ascendente. ELT conserva los datos brutos para un modelado posterior, pero traslada una mayor responsabilidad a la governance del almacén, el control de acceso, las pruebas y la gestión del cómputo.
Una matriz de decisión útil se ve así:
Factor | Elija ETL cuando | Elija ELT cuando |
|---|---|---|
Compliance | Los datos sensibles deben transformarse o restringirse antes de la carga | Los datos brutos se pueden retener bajo estrictos controles de acceso |
Calidad de los datos | La Data Validation previa a la carga debe bloquear los registros inadecuados | Las pruebas de almacén pueden gobernar los modelos después de la ingesta |
Ubicación del cómputo | El procesamiento externo está disponible o el destino tiene un cómputo limitado | El almacén o lago de datos proporciona la capacidad de transformación adecuada |
Reprocesamiento | El contrato de precarga es estable y está estrictamente controlado | Los equipos necesitan volver a examinar los datos brutos con una lógica de negocio cambiante |
Governance | Se requiere un destino depurado antes de un acceso amplio | Las zonas brutas y modeladas se pueden separar y gobernar |
Habilidades del equipo | Los ingenieros son más fuertes en herramientas de integración y transformaciones procedimentales | Los analistas e ingenieros se sienten cómodos con el modelado de almacenes basado en SQL |
Arquitectura | Predominan las bases de datos heredadas o los flujos de trabajo por lotes regulados | El almacenamiento nativo de la nube y el procesamiento elástico de almacenes son fundamentales |
Modelo operativo | La organización valora las puertas de Release estrictas antes de la publicación | La organización necesita una experimentación rápida con modelos trazables |
Los diseños híbridos son comunes por una buena razón. Un equipo puede usar ETL para tokenizar campos sensibles y aplicar contratos a nivel de fuente, y luego usar ELT para el modelado dimensional posterior. Esa disposición preserva el control en el extremo sin sacrificar la flexibilidad analítica.
Utilice la explicación de digna sobre la ingesta de datos para aclarar el límite de ingesta antes de seleccionar un patrón de transformación. La decisión más importante no es la etiqueta. Es si la arquitectura hace que el riesgo de datos, el costo, el linaje y la recuperación sean visibles para las personas responsables del resultado.
Fallos comunes en las canalizaciones y cargas de mantenimiento
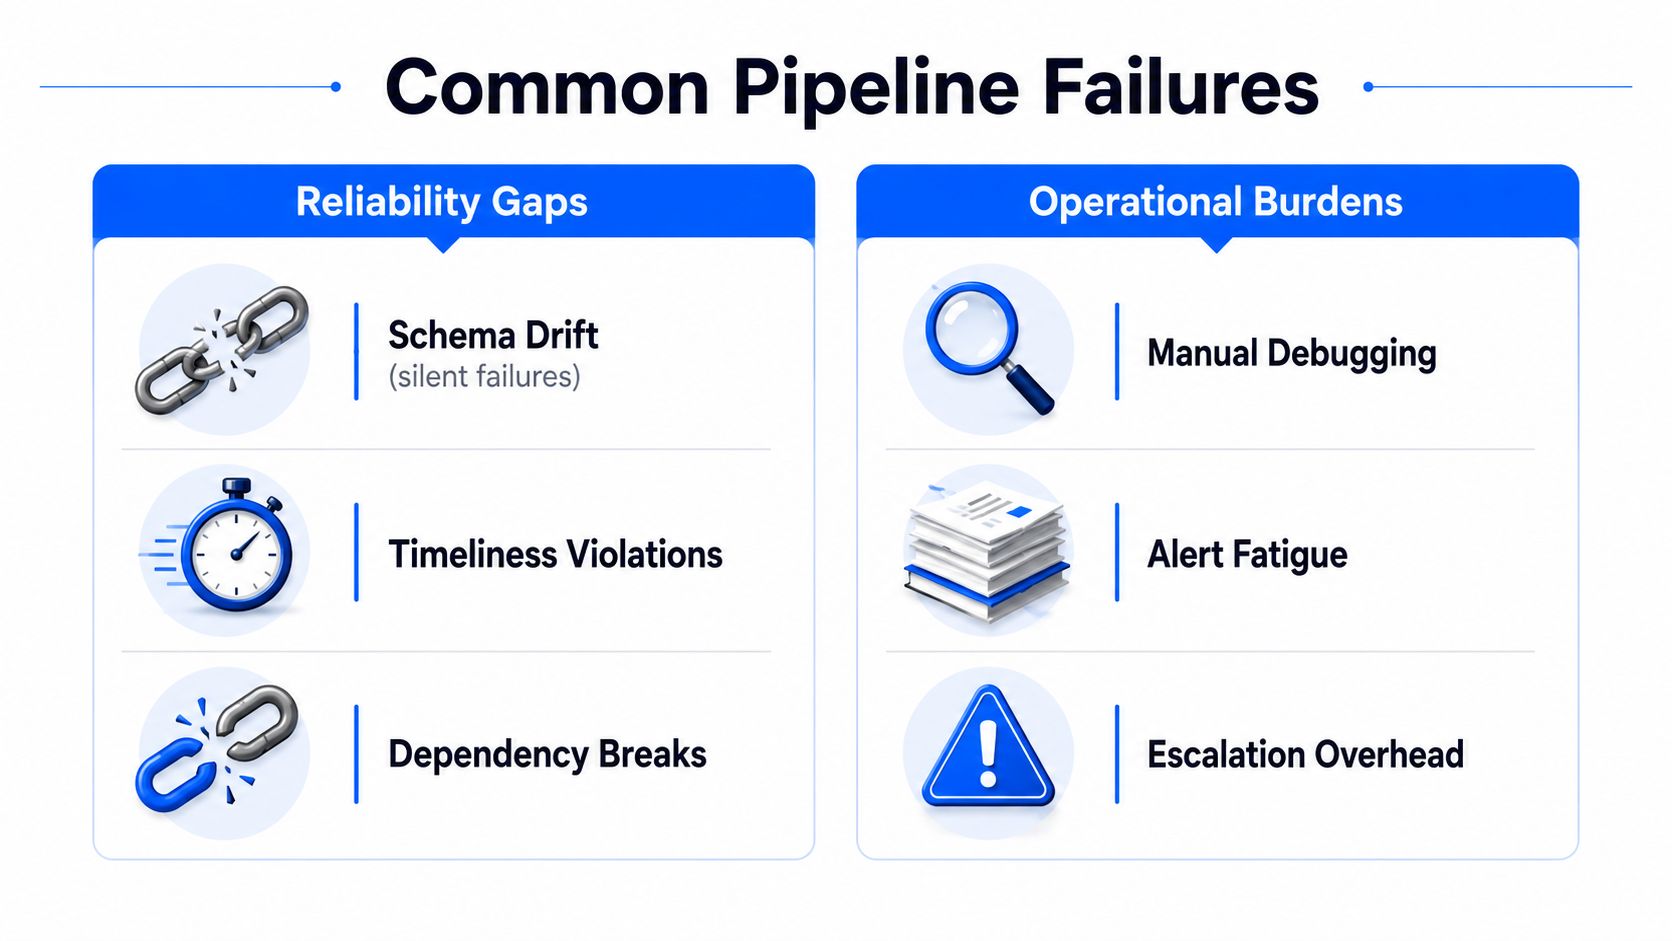
Un estado verde del programador oculta mucho más de lo que revela sobre la corrección de la canalización. Un trabajo ETL puede finalizar después de ingestar un archivo incompleto, aceptar un tipo de columna modificado, cargar registros desactualizados o producir un resultado técnicamente válido que tergiverse los ingresos, el inventario o la actividad del cliente.
La deriva del esquema es una fuente común de fallos silenciosos. Supongamos que una fuente cambia customer_id de un entero a una cadena, o cambia el nombre de order_status mientras la extracción sigue reportando éxito. La transformación puede rechazar cada fila, forzar valores incorrectamente o publicar un resultado cuyo significado ha cambiado. Compare los metadatos entrantes con una línea base con versión en cada ejecución, clasifique el cambio y ponga en cuarentena las discrepancias antes de la ejecución de carga completa. La guía de incidentes de deriva de esquema proporciona un contexto útil para manejar estos eventos.
Lo que el monitoreo convencional pasa por alto
Contar los trabajos fallidos captura errores de ejecución explícitos, mientras que las operaciones confiables requieren señales más amplias:
Rendimiento: Compare el movimiento esperado con las filas o bytes reales procesados.
Frescura: Confirme que los últimos registros llegaron dentro de la ventana de servicio acordada.
Disponibilidad: Realice un seguimiento de si la canalización y sus dependencias son utilizables cuando los consumidores las necesitan.
Tiempo de recuperación: Mida cuánto tiempo tardan los equipos en restablecer una entrega confiable.
Comportamiento de error: Observe las filas rechazadas, los reintentos, el crecimiento de los mensajes no entregados y los fallos parciales recurrentes.
Las comprobaciones de Timeliness deben combinar marcas de tiempo de origen como created_at o updated_at con señales de latido y comparaciones entre programación y disponibilidad. Estos controles pueden exponer una ingesta demorada antes de que un informe posterior falle visiblemente (guía de monitoreo de timeliness).
El mantenimiento es una restricción económica
Las canalizaciones heredadas y personalizadas se rompen con más frecuencia que los sistemas ELT completamente administrados, y los ingenieros de datos pueden dedicar el 53 % de su tiempo al mantenimiento de las canalizaciones, según la encuesta de finales de 2025 analizada en el informe de TechTarget. El ELT administrado no elimina el trabajo de confiabilidad. Los equipos aún necesitan contratos, propiedad, procedimientos de recuperación y pruebas. La elección operativa debe tener en cuenta la mano de obra, el tiempo de inactividad y el costo de investigar resultados engañosos.
La Observability cambia ese cálculo cuando conecta los síntomas con el impacto y la causa probable. La guía de Captapi para sistemas resilientes ofrece un tratamiento más amplio de las pruebas de resiliencia y el comportamiento ante fallos. Las alertas deben identificar los conjuntos de datos afectados, la urgencia y la siguiente acción, en lugar de crear otra cola de ruido sin explicación.
Un análisis centrado en la detección temprana aparece en el análisis de digna sobre por qué fallan las canalizaciones de datos en producción. El objetivo práctico es un camino más corto desde el cambio de origen hasta la decisión operativa segura, transformando la visibilidad de la canalización de una carga de mantenimiento a un activo para una entrega de datos confiable.
Construcción de confiabilidad con controles de calidad
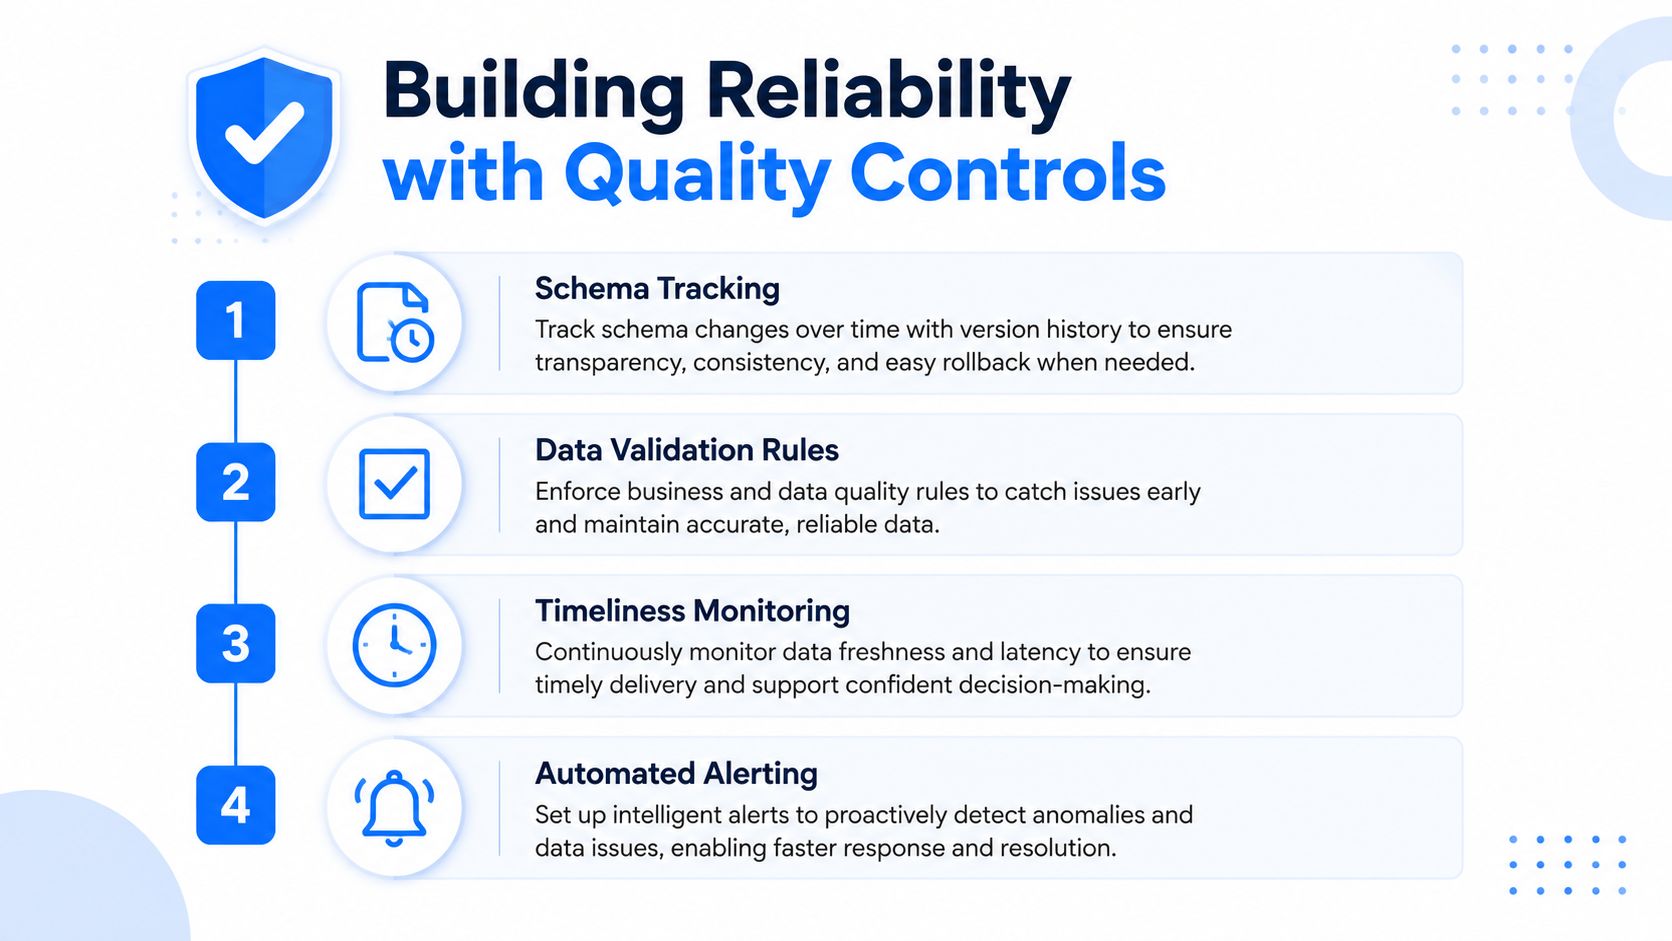
La confiabilidad depende de los controles colocados a lo largo de la canalización. El seguimiento de esquemas detecta cambios estructurales, la Data Validation prueba el significado de los datos, el monitoreo de timeliness identifica problemas de entrega y las métricas operativas revelan una disminución en la calidad de la ejecución, incluso cuando los trabajos aún se completan. Juntos, estos controles limitan el costo oculto de los fallos, incluido el reprocesamiento, la investigación manual, las decisiones demoradas y la pérdida de confianza en los resultados posteriores.
Comenzar en la ingesta
Maneje la deriva del esquema en el límite de la fuente, antes de que una estructura modificada llegue a las transformaciones y a los lectores posteriores. Establezca una línea base con versión para cada fuente importante, compare los metadatos entrantes en cada ejecución y clasifique los cambios por riesgo.
La adición de un campo compatible puede requerir revisión sin causar una interrupción. Un campo eliminado, un cambio de tipo incompatible o una clave de negocio renombrada generalmente deberían detener o poner en cuarentena el flujo afectado hasta que un propietario lo vuelva a certificar explícitamente. Las ejecuciones de prueba (canary runs) y los registros de esquemas permiten a los equipos probar la compatibilidad antes de publicar la carga completa.
Validar registros y relaciones
Las reglas de negocio convierten las expectativas de calidad en decisiones que los sistemas pueden probar. Los controles empresariales pueden incluir rangos de variación de recuento de filas de ±30 %, un límite de tasa de valores nulos de correo electrónico de menos del 5 % y una regla de integridad referencial que requiere que cada order.customer_id exista en la tabla de clientes (ejemplos de control de calidad ETL).
Estos umbrales no son valores predeterminados universales. Son contratos explícitos que los propietarios de datos deben aprobar, documentar y revisar cuando cambie el comportamiento de la fuente. La validación a nivel de registro también crea evidencia de auditoría al mostrar qué regla falló y qué registros se vieron afectados. Los trabajos académicos sobre la verificación de reglas de negocio para la calidad de los datos respaldan la evaluación de la calidad frente a las reglas establecidas. Para obtener orientación sobre la implementación, consulte el análisis de digna sobre las reglas de validación de datos y la calidad continua de los datos.
Monitorar la entrega y la recuperación
Una canalización puede pasar todas las pruebas de contenido y, aun así, no cumplir con su plazo comercial. Defina las expectativas de frescura a partir de las marcas de tiempo de origen, los patrones de llegada esperados y los requisitos de servicio posteriores. Alerte sobre entregas faltantes, tardías o tempranas cuando esos eventos indiquen un problema ascendente o de programación.
Realice un seguimiento de las filas entrantes, las filas salientes, las filas rechazadas, la duración, el recuento de errores y la frescura para cada etapa. La guía de expertos recomienda apuntar a tasas de error inferiores al 0.1 %, tratar las tasas superiores al 5 % como una señal de fallo sistémico, mantener una disponibilidad del 99.9 % y restaurar el servicio en menos de 30 minutos (guía de evaluación comparativa de ETL).
Regla operativa: Una alerta debe identificar el conjunto de datos, el contrato infringido, la dependencia probable, el propietario de la empresa y la siguiente acción segura.
Estos controles forman un bucle operativo. La detección sin cuarentena permite que se propaguen los datos erróneos. La validación sin timeliness deja a los consumidores con resultados desactualizados. Las métricas sin propiedad producen gráficos pero no recuperación. La Observability conecta cada señal con una respuesta priorizada, lo que reduce el trabajo de mantenimiento y, al mismo tiempo, convierte la entrega confiable de datos en una capacidad operativa gestionada.
Cómo la Data Observability transforma las operaciones
El monitoreo tradicional pregunta si una tarea se ejecutó. La Data Observability pregunta si los datos se comportaron como se esperaba, si los consumidores los recibieron a tiempo y qué cambio explica la desviación.
Considere una canalización de servicios financieros que recibe datos de transacciones de varios sistemas operativos. Un equipo de origen agrega un campo y cambia un tipo sin coordinarse con el equipo de la plataforma de datos. Un programador puede informar el éxito de la extracción, mientras que un modelo posterior descarta valores o cambia su agregación sin notificación. El seguimiento de esquemas puede identificar el cambio estructural en la ingesta, poner en cuarentena el flujo afectado y proporcionar evidencia a los ingenieros antes de que un ciclo de informes dependa del resultado.
Las canalizaciones de atención médica generan una presión diferente. Un conjunto de datos puede llegar con un esquema familiar pero con un patrón de integridad inusual, omitiendo una parte significativa de los registros esperados. La detección de anomalías en la línea base puede alertar sobre el cambio de comportamiento, mientras que las comprobaciones de validación pueden probar las relaciones requeridas y las reglas de negocio. El monitoreo de timeliness luego distingue un flujo retrasado de uno que llegó a tiempo pero contiene contenido anormal.
Los equipos de telecomunicaciones a menudo gestionan un gran volumen de datos operativos y de clientes en sistemas heterogéneos. Una capa de Observability útil debe conectar el comportamiento de la plataforma con el comportamiento de los datos, de modo que los ingenieros puedan separar un problema de carga de trabajo, una interrupción del origen, un cambio de esquema y un fallo de calidad. Para los equipos que operan tanto plataformas de datos como prácticas de ingeniería de confiabilidad, los recursos sobre monitoreo de infraestructura para SRE proporcionan un contexto relevante para pensar en señales, dependencias y respuesta a incidentes.
digna puede servir como una opción en esta categoría. Se ejecuta dentro del entorno del cliente, realiza comprobaciones en la base de datos, monitorea anomalías, timeliness, reglas de validación, cambios de esquema y métricas de plataforma, y admite la implementación en nube privada o local. Su estructura modular permite a un equipo comenzar con una capacidad de monitoreo y expandirse a tablas y canalizaciones críticas, mientras que una interfaz compartida brinda a ingenieros, analistas y partes interesadas una visión común de incidentes y tendencias.
El cambio estratégico se puede medir en el flujo de trabajo, incluso cuando los datos mismos permanecen en su lugar. Los ingenieros dedican menos tiempo a demostrar que ocurrió un fallo y más tiempo a decidir si bloquear, reproducir, remediar o comunicar el impacto.
Implementación de Observability en su entorno
Comience con los conjuntos de datos que tienen consecuencias comerciales claras. Mapee sus fuentes, propietarios, consumidores posteriores, comportamiento de entrega esperado, campos clave y dependencias de recuperación. No comience por instrumentar cada tabla. Un primer alcance estrecho produce una propiedad más clara y expone brechas en los contratos.
A continuación, establezca una línea base para cada conjunto de datos seleccionado. Capture el volumen normal, el comportamiento de llegada, la forma del esquema, los patrones nulos y los resultados de la validación. Configure alertas para las desviaciones que requieran acción y diríjalas al equipo que puede cambiar el origen, la canalización o el destino. Una alerta que no llega a nadie capaz de remediarla es solo documentación de un fallo.
Agregue controles sin reemplazar el programador existente. Airflow, dbt, Informatica, Talend y Spark pueden continuar orquestando transformaciones mientras una capa de Observability evalúa el comportamiento a su alrededor. Comience en un modo de monitoreo si el bloqueo de cargas creara un riesgo innecesario, luego promueva las comprobaciones de alta confianza a cuarentena o puertas de Release.
Hacer que los incidentes sean colaborativos
Defina un registro de incidentes que incluya la expectativa infringida, los datos afectados, la hora de la primera detección, el estado actual, el propietario, la solución y la acción de seguimiento. Revise los fallos recurrentes por impacto comercial, no por recuento de alertas. Un conjunto de datos tardío de bajo impacto puede clasificarse por debajo de un cambio de esquema sutil en un flujo regulatorio, incluso si este último no produjo ningún error en el programador.
Mida si la práctica está reduciendo el tiempo de detección, el esfuerzo de investigación, la recurrencia, la entrega desactualizada y los datos rechazados. Mantenga la revisión vinculada a los resultados comerciales, como informes confiables y entradas de IA más seguras. La Observability se convierte en un activo estratégico cuando los líderes pueden ver qué inversiones en confiabilidad protegen las decisiones y qué cambios en las canalizaciones generan una nueva exposición.
digna proporciona Data Observability en el entorno para canalizaciones ETL, lo que incluye detección de anomalías, seguimiento de esquemas, monitoreo de timeliness, Data Validation a nivel de registro y métricas de plataforma. Visite digna para evaluar cómo su modelo de implementación modular puede ayudar a su equipo a detectar el riesgo en las canalizaciones de manera más temprana y transformar el trabajo de confiabilidad en una práctica operativa responsable.
Preguntas frecuentes
¿Cuánto cuesta realmente un fallo de canalización?
Un benchmark de 2026 halló que el 97 % de los responsables sénior de datos y tecnología dice que los fallos de canalización han frenado iniciativas de analítica o IA, con una exposición media mensual de unos 3 millones de dólares. El coste rara vez aparece en el planificador, y por eso no se presupuesta.
¿Por qué sigue importando ETL junto a ELT y streaming?
Porque muchas organizaciones siguen necesitando que las transformaciones sean controladas, reproducibles y auditables antes de que el dato llegue a los sistemas analíticos. ELT y streaming ampliaron el espacio de diseño sin eliminar ese requisito.
¿Cuándo se convirtió ETL en patrón estándar?
A principios de los años noventa, cuando los almacenes de datos entraron en la analítica generalista. En esa época surgieron productos de integración dedicados, entre ellos Prism Solutions fundada en 1988, Informatica fundada en 1993 y DataStage en el mismo periodo.
¿Cuáles son los movimientos que definen una canalización ETL?
Tres: extraer en el borde del origen, transformar según una lógica acordada y cargar en el destino. Nombrarlos por separado importa porque cada uno tiene sus modos de fallo y cada uno es por donde entra un tipo distinto de defecto.
¿Qué monitorizar más allá del estado del trabajo?
El dato que el trabajo produjo. Un planificador informa de la finalización, mientras que la exposición de negocio nace de una salida que terminó y estaba mal, así que el trabajo de fiabilidad corresponde a la capa de datos y no solo a la de orquestación.


